Año 2 · Módulo 13
128.1. Simular eventos sin resolver toda la ecuación maestra
La ecuación maestra permite calcular cómo cambia una distribución de estados, pero resolverla directamente puede ser inviable cuando los estados posibles son numerosos. El algoritmo de Gillespie aborda el problema desde el nivel de los acontecimientos. Parte de las tasas de reacción, sortea el tiempo del próximo salto y selecciona el canal que se activará. Una secuencia de esos pasos genera realizaciones exactas del proceso de saltos modelado, siempre que se respeten las hipótesis sobre sus propensiones.
El método fue desarrollado por el físico Daniel T. Gillespie en el contexto de la cinética de reacciones químicas y permite simular los saltos de un proceso de Markov en tiempo continuo sin imponer una cuadrícula temporal de paso fijo. En cada estado calcula cuánto falta hasta el próximo evento y cuál de los eventos permitidos será; después actualiza el estado y repite el procedimiento.
El interés excede la química. Podemos aplicar la misma idea a nacimientos y muertes de organismos, fallos y reparaciones de componentes, movimientos de partículas en una red discreta o transmisiones infecciosas en un modelo de compartimentos. Estos ejemplos comparten una estructura matemática, aunque sus mecanismos sean distintos. Hay un conjunto discreto de estados, una lista de transiciones posibles y una tasa de ocurrencia para cada transición, condicionada al estado actual.
La palabra «exacto», que suele acompañar al método, necesita interpretación. El algoritmo es exacto respecto de la cadena de Markov y de las tasas especificadas, porque no introduce el error sistemático que produce dividir el tiempo en pasos de tamaño finito. Sus resultados continúan sujetos a incertidumbre de Monte Carlo cuando calculamos estadísticas con un número limitado de realizaciones. Por otra parte, un modelo que describe mal la realidad producirá simulaciones exactas de un mecanismo equivocado.
Desarrollaremos primero el fundamento probabilístico del método, luego la forma de representar varios canales de transición y finalmente dos casos reproducibles. El primero tiene solución analítica, con la que verificaremos el código; el segundo, un modelo epidémico sencillo, muestra cómo usar el método cuando las tasas dependen de varias variables y de sus interacciones. Terminaremos examinando aproximaciones más rápidas y los controles mínimos para no confundir una animación plausible con un experimento computacional fiable.
128.2. Canales, propensiones y relojes de transición
Supongamos que el estado del sistema es un vector entero . En ese estado existen clases de acontecimientos, o canales, numerados por . El canal tiene una tasa instantánea o propensión . Su significado es la probabilidad, condicionada al estado actual, de que el acontecimiento ocurra en un intervalo pequeño , dividida por en el límite
La formulación presupone un proceso de saltos regular en el que los términos de orden superior se comportan adecuadamente y no hay dos o más saltos simultáneos con probabilidad de primer orden. Cada acontecimiento modifica el estado mediante un vector , de modo que . Para construir una trayectoria necesitamos decidir cuándo se activará alguno de los canales y cuál será el elegido.
Definimos la propensión total
Mientras no ocurre ningún acontecimiento, el estado permanece en . Si el modelo es homogéneo en el tiempo, también permanecen constantes sus propensiones. La probabilidad de que todos los canales permanezcan sin activarse durante una duración es
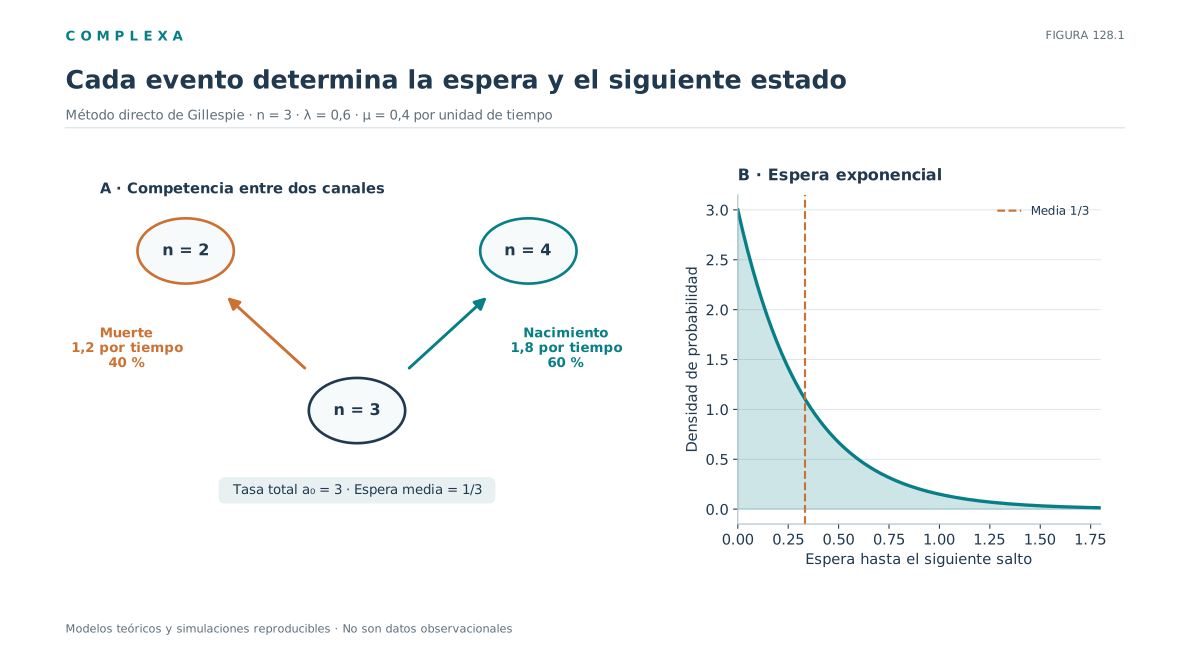
Por tanto, el tiempo hasta el próximo evento es exponencial de tasa . Si , no hay ningún salto habilitado y el sistema permanece en ese estado, que es absorbente bajo las reglas definidas. Si , la espera tiene esperanza .
Una manera intuitiva de recuperar este resultado consiste en imaginar un reloj exponencial independiente por cada canal, con tasa . El primero en sonar determina el acontecimiento. La probabilidad de que ningún reloj suene durante es el producto de sus probabilidades de supervivencia
La probabilidad de que el canal sea el ganador es . Este argumento requiere las hipótesis de competencia entre relojes usadas en el modelo; no autoriza a suponer independencia de los acontecimientos futuros después de un salto, porque el salto puede modificar todas las tasas.
Esto marca una diferencia con la simulación de procesos puntuales. Una sucesión de eventos que se produce a tasa total no es, en general, un proceso de Poisson homogéneo a lo largo de toda la trayectoria, porque cada evento cambia y puede modificar la intensidad del siguiente. La distribución exponencial del próximo intervalo, condicionada al estado presente, es compatible con una secuencia de esperas globalmente dependiente y con intensidades variables.
El algoritmo necesita una representación que pueda traducirse de forma inequívoca a código. Cada canal tiene una variación y una propensión . Consideremos la población de C127, con nacimientos a tasa y muertes a tasa . Podemos escribir
Si , ambas propensiones son nulas y el estado queda absorbido. Si , y , la propensión total es tres acontecimientos por unidad de tiempo. La espera promedio hasta el próximo evento será unidades. Condicionado a un evento, la probabilidad de nacimiento es y la de muerte . Estas cifras definen la distribución que debe respetar una simulación correcta, sin fijar cuál de los dos eventos ocurrirá.
En sistemas de varias especies, el cambio se expresa como vector estequiométrico. Por ejemplo, la conversión disminuye el conteo de en uno y aumenta el de en uno. Para el estado su vector es . Si cada molécula de se transforma con tasa individual , la propensión es . El cambio conserva el número total , un invariante que puede verificarse durante toda la simulación.
Para una reacción de encuentro entre dos especies distintas, , una propensión bien mezclada puede ser bajo una elección adecuada de volumen y constante de tasa. Si dos moléculas de la misma especie participan, el número de pares no ordenados es ; la propensión microscópica correspondiente se escribe con ese factor combinatorio y una constante definida de manera coherente. Omitirlo puede duplicar la tasa de reacción. La ecuación macroscópica de acción de masas y la propensión discreta se parecen, pero sus constantes tienen unidades y escalados que deben distinguirse.
Los estados imposibles requieren restricciones explícitas. Si , una reacción que consume debe tener propensión cero. Corregir los conteos negativos después del salto no sirve, porque cambia la ley de transición y produce un proceso diferente. En sistemas con capacidad finita, una reacción de nacimiento debe deshabilitarse cuando ya no hay espacio. Dejar tasas positivas para eventos físicamente imposibles y confiar en que la simulación los «resolverá» después es un error de modelización.
La lista de canales es también una forma de hacer auditables los supuestos. Una matriz de tasas grande puede resultar difícil de interpretar, mientras que una tabla de acontecimientos hace visible qué conserva el modelo, dónde entra la interacción y qué condiciones lo convierten en absorbente. Esa ventaja pedagógica explica por qué los métodos de simulación por eventos son útiles incluso cuando un problema pequeño permite resolver exactamente la ecuación maestra.
128.3. Derivación y ejecución del método directo
El método directo de Gillespie genera dos números pseudoaleatorios independientes con distribución uniforme en . Para obtener el tiempo de espera usamos la transformación inversa de la distribución exponencial
La probabilidad de que el siguiente evento sea del canal es
Para seleccionar el canal definimos sumas acumuladas y escogemos el primer índice tal que . El orden de los canales dentro de la lista no debería cambiar sus probabilidades individuales si todos se procesan de manera coherente. La implementación usa comparaciones y números de precisión finita, por lo que conviene comprobar casos de frontera y tasas extremadamente desiguales.
En cada iteración evaluamos las propensiones con el estado actual, calculamos , generamos , identificamos el canal , avanzamos el reloj a , modificamos el estado a y repetimos. Si , terminamos porque la dinámica carece de eventos habilitados. Uno de los números aleatorios controla el intervalo temporal y el otro el tipo de salto; reutilizar el mismo valor uniforme para ambos podría introducir una dependencia artificial.
La distribución conjunta del siguiente intervalo y del canal contiene toda la justificación esencial
Al integrar sobre , obtenemos . Al sumar sobre canales, obtenemos la densidad exponencial . La factorización demuestra que, condicionado al estado, el tiempo de espera y el canal seleccionado son independientes bajo el modelo homogéneo. Esta propiedad no siempre se conserva de la misma forma cuando las propensiones dependen explícitamente del tiempo; allí puede ser necesario integrar intensidades variables y modificar el procedimiento.
Al simular hasta un horizonte fijo , si el siguiente tiempo generado supera , el salto no debe ejecutarse más allá del horizonte para luego atribuírselo al estado en . El sistema conserva su último estado hasta . El registro adecuado incluye los tiempos exactos de salto y la posibilidad de consultar el estado entre ellos. Las trayectorias de cadenas de Markov de salto puro son funciones escalonadas, convencionalmente continuas por la derecha.
No hay un tamaño de paso temporal que debamos elegir para garantizar exactitud en el método directo. Esa ausencia de discretización del tiempo es una ventaja frente a esquemas de Euler usados incorrectamente como aproximación de procesos discretos. El precio es computacional, porque si la tasa total es muy grande, los intervalos pueden ser diminutos y la trayectoria puede requerir millones de eventos. El algoritmo tampoco vuelve automáticamente eficiente la estimación de probabilidades raras; para cuantificarlas mediante Monte Carlo ordinario podrían necesitarse muchísimas realizaciones.
128.4. Primer banco de pruebas con la desaparición independiente de cuatro unidades
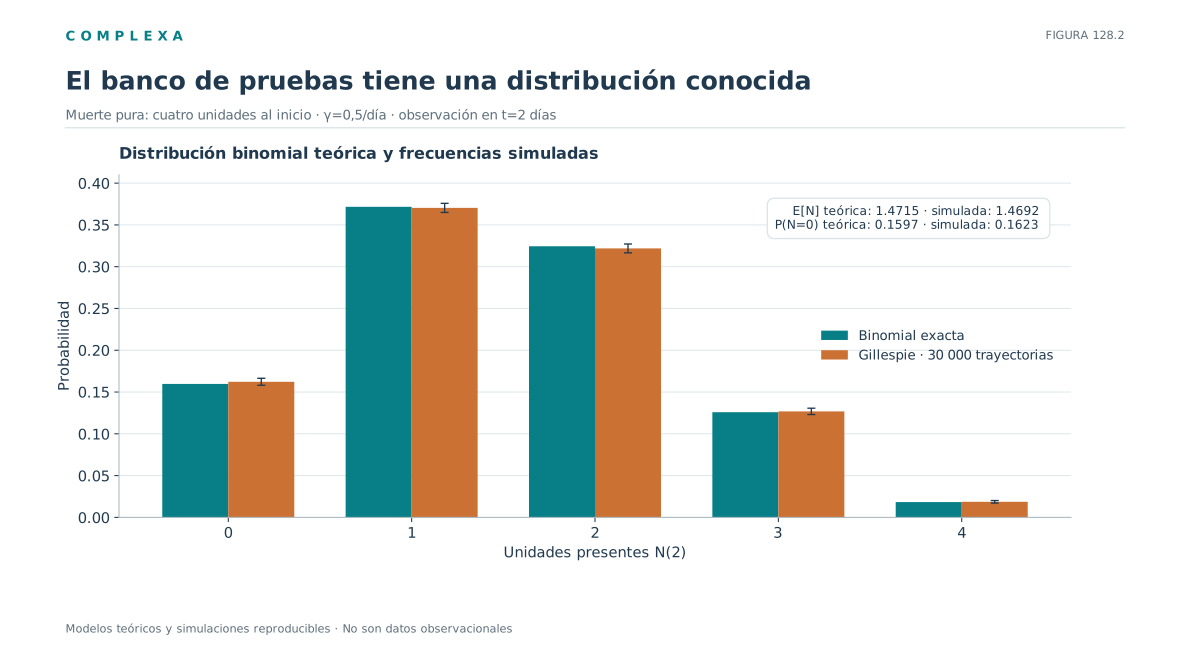
Antes de simular un sistema complejo conviene elegir uno cuya distribución final pueda calcularse sin un ordenador. Supongamos cuatro unidades presentes en y sin aparición de nuevas unidades; cada una desaparece de forma independiente a tasa por día. Si , la tasa de desaparición total es . Cada unidad sobrevive hasta con probabilidad . En consecuencia,
La esperanza, la varianza y la probabilidad de absorción son
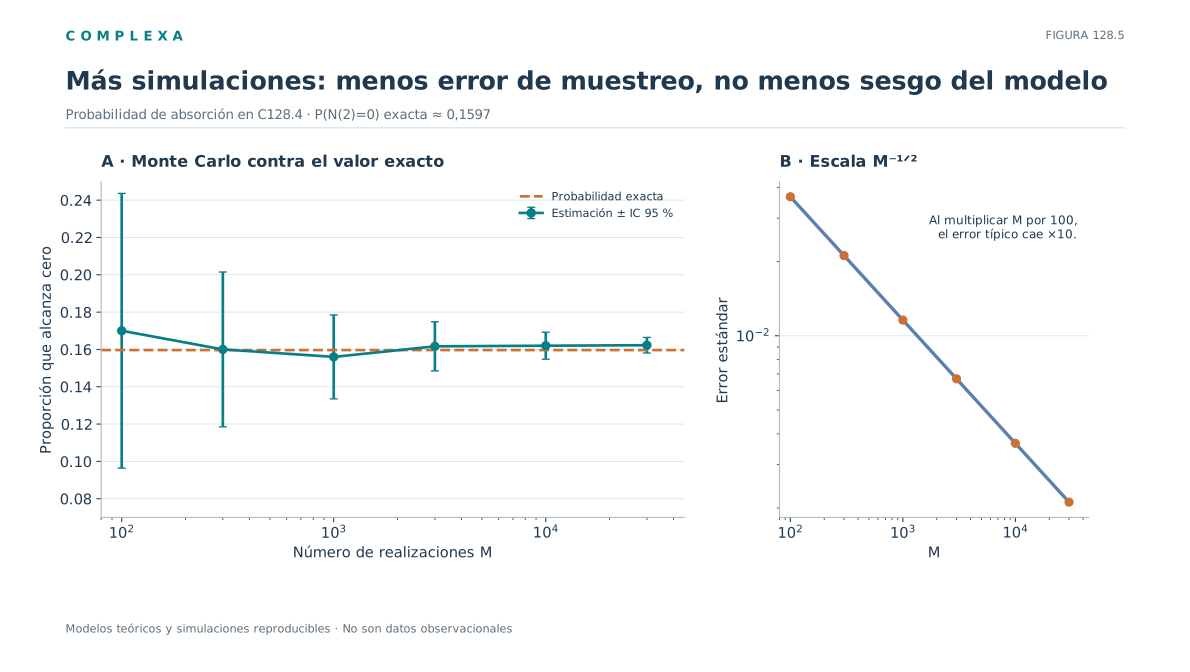
En días, el valor exacto de la media es , aproximadamente , mientras que la probabilidad de que todas las unidades hayan desaparecido es , aproximadamente . Con ambos valores se puede evaluar una implementación independiente.
El siguiente código implementa el método directo de Gillespie con una sola clase de evento. Usa una semilla explícita para permitir repetir el experimento y registra el estado en un tiempo de observación fijo. Genera los saltos con la tasa que corresponde al tamaño actual, sin discretizar el intervalo de dos días.
import numpy as np

rng = np.random.default_rng(128)

def desaparicion(n0=4, gamma=0.5, horizonte=2.0):
    t = 0.0
    n = n0
    while n > 0:
        tasa = gamma * n
        espera = rng.exponential(scale=1.0 / tasa)
        if t + espera > horizonte:
            break
        t += espera
        n -= 1
    return n

muestras = np.array([desaparicion() for _ in range(30_000)])
media_exacta = 4 * np.exp(-1.0)
absorcion_exacta = (1.0 - np.exp(-1.0))**4

print('Media teórica:', media_exacta)
print('Media simulada:', muestras.mean())
print('P(extinción) teórica:', absorcion_exacta)
print('P(extinción) simulada:', np.mean(muestras == 0))
assert np.all((muestras >= 0) & (muestras <= 4))
La coincidencia aproximada entre resultados exactos y empíricos es una condición necesaria para confiar en el programa, aunque insuficiente. Un fallo en la selección de canales puede pasar inadvertido en un modelo que tiene uno solo; por eso necesitamos un segundo caso con varias transiciones y dependencias entre variables. El caso sencillo sí descarta errores frecuentes, como calcular mal la espera exponencial, usar la tasa individual cuando correspondía la tasa total, aplicar un salto después del horizonte o permitir estados negativos.
La magnitud de la discrepancia esperable puede expresarse estadísticamente. Si estimamos una proporción a partir de trayectorias independientes, su error estándar aproximado es . Con y , ese error es cercano a . Diferencias de unas pocas milésimas son normales; una discrepancia sistemática mucho mayor, repetida con distintas semillas, exigiría investigar la implementación o la fórmula de comparación.
128.5. Un sistema acoplado y la estimación por Monte Carlo
El modelo SIR divide una población cerrada en individuos susceptibles , infecciosos y retirados de la transmisión . El estado completo es , con total constante . Consideraremos un modelo ideal homogéneo, sin nacimientos, mortalidad ni pérdida de inmunidad. Tiene dos canales. La infección transforma un susceptible en infeccioso y la recuperación mueve un infeccioso a retirado.
La tabla de eventos es
La tasa supone mezcla homogénea y encuentros efectivos expresados por la constante , cuya unidad es inversa de tiempo. No debemos interpretarla como una probabilidad individual aislada. La tasa de recuperación corresponde a duraciones infecciosas exponenciales independientes con parámetro . Ambas hipótesis pueden ser razonables como primera aproximación o claramente inadecuadas cuando hay estructuras de contacto, duraciones heterogéneas o intervenciones que cambian con el calendario.
La dinámica respeta invariantes. Toda infección reduce en uno e incrementa en uno; toda recuperación reduce y eleva . Nunca deben aparecer estados negativos. Cuando , ambas propensiones se anulan y el proceso termina. Como el número de susceptibles solo disminuye y el de retirados solo aumenta, el número total de saltos es finito en una población finita bajo estas reglas. Por ello, con , la epidemia llega al estado sin infecciosos con probabilidad uno.
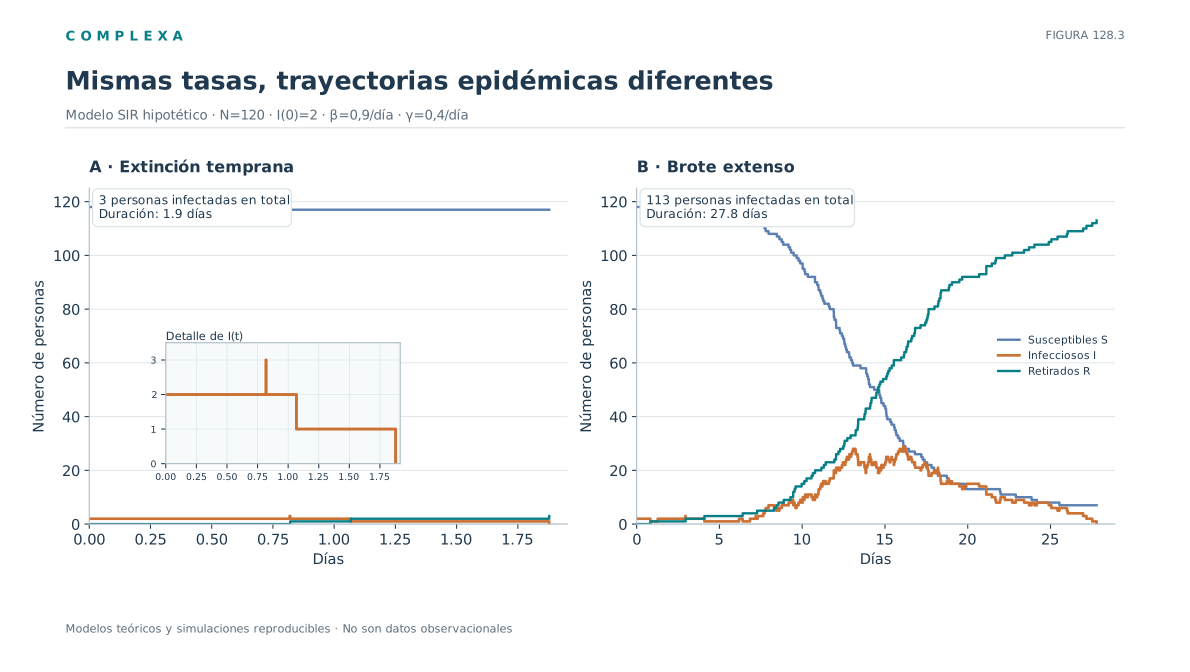
En la versión determinista, , y . Son ecuaciones de evolución de cantidades continuas que pueden dar buenas aproximaciones bajo condiciones de escala adecuadas. El proceso estocástico, en cambio, puede extinguirse con apenas dos infecciosos iniciales incluso cuando . La posibilidad de que ambos se recuperen antes de transmitir es distinta del crecimiento esperado de una cohorte de poblaciones idénticas.
Usaremos , , , , y , con el día como unidad temporal. Estas cifras son hipotéticas y se eligen para ilustrar el procedimiento. El número de nuevas infecciones acumuladas se calcula como ; el número total de personas que estuvieron infectadas incluye además los dos casos iniciales. Mezclar ambos recuentos alteraría la interpretación de los tamaños finales del brote.
En el siguiente programa cada salto corresponde a una infección o a una recuperación. Se registran el estado final, el tamaño acumulado del brote y su duración hasta . El experimento conserva la misma población total y ejecuta múltiples trayectorias independientes con el mismo generador pseudoaleatorio, sin reiniciar la semilla en cada una.
import numpy as np

rng = np.random.default_rng(12806)

def una_epidemia(beta=0.9, gamma=0.4, n=120, i0=2):
    s, i, r = n - i0, i0, 0
    t = 0.0
    eventos = 0
    while i > 0:
        infectar = beta * s * i / n
        recuperar = gamma * i
        total = infectar + recuperar
        assert total > 0.0
        t += rng.exponential(scale=1.0 / total)
        if rng.random() * total < infectar:
            s -= 1
            i += 1
        else:
            i -= 1
            r += 1
        eventos += 1
        assert min(s, i, r) >= 0 and s + i + r == n
        assert eventos <= 2 * n
    return n - s, t

resultados = [una_epidemia() for _ in range(5_000)]
tamanos = np.array([r[0] for r in resultados])
duraciones = np.array([r[1] for r in resultados])
print('Media del tamaño total:', tamanos.mean())
print('Mediana del tamaño total:', np.median(tamanos))
print('P(tamaño total >= 30):', np.mean(tamanos >= 30))
print('Mediana de días hasta I=0:', np.median(duraciones))
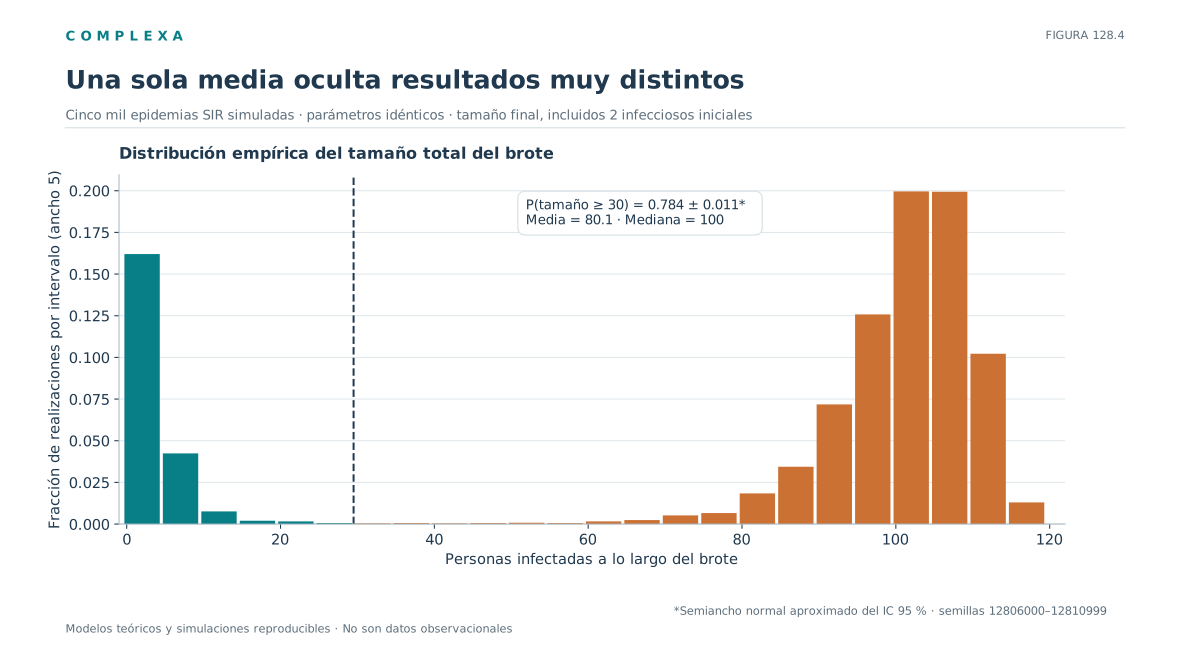
El resultado es una distribución de tamaños finales, con brotes que terminan pronto y otros que comprometen a una fracción grande de la población. El mismo valor promedio puede ocultar esa heterogeneidad. Si el objetivo es decidir sobre un umbral de capacidad sanitaria, la estimación puede resultar más informativa que la sola media, aunque seguirá siendo una predicción del modelo hipotético, sin validación clínica.
Cada ejecución de un programa de Gillespie produce una sola trayectoria. Para aproximar una probabilidad debemos repetirla muchas veces de manera independiente con parámetros y estado inicial idénticos. Si vale uno cuando la realización cumple un criterio de interés y cero en caso contrario, el estimador de probabilidad es
Si las trayectorias son independientes y el modelo es correcto, y . El error estándar decrece como . Multiplicar por cien el número de trayectorias reduce aproximadamente a una décima la incertidumbre de muestreo de una proporción bien comportada. La computación adicional mejora la precisión estadística, pero no corrige tasas equivocadas.
Las probabilidades muy pequeñas requieren especial cuidado. Si una catástrofe tiene probabilidad real bajo el modelo, cien mil simulaciones producirán en promedio un solo evento. Esa cantidad es insuficiente para una estimación precisa. Observar cero eventos tampoco demuestra que la probabilidad sea cero; como regla aproximada, el límite superior unilateral de 95 % para una proporción binomial cuando no aparecen éxitos es alrededor de . Para fenómenos raros pueden necesitarse métodos de importancia, divisiones de trayectorias o soluciones analíticas, siempre acompañados de una justificación de sus sesgos y límites.
El tiempo de observación también forma parte del estimando. , y coinciden en ciertos procesos absorbentes, pero las dos primeras solo se refieren al horizonte ; la última es eventual. En modelos con recuperación o recurrencia, observar el estado cero en un instante no equivale necesariamente a haber llegado alguna vez a cero, salvo que cero sea absorbente. El código y el informe deben identificar qué evento se contó.
Una trayectoria de salto puede registrarse en una cuadrícula regular para producir gráficos comparables. Para consultar el estado en , se toma el último estado generado cuyo tiempo de salto no exceda cada instante. Es incorrecto interpolar linealmente dos conteos separados por un salto, porque la interpolación crearía estados fraccionarios que el proceso nunca ocupó. Conviene guardar los tiempos y estados de los saltos y construir cualquier visualización después, de manera independiente del motor probabilístico.
Un asunto más sutil es la dependencia inducida por la selección. Si calculamos el tamaño medio de las epidemias que superaron treinta casos, no obtenemos el tamaño promedio de todas las epidemias. Estamos describiendo una subpoblación condicionada al evento que pretendíamos estimar. Para cuantificar probabilidades y medias, cada trayectoria generada debe conservarse en el denominador original o debe declararse explícitamente la condición de inclusión. Las comparaciones entre dos políticas simuladas requieren definir el contraste antes de explorar qué resultados son más llamativos.
128.6. Verificación mediante invariantes, límites y pruebas cruzadas
Un algoritmo reproducible necesita controles que permitan detectar errores conceptuales antes de confiar en sus resultados. El primero es revisar las propensiones. Deben ser no negativas en todos los estados admitidos, anularse cuando un canal carece de reactivos o individuos disponibles y tener unidades temporales compatibles. La suma de propensiones debe coincidir con la tasa de salida descrita por el generador del modelo. Si dos canales llevan al mismo estado final, sus tasas pueden sumarse en el generador, aunque quizá interese conservarlos separados cuando corresponden a mecanismos distinguibles.
El segundo control es algebraico. En el modelo SIR, debe conservarse exactamente y todas las variables deben permanecer enteras no negativas. En un sistema de reacciones químicas puede haber balances de masa, carga o número total de determinadas especies. Si la simulación viola uno de esos invariantes, hay un defecto en las transiciones, aunque el gráfico parezca verosímil. Es preferible detener la ejecución y localizar el error antes que corregir silenciosamente los estados.
El tercer control es probabilístico. Para un modelo pequeño, podemos construir la matriz generadora , calcular y comparar sus probabilidades con frecuencias simuladas. Una comparación puntual puede pasar por azar; conviene examinar varios tiempos y diferentes estados iniciales. También son útiles soluciones conocidas, como la distribución binomial del proceso de muerte pura, los tiempos exponenciales de permanencia y las probabilidades de elección de canales en un estado fijo.
El cuarto control consiste en separar fallos de simulación de fallos estadísticos. Un promedio de Monte Carlo no tiene por qué coincidir exactamente con una fórmula cerrada, de modo que la comparación debe incorporar un error estándar o intervalos razonables. A la inversa, una discrepancia persistente al aumentar , especialmente si supera repetidamente el error de muestreo, obliga a revisar la programación o los supuestos. Una semilla fija facilita la reproducción de errores, aunque la validación debería repetirse también con semillas distintas.
El quinto control atañe a los horizontes temporales. En una simulación truncada en , cualquier trayectoria que no haya alcanzado un evento objetivo debe identificarse como censurada en ese horizonte. Registrar como si fuera el tiempo exacto del evento sesga las estimaciones de tiempo hasta llegada. Tampoco debemos descartar sin anotación las trayectorias largas porque agotaron un límite arbitrario de iteraciones. Si hay posibilidad de explosión de eventos o de un tiempo de cálculo descontrolado, el programa debe registrar la interrupción para que no se confunda con una absorción legítima.
Finalmente está la validación científica. Un algoritmo puede aprobar todas las pruebas anteriores y seguir siendo un modelo pobre para un fenómeno real. Las tasas deducidas de una mezcla homogénea pueden fracasar cuando la interacción ocurre sobre una red de contactos. Una aproximación markoviana puede necesitar más variables de estado para representar memoria. Una tasa constante puede cambiar durante el día. La auditoría computacional es necesaria para establecer que implementamos las ecuaciones pretendidas; la adecuación de esas ecuaciones a los datos exige argumentos distintos.
128.7. Coste computacional y alcance de la simulación
El coste del algoritmo directo crece con el número de eventos simulados. Si un sistema experimenta millones de reacciones por segundo y nuestro interés está en una escala temporal de horas, registrar todos los saltos puede ser innecesario o impracticable. Hay métodos exactos que actualizan selectivamente los relojes o usan estructuras eficientes para buscar el próximo canal; también hay métodos aproximados que intercambian precisión por velocidad. Las diferencias entre ellos no deben ocultarse bajo la palabra genérica «simulación estocástica».
El método denominado tau-leaping, introducido por Gillespie para acelerar ciertos procesos de reacción, elige un intervalo durante el cual supone que las propensiones varían poco. Aproxima entonces el número de ocurrencias del canal en ese intervalo mediante
con variables independientes condicionadas al estado inicial de ese paso bajo la formulación elemental. El estado se actualiza mediante . Esta aproximación puede saltar sobre muchos acontecimientos y ahorrar tiempo de cálculo. Su validez depende de que sea suficientemente pequeño para que las propensiones no cambien de forma importante durante el intervalo y de que no se violen las restricciones del sistema.
Los conteos negativos son un problema concreto, porque una aproximación de Poisson puede seleccionar más reacciones consumidoras que moléculas disponibles. Hay variantes con control de paso, tratamiento especial de canales críticos y distribuciones binomiales que buscan preservar las restricciones. Truncar en cero de forma improvisada puede introducir sesgos difíciles de cuantificar. El tamaño de paso debe evaluarse frente a cantidades relevantes del problema, incluidos los riesgos de llegada a fronteras absorbentes.
Otra aproximación consiste en reemplazar el modelo de saltos por ecuaciones diferenciales deterministas cuando los conteos son muy grandes. Entre ambos extremos se encuentran las aproximaciones por difusión, que incorporan ruido continuo y se estudiarán en el siguiente módulo. Esas ecuaciones pueden capturar fluctuaciones alrededor de un régimen macroscópico sin reproducir necesariamente bien la probabilidad de extinción de una población escasa. El límite continuo requiere condiciones de escala y no se obtiene añadiendo un término de ruido arbitrario a cualquier ecuación conocida.
En modelos híbridos, algunos canales rápidos se aproximan mediante dinámicas continuas mientras otros canales raros conservan saltos individuales. La elección obliga a decidir cuál es el umbral entre rápido y lento, cuándo debe cambiar el tratamiento y cómo se garantizan la conservación y la no negatividad. Para una aplicación científica, esos criterios deben declararse y comprobarse en casos donde también sea posible ejecutar el método directo. La aceleración tiene sentido cuando se cuantifica el error que introduce respecto de los observables que interesan.
La elección del simulador depende, por tanto, del tamaño del sistema y de la pregunta formulada. Para estudiar una reacción rara que desencadena una transición decisiva puede ser fundamental preservar el evento individual. Para estimar una concentración macroscópica a lo largo de una trayectoria típica quizá sea suficiente una aproximación determinista. No hay un algoritmo superior en todos los regímenes; corresponde usar el más económico que conserve las propiedades necesarias para la inferencia o la decisión.
El algoritmo de Gillespie conecta las ecuaciones maestras con trayectorias individuales mediante una regla probabilística explícita. En cada estado, las propensiones determinan la tasa total del siguiente salto y la distribución de sus posibles canales. Un número aleatorio transforma esa tasa en una espera exponencial; otro selecciona la transición. La repetición de este procedimiento produce realizaciones de la cadena de Markov que hemos especificado. Su principal fortaleza es evitar un error de discretización temporal en los acontecimientos de salto del modelo homogéneo.
Las trayectorias dan una clase de información distinta de la solución de una ecuación para la media. Dos sistemas pueden compartir una tasa promedio de crecimiento y diferir en la probabilidad de desaparición. En epidemias incipientes, algunas realizaciones terminan pronto y otras crecen lo suficiente para alcanzar estados macroscópicos. En sistemas químicos pequeños, las fluctuaciones pueden producir resultados que no serían visibles al resolver únicamente ecuaciones de concentración continua. La simulación permite estudiar estas distribuciones, pero no sustituye la tarea de justificar las tasas.
El banco de pruebas de muerte pura mostró cómo verificar estadísticas conocidas antes de abordar un mecanismo más amplio. La aplicación SIR exigió declarar canales, estados e invariantes. Su código es reproducible y puede ampliarse a otras reglas; sus parámetros, en cambio, son ilustrativos y no permiten describir una población específica ni sacar conclusiones sanitarias. Para pasar a una investigación empírica sería necesario estimar parámetros a partir de datos pertinentes, estudiar la identificabilidad, incorporar la incertidumbre sobre esas estimaciones y comprobar la adecuación del mecanismo de transmisión.
El método directo obtiene, a partir del estado actual, una espera exponencial cuya tasa es la suma de las propensiones y un destino elegido proporcionalmente a la propensión de cada canal. Al repetir esa operación se simula el proceso de saltos definido por el modelo. En el experimento de desaparición independiente, la distribución binomial conocida sirve para contrastar resultados; en el sistema SIR se comprueban además los invariantes del estado.
La exactitud del método se refiere a la ley del proceso de saltos especificado, salvo límites computacionales de precisión. No garantiza que las propensiones representen un mecanismo biológico real. Si se aproxima mediante saltos múltiples por intervalo, cambia también el problema numérico; hay que controlar los estados imposibles, los saltos críticos y los errores introducidos por congelar tasas durante el paso.
Referencias
- Anderson, D. F., y Kurtz, T. G. (2015). Stochastic Analysis of Biochemical Systems. Springer. Representación de procesos de reacción mediante saltos e intensidades.
- Gillespie, D. T. (1976). A general method for numerically simulating the stochastic time evolution of coupled chemical reactions. Journal of Computational Physics, 22(4), 403–434. https://doi.org/10.1016/0021-9991(76)90041-3
- Gillespie, D. T. (1977). Exact stochastic simulation of coupled chemical reactions. The Journal of Physical Chemistry, 81(25), 2340–2361. https://doi.org/10.1021/j100540a008
- Gillespie, D. T. (2001). Approximate accelerated stochastic simulation of chemically reacting systems. The Journal of Chemical Physics, 115(4), 1716–1733. https://doi.org/10.1063/1.1378322
- Higham, D. J. (2008). Modeling and simulating chemical reactions. SIAM Review, 50(2), 347–368. https://doi.org/10.1137/060666457
- van Kampen, N. G. (2007). Stochastic Processes in Physics and Chemistry (3.ª ed.). Elsevier. Ecuaciones maestras y aproximaciones de gran escala.