Año 2 · Módulo 13
122.1. Definir el estado y formular una cadena de Markov
La congestión de un servicio depende, en parte, de su estado actual. Un servicio saturado tiende a permanecer congestionado durante más tiempo que uno con baja ocupación. Para representar este comportamiento mediante una cadena de Markov es necesario elegir estados que retengan la información predictiva pertinente. La hipótesis esencial trata de las probabilidades futuras condicionadas al estado presente; su plausibilidad depende de cómo se haya construido esa variable de estado.
Andréi Márkov, matemático ruso de comienzos del siglo XX, desarrolló el estudio de secuencias de variables dependientes mediante reglas de transición. Su trabajo mostró que calcular probabilidades no exige que las observaciones sean independientes. Una serie puede mostrar persistencia, alternancia o agrupamiento de estados y continuar admitiendo una estructura probabilística manejable.
Consideremos una máquina que puede estar funcionando, detenida por mantenimiento o averiada. Al finalizar cada día anotamos su condición. Una forma elemental de modelar el proceso es asignar, para cada estado actual, las probabilidades de encontrarse al día siguiente en cada uno de los estados posibles. La probabilidad de avería puede ser diferente si hoy funciona o si ya está averiada. En ambos casos se supone que el estado presente resume la información del pasado necesaria para determinar la ley del próximo estado.
La palabra «estado» hace casi todo el trabajo conceptual. Si el riesgo de avería depende de cuántos días lleva operando la máquina, la simple etiqueta «funcionando» probablemente sea insuficiente. Podríamos incorporar al estado la antigüedad o el tiempo transcurrido desde el último mantenimiento. En el espacio de estados así ampliado, un modelo que parecía tener memoria larga al observar una sola variable puede ser markoviano.
La unidad temporal debe definirse explícitamente, porque el estado puede registrarse por días, por turnos o después de cada operación. Las probabilidades de transición obtenidas para una de esas escalas no se trasladan automáticamente a otra. Si una matriz describe un paso diario, la predicción de dos días usa su cuadrado; para interpretar transiciones en instantes arbitrarios habrá que especificar tasas por unidad de tiempo. En este capítulo los estados y los pasos son discretos y el espacio es finito.
122.2. La propiedad de Markov y la matriz de transición
Sea una sucesión de variables aleatorias que toma valores en un conjunto de estados . La propiedad de Markov exige que, siempre que el evento condicionado tenga probabilidad positiva,
El historial puede haber influido en el estado actual. La igualdad afirma que, una vez conocido el presente, el historial no añade información sobre el siguiente estado. En particular, la igualdad no implica independencia temporal; en una cadena que conserva con alta probabilidad el estado precedente, dos observaciones consecutivas estarán correlacionadas.
Si las probabilidades condicionales no dependen explícitamente de , la cadena es homogénea en el tiempo. Escribimos
para . En un espacio finito , reunimos esos números en una matriz
Adoptaremos la convención por filas, en la que la fila contiene las probabilidades de destino cuando el estado de origen es . Cada entrada debe satisfacer y cada fila debe cumplir
Una matriz con estas propiedades se llama estocástica por filas. Algunos libros usan vectores columna y matrices estocásticas por columnas. Las fórmulas son equivalentes tras transponer de manera coherente, pero mezclarlas ocasiona errores que pueden pasar inadvertidos si solo se revisa que las probabilidades sumen uno.
Una matriz de transición describe una regla probabilística; el camino que sigue el sistema es una realización de esa regla. Si , cada visita al estado 1 implica una probabilidad condicional del 30 % de pasar al estado 2 en el próximo paso. Una simulación puede hacer diez transiciones desde 1 sin observar ese cambio, o producirlo repetidamente. Una trayectoria finita solo da datos para estimar el parámetro.
La cadena queda especificada en cuanto a su ley de dimensión finita cuando conocemos la matriz de transición y la distribución inicial . Esta distribución determina qué estados son probables al comienzo y modifica las predicciones de corto plazo, aunque con el tiempo algunas cadenas pierdan sensibilidad a ese reparto inicial.
122.3. Un modelo de dos estados, calculado sin simulaciones
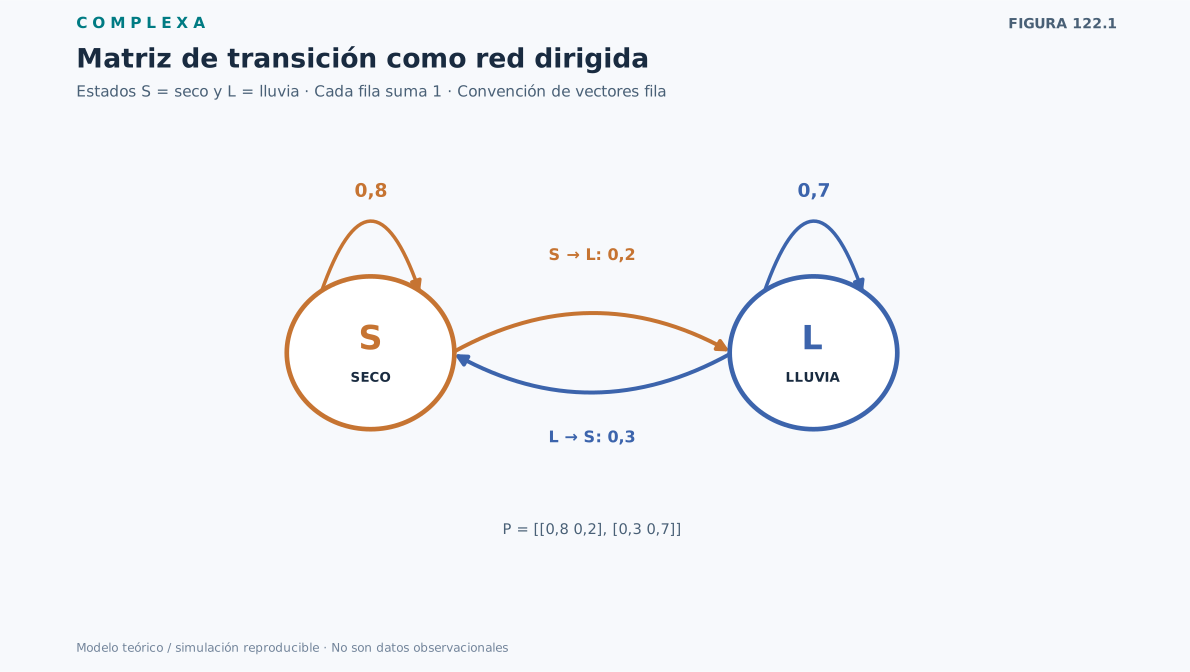
Imaginemos que una estación meteorológica clasifica cada día según una condición simplificada: S si se mantiene seco y L si registra lluvia. El modelo es una simplificación para estudiar transiciones. Supongamos que las probabilidades de mañana dependen solamente de la categoría de hoy y que permanecen constantes durante el período estudiado, con matriz
La primera fila dice que después de un día seco hay probabilidad de otro día seco y de lluvia. La segunda indica que después de lluvia hay probabilidad de pasar a seco y de seguir con lluvia. La suma de cada fila es uno. La matriz es válida; si es empíricamente adecuada sigue siendo una cuestión distinta.
Representemos la distribución en el día mediante el vector fila
La ley de probabilidad total conduce a
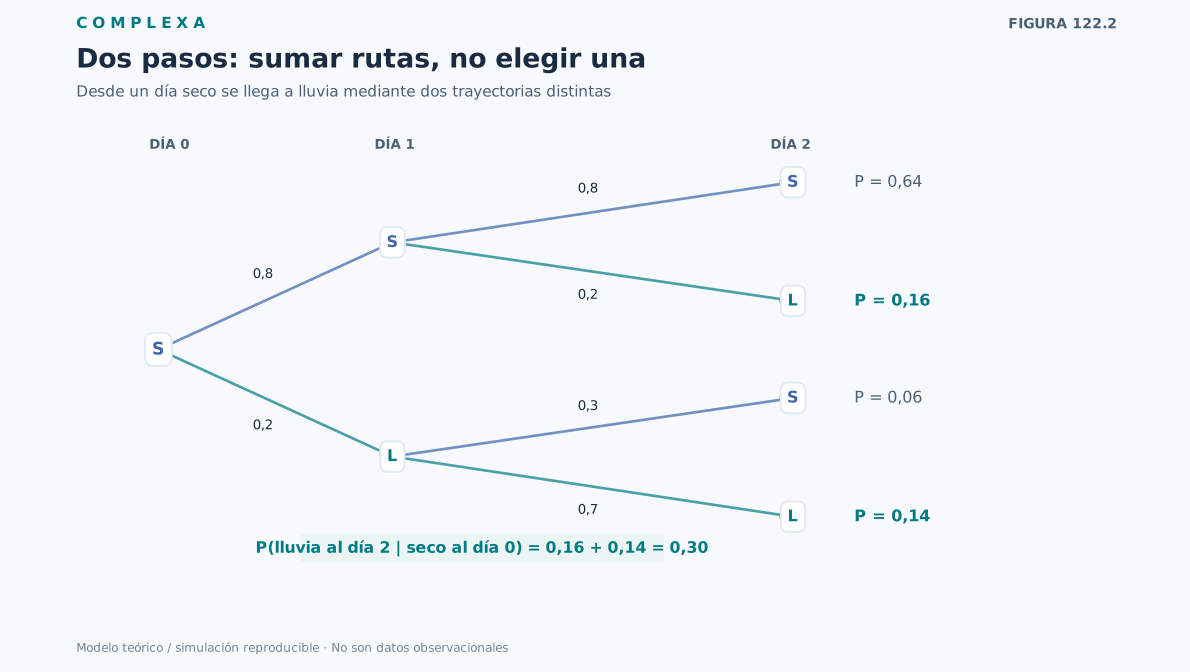
Si el día inicial es seco con certeza, . Para mañana obtenemos . Pasado mañana, debemos sumar los caminos que desembocan en cada estado. La probabilidad de lluvia dos días después es
La probabilidad de volver a seco es . Por tanto,
La entrada de suma dos trayectos de longitud dos, seco-seco-lluvia y seco-lluvia-lluvia. Este cálculo muestra cómo la matriz organiza las probabilidades de múltiples caminos sin seleccionar uno de ellos. Tras tres días, la probabilidad de lluvia, partiendo de seco, pasa a . No hay contradicción con la trayectoria simulada, que en cada día presenta un único estado concreto.
El modelo muestra también por qué persistencia y ausencia de memoria adicional pueden coexistir. La probabilidad de lluvia mañana difiere entre y según el estado presente. Hay dependencia temporal. Sin embargo, si la propiedad de Markov es correcta, saber cómo estaba el tiempo hace una semana no modifica esas cifras una vez conocida la categoría de hoy.
122.4. Probabilidades a varios pasos y la ecuación de Chapman–Kolmogorov
Para cualquier cadena homogénea finita, la matriz contiene las probabilidades de transición después de pasos,
Las potencias de son productos matriciales, en los que se suman todos los estados intermedios posibles; elevar cada entrada por separado da otra cosa. Si definimos
la identidad de Chapman–Kolmogorov establece
La demostración divide un recorrido de pasos según el estado alcanzado después de pasos. La propiedad de Markov permite escribir la transición restante como una probabilidad que depende únicamente de ese estado intermedio. En forma matricial, la identidad es . De allí procede la fórmula
Volvamos al modelo meteorológico. Sea . Condicionando por el estado presente, la probabilidad de lluvia al día siguiente es
Esta ecuación es un mapa afín determinista para la probabilidad, mientras el clima simulado salta aleatoriamente entre S y L. Resolvemos el punto fijo y obtenemos . Restando ese punto fijo de ambos lados,
Por iteración,
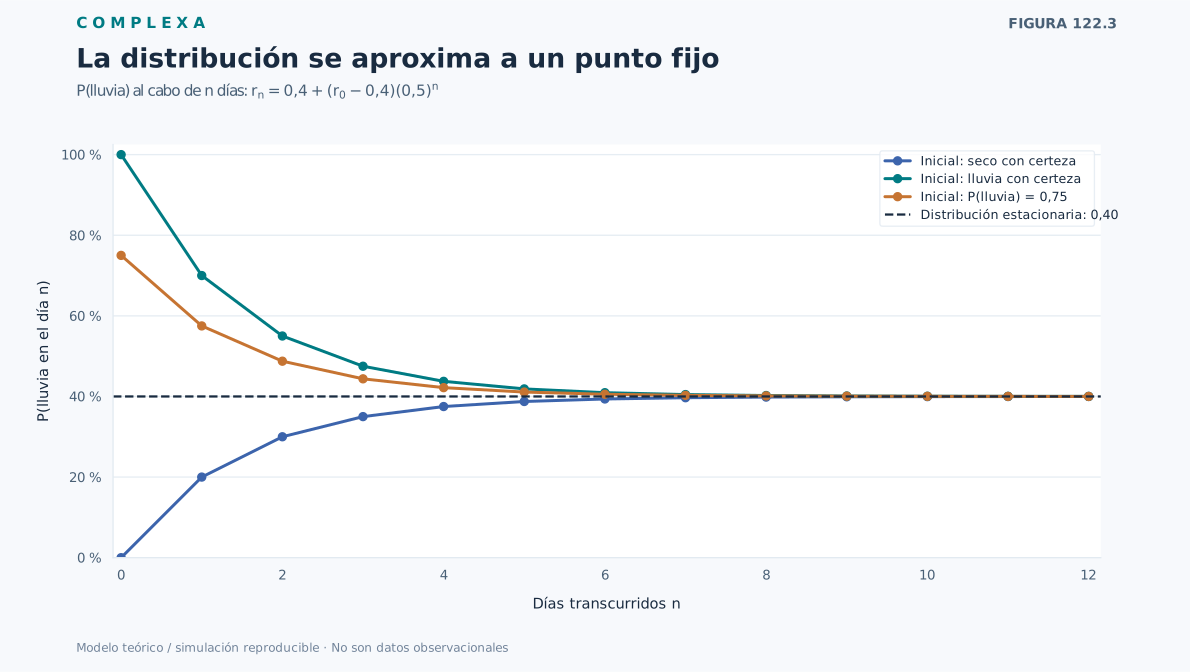
Si empezamos en seco, , por lo que . Tras un día, ; tras dos, ; tras tres, . El valor se acerca a . La convergencia aparece en este ejemplo porque la pendiente de la recurrencia tiene valor absoluto menor que uno. No todas las matrices de transición producen convergencia temporal desde cualquier distribución inicial; veremos contraejemplos cuando introduzcamos periodicidad.
Como evoluciona por una ecuación determinista, podemos calcular distribuciones futuras sin simular millares de trayectorias si conocemos . Cuando el número de estados es enorme, la multiplicación matricial directa puede resultar costosa; entonces la simulación vuelve a ser útil.
El álgebra lineal estudiada anteriormente permite interpretar este resultado con mayor generalidad. Como las filas de una matriz estocástica suman uno, el vector columna formado íntegramente por unos es un vector propio derecho con valor propio uno. Los valores propios de una matriz estocástica finita tienen módulo menor o igual que uno. El valor propio uno es consecuencia de la conservación de la probabilidad total; los restantes pueden describir modos de relajación u oscilación de las distribuciones, siempre que se tenga en cuenta la estructura de la matriz y su posible falta de diagonalización.
En nuestro modelo de dos estados los valores propios son y . El segundo aparece exactamente como factor en la solución de . Su potencia explica cómo se atenúa la diferencia entre dos distribuciones iniciales a medida que avanzan los pasos. En una cadena de múltiples estados pueden coexistir modos con velocidades distintas; algunos desaparecen en pocos pasos, mientras que otros persisten mucho tiempo. Un valor propio cercano a uno puede indicar relajación lenta; uno cercano a menos uno puede acompañarse de alternancia prolongada.
Esta interpretación debe hacerse con cuidado. Una matriz reducible o periódica puede poseer varios comportamientos invariantes o modos que no decaen. Además, valores propios aislados no describen por completo la respuesta transitoria de una matriz no normal. Para afirmar convergencia desde cualquier distribución inicial hacen falta condiciones estructurales, que un cálculo numérico aparentemente estabilizado no garantiza. Las propiedades precisas de esas condiciones, incluida la diferencia entre invariancia y convergencia, serán el tema de C123.
122.5. Probabilidades de secuencias e inferencia de transiciones
La ley de una cadena contiene más que distribuciones de estados aislados. Para una secuencia de estados , la regla de multiplicación de probabilidades condicionales y la propiedad de Markov dan
Cada factor corresponde a una transición observada. Esta expresión permite calcular probabilidades de episodios específicos y también construir una función de verosimilitud para estimar los elementos de a partir de una trayectoria. Si contamos cuántas veces observamos una transición desde hacia , obtenemos . Sea el número de salidas observadas desde . La estimación de máxima verosimilitud para la transición es
cuando la cadena es homogénea, se observan todos los estados sin error y se maximiza respecto de cada fila bajo la restricción de sumar uno. La expresión parece una proporción elemental, pero su justificación procede de la estructura de verosimilitud condicional de la cadena. Que las transiciones consecutivas sean dependientes no impide esta estimación, aunque exige cuidado al calcular su incertidumbre y evaluar la representatividad de la trayectoria.
Supongamos que desde el estado seco observamos ochenta salidas, de las cuales sesenta y cuatro terminan en seco y dieciséis en lluvia. La fila estimada es . Si desde lluvia registramos cincuenta salidas, quince hacia seco y treinta y cinco hacia lluvia, obtenemos . Los recuentos reproducen nuestra matriz de ejemplo. Ahora bien, una transición no observada en una muestra limitada recibirá estimación cero, aunque su probabilidad verdadera pueda ser pequeña pero positiva. También hay estados que quizá no se visiten durante el registro, por lo que no existe estimación directa de sus filas.
Cuando faltan observaciones intermedias, la inferencia cambia. Si sabemos que el sistema estaba en y lo observamos en tres pasos después, ese par informa sobre la entrada y solo indirectamente sobre . Tratarlo como una transición de un solo paso altera la escala temporal del modelo. Si las mediciones se obtienen a intervalos diferentes, cada separación debe intervenir en la verosimilitud con la potencia correspondiente de . Asimismo, un error de clasificación del estado puede producir transiciones aparentes que nunca ocurrieron. La estimación ingenua mediante cocientes de frecuencias solo conserva su justificación bajo observación completa, clasificación correcta e intervalos compatibles con la unidad temporal declarada. Estos detalles distinguen una matriz descriptiva de una estimación que puede sostener decisiones sobre el futuro.
La elección del período de análisis plantea otra dificultad. Si la dinámica cambia entre estaciones, turnos o fases del proceso, una sola matriz ajustada a todos los datos puede esconder transiciones dependientes del tiempo. Hay que comprobar si la suposición de homogeneidad es razonable y si los estados observados permiten calcular probabilidades condicionales estables. Un ajuste aparente a frecuencias globales no garantiza que la matriz prediga secuencias o tiempos de permanencia con precisión.
122.6. Persistencia, correlación y tiempo característico
En una cadena de dos estados se pueden relacionar directamente los parámetros de transición con la persistencia temporal. Escribamos una matriz general para los estados y ,
El parámetro es la probabilidad de entrar en el estado 1 desde 0; es la probabilidad de abandonarlo. Si , la distribución satisface . En C123 estudiaremos por qué esta igualdad se llama estacionariedad y qué hipótesis permiten interpretar un límite temporal mediante ella. Por ahora nos sirve como distribución inicial que mantiene constantes las probabilidades marginales.
La evolución de obedece
El factor controla la rapidez y el signo de la relajación de las probabilidades. Si , la desviación respecto de la distribución estacionaria disminuye geométricamente sin alternar de signo. Si , esa desviación alterna de signo mientras se amortigua. Los casos o merecen atención porque pueden impedir el olvido de la condición inicial.
En el modelo de días secos y lluviosos, , y . Si la cadena comienza en la distribución estacionaria y definimos para lluvia, cero para seco, encontramos
Como la varianza de vale , la correlación a retardo es . Esta medida describe dependencia del modelo; no debe equipararse automáticamente con una duración física de memoria si el intervalo de muestreo cambia o si el mecanismo real posee variables ocultas.
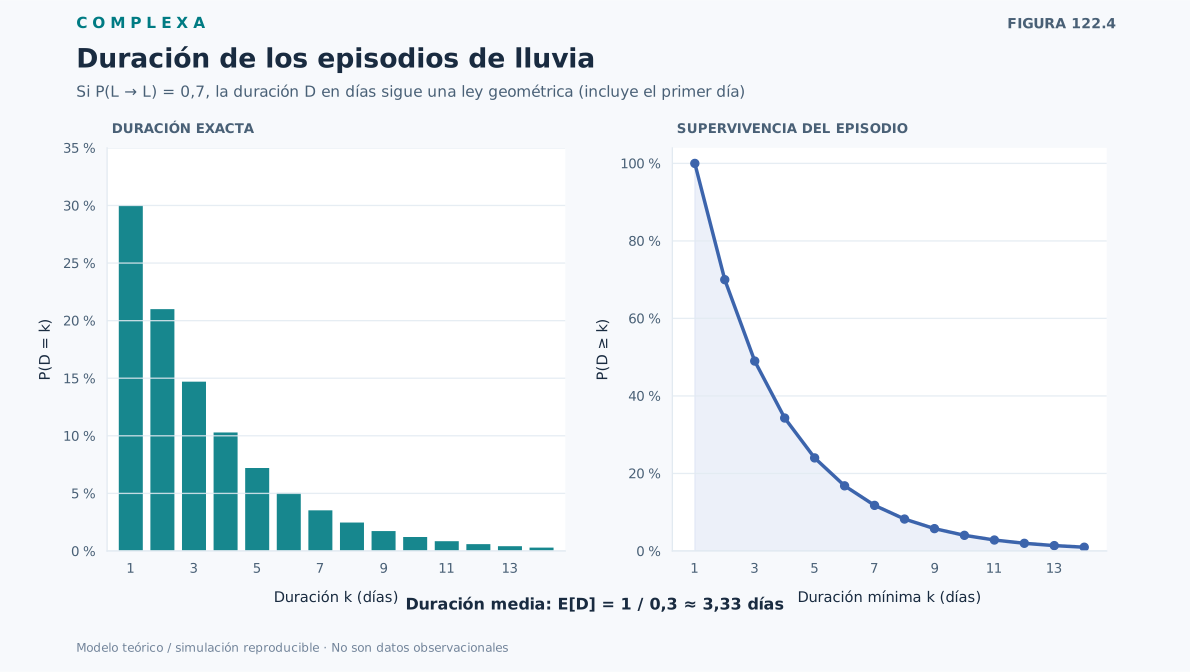
Otra medida útil es la longitud de un episodio. Si hoy llueve, la probabilidad de seguir con lluvia mañana es . Bajo la propiedad de Markov, la probabilidad de que un episodio lluvioso iniciado hoy dure al menos días, contando el primero, es . Su duración esperada es , aproximadamente días. Esta regla geométrica exige que la probabilidad de abandonar el estado no dependa de cuánto tiempo llevemos allí. Si la duración transcurrida altera la probabilidad de salida, una cadena que observa solamente «lluvia» y «seco» resulta insuficiente. Comparar la distribución observada de episodios con la geométrica es, así, una comprobación empírica de la representación elegida.
122.7. Clases de estados, periodicidad y memoria
La matriz de transición también puede interpretarse como una red dirigida. Los estados son nodos y existe una arista de a cuando . La magnitud de la entrada es una probabilidad condicional; no debe leerse como distancia física ni como intensidad causal demostrada. Esta perspectiva permite estudiar qué estados se pueden alcanzar y qué partes del sistema permanecen separadas.
Decimos que el estado es accesible desde si existe algún número tal que . Dos estados se comunican si cada uno es accesible desde el otro. La relación de comunicación separa el espacio en clases. Una cadena es irreducible cuando todos sus estados pertenecen a una misma clase de comunicación. En tal caso, desde cualquier estado se puede llegar eventualmente a cualquier otro con probabilidad positiva, aunque el número de pasos y la probabilidad concreta puedan variar mucho.
Un estado es absorbente si . Una vez ingresado, el sistema permanece allí para siempre. El estado de extinción irreversible de una población, dentro de un modelo sin inmigración ni recolonización, suele construirse de esta forma. Una clase de comunicación es cerrada cuando, una vez que se entra en ella, no hay transiciones hacia estados exteriores; puede tener más de un estado. La presencia de clases cerradas diferentes puede impedir que todas las condiciones iniciales compartan un mismo comportamiento a largo plazo.
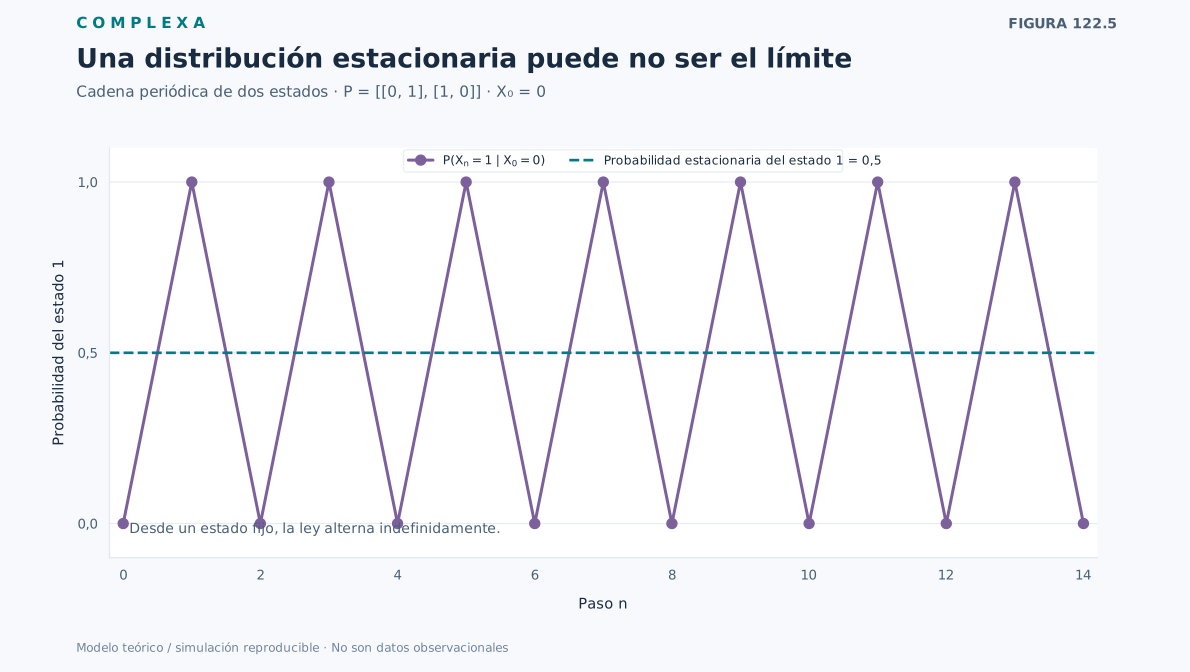
La periodicidad introduce una dificultad menos evidente. Consideremos
La cadena alterna necesariamente entre sus dos estados. Es irreducible, porque cada estado puede alcanzarse desde el otro. Sin embargo, comenzando en el primero, la distribución será en tiempos pares y en tiempos impares. No converge a una distribución límite conforme aumenta. Aun así, es una distribución estacionaria porque permanece inalterada al multiplicarla por .
El período de un estado se define como el máximo común divisor de los tiempos positivos en que existe probabilidad de regresar a él. En el ejemplo de alternancia, los retornos solo ocurren en tiempos pares y el período es dos. Cuando ese máximo común divisor es uno, el estado es aperiódico. Todos los estados comunicantes tienen el mismo período. Para una cadena finita irreducible y aperiódica, las distribuciones desde cualquier estado inicial convergen a la distribución estacionaria única. Cada adjetivo cumple una función; eliminarlos produciría afirmaciones incorrectas sobre cadenas como la de alternancia.
Estas propiedades también ilustran la diferencia entre observar una serie y caracterizar un mecanismo. Una trayectoria corta puede alternar por casualidad bajo una matriz que permite permanecer en el mismo estado. La periodicidad matemática requiere examinar cuáles transiciones tienen probabilidad positiva y qué retornos permite la estructura completa.
La propiedad de Markov depende de cómo definimos el estado y de qué observamos. Supongamos un proceso de dos símbolos en que la probabilidad del próximo símbolo depende de los dos últimos. La secuencia no sería, en general, una cadena de Markov de primer orden si solo conservamos . Podemos construir un estado ampliado . El próximo estado será y su distribución condicional podrá depender únicamente de . Bajo una regla homogénea de segundo orden, sí es una cadena de Markov de primer orden.
El procedimiento no siempre resulta tan sencillo. Si el número de pasos transcurridos desde la entrada a un estado modifica la probabilidad de salida, puede ser necesario añadir la edad del episodio como componente del estado. Si existe un entorno oculto que afecta las probabilidades de transición, el proceso conjunto formado por estado observado y entorno puede ser markoviano, mientras que la serie observada aislada puede no serlo.
Consideremos una unidad hospitalaria en la que solo registramos si hay camas libres. El estado binario «libres/ocupadas» quizá parezca suficiente, pero el número de pacientes próximos al alta, las duraciones de estancia y las llegadas previstas pueden alterar la probabilidad de ocupación del día siguiente. Dos días con idéntico indicador binario pueden comportarse de manera diferente si esas variables latentes son distintas. Incorporarlas mejora la representación a costa de ampliar el espacio de estados y exigir nuevos datos. Basta conservar la información que necesita la pregunta de predicción.
Hay dos operaciones temporales que conviene separar. Si observamos una cadena homogénea cada pasos, la secuencia sigue siendo markoviana, con matriz . En cambio, si agrupamos varios estados distintos bajo una misma etiqueta observable, el proceso agregado no tiene por qué ser markoviano. En ciertos casos lo será, si las probabilidades totales de transición hacia cada grupo son iguales para todos los estados que pertenecen al mismo grupo. Esta es la condición de agregabilidad o lumpability de las cadenas.
Podemos mostrar el riesgo de agrupar estados mediante una cadena de tres estados . Supongamos que conduce siempre a , conduce siempre a y conduce siempre a . Su matriz es
Es una cadena de Markov bien definida, en la que el estado actual fija el siguiente. Ahora supongamos que un instrumento distingue solo dos etiquetas, y . Si ayer observamos y hoy , sabemos que el estado actual es ; mañana aparecerá . Si ayer observamos y hoy volvemos a observar , el estado actual es , siempre que la cadena no haya sido observada únicamente en el instante inicial; mañana seguirá siendo . Por tanto, dentro del modelo, la probabilidad de mañana difiere según la etiqueta de ayer, aun cuando hoy observemos la misma . El proceso de etiquetas pierde la propiedad de Markov de primer orden.
El ejemplo muestra un error frecuente, que es suponer que, si una dinámica microscópica es markoviana, también lo es cualquier variable macroscópica derivada de ella. La elección de categorías debe preservar las probabilidades relevantes si pretendemos seguir trabajando con una cadena de primer orden sobre los estados agregados. La alternativa es conservar memoria adicional o usar un modelo de observación parcial.
La propiedad de Markov es una simplificación condicional que puede ser comprobable, útil o inadecuada según el fenómeno. Expresa que la historia pertinente para la predicción futura está representada en el estado elegido, aunque el sistema tenga una historia física más larga. Una formulación aplicada puede fallar precisamente porque la variable que parecía resumir la situación omite información que continúa actuando sobre las transiciones.
122.8. Simular una cadena y comprobar lo que realmente se está calculando
Una cadena de Markov puede analizarse de dos formas complementarias. Mediante operaciones matriciales obtenemos distribuciones y probabilidades exactas, dentro de la aritmética del modelo. Mediante simulación generamos trayectorias individuales seleccionando el próximo estado según la fila correspondiente de . Las simulaciones deben reproducir, en conjunto, las predicciones analíticas dentro de una variación compatible con el tamaño de la muestra.
Elegimos a partir de la distribución inicial. En cada paso identificamos la fila de la matriz correspondiente al estado actual, extraemos aleatoriamente el siguiente estado de esa distribución y lo registramos. Repetimos hasta construir la longitud temporal deseada. Una sola secuencia puede parecer atípica sin que el programa contenga un error, porque la ley admite realizaciones con distinta estructura. Para verificar la implementación conviene generar numerosas trayectorias independientes, fijar la semilla cuando sea necesario reproducir un resultado y comparar frecuencias con probabilidades conocidas.
El siguiente programa de Python usa una semilla explícita. Genera cien mil trayectorias de dos pasos, todas inicialmente secas, y contrasta el estado final con la distribución predicha para el segundo día mediante la primera fila de calculada antes.
import numpy as np

P = np.array([[0.8, 0.2], [0.3, 0.7]])
rng = np.random.default_rng(2026)
N = 100_000
estados = np.zeros(N, dtype=int)

for paso in range(2):
    u = rng.random(N)
    prob_lluvia = P[estados, 1]
    estados = (u < prob_lluvia).astype(int)

empirica = np.bincount(estados, minlength=2) / N
teorica = np.array([1.0, 0.0]) @ np.linalg.matrix_power(P, 2)

print("Frecuencia simulada:", empirica)
print("Probabilidad teórica:", teorica)
La probabilidad teórica impresa será ; la frecuencia simulada deberá encontrarse cerca de esos valores, sin coincidir exactamente. Para el indicador de lluvia al segundo paso, la desviación estándar aproximada de la frecuencia sobre trayectorias independientes es , cercana a . La semilla asegura reproducibilidad de esta implementación, pero la realización obtenida sigue siendo una muestra aleatoria.
La verificación debe incluir condiciones estructurales. Todas las filas de han de sumar uno dentro de las tolerancias numéricas, las entradas deben ser no negativas y toda distribución calculada debe permanecer normalizada. Si hay estados imposibles, sus transiciones deben continuar con probabilidad cero. El generador aleatorio y el código deben separarse conceptualmente de las hipótesis científicas; un programa que reproduce exactamente una matriz equivocada continúa siendo una implementación correcta de un modelo inadecuado.
122.9. Aplicación y límites de una matriz de transición
Terminemos con un problema de gestión expresado en un espacio mínimo de estados. Un servicio registra diariamente dos categorías de ocupación, normal (N) y alta (A). Con valores ilustrativos, que no proceden de un establecimiento real, definimos
Si hoy la ocupación es normal, mañana será alta con probabilidad . Si hoy es alta, permanecerá alta con probabilidad . La probabilidad de ocupación alta dos días después de comenzar en situación normal se obtiene por los caminos N-N-A y N-A-A,
Sea . Entonces , cuyo punto fijo es . Si comenzamos en N, la solución es . El parámetro caracteriza el decaimiento de la influencia de la distribución inicial. Una sucesión de días con alta ocupación tiene probabilidad condicional de persistencia por paso. Su duración media, dentro de este modelo, es días, contando el primero. No sería correcto sustituir esta duración por la frecuencia media de días de alta ocupación, pues son propiedades diferentes de la dinámica.
Si iniciamos la cadena en su distribución estacionaria, la probabilidad de observar tres días consecutivos de ocupación alta vale , aproximadamente . Un modelo independiente con idéntica frecuencia marginal produciría , aproximadamente . Los dos predicen una proporción similar de días de ocupación elevada, pero difieren mucho en su frecuencia de rachas. Para un planificador interesado en episodios prolongados, la diferencia puede pesar más que la concordancia de las medias.
Nada de este cálculo establece que los episodios reales tengan duración geométrica o que la ocupación cambie homogéneamente entre días. Puede haber estacionalidad, variación de dotación, correlaciones con factores epidemiológicos o cambios operativos. El estado binario puede ser demasiado tosco para separar un aumento de llegadas de una disminución de egresos. Conviene contrastar las probabilidades de transición en diferentes períodos, comparar distribuciones de duración observadas con las geométricas previstas y examinar qué variables explican los errores más persistentes.
Lo mismo vale para el ejemplo meteorológico. Allí la segunda potencia permite predecir a dos días sin suponer independencia entre días consecutivos y la probabilidad de lluvia converge a 0,4 por el factor 0,5 de cada paso. Esa regularidad pertenece a la matriz adoptada; si las transiciones cambian por estación, o el estado registrado omite variables pertinentes, el cálculo seguirá siendo correcto para el modelo pero no necesariamente para los datos observados.
Antes de interpretar una cadena como mecanismo, conviene examinar cuánto tarda en cambiar su distribución, qué transiciones tienen escasas observaciones y si el historial cambia la predicción una vez conocido el estado actual. Tales comprobaciones distinguen una representación operativa útil de una hipótesis de memoria insuficiente.
Referencias
- Norris, J. R. (1997). Markov Chains. Cambridge University Press. Teoría de cadenas discretas y clasificación de estados.
- Kemeny, J. G., y Snell, J. L. (1960). Finite Markov Chains. Van Nostrand. Tratamiento clásico de cadenas finitas.
- Levin, D. A., Peres, Y., y Wilmer, E. L. (2017). Markov Chains and Mixing Times (2.ª ed.). American Mathematical Society. Convergencia y mezclado.
- Ross, S. M. (1996). Stochastic Processes (2.ª ed.). Wiley. Procesos de Markov y aplicaciones.