Una máquina puede funcionar de manera estable sin que su controlador conozca con precisión todos sus parámetros. También puede ocurrir lo contrario: una estimación cada vez más ajustada convive con acciones que producen transitorios inaceptables. Aprender y controlar comparten observaciones, pero sus resultados se evalúan con criterios diferentes. Para identificar interesa distinguir modelos; para regular interesa mantener determinadas variables cerca de una referencia. La realimentación conecta ambos problemas porque las acciones que reducen una desviación modifican los datos que estarán disponibles después.
Esta conexión aparece incluso cuando el sistema desconocido permanece constante. Adaptar un controlador no exige suponer que la planta cambia a cada instante. Puede significar revisar la acción a medida que se conoce un coeficiente fijo. Si el coeficiente cambia realmente, surge además un problema de seguimiento: los datos antiguos describen una dinámica que quizá ya no está vigente. La velocidad de ese cambio pasa a formar parte de las condiciones del diseño.
Conviene distinguir tres operaciones. La identificación actualiza una descripción del sistema a partir de observaciones y entradas conocidas. La adaptación modifica el controlador utilizando esa información, o ajusta directamente sus parámetros mediante una regla de error. La exploración elige acciones para producir información que una operación habitual proporcionaría con dificultad. Un algoritmo puede identificar sin adaptar todavía, adaptar aprovechando datos incidentales o incorporar una señal de exploración explícita. Estas decisiones tienen consecuencias distintas sobre el movimiento físico.
Los reguladores autoajustables de Åström y Wittenmark (1973) combinaron estimación por mínimos cuadrados y regulación de mínima varianza. Su análisis distinguía las propiedades del lazo cerrado de la identificación literal de los parámetros: algunos resultados suponían que las estimaciones convergían y caracterizaban entonces el controlador obtenido. Esa condición no equivale a una demostración universal de convergencia del estimador. Más adelante, Goodwin, Ramadge y Caines (1980) establecieron acotación de entradas y salidas y convergencia del error de seguimiento para una clase concreta de algoritmos y sistemas lineales deterministas en tiempo discreto. El alcance depende de la planta y de la actualización que se analizan conjuntamente.
Una actualización que ocurre después de actuar
Consideremos un ejemplo didáctico construido, sin datos observados ni interpretación clínica. El estado y la entrada están expresados en unidades normalizadas. Cada paso corresponde al mismo intervalo de operación y el sistema evoluciona según
El estado escalar es observable exactamente; la entrada aplicada es conocida; la ganancia que multiplica esa entrada vale uno. El coeficiente constante desconocido pertenece al intervalo conocido . La perturbación aditiva es . Primero estudiaremos el caso sin perturbaciones. La tarea de regulación consiste en llevar el estado hacia cero, sin imponer aquí una función de coste óptimo.
Al comienzo del paso se dispone del estado actual y de una estimación . La entrada elegida será
donde es una señal de exploración especificada por separado. Si el coeficiente estimado coincidiera con el verdadero y no hubiera perturbaciones, esta acción cancelaría el término dependiente del estado. Con exploración nula, el siguiente estado sería cero. Utilizar el modelo estimado como si fuera exacto al calcular esa cancelación es una forma sencilla de certeza equivalente.
Después de aplicar la entrada se observa el estado siguiente. Solo entonces se calcula el error de predicción y se actualiza la estimación:
La operación proyecta sobre el intervalo: conserva un valor interior y lleva un valor exterior al extremo más cercano. El cociente corresponde a una actualización de gradiente normalizada para el error de predicción cuadrático. El denominador modera el cambio cuando el estado tiene gran magnitud. Con nuestras unidades normalizadas y esta ganancia de actualización, la regla queda completamente definida; cambiar la escala de las variables exigiría reconsiderar su normalización.
El orden temporal evita una circularidad frecuente. La entrada del paso actual se obtiene con la estimación anterior a la nueva observación. El estado siguiente todavía no existe cuando se selecciona esa entrada. Una simulación que actualizara primero utilizando ese estado y después decidiera la acción del mismo paso concedería al controlador información futura. Su trayectoria no correspondería al algoritmo que puede ejecutarse.
Fijemos ahora el coeficiente verdadero en , la estimación inicial en y el estado inicial en uno. Sin exploración ni perturbaciones, la primera entrada es y el siguiente estado vale . La predicción era cero, por lo que el error de predicción vale también . La actualización aumenta la estimación en y la deja en uno. En el segundo paso la entrada es , el estado pasa a y la estimación alcanza , aproximadamente . El tercer estado es , aproximadamente .
La desviación física disminuye con rapidez. La estimación se mueve hacia el parámetro verdadero, aunque sus incrementos se hacen pequeños. La razón aparece en el numerador: el residuo se multiplica por el estado usado para identificar. Cuando ese estado apenas varía respecto de cero, la corrección del coeficiente también se debilita. Un error pequeño de predicción puede reflejar una descripción precisa o simplemente un experimento poco informativo.
Para estudiar el sistema completo hay que conservar tanto el estado físico como la estimación. Dos ejecuciones que se encuentren en el mismo estado pueden aplicar entradas diferentes si llegan con estimaciones distintas. La memoria del aprendizaje forma parte del estado del controlador. Al evaluar una trayectoria deben declararse las dos condiciones iniciales y cualquier memoria adicional del estimador; fijar únicamente el estado de la planta deja incompleto el experimento.
El error de predicción también tiene una interpretación diferente del error respecto de una referencia. En nuestro diseño, ambos coinciden cuando la exploración es cero porque la predicción del siguiente estado se cancela. Con exploración presente, el residuo compara lo observado con la predicción que incluye esa señal. Atribuir la desviación deliberadamente inducida a un error del modelo modificaría la actualización: el controlador intentaría aprender como dinámica desconocida una entrada que él mismo ha elegido y registrado.
Una garantía que no necesita esperar al aprendizaje
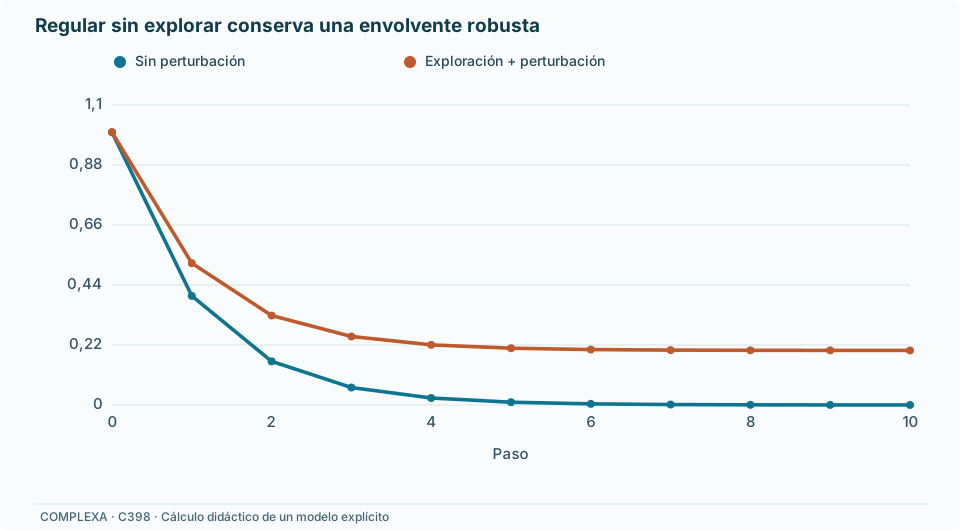
La proyección tiene una consecuencia verificable antes de demostrar convergencia del estimador. Puesto que el parámetro verdadero y la estimación pertenecen al mismo intervalo, su diferencia tiene magnitud máxima de . Al sustituir la acción en la planta se obtiene
La desigualdad vale para cualquier sucesión de estimaciones dentro del intervalo, incluso una que aprenda mal. Sin exploración ni perturbaciones, el estado disminuye al menos con la envolvente geométrica . La prueba de regulación utiliza un margen común de contracción, que permanece válido mientras cambia el controlador. El ajuste en línea no destruye ese margen bajo los supuestos declarados.
Si las magnitudes de exploración y perturbación están acotadas por y , respectivamente, la misma desigualdad, aplicada de forma sucesiva, proporciona
Por ejemplo, una exploración de magnitud máxima y una perturbación de magnitud máxima producen una cota asintótica de . La afirmación permite perturbaciones variables y dependientes de la trayectoria; no presupone independencia, media cero ni distribución normal. Por esa misma razón garantiza una región de operación, sin afirmar que el estado converja exactamente a cero.
Para cualquier estado inicial de magnitud máxima uno, esa envolvente mantiene la magnitud del estado por debajo de uno durante toda la operación. Entonces la entrada cumple . Si el actuador admite el intervalo , la acción calculada puede aplicarse sin saturación en este régimen. Esta comprobación enlaza el argumento matemático con una capacidad concreta del dispositivo. Imponer un límite menor y recortar la acción cambiaría la ecuación del lazo cerrado; la cota anterior dejaría de seguirse de la cancelación utilizada.
El intervalo previo tampoco funciona como una distribución de credibilidad. Proyectar una estimación solo impide que salga del conjunto elegido. La pertenencia del parámetro verdadero debe sostenerse mediante conocimiento del sistema u otro procedimiento justificado. Si ese conocimiento es erróneo, conservar las estimaciones dentro del intervalo puede obligar al controlador a permanecer en una familia inadecuada.
Este ejemplo incluye una comparación que evita atribuirle una ventaja inexistente. La realimentación fija ya estabiliza todos los coeficientes del intervalo: su factor de evolución tiene magnitud máxima de . Por tanto, aquí la adaptación no es necesaria para estabilizar, y nuestra cota de contracción adaptativa es incluso menos favorable. El interés del ejemplo consiste en distinguir garantías de regulación e identificación. Una ventaja de rendimiento requeriría definir costes, referencias y perturbaciones y compararlos bajo las mismas condiciones.
En sistemas de varias variables puede faltar una contracción común tan sencilla. Que cada controlador mantenga estable una planta cuando se congela su ganancia no demuestra automáticamente estabilidad cuando las ganancias cambian. Las transiciones entre ellas también forman parte de la dinámica. En nuestro escalar, el mismo valor absoluto sirve para todas las estimaciones admitidas, por lo que la desigualdad puede encadenarse sin imponer una velocidad mínima o máxima de adaptación.
Regular puede extinguir la corrección paramétrica
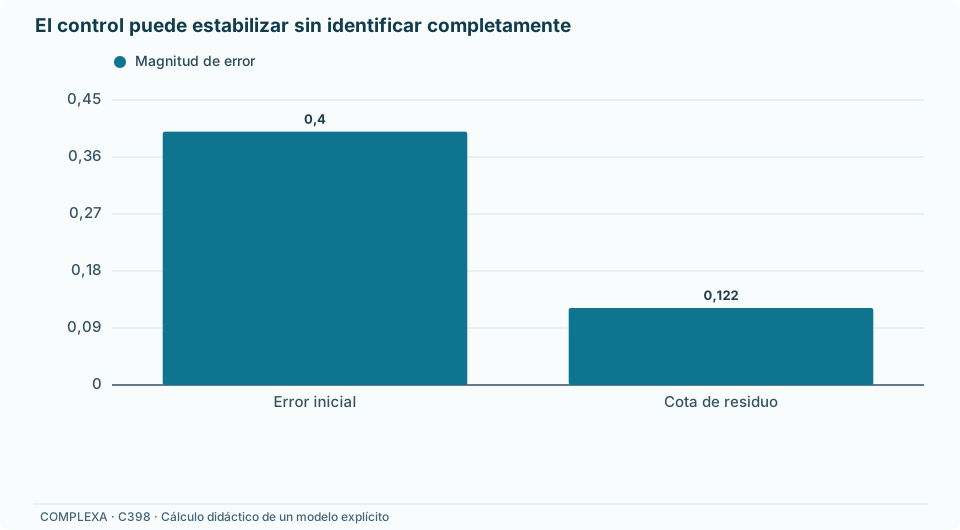
Denotemos el error de parámetro por . En ausencia de perturbación, el residuo es . Antes de proyectar, la actualización de la estimación es una combinación convexa de la estimación anterior y del parámetro verdadero. Ambos están dentro del intervalo, así que la proyección queda inactiva. Resulta la identidad
Cada observación con estado no nulo reduce la magnitud del error. Sin embargo, infinitas reducciones pueden dejar un resto positivo cuando los factores se aproximan demasiado deprisa a uno. Con exploración nula, la envolvente geométrica implica que la suma de los cuadrados de los estados no supera para nuestro estado inicial. El error restante es el error inicial dividido por el producto de los términos .
La desigualdad para valores no negativos permite acotar ese producto. En este ejemplo, el error límite satisface
La ejecución de la regla durante dos mil pasos deja la estimación aproximadamente en , con un error cercano a . El estado desaparece numéricamente por su disminución continuada; en la trayectoria matemática permanece positivo en cada paso finito. La cota analítica demuestra que el error paramétrico no desaparece y evita interpretar un redondeo computacional como un resultado asintótico.
Esta falta de convergencia pertenece a la actualización escogida. Con la ganancia de entrada conocida, sin ruido y con una observación exacta cuyo estado sea no nulo, el coeficiente puede recuperarse directamente mediante . Los primeros datos ya contienen información suficiente para identificarlo. El gradiente normalizado no aprovecha esa información de la misma forma que la resolución algebraica o un estimador que conserve y procese conjuntamente los datos.
La diferencia importa cuando se interpreta un fracaso de aprendizaje. Una familia de modelos puede ser identificable a partir del registro y, aun así, un algoritmo particular puede detener prácticamente sus correcciones. También puede ocurrir que numerosos algoritmos fallen porque los datos son compatibles con varios modelos. Antes de pedir más excitación conviene determinar cuál de esos dos problemas está presente.
Al introducir ruido, dividir por un estado pequeño amplifica el error de la observación. La facilidad algebraica del caso exacto pierde entonces parte de su utilidad práctica. Acumular datos puede reducir incertidumbre bajo un modelo estadístico adecuado, pero el número de muestras por sí solo no determina cuánta información contienen. Repetir mediciones casi idénticas de un estado cercano a cero puede añadir muy poca sensibilidad respecto del coeficiente buscado.
Mantener información tiene un coste dinámico
Una forma directa de sostener las correcciones consiste en añadir la señal alternante , manteniendo por ahora la perturbación nula. El primer estado pasa a y la primera estimación a uno. En el segundo paso el estado llega a cero y la estimación a . Ese cero aislado no detiene el aprendizaje: la siguiente entrada de exploración devuelve el estado a . La información depende de una ventana de observaciones, no de que cada muestra individual sea informativa.
La relación del lazo cerrado permite comprobarlo sin confiar únicamente en una simulación. Como la diferencia paramétrica no excede , la amplitud de exploración cumple . Al elevar y aplicar la desigualdad de Cauchy se obtiene
Toda ventana de dos estados conserva una cantidad positiva de excitación. Además, el producto es al menos uno más la suma de sus cuadrados. La identidad del error paramétrico demuestra entonces que su magnitud se contrae, por cada dos actualizaciones, por un factor no mayor que . Esta cota es conservadora, pero suficiente para demostrar convergencia del estimador en el caso sin ruido.
Después de dos mil pasos la estimación difiere del parámetro verdadero en aproximadamente . El estado tiene una magnitud cercana a . Cuando el término de cancelación se vuelve exacto, queda precisamente el efecto de la señal añadida: el estado siguiente reproduce la exploración. La mejora de identificación se ha conseguido manteniendo una oscilación física, de modo que no puede describirse a la vez como convergencia del estado al origen mientras la señal continúe.
Para un vector de parámetros, la excitación se expresa mediante los regresores que multiplican esos parámetros. Una condición habitual pide que la suma de sus productos exteriores, en cada ventana de cierta longitud, sea positiva en todas las direcciones paramétricas con un margen uniforme. Un regresor grande pero siempre orientado igual informa sobre una combinación de coeficientes y deja otras sin resolver. La magnitud de la señal y su diversidad cumplen funciones diferentes.
El trabajo de Anderson (1977) examinó condiciones de estabilidad exponencial para ecuaciones variables en el tiempo que aparecen en identificación adaptativa. Esa conexión obliga a estudiar la evolución del error del identificador, además de la evolución de la planta. La demostración escalar anterior se ha obtenido directamente para nuestra actualización discreta; no presupone que cualquier condición de un identificador continuo se transfiera sin cambios al algoritmo elegido.
Mantener la exploración indefinidamente no es la única política posible. Se puede utilizar durante una fase limitada y luego retirarla. En ese caso, la prueba de excitación uniforme deja de aplicarse después de la retirada. La regulación continúa protegida por el intervalo previo, pero una estimación que todavía conserva error puede volver a recibir correcciones cada vez menores. La duración del experimento debe relacionarse con la precisión que exige la decisión posterior, y esa precisión no se deduce únicamente del tamaño del estado.
La ejecución permite medir este efecto para dos calendarios. Si la señal se retira después de veinte pasos, la estimación está aproximadamente en ; tras continuar regulando, se aproxima a . Retirarla después de doscientos pasos deja una estimación cercana a , que después se aproxima a . En ambos casos el estado vuelve hacia cero. Las correcciones posteriores recuperan algo de información de la desviación restante, pero apenas cambian la precisión alcanzada durante la exploración. Estas cifras describen el algoritmo y los parámetros fijados, sin ruido.
También puede cuantificarse el coste de mantener la señal. Con amplitud y alternancia de signo, cuando la estimación converge el estado tiene amplitud y signo opuesto a la exploración del paso actual. La entrada de control alcanza entonces amplitud . Si se evalúa el coste por paso , con peso de entrada , su valor asintótico es . Para la amplitud utilizada resulta . Ese coste no desaparece al aprender el coeficiente.
Reducir a la mitad la amplitud divide por cuatro ese coste asintótico. También divide por cuatro la cota de excitación de una ventana: pasa de a , y el factor demostrado de contracción del error por pareja pasa a . Una señal más pequeña permite una demostración de aprendizaje más lenta. La amplitud elegida conecta así una precisión paramétrica, un tiempo de observación y un coste físico; ninguno de los tres puede evaluarse a partir de la trayectoria del estimador solamente.
Cuando la realimentación oculta dos parámetros
Modifiquemos ahora el problema de identificación: tanto el coeficiente de estado como la ganancia de entrada son desconocidos. La planta es , sin perturbaciones. Consideremos las dos posibilidades y . Si se usa siempre , ambas producen . Con estado inicial uno, las secuencias completas de estados y acciones coinciden.
En este caso existe una pérdida de identificabilidad en los datos generados por la política. Cada observación informa sobre la diferencia . El vector de regresores es y permanece sobre una misma recta. Acumular más observaciones bajo esa regla no permite decidir cuál de los dos pares produjo el registro, aunque la regulación sea perfecta a largo plazo.
Con las dos primeras filas de regresores, correspondientes a estados uno y , la matriz de información proporcional a la suma de productos exteriores es
Su determinante es cero. La dirección que aumenta ambos coeficientes por la misma cantidad permanece invisible. Esta es una limitación del experimento bajo esa realimentación, independiente del método utilizado para resolver el problema de estimación.
Una modificación concreta separa los modelos. Se conserva la primera entrada, que lleva el estado a , pero se aplica entrada cero en el paso siguiente. Los regresores utilizados son ahora y ; la matriz formada por esas filas tiene determinante . El siguiente estado vale para el primer modelo y para el segundo. Con observaciones exactas, el segundo resultado identifica el coeficiente de estado y el primero permite recuperar después la ganancia de entrada.
La acción exploratoria ha aumentado temporalmente el estado del primer modelo desde hasta . La trayectoria regulada habitual lo habría reducido hasta . El dato adicional tiene, por tanto, un coste inmediato visible en la desviación. Valorar ese coste exige conocer las restricciones y la importancia de futuras decisiones que dependan de distinguir ambos coeficientes. La identificación exacta con dos filas independientes tampoco asegura buena precisión con ruido: la geometría puede ser invertible y, aun así, amplificar considerablemente pequeños errores.
La ambigüedad tampoco impide todas las tareas de control. Mientras se conserve la realimentación que produjo los datos, ambos modelos predicen el mismo comportamiento y ofrecen la misma reducción del estado. Si esa respuesta satisface el objetivo, distinguir los dos coeficientes puede aportar poco a la decisión inmediata. Una necesidad de identificación más exigente aparece al cambiar de política, solicitar una respuesta más rápida o trasladar el modelo a otra condición de operación. Los parámetros deben conocerse con la precisión que exige ese uso.
La cancelación exacta en una planta con ganancia desconocida depende del cociente entre el coeficiente de estado y la ganancia de entrada. Una estimación precisa de la diferencia identificada bajo realimentación fija no proporciona necesariamente un cociente preciso. Cerca de una ganancia de entrada nula, pequeñas incertidumbres sobre esa ganancia producen grandes diferencias en la acción calculada. Una familia de modelos compatible con las observaciones puede contener, por ello, acciones de cancelación que exceden la capacidad del actuador.
Los dos modelos concretos utilizados tienen ganancias positivas y alejadas de cero. Eso permite calcular sus cancelaciones sin esa singularidad. Si se ampliara la familia a ganancias arbitrariamente pequeñas o de signo desconocido, habría que especificar cómo se seleccionan las acciones cuando la estimación se aproxima a cero y qué conocimiento previo permite actuar de forma estable. Dividir por la estimación de una ganancia sin controlar ese caso dejaría incompleto el algoritmo.
Al comparar estrategias sobre este ejemplo, la evaluación puede registrar por separado la desviación transitoria, el esfuerzo de entrada y la incertidumbre restante sobre el cociente necesario para actuar. Un único indicador de error de predicción bajo la política fija omite justamente la incertidumbre que aparece al modificarla. La observación exploratoria debe juzgarse por la diferencia que permite resolver entre esas acciones futuras, además de por su efecto sobre el estado actual.
Perturbaciones, límites previos y cambios reales
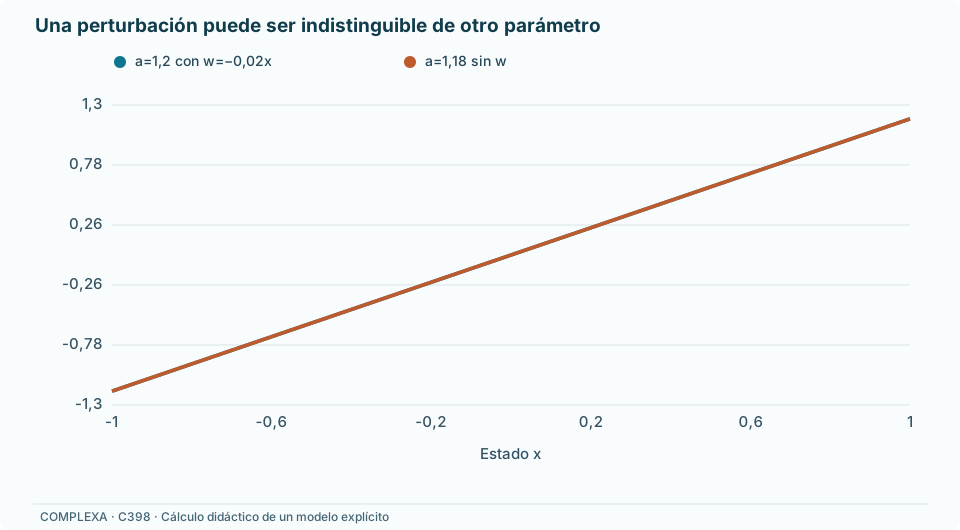
Volvamos a la planta con ganancia de entrada conocida. La cota de estado bajo perturbaciones no asegura que el estimador encuentre el parámetro físico. Un ejemplo admisible lo muestra: con coeficiente verdadero , elijamos la perturbación . Como el estado permanece dentro de la región de magnitud máxima uno, la perturbación cumple el límite de . Sin embargo, la evolución observada es exactamente la de una planta con coeficiente y perturbación nula.
Con la exploración alternante, las dos descripciones producen la misma secuencia de acciones, estados y estimaciones. La actualización converge hacia el coeficiente efectivo, aproximadamente , y conserva un error cercano a respecto del coeficiente físico definido originalmente. Ningún análisis de ese mismo registro puede separar ambas descripciones sin restringir adicionalmente el mecanismo de perturbación. La robustez frente a entradas adversas acotadas permite operar dentro de una región; la consistencia paramétrica necesita otras condiciones.
Suponer ruido de media cero condicionado a la información pasada aportaría una estructura diferente de la perturbación anterior, que depende del estado. Esa hipótesis debe defenderse antes de utilizar argumentos estadísticos de consistencia. También hay que separar perturbación de proceso y error de medición. Si el estado observado contiene ruido, ese ruido entra en el regresor y en la realimentación; la ecuación de error usada para demostrar convergencia cambia. Un estimador diseñado para observaciones exactas no hereda automáticamente las mismas propiedades.
Cuando solo se conoce una cota de perturbación, los datos pueden utilizarse para conservar un conjunto de coeficientes compatibles. Cada transición observada exige
Para un estado positivo, esta desigualdad define un intervalo centrado en el cociente que identificaría el parámetro sin perturbaciones, con semianchura . Si el estado es negativo se invierte el orden de los extremos al dividir. El intervalo se intersecta con el conocimiento previo y con los intervalos de las observaciones anteriores. Mientras sean válidos el modelo, las mediciones exactas y la cota, el parámetro verdadero permanece en esa intersección.
En la primera transición sin perturbación del ejemplo, el estado vale uno y la diferencia entre siguiente estado y entrada vale . Si admitimos que la perturbación desconocida podría alcanzar la cota declarada, la observación deja el intervalo previo reducido a . Una transición posterior con estado y diferencia deja por sí sola el intervalo . Es menos informativa porque el mismo margen de perturbación representa una incertidumbre paramétrica mayor al dividir por un estado pequeño.
Conservar la intersección evita perder la precisión de la primera observación cuando llegan estados pequeños. Un estimador que retiene esa información se comporta de forma distinta de nuestra actualización de gradiente. Podría diseñarse un controlador a partir del conjunto actualizado, pero sería otro algoritmo y necesitaría su propia regla de selección y análisis. La comparación permite localizar qué parte de la incertidumbre procede de las observaciones y qué parte depende de cómo se procesan.
En un estado exactamente nulo, la transición deja de restringir el coeficiente porque su contribución se anula. Aun así, sirve para comprobar la descripción del experimento: una diferencia entre siguiente estado y entrada mayor que la cota de perturbación sería incompatible con las hipótesis. Una intersección vacía en cualquier paso puede revelar una cota demasiado estrecha, un coeficiente variable, un error de medición o una entrada registrada incorrectamente. Forzar una nueva estimación puntual dentro del intervalo inicial ocultaría esa incompatibilidad.
El fallo del intervalo previo es otra cuestión. Si el coeficiente verdadero fuera y las estimaciones siguieran proyectándose sobre el intervalo inicial, cualquier ganancia disponible dejaría un factor del lazo cerrado de al menos . Sin exploración ni perturbaciones, un estado inicial positivo crecería. La proyección mantendría acotado el estimador mientras la planta diverge. Confundir esas dos acotaciones ocultaría el problema.
Además de coeficientes erróneos, puede faltar una parte de la dinámica. Rohrs y colaboradores (1985) mostraron problemas de robustez de clases de algoritmos adaptativos ante dinámica de alta frecuencia no modelada y perturbaciones de salida. En los mecanismos estudiados, ciertas entradas podían aumentar la ganancia del lazo y activar esas dinámicas omitidas, con pérdida de estabilidad. El resultado se refiere a los esquemas analizados; no establece que toda adaptación sea inestable. Sí explica por qué un residuo persistente no debe interpretarse automáticamente como una invitación a aumentar la ganancia de aprendizaje.
Si el coeficiente cambia realmente dentro del intervalo previo, la contracción común sigue proporcionando la cota física mientras la estimación permanezca también dentro de él. En cambio, la identidad del error paramétrico incorpora ahora el cambio del coeficiente entre pasos. Su convergencia a cero ya no se sigue de la demostración para un parámetro constante. La velocidad de variación y la cantidad de excitación disponible determinan cuánto retraso de seguimiento puede tolerarse.
Dar menor peso a datos antiguos puede ayudar a seguir cambios, pero reduce la información acumulada para estimar un parámetro constante con ruido. Un mecanismo de olvido no resuelve ese compromiso sin hipótesis adicionales. Si el estado permanece exactamente en cero y no hay exploración ni perturbaciones, un cambio del coeficiente puede resultar invisible: multiplica una variable nula. Aumentar la frecuencia de actualización del estimador no crea una señal que los datos no contienen.
Elegir acciones por la información que producirán
La exploración alternante que hemos calculado tiene amplitud y calendario fijados de antemano. Su prueba de excitación explica qué aprende el estimador, pero no demuestra que esa exploración sea la mejor para un objetivo de control. Podría exigir más esfuerzo de control del necesario, mantenerse demasiado tiempo o actuar en momentos en que una desviación cuesta más. Optimizarla exige incorporar al problema las consecuencias futuras de la información adquirida.
En control dual, una acción se evalúa tanto por su efecto físico como por la modificación de las creencias sobre la dinámica. Esa modificación puede cambiar las acciones que convendrá aplicar después. Klenske y Hennig (2016) desarrollaron aproximaciones a este problema bayesiano en horizonte finito, con incertidumbre sobre parámetros y estados. Su tratamiento utiliza aproximaciones para evitar el coste de resolver exactamente la planificación sobre creencias, y sus experimentos comparan comportamientos en sistemas simulados. Tales comparaciones no constituyen una garantía general de estabilidad o cumplimiento de restricciones.
La certeza equivalente también puede tener garantías rigurosas bajo condiciones específicas. Mania, Tu y Recht (2019) analizaron control lineal cuadrático y obtuvieron cotas de pérdida de rendimiento que dependen cuadráticamente del error de estimación cuando este es suficientemente pequeño. La condición de precisión importa para asegurar que el controlador nominal estabilice la planta. El resultado no autoriza a sustituir cualquier sistema desconocido por una estimación inicial arbitraria; describe un régimen de errores y supuestos definido en el análisis.
En una implementación, la decisión de explorar necesita una medida de incertidumbre adecuada para la acción pendiente. Una estimación puntual que apenas cambia puede indicar precisión o falta de información. Un intervalo basado en perturbaciones acotadas y una distribución posterior basada en un modelo probabilístico responden a preguntas distintas. Ambos deben actualizarse usando las entradas realmente aplicadas, incluidas posibles saturaciones, y las observaciones disponibles en el momento correcto.
Para los dos modelos con ganancia de entrada desconocida, prolongar indefinidamente la realimentación fija conserva la misma ambigüedad. Si después se quisiera cancelar el siguiente estado desde una desviación común de , el primer modelo exigiría una entrada de , mientras el segundo exigiría aproximadamente . La acción de entrada cero utilizada durante la identificación produce respuestas distintas y permite elegir entre esas cancelaciones en el caso exacto. El valor del experimento queda ligado a esa decisión concreta y al coste de la desviación temporal que hizo posible distinguir los modelos.
Referencias
Anderson, B. D. O. (1977). Exponential stability of linear equations arising in adaptive identification. IEEE Transactions on Automatic Control, 22(1), 83–88. https://doi.org/10.1109/TAC.1977.1101406
Åström, K. J., y Wittenmark, B. (1973). On self tuning regulators. Automatica, 9(2), 185–199. https://doi.org/10.1016/0005-1098(73)90073-3
Goodwin, G. C., Ramadge, P. J., y Caines, P. E. (1980). Discrete-time multivariable adaptive control. IEEE Transactions on Automatic Control, 25(3), 449–456. https://doi.org/10.1109/TAC.1980.1102363
Klenske, E. D., y Hennig, P. (2016). Dual control for approximate Bayesian reinforcement learning. Journal of Machine Learning Research, 17(127), 1–30. https://www.jmlr.org/papers/v17/15-162.html
Mania, H., Tu, S., y Recht, B. (2019). Certainty equivalence is efficient for linear quadratic control. Advances in Neural Information Processing Systems, 32. https://papers.neurips.cc/paper_files/paper/2019/hash/5dbc8390f17e019d300d5a162c3ce3bc-Abstract.html
Rohrs, C. E., Valavani, L., Athans, M., y Stein, G. (1985). Robustness of continuous-time adaptive control algorithms in the presence of unmodeled dynamics. IEEE Transactions on Automatic Control, 30(9), 881–889. https://doi.org/10.1109/TAC.1985.1104070