Dos dispositivos permanecen en el mismo nivel cuando reciben una entrada constante. Al aumentar la entrada hasta un valor de referencia, ambos terminan en ese valor. Una descripción atribuye la aproximación al equilibrio a una respuesta lenta; otra supone una respuesta rápida. Si el instrumento registra únicamente el resultado una vez estabilizado, las dos explicaciones hacen la misma predicción. Repetir esa medición con mayor precisión puede confirmar la coincidencia, pero deja sin examinar la velocidad que las diferencia.
El problema cambia cuando podemos decidir cómo estimular el dispositivo y cuándo observarlo. Una perturbación breve obliga a las dos descripciones a predecir una trayectoria. La discrepancia puede aparecer al principio, desaparecer en una medición posterior y reaparecer después. Elegir el instante de lectura forma parte del experimento tanto como elegir la intensidad de la entrada. Un instrumento excelente situado en un momento poco informativo puede producir un registro muy preciso de una coincidencia.
Esta situación pertenece al diseño de experimentos para discriminar modelos. Atkinson y Fedorov (1975) desarrollaron procedimientos secuenciales y no secuenciales para comparar dos modelos de regresión rivales, incluidos modelos no lineales en sus parámetros. La cuestión que organiza ese trabajo sigue siendo concreta: qué observaciones nuevas permitirían separar explicaciones que los datos disponibles todavía admiten. Para responder hacen falta candidatos explícitos, una descripción de lo que se puede modificar y un criterio que indique qué diferencia resulta informativa.
Las construcciones numéricas siguientes son didácticas. No representan dispositivos medidos, intervenciones clínicas ni experimentos realizados. Sus ecuaciones permiten calcular exactamente dónde surge la información y dónde permanece una ambigüedad. También permiten distinguir tres resultados que suelen confundirse: predecir una salida, estimar los parámetros de una familia y discriminar entre familias. Un experimento puede mejorar uno de ellos sin mejorar los demás.
La perturbación y la lectura forman un solo diseño
Representemos el estado del dispositivo en el instante discreto siguiente mediante
La entrada controlada es , el estado es y la lectura es . Cada paso corresponde al mismo intervalo de tiempo. El error del instrumento, , tiene distribución normal, media cero y varianza ; su desviación estándar es . Suponemos errores independientes entre lecturas y ausencia de ruido en la evolución del estado. Se trata de un modelo de medición deliberadamente sencillo, no de una propiedad general de los sistemas dinámicos.
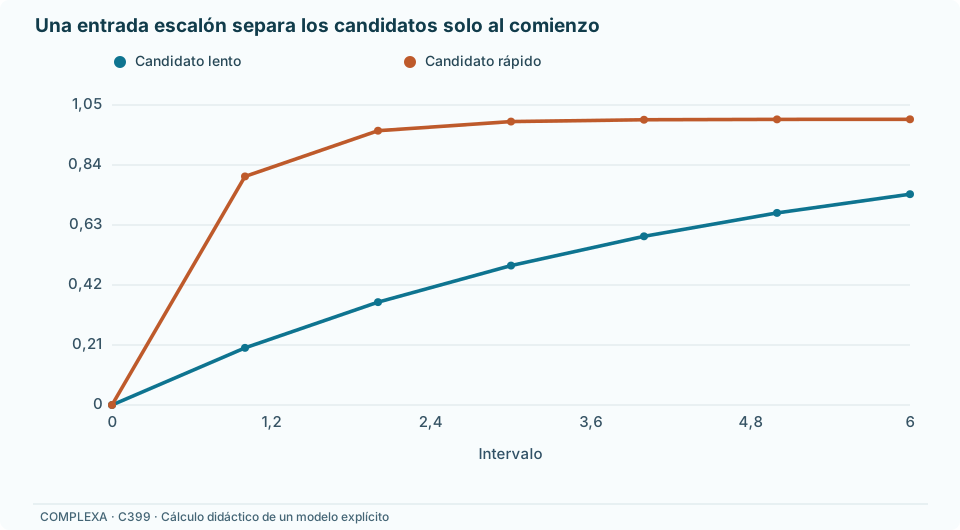
El candidato lento tiene ; el rápido, . Ambos comienzan en el estado conocido . Si mantenemos una entrada constante igual a uno, el equilibrio satisface , de modo que vale uno en ambos casos. El coeficiente de la entrada cambia junto con la persistencia precisamente para conservar esa ganancia estacionaria. En este primer contraste, todos esos parámetros están fijados: comparamos dos leyes de observación completamente especificadas.
Estas dos hipótesis pertenecen a la misma familia dinámica. La discrepancia reside en el valor de la persistencia, no en la presencia de un mecanismo adicional. Discriminarlas resolvería una incertidumbre paramétrica discreta. Más adelante compararemos familias con términos diferentes. Mantener esa distinción evita atribuir al primer experimento una identificación de estructura que sus candidatos no plantean: elegir entre una respuesta lenta y otra rápida no demuestra que la ecuación de primer orden sea la descripción adecuada del dispositivo.
Apliquemos ahora un pulso: entrada uno durante el primer intervalo y cero en los siguientes. Las predicciones son:
| Momento de lectura | Candidato lento | Candidato rápido |
|---|---|---|
| Después del primer intervalo | 0,20 | 0,80 |
| Después del segundo intervalo | 0,16 | 0,16 |
| Después del tercer intervalo | 0,128 | 0,032 |
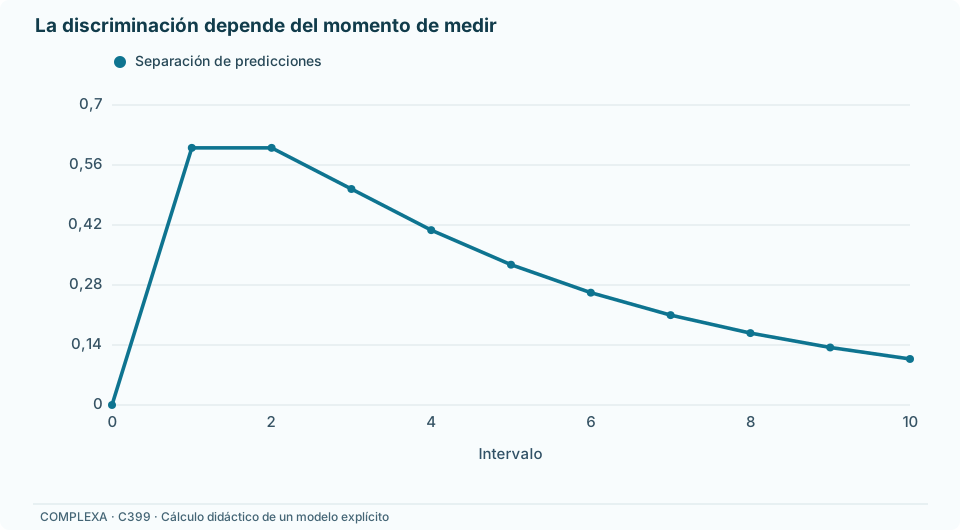
La primera diferencia es amplia respecto del error del instrumento. En el segundo instante, las predicciones coinciden exactamente: la respuesta inicial pequeña del candidato lento se conserva más, mientras que la respuesta inicial grande del rápido decae más. Después, el orden se invierte. Por tanto, medir una vez terminada la primera fase de recuperación puede ocultar la diferencia que habría mostrado una lectura anterior.
El mismo cálculo explica por qué no basta con describir un experimento como «aplicar un pulso». Si solo guardamos la segunda lectura, la distribución observada es la misma bajo ambos candidatos. Ningún procedimiento estadístico puede recuperar de esa variable una distinción que sus distribuciones no contienen. Si guardamos la primera lectura, sí existe una diferencia probabilística. La posibilidad de discriminar depende del par formado por el estímulo y el esquema de observación.
El estado inicial conocido también es parte del diseño. Si cada candidato pudiera elegir libremente ese estado, una única lectura temprana dejaría de imponer la separación calculada: ambos podrían desplazar su predicción mediante un valor inicial distinto. Preparar el dispositivo o medirlo antes del pulso reduce esa libertad. Si únicamente sabemos que su estado inicial está entre menos y más una décima, el candidato lento predice una primera media entre y ; el rápido, entre y . Las dos bandas siguen separadas, aunque la distancia desfavorable es menor que la obtenida fijando el estado en cero.
Esas bandas describen incertidumbre sobre medias, no intervalos de las futuras lecturas. El error normal del instrumento todavía debe añadirse al calcular probabilidades de observación. Tampoco conviene tratar el estado inicial como libre por candidato si una medición basal precisa lo restringe de manera común: el ajuste debe respetar toda la información disponible. Decidir qué cantidades se preparan, cuáles se miden y cuáles quedan como parámetros inciertos permite formular una comparación más fiel a las condiciones experimentales.
Mantener la entrada en uno durante dos intervalos produce otra trayectoria: los estados al final del segundo intervalo son y . Ese diseño también separa las predicciones en el segundo instante, pero utiliza la entrada durante más tiempo. Compararlo con el pulso exige contar ese consumo. Decidir después que solo interesa la lectura que mejor separó las curvas cambiaría la pregunta original y exigiría reconocer la selección realizada.
Kreutz y Timmer (2009) sitúan precisamente la combinación de estimulaciones y observaciones temporales en el centro del diseño para sistemas biológicos. Su revisión distingue objetivos de estimación de parámetros y de discriminación. La enseñanza aplicable al ejemplo es que intensidad, duración y tiempo de lectura deben evaluarse conjuntamente. No se deduce que el pulso elegido aquí sea apropiado para un sistema biológico particular; esa decisión requeriría sus mecanismos, restricciones y mediciones.
Diferencia entre curvas y evidencia esperada
Para dos vectores de medias predichas, y , con el mismo error normal de covarianza definida positiva, la divergencia de Kullback–Leibler es
Esta expresión mide separación entre distribuciones de observaciones. Puede interpretarse como la esperanza, bajo el primer candidato, del logaritmo de su razón de verosimilitudes frente al segundo. La matriz inversa pondera las diferencias según el ruido. Una distancia grande entre dos estados ocultos carece de utilidad para este criterio si el instrumento no distingue esos estados en la variable registrada.
En la primera lectura del pulso, la diferencia de medias es . Con varianza , la divergencia resulta
En la segunda lectura aislada vale cero. Si conservamos ambas lecturas, su divergencia conjunta sigue siendo , porque la segunda aporta una diferencia de medias nula y los errores fueron definidos como independientes. Esta última condición importa: con errores correlacionados, una lectura podría ayudar a interpretar el error de otra aunque sus medias candidatas coincidieran. Habría que usar la covarianza conjunta, en lugar de sumar contribuciones independientes.
El valor calculado es una propiedad esperada del diseño bajo dos modelos, no la evidencia que necesariamente aparecerá al realizarlo. Una lectura exactamente situada en tendría la misma verosimilitud bajo ambos. Si las dos hipótesis tuviesen probabilidades iniciales iguales y todos sus parámetros fueran conocidos, clasificar por el lado del punto medio produciría una probabilidad de error aproximada del % bajo cualquiera de ellas. La separación es informativa y, aun así, una sola lectura puede conducir a la clasificación equivocada.
También conviene examinar la adecuación absoluta. Imaginemos, únicamente para hacer el cálculo, una primera lectura de . Favorecería al candidato rápido sobre el lento con un logaritmo de razón de verosimilitudes igual a treinta. Sin embargo, se encuentra a ocho desviaciones estándar y media de la media del candidato rápido. Ese resultado motivaría revisar el error supuesto, el estado inicial o la familia de modelos. Una victoria relativa contundente puede coexistir con una observación muy poco compatible con el vencedor.
Al reducir a la mitad la amplitud del pulso, las diferencias de medias también se reducen a la mitad y la divergencia pasa de a . La dependencia cuadrática sugiere usar amplitudes grandes, pero solo dentro del dominio permitido. Si la entrada está limitada entre menos uno y uno, la opción matemática no puede ignorar ese límite. Además, extrapolar la ecuación fuera del intervalo donde se considera válida podría aumentar una diferencia ficticia entre modelos mal especificados.
En este ejemplo, el estado siguiente es una combinación convexa del estado actual y de la entrada. Desde cero, entradas dentro de ese intervalo mantienen ambos estados dentro de él. Esta propiedad puede comprobarse directamente por inducción. Asegura una restricción del modelo declarado; no establece límites sobre componentes físicos que quedaron fuera de sus ecuaciones. El dominio admisible del experimento debe incluir las variables que realmente se pretende proteger.
La escala del instrumento merece una comprobación distinta. Si expresamos todas las lecturas en unidades cien veces menores, las diferencias numéricas entre medias se multiplican por cien y la varianza por diez mil. Su cociente en la divergencia permanece igual. Una separación visual más grande, obtenida cambiando las unidades o los ejes de una figura, no aumenta la información. Si aumentar la amplitud también aumenta el ruido, en cambio, el cociente puede variar de una manera diferente de la dependencia cuadrática calculada bajo varianza constante. Esa relación requiere una caracterización del sensor en el intervalo de trabajo.
La repetición presenta otra posibilidad. Supongamos que las lecturas de una ejecución comparten un desplazamiento aleatorio , centrado, y que además tienen errores independientes , también centrados. En la expresión , todos los errores individuales son independientes de ese desplazamiento. La varianza de la media es , si las varianzas individuales son iguales. Aumentar el número de lecturas reduce el segundo término, pero deja el primero intacto. Obtener nuevas ejecuciones con desplazamientos independientes puede aportar más información que volver a leer la misma ejecución. El costo por lectura y el costo por preparación determinan entonces una decisión de diseño que el simple recuento de observaciones oculta.
El rival también puede volver a ajustarse
Hasta aquí comparamos parámetros fijos. Muchas investigaciones comienzan con familias cuyos parámetros se estimarán de nuevo cuando lleguen las observaciones. Dibujar dos curvas previamente ajustadas y elegir su máxima separación puede sobrevalorar el experimento: después de recibir los datos, el candidato rival quizá cambie su intercepto, su pendiente o sus condiciones iniciales y explique la diferencia.
Consideremos una respuesta estática a una entrada normalizada , limitada al intervalo entre menos uno y uno. El primer candidato es lineal y el segundo incorpora curvatura:
Los parámetros y son desconocidos y cada familia puede ajustarlos. Los errores conservan la distribución normal de media cero y varianza , independientes entre unidades experimentales. La curvatura constituye la diferencia que interesa detectar. Antes de calcular una separación necesitamos indicar qué parámetros se mantienen fijos para planificar y cuáles pueden cambiar en el rival.
Una estrategia aparentemente enérgica consiste en repetir únicamente las entradas extremas. En ambas, el cuadrado de la entrada es uno. Por ello, la contribución cuadrática se convierte en una constante que el modelo lineal puede absorber en su intercepto. La respuesta coincide, en los dos niveles usados, con una línea de intercepto y pendiente . Ni una precisión ilimitada ni miles de repeticiones en esos mismos puntos separarían las familias.
La dificultad no implica que la curvatura sea inexistente. Significa que, bajo ese diseño, queda confundida con el nivel basal. Los dos valores distintos de entrada determinan una línea y cualquier par de medias puede ser reproducido por ella. La situación cambia al incorporar el nivel central, donde la contribución cuadrática desaparece. Ahora disponemos de una comparación que el intercepto y la pendiente no pueden absorber conjuntamente.
Denotemos las medias de las réplicas en cada nivel por , y . El contraste
elimina exactamente los términos constante y lineal. Bajo la familia lineal su esperanza es cero; bajo la cuadrática es . No necesitamos conocer los valores del intercepto y la pendiente para calcular esa separación. Sí necesitamos que las observaciones correspondan a la misma relación de respuesta y que el nivel asignado no esté confundido con cambios de calibración, lote o momento de ejecución.
Una deriva del instrumento podría producir un contraste distinto de cero si todas las entradas centrales se midieran en otra sesión. Aleatorizar o equilibrar el orden de los niveles ayuda a impedir esa confusión de diseño. No modifica la identidad algebraica del contraste; modifica las razones por las que sus componentes serían comparables. Las réplicas deben repetir la unidad experimental pertinente. Leer varias veces el mismo espécimen con un error compartido no equivale a disponer de ese número de unidades independientes.
El razonamiento también muestra una diferencia entre discriminación y estimación. Con una recta asumida de antemano, los extremos pueden ser muy útiles para estimar la pendiente. Para examinar una desviación cuadrática con intercepto desconocido, reservar observaciones en el centro permite una comparación que los extremos solos no contienen. La mejor distribución de mediciones depende de la función que se exige al experimento.
El contraste es específico de la alternativa que estamos examinando. Consideremos una respuesta con un término cúbico, , donde puede ser distinto de cero. En los tres niveles elegidos, el cubo de la entrada coincide con la entrada. Por tanto, esa respuesta reproduce exactamente una recta de pendiente . Su contraste central también vale cero, aunque la función completa tenga curvatura fuera de esos puntos. Interpretar un contraste nulo como demostración de linealidad en todo el intervalo excedería la información obtenida.
Un nivel adicional permite examinar esa ambigüedad concreta. En la entrada igual a una mitad, el término cúbico aporta , mientras que la recta que reproduce los tres niveles anteriores aporta a través de su pendiente. La diferencia entre ambas predicciones es . Si la alternativa cúbica fuera pertinente, incluir esa lectura introduciría una nueva comparación, aunque reduciría los recursos disponibles para otras. Al volver a ajustar la recta a los cuatro niveles podría redistribuirse el error entre ellos, pero ya no podría reproducirlos todos exactamente cuando el coeficiente cúbico fuera distinto de cero.
Este cambio de diseño nace de ampliar las hipótesis rivales. No exige asumir que todos los mecanismos omitidos pueden anticiparse. Exige conservar la diferencia entre «estos datos distinguen los candidatos propuestos» y «ningún otro mecanismo produciría estos datos». Incorporar una condición adicional permite someter a prueba una nueva discrepancia; añadir réplicas en condiciones donde los candidatos coinciden solo precisa esa coincidencia.
Doce mediciones y una distribución desigual
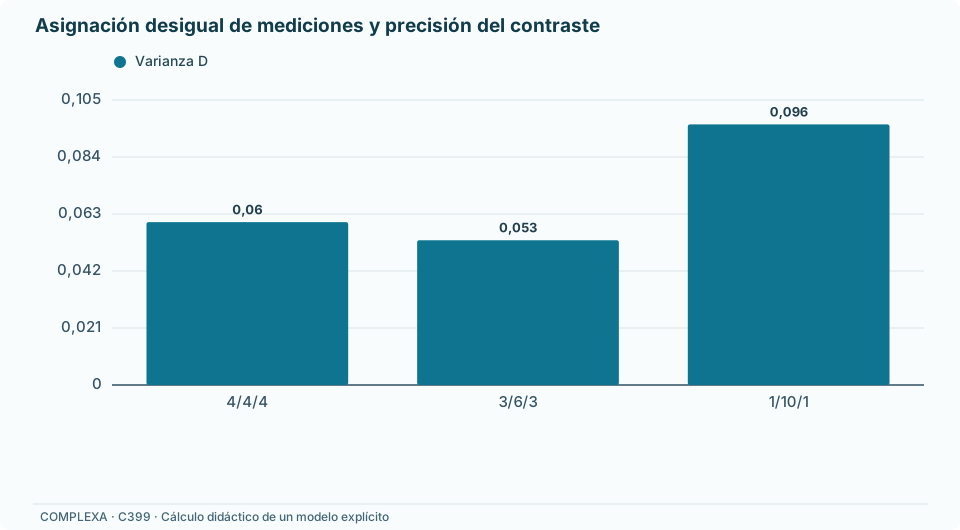
Fijemos ahora un presupuesto de doce unidades independientes y limitemos las entradas a los tres niveles anteriores. Cada nivel recibirá al menos una unidad. Si sus tamaños son , y , la varianza del contraste es
El nivel central entra con coeficiente menos dos y contribuye cuatro veces su varianza de media. Por esa razón, repartir las unidades por igual no es necesariamente la mejor opción para este contraste. La independencia permite sumar las tres contribuciones; un diseño de medidas emparejadas necesitaría incorporar sus covarianzas y podría llevar a otra asignación.
Por ejemplo, un desplazamiento común de calibración se cancelaría en el contraste si afectara por igual a los tres niveles, porque sus coeficientes suman cero. Si cada nivel tuviera un desplazamiento de sesión diferente, esa cancelación dejaría de operar. Organizar bloques que incluyan todos los niveles puede aprovechar la primera situación, siempre que el sistema pueda restablecerse y que un estímulo no altere la respuesta al siguiente. Esa alternativa exige modelar los efectos compartidos del bloque. No autoriza a usar la fórmula independiente anterior contando como nuevas unidades todas las lecturas de un mismo sistema.
La distribución equilibrada, cuatro unidades por nivel, produce varianza . La distribución tres, seis y tres produce , aproximadamente . Para ver por qué aparece esa proporción, podemos permitir momentáneamente cantidades continuas de observaciones. Minimizar la suma de términos inversos con presupuesto fijo iguala el beneficio marginal de una unidad adicional. Los tamaños quedan proporcionales a los valores absolutos de los coeficientes del contraste: uno, dos y uno.
En nuestro presupuesto, esa solución continua es entera y satisface las restricciones. La enumeración de las cincuenta y cinco asignaciones enteras positivas confirma que tres, seis y tres es el único mínimo. La afirmación de optimalidad se refiere a ese presupuesto, esos niveles, ese error y ese criterio. No abarca todos los estímulos imaginables, otros instrumentos ni otras preguntas sobre la respuesta.
Tomemos como valor de planificación, sin afirmar que haya sido estimado en un experimento. La esperanza del contraste es . Frente al mejor ajuste lineal a las medias cuadráticas, la divergencia normal es tres con la asignación equilibrada y con la asignación tres, seis y tres. El cálculo permite que el rival vuelva a ajustar tanto el intercepto como la pendiente. Por tanto, la ventaja no procede de inmovilizar artificialmente una recta mal elegida.
En los dos diseños simétricos, la pendiente del mejor rival coincide con . Su intercepto aumenta respecto de en dos tercios de la curvatura con la asignación equilibrada y en la mitad con la otra. Al restar esa recta, quedan diferencias residuales entre niveles que producen las divergencias indicadas. Cuanto más puede absorber el rival mediante sus parámetros, menor es la separación útil que queda disponible para discriminar la estructura.
Para estas tres medias y este contraste, la misma divergencia se expresa como . Esta igualdad conecta el cálculo geométrico del mejor rival con la precisión de una comparación observable. No convierte la divergencia en un valor de significación ni en una probabilidad de que la familia cuadrática sea verdadera. Una prueba del contraste o una comparación bayesiana necesitarían sus reglas de inferencia, además del criterio utilizado para planificar.
Diseñar con parámetros inciertos
El valor de planificación puede ser incorrecto. Si la curvatura real es muy pequeña, incluso una asignación eficiente tendrá poca capacidad para separarla de cero. Si es exactamente cero, la familia cuadrática contiene a la lineal y ambas describen la misma respuesta. Ningún diseño puede garantizar una separación positiva entre todas las configuraciones de dos familias que se solapan de ese modo.
Este límite afecta a la formulación de un criterio robusto. Podríamos buscar el diseño que maximice la menor separación sobre un conjunto de parámetros plausibles. Si ese conjunto permite la coincidencia exacta para cualquier diseño admisible, el mínimo vale cero. La respuesta útil consiste en reconocer el solapamiento o definir una diferencia mínima de interés sustentada por la pregunta científica. Excluir valores cercanos a cero solo para obtener una optimización favorable escondería la dificultad.
Skanda y Lebiedz (2013) plantean diseños para sistemas dinámicos que consideran configuraciones desfavorables de parámetros al discriminar modelos. Su enfoque incorpora decisiones sobre perturbaciones y tiempos de medición. La robustez corresponde a los candidatos, los rangos y el modelo probabilístico especificados. No protege automáticamente contra mecanismos ausentes del conjunto ni contra un sensor cuyo error tenga otra estructura.
Una alternativa utiliza una distribución previa sobre modelos y parámetros y maximiza una utilidad esperada. Chaloner y Verdinelli (1995) presentan el diseño bayesiano desde ese marco de decisión. La utilidad puede reflejar información relevante o consecuencias de decisiones posteriores, y la distribución previa determina cómo se ponderan situaciones posibles. Un diseño que sea excelente en promedio puede ser débil en una región poco probable; el criterio de peor caso atiende esa región, pero puede sacrificar mucho rendimiento en las demás.
La selección entre ambos criterios requiere hacer explícito qué fracaso preocupa. Si el objetivo es identificar una desviación de magnitud relevante para una decisión posterior, resulta razonable examinar el comportamiento del diseño alrededor de esa magnitud. Si interesa resolver una ambigüedad peligrosa aunque sea poco probable, el peor caso puede recibir mayor atención. Esas elecciones expresan prioridades del problema; no se desprenden por sí mismas de una curva de respuesta.
La identificabilidad de parámetros aporta otra comprobación. Raue y colaboradores (2009) distinguen limitaciones estructurales de otras debidas a cantidad o calidad insuficiente de datos. En su análisis por perfiles, un parámetro se fija sucesivamente mientras los restantes se reajustan. Esa operación permite reconocer compensaciones que desaparecerían de la vista si los demás parámetros se mantuvieran inmóviles. La evaluación se realiza dentro de una familia: restringir sus parámetros no demuestra que su estructura sea la correcta.
Reajustar tampoco significa olvidar los datos anteriores. Si una calibración independiente determina el intercepto con gran precisión, el rival lineal ya no puede desplazarlo libremente sin empeorar su explicación de esa calibración. El criterio debe considerar conjuntamente la información previa y el experimento propuesto, o condicionar la predicción nueva a lo que ya se sabe. En nuestra comparación cuadrática dejamos libres el intercepto y la pendiente para mostrar una compensación posible. Una restricción adicional sobre ellos cambiaría la separación que queda después del ajuste y, con ella, la utilidad de cada diseño.
Algo semejante ocurre cuando el mismo parámetro se comparte entre varias condiciones. Permitir que cada condición tenga un valor completamente distinto puede borrar una discrepancia que el modelo original prohibía absorber. Forzar un valor común cuando los mecanismos permiten variación puede crear una discrepancia artificial. La unidad que recibe una perturbación y la unidad que comparte parámetros deben quedar identificadas antes de optimizar. Esa decisión conecta el modelo estadístico con el modo en que se preparan y repiten las condiciones experimentales.
Liu, Maini y Baker (2026) estudian la elección de una entrada externa para mejorar identificabilidad práctica y discriminación, formulando esta última mediante control óptimo. Su planteamiento refuerza la separación entre objetivos: una entrada que reduce incertidumbre paramétrica puede diferir de otra que separa candidatos. Aplicar condiciones de optimalidad tampoco demuestra, por sí solo, que una solución numérica sea el máximo global. En el ejemplo de doce mediciones pudimos enumerar todas las alternativas; en problemas dinámicos mayores, esa garantía requiere argumentos adicionales.
Qué componente modifica realmente el estímulo
Una diferencia estructural puede permanecer oculta incluso después de aleatorizar una señal externa. Consideremos una variable latente , normal de media cero y varianza uno; una señal controlada ; y un error , independiente de ambos, normal de media cero y varianza . Dos mecanismos proponen:
En el primero, la señal afecta a la salida a través de . En el segundo, la señal y la variable latente tienen caminos directos a la salida, mientras que no aparece en su ecuación. Al sustituir la ecuación de en el primer mecanismo obtenemos exactamente la expresión del segundo. Coinciden para cada realización de la variable latente, la señal y el error, no solo en una correlación particular.
Si asignamos aleatoriamente la señal a valores positivos o negativos, independientes de , ambos modelos siguen prediciendo la misma ley de las variables observadas. Fijar produce en ambos una media de salida . El experimento permite aprender el efecto de esa señal, pero no distingue el camino mediado por del camino directo. Haber generado variación externa no basta para atribuir todo su efecto a la variable que también responde a ella.
La diferencia aparece en otra intervención. Mantengamos la señal en cero y reemplacemos únicamente la ecuación de por . En el primer mecanismo, la media de la salida pasa a . En el segundo permanece en cero, pues depende de la variable latente y del error, ambos centrados. La intervención distingue los candidatos solo si podemos defender que modifica ese componente sin introducir el camino directo que figuraba en el segundo mecanismo.
La representación estructural de una intervención como sustitución de una ecuación, conservando los demás mecanismos, se expone en Pearl (2009). En una investigación aplicada, esa sustitución es una afirmación sobre cómo funciona la manipulación. Su validez puede apoyarse en conocimiento del dispositivo, mediciones de efectos secundarios y comparaciones entre maneras de actuar. La aleatorización resuelve la asignación de la señal; no define automáticamente todos los mecanismos que la señal modifica.
Este ejemplo también establece un límite a la amplitud. Variar los valores o patrones de asignación de o repetir indefinidamente la misma manipulación no rompe la igualdad algebraica entre candidatos. Para aprender sobre el camino causal habría que modificar el conjunto de acciones posibles o añadir información que descarte uno de los mecanismos. Un optimizador que solo reciba esa familia de señales no puede inventar la selectividad que falta.
Un experimento que pueda cambiar la decisión
Una planificación defendible especifica qué resultados obligarían a revisar los candidatos. En el dispositivo dinámico, el pulso y la lectura temprana separan las predicciones fijadas. Si el registro se sitúa lejos de ambas, el paso siguiente sería estudiar el sensor, el estado inicial o una dinámica adicional. Repetir la comparación como si una de las dos curvas tuviera que ser correcta convertiría el diseño en una competencia cerrada por decisión del analista.
También hay que distinguir la adaptación prevista de la selección oportunista. Podemos usar una primera tanda para actualizar parámetros y elegir después otro estímulo. Los diseños secuenciales formalizan esa posibilidad. El análisis posterior debe reconocer cómo se eligieron las nuevas entradas y qué información estaba disponible al decidir. Una regla de parada o una selección de tiempos guiada por los resultados forma parte del procedimiento que genera la evidencia.
Las comprobaciones de implementación pueden resultar decisivas. La entrada ordenada puede diferir de la entrada aplicada por saturación o retraso del actuador. Una lectura etiquetada como posterior al pulso puede integrar un intervalo que incluye parte de él. En el ejemplo dinámico, confundir esos tiempos alteraría la comparación entre la primera y la segunda medición. Registrar la señal realmente entregada y el intervalo efectivo de lectura permite evaluar el experimento que ocurrió.
Conviene conservar además una distinción entre explorar una respuesta y confirmar una discrepancia. Una exploración densa puede localizar fases en las que divergen las trayectorias. Una comparación posterior, con reglas fijadas y unidades nuevas cuando proceda, permite evaluar esa diferencia con un alcance más claro. El costo de esa separación debe compararse con el riesgo de perseguir fluctuaciones del instrumento o particularidades de una única ejecución.
Al volver a las doce mediciones, la decisión queda delimitada: tres unidades en cada extremo y seis en el centro minimizan la varianza del contraste de curvatura entre las asignaciones consideradas. Una media central desplazada podría sugerir curvatura, deriva o un cambio de condiciones; el diseño de orden y calibración ayuda a distinguir esas explicaciones. En el dispositivo dinámico, una sola lectura bien situada puede contener información que no aportan muchas lecturas tardías. En ambos casos, el experimento gana capacidad de discriminación al crear una comparación que el rival no puede reproducir mediante las libertades que realmente conserva.
Referencias
Atkinson, A. C., y Fedorov, V. V. (1975). The design of experiments for discriminating between two rival models. Biometrika, 62(1), 57–70. https://doi.org/10.1093/biomet/62.1.57
Chaloner, K., y Verdinelli, I. (1995). Bayesian Experimental Design: A Review. Statistical Science, 10(3), 273–304. https://doi.org/10.1214/ss/1177009939
Kreutz, C., y Timmer, J. (2009). Systems biology: experimental design. The FEBS Journal, 276(4), 923–942. https://doi.org/10.1111/j.1742-4658.2008.06843.x
Liu, Y., Maini, P. K., y Baker, R. E. (2026). Optimal experiment design for practical parameter identifiability and model discrimination. Mathematical Biosciences, 399, 109710. https://doi.org/10.1016/j.mbs.2026.109710
Pearl, J. (2009). Causal inference in statistics: An overview. Statistics Surveys, 3, 96–146. https://doi.org/10.1214/09-SS057
Raue, A., Kreutz, C., Maiwald, T., Bachmann, J., Schilling, M., Klingmüller, U., y Timmer, J. (2009). Structural and practical identifiability analysis of partially observed dynamical models by exploiting the profile likelihood. Bioinformatics, 25(15), 1923–1929. https://doi.org/10.1093/bioinformatics/btp358
Skanda, D., y Lebiedz, D. (2013). A robust optimization approach to experimental design for model discrimination of dynamical systems. Mathematical Programming, 141, 405–433. https://doi.org/10.1007/s10107-012-0532-0