Año 2 · Módulo 13
130.1. Un servicio con la misma demanda media puede funcionar de maneras diferentes
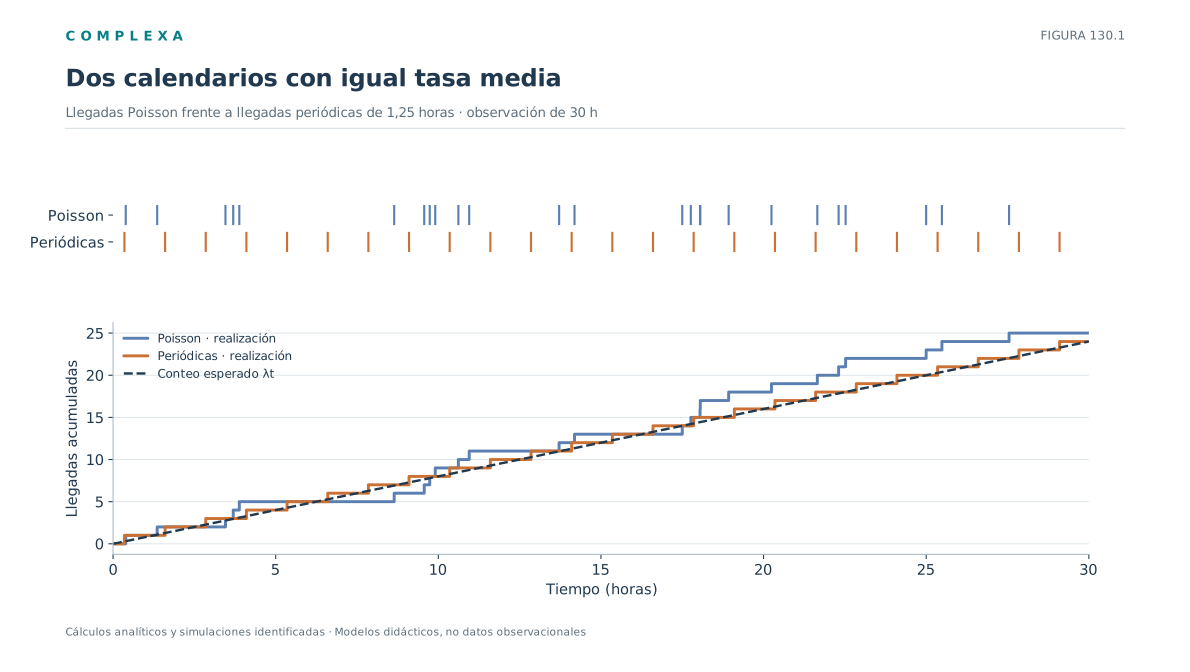
Dos sistemas reciben, en promedio, 0,8 personas por hora y atienden a una persona por hora. Comparten utilización del servidor y duración media de atención. Sin embargo, si las llegadas son de Poisson en un sistema y periódicas en el otro, las esperas en la cola cambian sustancialmente. El problema permite integrar procesos de conteo, cadenas de Markov y renovación en un cálculo operativo.
Las esperas dependen de cómo se distribuyen las llegadas a lo largo del tiempo. Ocho personas pueden llegar separadas por intervalos regulares o concentrarse en grupos que dejan períodos de inactividad. La tasa media no distingue entre esas posibilidades. Aunque la distribución del tiempo de atención no cambie, las esperas pueden ser muy diferentes, porque con capacidad limitada y trabajo pendiente acumulado el orden temporal de los eventos influye en ellas.
Para calcular la espera habrá que representar la demanda como una secuencia temporal, describir el trabajo acumulado y resolver la interacción con el servidor. El ejemplo permitirá separar la tasa media de llegadas, el grado de utilización y la distribución del tiempo de espera, tres magnitudes que suelen agruparse indebidamente bajo la expresión «carga del servicio». La relación entre ellas depende de la estructura temporal de la demanda.
Compararemos dos modelos de llegada a un mismo servicio. En el modelo A, las llegadas forman un proceso de Poisson homogéneo, con tiempos entre llegadas exponenciales e independientes. En el modelo B, las personas llegan a intervalos exactamente iguales. Ambos tendrán la misma tasa media de entrada, el mismo profesional, la misma distribución exponencial del tiempo de servicio y la misma regla de atención por orden de llegada. Mantener constantes estos elementos permite atribuir las diferencias entre modelos al patrón temporal de entrada.
Los dos modelos serán deliberadamente ideales. Un centro de atención real puede tener horarios, prioridades, abandonos, interrupciones, duraciones dependientes del tipo de consulta y límites de capacidad. El caso resuelto los deja de lado para mostrar qué puede aprenderse de una comparación controlada. El propósito es calcular magnitudes observables bajo hipótesis explícitas y evaluar si las predicciones coinciden con una simulación independiente del modelo.
Trabajaremos con tasas constantes y un horizonte suficientemente largo para estudiar un régimen estable. Al final examinaremos qué conclusiones siguen siendo válidas cuando introducimos variación horaria o dependencia entre servicios. El ejercicio también permitirá distinguir promedios por unidad de tiempo, promedios por persona atendida y estados observados justo antes de una llegada.
130.2. Mecanismos de llegada y dispersión de los conteos
Especifiquemos los parámetros en horas. La tasa media de llegadas será por hora y la tasa de servicio por hora. Por consiguiente, el intervalo medio entre llegadas es
mientras que el tiempo medio de atención es
En ambos modelos supondremos que los tiempos de servicio son independientes y tienen distribución exponencial de tasa . De ese modo, el tiempo de servicio tiene desviación estándar de una hora y coeficiente de variación igual a uno. También supondremos independencia entre los tiempos de servicio y el mecanismo que determina las llegadas. La atención es por orden de llegada, sin interrupciones, sin abandonos y con una sola estación de servicio.
En el modelo A, las diferencias entre instantes sucesivos de llegada son exponenciales con tasa . Su densidad es
Se trata de un proceso de renovación con intervalos independientes. La probabilidad de que no llegue nadie durante las próximas dos horas es , aproximadamente 0,202. El mecanismo permite tanto intervalos muy breves, en los que pueden acumularse varias personas, como intervalos largos sin entradas. Si el sistema ya acumula trabajo pendiente, un grupo adicional de llegadas prolonga la espera de quienes llegan después.
En el modelo B, todos los intervalos entre llegadas tienen la misma duración
Los intervalos de llegada no producen agrupamientos aleatorios y toda la variabilidad del sistema proviene de los tiempos de servicio. Un servicio ocasionalmente muy largo puede crear trabajo acumulado que se transmitirá a varias llegadas posteriores, aunque cada entrada ocurra a su hora. Por tanto, el modelo periódico sigue siendo estocástico.
Para comparar distribuciones de conteos en ventanas situadas en un origen temporal arbitrario, podemos asignar una fase inicial uniformemente distribuida entre cero y 1,25 horas al calendario periódico. Así, el conjunto de llegadas no queda artificialmente alineado con el comienzo de la observación. Esta aleatorización de fase no cambia los intervalos entre llegadas ni las esperas observadas en régimen estable en los instantes de llegada.
La intensidad de tráfico, denominada también utilización media cuando existe régimen estacionario, es
En ambos modelos la capacidad media supera la demanda media. La condición permite un régimen estable para las colas estudiadas, bajo las hipótesis de estacionariedad y ergodicidad pertinentes, aunque no fija la longitud promedio de la cola. Una utilización del 80 % significa que, a largo plazo y sin pérdidas, el servidor está ocupado alrededor del 80 % del tiempo.
Usaremos la notación de Kendall, que clasifica los modelos de colas por la estructura de llegadas, la distribución de servicios y el número de servidores. El modelo A es (llegadas de Poisson, tiempos exponenciales de servicio y un servidor) y el modelo B es (intervalos deterministas de llegada, servicio exponencial y un servidor). Esta diferencia, reducida a una letra, modificará varias predicciones del ejercicio.
Comencemos sin considerar aún las esperas. Sea el número de personas que llegan durante una ventana temporal de longitud . Si las llegadas siguen un proceso de Poisson homogéneo, entonces
por lo que
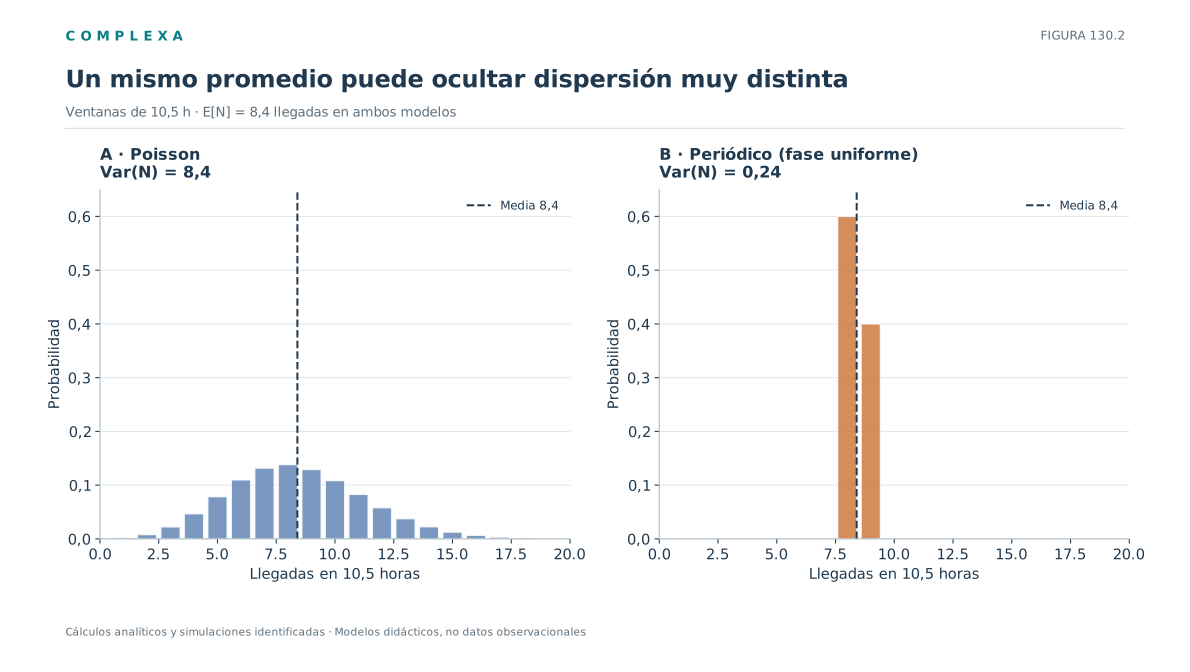
Durante una ventana de 10,5 horas esperamos 8,4 llegadas y la varianza del conteo también es 8,4. La desviación estándar es aproximadamente 2,90 personas. Esta dispersión es propia del mecanismo aleatorio del modelo y persistiría aunque conociéramos sin error.
Para las llegadas periódicas con fase inicial uniforme, el conteo en la misma ventana tiene un comportamiento muy diferente. En 10,5 horas caben 8,4 intervalos de longitud 1,25 horas. El número de llegadas es ocho o nueve, con probabilidades 0,6 y 0,4 respectivamente, salvo convenciones de frontera que no afectan el resultado por tener probabilidad nula. Así,
La esperanza es idéntica en ambos sistemas. La varianza del conteo es treinta y cinco veces mayor en el modelo de Poisson (). Si elegimos una ventana cuya longitud es un múltiplo entero del período de llegada, el conteo periódico con fase uniforme es constante casi seguramente y su varianza es cero. Aun así, las esperas siguen variando, porque el mecanismo de servicio es aleatorio.
En series observacionales suele usarse el índice de dispersión de conteos, , también conocido como factor de Fano. Para un proceso de Poisson homogéneo vale uno en cualquier ventana temporal finita. Para las llegadas periódicas con fase aleatoria depende de la longitud de la ventana y, al ampliarla, tiende a cero. En datos reales, un factor distinto de uno no identifica de manera única el mecanismo, porque la heterogeneidad de tasas, los calendarios, el agrupamiento inducido por citas y una resolución temporal inadecuada pueden alterar el índice.
Podemos entender el resultado desde el punto de vista del trabajo acumulado. Cada llegada añade una cantidad de trabajo igual al tiempo de servicio que requerirá. Si aparecen varias personas antes de que se complete la atención anterior, la carga pendiente aumenta. El trabajo llega como una secuencia de incrementos localizados en momentos concretos. La distribución de los intervalos determina con qué frecuencia el servidor puede reducir esa carga entre entradas.
Esta observación explica por qué comparar tasas medias es insuficiente para decidir la dotación de un servicio, ya que dos calendarios con el mismo número de horas profesionales pueden generar esperas distintas. También anticipa una restricción de inferencia; si solo conocemos conteos diarios, quizá no haya resolución temporal suficiente para distinguir un flujo aproximadamente homogéneo de una entrada concentrada en momentos específicos del día.
130.3. La ecuación de Lindley y el trabajo pendiente en cada llegada
Necesitamos una variable de estado que conecte las llegadas con el funcionamiento del servidor. Denotaremos por el tiempo que debe esperar en cola la persona desde que llega hasta que comienza su atención. No incluiremos en el tiempo que requiere su propio servicio. El tiempo total que pasa en el sistema será . Esta separación evita interpretar una espera de cuatro horas como cuatro horas de atención profesional.
Sea el servicio requerido por la persona y el tiempo entre las llegadas y . Inmediatamente después de su llegada, el trabajo que debe completarse antes de terminar el servicio de la persona es . Durante las siguientes horas, el servidor puede disminuir ese trabajo acumulado. Si termina antes de la próxima llegada, el servidor queda desocupado durante el tiempo restante. Por ello,
Esta es la recurrencia de Lindley, que describe de forma exacta la espera en una cola de un servidor que respeta las reglas especificadas, sean los intervalos exponenciales o deterministas. Una vez conocemos una secuencia de llegadas y servicios, la evolución de la espera es determinista. La aleatoriedad aparece cuando tratamos esas secuencias como realizaciones de variables aleatorias.
La ecuación tiene un parecido formal con una caminata aleatoria reflejada. Definamos los incrementos de trabajo . Sin la restricción , la suma acumulada de los podría tomar valores negativos. La operación máximo con cero impide que el trabajo pendiente se vuelva negativo y representa los períodos de inactividad del servidor. La acumulación de incrementos y la frontera reflectante conectan la teoría de colas con las caminatas de C129. No obstante, el tiempo de espera se mide en horas y no es una posición espacial física.
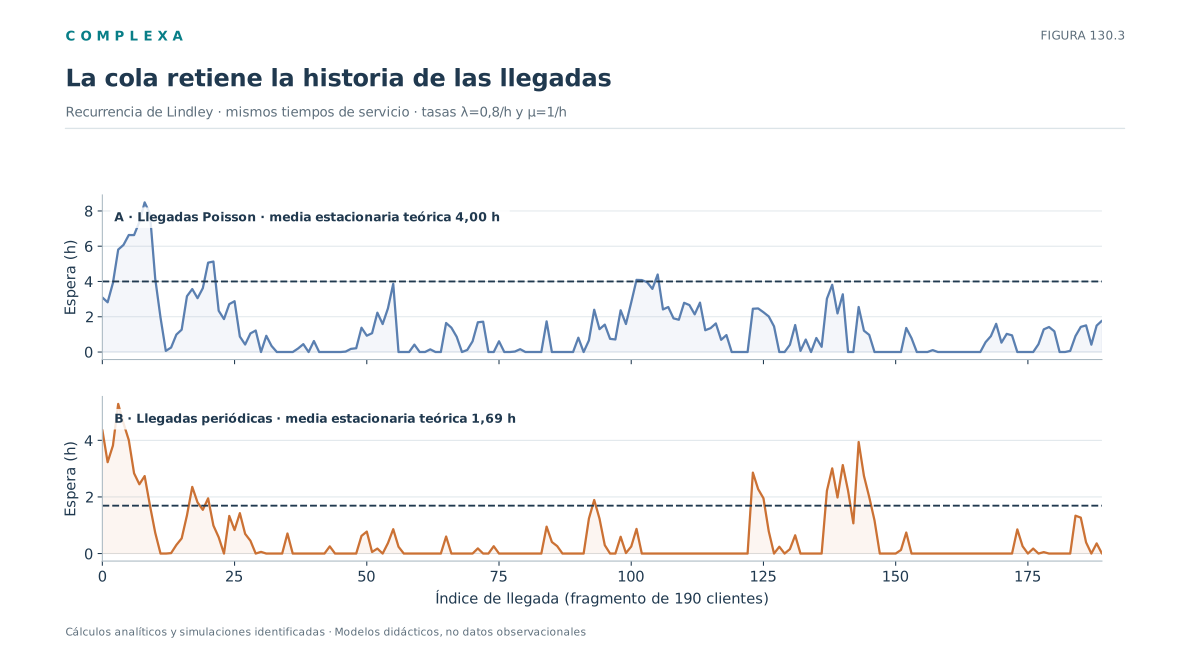
En ambos modelos, horas. El signo negativo indica que el servicio disponible supera la demanda en promedio. Sin embargo, las distribuciones de son diferentes. En el caso Poisson, el intervalo puede ser muy corto y producir incrementos positivos relativamente grandes. En el caso periódico, el siguiente intervalo está fijado de antemano. La recurrencia propaga esa diferencia y modifica la distribución de aunque la media de coincida.
Para calcular promedios en régimen estacionario debemos distinguir ese régimen del arranque de una simulación con . Un sistema recién abierto y vacío tiene esperas iniciales inferiores, por lo general, a las de uno que ya lleva mucho tiempo funcionando cerca del equilibrio estadístico. Al estimar estadísticas mediante simulación eliminaremos un período inicial y examinaremos la sensibilidad del resultado a su duración. Esta operación suele llamarse calentamiento (período de inicialización descartado) y no corrige un modelo inestable.
La recurrencia de Lindley también permite analizar sistemas con otros tiempos de servicio o llegada, incluso cuando no disponemos de una fórmula cerrada para el promedio de espera. Por eso será nuestra herramienta principal de simulación. Primero calcularemos las soluciones analíticas disponibles para los dos modelos escogidos; después verificaremos que una implementación directa de la recurrencia reproduce esas predicciones.
130.4. Modelo A y solución analítica de la cola M/M/1
Con llegadas de Poisson y servicios exponenciales, el número de personas en el sistema, contando a quien está siendo atendida, es una cadena de Markov en tiempo continuo. Desde el estado una llegada aumenta el conteo a con tasa . Si , una finalización de servicio lo reduce a con tasa . Cuando el sistema está vacío no pueden producirse salidas. Es un proceso de nacimiento y muerte con tasas constantes, salvo en la frontera cero.
En régimen estacionario, la conservación del flujo entre estados vecinos da . De ahí obtenemos , donde . Al normalizar las probabilidades para , resulta
Con , la probabilidad de que el sistema se encuentre vacío en un instante arbitrario es 0,2. La media de personas presentes en el sistema es
Este promedio incluye a la persona que esté siendo atendida. El número esperado de personas esperando en cola es . Un servidor que atiende, en promedio, un trabajo por hora puede mantener varias personas en espera cuando la intensidad de tráfico se aproxima a su capacidad.
La ley de Little relaciona número medio en el sistema, tasa efectiva de llegada y tiempo medio de permanencia. Bajo sus condiciones de estabilidad y definición coherente de promedios,
Por tanto,
El tiempo medio total comprende cuatro horas de espera más una hora de atención. La proximidad entre las tasas de llegada y servicio explica el tamaño de estas cifras, pues el denominador vale apenas 0,2 por hora. Si la tasa media de llegada aumentara sin incrementar la capacidad, las esperas previstas crecerían rápidamente antes de alcanzar la condición de inestabilidad.
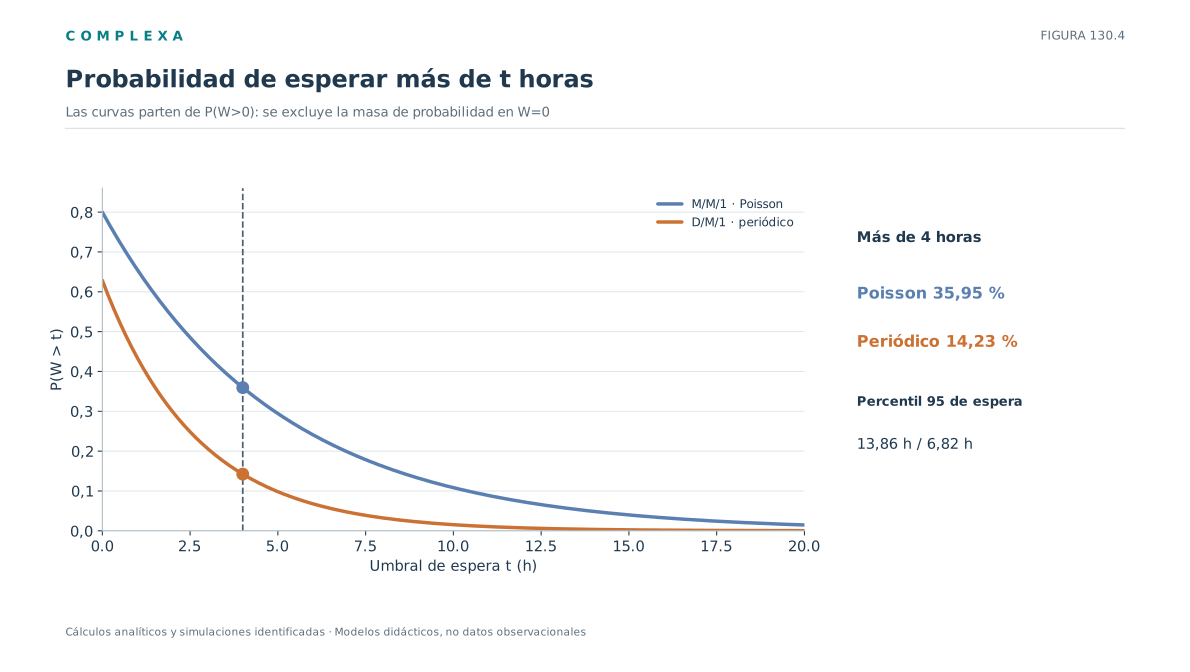
El teorema PASTA, según el cual las llegadas de Poisson ven promedios temporales bajo las hipótesis apropiadas, permite afirmar que una llegada típica encuentra el servidor ocupado con probabilidad . En consecuencia, el 80 % de las llegadas tiene una espera positiva en este modelo. La distribución del tiempo de espera en cola tiene una masa de probabilidad en cero y una cola exponencial dada por
La expresión en da la probabilidad de tener que esperar. Para horas, la probabilidad de superar cuatro horas de espera es aproximadamente 0,3595. El percentil 95 de , definido considerando también a quienes no esperan, es , aproximadamente 13,86 horas.
Estas cifras describen un servicio real solo si se cumplen las premisas. Son, sobre todo, una referencia analítica. Si el código aplicado al modelo A no recupera promedios cercanos a cuatro horas de espera, hay una razón clara para revisar el programa antes de usarlo en un problema sin solución cerrada.
130.5. Cola D/M/1 con llegadas periódicas
En el modelo B las llegadas se producen cada 1,25 horas. Aunque el tiempo de servicio sigue siendo exponencial, el número de personas presentes en un instante arbitrario ya no es, por sí solo, una cadena de nacimiento y muerte con las transiciones del modelo A. La próxima llegada depende del tiempo transcurrido desde la anterior. Si quisiéramos construir un proceso markoviano en tiempo continuo, tendríamos que ampliar el estado incorporando la fase del calendario. Es un caso concreto del principio estudiado en C122, según el cual la propiedad de Markov depende de qué información incluimos en la representación del estado.
Podemos evitar esa ampliación observando el sistema inmediatamente antes de cada llegada. Sea la cantidad de personas presentes justo antes de la llegada , incluyendo a quien esté siendo atendida. Tras esa llegada habrá trabajos en el sistema. Durante las siguientes horas, el servidor puede completar algunos de ellos. La memoria nula de los servicios exponenciales permite representar las oportunidades potenciales de finalización por un reloj de Poisson de tasa . El número de oportunidades durante ese intervalo tiene distribución de Poisson con media y el estado antes de la llegada siguiente satisface
Las oportunidades que ocurren con el servidor ya vacío no producen salidas adicionales, porque la operación máximo impide conteos negativos. Bajo esta construcción, el muestreo de la cola en instantes de llegada es una cadena discreta. El problema se reduce a encontrar su distribución estacionaria.
Ensayemos una distribución geométrica en los instantes de llegada,
con . Su probabilidad de cola es . Condicionando por las oportunidades de servicio, para , obtenemos
Para conservar la misma distribución geométrica entre llegadas sucesivas necesitamos, por tanto,
La ecuación siempre admite la solución , pero esa solución no corresponde a una distribución geométrica normalizable. En el régimen estable existe otra solución en el intervalo abierto , que es la que necesitamos. Con y , el resultado numérico es
Al llegar una persona, la probabilidad de encontrar a alguien en el sistema y tener que esperar es , aproximadamente 0,629. Si encuentra trabajos pendientes, su espera hasta comenzar la atención es la suma de tiempos exponenciales de tasa . El primero corresponde, cuando procede, al tiempo residual del servicio en curso, que conserva la distribución exponencial por ausencia de memoria. Al mezclar sobre la distribución geométrica de , se obtiene
Integrando la cola de supervivencia,
La permanencia total media es horas. El cálculo usa la estructura exponencial del servicio. Si la duración de las atenciones siguiera otra distribución, la recurrencia de Lindley continuaría siendo válida, pero no podríamos conservar esta fórmula geométrica sin justificarla nuevamente.
En ambos modelos el servidor permanece ocupado el 80 % del tiempo en régimen estable, porque el trabajo medio recibido es idéntico y no hay abandonos ni pérdidas. Sin embargo, la distribución del trabajo pendiente en los instantes de llegada no es la misma. El modelo periódico deja más tiempo entre llegadas consecutivas y evita los intervalos muy cortos que el modelo de Poisson permite.
La tabla siguiente resume los resultados calculados.
| Magnitud en régimen estable | A: Poisson + servicio exponencial | B: llegadas periódicas + servicio exponencial |
|---|---|---|
| Tasa media de llegada | 0,8 por hora | 0,8 por hora |
| Utilización temporal del servidor | 80 % | 80 % |
| Probabilidad de espera en una llegada | 80,0 % | 62,86 % |
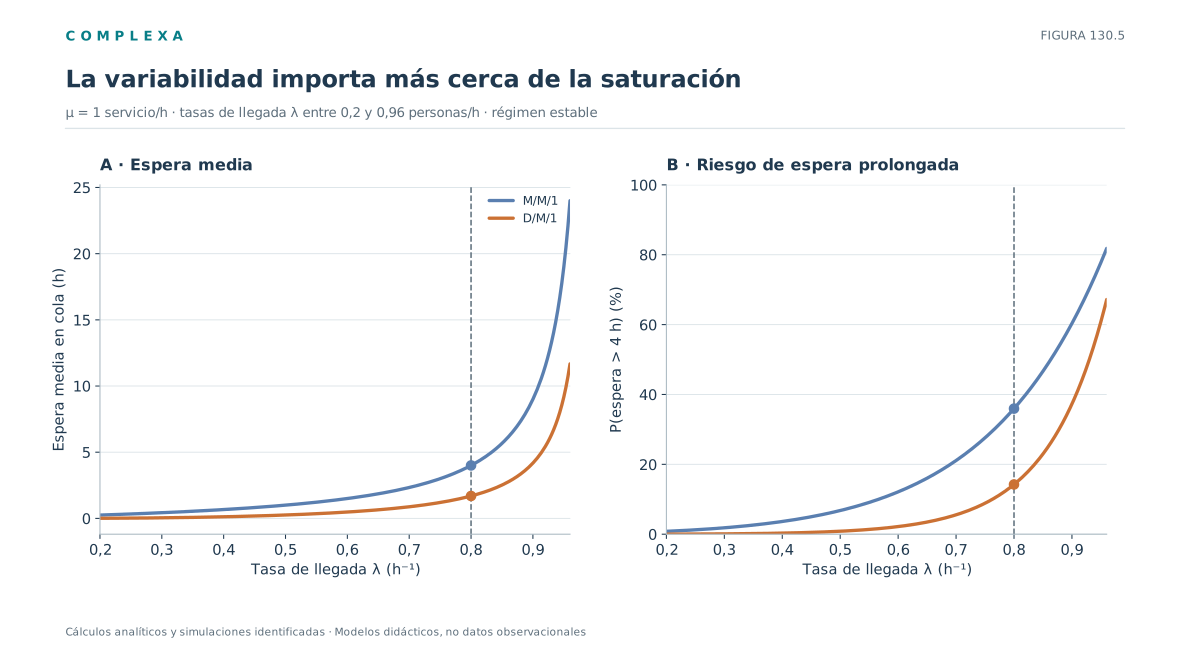
| Espera media en cola | 4,00 h | 1,69 h |
| Permanencia total media | 5,00 h | 2,69 h |
| Personas medias en el sistema, en el tiempo | 4,00 | 2,15 |
| Probabilidad de esperar más de 4 h | 35,95 % | 14,23 % |
| Percentil 95 de la espera en cola | 13,86 h | 6,82 h |
El número medio de personas en el sistema del modelo B se deduce de la ley de Little. Con una tasa efectiva de 0,8 por hora y una permanencia media de aproximadamente 2,69273 horas, obtenemos . Es un promedio a lo largo del tiempo, distinto de la esperanza del número de personas observadas justo antes de las llegadas, porque en el modelo periódico esas dos formas de muestreo no son equivalentes.
También puede calcularse el riesgo de una espera superior a cuatro horas. Para el modelo A,
Para el modelo B,
El evento es el mismo en ambos modelos y su probabilidad cambia sustancialmente. El percentil 95 también se reduce casi a la mitad. Una interpretación centrada solo en esperas medias perdería parte de esta información sobre las colas de la distribución. Si el problema práctico exige evitar esperas superiores a cierto umbral, la probabilidad de excedencia suele ser una magnitud directamente relevante.
Podría parecer contradictorio que la utilización del servidor sea idéntica mientras disminuyen las esperas. No lo es. La utilización mide qué fracción del tiempo se encuentra ocupado el servidor. La espera describe cuánto trabajo pendiente encuentra una persona cuando llega. Una secuencia regular puede distribuir las cargas de manera más favorable a lo largo del tiempo sin alterar la cantidad total de trabajo requerida.
La comparación no garantiza que cualquier calendario regular reduzca las esperas en una cantidad determinada. El resultado depende de que haya un servidor, independencia entre llegadas y atenciones, disciplina por orden de llegada y servicio exponencial. Cuando cambian esas condiciones, los valores numéricos deben volver a calcularse. El valor de la comparación está en aislar un mecanismo y mostrar su efecto dentro de una representación controlada.
130.6. Simulación independiente y pruebas de consistencia
Calcularemos ahora las esperas sin usar las fórmulas de las secciones anteriores. La recurrencia de Lindley solo necesita una secuencia de servicios y otra de intervalos entre llegadas. Generaremos quinientas mil atenciones potenciales, mantendremos la misma muestra de tiempos de servicio en los dos modelos y cambiaremos únicamente la serie de intervalos. Esta elección reduce parte del ruido en la comparación entre escenarios, aunque no elimina la variabilidad de Monte Carlo.
Descartaremos las primeras cincuenta mil observaciones para aproximarnos al régimen estable desde un sistema inicialmente vacío. El descarte es conservador para los parámetros escogidos, pero otros sistemas pueden requerir un calentamiento distinto. Es conveniente repetir el análisis con varios tamaños de muestra, semillas independientes y períodos de inicialización cuando se pretende estimar probabilidades muy pequeñas o cuando la utilización se aproxima a uno.
El código usa solo NumPy y la biblioteca estándar de Python. No hace falta simular cada instante de tiempo; el trabajo pendiente se actualiza solo en los instantes de llegada, exactamente como prescribe la recurrencia. Luego las estadísticas se comparan con las expresiones analíticas ya obtenidas.
import math
import numpy as np

rng = np.random.default_rng(20261012)
lam, mu = 0.8, 1.0
cantidad, calentamiento = 500_000, 50_000

servicios = rng.exponential(scale=1 / mu, size=cantidad)
intervalos_A = rng.exponential(scale=1 / lam, size=cantidad)
intervalos_B = np.full(cantidad, 1 / lam)

def esperas_lindley(intervalos, servicios):
    w = np.zeros(len(servicios), dtype=float)
    for n in range(1, len(servicios)):
        w[n] = max(0.0, w[n - 1] + servicios[n - 1] - intervalos[n - 1])
    return w[calentamiento:]

w_A = esperas_lindley(intervalos_A, servicios)
w_B = esperas_lindley(intervalos_B, servicios)

# Raíz no trivial de r = exp[-mu * a * (1 - r)] por bisección.
def raiz_periodica(lam, mu):
    a = 1 / lam
    lo, hi = 1e-12, 1 - 1e-8
    def f(x):
        return math.exp(-mu * a * (1 - x)) - x
    assert f(lo) > 0 and f(hi) < 0
    for _ in range(100):
        medio = (lo + hi) / 2
        if f(medio) > 0:
            lo = medio
        else:
            hi = medio
    return (lo + hi) / 2

rho = lam / mu
r = raiz_periodica(lam, mu)
teoria = {
    'A': (rho, rho / (mu - lam), rho * math.exp(-(mu - lam) * 4)),
    'B': (r, r / (mu * (1 - r)), r * math.exp(-mu * (1 - r) * 4)),
}

for nombre, muestra in [('A', w_A), ('B', w_B)]:
    simulacion = (np.mean(muestra > 0), muestra.mean(), np.mean(muestra > 4))
    print(nombre, 'simulado:', np.round(simulacion, 4))
    print(nombre, 'teórico: ', np.round(teoria[nombre], 4))

assert abs(w_A.mean() - teoria['A'][1]) < 0.6
assert abs(w_B.mean() - teoria['B'][1]) < 0.35
assert abs(np.mean(w_A > 0) - rho) < 0.03
assert abs(np.mean(w_B > 0) - r) < 0.03
assert w_B.mean() < w_A.mean()
Las comprobaciones programadas comparan magnitudes que podrían revelar errores distintos. Una discrepancia en la fracción de personas que esperan puede indicar un problema con la definición de la cola, el instante de observación o la actualización de Lindley. Una discrepancia solo en los tiempos medios puede deberse a una tasa de servicio equivocada, a una duración insuficiente del experimento o a variación muestral todavía considerable. Comparar además la proporción que supera cuatro horas permite verificar una propiedad de la cola que no queda determinada por el promedio.
Las tolerancias de las aserciones no son intervalos de confianza. Las esperas sucesivas dentro de una misma ejecución están correlacionadas, porque un período de congestión puede afectar a muchas personas consecutivas. Para cuantificar precisión de manera formal pueden usarse réplicas independientes, análisis de lotes suficientemente largos o métodos específicos para simulación estacionaria. El experimento muestra concordancia numérica con la teoría en el escenario elegido.
130.7. Sensibilidad y consecuencias operativas
Los resultados cambian sensiblemente si la demanda se aproxima a la capacidad. Manteniendo , aumentemos la tasa de llegadas a por hora. En el modelo M/M/1, la espera media en cola crece a horas. Para llegadas periódicas, el nuevo intervalo es aproximadamente 1,111 horas y la ecuación de la raíz produce . La espera media en cola del modelo D/M/1 aumenta a unas 4,18 horas. Sigue siendo inferior a la del sistema Poisson bajo estas hipótesis, pero ha crecido marcadamente respecto de la situación inicial.
Cuando , las fórmulas estacionarias usadas dejan de dar una distribución normalizable de la misma clase. En la frontera pueden persistir fenómenos de crecimiento de la cola por fluctuaciones, aunque la deriva media sea cero. Por encima de la capacidad, el trabajo pendiente aumenta a largo plazo en el modelo sin pérdidas y sin modificaciones del mecanismo. Un promedio de llegadas apenas superior al de servicio puede producir una evolución cualitativamente distinta. La condición de estabilidad debe comprobarse antes de presentar tiempos estacionarios como resultados operativos.
En una aplicación empírica habría que estimar la distribución completa de los intervalos entre llegadas. Importaría saber si existen franjas horarias de mayor intensidad, agrupamientos por transporte o apertura de agendas y diferencias entre días. Un proceso de Poisson homogéneo no permite variaciones sistemáticas de intensidad a lo largo del día. Uno no homogéneo podría representar parte de esa estructura, pero tampoco reproduce automáticamente dependencias entre llegadas ni eventos agrupados por una causa común.
La distribución de los servicios también requiere atención. Hemos usado tiempos exponenciales por su conveniencia analítica, ya que su desviación estándar iguala su media y el tiempo residual es independiente del tiempo ya transcurrido. En muchos servicios los tiempos de atención dependen del motivo de consulta o del profesional, pueden presentar colas amplias y están condicionados por tareas administrativas. Si el tiempo de servicio tiene mayor variabilidad, la espera puede aumentar incluso manteniendo constante su promedio. Modificar solo el patrón de llegadas no garantiza una mejora cuando existen otras fuentes dominantes de congestión.
El modelo tampoco incorpora personas que abandonan la espera, reprogramaciones, atención prioritaria o varias estaciones que comparten una misma cola. Incluir esas reglas cambia la definición de tiempo de permanencia, la tasa efectiva de atención y, en ocasiones, el espacio de estados. Si una persona se retira antes de ser atendida, por ejemplo, la tasa de llegadas al sistema ya no coincide necesariamente con la tasa de servicios completados. Aplicar la ley de Little exige entonces indicar con claridad qué población, qué frontera del sistema y qué tasa efectiva se están contabilizando.
Finalmente, el diseño de una intervención requiere distinguir predicción de causalidad. La comparación matemática muestra qué sucedería bajo dos mecanismos idealizados que difieren únicamente en la regularidad de las llegadas. En la práctica, convertir un servicio en un sistema de citas puede modificar también el número de personas que se presenta, la duración de las atenciones y el comportamiento de quienes esperan. Esos cambios deben incluirse en la evaluación, sin atribuir todo el resultado a la sola reducción de la variabilidad temporal.
El caso muestra que dos sistemas con la misma tasa media de llegada y el mismo tiempo medio de servicio pueden producir distribuciones de espera distintas. Para la configuración estudiada, la espera media en cola bajó de cuatro horas en el modelo Poisson a aproximadamente 1,69 horas con llegadas periódicas. La probabilidad de una espera superior a cuatro horas se redujo de 35,95 % a 14,23 %. Estas cifras, válidas para el régimen estacionario de modelos con un servidor, atención exponencial e independencia de los mecanismos especificados, se comprobaron mediante simulación de las secuencias de servicio y llegada.
La explicación está en el mecanismo temporal. Una tasa media es una propiedad agregada del proceso de conteo; no describe cómo se distribuyen los eventos dentro de cada intervalo. La cola retiene parte de esa historia porque una llegada puede encontrar trabajo acumulado por episodios previos. La recurrencia de Lindley describe exactamente esa memoria operativa. Para ciertas llegadas y servicios pueden deducirse distribuciones estacionarias; cuando no hay solución cerrada, puede conservarse la misma ecuación para simular y comparar escenarios con controles adecuados.
La solución también mostró dos maneras distintas de observar un proceso. El tiempo que el servidor permanece ocupado es una propiedad temporal y resulta igual en los dos modelos. La probabilidad de que una persona encuentre el servidor ocupado se define en los instantes de llegada y no necesariamente coincide con aquella fracción de tiempo. Para llegadas de Poisson independientes, PASTA iguala ambas magnitudes; para las llegadas periódicas del ejemplo, en cambio, difieren. La elección del instante de observación forma parte de la pregunta probabilística.
Con la misma capacidad media, la espera media en cola del modelo Poisson es más del doble que la del modelo periódico, de modo que la capacidad media no fija el grado de congestión. Para trasladar el cálculo a un servicio real habría que contrastar primero la distribución de intervalos, la variación horaria y las reglas de prioridad. La aproximación de atención exponencial es especialmente verificable, ya que sus hipótesis sobre tiempos largos y ausencia de memoria pueden compararse con datos observados antes de usar la predicción para dimensionar personal.
Referencias
- Asmussen, S. (2003). Applied Probability and Queues (2.ª ed.). Springer. Teoría de renovación, sistemas GI/M/1 y ecuaciones de espera.
- Gross, D., Shortle, J. F., Thompson, J. M., y Harris, C. M. (2008). Fundamentals of Queueing Theory (4.ª ed.). Wiley. Modelos M/M/1 y D/M/1 y medidas de desempeño.
- Kendall, D. G. (1953). Stochastic processes occurring in the theory of queues and their analysis by the method of the imbedded Markov chain. The Annals of Mathematical Statistics, 24(3), 338–354. Fundamento del análisis en instantes de llegada.
- Little, J. D. C. (1961). A proof for the queuing formula: . Operations Research, 9(3), 383–387. DOI: 10.1287/opre.9.3.383. Relación entre carga, flujo y permanencia.
- Ross, S. M. (2019). Introduction to Probability Models (12.ª ed.). Academic Press. Procesos de Poisson, renovación y colas de un servidor.
- Wolff, R. W. (1982). Poisson arrivals see time averages. Operations Research, 30(2), 223–231. DOI: 10.1287/opre.30.2.223. Propiedad PASTA y sesgo de muestreo en las llegadas.