Un programa de continuidad asistencial puede intervenir en momentos sucesivos: preparar una transición, mantener un responsable accesible y adaptar el seguimiento cuando cambian las necesidades. La evolución de la persona influye a su vez en la atención que recibe. Quienes empeoran pueden obtener más contactos, mientras que quienes mejoran pueden dejar de necesitar una intervención intensiva. Comparar retrospectivamente personas con muchos y pocos contactos mezcla el efecto de la atención con las circunstancias que produjeron esa atención.
La continuidad tampoco queda definida por el número de visitas. Haggerty y colaboradores (2003) distinguen dimensiones informacionales, de gestión y relacionales. Un registro puede mostrar encuentros frecuentes sin informar si los profesionales disponían de los antecedentes pertinentes o si existía un plan coherente. Antes de evaluar un efecto hay que convertir la pregunta general en una intervención concreta y describir lo que ocurre en su alternativa. La definición elegida determinará qué parte de la continuidad se estudia y qué datos hacen falta.
El caso que sigue es completamente construido. Sus ocho mil registros representan una distribución exacta generada mediante reglas públicas; no proceden de pacientes ni estiman la eficacia de un servicio. El propósito es resolver una evaluación en la que la necesidad asistencial cambia con la atención previa y orienta una decisión posterior. El diseño, las fechas, los estimandos y el mecanismo generador se fijaron antes de ejecutar el análisis. Los datos observados se conservaron separados de la información que permite conocer la verdad de la construcción.
Un programa definido en dos decisiones
Imaginemos adultos que inician una transición hacia seguimiento ambulatorio. Todos cumplen los criterios de elegibilidad el primero de enero de dos mil veinticinco, que será el día cero. La necesidad asistencial inicial se registra mediante una variable binaria : uno indica necesidad elevada y cero indica necesidad menor. Se trata de una clasificación hipotética utilizada para el ejemplo, sin pretensión de representar una escala clínica validada. La mitad de la población pertenece a cada categoría.
En el día cero se decide si se activa un módulo de coordinación durante los primeros treinta días. El módulo incluye un responsable identificado, transmisión del plan al servicio receptor y contacto proactivo durante ese periodo. Llamamos a su activación y a la atención usual sin ese módulo añadido. La alternativa mantiene disponibles los servicios habituales. Por tanto, el contraste no representa recibir atención frente a quedar completamente sin atención.
En el día treinta se vuelve a medir la necesidad, mediante , antes de tomar una segunda decisión. Se puede activar el mismo módulo para los días treinta a cincuenta y nueve; esa decisión se representa por . Activarlo en el segundo periodo es posible tanto si estuvo activo en el primero como si no. En esta construcción, cada módulo asignado se cumple íntegramente. No hay cancelaciones, contactos incumplidos ni variaciones ocultas de intensidad dentro de una misma categoría.
El calendario distingue los intervalos de sus puntos de decisión. El primer periodo comprende del uno al treinta de enero. El segundo comienza el treinta y uno de enero, día treinta, y termina el uno de marzo, día cincuenta y nueve. Desde el dos de marzo, día sesenta, todos siguen el mismo procedimiento posterior. El desenlace se evalúa el uno de abril, día noventa. Es un criterio binario hipotético de deterioro funcional, medido mediante la misma regla externa para todas las personas, independientemente de los contactos recibidos.
No se producen muertes, pérdidas de seguimiento ni exclusiones posteriores en la población construida. Esta simplificación hace que el desenlace esté definido y observado para todos en el mismo momento. Tampoco hay interferencia entre personas: activar un módulo no reduce la disponibilidad del programa para otra. Estas propiedades forman parte del diseño artificial. Si se trasladara la evaluación a un servicio con pérdidas, mortalidad o límites de capacidad, habría que introducir esas condiciones en la pregunta y en el análisis.
El estimando principal es la diferencia entre el riesgo si todos recibieran el módulo en ambos periodos y el riesgo si nadie recibiera el módulo añadido. Usaremos las etiquetas y para esas estrategias. También se fijaron comparaciones secundarias: activar solo el primer módulo, activar solo el segundo y una regla dinámica que inicia el módulo para todos y lo repite únicamente cuando la necesidad sigue elevada al día treinta. Todas las estrategias se evalúan en la misma población inicial y sobre el mismo desenlace del día noventa.
Que la segunda decisión ocurra en un día fijo permite definir sin ambigüedad la información que puede usar. Una regla que permitiera activar el módulo en cualquier momento durante una ventana necesitaría otra especificación. Habría que establecer qué ocurre antes de la activación, cómo se tratan las personas que aún no lo han iniciado y qué desenlaces se cuentan durante ese intervalo. Desplazar el comienzo del seguimiento hasta que cada persona complete el módulo cambiaría la población comparada. El protocolo del caso evita esa ambigüedad fijando tanto el momento de decisión como el periodo que cubre.
La asignación temporal se registra en el momento de cada decisión. No esperamos a observar cuántas visitas completó una persona para etiquetarla retrospectivamente como expuesta desde el inicio. El marco de ensayo objetivo de Hernán y Robins (2016) ayuda a alinear elegibilidad, estrategias, seguimiento y contraste causal. Hernán y colaboradores (2016) muestran además cómo su desalineación puede introducir sesgos. Si completar varias visitas exige sobrevivir hasta la última, definir el grupo con esa información puede producir tiempo inmortal. Nuestro ejemplo carece de ese mecanismo porque no hay muertes y las decisiones se codifican prospectivamente.
La ley que produce los registros
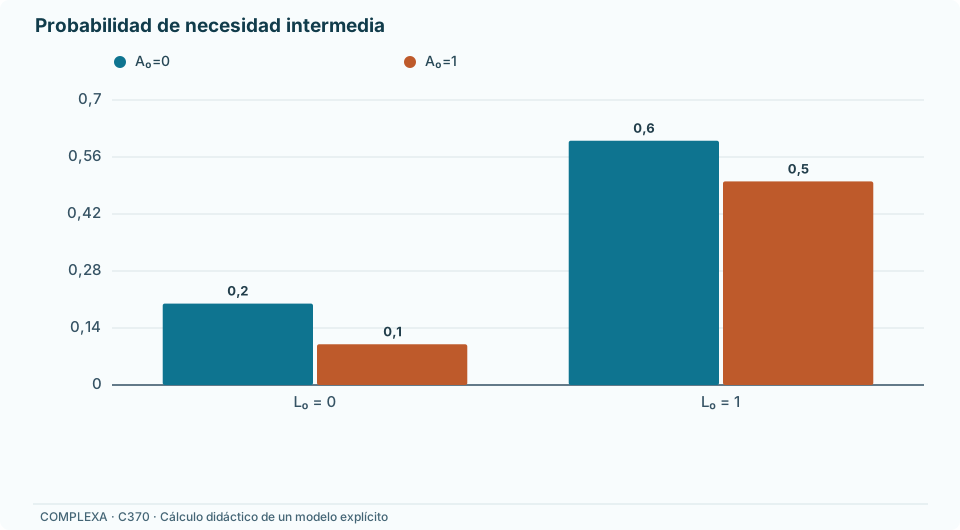
La asignación inicial depende de la necesidad basal. Entre personas con , una cuarta parte recibe el primer módulo; entre personas con , lo reciben tres cuartas partes. El primer módulo modifica la distribución de necesidad al día treinta. Las probabilidades de necesidad elevada son las siguientes:
| Necesidad inicial | Sin primer módulo | Con primer módulo |
|---|---|---|
| 0,20 | 0,10 | |
| 0,60 | 0,50 |
La segunda asignación responde a la necesidad actual. Cuando , la probabilidad de activar el segundo módulo es ; cuando , es . La historia anterior continúa registrada, aunque en esta ley concreta la segunda asignación solo depende de . Esta diferencia reproduce un mecanismo de priorización: las personas con mayor necesidad tienen más probabilidad de recibir coordinación adicional. La regla no se presenta como una política real ni como una recomendación.
El riesgo condicional del desenlace se define por
Cada módulo reduce el riesgo condicional en cinco puntos porcentuales, mientras que cada indicador de necesidad elevada lo incrementa en veinte puntos. El primer módulo tiene además una vía de influencia a través de la necesidad intermedia. Todos los riesgos de esta expresión quedan entre cero y uno. Existe una historia cuyo riesgo es cero; ello no implica que esa historia carezca de observaciones ni que se viole la positividad de las estrategias.
Para generar los datos se enumeran variables exógenas independientes que determinan necesidad, asignación y desenlace mediante umbrales enteros. Se recorren todas sus combinaciones, en lugar de extraer una muestra aleatoria. Así se obtienen exactamente las proporciones anteriores. La independencia impuesta al generador garantiza que, condicionando en la historia pertinente, la asignación no depende de factores pronósticos adicionales. En un registro real, esa intercambiabilidad secuencial sería un supuesto apoyado en conocimiento sustantivo, no una propiedad demostrable observando las frecuencias.
La base que recibe el estimador contiene treinta y dos celdas: todas las combinaciones binarias de , acompañadas por su frecuencia. La suma de las frecuencias es ocho mil. Una celda tiene frecuencia cero debido al riesgo nulo descrito; las dieciséis historias de covariables y tratamiento tienen frecuencia positiva. El archivo del analista no contiene las variables exógenas ni los desenlaces que cada persona habría tenido bajo otras estrategias.
El orden temporal explica la dificultad causal. La necesidad intermedia recibe una influencia del primer módulo y, a la vez, orienta el segundo módulo y predice el desenlace. Se produce la realimentación entre tratamiento y confusión descrita por Robins, Hernán y Brumback (2000). Ignorar deja confusión en la segunda decisión. Mantener su distribución fija al comparar las estrategias puede eliminar parte del efecto producido por la primera. Resolver el problema exige conservar ambas funciones de la variable.
Lo que muestra una comparación retrospectiva
Entre las personas que recibieron ambos módulos hay mil setecientos sesenta registros y quinientos cincuenta y seis desenlaces. Su riesgo observado es aproximadamente . Entre quienes no recibieron ninguno hay dos mil cuatrocientos ochenta registros y trescientos ochenta y cuatro desenlaces; su riesgo es aproximadamente . La diferencia cruda es de unos dieciséis puntos porcentuales en dirección desfavorable para el programa.
Esos grupos no representan las poblaciones que existirían si todos siguieran cada estrategia. Recibir ambos módulos es más probable cuando la necesidad inicial es elevada y cuando persiste necesidad al día treinta. Una parte del grupo con ambos módulos ha llegado a esa trayectoria precisamente por conservar un pronóstico peor. El grupo sin módulos concentra más historias de menor necesidad. Comparar sus resultados sin reconstruir cómo se asignó la atención atribuye al programa diferencias que preceden a sus decisiones.
La comparación retrospectiva tampoco incluye a quienes recibieron solo un módulo. No hay motivo para excluir esas historias al estimar el efecto de una política aplicada a toda la población inicial. Sus datos aportan información sobre riesgos condicionales, transiciones de necesidad y probabilidades de asignación. Los métodos longitudinales utilizan esa información para construir los contrastes pertinentes. La selección de una trayectoria observada y la intervención que impone una trayectoria son operaciones diferentes.
La dirección de la asociación cruda resulta llamativa porque el generador incluye efectos protectores de los módulos. Sin conocer ese generador, una reversión posterior del contraste no demostraría que el ajuste es correcto. La interpretación depende de que las variables medidas permitan comparar decisiones dentro de historias suficientes, de que las estrategias estén bien definidas y de que los procedimientos de estimación correspondan a esas condiciones. El ejemplo permite comprobar esos requisitos porque fueron impuestos y documentados antes del cálculo.
Reconstrucción por la g-fórmula longitudinal
Para una estrategia fija , definimos como el riesgo observado del desenlace dentro de esa historia. La g-fórmula utilizada es
La operación conserva la distribución basal de la población y deja que la necesidad intermedia cambie según el primer módulo impuesto. Después utiliza el riesgo correspondiente a cada historia y al segundo módulo elegido. Young y colaboradores (2011) desarrollan este principio para estrategias dinámicas y trayectorias más extensas. Aquí la suma tiene solo cuatro combinaciones de necesidad, por lo que se calcula exactamente con las frecuencias observadas, sin simulación de Monte Carlo ni modelos paramétricos ajustados.
La simplicidad de esa suma depende del tamaño de la historia. Con muchas mediciones continuas y decisiones frecuentes, la tabla de combinaciones crece y algunas historias pueden tener muy pocas observaciones. Entonces se suelen modelar las transiciones y los riesgos para compartir información entre historias. Ese paso introduce supuestos sobre las formas de las relaciones, además de los supuestos causales. Una predicción demasiado rígida de la evolución de la necesidad puede alterar la distribución que se integra bajo cada estrategia, aun cuando el modelo final del desenlace parezca ajustarse bien.
Bajo la estrategia , el riesgo entre quienes tenían necesidad basal menor es . Entre quienes tenían necesidad elevada es . Promediar ambos grupos con pesos iguales produce un riesgo de . El segundo término dentro de cada cálculo representa la mezcla de necesidad intermedia que aparecería sin el primer módulo.
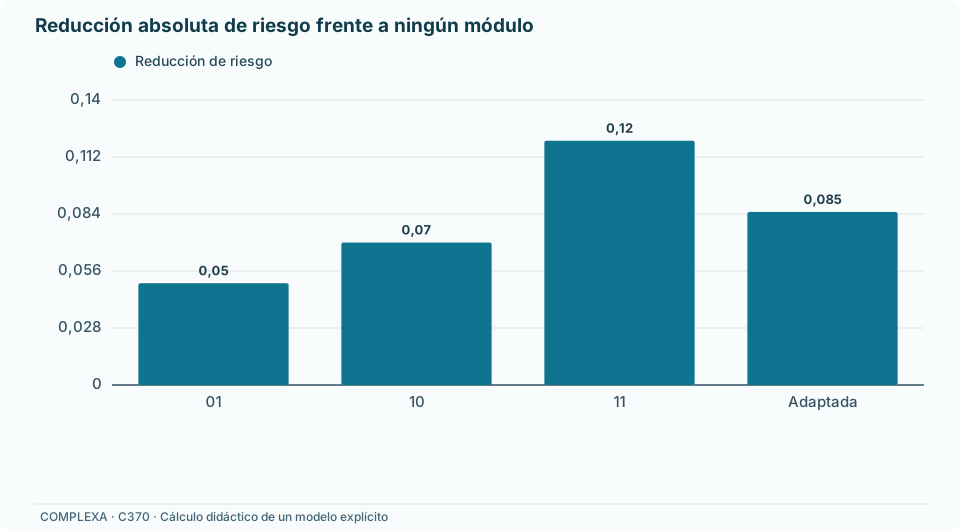
Bajo la estrategia , la necesidad elevada al día treinta tiene probabilidad de en el primer grupo y de en el segundo. Los riesgos resultantes son y , respectivamente. Su promedio es . La diferencia principal es, por tanto, : doce puntos porcentuales menos en la población construida. La razón de riesgos es , aproximadamente .
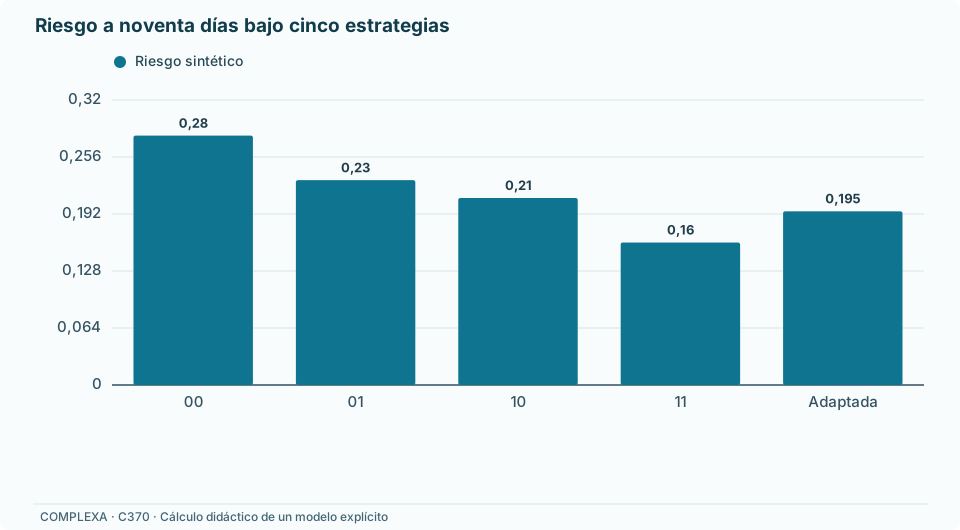
| Estrategia impuesta | Riesgo al día noventa |
|---|---|
| Ningún módulo, | 0,280 |
| Solo segundo módulo, | 0,230 |
| Solo primer módulo, | 0,210 |
| Ambos módulos, | 0,160 |
| Primer módulo y segundo según | 0,195 |
La diferencia entre los dos módulos aparece en las estrategias intermedias. Activar únicamente el segundo reduce el riesgo en cinco puntos respecto de no activar ninguno. Activar únicamente el primero lo reduce en siete. Además de su contribución condicional de cinco puntos, el primer módulo reduce en diez puntos la probabilidad de necesidad intermedia elevada; como esa necesidad añade veinte puntos de riesgo, la vía intermedia aporta otros dos puntos. La suma recupera los siete puntos del efecto total del primer periodo en este modelo.
Esta descomposición se apoya en la estructura aditiva específica del generador. No establece que una intervención real de coordinación tenga efectos aditivos ni que sus componentes puedan separarse sin más supuestos. En el caso construido, permite verificar de dónde procede cada término del contraste. Si la ecuación incluyera interacción entre necesidad y módulo, habría que promediar los efectos dentro de cada historia con su distribución correspondiente. La g-fórmula seguiría expresando esa operación, aunque el cálculo mental resultara menos sencillo.
La diferencia de doce puntos es un promedio poblacional. No identifica, a partir del registro observado, qué personas evitarían el desenlace ni quiénes responderían a un módulo concreto. Los riesgos bajo cada estrategia describen distribuciones marginales. Conocer el desenlace de una persona bajo dos estrategias incompatibles requeriría información que un seguimiento ordinario no proporciona. La tabla de verdad del generador contiene resultados potenciales por tipo porque fueron definidos artificialmente, pero esa información queda reservada para comprobar el ejemplo y no se atribuye al estimador.
Recuperación del mismo contraste mediante ponderación
La ponderación inversa proporciona otra ruta de estimación. Para una persona cuya historia sea compatible con la estrategia fija , el peso es
Las personas incompatibles reciben contribución cero para ese régimen. El riesgo se estima sumando el producto de desenlace y peso de las historias compatibles y dividiendo por el tamaño inicial de la población. También calculamos una versión normalizada por la suma de los pesos. En esta enumeración exacta, ambas versiones coinciden porque cada población ponderada suma ocho mil unidades.
Una historia poco frecuente bajo la asignación observada recibe mayor peso porque representa a más personas bajo la intervención. Para alguien con necesidad inicial menor que recibe el primer módulo y, teniendo necesidad intermedia menor, recibe también el segundo, la probabilidad de ambas decisiones es . Su peso es veinte. Para una persona con ambas necesidades elevadas que recibe ambos módulos, la probabilidad es y el peso es .
El peso no es el inverso de la probabilidad de toda la historia clínica. No se divide por la probabilidad de desarrollar necesidad intermedia elevada: esa evolución debe conservarse como una consecuencia posible del primer módulo. Se eliminan las diferencias producidas por el mecanismo de asignación, manteniendo la distribución de necesidad que corresponde al régimen. Esta distinción explica por qué ponderar adecuadamente no equivale a forzar que ambas estrategias tengan la misma proporción de .
Cole y Hernán (2008) explican la relación entre construcción de pesos, intercambio condicional, positividad y especificación de los modelos de asignación. En nuestro caso, las probabilidades se estiman por proporciones exactas dentro de cada historia; todas las decisiones comparadas tienen soporte. El análisis recupera los mismos cinco riesgos de la tabla mediante g-fórmula y ponderación. Esa coincidencia permite comprobar la implementación de dos expresiones, pero ambas seguirían dependiendo de los supuestos causales si los datos fueran observacionales reales.
Los diagnósticos conservan información sobre la distribución de los pesos. Para las cuatro estrategias estáticas, oscilan entre y veinte. La historia con menor frecuencia contiene veinte registros; no hay una historia de covariables y tratamiento vacía que exija extrapolar un riesgo desconocido. Al ponderar la estrategia , cada categoría de necesidad inicial representa cuatro mil unidades, mientras que las frecuencias relativas de necesidad intermedia elevada siguen siendo y dentro de ellas. La reconstrucción preserva así la evolución bajo el primer módulo.
También calculamos el índice , donde cada registro elemental cuenta una vez. En la tabla agregada se implementa como . Para la estrategia vale aproximadamente , frente a mil setecientos sesenta registros compatibles observados. Aquí describe concentración de las contribuciones; no es un tamaño muestral probabilístico ni autoriza un intervalo de confianza. La población se enumeró exactamente y carece del esquema de muestreo que tal interpretación requeriría.
No truncamos los pesos. Recortarlos modificaría las contribuciones y rompería la igualdad exacta que queremos comprobar. En estudios muestrales, limitar pesos extremos puede reducir variabilidad a costa de introducir sesgo, como discuten Cole y Hernán. Elegir ese procedimiento requiere documentar umbrales y examinar qué historias pierden representación. Un rango de pesos moderado tampoco demuestra ausencia de confusores omitidos: únicamente informa sobre las probabilidades estimadas a partir de la historia que se ha medido.
El ajuste que fija indebidamente la necesidad intermedia
Es tentador incorporar a una regresión y después comparar ambas estrategias manteniendo fija una única distribución de todas las covariables. En nuestro caso conocemos exactamente el riesgo de cada historia, de modo que podemos examinar ese error sin atribuirlo a un mal ajuste estadístico. Si promediamos los riesgos bajo y con la distribución conjunta observada de , obtenemos y . La diferencia es de diez puntos porcentuales, en lugar de los doce del contraste total.
La necesidad intermedia elevada tiene frecuencia global de en la población observada. Sin embargo, si nadie recibiera el primer módulo, esa frecuencia sería ; si todos lo recibieran, sería . Usar el mismo promedio de necesidad para las dos estrategias elimina esta diferencia. Los dos puntos que desaparecen son precisamente la contribución que viaja desde el primer módulo a través de la necesidad intermedia hasta el desenlace.
La distribución común puede corresponder a otra pregunta, pero no recupera automáticamente el efecto total de mantener el programa. Tampoco basta con denominar al resultado «efecto directo»: intervenir sobre una variable intermedia exige definir qué operación la fijaría y qué supuestos permitirían identificar ese contraste. En este ejercicio solo necesitamos reconocer que el cálculo conserva una mezcla que el tratamiento habría cambiado. El error está en la estandarización elegida, aunque los riesgos condicionales sean correctos.
Por otra parte, omitir toda la necesidad intermedia del análisis de la segunda decisión deja sin tratar su papel como causa de asignación y pronóstico. La solución longitudinal utiliza esa variable para comparar la segunda decisión dentro de historias adecuadas, y después integra las historias según la distribución que produciría cada primera decisión. Esto permite conservar el efecto de la intervención sobre la evolución sin ignorar cómo esa evolución determina la atención posterior.
Una regla que adapta el segundo módulo
La estrategia dinámica inicia el primer módulo en todos y asigna el segundo únicamente a quienes tienen necesidad elevada en el día treinta. Esta es una regla definida antes del análisis, que utiliza información disponible justo antes de decidir. No selecciona retrospectivamente a las personas que mejoraron ni anticipa su desenlace. Su evaluación mantiene el mismo punto de partida y la misma población que las estrategias estáticas.
Bajo el primer módulo, la proporción con necesidad elevada al día treinta es en la población conjunta. La estrategia dinámica activa por ello el segundo módulo para treinta por ciento de las personas. El riesgo promedio que obtendrían con solo el primer módulo es . Activar el segundo en ese treinta por ciento reduce el riesgo global en . El riesgo bajo la regla dinámica queda en .
La proporción utilizada para aplicar la regla debe proceder de la intervención inicial. Sustituirla por la frecuencia intermedia observada mezclaría personas que iniciaron el módulo y personas que no lo iniciaron. Aunque la segunda decisión tenga la misma definición en ambas operaciones, cambiaría la población de historias sobre la que se aplica. La adaptación requiere reconstruir primero esa evolución.
Frente a activar ambos módulos para todos, la regla dinámica presenta un riesgo superior en tres puntos y medio, y utiliza setenta puntos porcentuales menos de segundos módulos. En la construcción, esos números describen exactamente el intercambio entre ambas estrategias. No son una evaluación económica: no se asignaron costos, cargas para pacientes, preferencias o valor relativo al desenlace. Tampoco demuestran que esa regla sea óptima entre todas las reglas posibles. Es una comparación secundaria de dos intervenciones especificadas.
La ponderación de la estrategia dinámica conserva las historias con y . Sus pesos llegan hasta cinco y su índice descriptivo de concentración es dos mil cuatrocientos. La regla sigue decisiones que son relativamente frecuentes bajo la práctica generada: con necesidad elevada suele activarse el segundo módulo, y con necesidad menor suele omitirse. Por eso necesita menos contribuciones extremas que imponer el segundo módulo a todas las personas, incluidas aquellas que pocas veces lo reciben en los datos.
Una regla dinámica puede ser identificable aunque otras reglas carezcan de soporte. Si en un servicio jamás se retirara coordinación a una categoría de necesidad muy elevada, comparar una estrategia que exige retirarla allí dependería de extrapolaciones adicionales. Eso no impediría necesariamente estudiar otra regla que mantuviera la coordinación en esa categoría. La positividad se examina respecto de las estrategias que se comparan y de las historias que estas pueden producir, no como una cualidad única de toda la base.
Iniciar el programa y mantenerlo responden preguntas diferentes
Consideremos ahora intervenir únicamente en y dejar que la segunda decisión siga su mecanismo observado: probabilidad de activación de con necesidad menor y de con necesidad elevada. Este contraste representa el efecto del inicio con la continuación que genera esa práctica. No impone los dos módulos a la misma persona y no debe presentarse como equivalente a la estrategia .
Al iniciar el primer módulo, la frecuencia de necesidad elevada baja a . La probabilidad promedio de recibir el segundo queda en . El riesgo es entonces . Sin iniciar el primer módulo, la necesidad elevada tiene frecuencia de y la activación posterior alcanza . El riesgo correspondiente es .
La diferencia entre esos riesgos es de menos seis coma siete puntos porcentuales. Es menor en magnitud que la diferencia de doce puntos de mantener ambos módulos frente a no activar ninguno. Al dejar evolucionar la segunda decisión, una parte del grupo sin inicio recibe después el módulo porque conserva mayor necesidad. A la vez, algunas personas que comenzaron no lo reciben de nuevo porque su necesidad se ha reducido. La política posterior forma parte del efecto de iniciar que acabamos de definir.
Este cálculo también muestra por qué no se debe usar el término intención de tratar de manera automática en un registro. En un ensayo, la intención de tratar compara asignaciones iniciales. En datos observacionales, con frecuencia solo se registra el inicio, y su interpretación exige ajustar la confusión basal pertinente. Hernán y Robins (2016) distinguen estos objetos del efecto de seguir una estrategia durante el seguimiento. En nuestro generador, asignación y cumplimiento del módulo coinciden, pero el contraste de inicio deja deliberadamente libre la segunda decisión.
Qué permite comprobar la reproducción
El paquete del caso contiene un generador, un estimador y un verificador separados. El estimador abre únicamente la tabla de frecuencias observadas. Recupera las probabilidades de asignación, las transiciones de necesidad y los riesgos condicionales mediante sumas de esas frecuencias. No importa el generador ni lee la tabla de resultados potenciales. Esta separación evita que una coincidencia obtenida usando directamente la verdad se presente como una recuperación a partir de datos observados.
El verificador usa la información reservada para calcular los desenlaces bajo cada estrategia. Comprueba los riesgos de los cinco regímenes, el contraste de inicio, todas las celdas conjuntas observadas y las composiciones ponderadas. También verifica las fechas y la suma de frecuencias. Son ciento cinco controles numéricos y de estructura realizados por un programa separado del estimador, aunque escrito por el mismo autor. La revisión independiente del texto y del código constituye un control adicional, con alcance distinto.
No calculamos valores de significación ni intervalos muestrales. Los resultados son propiedades exactas de una población construida. Añadir filas duplicadas no aportaría información nueva y no debería transformar este ejercicio en evidencia clínica más precisa. Si se extrajera una muestra aleatoria del generador, podría estudiarse la variación estadística de los estimadores, pero ese sería otro experimento. Aquí interesa comprobar el estimando y el tratamiento de la evolución temporal sin mezclar esos problemas con fluctuaciones de muestreo.
La reproducción conserva tanto las fracciones exactas como los decimales comunicados. De ese modo se puede distinguir una discrepancia por redondeo de una diferencia en el cálculo. Las frecuencias agregadas representan personas elementales, no treinta y dos observaciones de igual peso. Tratar cada fila de la tabla como una persona alteraría la población, las probabilidades de asignación y el índice de concentración. El formato compacto facilita inspeccionar todas las combinaciones, pero su interpretación depende de mantener la columna de frecuencia en cada suma.
Para aplicar una evaluación semejante a un registro de servicios harían falta datos que el ejemplo da por disponibles. La necesidad del día treinta debería medirse antes de la decisión que pretende explicar; un campo completado después de asignar coordinación podría incorporar información posterior. La activación del módulo tendría que distinguirse de una visita atendida o de un intento de contacto. El desenlace requeriría una regla comparable entre grupos, para evitar que un mayor seguimiento aumentara simplemente la detección de dificultades.
También habría que examinar el contenido de la intervención. Dos módulos registrados con el mismo código pueden corresponder a responsables distintos, demoras diferentes o ausencia de transmisión efectiva del plan. Esa variación puede cambiar el significado de la consistencia entre la estrategia definida y la atención observada. Una evaluación de continuidad relacional necesitaría además información que nuestro módulo administrativo no contiene. El criterio operativo debe mantener una relación defendible con la experiencia asistencial que se quiere modificar.
La ausencia de interferencia es especialmente relevante al comparar una cobertura universal con una regla selectiva. Si mantener el programa para todos sobrecargara al mismo equipo, la calidad del módulo podría depender de cuántas otras personas lo reciben. En ese servicio, imponer la estrategia individual no bastaría para definir el resultado: habría que especificar recursos, capacidad y cobertura del conjunto. El caso presupone capacidad suficiente, de manera que su comparación dinámica no incorpora ese posible cambio de calidad. Una evaluación por equipos o servicios podría plantear una intervención sobre la organización completa, con otra unidad de asignación y otra estructura de dependencia.
El primer paso de una auditoría aplicada sería reconstruir una pequeña selección de trayectorias fechadas. Para cada una se comprobaría qué necesidad era conocida antes del primer módulo, qué había cambiado antes del segundo y qué información utilizó quien tomó esa decisión. Si una supuesta medición previa se registró después de activar el programa, esa trayectoria no respaldaría el ajuste temporal previsto. Corregir su orden o redefinir la variable tendría una consecuencia inmediata sobre la tabla de historias y las probabilidades de asignación que alimentan ambos estimadores.
Referencias
Cole, S. R., y Hernán, M. A. (2008). Constructing inverse probability weights for marginal structural models. American Journal of Epidemiology, 168(6), 656–664. https://doi.org/10.1093/aje/kwn164
Haggerty, J. L., Reid, R. J., Freeman, G. K., Starfield, B. H., Adair, C. E., y McKendry, R. (2003). Continuity of care: a multidisciplinary review. BMJ, 327(7425), 1219–1221. https://doi.org/10.1136/bmj.327.7425.1219
Hernán, M. A., y Robins, J. M. (2016). Using big data to emulate a target trial when a randomized trial is not available. American Journal of Epidemiology, 183(8), 758–764. https://doi.org/10.1093/aje/kwv254
Hernán, M. A., Sauer, B. C., Hernández-Díaz, S., Platt, R., y Shrier, I. (2016). Specifying a target trial prevents immortal time bias and other self-inflicted injuries in observational analyses. Journal of Clinical Epidemiology, 79, 70–75. https://doi.org/10.1016/j.jclinepi.2016.04.014
Robins, J. M., Hernán, M. A., y Brumback, B. (2000). Marginal structural models and causal inference in epidemiology. Epidemiology, 11(5), 550–560. https://doi.org/10.1097/00001648-200009000-00011
Young, J. G., Cain, L. E., Robins, J. M., O’Reilly, E. J., y Hernán, M. A. (2011). Comparative effectiveness of dynamic treatment regimes: an application of the parametric g-formula. Statistics in Biosciences, 3(1), 119–143. https://doi.org/10.1007/s12561-011-9040-7