Una asociación puede estimarse con mucha precisión y seguir dependiendo de una variable ausente. En una evaluación de servicios, esa variable podría representar la gravedad previa que no quedó registrada, las dificultades para desplazarse o el apoyo disponible fuera de la institución. Cada posibilidad describe un mecanismo distinto. La gravedad puede aumentar simultáneamente la probabilidad de recibir atención y la de presentar un desenlace adverso. El apoyo familiar puede favorecer el acceso y mejorar el desenlace por otras vías. Escribir que los resultados «podrían estar afectados por confusión residual» deja esas diferencias sin examinar. Un análisis de sensibilidad convierte alguna de ellas en un conjunto de supuestos que se puede modificar y cuyas consecuencias se pueden calcular.
La pregunta causal debe estar definida antes de introducir parámetros de sensibilidad. Supongamos una exposición binaria, un desenlace adverso observado al final de un plazo fijo y una población especificada. Interesa comparar el riesgo si todos recibieran la estrategia con el riesgo si todos recibieran la alternativa. Llamaremos a la estrategia recibida, al desenlace y a las características previas medidas. Una estimación ajustada por puede interpretarse causalmente si, además de las restantes condiciones del diseño, las variables ajustadas permiten comparar grupos intercambiables. La sensibilidad a confusión no medida estudia qué cambia cuando esa última condición necesita una variable adicional .
El ejercicio mantiene otras condiciones. Las estrategias deben corresponder a intervenciones suficientemente definidas; el registro del desenlace debe representar lo que se pretende medir; el seguimiento no debe seleccionar de manera inadvertida un grupo diferente del previsto. Variar un supuesto conserva los demás como parte del escenario. Por eso conviene identificar la amenaza que se está examinando antes de elegir una herramienta. Lash y colaboradores (2014) presentan el análisis cuantitativo de sesgos como una forma de explicitar su dirección, magnitud e incertidumbre. También permite localizar qué información adicional podría cambiar una conclusión. Su valor depende del vínculo entre los parámetros elegidos y el mecanismo que falta en los datos.
Una asociación que desaparece al observar la variable omitida
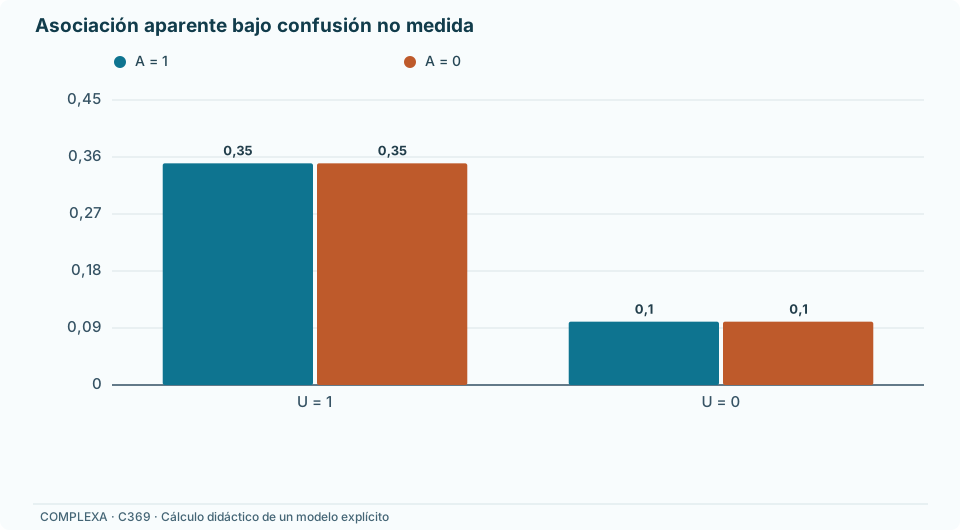
Consideremos una construcción didáctica con dos grupos de mil personas. Los números representan exactamente una distribución de probabilidades; no son observaciones clínicas ni una realización aleatoria. En el grupo con , ochocientas personas tienen y doscientas tienen . En el grupo con , esas cantidades se invierten. La variable omitida precede a la estrategia y aumenta el riesgo del desenlace. Dentro de cada categoría de , la estrategia carece de efecto: el riesgo es cuando y cuando , cualquiera que sea .
| Estrategia | Categoría omitida | Personas | Desenlaces |
|---|---|---|---|
| 800 | 280 | ||
| 200 | 20 | ||
| 200 | 70 | ||
| 800 | 80 |
El riesgo observado es en el primer grupo y en el segundo. Su razón es dos y su diferencia es de quince puntos porcentuales. La exposición parece asociada con un desenlace más frecuente porque concentra personas de mayor riesgo. En la población conjunta, la mitad tiene cada valor de . Al aplicar esa misma composición a ambas estrategias, el riesgo resulta en las dos. La razón causal es uno. Hemos fijado por construcción que, condicionado en , los riesgos observados corresponden a los riesgos bajo intervención; la tabla por sí sola no demuestra ese supuesto.
Un investigador que solo reciba e verá la razón observada de dos. No podrá reconstruir con esos datos la prevalencia de , su relación con el desenlace o la razón causal. La información revelada por el generador del ejemplo sirve para comprobar una posibilidad concreta: existe un mundo coherente en el que toda la asociación se explica por confusión. No implica que esa sea la explicación de cualquier estudio con la misma razón de riesgos. Otros mecanismos pueden producir exactamente los mismos márgenes observados.
Esta distinción separa dos trabajos. Si conocemos una variable omitida y podemos defender valores para sus prevalencias y riesgos, resulta posible especificar una corrección detallada. Si únicamente podemos limitar la intensidad de ciertas asociaciones, obtendremos una cota. La segunda opción usa menos información sobre el mecanismo y permite una familia más amplia de distribuciones. Su resultado puede ser más conservador que la corrección de un ejemplo particular. Confundir ambas operaciones lleva a atribuir al análisis una precisión que no contiene.
Qué significan los parámetros de una cota
Ding y VanderWeele (2016) desarrollaron una cota que resume la confusión mediante dos cantidades en escala de razones de riesgos. Para explicar su uso trabajaremos dentro de un único estrato de las covariables medidas, o en una población sin variación de esas covariables. Así evitamos mezclar razones condicionales con contrastes marginales. El primer parámetro mide el desequilibrio de las categorías de entre estrategias:
La dirección de esta razón está fijada. En nuestro ejemplo, para vale cuatro y para vale un cuarto; el máximo es cuatro. No estamos calculando la probabilidad de recibir la estrategia condicionada en , aunque esa probabilidad también podría describir el mecanismo de asignación. Tampoco usamos una correlación entre dos variables. Estos objetos no tienen la misma definición y no pueden intercambiarse en la fórmula.
El segundo parámetro resume cuánto puede variar el riesgo del desenlace entre categorías de , manteniendo fija la estrategia. Primero se divide el mayor riesgo por el menor dentro de cada brazo y después se toma el máximo de ambos resultados:
En la tabla vale . La definición permite que las asociaciones difieran entre brazos. No exige que sea una sola variable binaria: puede representar conjuntamente varios factores omitidos. Sin embargo, al usar una categoría conjunta muy detallada se comparan sus riesgos extremos. Interpretar ese máximo requiere considerar qué combinaciones de características existen y con qué frecuencia aparecen. Un cociente extremo y una diferencia frecuente en la población describen aspectos distintos del mismo problema.
Para una asociación observada superior a uno, el factor de acotación es
El contraste causal estandariza los riesgos de ambas estrategias a la misma distribución poblacional de dentro del estrato considerado. Su interpretación supone que incorporar resolvería la confusión pertinente. La cota no demuestra que la población observada sea representativa ni que el desenlace esté bien medido. El título del trabajo original, Sensitivity Analysis Without Assumptions, se refiere a la amplitud del tratamiento de los confusores omitidos, no a una inferencia causal desprovista de condiciones.
Con los parámetros del ejemplo, el factor es , aproximadamente . Al dividir la razón observada de dos obtenemos la cota inferior , aproximadamente . Este límite permite el valor nulo. No afirma que el efecto causal sea protector ni que su mejor estimación sea ese límite. Conocemos la construcción completa y sabemos que la razón causal es uno; su sesgo multiplicativo efectivo es dos. La cota admite distribuciones más desfavorables que la tabla particular y, por ello, deja un margen adicional.
El factor tiene otra utilidad cuando sus componentes se interpretan como límites superiores plausibles. Si ambas asociaciones estuvieran acotadas por dos, el factor máximo sería y la razón causal no podría quedar por debajo de , manteniendo las condiciones anteriores. Esa conclusión es condicional al límite elegido. Una medición externa que mostrara una asociación mayor invalidaría el argumento de robustez basado en ese límite, aunque los datos principales permanecieran intactos. Declarar las restricciones permite discutirlas con evidencia específica.
La cota inferior tampoco ofrece por sí sola un intervalo simétrico alrededor de la estimación. Responde a cuánto podría disminuir el contraste con el mecanismo considerado. Para estudiar aumentos, inversiones u otras direcciones de sesgo se deben plantear las restricciones correspondientes. Llamar «intervalo corregido» al espacio entre el límite y la estimación observada introduciría además una hipótesis sobre la dirección del efecto del sesgo que no se desprende automáticamente de la desigualdad.
Al comunicar el resultado conviene conservar la forma condicional de la afirmación: bajo determinados máximos de asociación, el contraste no puede caer por debajo de cierto valor. Esta redacción deja visibles los puntos que una revisión puede cuestionar. Una crítica puede dirigirse al máximo permitido, a la población usada para estandarizar o al supuesto de que el conjunto de variables descrito resolvería la confusión. Cada objeción modifica un componente distinto y puede evaluarse sin repetir toda la estimación observacional.
La fórmula usada aquí corresponde a razones de riesgos. El artículo tiene un erratum de 2018 que identifica una errata en una fórmula de diferencia de riesgos; no anuncia una modificación del factor anterior. La separación entre escalas importa también fuera de la revisión bibliográfica: una fórmula para un cociente no se convierte en una fórmula para una resta cambiando el nombre del resultado. Para evaluar diferencias absolutas hay que usar un desarrollo que conserve los riesgos de referencia y las restricciones propias de esa escala.
La restricción a un estrato medido merece conservarse al aplicar el resultado. Si una evaluación distingue niveles de gravedad previa, las prevalencias del factor omitido deben referirse a personas comparables en esa gravedad. Un apoyo social muy desigual entre los dos grupos completos podría resultar bastante parecido dentro de cada nivel. También puede suceder lo contrario: un promedio global puede ocultar un desequilibrio importante en uno de ellos. El parámetro residual responde a la información ya incorporada en el ajuste, de manera que su interpretación cambia cuando cambia el conjunto de covariables.
Cuando interesa un efecto marginal en toda la población, deben combinarse riesgos estandarizados con la distribución objetivo de las covariables. Promediar razones condicionales con pesos elegidos por comodidad no reproduce necesariamente esa operación. Una categoría con riesgo basal elevado aporta más desenlaces al denominador que otra de igual tamaño y riesgo pequeño. El análisis de sensibilidad tiene que seguir ese mismo procedimiento de estandarización o emplear un resultado que justifique directamente la cota marginal. En la construcción de este capítulo no aparece esa complicación porque todos pertenecen a un solo estrato medido.
El E-value y la frontera de las combinaciones posibles
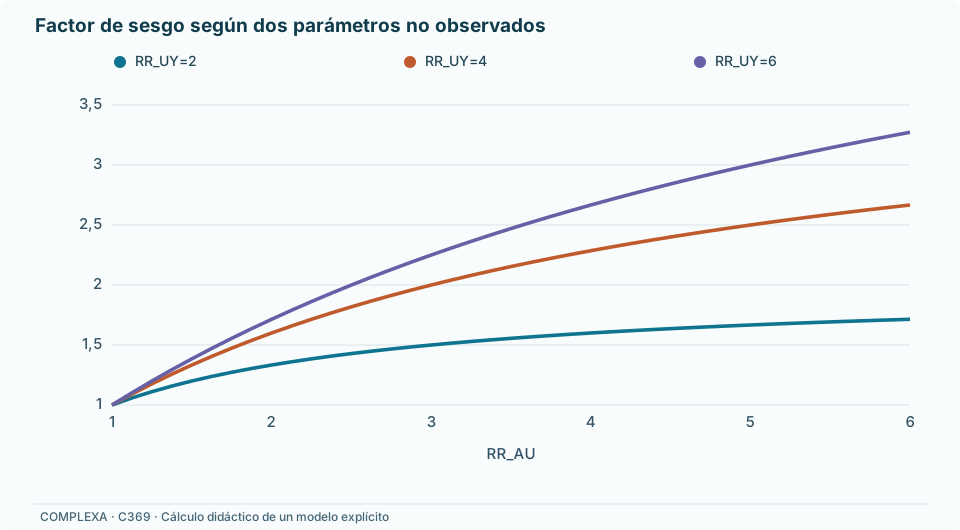
VanderWeele y Ding (2017) propusieron el E-value como un resumen de sensibilidad a confusión no medida. Para una razón de riesgos observada , su expresión es
Su interpretación se entiende al igualar las dos fortalezas de asociación. Si ambas valen , el factor de acotación es . Buscar el valor que permite reducir una razón observada de dos hasta uno equivale a resolver . La solución admisible es , aproximadamente . Con fortalezas iguales, ese es el umbral requerido para que el factor alcance dos.
La igualdad sirve para resumir una frontera; no describe necesariamente al confusor existente. Por ejemplo, una asociación de tres entre estrategia y confusor, junto con una asociación de cuatro entre confusor y desenlace, produce un factor de dos. La primera cantidad queda por debajo del E-value y la segunda por encima. Sería incorrecto afirmar que las dos deben superar individualmente . Para explicar completamente el contraste mediante la cota, al menos una debe alcanzar ese umbral, pero esa condición aislada no basta: importa la combinación de ambas.
También sería incorrecto concluir que una asociación de cuatro en un lado siempre elimina el efecto. Si la otra vale uno, el factor es uno. En ese caso falta una de las conexiones necesarias para producir confusión mediante este mecanismo. La superficie de sensibilidad muestra este comportamiento con más claridad que un único número. Cerca de una asociación nula con uno de los componentes, aumentar mucho el otro tiene un rendimiento limitado. Es la conexión entre asignación y pronóstico la que modifica la comparación.
Podemos describir la frontera sin dibujarla. Para que el factor sea exactamente dos, si fijamos la primera asociación en , la segunda debe valer . Con la primera en tres se necesita una segunda de cuatro; con la primera en cuatro basta una segunda de tres. Si la primera se acerca a dos desde arriba, la segunda requerida aumenta sin límite. Con una de las asociaciones igual a dos, ningún valor finito de la otra hace que este factor alcance dos. El umbral conjunto contiene, por tanto, información que se pierde al preguntar únicamente si algún factor omitido podría estar «fuertemente asociado» con el desenlace.
El objetivo de sensibilidad tampoco tiene que ser siempre el nulo. Supongamos que una razón causal inferior a cambiaría la interpretación sustantiva de una razón observada de dos. El factor que permitiría llegar a ese objetivo es . Al resolver el mismo problema con fortalezas iguales, el umbral resulta aproximadamente . Es menor que el requerido para explicar toda la asociación. Definir este objetivo antes de examinar los resultados permite evaluar la estabilidad de una conclusión concreta, como conservar un incremento de riesgo de cierta magnitud, sin reducir la discusión a la presencia o ausencia de cualquier efecto.
El E-value tampoco estima la probabilidad de que exista un confusor suficientemente fuerte. Esa probabilidad exigiría información o supuestos sobre su presencia y distribución. Una cifra grande puede corresponder a un mecanismo omitido conocido y plausible; una cifra menor puede resultar poco compatible con un contexto en el que se midieron bien las principales causas comunes. Las asociaciones relevantes son residuales respecto de las covariables ya ajustadas. Compararlas con asociaciones crudas publicadas en otra población puede exagerar o minimizar la amenaza.
Cuando la estimación es protectora, se invierte la razón antes de aplicar la fórmula. Una razón de produce así el mismo E-value que una razón de dos. Esta simetría del resumen multiplicativo no hace iguales las consecuencias absolutas. Reducir un riesgo de dos por ciento a uno por ciento y reducirlo de cuarenta a veinte por ciento arrojan la misma razón, con diferencias de riesgo muy distintas. El umbral de sensibilidad responde al contraste relativo elegido; una decisión que dependa de beneficios absolutos necesita conservar además esa información.
La fórmula escrita corresponde a riesgos acumulados en un plazo definido. Una odds ratio y una razón de riesgos pueden diferir considerablemente cuando el desenlace es frecuente. Una razón de tasas instantáneas describe otra comparación. Sustituir cualquiera de ellas directamente por requiere justificar la transformación o aproximación utilizada. Un resultado de regresión no identifica automáticamente la escala adecuada para el análisis causal posterior. Conviene volver a los riesgos y al horizonte que dieron origen a la pregunta.
Reconstruir mecanismos en lugar de elegir un único umbral
Podemos utilizar la misma asociación observada para construir escenarios más informativos. Sean y las prevalencias del confusor binario entre quienes recibieron cada estrategia. Supongamos que el confusor multiplica por el riesgo dentro de ambos brazos y que la estrategia multiplica por el riesgo en ambas categorías del confusor. Si es el riesgo bajo , los cuatro riesgos son , , y . Esta estructura impone ausencia de modificación del efecto en la escala multiplicativa. Se deben comprobar además probabilidades entre cero y uno.
La razón observada tiene entonces una descomposición exacta:
La fracción es el sesgo efectivo bajo este modelo. A diferencia del factor de acotación, usa las prevalencias de ambas categorías y una estructura específica para los riesgos. Al fijar y conservar la razón observada de dos, obtenemos varios escenarios:
| Sesgo efectivo | Razón causal | ||
|---|---|---|---|
| 0,40 | 2,0 | 1,167 | 1,714 |
| 0,60 | 3,5 | 1,667 | 1,200 |
| 0,80 | 3,5 | 2,000 | 1,000 |
| 0,80 | 5,0 | 2,333 | 0,857 |
Cada fila conserva los riesgos observados de y si elegimos . Los cuatro riesgos condicionales permanecen en el intervalo admisible. Por tanto, los cambios de la última columna no surgen de modificar el resultado observado. Se deben a diferentes distribuciones no observadas compatibles con él. En este modelo, la razón causal es cualquiera que sea la distribución común de utilizada para estandarizar, porque el mismo multiplicador relaciona los riesgos en ambas categorías.
La primera fila describe un confusor menos desequilibrado y menos asociado con el desenlace; queda un incremento causal del riesgo. La tercera reproduce el mundo nulo inicial. La cuarta representa un mundo en el que la estrategia reduce el riesgo dentro de cada categoría, pero la composición del grupo expuesto oculta esa reducción. Ninguna fila recibe mayor credibilidad por estar más cerca del resultado que el investigador esperaba. La elección requiere justificar prevalencias y asociaciones con conocimiento externo.
Una fuente útil puede ser una submuestra en la que se recuperaron antecedentes ausentes del registro principal. Si esa recuperación se hizo solo para personas con desenlace, la prevalencia obtenida no estima directamente la prevalencia entre todos los expuestos. Otra fuente puede ser un estudio previo en la misma población, siempre que las definiciones y el periodo sean comparables. El trabajo de trasladar información externa forma parte del análisis. Introducir sus valores en una fórmula no elimina el problema de transporte entre poblaciones.
La tabla también ayuda a priorizar nuevas mediciones. Si el debate se concentra en si la prevalencia entre expuestos se aproxima a cuarenta u ochenta por ciento, recuperar esa variable puede ser más útil que añadir observaciones del mismo registro incompleto. Si la prevalencia ya se conoce bien, pero su relación con el desenlace permanece incierta, hace falta otro tipo de evidencia. Esta lectura convierte la sensibilidad en una herramienta para diseñar la siguiente recogida de información, además de evaluar el resultado existente.
La codificación de la variable omitida impone una restricción adicional. Definir apoyo social como presente o ausente puede reunir situaciones muy diferentes: una ayuda estable, un contacto ocasional o una red que no puede intervenir durante una crisis. Los valores extremos del riesgo dentro de esas categorías no describen necesariamente los de una medición más detallada. Si se usa información externa para fijar el multiplicador del desenlace, debe mantenerse la definición de la variable o justificar su correspondencia. De lo contrario, el análisis puede parecer calibrado con evidencia y estar utilizando parámetros de otro objeto.
También conviene separar un escenario que describe un solo factor de otro que representa varios factores conjuntamente. Una prevalencia binaria sencilla resulta útil para explorar un mecanismo interpretable. No agota todas las combinaciones de causas ausentes. En cambio, una cota que permite un vector de confusores puede admitir configuraciones difíciles de traducir a una historia concreta. Se pueden presentar ambos niveles: una familia amplia delimitada por asociaciones y algunos mecanismos explícitos dentro de ella. El ejemplo inicial permite ver exactamente cuánto margen añade la familia más amplia respecto de una distribución especificada.
Incertidumbre del supuesto e incertidumbre de la muestra
Los escenarios anteriores describen distribuciones exactas. Una colección de razones causales compatibles con restricciones sobre el confusor es un conjunto de identificación o una región de sensibilidad, según la formalización empleada. No es un intervalo de confianza. Aunque se observara sin error toda la distribución de e , la variable omitida seguiría permitiendo varias explicaciones. Aumentar el tamaño de la muestra reduce cierta incertidumbre estadística; no decide cuál de esas explicaciones es correcta.
En datos muestrales se añade la variación de la estimación. Supongamos, en un ejemplo separado y puramente ilustrativo, que se comunica una razón estimada de dos con un intervalo de confianza de . No lo hemos calculado a partir de la tabla exacta anterior. El E-value de la estimación puntual es aproximadamente ; el correspondiente al límite más próximo al nulo es , aproximadamente . El segundo número responde a la fuerza de confusión necesaria para desplazar ese límite hasta uno bajo el procedimiento utilizado.
La diferencia entre ambos números tiene una interpretación precisa. Explicar completamente el valor puntual exige más sesgo que hacer compatible con el nulo un intervalo que ya se acerca a él. Si el intervalo incluyera uno, el E-value de ese intervalo sería uno. Eso no demostraría falta de efecto ni ausencia de confusión; señalaría que el nulo ya está incluido antes de introducir el parámetro de sesgo. El intervalo conserva la interpretación estadística de su método de construcción y sus supuestos.
Esta separación puede observarse al imaginar dos estudios con idénticas proporciones, pero tamaños distintos. Bajo un esquema de muestreo adecuado, el estudio mayor tendría menor incertidumbre estadística sobre las proporciones y la razón observada. El E-value de la estimación puntual seguiría siendo el mismo, porque su fórmula no incluye el tamaño de la muestra. La incertidumbre sobre las prevalencias del confusor ausente tampoco desaparecería por ese aumento. Si la nueva recogida de datos incluyera precisamente esa variable, sí cambiaría el problema: parte de lo que antes era un supuesto pasaría a ser información observada.
Un análisis probabilístico de sesgo incorpora distribuciones para los parámetros inciertos y propaga sus consecuencias. Su utilidad depende de explicar de dónde proceden esas distribuciones. Asignar más probabilidad a prevalencias moderadas que a prevalencias extremas agrega información que una simple cota no contiene. Si se simulan parámetros como si fueran independientes cuando provienen de una misma fuente, pueden generarse combinaciones poco defendibles. La salida refleja tanto los datos como esas decisiones de modelización; un percentil de las simulaciones no se convierte automáticamente en un intervalo de confianza convencional.
Hay una manera sencilla de mostrar lo que está en juego sin añadir una simulación. En el modelo binario anterior, elegir con igual frecuencia las cuatro filas equivale a imponer una distribución discreta sobre cuatro mecanismos. Duplicar la frecuencia de la fila nula cambiaría la distribución de resultados corregidos sin cambiar una sola observación principal. Esa modificación puede ser razonable si nueva evidencia favorece el mecanismo nulo. También puede ser arbitraria. Publicar los escenarios y sus pesos permite distinguir esas situaciones.
Sesgos que una cota de confusión no contiene
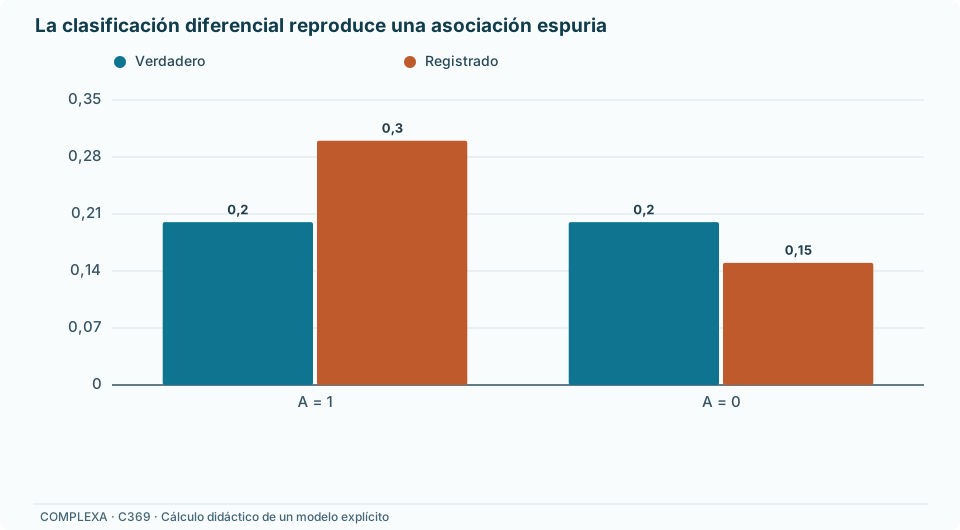
Construyamos ahora otro mundo con los mismos riesgos registrados, pero sin confusión. El riesgo verdadero del desenlace es bajo ambas estrategias. En el brazo expuesto, el registro identifica correctamente el noventa por ciento de los desenlaces verdaderos y clasifica como positivos al quince por ciento de quienes no los tienen. En el otro brazo, esas proporciones son cincuenta y cinco y cinco por ciento. Se trata de un mecanismo artificial de clasificación diferencial, no de una descripción de un instrumento clínico.
El riesgo registrado en el primer brazo es ; en el segundo es . Vuelve a aparecer una razón de dos, con razón causal verdadera igual a uno. El E-value calculado sobre el registro conserva su valor numérico, pero no cuantifica la amenaza que acabamos de introducir. El mecanismo depende de sensibilidad y especificidad de la medición. No hay un confusor que necesite satisfacer las dos asociaciones de la cota anterior.
Cuando se conocen esos parámetros de clasificación, el riesgo verdadero se relaciona con el registrado mediante
Si , puede despejarse . Aplicar los valores del ejemplo recupera en ambos brazos. El resultado depende de que los parámetros describan la medición en cada uno. Una validación conjunta que mezcle grupos con procedimientos diagnósticos diferentes podría ocultar precisamente la diferencia que produce el sesgo.
La selección requiere otra descripción. Si la entrada al análisis depende de la estrategia y de causas del desenlace, condicionar en estar observado puede abrir una asociación ausente en la población de partida. Para estudiar ese problema hay que especificar probabilidades de selección o restricciones relacionadas con ellas. Multiplicar varios factores de corrección obtenidos por separado necesita un modelo que justifique su combinación y su orden. Los mecanismos pueden compartir variables y modificar las distribuciones sobre las que actúa cada corrección.
La escala de los parámetros también cambia con el modelo de resultado. Cinelli y Hazlett (2020) desarrollan sensibilidad a variables omitidas en regresión mediante asociaciones expresadas con parciales. Esa parametrización pregunta por variación residual explicada, condicionada en las variables incluidas. Un porcentaje de varianza residual y una razón entre riesgos extremos no son magnitudes equivalentes. La elección del análisis debe conservar el modelo y el estimando del estudio; comparar valores numéricos de índices distintos sin sus definiciones carece de interpretación.
La palabra residual evita una confusión habitual en esa comparación. Un factor puede explicar una proporción elevada de la variación total de un desenlace y aportar poco después de incluir predictores relacionados con él. Lo relevante para una variable omitida es lo que aún falta después del ajuste. Al usar una covariable medida como referencia de intensidad, importa especificar qué otras variables se mantienen y en qué ecuación se calcula su asociación. Eliminar una variable del modelo y observar cuánto se mueve el coeficiente puede aportar una referencia, pero no demuestra que cualquier variable ausente deba ser más débil. Esa comparación exige conocimiento sobre la medición y sobre el proceso que produjo las ausencias.
Controles negativos y comprobaciones que pueden fallar
Un control negativo introduce una comparación cuyo efecto causal se supone nulo y que comparte un mecanismo de sesgo relevante con la comparación principal. Un desenlace de control no debe ser causado por la exposición. Una exposición de control no debe causar el desenlace principal. Además, hace falta justificar qué causas comunes o procesos de registro comparten. Estas condiciones, desarrolladas por Lipsitch, Tchetgen Tchetgen y Cohen (2010), distinguen un control informativo de una variable elegida simplemente porque su asociación parece improbable. Bots y colaboradores (2026) separan también los objetivos de detección, corrección y calibración, que requieren supuestos distintos.
Volvamos al confusor de la primera tabla. Imaginemos un desenlace de control que no responde a la estrategia, pero cuyo riesgo es con y con . La composición de los brazos produce riesgos de y . La asociación del control detectaría una diferencia compatible con ese confusor. Su magnitud no coincide con la asociación principal porque el confusor afecta de otra manera a cada desenlace. Restar o dividir directamente una asociación por otra necesitaría una relación cuantitativa adicional.
Ahora supongamos que elegimos como control una variable con riesgo de en ambas categorías de . Su asociación con la estrategia será nula, aunque la confusión del desenlace principal siga intacta. El control no comparte la conexión que debía investigar. Este ejemplo muestra por qué encontrar un resultado nulo no verifica que todas las causas comunes estén ajustadas. En una muestra finita se suma la posibilidad de no detectar una asociación existente, especialmente si el desenlace de control es infrecuente.
Usar un desenlace ocurrido antes de la exposición puede facilitar la defensa de ausencia de un efecto hacia atrás en el tiempo. Sin embargo, el proceso que generó ese desenlace previo podría influir en la decisión de iniciar la estrategia. Su relación con la exposición futura merece explicarse. La temporalidad resuelve una dirección causal concreta; no establece por sí sola que el control reproduzca la estructura de sesgo del desenlace posterior. Seleccionar el control después de comparar muchos resultados y conservar únicamente el que parece tranquilizador debilita todavía más la comprobación.
En el ejemplo inicial, una auditoría de antecedentes podría recuperar en una submuestra representativa y contrastar el desequilibrio supuesto de prevalencias. Una validación del desenlace por brazo podría investigar el mecanismo de clasificación. Un control negativo compatible con las causas omitidas podría aportar evidencia sobre confusión persistente. Cada operación informa una parte identificable del problema. Si la primera auditoría contradijera una prevalencia de ochenta por ciento entre expuestos, la fila nula de la tabla perdería apoyo; si la validación encontrara la clasificación diferencial descrita, habría que corregir la medición antes de interpretar la cota de confusión aplicada al registro.
Referencias
Bots, S. H., Schultze, A., Pajouheshnia, R., Douglas, I. J., Gini, R., Klungel, O. H., y Groenwold, R. H. H. (2026). Negative controls and how to use them: a guidance paper. International Journal of Epidemiology, 55(5), dyag163. https://doi.org/10.1093/ije/dyag163
Cinelli, C., y Hazlett, C. (2020). Making sense of sensitivity: extending omitted variable bias. Journal of the Royal Statistical Society: Series B, 82(1), 39–67. https://doi.org/10.1111/rssb.12348
Ding, P., y VanderWeele, T. J. (2016). Sensitivity analysis without assumptions. Epidemiology, 27(3), 368–377. https://doi.org/10.1097/EDE.0000000000000457
Epidemiology. (2018). Erratum: Sensitivity analysis without assumptions. Epidemiology, 29(3), e19. https://doi.org/10.1097/EDE.0000000000000807
Lash, T. L., Fox, M. P., MacLehose, R. F., Maldonado, G., McCandless, L. C., y Greenland, S. (2014). Good practices for quantitative bias analysis. International Journal of Epidemiology, 43(6), 1969–1985. https://doi.org/10.1093/ije/dyu149
Lipsitch, M., Tchetgen Tchetgen, E., y Cohen, T. (2010). Negative controls: a tool for detecting confounding and bias in observational studies. Epidemiology, 21(3), 383–388. https://doi.org/10.1097/EDE.0b013e3181d61eeb
VanderWeele, T. J., y Ding, P. (2017). Sensitivity analysis in observational research: introducing the E-value. Annals of Internal Medicine, 167(4), 268–274. https://doi.org/10.7326/M16-2607