Un curso de resolución de problemas mejora más el desempeño de quienes llegan con poca práctica que el de quienes ya dominan parte de las tareas. Sin embargo, las personas experimentadas se ofrecen con mayor frecuencia para participar en su evaluación. El ensayo puede comparar correctamente el curso con la actividad habitual y producir una estimación poco adecuada para decidir qué ocurriría entre quienes no participaron. La dificultad aparece al cambiar la población sobre la que se promedia.
Construiremos una evaluación didáctica con cuatro mil personas elegibles. Mil participan en el ensayo y tres mil quedan fuera. Se registra la experiencia previa de todas, pero el tratamiento y el resultado solo se observan entre participantes. Las cifras y respuestas que utilizaremos son inventadas para desarrollar los cálculos. El resultado será una puntuación de resolución de tareas, entre cero y cien, medida un mes después de la asignación. No representa un diagnóstico ni una mejoría clínica.
La decisión inicial consiste en valorar el mismo curso para las tres mil personas que no entraron en el ensayo. Esa precisión importa: calcular el efecto para ellas, para las cuatro mil elegibles o para cualquier persona que pudiera solicitar el curso en el futuro requiere promedios diferentes. Un resultado no adquiere una población de destino por llevar la etiqueta de ensayo aleatorizado.
Definir a quién pertenece el resultado
Usaremos para indicar participación en el ensayo y para indicar no participación dentro de la cohorte elegible. La letra identifica la asignación: uno corresponde al curso y cero a la actividad habitual. Entre participantes se asigna cada alternativa con probabilidad de un medio, independientemente de los resultados potenciales. La variable basal vale uno si existe experiencia previa y cero si no la hay.
El resultado potencial es la puntuación que obtendría una persona bajo la alternativa . La pregunta sobre quienes quedaron fuera se expresa mediante
El subíndice recuerda la población a la que pertenece la expectativa. El efecto entre participantes sería , mientras que el promedio entre todas las personas elegibles se escribiría sin condicionar por participación. Las tres cantidades comparan las mismas dos alternativas, con el mismo resultado y horizonte temporal. Cambia la distribución de personas sobre la que se calcula el promedio.
Suele reservarse «generalización» para extender la inferencia desde una muestra hacia una población que la contiene, y «transporte» para llevarla a otra población. Westreich y colaboradores (2017) emplean esta distinción al desarrollar la ponderación por odds de muestreo. La terminología tiene variaciones entre autores; especificar la población y la cantidad causal evita depender de esa etiqueta. En nuestra cohorte podemos estudiar tanto a todos los elegibles como al subconjunto no participante.
La elegibilidad tampoco equivale a la población completa de posibles usuarios. Si el ensayo excluyó a quienes no podían completar las tareas en el idioma utilizado, sus datos no describen automáticamente la respuesta de esas personas. Una definición amplia de destino puede incluirlas, pero entonces habrá que explicar de dónde proviene la información necesaria para ese grupo. Cambiar el encabezado de una tabla no amplía el soporte de los datos.
Supongamos que la respuesta media bajo cada alternativa depende de la experiencia según esta construcción:
| Experiencia previa | Participantes | No participantes | Media con actividad habitual | Media con curso |
|---|---|---|---|---|
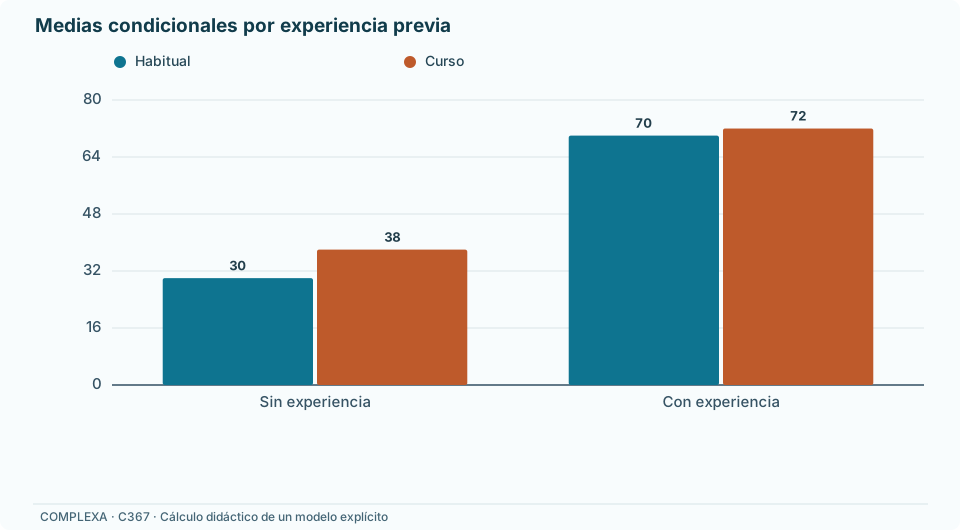
| No, | 200 | 2400 | 30 | 38 |
| Sí, | 800 | 600 | 70 | 72 |
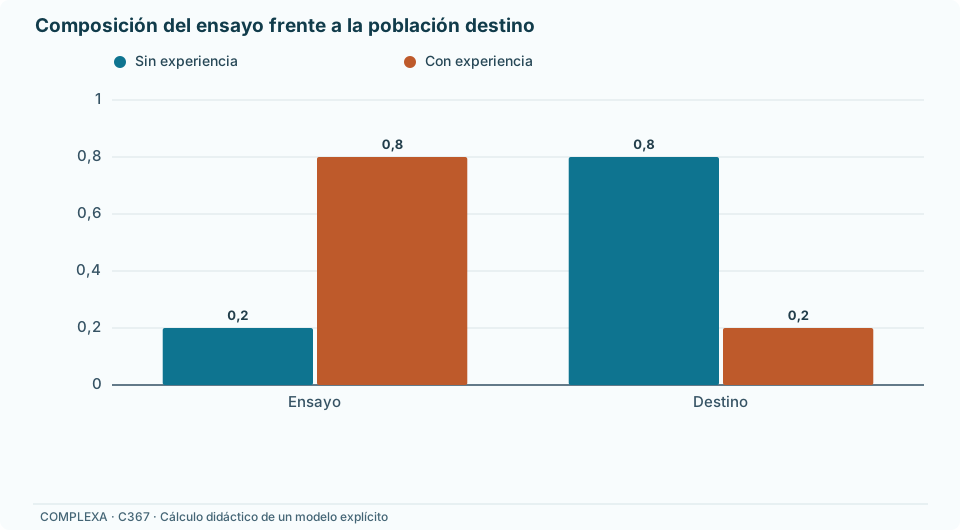
Por ahora suponemos que las dos medias de cada fila se conservan entre participantes y no participantes. Esa es una propiedad que hemos impuesto al ejemplo, no una conclusión producida por observar la tabla. Las personas sin experiencia mejoran ocho puntos y las experimentadas, dos. Entre participantes, cuatro de cada cinco tienen experiencia; entre no participantes, solo una de cada cinco.
Para las comprobaciones exactas asignaremos esos mismos resultados potenciales a todas las personas de cada fila. Así podemos seguir la ponderación sin añadir variación individual. En datos reales, estimaríamos medias de respuestas diferentes dentro de cada categoría.
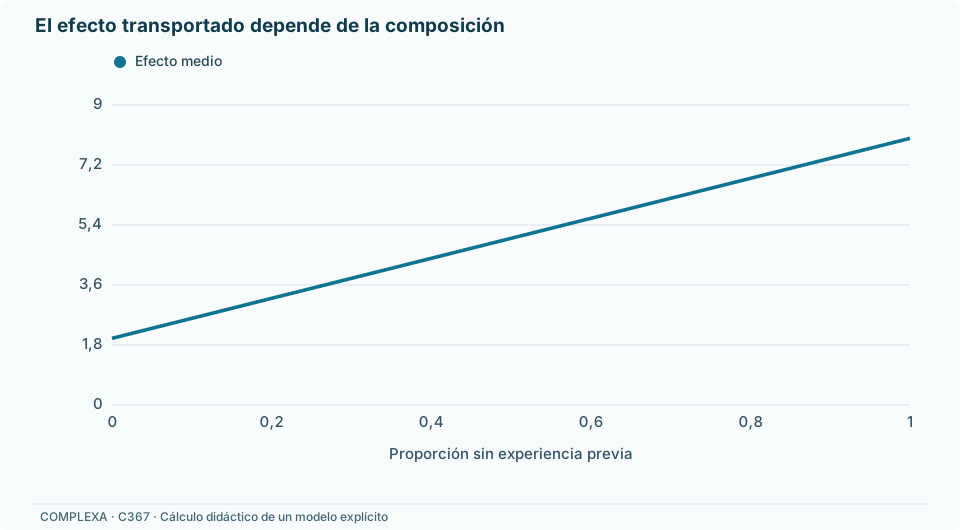
El efecto promedio del ensayo es tres coma dos puntos. El efecto para quienes quedaron fuera es seis coma ocho. La diferencia surge porque la población de destino contiene más personas de la categoría con mayor respuesta. El curso y los efectos dentro de cada categoría permanecen iguales. Cole y Stuart (2010) muestran cómo una estandarización hacia una población especificada puede abordar esta combinación de selección y heterogeneidad del efecto.
La selección por experiencia no bastaría por sí sola para cambiar el efecto promedio. En una variante, conservemos los resultados sin curso de treinta y setenta, pero hagamos que el curso añada cinco puntos en ambas categorías. Aunque el ensayo siga concentrando personas experimentadas, su efecto será cinco y el de destino también. Sus medias de resultado continuarán siendo distintas. La experiencia sigue prediciendo el desempeño, pero ha dejado de modificar el efecto en la escala de diferencias. Esta variante ayuda a decidir qué discrepancias entre poblaciones amenazan el contraste solicitado: una característica puede explicar grandes diferencias de pronóstico sin producir una diferencia de efectos.
En una investigación real no conocemos de antemano qué características modifican la respuesta. La ausencia de una interacción estadísticamente detectable en un ensayo pequeño tampoco demuestra uniformidad. Conviene combinar el conocimiento sobre el funcionamiento del curso con la precisión disponible para esas interacciones. Elegir variables únicamente porque presentan medias muy distintas entre archivos puede dejar fuera una característica moderadamente desequilibrada que cambie mucho la respuesta.
Qué autoriza a reutilizar las respuestas del ensayo
La aleatorización permite estimar las medias de resultado bajo ambas alternativas entre participantes. No distribuye al azar la participación misma. En nuestro ejemplo, la comparación interna no confunde el curso con experiencia previa, porque la asignación ocurre después del ingreso y utiliza el mismo mecanismo en ambas categorías. Aun así, el ensayo contiene una composición muy distinta de la población diana.
Para transportar cada media de resultado planteamos una condición adicional: entre personas con el mismo valor de experiencia, la media potencial bajo cada alternativa es igual a ambos lados de la selección. Escribiéndola explícitamente,
Esta igualdad debe sostenerse para cada alternativa y cada categoría que importe en destino. Puede resultar defendible cuando la experiencia recoge las diferencias relevantes entre participantes y no participantes. Puede fallar si, dentro de una misma categoría, difieren la disponibilidad para practicar, la calidad de la implementación o algún modificador de la respuesta que no fue medido.
La consistencia vincula el resultado observado con el resultado potencial correspondiente a la intervención efectivamente asignada. Aquí definimos el curso y su comparación con suficiente detalle, suponemos seguimiento completo y ausencia de interferencia entre personas. El transporte requiere que esa definición siga siendo pertinente en destino. Si el ensayo ofrece tutoría individual y la ampliación consiste en enviar materiales sin tutor, habrá cambiado una parte de la intervención cuyo efecto se está solicitando.
Participar en una evaluación también puede alterar la experiencia de ambas alternativas. Recibir recordatorios, acudir a mediciones repetidas o saber que alguien comprobará las tareas puede modificar el desempeño. Si esas condiciones están presentes únicamente en el ensayo, el indicador de participación recoge una diferencia del entorno además de la selección de personas. Añadir edad y experiencia al ajuste no elimina por definición esa diferencia. Hay que describir qué componentes del seguimiento acompañarán a la intervención cuando se amplíe y cuáles desaparecerán.
La importancia causal depende de cómo opere ese acompañamiento. Si añade exactamente el mismo número de puntos bajo ambas alternativas, las medias pueden dejar de transportarse mientras se conserva su diferencia. Si ayuda especialmente a completar las actividades del curso, puede cambiar también el efecto. Una evaluación del programa habitual y otra con seguimiento intensivo responden entonces a intervenciones distintas. Registrar el contacto recibido, sin tratarlo automáticamente como una covariable basal de ajuste, permite reconocer el contraste implementado. Su medición por sí sola no garantiza que podamos eliminar estadísticamente ese componente posterior a la asignación.
También hacen falta participantes en cada categoría presente en destino, y personas asignadas a cada alternativa dentro de esas categorías. Son dos condiciones de positividad distintas: participación y tratamiento. La primera garantiza que el ensayo pueda informar sobre una categoría; la segunda permite comparar sus alternativas. Dahabreh y colaboradores (2019) formulan estas condiciones para ensayos anidados en cohortes de personas elegibles.
Transportar una diferencia puede requerir menos que transportar sus dos medias por separado. Si el efecto medio dentro de cada categoría es igual entre participantes y no participantes, el promedio de esas diferencias puede trasladarse aunque ambos niveles de resultado cambien. Por ejemplo, sumar cinco puntos a los dos resultados potenciales de todas las personas no participantes conserva los efectos de ocho y dos. Ya no serían válidas las medias de destino calculadas con los niveles originales, pero seguiría siendo válido el efecto de seis coma ocho.
Esta distinción evita reclamar supuestos innecesarios y, a la vez, evita derivar más de lo supuesto. La igualdad de efectos dentro de categorías no autoriza a predecir por separado cuántos puntos obtendría la población con y sin curso. En los primeros cálculos utilizaremos la condición más fuerte de igualdad de ambas medias; al estudiar sensibilidad volveremos a la diferencia.
Estandarizar y ponderar la misma información
Definamos , la media observada del ensayo para una alternativa y categoría. La aleatorización, junto con las condiciones anteriores, permite calcular la media potencial de destino como
Primero se estima la respuesta dentro de cada categoría en el ensayo y después se promedia usando las proporciones de destino. Con actividad habitual, el cálculo combina treinta y setenta con pesos de ocho décimas y dos décimas: el resultado es treinta y ocho. Con curso, combina treinta y ocho y setenta y dos con los mismos pesos: cuarenta y cuatro coma ocho. Su diferencia es seis coma ocho.
El ensayo sin estandarizar habría dado medias de sesenta y dos y sesenta y cinco coma dos. Las puntuaciones medias de destino son menores bajo ambas alternativas, aunque la mejoría atribuible al curso sea mayor. Una población que obtiene resultados más bajos puede responder más al programa. Mezclar el nivel de resultado con el efecto del tratamiento ocultaría esta posibilidad.
La ponderación reconstruye el mismo promedio desde las filas del ensayo. A cada participante sin experiencia le corresponde un peso de cuatro, porque esa categoría representa ocho décimas del destino y dos décimas del ensayo. A cada participante experimentado le corresponde un peso de un cuarto. La razón general es
Las doscientas personas sin experiencia pasan a representar ochocientas unidades ponderadas; las ochocientas experimentadas representan doscientas. La distribución resultante coincide con las proporciones de destino. No se han creado observaciones ni medido resultados adicionales: se ha modificado cuánto aporta cada respuesta observada al promedio.
Podemos comprobar la comparación por brazo con una realización exactamente balanceada del sorteo. Cada brazo contiene cien participantes sin experiencia y cuatrocientos experimentados. Tras ponderar, contiene cuatrocientas y cien unidades, respectivamente. La media ponderada de la actividad habitual es treinta y ocho y la del curso, cuarenta y cuatro coma ocho. Esta igualdad con la estandarización es exacta para las medias y frecuencias construidas; las estimaciones obtenidas con modelos diferentes pueden no coincidir exactamente en una muestra real.
En la cohorte completa conocemos la probabilidad de participación de cada categoría. Llamándola , resulta un treceavo sin experiencia y cuatro séptimos con experiencia. La regla de Bayes relaciona esa probabilidad con la razón anterior:
Las odds inversas de participación son doce y tres cuartos. Como participa una cuarta parte de la cohorte, el último factor es un tercio, y recuperamos los pesos cuatro y un cuarto. Un factor común de escala no altera una media ponderada normalizada. Westreich y colaboradores (2017) desarrollan esta representación para llevar resultados hacia una población externa al ensayo.
Si el objetivo cambia a todas las personas elegibles, las proporciones relevantes son sesenta y cinco por ciento sin experiencia y treinta y cinco por ciento con ella. El efecto pasa a cinco coma nueve puntos. En este caso se utilizan probabilidades inversas de participación: trece y siete cuartos. Aplicadas a los recuentos del ensayo, reconstruyen dos mil seiscientas y mil cuatrocientas personas. Sustituir estas probabilidades inversas por odds inversas dirigiría el cálculo a otra población.
La probabilidad de tratamiento también forma parte de los pesos cuando varía entre categorías. Si es la probabilidad de asignar la alternativa dentro del ensayo, el peso para ese brazo incluye el factor . En nuestra construcción es siempre dos y se cancela al normalizar. Omitirlo en un sorteo con probabilidades diferentes podría deshacer la correspondencia entre la distribución ponderada y el destino previsto.
La población que permite describir cada archivo
Hemos conocido la cohorte completa y su participación. Muchas aplicaciones combinan, en cambio, un ensayo ya terminado con una encuesta de otra población. En ese diseño, la fracción de filas pertenecientes al ensayo depende de cuántos registros se decida incorporar. No es automáticamente la probabilidad real de que una persona de la población ingrese en el ensayo.
Puede estimarse una razón de distribuciones entre ambas fuentes, bajo un diseño de muestreo adecuado. Para medias normalizadas, ciertos factores constantes de muestreo se cancelan. Esa propiedad no resuelve una encuesta de destino que sobrerrepresente determinados grupos y se analice como si cada fila tuviera el mismo peso. Primero se necesita representar la distribución de la población diana, incorporando los pesos de encuesta o la información de diseño que corresponda.
Los criterios con que se extrajeron los registros deben acompañar al indicador de fuente. Un archivo formado exclusivamente por quienes ya usan el curso describe una población seleccionada por una decisión relacionada con el tratamiento. No equivale sin explicación a todas las personas que podrían utilizarlo. La elegibilidad, el momento de entrada y la condición de usuario deben separarse para saber qué promedio representa el análisis.
La medición compartida de la experiencia es igualmente necesaria. Si el ensayo la define mediante una prueba práctica y la encuesta mediante una pregunta sobre cursos previos, ambos archivos pueden usar el valor uno para personas diferentes. Obtener equilibrio perfecto en esa columna no restablece una categoría común. Una pequeña muestra medida con ambos procedimientos puede ayudar a estudiar la correspondencia; su utilidad depende de qué diferencias de clasificación permita identificar.
También importa la distribución conjunta. Añadamos una segunda característica basal: disponer de tiempo de práctica, indicada por una variable binaria. Construyamos otra población ilustrativa donde la mitad tiene experiencia y la mitad dispone de tiempo, tanto en el ensayo como en destino. Esas dos proporciones coinciden perfectamente. Sin embargo, en el ensayo cuatro décimas reúnen ambas características y cuatro décimas no tienen ninguna; las dos combinaciones restantes ocupan una décima cada una. En destino ocurre lo contrario: cada combinación discordante ocupa cuatro décimas y cada combinación concordante, una décima.
Supongamos ahora un efecto de dos puntos para todo el mundo, más ocho adicionales cuando coinciden experiencia y tiempo de práctica. El efecto del ensayo es cinco coma dos puntos; el de destino, dos coma ocho. Comparar por separado la media de experiencia y la disponibilidad de tiempo habría sugerido que no había nada que ajustar. El desacuerdo aparece en su combinación, que es precisamente donde opera la heterogeneidad de esta construcción.
Las cuatro combinaciones tienen soporte positivo. Sus pesos correctos serían un cuarto para cada combinación concordante y cuatro para cada discordante, usando las razones entre sus proporciones. Conocer únicamente los márgenes no determina esos pesos. En aplicaciones con muchas características, equilibrar todas las combinaciones puede ser inviable; entonces se necesita decidir qué interacciones o funciones son pertinentes para la respuesta. La revisión del equilibrio debe corresponder a esas funciones, y no limitarse a una colección de medias que omita la estructura que se intenta transportar.
El resultado también necesita una definición común. Una prueba resuelta inmediatamente después de la clase y otra un mes después describen horizontes distintos. Si las personas experimentadas retienen mejor lo aprendido, la modificación del horizonte puede cambiar tanto los efectos dentro de categorías como el promedio de destino. En ese caso, observar la distribución correcta de experiencia no permite convertir automáticamente el efecto inmediato en un efecto sostenido. Habría que disponer de seguimiento o justificar un modelo de evolución que aporte esa información.
Soporte suficiente y pesos concentrados
Incluso con soporte positivo, algunas categorías pueden estar representadas por muy pocas personas. En nuestro ensayo, los pesos cuatro y un cuarto hacen que una quinta parte de las observaciones aporte cuatro quintas partes del total ponderado. Un resumen descriptivo de esa concentración es el tamaño efectivo . Con los mil participantes resulta aproximadamente trescientos ocho.
Ese número describe la desigualdad de los pesos. Su relación con la varianza del efecto depende de los resultados, del diseño del sorteo y de cómo se estimaron los pesos. Tampoco equivale a disponer de trescientas ocho personas nuevas en destino. Sirve para advertir cuánto descansa el cálculo sobre las respuestas de un subconjunto del ensayo.
Podemos seguir la influencia de una observación en la realización balanceada. En el brazo del curso, la suma de pesos es quinientos. Si una puntuación sin experiencia se registrara diez puntos más alta, su peso cuatro elevaría la media ponderada en ocho centésimas. El mismo error en una persona experimentada, con peso un cuarto, la elevaría en cinco milésimas. La primera observación influye dieciséis veces más. La cuenta no supone que un grupo se mida peor: muestra dónde un error o una respuesta atípica tendría mayor repercusión sobre el estimador elegido.
Si todavía se puede planificar la incorporación, reclutar más personas sin experiencia reduce esta concentración. Un ensayo con ochocientas sin experiencia y doscientas experimentadas tendría la composición de nuestro destino y utilizaría pesos de representación iguales. No se deduce de ello que esa distribución sea óptima para cualquier objetivo: también importan la variación de resultados, los costes de reclutamiento y la precisión requerida en cada categoría. El destino previsto sí ofrece un criterio para advertir que seguir incorporando casi exclusivamente personas experimentadas deja poco resuelta la incertidumbre más relevante.
Recortar los pesos grandes puede mejorar estabilidad a costa de modificar la representación. Si reemplazamos el peso cuatro por dos y dejamos un cuarto para los experimentados, la distribución ponderada queda con dos tercios sin experiencia y un tercio con ella. Su efecto es seis puntos. El recorte ya no reconstruye la población de destino original, cuyo efecto era seis coma ocho bajo nuestros supuestos. Conviene informar qué cambió y estudiar el compromiso entre incertidumbre y sesgo respecto del objetivo fijado.
La ausencia completa de soporte plantea otra situación. Imaginemos una nueva población diana en la que una décima parte pertenece a una categoría de experiencia no representada en el ensayo. Las otras nueve décimas conservan las proporciones relativas de nuestra población anterior. Para ellas el efecto es seis coma ocho, pero desconocemos el efecto de la categoría nueva, que llamaremos .
El promedio de la población ampliada sería seis coma doce más una décima de ese efecto desconocido. Como la puntuación está acotada entre cero y cien, la diferencia individual puede situarse entre menos cien y cien. Utilizar solo esas cotas produce un intervalo de identificación desde menos tres coma ochenta y ocho hasta dieciséis coma doce. No es un intervalo de confianza: expresa cuánto puede variar el efecto manteniendo fija la información disponible y dejando libre la categoría ausente.
Suponer que el efecto de esa categoría está entre cero y diez estrecha el intervalo a seis coma doce y siete coma doce. El estrechamiento procede de una nueva restricción sustantiva. Un modelo de regresión que asigne automáticamente una respuesta al grupo ausente también incorpora una extrapolación, aunque no la presente en forma de cota. Otra posibilidad es redefinir la pregunta para la parte de destino que sí tiene soporte, dejando claro a quiénes excluye.
Combinar modelos sin convertirlos en supuestos causales
Con varias características basales, estimar una media para cada combinación puede requerir más datos de los disponibles. Un modelo de resultados permite compartir información entre categorías; un modelo de participación permite construir pesos sin estimar por separado cada frecuencia. Ambas decisiones introducen condiciones de estimación además de las condiciones causales ya declaradas.
Dahabreh y colaboradores (2019) desarrollan estimadores aumentados que combinan predicciones y residuos ponderados. La idea puede entenderse sin identificar el modelo ajustado con el mecanismo real. Se predice el resultado bajo cada alternativa para la población diana y se corrige esa predicción con las discrepancias observadas en participantes comparables. Para el destino no participante, una expresión es
donde cuenta a las personas no participantes y el indicador selecciona el brazo pertinente. La primera suma extrapola las predicciones a destino; la segunda utiliza los residuos del ensayo para corregirlas. El tratamiento se pondera con su probabilidad conocida de asignación.
En nuestra tabla exacta, supongamos un modelo de resultados muy pobre que predice cincuenta puntos para todo el mundo bajo ambas alternativas. La predicción sola daría un efecto nulo. Con las probabilidades correctas de participación, la corrección promedio es menos doce puntos para la actividad habitual y menos cinco coma dos para el curso. Las medias corregidas vuelven a treinta y ocho y cuarenta y cuatro coma ocho.
Si las predicciones de cada celda son correctas en esta construcción determinista, los residuos son cero y la estandarización recupera el destino aun usando un modelo incorrecto de participación. En cambio, combinar la predicción constante de cincuenta con una probabilidad de participación constante de un cuarto devuelve las medias del ensayo, sesenta y dos y sesenta y cinco coma dos. Equivocarse en ambos modelos no produce una corrección automática.
La doble robustez se refiere a consistencia bajo la correcta especificación de uno de los modelos pertinentes, manteniendo las condiciones de identificación y las condiciones estadísticas necesarias. No asegura exactitud en cualquier muestra pequeña ni protege frente a un modificador del efecto ausente de ambos archivos. La incertidumbre debe incorporar la estimación de resultados y participación, así como el muestreo de destino cuando su distribución también se estima.
Una comprobación práctica separa esas fuentes. Si las tres mil personas no participantes están enumeradas completamente, sus proporciones de experiencia son conocidas para esa población finita. Aún habrá incertidumbre sobre las respuestas contrafactuales que se estiman desde el ensayo. Si, en cambio, se dispone de una encuesta pequeña del destino, también fluctúan las proporciones utilizadas para promediar. Tratar los pesos calculados una sola vez como constantes puede omitir parte de esa variación. Un procedimiento de remuestreo debe respetar qué unidades se muestrearon juntas y volver a ajustar los componentes estimados que forman parte del análisis.
Lo que el equilibrio entre poblaciones deja sin decidir
Volvamos a las dos categorías originales. Hay otra población posible con los mismos datos observados: las respuestas del ensayo permanecen intactas y las proporciones de destino también, pero las personas no participantes sin experiencia pierden dos puntos con el curso en lugar de ganar ocho. Las experimentadas siguen ganando dos. El efecto de destino sería entonces menos uno coma dos puntos.
Ambas explicaciones producen exactamente la información que hemos supuesto disponible: resultados y asignación en el ensayo, experiencia en destino. Incluso podríamos conservar iguales los resultados sin curso en destino. La discrepancia aparece en su respuesta no observada al curso. Balancear la distribución de experiencia no permite elegir entre esas explicaciones. Para descartarla hace falta justificar la estabilidad de la respuesta o incorporar evidencia que la examine.
Una manera de hacer visible esa dependencia es definir como la diferencia entre el efecto de destino y el del ensayo dentro de cada categoría. El efecto solicitado se escribe entonces como seis coma ocho más ocho décimas de y dos décimas de . Si se consideran plausibles discrepancias de hasta dos puntos sin experiencia y uno con experiencia, el efecto queda entre cinco y ocho coma seis. Es un análisis de sensibilidad condicionado a esas magnitudes, que deben justificarse, no probabilidades inferidas de la tabla.
Los diagramas de selección de Pearl y Bareinboim (2014) ofrecen otra forma de expresar dónde podrían cambiar los mecanismos. Sus nodos de selección señalan variables cuyo proceso generador puede diferir entre entornos. No son, por definición, el indicador observado de participación que aquí llamamos . Mantener separados ambos usos evita interpretar cualquier cambio de archivo como una intervención sobre una variable del sistema.
Cuando solo cambia la composición de una característica basal y se conserva la respuesta causal condicionada por ella, la estandarización tiene una justificación gráfica. Si cambia el mecanismo que transforma el curso y la experiencia en desempeño, esa misma operación puede dejar de identificar el efecto. El diagrama organiza la información causal que se está suponiendo; los datos de cada fuente aportan las distribuciones necesarias una vez justificada su combinación.
La escala del efecto también forma parte de ese argumento. En una ilustración binaria independiente de la puntuación anterior, supongamos una probabilidad de éxito sin curso de una décima y con curso de dos décimas en origen. La razón es dos y la diferencia, una décima. Si en destino la probabilidad sin curso es tres décimas, transportar la razón dos produce seis décimas con curso y una diferencia de tres décimas. Transportar, en cambio, la diferencia original produciría cuatro décimas.
Dahabreh, Robertson y Steingrimsson (2024) estudian esta distinción entre transportabilidad de medidas relativas y de diferencias. La igualdad de una razón no establece la igualdad de una diferencia cuando cambia el nivel basal. Para calcular la probabilidad de destino usando solo una razón transportada se necesita además información sobre su resultado bajo la comparación, identificada con los supuestos correspondientes. Decidir qué escala permanece estable exige conocimiento del problema.
Finalmente, la propia etiqueta del curso puede reunir versiones distintas. Supongamos que una versión con práctica guiada aporta ocho puntos y otra sin esa práctica aporta dos, manteniendo lo demás fijo. Una mezcla con tres cuartas partes de la primera tiene efecto medio seis coma cinco; una mezcla con una cuarta parte tiene efecto tres coma cinco. Igualar la distribución basal de participantes no iguala esas mezclas de intervención. Hernán y VanderWeele (2011) explican por qué los tratamientos compuestos requieren especificar qué versiones se implementan y con qué distribución.
Para la ampliación inicial, el informe puede presentar los seis coma ocho puntos junto con la población de tres mil no participantes, las categorías utilizadas y la versión del curso evaluada. Antes de aplicarlo en nuevos centros conviene verificar que la experiencia se mide del mismo modo y que la práctica guiada prevista coincide con la del ensayo. Si aparece la categoría ausente, el siguiente tramo de evaluación puede incorporar participantes de ese grupo. La nueva información permitirá sustituir su efecto desconocido en el promedio, conservando explícita la población a la que responde la decisión.
Referencias
Cole, S. R., y Stuart, E. A. (2010). Generalizing evidence from randomized clinical trials to target populations: The ACTG 320 trial. American Journal of Epidemiology, 172(1), 107–115. https://doi.org/10.1093/aje/kwq084
Dahabreh, I. J., Robertson, S. E., Tchetgen Tchetgen, E. J., Stuart, E. A., y Hernán, M. A. (2019). Generalizing causal inferences from individuals in randomized trials to all trial-eligible individuals. Biometrics, 75(2), 685–694. https://doi.org/10.1111/biom.13009
Dahabreh, I. J., Robertson, S. E., y Steingrimsson, J. A. (2024). Learning about treatment effects in a new target population under transportability assumptions for relative effect measures. European Journal of Epidemiology, 39(9), 957–965. https://doi.org/10.1007/s10654-023-01067-4
Hernán, M. A., y VanderWeele, T. J. (2011). Compound treatments and transportability of causal inference. Epidemiology, 22(3), 368–377. https://doi.org/10.1097/EDE.0b013e3182109296
Pearl, J., y Bareinboim, E. (2014). External validity: From do-calculus to transportability across populations. Statistical Science, 29(4), 579–595. https://doi.org/10.1214/14-STS486
Westreich, D., Edwards, J. K., Lesko, C. R., Stuart, E. A., y Cole, S. R. (2017). Transportability of trial results using inverse odds of sampling weights. American Journal of Epidemiology, 186(8), 1010–1014. https://doi.org/10.1093/aje/kwx164