Una decisión puede parecer conveniente durante la primera semana y dejar de serlo cuando se considera lo que será posible hacer después. Un programa intensivo puede mejorar rápidamente una habilidad, pero consumir recursos que una intervención posterior, dirigida únicamente a quienes todavía necesitan ayuda, habría utilizado con mayor rendimiento. Para elegir la secuencia hay que considerar cómo cada acción modifica la información y las opciones de las decisiones siguientes.
Una estrategia dinámica especifica esas decisiones mediante reglas. La regla indica qué hacer cuando llega el momento de actuar y se conoce una determinada historia. Dos personas pueden seguir la misma estrategia y recibir acciones distintas porque sus trayectorias difieren. También pueden recibir hoy la misma acción siguiendo estrategias diferentes, cuyas instrucciones se separarían si mañana apareciera una dificultad.
Murphy (2003) formuló la búsqueda de estrategias óptimas como un problema de decisiones sucesivas. El objetivo es comparar los resultados que producirían reglas completas, incluidas sus respuestas a estados que todavía no han ocurrido. En salud, esas reglas pueden organizar revisiones y cambios de una intervención; los ejemplos numéricos siguientes utilizarán un programa de formación enteramente inventado. Sus puntuaciones son utilidades didácticas y no representan efectos clínicos.
La historia que una regla puede utilizar
Consideremos dos decisiones. Antes de la primera se observa información inicial , y se elige una acción . Después se registra una nueva observación y se elige . Las historias disponibles son y . Una estrategia determinista indica las acciones mediante
La palabra disponible tiene una consecuencia práctica. Una evaluación corregida al final del programa no puede utilizarse para justificar una decisión que debía tomarse antes de recibir esa corrección. Tampoco puede emplearse retrospectivamente la mejoría futura como criterio para escoger quién habría necesitado apoyo. La regla debe funcionar con la información que existiría en el momento de aplicarla.
La historia incluye acciones anteriores porque una misma observación puede tener significados distintos según cómo se alcanzó. Una puntuación intermedia idéntica después de una intervención breve o de varias sesiones intensivas puede implicar posibilidades de respuesta diferentes. Usar solamente la última medida constituye una simplificación que necesita justificación. La formulación general no exige que esa medida resuma todo el pasado relevante, como explica la revisión de Chakraborty y Murphy (2014).
Una regla puede utilizar un resumen de la historia para ser aplicable. Por ejemplo, puede emplear la puntuación actual y el número acumulado de sesiones. Hay dos decisiones distintas: qué información se conserva para justificar la comparación causal y qué información se permite usar a la regla. Podemos necesitar ajustar por una historia detallada para evaluar una estrategia sencilla. Restringir la regla a dos variables no autoriza a ignorar las demás causas de asignación al estimar su valor.
También deben definirse los casos difíciles. «Ofrecer apoyo si la puntuación es baja» deja sin resolver qué significa baja, cuándo se mide y qué hacer si falta la medición. Una versión operativa puede fijar un umbral, una ventana de observación y una acción cuando el resultado no está disponible. Esa acción para información ausente es parte de la estrategia; excluir después a esas personas plantea otra población y otra pregunta.
La regla necesita especificar opciones factibles. Si una acción no está disponible después de cierto evento, no puede aparecer como una elección ordinaria en esa historia. Puede definirse una acción de cierre o una regla distinta para continuar el seguimiento del resultado. Esta precisión evita interpretar la ausencia de una segunda intervención como si todas las personas hubieran elegido libremente no recibirla.
El resultado de aplicar una estrategia
Denotemos por el resultado potencial bajo la aplicación de toda la estrategia. Su valor poblacional es , tomando valores mayores como preferibles. Comparar y expresa la diferencia media entre aplicar dos reglas completas a la población definida. No requiere que todas las personas reciban las mismas acciones dentro de cada regla.
El valor depende de lo que se haya llamado resultado. Puede ser un desempeño final o una utilidad que combine desempeño con tiempo y esfuerzo. Si se utiliza una suma de resultados de varias etapas, debe explicarse cómo se ponderan. Una estrategia que maximiza la puntuación final puede diferir de otra que maximiza esa puntuación después de descontar una carga importante durante el proceso.
La adaptación individual no identifica automáticamente un beneficio individual. Una regla puede escoger la acción con mayor resultado medio entre personas con una historia semejante. Esa comparación condicionada no revela los dos resultados potenciales de una persona concreta. El término individual describe aquí la información utilizada para decidir; la calidad de la regla sigue evaluándose mediante resultados de una población o de subgrupos definidos.
Tampoco se conoce el valor de una estrategia completa observando una sola trayectoria. Si una persona mejora tras la primera acción, no llegará a la rama prevista para quienes no mejoran. Su trayectoria informa sobre las partes de la regla que recorrió. Las instrucciones de otras ramas deben evaluarse con información de personas que pudieron llegar a ellas bajo las condiciones pertinentes.
La población inicial importa porque las reglas modifican quién llega a cada estado posterior. Evaluar el promedio entre quienes necesitan apoyo al segundo momento no equivale a evaluar el valor desde el comienzo. Una primera acción puede reducir la proporción que necesita apoyo y cambiar la composición de ese grupo. El valor de la estrategia integra esas transiciones, además del resultado de cada acción posterior.
Cómo se identifica el valor desde trayectorias observadas
La consistencia conecta la regla con lo registrado: cuando las acciones observadas coinciden con las instrucciones de una estrategia durante la trayectoria de una persona, su resultado observado coincide con el potencial correspondiente a esa estrategia. Para utilizar esa conexión, las acciones deben tener una definición suficientemente concreta. Dos formas de «apoyo intensivo» con horarios y contenidos distintos podrían constituir intervenciones diferentes aunque compartieran la misma etiqueta administrativa.
La comparación necesita además intercambiabilidad secuencial. En cada decisión, después de considerar la historia pertinente, la acción asignada debe ser independiente de los resultados potenciales futuros relevantes para la evaluación. Una aleatorización en cada momento puede justificar esta condición para las opciones sorteadas. En registros observacionales hay que defenderla mediante el conocimiento de cómo se decide y qué información se registra.
La primera decisión aleatoria no garantiza esa propiedad en la segunda. Un tutor puede ofrecer apoyo adicional basándose en una dificultad que no aparece en el registro. Si esa dificultad también predice el resultado, comparar directamente las acciones posteriores mezcla su efecto con el criterio de selección. Incluir la historia observada no resuelve por definición la omisión de una parte relevante de esa historia.
La positividad se refiere a las acciones que exige la estrategia en las historias que esta puede producir. Si propone apoyo para un estado donde nadie pudo recibirlo, los datos no proporcionan esa comparación. No hace falta exigir acciones irrelevantes en historias imposibles bajo la estrategia evaluada. Sin embargo, una regla que parece razonable sobre el papel puede conducir a combinaciones de historia y acción para las que el estudio carece de información.
Para variables discretas y dos decisiones, estas condiciones permiten expresar el valor mediante una fórmula que conserva las transiciones inducidas por la regla:
La media condicional del resultado corresponde a la acción posterior que indica la regla. Su peso depende de la probabilidad de alcanzar ese estado intermedio bajo la primera acción de la misma regla. No se promedia sobre una distribución intermedia común a todas las estrategias por simple comodidad: esa distribución puede ser una consecuencia de la primera decisión.
La fórmula identifica una cantidad; todavía hay que estimar sus componentes. Pocas trayectorias en algunas ramas pueden producir mucha incertidumbre, aunque sus probabilidades sean positivas. Los modelos de transición y de resultado permiten reunir información entre historias, pero introducen supuestos sobre su semejanza. Un ajuste flexible tampoco produce datos para una rama sin soporte.
Aquí suponemos que la intervención de una persona no modifica el resultado de otra. Si las sesiones compartidas o la competencia por recursos producen esas conexiones, el resultado dependerá también de las reglas aplicadas a las demás. Entonces habrá que definir una política conjunta. La fórmula individual expuesta no incorpora por sí sola esa dependencia.
El calendario también forma parte de la estrategia
Definir dos etapas no basta para saber cuándo ocurren. Una regla puede revisar el dominio de la habilidad al terminar una semana; otra puede hacerlo cuando la persona completa una tarea determinada. La primera comparte un calendario, mientras la segunda produce tiempos de revisión que dependen de la trayectoria. Si el tiempo disponible influye en el resultado, no son dos descripciones equivalentes de la misma intervención. Las instrucciones deben conservar el criterio que hace llegar cada decisión.
La oportunidad de observar puede ser una parte activa del programa. Medir cada día permite ofrecer tutoría antes que medir una vez al mes. También consume tiempo y puede modificar la conducta. Una regla que promete actuar en cuanto aparece una dificultad necesita un procedimiento capaz de detectarla. Evaluarla con registros donde la dificultad se reconocía mucho después requiere justificar cómo se relacionan esas observaciones con la información que usaría la regla. Esa relación no se obtiene simplemente cambiando las fechas en una tabla.
El horizonte determina qué consecuencias entran en el valor. El desempeño al finalizar la segunda etapa puede favorecer una acción que acelera el aprendizaje; una medida varios meses después puede valorar de otro modo su conservación. No es necesario decidir que un horizonte es universalmente correcto. Se elige el que responde a la decisión prevista y se define cuándo se obtiene el resultado para todas las trayectorias. Si cada persona se evalúa al abandonar el programa, cambiar la duración puede cambiar tanto la intervención como el momento de medición.
La programación hacia atrás necesita una etapa terminal porque allí define la última consecuencia que optimiza. Si la segunda decisión tiene efectos posteriores excluidos del resultado, el procedimiento sigue siendo óptimo para el horizonte definido, pero no necesariamente para otro. En un problema de duración indefinida harían falta otras condiciones, por ejemplo sobre cómo valorar resultados distantes y sobre la estabilidad del proceso. La recursión finita de nuestro ejemplo no demuestra esas propiedades ni exige asumirlas para resolver sus dos decisiones.
También conviene fijar qué significa terminar. Una persona puede completar la formación, dejar de participar o continuar sin nuevas sesiones. Esos estados no tienen por qué eliminar el seguimiento del resultado. La regla puede dejar de asignar acciones y mantener una evaluación final común. Si la evaluación se obtiene únicamente entre quienes completan las sesiones, se introduce una selección que puede depender de decisiones anteriores. Registrar el motivo de salida y conservar el objetivo inicial permite distinguir el resultado de la estrategia de la experiencia de quienes permanecieron.
Resolver primero la última decisión
En nuestro programa ficticio, la primera acción puede ser una preparación breve, , o intensiva, . No hay diferencias iniciales entre participantes en esta construcción. Tras la preparación se observa si la persona domina una habilidad, , o todavía no, . La probabilidad de dominarla es un quinto con la preparación breve y cuatro quintos con la intensiva.
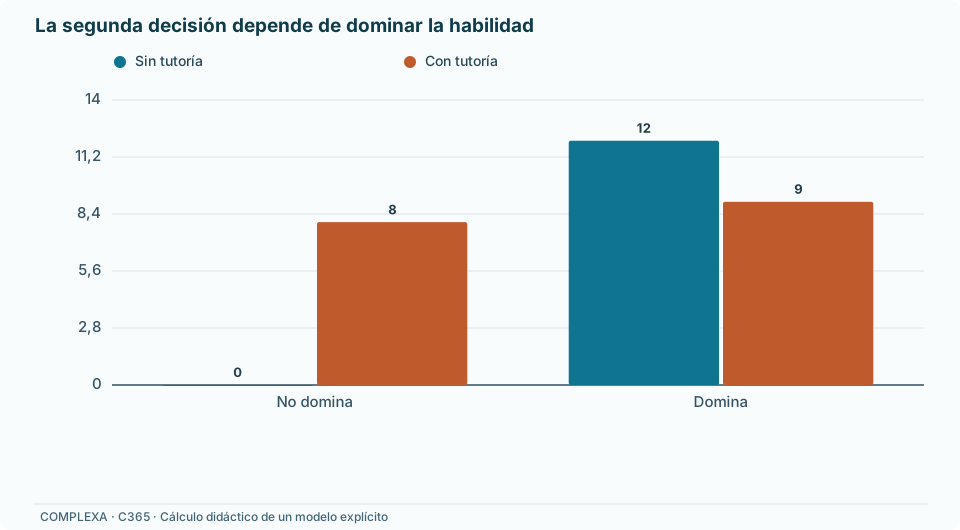
La segunda acción consiste en continuar sin tutoría adicional, , o recibirla, . La tabla define la utilidad final esperada según el estado y esa decisión. Las puntuaciones incorporan el desempeño y la carga de la segunda etapa; después descontaremos por separado la carga de la preparación intensiva inicial.
| Estado antes de la segunda decisión | Sin tutoría adicional | Con tutoría adicional |
|---|---|---|
| Todavía no domina la habilidad | 0 | 8 |
| Ya domina la habilidad | 12 | 9 |
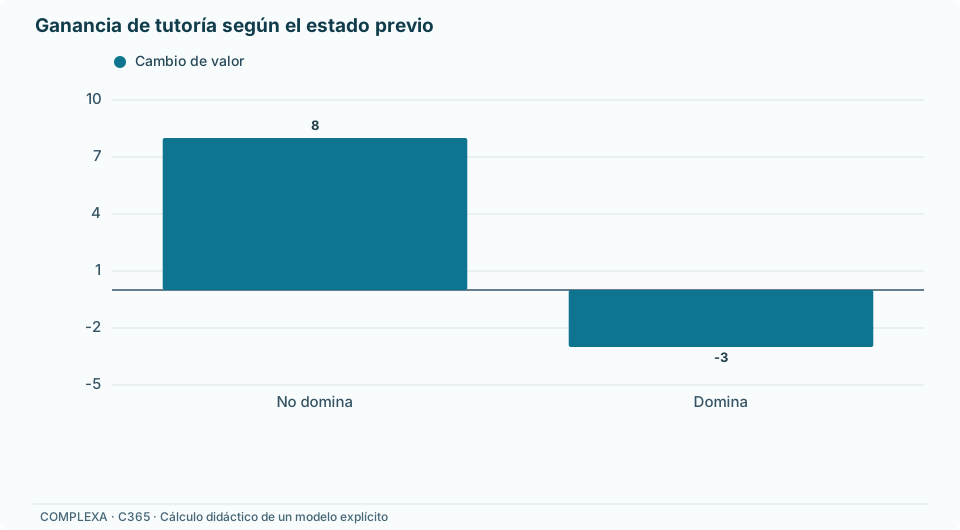
La tutoría beneficia en promedio a quienes todavía no dominan la habilidad. Para quienes ya la dominan, su carga reduce la utilidad de doce a nueve. En esta construcción, una vez conocido el estado, la primera acción no tiene otro efecto sobre la utilidad final aparte de su carga inicial. Esta última equivale a tres puntos si la preparación fue intensiva y a cero si fue breve.
En la última decisión se elige tutoría cuando el estado es cero y se continúa sin ella cuando es uno. Las utilidades óptimas posteriores son ocho y doce, respectivamente. Con esa continuación, empezar con preparación breve da
Empezar con preparación intensiva y usar la misma regla posterior da . La preparación intensiva produce más dominio inicial, pero la tutoría posterior permite resolver de forma selectiva parte de la dificultad. Cuando se considera la secuencia y la carga, la estrategia de mayor valor empieza con la opción breve.
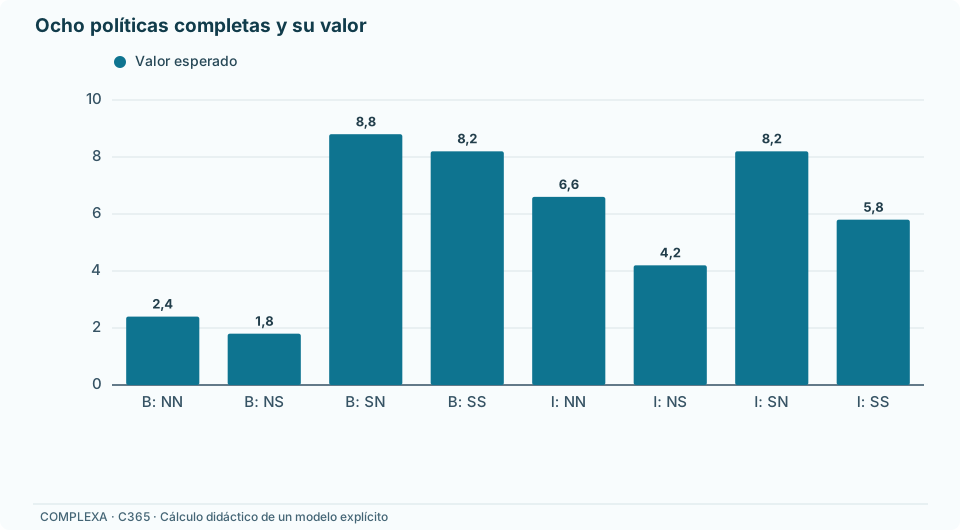
Podemos comprobar todas las posibilidades. Hay dos primeras acciones y cuatro reglas posteriores: cada regla elige una acción para el estado cero y otra para el estado uno. Como no existen diferencias iniciales, esas combinaciones producen ocho estrategias efectivas desde el comienzo.
| Preparación inicial | Tutoría si todavía no domina | Tutoría si ya domina | Valor |
|---|---|---|---|
| Breve | No | No | 2,4 |
| Breve | No | Sí | 1,8 |
| Breve | Sí | No | 8,8 |
| Breve | Sí | Sí | 8,2 |
| Intensiva | No | No | 6,6 |
| Intensiva | No | Sí | 4,2 |
| Intensiva | Sí | No | 8,2 |
| Intensiva | Sí | Sí | 5,8 |
Una estrategia estática fija las dos acciones sin consultar el estado intermedio. La mejor de las cuatro opciones estáticas empieza con preparación breve y ofrece tutoría a todos; vale ocho coma dos. La adaptación añade seis décimas al valor al evitar tutoría en quienes ya dominan la habilidad. El cálculo compara reglas completas y conserva la probabilidad de cada estado.
Esta resolución por etapas es la base de la programación hacia atrás. En una notación de dos decisiones, representa la utilidad final esperada para una historia y una última acción. La primera decisión se valora utilizando la mejor continuación posible:
En esta expresión, la utilidad final incluye las cargas definidas para toda la trayectoria. El aprendizaje de funciones Q estima esas medias y utiliza sus predicciones óptimas posteriores para aprender la decisión anterior (Chakraborty y Murphy, 2014; Laber y colaboradores, 2014). Requiere las condiciones causales ya indicadas para interpretar las medias observadas como resultados de las decisiones.
La expresión también muestra por qué se conserva la historia. La primera acción influye en la distribución de . Elegirla a partir de una media del resultado que mezcla continuaciones distintas puede responder a otra pregunta. La utilidad de una primera opción bajo la práctica posterior habitual puede diferir de su utilidad cuando después se aplica la mejor regla disponible.
Qué aporta un experimento con decisiones sucesivas
Un ensayo secuencial con múltiples asignaciones aleatorias, conocido como SMART, puede producir información para comparar varias estrategias. Murphy (2005) propuso este diseño para desarrollar intervenciones adaptativas. El estudio organiza los sorteos y las oportunidades de decisión; las estrategias son las instrucciones que esos datos permiten evaluar. No son objetos intercambiables.
Construyamos un ensayo para el programa de formación. La primera preparación se sortea con igual probabilidad. Quienes ya dominan la habilidad continúan sin tutoría adicional. Quienes todavía no la dominan se sortean de nuevo, también con igual probabilidad, entre recibir tutoría o continuar sin ella. Este diseño contiene cuatro estrategias: dos opciones iniciales, cada una combinada con dos opciones para quienes necesitan apoyo. Todas mantienen la continuación sin tutoría para quienes ya dominan la habilidad.
Las cuatro estrategias restantes de la tabla no quedan evaluadas por este ensayo, porque requieren ofrecer tutoría a alguna persona que ya domina la habilidad y esa opción nunca se sortea ni se aplica en ese estado. La tabla completa podía calcularse porque conocíamos todas las reglas generadoras del ejemplo. Un estudio real con este diseño solo identificaría las alternativas para las que proporciona soporte, bajo las demás condiciones necesarias.
Una persona que domina la habilidad tras preparación breve es compatible con las dos estrategias que empiezan así: sus instrucciones difieren únicamente en lo que harían si no hubiera dominado la habilidad. Esa persona llegó a su trayectoria por un solo sorteo. Quien no domina la habilidad y recibe tutoría llegó por dos sorteos. Al estimar el valor de una estrategia concreta, sus probabilidades de asignación son un medio y un cuarto, respectivamente.
Por ello, sus contribuciones reciben pesos dos y cuatro. Estos pesos invierten las probabilidades de las acciones asignadas a lo largo de la historia, no la probabilidad de haber mejorado. La mejoría determina qué sorteo corresponde; no debe eliminarse del promedio como si fuera otra acción que se hubiera asignado.
Para la estrategia breve seguida de tutoría cuando falta dominio, una décima parte de toda la población del ensayo pertenece a la rama que ya domina: un medio recibe preparación breve y, dentro de ese grupo, un quinto alcanza ese estado. Dos décimas pertenecen a la rama que no domina y recibe tutoría: un medio por cuatro quintos por un medio. La contribución ponderada al valor es .
Promediar sin ponderación solamente esas trayectorias daría , aproximadamente nueve coma treinta y tres. La discrepancia aparece porque quienes ya dominan están sobrerrepresentados entre las trayectorias compatibles. Nahum-Shani y colaboradores (2012) explican esta estructura de ponderación y la posibilidad de reutilizar una trayectoria compatible con varias estrategias. Esa reutilización no crea observaciones independientes; la incertidumbre debe reconocer que algunas estimaciones comparten participantes.
El ensayo ofrece otra comparación instructiva. Si agrupamos por la primera preparación y conservamos la continuación aleatoria para quienes no dominan, la utilidad media es cinco coma seis con la opción breve y siete coma cuatro con la intensiva. Esa comparación favorece la preparación intensiva. Sin embargo, después de optimizar la continuación, la mejor estrategia empieza con preparación breve y alcanza ocho coma ocho, frente a ocho coma dos de la intensiva. Ambas comparaciones son correctas: sus políticas posteriores son diferentes.
Adaptar decisiones y actualizar el algoritmo
Una estrategia puede permanecer completamente fija mientras sus acciones cambian de una persona a otra. La instrucción «ofrecer tutoría cuando todavía no domina la habilidad» no necesita reestimarse cada vez que recibe una nueva observación. Cambia la entrada de la regla y, con ella, la acción. Esta adaptación dentro de la trayectoria es distinta de volver a ajustar el umbral utilizando los resultados acumulados de participantes anteriores.
Si se actualiza el algoritmo durante la aplicación, habrá una sucesión de versiones. La decisión recibida por una persona dependerá de su historia y del conocimiento acumulado cuando ingresó al programa. Para evaluar ese procedimiento habrá que conservar qué versión estaba activa y qué datos podían utilizarse para entrenarla. Una regla fija y un procedimiento que aprende continuamente pueden coincidir en muchas recomendaciones, pero describen intervenciones diferentes cuando el aprendizaje cambia las instrucciones.
Una separación operativa consiste en fijar períodos de actualización. Durante cada período se aplica la versión previamente acordada; al terminar, los resultados disponibles se utilizan para proponer otra. El registro conserva las versiones, sus poblaciones y las fechas en que se dispuso de cada resultado. Esto permite reconstruir qué información produjo una decisión y evita presentar como prospectiva una regla que fue modificada después de conocer el resultado que pretende explicar.
La regla tampoco tiene que ser determinista. Una estrategia estocástica especifica probabilidades de las acciones según la historia. En una situación de empate puede sortear entre opciones, y una política de exploración puede reservar cierta probabilidad para acciones cuyo valor se conoce peor. Su resultado potencial incluye esa aleatoriedad especificada. El valor promedia tanto la variación de las historias como el sorteo de acciones realizado por la política.
Es útil distinguir ese sorteo del que se utilizó para reunir los datos. Un ensayo puede asignar opciones con iguales probabilidades para aprender sobre ellas, aunque la estrategia que luego se evalúa indique siempre la opción preferida en cada estado. A la inversa, un registro puede informar sobre una política que decide al azar entre alternativas. En ambos casos, las probabilidades del diseño observado y las instrucciones de la política objetivo cumplen funciones distintas y deben conservarse por separado.
Finalmente, debe registrarse si la instrucción se ejecutó. Una recomendación de tutoría, una invitación enviada y una sesión efectivamente recibida son eventos diferentes. Si el programa solo controla la invitación, puede definirse una estrategia de invitaciones y evaluar sus consecuencias, incluida la respuesta posterior de los participantes. Si se pretende evaluar recibir las sesiones indicadas, serán necesarias otras condiciones sobre la recepción. Nombrar el evento controlado permite vincular el valor de la regla con una acción que la organización realmente puede realizar.
Aprender una regla y evaluar lo aprendido
En una investigación real no conocemos las utilidades de cada celda. Se estiman utilizando datos y se selecciona una regla a partir de esas estimaciones. Ese paso introduce una diferencia entre el valor de una regla previamente fijada y el valor de la regla que ganó una búsqueda. Cuantas más alternativas se comparan, más oportunidades hay de elegir una estimación favorecida por el error.
Una cuenta pequeña aísla ese fenómeno. Imaginemos dos reglas cuyo valor real es ocho. La estimación de cada una añade, de manera independiente, un error de más uno o menos uno con iguales probabilidades. Cada estimación es insesgada por separado. Las cuatro combinaciones de errores producen máximos observados de siete, nueve, nueve y nueve. Si siempre elegimos la estimación mayor y la comunicamos como valor de la ganadora, el promedio comunicado es ocho coma cinco.
La regla elegida sigue teniendo valor real ocho en todas las combinaciones. La media de ocho coma cinco describe el criterio después de seleccionar, no una mejora verdadera. Una evaluación independiente de la regla ya elegida volvería a tener esperanza ocho si su estimador es válido. La independencia se refiere a los datos usados para evaluarla: la misma observación no debe contribuir a escoger la regla y luego presentarse como comprobación ajena a esa selección.
Una separación entre desarrollo y evaluación permite congelar el conjunto de decisiones antes de examinar el resultado de evaluación. El desarrollo puede incluir selección de variables, umbrales y complejidad. La evaluación necesita conservar el mecanismo de asignación y el seguimiento del resultado para estimar el valor de la regla congelada. Dividir los datos no elimina confusión, falta de soporte o una mala definición de las acciones.
La validación cruzada puede aprovechar varios repartos. En cada uno se aprende con una parte y se evalúa con observaciones que no participaron en ese aprendizaje. Sin embargo, las reglas aprendidas pueden diferir entre repartos. El promedio resultante evalúa el procedimiento de aprendizaje bajo esos repartos; no constituye automáticamente una evaluación independiente exacta de una nueva regla ajustada después con todos los datos. El objetivo comunicado debe corresponder al procedimiento realizado.
Luedtke y van der Laan (2016) distinguen, para una decisión, el valor de una regla fija, el de una regla aprendida y el valor óptimo. Su procedimiento de evaluación utiliza observaciones posteriores a las empleadas en cada actualización del aprendizaje, con condiciones específicas para la inferencia. Ese resultado no debe trasladarse como garantía automática a cualquier algoritmo de varias etapas. Sí hace visible por qué la selección y la evaluación pertenecen al diseño del análisis.
La exactitud al reproducir acciones tampoco resume el valor. Supongamos cien historias igualmente ponderadas. En diez, la diferencia de utilidad entre acciones es dos centésimas; en las demás, es dos. Una regla que se equivoca en las diez primeras pierde dos milésimas de utilidad promedio. Otra que se equivoca en diez de las restantes pierde dos décimas. Ambas coinciden con la acción óptima en noventa por ciento de las historias, pero sus pérdidas difieren cien veces.
La pérdida de valor pondera cada desacuerdo por su consecuencia. Murphy (2003) utiliza funciones de pérdida respecto de la decisión óptima para caracterizar decisiones sucesivas. Nuestro ejemplo de cien historias es una construcción de una etapa: en varias etapas, una acción también cambia las historias futuras y la comparación debe incorporar esa continuación.
Empates, restricciones y decisiones reproducibles
Cerca de un empate, una pequeña variación de la media estimada puede cambiar la acción recomendada. Eso no implica necesariamente una gran pérdida de valor, pero sí puede hacer inestable la regla aprendida. En el aprendizaje hacia atrás, el máximo utilizado como resultado intermedio tiene un cambio de pendiente cuando se igualan las alternativas. Laber y colaboradores (2014) estudian cómo esa falta de suavidad afecta a la inferencia sobre parámetros de las reglas.
No se desprende que toda inferencia sobre su valor fracase. El problema depende del objetivo, la distribución y el procedimiento. Luedtke y van der Laan (2016) muestran que, para su objetivo de valor óptimo, los estratos con contraste cero y variabilidad del resultado requieren atención especial. Aplicar sin comprobación una aproximación normal habitual porque la regresión de la última etapa la utiliza puede ser insuficiente para la decisión aprendida en una etapa anterior.
En la implementación, una convención para empates hace reproducible la regla. Puede preferirse la acción de menor carga cuando los valores definidos son iguales. Esa convención debe distinguirse de declarar equivalencia porque una estimación es imprecisa. Una diferencia estimada pequeña puede tener mucha incertidumbre; dos utilidades conocidas e idénticas constituyen otro caso.
El conjunto de reglas admisibles puede limitarse por recursos o por la información que puede obtenerse a tiempo. Athey y Wager (2021) estudian el aprendizaje de políticas bajo restricciones de aplicación, incluidas complejidad y presupuesto. Una regla sencilla puede tener menor valor que la mejor función imaginable y, aun así, ser la mejor dentro del conjunto que el servicio puede ejecutar. La comparación debe nombrar ese conjunto.
En el ejemplo de formación, el resultado depende de cómo valoramos la carga inicial. Antes de descontarla, la preparación intensiva con continuación óptima alcanza once coma dos, frente a ocho coma ocho de la breve. Si llamamos a esa carga, la primera opción resulta preferible cuando . Con carga de uno, su valor es diez coma dos; con la carga de tres utilizada antes, baja a ocho coma dos. «Óptima» siempre se refiere al resultado y las restricciones declarados.
Una capacidad limitada para tutorías plantea otra especificación. Si muchas personas necesitan apoyo al mismo tiempo, no basta con recomendarlo a todas suponiendo disponibilidad ilimitada. La regla debe incluir una forma de priorización o una política que distribuya las plazas. Si la atención de una persona reduce las posibilidades de otra, la evaluación pasa a depender de decisiones conjuntas y no únicamente de historias individuales.
Para preparar una evaluación del programa inventado, se podría congelar la regla de preparación breve, medir el dominio en una fecha fijada y ofrecer tutoría a quienes todavía no lo alcanzaron. El protocolo incluiría la acción ante una medición ausente y la capacidad de tutoría prevista. Un conjunto de datos posterior permitiría evaluar esa versión concreta con el resultado y la carga acordados. Si luego se cambia el umbral o la capacidad, habrá una nueva estrategia cuyo valor deberá referirse a esas nuevas instrucciones.
Referencias
Athey, S., y Wager, S. (2021). Policy learning with observational data. Econometrica, 89(1), 133–161. https://doi.org/10.3982/ECTA15732
Chakraborty, B., y Murphy, S. A. (2014). Dynamic treatment regimes. Annual Review of Statistics and Its Application, 1, 447–464. https://doi.org/10.1146/annurev-statistics-022513-115553
Laber, E. B., Lizotte, D. J., Qian, M., Pelham, W. E., y Murphy, S. A. (2014). Dynamic treatment regimes: Technical challenges and applications. Electronic Journal of Statistics, 8(1), 1225–1272. https://doi.org/10.1214/14-EJS920
Luedtke, A. R., y van der Laan, M. J. (2016). Statistical inference for the mean outcome under a possibly non-unique optimal treatment strategy. The Annals of Statistics, 44(2), 713–742. https://doi.org/10.1214/15-AOS1384
Murphy, S. A. (2003). Optimal dynamic treatment regimes. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 65(2), 331–355. https://doi.org/10.1111/1467-9868.00389
Murphy, S. A. (2005). An experimental design for the development of adaptive treatment strategies. Statistics in Medicine, 24(10), 1455–1481. https://doi.org/10.1002/sim.2022
Nahum-Shani, I., Qian, M., Almirall, D., Pelham, W. E., Gnagy, B., Fabiano, G. A., Waxmonsky, J. G., Yu, J., y Murphy, S. A. (2012). Experimental design and primary data analysis methods for comparing adaptive interventions. Psychological Methods, 17(4), 457–477. https://doi.org/10.1037/a0029372