Dos personas pueden tener probabilidades muy distintas de alcanzar un resultado favorable con una intervención y, aun así, obtener el mismo beneficio de recibirla. También puede ocurrir que quien tenga más posibilidades de responder sea quien menos gane al intervenir, porque sus posibilidades sin intervención ya eran altas. Para adaptar una decisión al estado observado necesitamos comparar alternativas dentro de ese estado. Predecir un resultado bajo una sola opción deja sin resolver esa comparación.
La distinción cambia el significado de personalizar. Una regla puede utilizar características de cada persona y seguir basándose en efectos promedio entre personas comparables. La precisión con que registra esas características no permite observar simultáneamente sus dos futuros. El problema consiste en definir qué información condiciona la comparación, estimar lo que esa información permite y evaluar la regla que se construye a partir de ella.
Un estado observado antes de decidir
Sea el estado disponible en el momento de una decisión. Puede incluir una medida funcional actual, antecedentes y otras características que se hayan registrado antes de asignar la intervención. La letra no presupone que todo el sistema quede descrito por ese resumen ni que su evolución sea markoviana. Designa la información que utilizaremos para comparar dos opciones en un momento definido.
Denotamos las alternativas por y , y el resultado favorable posterior por . Las probabilidades potenciales de respuesta dentro del estado son . Su diferencia, es el efecto promedio condicional, conocido como CATE. Aunque se calcule para el perfil de una persona concreta, sigue siendo un promedio condicionado a la información especificada. El efecto individual sería , una diferencia entre dos resultados potenciales de la misma persona que normalmente no pueden observarse juntos.
Para identificar las medias condicionales mediante una comparación observacional se requieren consistencia, intercambiabilidad y soporte para las opciones consideradas. Si el estado usado por la regla es un resumen pequeño, puede ser necesario ajustar por otras variables basales que confunden la asignación. Las variables necesarias para controlar confusión y las que se autoriza utilizar al decidir no tienen por qué coincidir. Después del ajuste se promedian los resultados sobre la distribución de esa información adicional dentro de cada estado.
En un experimento aleatorizado, la asignación aporta una base para comparar opciones dentro de los perfiles, pero los subgrupos pequeños siguen teniendo poca información. En datos observacionales, un algoritmo flexible no añade la intercambiabilidad que falte. Wager y Athey (2018) formulan sus resultados sobre bosques causales bajo condiciones explícitas de ausencia de confusión no medida y solapamiento, junto con restricciones sobre la construcción y regularidad del estimador.
Cuatro estados y una media que los reúne
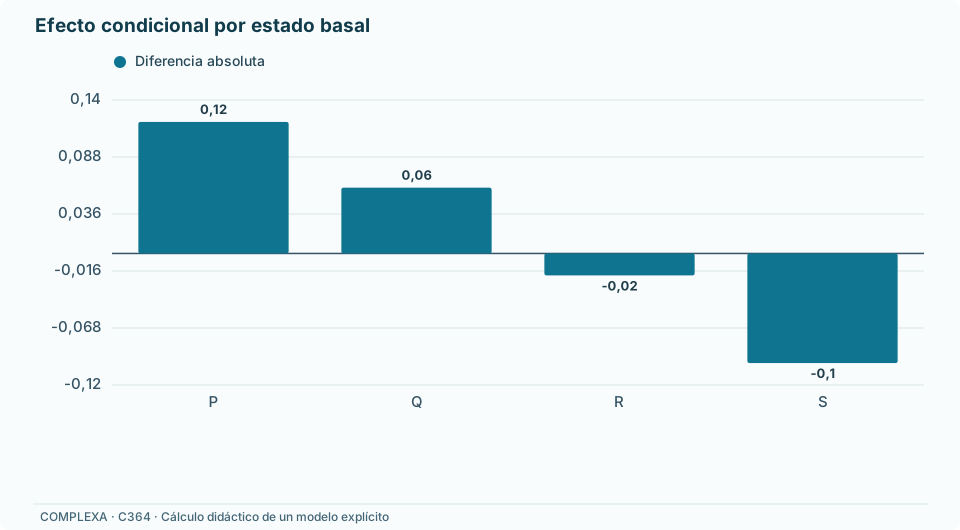
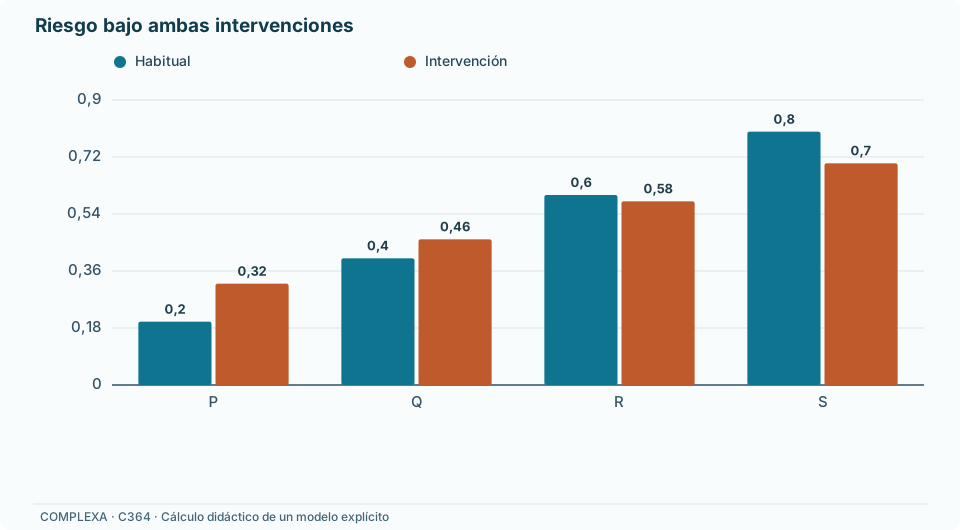
Trabajaremos con cuatro estados didácticos, denominados P, Q, R y S. Las letras son etiquetas y no constituyen una escala clínica. Se mantienen fijos el inicio de seguimiento, las dos opciones y el momento de evaluación. Supondremos ausencia de interferencia y una intervención suficientemente definida. Las proporciones y respuestas potenciales de la tabla son valores construidos, conocidos por quien diseña el ejemplo.
| Estado | Proporción de la población | Respuesta sin intervención | Respuesta con intervención | Diferencia |
|---|---|---|---|---|
| P | 0,40 | 0,20 | 0,32 | 0,12 |
| Q | 0,30 | 0,40 | 0,46 | 0,06 |
| R | 0,20 | 0,60 | 0,58 | −0,02 |
| S | 0,10 | 0,80 | 0,70 | −0,10 |
La probabilidad de respuesta si nadie recibiera la intervención sería cuarenta por ciento. Si todos la recibieran sería cuarenta y cinco coma dos por ciento. El efecto promedio general es positivo: cinco coma dos puntos porcentuales. Ese promedio combina incrementos de doce y seis puntos en los dos primeros estados con reducciones de dos y diez en los otros dos.
La heterogeneidad de la tabla es cualitativa en el sentido de que cambia la opción con mayor respuesta promedio. Si todos los efectos fueran positivos, pero de diferente magnitud, existiría heterogeneidad sin que cambiara necesariamente la opción preferida para maximizar exclusivamente ese resultado. La decisión puede cambiar también cuando se incorporan costos o daños, incluso si las diferencias de respuesta mantienen el mismo signo.
Los números no describen cuatro clases de personas con efectos individuales idénticos. Dentro de cada estado puede haber quienes respondan con cualquiera de las opciones, quienes respondan con una sola y quienes no respondan con ninguna. La tabla especifica dos distribuciones marginales por estado. No fija cómo se emparejan ambos resultados potenciales en cada individuo.
Tampoco convierte el estado en causa demostrada del efecto diferencial. Una característica puede ser útil para localizar dónde cambia un contraste sin que modificar esa característica reproduzca el cambio. Si el estado resume una historia anterior, su asociación con el beneficio puede reflejar esa historia. Intervenir sobre el marcador y asignar tratamiento según el marcador son preguntas distintas, con resultados potenciales y supuestos diferentes.
La distribución de estados determina cuánto contribuye cada contraste al promedio. Imaginemos otra población con diez por ciento en P, diez en Q, treinta en R y cincuenta en S. Si se conservaran exactamente las mismas respuestas potenciales condicionales, la probabilidad de respuesta sin intervención sería sesenta y cuatro por ciento y con intervención sesenta coma dos. El efecto promedio pasaría a menos tres coma ocho puntos. La inversión del signo ocurre sin cambiar ninguno de los cuatro efectos condicionales.
La regla que maximiza respuestas sin costos seguiría interviniendo en P y Q. Su incremento respecto de no intervenir sería ahora de uno coma ocho puntos, porque esos estados representan una proporción menor. La comparación entre intervenir en todos y no intervenir en nadie favorece aquí la segunda opción, aunque una regla adaptada pueda mejorar su resultado. Son contrastes diferentes: el primero enfrenta dos políticas uniformes y el segundo utiliza la información que distingue estados.
Este cálculo es una transferencia condicionada a que las medias potenciales por estado se mantengan. Conocer la nueva mezcla no demuestra que así sea. Si cambian versiones de la intervención, prácticas comparadoras o variables relevantes que quedaron agrupadas dentro de un mismo estado, habrá que revisar esa estabilidad. La descripción de los estados permite localizar qué se está transfiriendo y qué parte del cambio de resultado procede únicamente de la composición poblacional.
El efecto condicional deja variación individual sin resolver
En el estado P, veinte por ciento respondería sin intervención y treinta y dos por ciento con ella. Una población compatible puede contener veinte por ciento que respondería siempre, doce por ciento que respondería solo con intervención y sesenta y ocho por ciento que no respondería bajo ninguna opción. En esa construcción nadie pierde una respuesta por recibirla.
Otra población compatible contiene treinta y dos por ciento que responde solo con intervención, veinte por ciento que responde solo sin ella y cuarenta y ocho por ciento que no responde con ninguna. Nadie responde con ambas opciones. La intervención beneficia a más personas que en la primera construcción, pero también perjudica a algunas. El efecto promedio condicional sigue siendo de doce puntos, y las dos probabilidades marginales permanecen iguales.
| Tipo potencial en P | Primera construcción | Segunda construcción |
|---|---|---|
| Responde con ambas opciones | 0,20 | 0 |
| Responde solo con intervención | 0,12 | 0,32 |
| Responde solo sin intervención | 0 | 0,20 |
| No responde con ninguna | 0,68 | 0,48 |
Conocer exactamente las medias condicionales no distingue estos emparejamientos. Bajo esa información, la fracción que se beneficia en P puede variar entre doce y treinta y dos por ciento. El efecto condicional informa el balance promedio entre beneficios y pérdidas de respuesta; no identifica de manera individual a quienes integran cada tipo. Añadir un intervalo de confianza estrecho alrededor de la media no resuelve esta ausencia de información conjunta.
Medir nuevas características puede revelar promedios distintos dentro de P y hacer más informativa la comparación. Lo que no se puede garantizar es que una descripción cada vez más detallada termine revelando los dos resultados de cada persona. El supuesto de que todos los integrantes de un perfil tengan el mismo efecto es una restricción adicional sobre el mundo, no una consecuencia de haber utilizado muchas variables.
La distinción también orienta la comunicación. Una predicción de doce puntos porcentuales para el perfil P puede expresarse como el aumento esperado al comparar ambas opciones entre personas con la información especificada. Presentarla como la probabilidad de que una persona determinada se beneficie confundiría ese aumento con la fracción de efectos individuales positivos, que acabamos de ver variar manteniendo el mismo promedio.
Heterogeneidad en una escala, estabilidad en otra
La escala del contraste forma parte de la definición. En otro ejemplo construido, dos estados podrían tener probabilidades de respuesta sin intervención de diez y cuarenta por ciento, y con intervención de veinte y ochenta. En ambos, el cociente entre las probabilidades de respuesta con y sin intervención es dos. Las diferencias absolutas son diez y cuarenta puntos porcentuales. Hay heterogeneidad en la escala aditiva y constancia en la multiplicativa.
Kent y colaboradores (2020), en la declaración PATH, distinguen enfoques que modelan el riesgo del resultado de enfoques que modelan directamente diferencias del efecto. La variación del riesgo basal puede producir variación relevante del beneficio absoluto incluso con una medida relativa constante. Esa posibilidad no elimina la necesidad de verificar el modelo de riesgo y su adecuación a la población donde se utilizará.
Buscar una interacción en una regresión requiere indicar la escala que representa su coeficiente. Una interacción con tratamiento en un modelo de probabilidad lineal describe una modificación aditiva bajo sus restricciones. Una interacción en la escala logarítmica de odds tiene otro significado. Su ausencia no establece que las diferencias absolutas sean iguales. La comparación debe volver a probabilidades o resultados potenciales en la escala que interesa para la pregunta.
Otra confusión frecuente aparece al comparar significaciones por separado. Supongamos dos subgrupos independientes con diferencias estimadas de diez y ocho puntos porcentuales, y errores estándar de cuatro y siete puntos. El primer contraste excluye cero con una aproximación normal habitual; el segundo no. Eso no demuestra que los efectos sean distintos entre subgrupos.
La diferencia entre sus estimaciones es de dos puntos. Bajo la independencia supuesta, su error estándar es aproximadamente ocho coma cero seis puntos, obtenido sumando las dos varianzas antes de extraer la raíz. El cociente entre diferencia y error estándar es cercano a un cuarto. Los mismos números que producen una comparación significativa y otra no significativa ofrecen poca evidencia de una interacción. La hipótesis sobre la diferencia debe evaluarse directamente, respetando la dependencia entre estimaciones cuando exista.
La exploración de muchos perfiles agrega otro problema: algunos mostrarán contrastes llamativos por variación muestral. La credibilidad de un modificador requiere examinar cómo se propuso, cuántas alternativas se exploraron, si su medición precedía a la decisión y qué ocurre al comprobarlo con nueva información. La declaración PATH sitúa esas evaluaciones antes de trasladar una heterogeneidad exploratoria a decisiones clínicas. Nuestros estados construidos permiten conocer el mecanismo; un subgrupo descubierto en un estudio no dispone de esa ventaja.
El resultado bajo tratamiento no ordena el beneficio
Volvamos a los cuatro estados. Si se clasificara a las personas por su probabilidad de responder con intervención, el orden sería S, R, Q y P. S tiene setenta por ciento de respuestas potenciales tratadas, mientras P solo treinta y dos. Pero S habría tenido ochenta por ciento sin intervención y P veinte. El orden del beneficio es P, Q, R y S, justamente inverso en esta construcción.
Un modelo pronóstico puede predecir bien quién responderá y ser insuficiente para elegir a quién conviene ofrecer la intervención según el objetivo definido. El error no proviene necesariamente de su ajuste estadístico. Puede provenir de haberle pedido predecir una cantidad diferente de la que determina la decisión. Para estimar beneficio hacen falta ambos resultados potenciales promedio o una estrategia que aprenda directamente su contraste.
Una política determinista asigna una de las dos opciones a cada estado. Su valor para el resultado favorable es . Bajo los supuestos anteriores,
Si no hay costos, restricciones ni otros resultados relevantes, la regla que maximiza este valor interviene cuando la diferencia condicional es positiva. En la tabla lo hace en P y Q. Su probabilidad promedio de respuesta es cuarenta y seis coma seis por ciento, superior a cuarenta y cinco coma dos al intervenir en todos y a cuarenta al no intervenir en nadie.
El incremento de uno coma cuatro puntos respecto de intervenir en todos procede de evitar las reducciones de respuesta en R y S. La regla utiliza información heterogénea, pero su rendimiento sigue siendo una media poblacional. Puede ser preferible para ese objetivo aunque no se conozca qué persona concreta se beneficiará. La expectativa permite comparar reglas sin suponer que todos los resultados individuales estén determinados de antemano por el estado observado.
Costos y capacidad modifican la regla
Supongamos ahora un costo hipotético equivalente a ocho centésimas de una unidad de respuesta por cada intervención. Es una conversión de utilidad elegida para el ejercicio, no un precio clínico ni una valoración general de daños. El criterio pasa a ser . Una intervención con beneficio positivo puede dejar de maximizar ese criterio si su incremento esperado no compensa el costo.
La diferencia en P, doce puntos, supera el costo; la de Q, seis, no. La regla óptima para este criterio interviene solo en P. Su respuesta bruta es cuarenta y cuatro coma ocho por ciento y su tasa de intervención cuarenta por ciento. Al descontar el costo promedio de tres coma dos puntos, queda una utilidad de cero coma cuatrocientos dieciséis.
Intervenir en P y Q produce una respuesta bruta mayor, pero una utilidad neta de cero coma cuarenta y uno después de descontar cinco coma seis puntos de costo. No intervenir en nadie mantiene cero coma cuarenta. La opción que maximiza respuestas y la que maximiza esta utilidad neta difieren porque se han especificado objetivos distintos. El valor asignado a cargas, recursos o efectos adversos debe proceder de la decisión que se intenta informar.
Los costos tampoco tienen que ser iguales entre estados. Si en Q el costo equivalente fuera de cuatro centésimas, manteniendo ocho en los demás, su beneficio neto sería positivo y la regla volvería a incluirlo. La información causal sobre respuestas seguiría intacta; habría cambiado una parte de la valoración de las consecuencias. Cuando existen preferencias o cargas diferentes, una regla basada únicamente en el signo del efecto sobre un desenlace puede omitir esa diferencia. Formular la utilidad permite separar lo que se estima sobre los resultados de lo que se acuerda valorar al decidir.
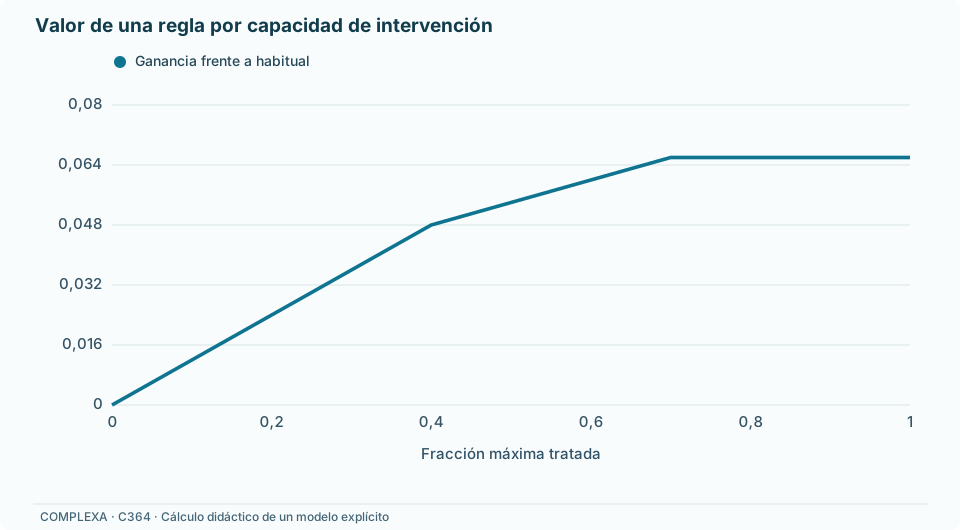
Consideremos otra restricción, separada del costo anterior: solo se puede intervenir en una cuarta parte de la población y se desea maximizar respuestas. El estado P contiene cuarenta por ciento de las personas y tiene el mayor beneficio. Si no hay más información relevante dentro de ese estado, una regla aleatoria que interviene en cinco octavos de P y en nadie más utiliza exactamente la capacidad disponible en promedio. La respuesta poblacional aumenta de cuarenta a cuarenta y tres por ciento.
Priorizar, en cambio, la respuesta pronosticada bajo intervención asignaría primero a todo S y después a tres cuartas partes de R. También cubriría una cuarta parte de la población, pero reduciría la respuesta promedio a treinta y ocho coma siete por ciento. Esa comparación mantiene constante la capacidad y muestra el costo de ordenar por pronóstico en lugar de por beneficio. Una restricción exacta de cupos en una población finita requeriría especificar además el procedimiento de selección dentro de P.
Kitagawa y Tetenov (2018) estudian la elección de tratamientos dentro de clases de reglas factibles, incluyendo restricciones de simplicidad o capacidad. Athey y Wager (2021) desarrollan el aprendizaje de políticas con datos observacionales bajo condiciones causales y estadísticas explícitas. Una regla óptima dentro de una clase restringida puede diferir de la que se obtendría si se permitiera cualquier función del estado. La restricción forma parte del problema, y no solo de la implementación informática.
Aprender dónde cambia el efecto
En una aplicación, las probabilidades de la tabla no son conocidas. Podrían estimarse ajustando un modelo para cada alternativa y restando sus predicciones, mediante una regresión con interacciones o usando procedimientos específicos para efectos heterogéneos. La disponibilidad de muchas variables amplía las particiones posibles, pero cada división reduce la información que sostiene las comparaciones locales.
Athey e Imbens (2016) proponen árboles causales que separan el descubrimiento de subgrupos de la estimación de sus efectos. Una muestra ayuda a elegir la partición y otra estima los contrastes dentro de sus hojas. Esta separación, denominada estimación honesta, evita utilizar el mismo ruido de resultados para escoger un subgrupo y exagerar después su efecto estimado. Los intervalos se refieren a promedios dentro de hojas, con los supuestos de muestreo e identificación pertinentes.
Los bosques causales agregan muchas particiones y permiten estimar variación más gradual. Los resultados de Wager y Athey (2018) corresponden a una clase definida de bosques, con condiciones de regularidad, honestidad y solapamiento. Son resultados puntuales sobre promedios condicionales y su distribución asintótica. No establecen cobertura simultánea para todos los perfiles ni justifican atribuir inferencia causal a cualquier bosque que prediga resultados observados.
Otra vía aprende directamente una regla cuyo valor esperado sea alto. Zhao y colaboradores (2012) expresan esa tarea como un problema de clasificación ponderado por el resultado y por la probabilidad de asignación. El objetivo es que las decisiones propuestas consigan una buena respuesta media. La clasificación no busca recuperar una etiqueta observada que indique cuál habría sido el mejor tratamiento individual, porque esa etiqueta contrafactual generalmente no existe en los datos.
Las dos tareas pueden exigir precisiones diferentes. Para elegir entre opciones con costo cero importa sobre todo el signo del efecto en los estados donde una decisión puede cambiar. Un error pequeño alrededor de cero puede invertir la regla, mientras un error mayor que conserve el signo puede dejarla igual. Para comunicar magnitudes, calcular costos o comparar políticas bajo restricciones, también importa cuánto se ha equivocado el modelo en cada efecto.
La pérdida de valor por una clasificación errónea depende de la magnitud del contraste y de la frecuencia del estado. En nuestro generador, intervenir indebidamente en R cuesta cuatro décimas de punto de respuesta poblacional: una quinta parte de dos puntos. Omitir la intervención en P cuesta cuatro coma ocho puntos. Una tasa global de decisiones acertadas podría asignar el mismo costo por persona a esos errores y ocultar la diferencia de consecuencias.
Para comprobar las predicciones de heterogeneidad tampoco basta comparar cada valor predicho con el resultado individual observado. Ese resultado depende de la opción recibida y no es una medición del efecto. En un conjunto reservado se pueden agrupar perfiles según sus efectos predichos y estimar, dentro de cada grupo, un contraste entre opciones con un procedimiento causal adecuado. Así se examina si los grupos anunciados como más beneficiados muestran diferencias promedio mayores.
Esa evaluación sigue teniendo una resolución limitada. Que un grupo con predicción media de diez puntos muestre un contraste próximo a diez no demuestra que cada perfil tenga ese efecto, ni verifica su distribución de beneficios y perjuicios individuales. Agrupar permite obtener comparaciones con información suficiente, a cambio de resumir variación interna. Además, los cortes deben provenir de la etapa de aprendizaje o quedar contemplados en el diseño de evaluación; buscarlos de nuevo con los resultados reservados modifica la prueba que se está realizando.
Cuando las estimaciones están cerca del umbral que cambia una decisión, pequeñas perturbaciones de los datos pueden producir reglas distintas. Esa inestabilidad merece describirse junto con la magnitud de las pérdidas que implicaría. Una regla que solo intervenga si un límite de confianza supera un costo introduce un criterio adicional de cautela estadística. Puede estudiarse como política propia, pero ya no equivale a maximizar sin más la utilidad estimada. Su rendimiento también requiere evaluación y no se deduce únicamente del nivel nominal del intervalo utilizado.
Evaluar una regla sin reutilizar sus resultados
Para ilustrar una evaluación, fijemos una regla candidata que interviene en P, Q y R, y deja S sin intervención. Imaginemos que una etapa previa produjo diferencias estimadas de once, cuatro, uno y menos siete puntos. Son valores inventados que representan un posible resultado de aprendizaje; aquí no se ha ejecutado un algoritmo para obtenerlos. La regla queda fijada antes de utilizar la tabla de evaluación.
Construimos una muestra de evaluación separada de diez mil registros, con las proporciones de estados anteriores y mitad de asignaciones a cada alternativa dentro de cada estado. Los recuentos de respuesta se fijan exactamente para reproducir las probabilidades del generador. Son datos didácticos sin ruido muestral añadido. No se presentan como una validación empírica de un tratamiento ni como prueba de rendimiento de un programa de aprendizaje.
| Estado | Personas por brazo | Respuestas con intervención | Respuestas sin intervención |
|---|---|---|---|
| P | 2000 | 640 | 400 |
| Q | 1500 | 690 | 600 |
| R | 1000 | 580 | 600 |
| S | 500 | 350 | 400 |
Para evaluar la regla candidata utilizamos las respuestas de quienes recibieron la opción que ella habría asignado: los tratados de P, Q y R, junto con los controles de S. Suman dos mil trescientas diez respuestas. Cada observación compatible recibe peso dos, inverso de su probabilidad de asignación. Al dividir la suma ponderada por diez mil, obtenemos cuarenta y seis coma dos por ciento.
El cálculo corresponde a
donde es la probabilidad de recibir la opción en los datos de evaluación. En la tabla vale un medio para ambas. Bajo asignación apropiada y para una regla fijada independientemente de esos resultados, el promedio ponderado representa la respuesta bajo la política. En datos observacionales, esa interpretación necesita la justificación causal y el soporte para las decisiones que la política asigna.
El generador permite comprobar el resultado: intervenir en R reduce el valor en cuatro décimas de punto respecto de la regla que solo interviene en P y Q. Esa comparación con la mejor regla del generador utiliza conocimiento disponible en un ejercicio construido. En una aplicación, escoger una nueva regla después de mirar la evaluación y presentar su resultado en la misma muestra como validación independiente volvería a introducir selección.
Zhao y colaboradores (2012) evalúan reglas en muestras de validación independientes en sus simulaciones y mediante particiones reservadas en su aplicación. La separación debe abarcar las decisiones que aprendieron de los resultados: selección de variables, transformaciones, umbrales y ajuste del algoritmo. Reservar filas después de haber usado todas las respuestas para escoger el modelo no restaura esa independencia.
Separar el ajuste de modelos y la evaluación de la política
La ponderación puede complementarse con modelos de respuesta. Una contribución aumentada para evaluar una regla fija es
El primer término predice el resultado bajo la opción indicada. El segundo corrige esa predicción con el residuo observado cuando la asignación coincide con la regla. Si las probabilidades de asignación son correctas, la corrección recupera en promedio el error del modelo de respuesta. Si las medias condicionales son correctas, los residuos tienen esperanza condicional cero, aunque el modelo de asignación no sea correcto, siempre que sus denominadores permitan la operación.
Esta propiedad de doble robustez concierne a esos componentes dentro de un problema causal identificado. No cubre confusión no medida, falta de soporte ni reutilización arbitraria de datos para seleccionar una regla. Athey y Wager (2021) construyen su aprendizaje de políticas a partir de contribuciones robustas y procedimientos de ajuste cruzado, bajo condiciones sobre la estimación de los componentes y la complejidad de las políticas admitidas.
La expresión escrita supone que el estado contiene información suficiente para el ajuste. Si hay otras variables basales necesarias, las probabilidades de asignación y las medias se condicionan también a ellas, mientras la regla puede seguir utilizando solo el estado permitido. Una variable puede ser necesaria para evaluar imparcialmente una política sin estar disponible o autorizada para asignar tratamientos en su uso futuro. El análisis debe conservar esa distinción al formar las predicciones y las correcciones.
El ajuste cruzado de los modelos auxiliares consiste en obtener para cada partición predicciones entrenadas sin sus propios resultados. Esa separación ayuda a controlar el sobreajuste de las probabilidades y respuestas. No equivale automáticamente a reservar una evaluación independiente de la política si la política final se seleccionó usando las contribuciones de todas las particiones. Las condiciones para aprender dentro de una clase y las de una evaluación externa deben distinguirse.
También se puede repetir todo el aprendizaje dentro de cada partición de entrenamiento y evaluar la regla correspondiente en la parte reservada. En ese caso se obtienen valores para varias reglas aprendidas con muestras algo menores. Su promedio informa el rendimiento de ese procedimiento de aprendizaje bajo la partición utilizada. No es, por identidad, el valor exacto de la única regla que después se reentrena con todos los datos; esa relación requiere estudiar estabilidad y tamaño de entrenamiento.
En problemas con mediciones repetidas, la división debe respetar la unidad que aporta dependencia. Si respuestas de una misma persona aparecen a ambos lados, la evaluación puede aprovechar información ya vista de esa persona. Una separación por instituciones o por tiempo puede responder a una pregunta de transporte distinta de una división aleatoria de personas del mismo origen. El diseño de validación debe corresponder al uso que se propone.
Qué significa adaptar al estado cuando el estado cambia
Hasta aquí, cada estado se mide antes de una sola decisión. Actualizarlo durante el seguimiento cambia el problema. Una mejoría temprana puede depender de la intervención anterior y, al mismo tiempo, modificar la decisión posterior. Usar esa mejoría para explicar retrospectivamente la primera asignación no equivale a evaluarla como información disponible para una nueva decisión.
Una regla adaptada al momento necesita especificar qué historia conoce, cuándo actúa y qué resultado posterior intenta mejorar. Puede ser necesario conservar tratamientos previos y trayectorias, aunque dos personas tengan hoy la misma puntuación. El resumen de estado debe ser suficiente para el análisis propuesto; llamarlo estado no garantiza que el resto de la historia sea irrelevante. Una política secuencial requiere evaluar las consecuencias de toda la secuencia que genera.
La medición también entra en la regla. Un umbral obtenido con una escala administrada de una manera puede clasificar de otra forma a las personas si cambia el instrumento, el momento o la calidad del registro. En ese caso no basta comprobar que la fórmula informática sea idéntica. Han cambiado los estados a los que se asignan las alternativas y posiblemente los promedios condicionales que justificaban la decisión.
Para el ejercicio de cuatro estados, la regla candidata evaluada conserva un valor de cuarenta y seis coma dos por ciento, frente a cuarenta al no intervenir. El conocimiento del generador localiza su pérdida: asigna la intervención al veinte por ciento situado en R, donde reduce la respuesta en dos puntos. La regla corregida para ese objetivo omitiría esa asignación y alcanzaría cuarenta y seis coma seis. Si además se adopta el costo hipotético anterior, la comparación debe recalcularse con esa utilidad, que selecciona solo P. Cada cambio de regla puede seguirse hasta el estado, el contraste y el objetivo que lo justifican.
Referencias
Athey, S., e Imbens, G. W. (2016). Recursive partitioning for heterogeneous causal effects. Proceedings of the National Academy of Sciences, 113(27), 7353–7360. https://doi.org/10.1073/pnas.1510489113
Athey, S., y Wager, S. (2021). Policy learning with observational data. Econometrica, 89(1), 133–161. https://doi.org/10.3982/ECTA15732
Kent, D. M., Paulus, J. K., van Klaveren, D., D’Agostino, R., Goodman, S., Hayward, R., Ioannidis, J. P. A., Patrick-Lake, B., Morton, S., Pencina, M., Raman, G., Ross, J. S., Selker, H. P., Varadhan, R., Vickers, A., Wong, J. B., y Steyerberg, E. W. (2020). The Predictive Approaches to Treatment effect Heterogeneity (PATH) Statement. Annals of Internal Medicine, 172(1), 35–45. https://doi.org/10.7326/M18-3667
Kitagawa, T., y Tetenov, A. (2018). Who should be treated? Empirical welfare maximization methods for treatment choice. Econometrica, 86(2), 591–616. https://doi.org/10.3982/ECTA13288
Wager, S., y Athey, S. (2018). Estimation and inference of heterogeneous treatment effects using random forests. Journal of the American Statistical Association, 113(523), 1228–1242. https://doi.org/10.1080/01621459.2017.1319839
Zhao, Y., Zeng, D., Rush, A. J., y Kosorok, M. R. (2012). Estimating individualized treatment rules using outcome weighted learning. Journal of the American Statistical Association, 107(499), 1106–1118. https://doi.org/10.1080/01621459.2012.695674