Un programa que simula un millón de personas puede producir una media muy precisa y, aun así, representar mal la intervención que interesa. La precisión numérica depende de cuántas trayectorias se generan. La validez de la estimación depende también de los datos, de los modelos utilizados y de los supuestos que relacionan esos datos con una intervención. Aumentar el número de personas simuladas modifica una parte del problema.
La fórmula g permite expresar el resultado esperado de una estrategia longitudinal mediante distribuciones observables, bajo condiciones causales explícitas. Su implementación paramétrica estima esas distribuciones mediante modelos y las combina para reconstruir las historias que produciría la estrategia. La simulación hacia delante es una forma de efectuar esa combinación cuando sumar todas las historias resulta difícil.
Estas operaciones pueden examinarse por separado. Primero se establece qué cantidad sería identificable si conociéramos perfectamente la distribución observada. Después se decide cómo estimar las piezas con una muestra finita. Finalmente se calcula la suma o integral correspondiente. Un ejemplo pequeño permite resolverla exactamente y comprobar cuánto añade cada fuente de aproximación.
Una suma sobre las historias de una intervención
Consideremos una característica basal , tres decisiones de tratamiento y dos estados intermedios. Su orden es . Cada estado se mide antes de la decisión que le sigue. El resultado aparece al terminar el seguimiento. Por ahora, todas las personas permanecen observadas y no hay acontecimientos que impidan definir el resultado.
Para una secuencia fija de decisiones, el resultado potencial se escribe . Definamos como la media observada del resultado dentro de esa historia completa. Bajo las condiciones de identificación, la media intervenida es
La suma conserva la distribución basal objetivo y deja que los estados respondan a las decisiones anteriores. No utiliza la distribución del estado de quienes espontáneamente completaron toda la secuencia. Cada factor corresponde a una transición dentro de la historia que se reconstruye.
Las probabilidades observadas de tratamiento no aparecen como factores de esta expresión para decisiones fijadas. La intervención reemplaza el mecanismo que elegía esas decisiones. Sin embargo, la forma de asignación observacional sigue importando para justificar el intercambio secuencial y comprobar que las historias intervenidas tienen apoyo en los datos.
Si la estrategia adapta decisiones al estado, sustituimos cada valor fijo por la regla correspondiente aplicada a la historia generada hasta ese momento. La primera decisión puede depender de la característica basal; la segunda, del estado intermedio ya simulado; la tercera, del estado posterior. Usar una variable futura para decidir violaría la estrategia temporal definida.
Naimi, Cole y Kennedy (2017) presentan la estandarización longitudinal como una operación que permite preservar las consecuencias de tratamientos anteriores mientras controla la confusión de decisiones posteriores. La igualdad causal requiere consistencia, intercambio secuencial y positividad. La capacidad de ejecutar la suma no demuestra que esas condiciones se cumplan en un estudio real.
Qué añade el adjetivo paramétrica
En una población pequeña con variables discretas podríamos estimar cada probabilidad mediante proporciones y cada media mediante promedios de celdas. Con muchas variables o periodos, las historias posibles se multiplican. Algunas se observan pocas veces y otras no aparecen. La implementación paramétrica utiliza funciones que comparten información entre historias mediante un conjunto de parámetros.
Una regresión logística puede representar la probabilidad de un estado binario en función de su historia. Una regresión lineal puede representar una puntuación final continua. Si el resultado es un evento durante el seguimiento, pueden modelarse probabilidades de evento en cada intervalo. Estas elecciones describen componentes de una distribución; sus coeficientes no tienen que coincidir con efectos totales de estrategias.
Taubman y colaboradores (2009) muestran cómo combinar modelos de factores temporales y del resultado para evaluar intervenciones longitudinales. McGrath y colaboradores (2020) distinguen expresamente la fórmula g, como función de la distribución de datos, de un estimador paramétrico de esa función. La identificación causal y la adecuación de los modelos utilizados para estimarla son requisitos diferentes.
El ajuste de una regresión no convierte una historia improbable en una historia bien observada. Un modelo puede asignar probabilidades y resultados a regiones con poco apoyo, pero esas predicciones dependen más de su forma funcional. Por ello, la revisión de las estrategias y de su soporte debe preceder a la interpretación de las simulaciones.
Una población sintética que puede enumerarse
Construyamos un programa ficticio con tres oportunidades de recibir apoyo. Cada decisión binaria indica si la sesión se asigna y se recibe; en esta construcción ambas cosas coinciden. Los estados intermedios indican carga alta de dificultades. La característica basal identifica un perfil distinto, presente en el cuarenta por ciento de la población. La puntuación final tiene unidades arbitrarias, y valores menores representan menor carga.
Usaremos dos modelos logísticos. Si es una probabilidad, . Las reglas verdaderas del ejemplo son
El coeficiente de la primera decisión en el segundo modelo es cero por construcción; su influencia puede continuar a través del primer estado. Esa restricción facilita el ejemplo y no constituye una recomendación general sobre qué historia omitir.
Las probabilidades son sencillas. Cuando la expresión dentro del paréntesis vale cero, la probabilidad es un medio; si vale uno, es dos tercios; si vale menos uno, es un tercio; si vale dos, es cuatro quintos. Todas las combinaciones permitidas producen probabilidades interiores entre cero y uno. Podemos trabajar con fracciones exactas, aunque las ecuaciones se hayan escrito como modelos logísticos.
La media del resultado final está dada por
El resultado individual añade un error normal independiente de media cero y desviación estándar dos. Este error produce variación dentro de historias idénticas, pero no cambia sus medias. El producto entre la segunda decisión y el estado posterior incorpora interacción: la contribución de esa decisión a la puntuación depende del estado que se produzca después.
Para generar datos observacionales, asignamos la primera sesión con probabilidad , la segunda con y la tercera con . Cada asignación utiliza un sorteo independiente condicionado por esa historia. Así, la atención depende del pronóstico registrado, y los estados responden a la atención anterior. Las sesenta y cuatro historias binarias observacionales tienen probabilidad positiva.
Cuatro estrategias con reglas completas
La primera estrategia no asigna ninguna sesión. La segunda asigna las tres. La tercera asigna solo la inicial. La cuarta utiliza una regla adaptada: asigna la primera sesión cuando el perfil basal vale uno, la segunda cuando el primer estado indica carga alta y la tercera cuando la indica el segundo estado.
La regla adaptada se resume como , y . Cada igualdad usa una variable conocida antes de decidir. La regla no selecciona retrospectivamente a quienes acabaron con carga alta; actúa en el momento definido, sobre el estado producido por las decisiones anteriores. Li, Young y Toh (2017) destacan esta necesidad de describir estrategias mediante decisiones que respondan a la historia disponible.
Para cualquiera de las cuatro estrategias quedan ocho historias de estados: dos valores basales, dos valores del primer estado y dos del segundo. Las decisiones están determinadas por la estrategia y por esos estados. Las ocho posibilidades deben incluirse, también cuando la regla prescribe no tratar en alguna de ellas. Omitir una rama eliminaría parte de la población objetivo.
La media de una estrategia resume sus resultados en toda la población. No equivale a la respuesta de una persona específica ni identifica quién se beneficiaría individualmente de cambiarla. En la regla adaptada, algunas personas reciben ninguna sesión y otras reciben varias; la comparación utiliza la regla completa que produce esa distribución.
También podemos calcular el número esperado de sesiones. Esta cantidad ayuda a describir la intervención que se está simulando, aunque no sustituye una evaluación de costes, preferencias u otros resultados. En nuestro ejemplo, ninguna de las ecuaciones pretende representar esos aspectos adicionales.
La solución exacta antes de simular
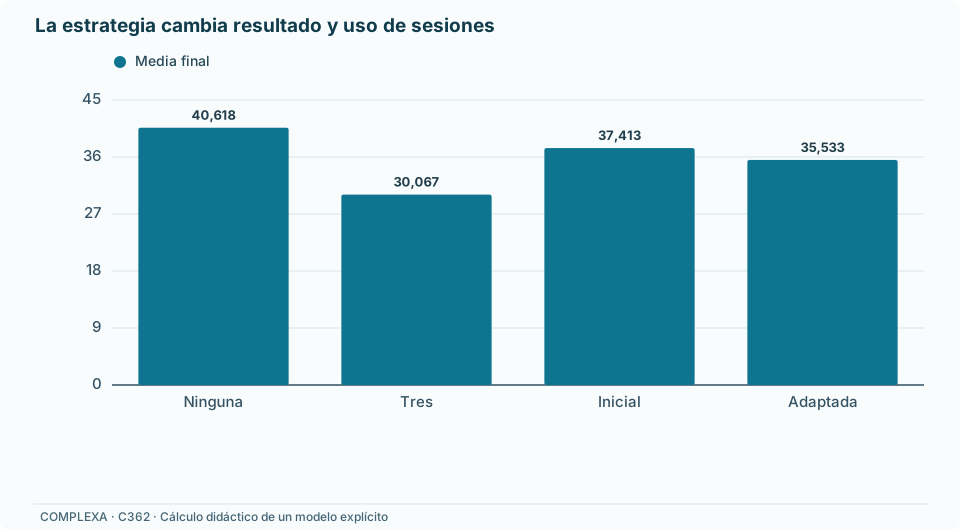
La probabilidad de cada historia se obtiene multiplicando la probabilidad basal por las dos probabilidades de transición, utilizando en cada paso la decisión indicada. Después se multiplica esa probabilidad por la media del resultado correspondiente. Sumar las ocho contribuciones produce la media de la estrategia.
Una rama de la regla adaptada comienza con perfil basal cero, pasa por carga baja en el primer estado y carga alta en el segundo. Su probabilidad es . Las decisiones son cero, cero y uno; su puntuación media es treinta y cuatro. La contribución de esa rama al promedio poblacional es 5,1 puntos. Las otras siete completan la suma.
La enumeración exacta da las siguientes cantidades. Los decimales se redondean únicamente para presentar la tabla; el cálculo utiliza fracciones.
| Estrategia | Media final | Sesiones medias por persona |
|---|---|---|
| Ninguna sesión | 40,618 | 0 |
| Las tres sesiones | 30,067 | 3 |
| Solo la inicial | 37,413 | 1 |
| Regla adaptada al perfil y al estado | 35,533 | 1,467 |
El contraste de las tres sesiones frente a ninguna es aproximadamente menos 10,551 puntos. El de la regla adaptada frente a ninguna es menos 5,084. Estas cantidades son efectos de los mecanismos inventados y no estimaciones clínicas. La tabla tampoco establece una estrategia óptima: ese juicio necesitaría un objetivo que incluyera las consecuencias relevantes de utilizar más o menos sesiones.
La regla adaptada permite comprobar algunas cuentas sin enumerar todas las ramas. Como la primera decisión iguala el perfil basal, el primer modelo logístico tiene predictor cero para todos y produce carga alta con probabilidad un medio. Como la segunda decisión iguala el primer estado, el segundo predictor se reduce al perfil basal. La probabilidad marginal de carga alta posterior es entonces diecisiete treintavos.
El número esperado de sesiones es la suma de las probabilidades de recibir cada una: cuatro décimos, un medio y diecisiete treintavos. El resultado es veintidós quinceavos, aproximadamente 1,467. Esta comprobación separada ayuda a detectar si el programa aplica la regla al estado correcto o reutiliza accidentalmente una historia observada.
Generar historias hacia delante
Para aproximar la misma suma por Monte Carlo, generamos primero el perfil basal de cada persona simulada. Aplicamos la primera decisión de la estrategia, calculamos la probabilidad del primer estado y sorteamos ese estado. A continuación aplicamos la segunda decisión, calculamos y sorteamos el segundo estado, aplicamos la tercera decisión y obtenemos la media predicha del resultado.
La simulación conserva todas las posibilidades de estado permitidas por los modelos. Una persona que simula carga baja en el primer momento puede pasar a carga alta en el segundo. Otra puede mejorar. Restringir el algoritmo a trayectorias que solo empeoran, por ejemplo, calcularía una población distinta de la que definen nuestras ecuaciones.
En la ejecución reproducible se generó un millón de trayectorias por estrategia, con semilla 3622026. Para comparar estrategias se utilizaron sorteos coordinados, conservando la distribución correcta de cada una. La coordinación es un recurso de cálculo; no aporta identificación de efectos individuales en personas reales.
Con los parámetros verdaderos, la media simulada para las tres sesiones fue 30,083, frente al valor exacto 30,067. Para la regla adaptada fue 35,538, frente a 35,533. Todas las ocho historias de estados aparecieron en cada simulación. La comparación con la enumeración permite verificar que el algoritmo reproduce las reglas declaradas y cuantificar la discrepancia numérica.
No fue necesario sortear el error final del resultado. Para estimar una media podemos promediar directamente las medias condicionales a lo largo de las historias simuladas. Añadir errores independientes de media cero mantendría la misma esperanza, pero introduciría variación numérica innecesaria. Si buscáramos una probabilidad de superar un umbral o un cuantil, necesitaríamos representar también la distribución del resultado pertinente.
Estimar las piezas con una muestra observada
Hasta ahora hemos usado los parámetros verdaderos de la población inventada. Para representar una aplicación estadística generamos una muestra observacional de veinte mil personas, con semilla 20261026. Cada persona sigue las probabilidades de asignación descritas, y su resultado incluye el error normal. Esta muestra contiene las sesenta y cuatro historias posibles, aunque la menos frecuente aparece solo ocho veces.
Con ella ajustamos el primer estado mediante una regresión logística con intercepto, perfil basal y primera decisión. Ajustamos el segundo mediante otra regresión logística con intercepto, perfil basal, primer estado y segunda decisión. Finalmente, ajustamos una regresión lineal del resultado con los términos de su ecuación, incluida la interacción. Los parámetros verdaderos no se introducen en esos ajustes: se estiman a partir de los datos generados.
También estimamos la distribución basal mediante la proporción observada. En esta muestra el perfil uno aparece en el 40,725 por ciento, frente al cuarenta por ciento de la población generadora. Esa diferencia forma parte de la variación muestral de la estandarización. No estamos redefiniendo deliberadamente la población objetivo; estamos aproximando su distribución con la muestra disponible.
Los modelos tienen la forma correcta porque conocemos cómo se generaron los datos. Aun así, sus parámetros estimados difieren de los verdaderos. El intercepto del primer modelo logístico es aproximadamente menos 0,016; sus coeficientes para perfil basal y primera decisión son aproximadamente 0,675 y menos 0,686. Los valores verdaderos eran cero, el logaritmo de dos y su negativo.
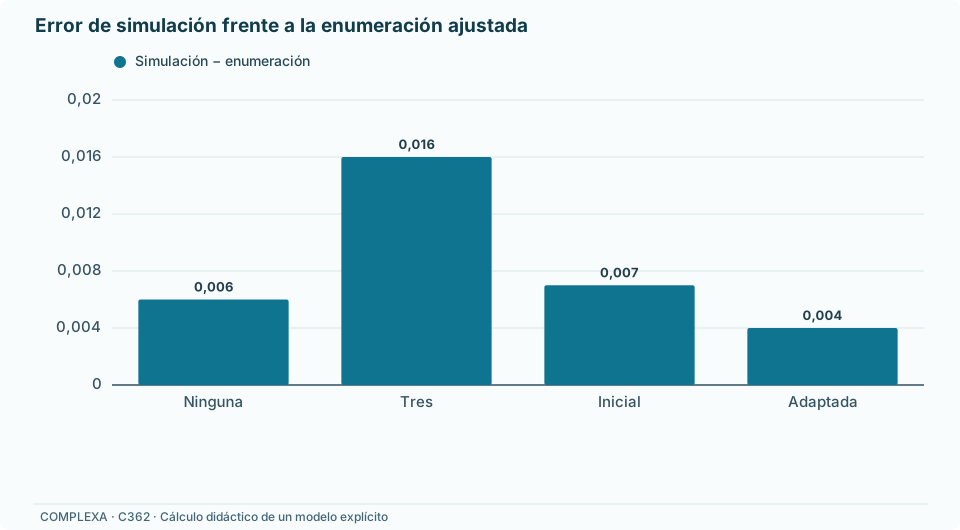
Sustituimos entonces las probabilidades y medias verdaderas por las ajustadas. Podemos integrar otra vez por enumeración de las ocho historias o por un millón de trayectorias simuladas. La tabla compara esas dos formas de calcular el mismo estimador paramétrico.
| Estrategia | Enumeración con modelos ajustados | Simulación con modelos ajustados |
|---|---|---|
| Ninguna sesión | 40,715 | 40,721 |
| Las tres sesiones | 30,191 | 30,207 |
| Solo la inicial | 37,548 | 37,555 |
| Regla adaptada | 35,597 | 35,601 |
Para las tres sesiones aparecen ahora tres números diferentes. El mecanismo verdadero da 30,067. El estimador integrado sin error Monte Carlo da 30,191. Su aproximación simulada da 30,207. La primera diferencia refleja que los modelos y la distribución basal fueron estimados con una muestra finita; la segunda procede de la aproximación numérica.
La enumeración con parámetros ajustados es exacta respecto de la distribución ajustada, salvo redondeo computacional. No significa que sea exacta respecto de la población verdadera. Esta distinción evita llamar «verdad» a un resultado solo porque se obtuvo con una suma determinista.
Las decisiones observacionales ayudan a obtener datos para ajustar los componentes, pero no se conservan al evaluar una estrategia. Para simular las tres sesiones, todos reciben las tres aunque en el registro sintético hubieran seguido otra secuencia. Los estados posteriores se generan de nuevo bajo esas decisiones; copiar los estados observados de cada persona mantendría consecuencias de una intervención distinta.
Cuánto error introduce Monte Carlo
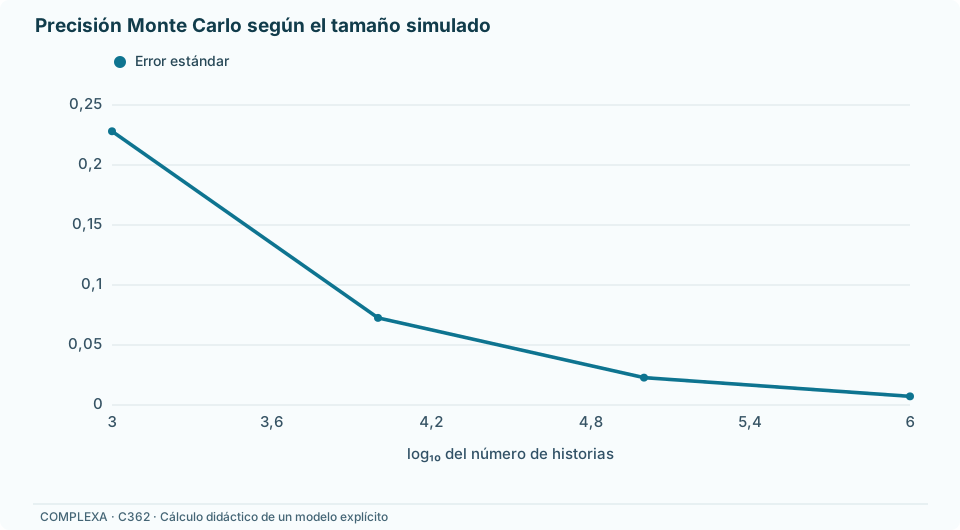
Si las trayectorias simuladas son independientes entre personas y los modelos permanecen fijos, el error estándar numérico de una media puede aproximarse mediante la desviación estándar de sus predicciones dividida por la raíz del número de trayectorias. La variabilidad relevante es la de las cantidades que realmente se promedian, aquí medias condicionales del resultado.
Con los parámetros verdaderos y la estrategia de tres sesiones, la desviación estándar poblacional de esas predicciones es aproximadamente 7,225. Con un millón de historias, el error estándar Monte Carlo es aproximadamente 0,0072 puntos. Ese cálculo describe la precisión de la integración del modelo conocido. No utiliza el tamaño de la muestra observacional ni cuantifica la incertidumbre de los parámetros ajustados.
La ejecución con tamaños crecientes produjo las siguientes medias. Se utilizó la misma semilla y se ampliaron las historias generadas; las cifras muestran una realización concreta.
| Trayectorias simuladas | Media de tres sesiones | Error estándar Monte Carlo |
|---|---|---|
| 1.000 | 30,033 | 0,2281 |
| 10.000 | 30,141 | 0,0726 |
| 100.000 | 30,119 | 0,0228 |
| 1.000.000 | 30,083 | 0,0072 |
La aproximación de mil historias quedó, por casualidad, más cerca del valor exacto que algunas aproximaciones mayores. Aumentar el tamaño reduce la variabilidad esperada; no obliga a que cada nueva realización se acerque monótonamente a la respuesta. Por eso conviene estimar el error numérico o repetir semillas, en vez de juzgar la precisión por una coincidencia afortunada.
Multiplicar por cien el número de trayectorias reduce aproximadamente por diez ese error estándar, bajo las condiciones indicadas. La reducción no añade personas observadas al estudio. Si la estimación depende de una asociación aprendida con pocas historias reales, simular más puede calcular esa asociación con mayor precisión sin mejorar su respaldo empírico.
Cuando las estrategias comparten sorteos, sus errores numéricos están correlacionados. Para calcular el error de una diferencia, se utiliza la variabilidad de las diferencias emparejadas entre predicciones. Sumar las varianzas como si las simulaciones fueran independientes ignoraría esa coordinación. La comprobación computacional del ejemplo conserva ese emparejamiento.
La incertidumbre de aprender los modelos
El tamaño observacional y el tamaño simulado cumplen tareas diferentes. Si repitiéramos el estudio de veinte mil personas, cambiarían la composición basal, los estados registrados y los parámetros ajustados. Esa variación seguiría existiendo aunque integráramos cada estimador por enumeración exacta. La ejecución de un millón de historias no convierte el estudio en un estudio de un millón de participantes.
Una forma de evaluar la variabilidad muestral es el bootstrap. Se remuestrean personas completas con todas sus observaciones, se vuelven a ajustar los modelos y se recalculan las medias de las estrategias. Remuestrear filas temporales como si pertenecieran a sujetos independientes rompería la dependencia de cada historia, salvo que otro diseño justificara una unidad distinta.
El remuestreo debe reproducir las etapas de estimación que contribuyen a la incertidumbre. Si la distribución basal se estima con la muestra, también cambia en cada réplica. Si procede de una población externa conocida, se mantiene según ese objetivo. Cuando también se estima con datos externos, su propia incertidumbre requiere una consideración adicional.
Keil y colaboradores (2014) separan en su procedimiento una cohorte observada pequeña, una población simulada mayor y la repetición del análisis en muestras bootstrap. Taubman y colaboradores (2009) también recalculan el procedimiento en muestras remuestreadas. Esas aplicaciones ilustran la diferencia entre producir historias para integrar y repetir el aprendizaje estadístico para evaluar incertidumbre.
El número simulado dentro de cada réplica debe ser suficiente para que el ruido numérico no domine la dispersión entre réplicas. Si algunas se calculan con pocas historias, sus diferencias pueden reflejar tanto la muestra remuestreada como una integración ruidosa. Es posible estudiar ambas contribuciones por separado, repitiendo simulaciones con parámetros fijos y repitiendo después el ajuste de parámetros.
Las tablas anteriores corresponden a una única muestra sintética. Sus errores Monte Carlo no son intervalos de confianza para los efectos poblacionales. Un intervalo muestral, además, permanecería condicionado por el diseño y los supuestos de los modelos. No incorporaría automáticamente la posibilidad de una causa de tratamiento y resultado que no haya sido registrada.
Contrastar la evolución habitual
Antes de interpretar una estrategia intervenida, conviene comprobar qué produce el sistema de modelos cuando se reproduce el mecanismo habitual de decisiones. En el ejemplo conocemos ese mecanismo: las tres probabilidades de tratamiento dependen de las historias especificadas. En un estudio observacional real, simular la evolución habitual puede requerir estimar también cómo se asigna el tratamiento.
Se comparan entonces resultados y estados simulados con sus distribuciones observadas en momentos equivalentes. Una media final cercana puede coexistir con una distribución intermedia equivocada. También pueden compensarse errores: demasiadas personas con carga alta y una respuesta predicha demasiado favorable pueden producir el promedio correcto por razones incorrectas.
Por ello resulta útil examinar proporciones de estados, transiciones, distribuciones de resultados y su relación con historias relevantes. En este modelo binario podemos revisar cada combinación. Con estados continuos habrá que evaluar rangos y formas de distribución, además de sus medias. Una estrategia adaptada a un umbral depende particularmente de cómo se modela la probabilidad de cruzarlo.
McGrath y colaboradores (2020) explican que la concordancia entre la evolución habitual simulada y los datos observados ayuda a detectar problemas importantes de especificación, pero no garantiza que los modelos sean correctos. Tampoco verifica el intercambio secuencial. Una causa omitida puede afectar conjuntamente decisiones y resultado mientras el modelo reproduce bien la distribución observada.
La comparación debe referirse al mismo proceso de seguimiento. Si la simulación elimina las pérdidas y la estimación observada resume únicamente la información disponible bajo pérdidas, una discrepancia puede deberse a la diferencia de objetivos. Taubman y colaboradores (2009) discuten esta necesidad de comparar procesos equivalentes al examinar la evolución sin intervención.
Las estrategias nuevas pueden cambiar la frecuencia de historias poco comunes en el programa habitual. Un buen ajuste promedio en ese programa puede ocultar errores precisamente donde la nueva estrategia coloca más población. La revisión debe seguir las distribuciones generadas por cada intervención, sin limitarse a una medida global de predicción.
Cuando la forma del modelo falla
El ejemplo incluyó una interacción entre la segunda decisión y el estado posterior. Si reajustamos la regresión del resultado omitiéndola, obtenemos aproximadamente 30,255 para las tres sesiones y 35,562 para la regla adaptada, al integrar las predicciones ajustadas. Son resultados distintos de los del modelo que conserva la interacción.
La modificación afecta también a los demás coeficientes: no equivale a borrar un sumando de la ecuación verdadera y mantener intacto el resto. La regresión reducida intenta representar mediante otros términos una relación que ya no puede expresar completamente. Su consecuencia en una media intervenida depende de las historias que esa estrategia hace frecuentes.
En esta realización, alguna estimación reducida puede quedar casualmente más cerca del valor verdadero. Esa coincidencia no convierte en correcta la familia de modelos que omite una interacción presente por construcción. Comparar sesgo, variabilidad y cobertura exige repetir muestras bajo mecanismos conocidos o realizar evaluaciones adecuadas; una sola proximidad numérica no establece desempeño general.
Los errores de transición también se propagan. Una probabilidad equivocada del primer estado cambia la población que llega al segundo modelo y, bajo una estrategia adaptada, cambia las decisiones que se toman. El resultado final depende de esa trayectoria de errores. No basta con revisar el modelo del desenlace como si las historias que recibe fueran externas a la estimación.
Modelos más flexibles pueden representar relaciones que una forma sencilla excluye, pero siguen necesitando datos informativos y una evaluación de su ajuste. La simulación paramétrica descrita no posee una garantía general de protección frente a cualquier componente mal especificado. Aumentar el número de trayectorias puede hacer más estable una media sesgada por la forma de sus modelos.
Verificar que el programa calcula la estrategia declarada
Una simulación puede coincidir aproximadamente con una media y contener un error en alguna transición. La revisión del programa necesita comprobaciones más localizadas. En el ejemplo, las probabilidades de las ocho ramas suman uno bajo cada estrategia. La suma de las probabilidades de las sesenta y cuatro historias observacionales también es uno. Son distribuciones diferentes, construidas para preguntas distintas.
Las medias de los estados ofrecen controles adicionales. Bajo las tres sesiones, la probabilidad del primer estado alto es 0,40 y la del segundo es siete quinceavos. Bajo ninguna sesión, son diecisiete treintavos y quinientos ochenta y siete novecientosavos. Si el programa conserva la misma distribución intermedia entre esas estrategias, está reutilizando información que debería haber cambiado.
En una regla adaptada, comprobar únicamente el número de sesiones asignadas puede ser insuficiente. Dos algoritmos pueden asignar la misma cantidad media y hacerlo a historias distintas. Conviene verificar la acción en cada rama: el perfil basal determina la primera, el primer estado determina la segunda y el segundo estado determina la tercera. La verificación debe utilizar los estados que el propio algoritmo acaba de generar.
También hay que revisar la inicialización. Cada estrategia comienza en la misma población basal objetivo, pero necesita su propia evolución posterior. Los sorteos pueden coordinarse para facilitar la comparación numérica; los estados de una estrategia no se copian sin modificación a otra. Las probabilidades deben recalcularse usando las decisiones y los antecedentes que corresponden a cada trayectoria.
La predicción final exige mantener la interacción y todas las unidades. Una puntuación media calculada correctamente para una historia puede entrar con un peso incorrecto y producir un promedio equivocado. Por eso la rama de probabilidad 0,15 y contribución 5,1 se comprueba separadamente, además de verificar el total. Una coincidencia global puede ocultar errores que se compensan.
El archivo de cálculo conserva parámetros generadores, coeficientes ajustados, semillas, tamaños y resultados de las comprobaciones. Esto permite distinguir una modificación de estrategia de una modificación del modelo o del cálculo numérico. Si se cambia la regla de una sesión, deben volver a verificarse todas las ramas afectadas, incluidas aquellas en las que no se asigna tratamiento. La reproducibilidad abarca la población que el programa recorre, además del valor final que imprime.
Cambiar el tipo de resultado
Para un resultado final continuo, hemos promediado predicciones de una media. Si el resultado fuera binario, podríamos promediar probabilidades condicionales. Si fuera el tiempo hasta un primer evento, habría que representar la ocurrencia de ese evento durante los intervalos y conservar quién continúa en riesgo.
Una simulación de supervivencia no debe seguir generando estados clínicos ordinarios después de un evento terminal. La trayectoria cambia a un estado absorbente o se incorpora mediante una formulación equivalente. Las probabilidades condicionales de supervivencia se combinan a lo largo de cada historia antes de promediar entre historias. El producto de probabilidades marginales promedio no reproduce en general esa operación.
Los acontecimientos competidores también requieren definición. Una muerte por otra causa puede impedir observar el evento principal; tratarla como una simple pérdida de información cambia la pregunta. El estimando debe indicar qué eventos se conservan y qué intervención, si alguna, se plantea sobre el seguimiento. El número de personas simuladas no resuelve una definición ambigua de esos estados.
Keil y colaboradores (2014) desarrollan el algoritmo para datos de tiempo hasta evento, y McGrath y colaboradores (2020) describen implementaciones para varios tipos de resultado. Las fórmulas específicas cambian con el objetivo, aunque se mantenga la idea de combinar respuestas y transiciones bajo una estrategia. Nuestro cálculo terminal evita esas complicaciones para que la verificación de cada rama sea transparente.
La simulación hacia delante es una implementación
Una suma finita puede calcularse sin sorteos. Además de enumerar las ocho historias, verificamos las medias integrando primero sobre el segundo estado, después sobre el primero y finalmente sobre la característica basal. La igualdad entre ambos cálculos sirve como comprobación algebraica independiente de la simulación.
En problemas más amplios existen estimadores basados en expectativas condicionales iteradas que recorren la estructura de forma recursiva. Wen y colaboradores (2021) comparan implementaciones que modelan distribuciones y simulan hacia delante con otras que utilizan regresiones sucesivas de expectativas condicionales. Comparten el objetivo causal y las condiciones de identificación, pero difieren en qué componentes estiman y cómo los combinan.
Por tanto, no toda aplicación de la fórmula g necesita generar personas simuladas ni ajustar cada distribución de covariables del modo utilizado aquí. La elección computacional depende de la estructura, del estimador y de las relaciones que resulte razonable modelar. Cambiar de implementación tampoco elimina la necesidad de definir la estrategia o justificar sus supuestos causales.
En el ejemplo, las cuatro estrategias usan los mismos mecanismos estimados; lo que cambia son las decisiones impuestas. La enumeración, la integración recursiva y el programa de simulación recorren todas sus ramas permitidas. Para las tres sesiones, esto permite distinguir el valor poblacional de 30,067, la estimación muestral de 30,191 y su aproximación simulada de 30,207. Cada cifra conserva así una función concreta dentro del análisis.
Referencias
Keil, A. P., Edwards, J. K., Richardson, D. B., Naimi, A. I., y Cole, S. R. (2014). The parametric g-formula for time-to-event data: Intuition and a worked example. Epidemiology, 25(6), 889–897. https://doi.org/10.1097/EDE.0000000000000160
Li, X., Young, J. G., y Toh, S. (2017). Estimating effects of dynamic treatment strategies in pharmacoepidemiologic studies with time-varying confounding: A primer. Current Epidemiology Reports, 4(4), 288–297. https://doi.org/10.1007/s40471-017-0124-x
McGrath, S., Lin, V., Zhang, Z., Petito, L. C., Logan, R. W., Hernán, M. A., y Young, J. G. (2020). gfoRmula: An R package for estimating the effects of sustained treatment strategies via the parametric g-formula. Patterns, 1(3), 100008. https://doi.org/10.1016/j.patter.2020.100008
Naimi, A. I., Cole, S. R., y Kennedy, E. H. (2017). An introduction to g methods. International Journal of Epidemiology, 46(2), 756–762. https://doi.org/10.1093/ije/dyw323
Taubman, S. L., Robins, J. M., Mittleman, M. A., y Hernán, M. A. (2009). Intervening on risk factors for coronary heart disease: An application of the parametric g-formula. International Journal of Epidemiology, 38(6), 1599–1611. https://doi.org/10.1093/ije/dyp192
Wen, L., Young, J. G., Robins, J. M., y Hernán, M. A. (2021). Parametric g-formula implementations for causal survival analyses. Biometrics, 77(2), 740–753. https://doi.org/10.1111/biom.13321