La segunda decisión de un tratamiento suele tomarse con información que todavía no existía al decidir la primera. Una persona mejora y continúa con menos apoyo; otra empeora y recibe una intervención adicional. Si comparamos después a quienes recibieron más y menos atención, las diferencias reflejan tanto los efectos del tratamiento como los motivos que hicieron cambiarlo. Además, esos motivos pueden haber sido modificados por el tratamiento anterior.
Esta relación produce una dificultad particular. El estado observado durante el seguimiento ayuda a explicar la elección posterior, pero también puede transmitir efectos de la elección inicial. Ajustar por él en una regresión y leer los coeficientes del tratamiento como efectos totales puede eliminar parte de lo que se quería medir. Omitirlo puede dejar sin controlar la confusión de las decisiones posteriores. La salida requiere representar la secuencia y definir qué decisiones se cambiarían.
La palabra retroalimentación describe aquí una sucesión temporal: la intervención modifica el estado, el estado informa la próxima intervención y esta vuelve a modificar la trayectoria. No supone una influencia del futuro sobre el pasado. Tampoco implica que toda asociación longitudinal padezca el mismo problema. Importa cuáles son las relaciones causales y qué efecto de la secuencia se pretende estimar.
Una variable puede ocupar dos posiciones causales
Consideremos el orden . La primera decisión de intervención es . El estado se mide después de esa decisión y antes de la segunda, . El resultado se observa al terminar el seguimiento. Los subíndices indican momentos de decisión; una covariable basal, si existiera, precedería a toda esta secuencia.
Supongamos que la primera intervención modifica el estado intermedio y que este influye tanto en la decisión posterior como en el resultado. Respecto del efecto de la segunda intervención, el estado intermedio es una variable de confusión: permite distinguir personas cuya probabilidad de recibirla y cuyo pronóstico ya eran diferentes. Respecto del efecto de la primera, puede ser una consecuencia y un mediador. Llamarlo simplemente «variable de control» borra esa diferencia.
La clasificación causal depende del contraste. Una puntuación de síntomas puede ser resultado intermedio de una intervención inicial y antecedente de una intervención posterior. Su función tampoco queda determinada por ser una escala clínica, una característica biológica o una variable social. La fecha de medición, el mecanismo que la genera y la información usada al decidir sitúan esa variable en el análisis.
Robins (1986) desarrolló métodos para estudiar exposiciones sostenidas en situaciones donde la evolución de las personas influye en su exposición posterior. La formulación de modelos estructurales marginales de Robins, Hernán y Brumback (2000) hizo explícito el problema de los confusores temporales afectados por exposiciones anteriores. La dificultad persiste aunque una regresión describa correctamente las medias observadas: identificar el efecto de una estrategia exige una operación causal adicional.
El motivo de una decisión forma parte de la historia
Un antecedente metodológico aparece en el estudio de Hernán, Brumback y Robins (2000) sobre zidovudina y supervivencia en hombres con VIH. El recuento de linfocitos CD4 era una variable temporal relevante para el tratamiento y el pronóstico, y podía ser afectado por el tratamiento previo. Esta doble posición permitió mostrar por qué controlar solo las características iniciales y ajustar convencionalmente los valores posteriores respondían de manera insuficiente al problema longitudinal.
El interés de ese antecedente es la estructura causal. No necesitamos trasladar sus estimaciones a tratamientos actuales ni a otras poblaciones. En un programa de apoyo psicológico podría aparecer una estructura semejante si el malestar modifica la intensidad de atención y la atención anterior modifica ese malestar. También podría faltar alguna de esas relaciones; habría que establecerla para el programa concreto.
La historia disponible antes de la segunda decisión puede incluir mucho más que la última puntuación. Importan las decisiones previas, su duración, respuestas anteriores, efectos adversos, preferencias y circunstancias que afectan el acceso. Si dos personas tienen la misma puntuación actual pero una viene mejorando y otra empeorando, el profesional puede actuar de forma diferente. Resumir la historia con una sola medición puede omitir información usada realmente para decidir.
El registro debe separar lo conocido antes de una decisión de lo medido después. Una escala completada al finalizar una sesión ya puede incorporar su efecto. Usarla como si hubiera determinado esa misma sesión altera el orden del problema. La fecha administrativa de una visita tampoco asegura que todas las variables registradas ese día precedan a la intervención.
Un programa ficticio con ocho historias posibles
Construyamos una población didáctica. Hay dos oportunidades para recibir una sesión de apoyo, codificadas por las dos decisiones binarias. El estado intermedio vale uno cuando la carga de dificultades es alta y cero cuando es baja. El resultado posterior es una puntuación de carga; valores menores representan una situación más favorable dentro del ejemplo. Las ecuaciones y los números son inventados y no describen la eficacia de ningún tratamiento.
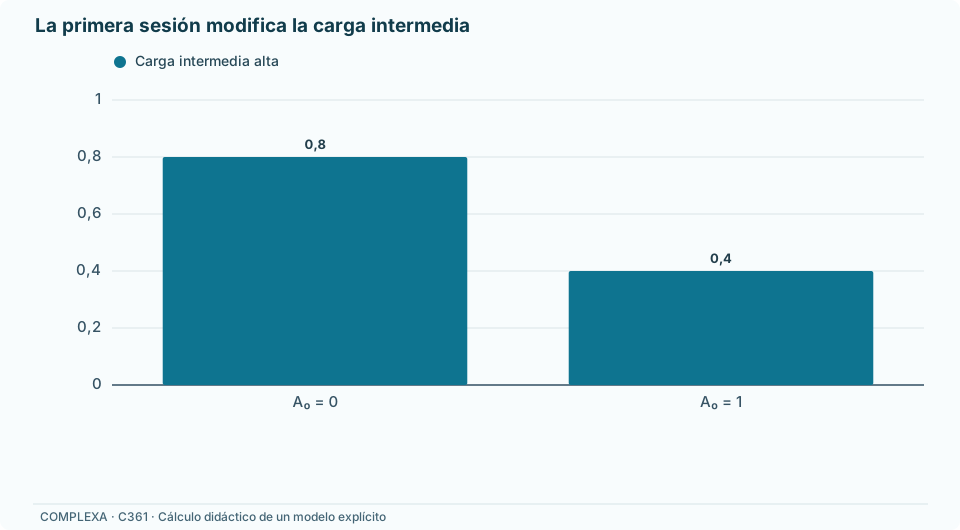
La primera sesión se asigna al azar con probabilidad un medio. En esta construcción, cada sesión asignada se recibe. La probabilidad de carga alta antes de la segunda sesión es 0,80 sin la primera y 0,40 con ella. La segunda sesión se asigna con probabilidad 0,20 si la carga intermedia es baja y 0,80 si es alta. Estos sorteos utilizan variables aleatorias independientes. Por tanto, la decisión posterior depende del estado registrado y no de alguna información adicional oculta.
Formalmente, las dos últimas reglas son y . La puntuación queda determinada por
La primera sesión tiene una contribución directa de menos dos puntos y modifica la distribución del estado intermedio. La segunda resta cuatro puntos en cualquiera de las historias. La carga intermedia alta añade diez puntos. Al ser una población construida, podemos conocer estos mecanismos y contrastarlos con lo que mostrarían sus datos observados.
Una representación exacta por mil personas distribuye la masa de probabilidad de la siguiente manera. Los recuentos son una forma de expresar la población hipotética, no una muestra producida por un sorteo real.
| Primera sesión | Carga intermedia alta | Segunda sesión | Personas por mil | Puntuación |
|---|---|---|---|---|
| 0 | 0 | 0 | 80 | 20 |
| 0 | 0 | 1 | 20 | 16 |
| 0 | 1 | 0 | 80 | 30 |
| 0 | 1 | 1 | 320 | 26 |
| 1 | 0 | 0 | 240 | 18 |
| 1 | 0 | 1 | 60 | 14 |
| 1 | 1 | 0 | 40 | 28 |
| 1 | 1 | 1 | 160 | 24 |
Todas las historias tienen probabilidad positiva. Podemos observar ambas decisiones posteriores dentro de cada combinación de intervención inicial y estado. Esa propiedad será necesaria para reconstruir las estrategias fijadas. No elimina por sí misma la confusión: solo asegura que las comparaciones pertinentes tienen representación en esta población.
La atención posterior parece perjudicial
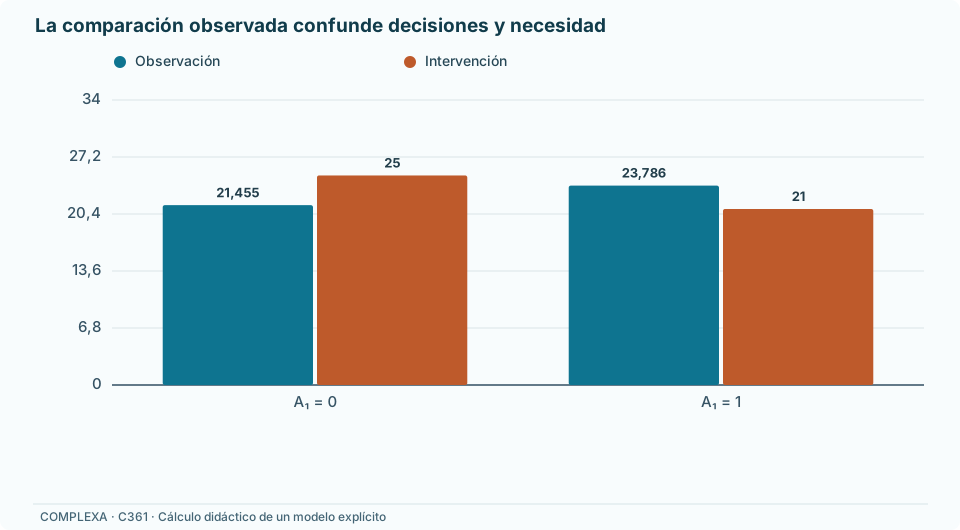
Entre quienes no reciben la primera sesión, la puntuación media de quienes tampoco reciben la segunda es veinticinco. Entre quienes reciben únicamente la segunda, es aproximadamente 25,412. La asociación observada sugiere una puntuación algo peor con esa sesión, aunque sabemos que su efecto causal es reducir cuatro puntos en cualquier persona.
La discrepancia se explica por la composición de los grupos. Sin primera sesión, la proporción de carga intermedia alta es un medio entre quienes no reciben la segunda y dieciséis diecisieteavos entre quienes la reciben. La atención adicional se concentra donde el pronóstico era peor. Al comparar resultados sin considerar ese estado, la diferencia mezcla el efecto beneficioso construido con la mayor carga previa de quienes son atendidos.
La misma inversión aparece entre quienes sí reciben la primera sesión. Las medias observadas son aproximadamente 19,429 sin segunda sesión y 21,273 con ella. Las proporciones de carga alta son un séptimo y ocho onceavos, respectivamente. Haber recibido la intervención inicial no elimina la selección que ocurre al decidir la siguiente.
Estas cuentas muestran por qué una asociación positiva entre intensidad de atención y carga posterior no identifica un efecto perjudicial de la atención. La conclusión causal depende del mecanismo de asignación. En este ejemplo lo conocemos exactamente; en una investigación observacional habría que justificar que la historia medida captura suficientemente las razones de la decisión.
Comparar a quienes recibieron las dos sesiones con quienes no recibieron ninguna tampoco resuelve el problema. Sus medias observadas son aproximadamente 21,273 y 25, con una diferencia de menos 3,727 puntos. La historia completa de tratamiento sigue siendo seleccionada: pertenecer al grupo de dos sesiones depende del estado intermedio producido después de la primera.
Ajustar por el estado y conservarlo fijo
Podemos recuperar sin error la ecuación del resultado mediante una regresión que incluya las dos decisiones y el estado intermedio. En esta población, el coeficiente de la primera decisión es menos dos, el de la segunda menos cuatro y el de la carga alta diez. El ajuste estadístico es perfecto porque las ecuaciones definen exactamente los datos.
Sin embargo, el contraste de dos sesiones frente a ninguna, conservando el mismo estado intermedio, es menos seis. El cálculo deja fuera el cambio de carga intermedia provocado por la primera sesión. Si la pregunta era por la diferencia entre dos estrategias completas, esa comparación condicional retiene una parte diferente del proceso.
Aquí conviene separar observación e intervención. Comparar personas con el mismo estado observado selecciona grupos según una variable posterior a la primera decisión. En este mecanismo particular, las condiciones que hemos construido hacen que el contraste condicional coincida con el obtenido al fijar también ese estado por intervención. La coincidencia necesita esos supuestos; observar un estado y producirlo deliberadamente son operaciones diferentes.
El efecto de cambiar la primera sesión, manteniendo fija la segunda pero dejando que el estado responda a la primera, es menos seis puntos: menos dos por la contribución directa y menos cuatro por la reducción de la probabilidad de carga alta. Mantener además fijo el estado deja solamente la contribución de menos dos. Ambos cálculos tienen sentido en el modelo, pero cambian decisiones y procesos distintos.
Por tanto, el problema no se corrige buscando un coeficiente que parezca más ajustado. La regresión condicional contiene información útil sobre las respuestas dentro de cada historia. Para responder por una estrategia completa hay que combinar esa información con la distribución del estado que produciría la estrategia. Daniel y colaboradores (2013) presentan esta diferencia como parte del motivo para utilizar métodos longitudinales apropiados.
Cambiar una decisión o fijar toda la secuencia
Hay otra pregunta identificable gracias al sorteo inicial: qué ocurre al ofrecer la primera sesión y conservar la regla habitual para la segunda. En esa comparación, la decisión posterior continúa respondiendo al estado que se produzca. No se fija que todas las personas reciban la segunda sesión ni se conserva su valor observado antes de imaginar el cambio inicial.
Podemos escribir la regla posterior como , donde es un sorteo uniforme independiente. Al intervenir sobre la primera decisión, dejamos intacta esta regla, pero permitimos que cambie el estado intermedio. Así, el cambio inicial puede modificar tanto la carga como la frecuencia de atención posterior.
Sin primera sesión, la probabilidad marginal de recibir la segunda es . Con primera sesión, desciende a . Las medias finales son 25,28 y 20,24, respectivamente. La diferencia es menos 5,04 puntos, y coincide con la comparación observada entre los grupos de asignación inicial porque esa asignación fue aleatoria.
La reducción de la carga intermedia y la contribución directa sumarían menos seis puntos si la segunda decisión permaneciera fijada. Sin embargo, la regla habitual produce menos segundas sesiones después de la mejora inicial. Esa disminución resta parte del beneficio que proporcionaban: añade 0,96 puntos al resultado respecto de aquel contraste. Por eso aparecen menos 5,04 en lugar de menos seis.
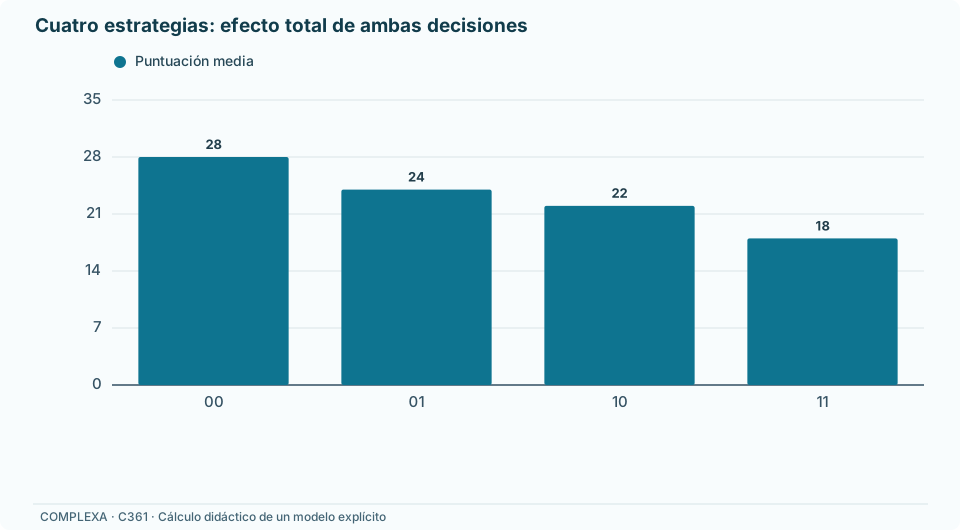
Fijar ambas sesiones da otra respuesta. Si nadie recibe ninguna, la media es veintiocho. Si todas las personas reciben las dos, es dieciocho. El efecto de esa estrategia conjunta es menos diez puntos. La primera aleatorización permite identificar el cambio inicial dentro del sistema posterior habitual, pero no convierte automáticamente la comparación observada entre trayectorias completas en una comparación aleatoria.
Promediar sobre el estado que cada estrategia genera
Denotemos por el resultado que se observaría al fijar las dos decisiones en valores determinados. El estado intermedio queda libre para responder a la primera decisión. Bajo consistencia, intercambio secuencial y positividad, la media de esa estrategia se expresa como
En nuestro ejemplo no hay covariables basales. Si las hubiera, las medias y probabilidades se calcularían dentro de sus valores y después se promediarían sobre la población objetivo. La fórmula utiliza el estado intermedio para resolver la comparación de la decisión posterior, y conserva su distribución bajo la decisión inicial elegida.
Para la estrategia sin sesiones, las puntuaciones posibles son veinte y treinta. Se ponderan por 0,20 y 0,80, que son las probabilidades de carga baja y alta sin primera intervención. El resultado es veintiocho. Para la estrategia con ambas sesiones, las puntuaciones son catorce y veinticuatro; sus pesos son 0,60 y 0,40. El promedio es dieciocho.
Las estrategias mixtas completan la comparación. Recibir solo la segunda sesión da veinticuatro puntos; recibir solo la primera da veintidós. Estas medias no coinciden necesariamente con las de los grupos que siguieron esas trayectorias espontáneamente. La fórmula cambia la distribución con la que se combinan los resultados condicionales para representar decisiones intervenidas.
Utilizar los mismos pesos del estado intermedio en todas las estrategias eliminaría parte del cambio producido por la primera sesión. Por ejemplo, una distribución común con igual cantidad de estados altos y bajos produciría veinticinco para ninguna sesión y diecinueve para ambas: volvería a aparecer una diferencia de menos seis. El error respecto del efecto conjunto está en qué población intermedia se reconstruye.
Esta forma de estandarización longitudinal constituye el núcleo de la fórmula g. Naimi, Cole y Kennedy (2017) muestran con un ejemplo trabajado cómo puede controlar la confusión de una decisión posterior sin conservar artificialmente la distribución de una variable afectada por decisiones anteriores. Ajustar una respuesta condicional puede formar parte del procedimiento; interpretar directamente uno de sus coeficientes como efecto de toda la estrategia no es la misma operación.
La regla posterior también pertenece a la pregunta
Podemos reemplazar la regla habitual probabilística por una indicación determinista: ofrecer la segunda sesión siempre que la carga intermedia sea alta y omitirla cuando sea baja. La segunda decisión queda entonces definida por . La persona sigue respondiendo a la primera intervención, pero su estado se traduce en una decisión mediante una regla diferente de la del programa original.
Con esa regla, no ofrecer la primera sesión produce una media de 24,8 puntos. Ofrecerla produce 20,4. La diferencia es menos 4,4 puntos. El cambio inicial continúa siendo el mismo, pero cambia el sistema de decisiones posteriores dentro del cual se evalúa. El efecto de iniciar atención no es una constante transportable entre protocolos posteriores diferentes.
Las cuentas se obtienen sustituyendo la nueva regla en la ecuación del resultado: la carga intermedia añade diez puntos y, cuando es alta, activa una sesión que resta cuatro. Su contribución neta es de seis puntos. La reducción de cuarenta puntos porcentuales en la carga alta aporta así menos 2,4 puntos, a los que se suman los menos dos de la contribución directa inicial.
La estrategia que ofrece la primera sesión y reserva la segunda para carga alta utiliza, en promedio, 1,4 sesiones por persona. La estrategia que ofrece ambas utiliza dos y produce dieciocho puntos en lugar de 20,4. Este cálculo permite describir conjuntamente atención utilizada y resultado dentro del modelo. Elegir entre estrategias requeriría valorar otras consecuencias, recursos y preferencias que la puntuación construida no contiene.
La nueva regla puede evaluarse porque sus decisiones tienen apoyo en todas las historias pertinentes del programa observado. No exige encontrar un grupo de personas que haya sido asignado al protocolo completo. Exige reconstruir qué estados produciría la primera decisión y cuál sería la respuesta a la segunda decisión indicada en cada uno. Esa es la información que organiza el análisis longitudinal.
Seleccionar por el estado puede abrir una asociación
El bloqueo de una vía causal no es el único problema posible. Construyamos un mecanismo diferente, separado del anterior, para examinar la selección. Existe ahora una característica no observada , presente en la mitad de la población, que influye en el estado intermedio y en el resultado. La primera sesión continúa asignándose al azar; la segunda depende exclusivamente del estado registrado mediante la misma regla probabilística anterior.
Sin primera sesión, la probabilidad de carga alta es 0,20 cuando esa característica está ausente y 0,80 cuando está presente. Con primera sesión, esas probabilidades bajan a 0,10 y 0,40. La carga alta marginal pasa de un medio a un cuarto. El resultado de este segundo mecanismo es : la primera sesión y el estado intermedio no tienen un efecto propio sobre esa puntuación.
Por tanto, si fijamos la segunda decisión, cambiar la primera no modifica el resultado de ninguna persona. El estado intermedio es un indicador de la característica latente y determina la atención posterior, pero intervenir sobre ese indicador no equivale a cambiar la característica que afecta el resultado. Esta diferencia está incorporada en las ecuaciones y delimita el ejemplo.
Entre quienes tienen carga intermedia baja y no recibieron la primera sesión, la proporción con la característica latente es 0,20. Entre quienes tienen la misma carga baja después de recibirla, es 0,40. La primera sesión hace posible que más personas con esa característica terminen en el grupo de carga baja. Seleccionar el mismo estado observado ya no conserva grupos comparables.
Si además fijamos el mismo valor de la segunda decisión, las puntuaciones condicionales difieren en dos puntos, desfavorables a la primera sesión. Esa asociación aparece aunque el efecto de cambiarla, con la segunda fijada, sea cero. En el estrato de carga alta, la proporción de la característica latente es 0,80 en ambos grupos y la asociación correspondiente es nula.
La estructura responsable es . El estado intermedio es un efecto común de la primera decisión y de la característica latente. Condicionar por él abre una asociación entre esas causas. Por eso un coeficiente condicionado por una variable posterior no puede recibir automáticamente el nombre de efecto directo. Li, Young y Toh (2017) explican esta forma de sesgo al estudiar estrategias de tratamiento.
La fórmula g conserva la respuesta correcta en este segundo mecanismo. Con la segunda sesión fijada en cero, las puntuaciones condicionales son veintidós y veintiocho sin primera sesión, ponderadas por mitades: media veinticinco. Con primera sesión, son veinticuatro y veintiocho, ponderadas por tres cuartos y un cuarto: otra vez veinticinco. Usar pesos comunes de un medio daría veinticinco y veintiséis, creando una diferencia espuria.
Que exista una causa no observada del estado y del resultado no destruye por sí solo esta identificación. En el mecanismo construido, la asignación posterior utiliza únicamente el estado medido y un sorteo independiente. La característica latente no aporta otra vía de selección del tratamiento después de condicionar por la historia. Esto permite distinguir una causa no medida del resultado de un confusor no controlado de las decisiones.
Lo que exige el intercambio secuencial
La condición de intercambio secuencial se refiere a cada decisión en su momento. Antes de la primera, comparamos personas con la misma historia basal pertinente; antes de la segunda, comparamos historias que incluyen las decisiones anteriores y el estado ya observado. Dentro de esas historias, la elección debe ser independiente de los resultados potenciales relevantes para las estrategias evaluadas.
En los ejemplos, la primera decisión está sorteada y la segunda utiliza una probabilidad conocida que solo depende del estado. Esas reglas justifican la condición por construcción. En un registro asistencial, habría que sostenerla con información sobre cómo se toman las decisiones. Una impresión clínica que no aparece en las variables registradas podría influir en la elección posterior y anticipar el resultado, dejando confusión residual.
La condición no exige que la segunda intervención sea marginalmente independiente del pronóstico. De hecho, los ejemplos hacen que se concentre entre quienes tienen carga alta. Exige independencia después de considerar una historia suficiente. Tampoco exige que el estado intermedio sea independiente del tratamiento inicial: conservar esa dependencia es necesario para representar las consecuencias de la primera intervención.
Una aleatorización inicial justifica el intercambio para esa primera decisión, pero no para decisiones posteriores tomadas fuera del protocolo experimental. Un ensayo puede identificar el efecto de la asignación inicial bajo la atención que después ocurre, mientras que el efecto de cumplir una secuencia completa requiere controlar las razones del cumplimiento y los cambios de tratamiento.
La historia utilizada para ajustar debe contener información disponible antes de la decisión correspondiente. Incorporar una variable futura porque mejora la predicción del resultado puede abrir otras vías de selección o bloquear efectos. La suficiencia causal de una historia no se evalúa únicamente comparando el rendimiento predictivo de modelos con distintas cantidades de variables.
Opciones posibles y tratamientos definidos
La positividad exige que las acciones previstas por una estrategia puedan observarse en las historias que esa estrategia genera. En el primer mecanismo, la probabilidad de la segunda sesión es siempre 0,20 o 0,80, de modo que ambas opciones están representadas. Podemos reconstruir tanto recibirla como no recibirla en cada estado.
Si la regla habitual ordenara obligatoriamente una segunda sesión para toda persona con carga alta, no observaríamos resultados sin esa sesión dentro de ese grupo. Una estrategia que propusiera omitirla allí carecería de apoyo directo en los datos. La extensión de una recta de regresión a esa combinación no crearía la comparación ausente; introduciría una restricción adicional sobre la respuesta.
La condición se evalúa respecto de las estrategias concretas. Una falta de apoyo para omitir una sesión en cierta historia no impide necesariamente estudiar una regla que siempre la indique en esa historia. Del mismo modo, las historias que una estrategia nunca produce no requieren la misma comprobación que aquellas que sí contribuyen a su resultado esperado.
La consistencia requiere precisar qué representan las decisiones. Dos sesiones de duración, contenido y condiciones diferentes pueden quedar comprimidas en el mismo indicador de atención. Si esas versiones tienen efectos distintos, el significado de intervenir sobre el indicador necesita mayor definición. También deben mantenerse explícitos el horizonte del resultado y las condiciones de atención posteriores al último momento modelado.
Reconstruir las estrategias mediante ponderación
Otra forma de recuperar las mismas medias utiliza las probabilidades de las decisiones observadas. En el primer ejemplo, cada persona que sigue una estrategia fijada recibe un peso igual al inverso del producto de la probabilidad de su primera decisión y la probabilidad de su segunda decisión dada la historia. Las personas con trayectorias menos probables representan más historias comparables.
Entre quienes reciben ambas sesiones, las sesenta personas de carga baja tienen un peso de diez: la probabilidad de esa secuencia de decisiones, dada su historia, es un medio por 0,20. Las ciento sesenta personas de carga alta tienen un peso de 2,5. Las cantidades ponderadas son seiscientas y cuatrocientas, que conservan la distribución de carga generada por la primera sesión.
Al promediar sus puntuaciones catorce y veinticuatro con esas cantidades, obtenemos dieciocho. Para la estrategia sin sesiones, las ochenta personas de carga baja representan doscientas, y las ochenta de carga alta representan ochocientas. Las puntuaciones veinte y treinta producen entonces veintiocho. La diferencia coincide con los menos diez puntos de la fórmula g.
Los pesos contienen probabilidades de tratamiento, no el inverso de la probabilidad de toda la historia incluyendo el estado. Cancelar también la probabilidad del estado borraría la distribución que la intervención inicial debe generar. La ponderación busca corregir la selección de decisiones mientras conserva las consecuencias de decisiones anteriores.
Un modelo estructural marginal representa cómo varían las medias contrafactuales entre estrategias; la ponderación es una forma de estimarlo. Es útil separar ambos conceptos, como hacen Robins, Hernán y Brumback (2000). En una población con solo cuatro estrategias podemos calcular sus medias directamente. Con historias largas suele ser necesario resumirlas mediante una función, cuya adecuación también debe examinarse.
El calendario de observación puede cambiar el problema
En una base de datos longitudinal, repetir una medición cada mes no garantiza que se haya registrado el estado que motivó cada decisión. Puede haber contactos entre visitas, cambios urgentes o información transmitida por otras personas. Si una modificación del tratamiento responde a esos cambios, usar únicamente la última visita programada puede dejar una parte importante de la decisión sin representar.
También puede ocurrir que la frecuencia de medición responda al estado. Quienes empeoran son evaluados antes y acumulan más registros. Comparar observaciones como si todas correspondieran al mismo calendario puede mezclar evolución con intensidad de vigilancia. A veces será necesario definir conjuntamente una estrategia de seguimiento y una estrategia de tratamiento, en lugar de suponer que las mediciones aparecen a intervalos externos al proceso.
El ejemplo ha fijado dos oportunidades de atención y una medición intermedia. Eso vuelve inequívoca la información disponible para decidir. Trasladarlo a un programa real requiere especificar cuánto dura cada intervalo, qué ocurre si una sesión se retrasa y cómo se clasifica una intervención adicional. Dividir el tiempo en intervalos muy amplios puede ocultar el orden entre deterioro e intervención.
La memoria del proceso también importa. Si la segunda decisión depende de dos estados anteriores, una regla que use solamente el más reciente podría no controlar la confusión. En cambio, incluir toda la historia sin una estrategia de modelado puede crear combinaciones con escasa información. La elección de un resumen de historia necesita una justificación sobre qué información modifica conjuntamente la decisión y el pronóstico.
Li, Young y Toh (2017) subrayan estas exigencias de datos al describir estrategias dinámicas. La disponibilidad de muchas filas por persona ayuda cuando esas filas contienen las mediciones pertinentes y respetan el calendario de las decisiones. La cantidad de registros, por sí misma, no establece el intercambio secuencial.
Seguimiento incompleto y cambios de pregunta
Hasta aquí, todas las personas tienen un resultado observado. Si quienes acumulan mayor carga abandonan el seguimiento, analizar solo a quienes continúan añade una selección. Esa selección puede depender de intervenciones previas y de variables intermedias, por lo que comparte la estructura temporal del problema de tratamiento.
Para identificar un resultado bajo seguimiento completo habría que definir esa intervención y justificar condiciones que permitan relacionar los resultados observados con los de quienes dejan de ser observados. Podrían utilizarse modelos de permanencia o ponderaciones adicionales, bajo supuestos apropiados. El mecanismo de pérdida no desaparece al incluir el último estado registrado en la regresión del resultado.
Abandonar una intervención y abandonar el estudio son acontecimientos distintos. Una persona puede dejar de recibir sesiones y seguir proporcionando resultados; otra puede continuar recibiéndolas fuera del sistema que registra los datos. Confundir ambos eventos altera la historia de tratamiento o elimina precisamente las trayectorias relevantes para la estrategia que se quiere comparar.
Tampoco toda variable temporal afectada por tratamiento obliga a abandonar cualquier análisis convencional. Si la pregunta se limita al efecto de una asignación inicial aleatoria bajo la atención posterior habitual, la comparación inicial puede ser válida. Si una variable posterior no interviene en la confusión de decisiones futuras, puede no existir la dificultad específica de retroalimentación descrita aquí. La estructura y el estimando determinan el método necesario.
En el programa ficticio, un informe que compare estrategias debería conservar las cuatro medias intervenidas: veintiocho sin sesiones, veinticuatro con solo la segunda, veintidós con solo la primera y dieciocho con ambas. Si el informe evalúa únicamente cambiar la oferta inicial manteniendo la regla posterior, las medias pertinentes son 25,28 y 20,24. Indicar qué decisiones se fijan y cuáles siguen respondiendo al estado permite interpretar por qué esos resultados son diferentes.
Referencias
Daniel, R. M., Cousens, S. N., De Stavola, B. L., Kenward, M. G., y Sterne, J. A. C. (2013). Methods for dealing with time-dependent confounding. Statistics in Medicine, 32(9), 1584–1618. https://doi.org/10.1002/sim.5686
Hernán, M. A., Brumback, B., y Robins, J. M. (2000). Marginal structural models to estimate the causal effect of zidovudine on the survival of HIV-positive men. Epidemiology, 11(5), 561–570. https://doi.org/10.1097/00001648-200009000-00012
Li, X., Young, J. G., y Toh, S. (2017). Estimating effects of dynamic treatment strategies in pharmacoepidemiologic studies with time-varying confounding: A primer. Current Epidemiology Reports, 4(4), 288–297. https://doi.org/10.1007/s40471-017-0124-x
Naimi, A. I., Cole, S. R., y Kennedy, E. H. (2017). An introduction to g methods. International Journal of Epidemiology, 46(2), 756–762. https://doi.org/10.1093/ije/dyw323
Robins, J. M. (1986). A new approach to causal inference in mortality studies with a sustained exposure period—application to control of the healthy worker survivor effect. Mathematical Modelling, 7(9–12), 1393–1512. https://doi.org/10.1016/0270-0255(86)90088-6
Robins, J. M., Hernán, M. A., y Brumback, B. (2000). Marginal structural models and causal inference in epidemiology. Epidemiology, 11(5), 550–560. https://doi.org/10.1097/00001648-200009000-00011