El informe inicial contiene una comparación incómoda. Entre quinientas personas que iniciaron un programa terapéutico, doscientas cuarenta alcanzaron el resultado funcional previsto. Entre quinientas que continuaron con atención habitual, lo alcanzaron trescientas. Las proporciones son cuarenta y ocho y sesenta por ciento. Quien lea únicamente esas dos cifras podría concluir que el programa empeora la respuesta en doce puntos porcentuales. Antes de atribuirle ese efecto necesitamos saber a quiénes se ofreció, cuándo se inició la comparación y qué resultado se intentaba estimar.
Todos los datos de este caso son construidos. El programa carece de una identidad clínica real y sus resultados no evalúan psicoterapia, medicamentos ni un servicio existente. Su finalidad es permitir que cada cambio de pregunta pueda seguirse hasta los denominadores y las operaciones que lo producen. La construcción conserva mil registros individuales, junto con una versión separada de sus resultados potenciales para comprobar las cuentas.
El diseño del ejercicio se fijó antes de generar esos archivos. Compara la iniciación de un programa al comienzo del seguimiento con atención habitual, mide una respuesta binaria a doce semanas y distingue tres poblaciones objetivo. El programa de estimación utiliza exclusivamente las variables que un estudio observacional podría registrar. Otro programa, separado, comprueba las conclusiones frente a los resultados potenciales del generador. Esa separación permite examinar qué aprende el análisis y qué sabe únicamente quien construyó el ejemplo.
Una decisión situada en el tiempo
El tiempo cero corresponde al momento en que se verifica la elegibilidad y se decide iniciar el programa o continuar la atención habitual. Nadie ha comenzado previamente el programa y ambas opciones están disponibles en los dos niveles de gravedad basal considerados. El indicador representa iniciar el programa en ese momento; , continuar con atención habitual. Las estrategias posteriores quedan incluidas en lo que sigue habitualmente a cada decisión inicial dentro del mundo simplificado del ejercicio.
El desenlace vale uno cuando, a las doce semanas, se alcanza un criterio funcional prefijado, y cero cuando no se alcanza. Para concretarlo podemos pensar en completar sin ayuda una tarea estandarizada ficticia de organización cotidiana dentro de un tiempo establecido. No es una escala validada ni una definición diagnóstica. El mismo criterio y el mismo momento de evaluación se aplican bajo ambas estrategias. La interpretación estadística dependerá de mantener constante esa regla.
Suponemos medición completa del resultado, ausencia de mortalidad durante el período y ausencia de interferencia entre participantes. La respuesta de una persona depende de su propia estrategia, sin cambios provocados por las estrategias de las demás. También suponemos una versión suficientemente definida de cada opción. Estas simplificaciones permiten concentrar el problema en la asignación inicial y en la composición de la población, sin introducir datos de adherencia o desenlaces adicionales que el archivo no contiene.
Describir ese calendario aproxima la pregunta a un experimento objetivo. Hernán y Robins (2016) proponen explicitar el ensayo que se intenta emular al trabajar con datos observacionales, incluyendo elegibilidad, estrategias y comienzo del seguimiento. Aquí sabemos qué decisión correspondería asignar en tiempo cero. Clasificar después a las personas según el número de sesiones que finalmente completaron cambiaría la intervención comparada y utilizaría información posterior para formar los grupos.
El detalle que desapareció del primer informe
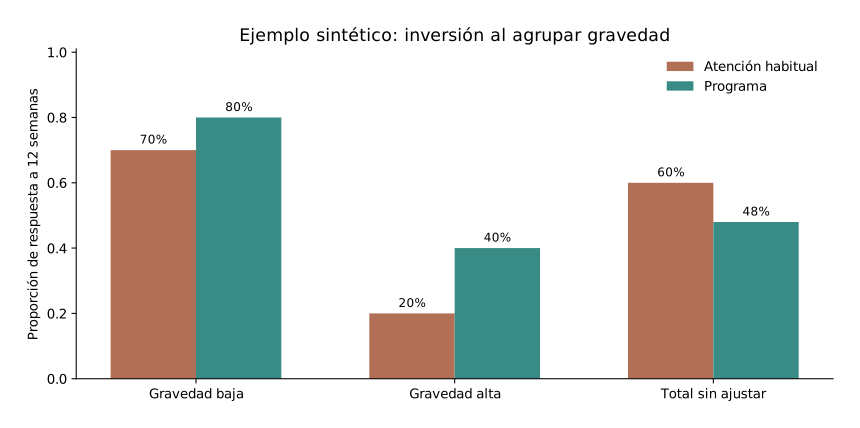
La variable se mide antes de la decisión y distingue gravedad basal baja, codificada como cero, y alta, codificada como uno. En la población inicial hay quinientas personas de cada nivel. La probabilidad construida de iniciar el programa es veinte por ciento entre las de gravedad baja y ochenta por ciento entre las de gravedad alta. Así se representa una asignación que dirige el programa con mayor frecuencia hacia quienes tienen peor pronóstico inicial.
| Gravedad basal | Estrategia | Personas | Respuestas a doce semanas | Proporción de respuesta |
|---|---|---|---|---|
| Baja | Programa | 100 | 80 | 0,80 |
| Baja | Atención habitual | 400 | 280 | 0,70 |
| Alta | Programa | 400 | 160 | 0,40 |
| Alta | Atención habitual | 100 | 20 | 0,20 |
La primera comparación sumó las filas de cada estrategia sin conservar esa composición. Las personas que iniciaron el programa contienen ochenta por ciento de gravedad alta, mientras que las de atención habitual contienen veinte por ciento. Dentro de cada nivel, la respuesta es mayor entre quienes iniciaron el programa: la diferencia observada es de diez puntos porcentuales en gravedad baja y de veinte en gravedad alta. El contraste agregado tiene el signo contrario.
Podemos reconstruir el promedio de los iniciadores como . El de atención habitual es . Cada promedio utiliza una mezcla diferente de gravedad. Las cuentas son correctas; el problema aparece cuando se interpreta su diferencia como si ambas estrategias se hubieran aplicado a una misma población.
Este cambio de dirección pertenece a los fenómenos asociados con la paradoja de Simpson. Su presencia no demuestra que el análisis condicionado sea siempre el adecuado. Hernán, Clayton y Keiding (2011) explican por qué la estructura causal y el significado de las variables determinan qué comparación interesa. Una variable basal que contribuye a la asignación y al resultado tiene un papel distinto del de una consecuencia posterior de la intervención. La aritmética de una tabla no establece por sí sola esa diferencia.
En nuestro generador, la gravedad precede a la decisión y organiza las distribuciones de respuesta potencial. Ese orden justifica examinarla como factor de confusión. En una base de datos real habría que documentar cómo se midió y qué conocimiento respalda su relación con la decisión terapéutica. Llamar «gravedad basal» a una puntuación registrada después del inicio no haría que esa medición tuviera automáticamente las propiedades supuestas aquí.
El resultado que habría tenido la misma población
Denotaremos por la respuesta que tendría una persona si iniciara el programa y por la que tendría con atención habitual. Solo se observa una de ellas. La consistencia del ejemplo exige que el resultado registrado sea . La formulación mediante resultados potenciales permite definir el efecto antes de escoger un método para estimarlo, siguiendo la separación planteada por Rubin (1974).
La pregunta sobre todas las personas elegibles se expresa como , el efecto promedio en la población inicial. Es la diferencia entre dos escenarios: uno en que todas esas personas inician el programa y otro en que todas continúan con atención habitual. Los escenarios se refieren a las mismas mil personas. El grupo que recibió efectivamente cada estrategia sirve para aprender sobre esos resultados, pero no define por sí solo el denominador del efecto.
Para identificarlo desde las variables observadas suponemos intercambiabilidad condicional: dentro de cada nivel de gravedad, la decisión inicial no aporta información adicional sobre cada resultado potencial. También necesitamos posibilidad de recibir ambas estrategias en los estratos pertinentes. En la tabla existen iniciadores y no iniciadores tanto con gravedad baja como alta. La positividad está satisfecha en esta construcción, aunque el reparto sea desigual.
Esos supuestos cumplen funciones diferentes. La consistencia conecta la intervención especificada con la experiencia registrada. La intercambiabilidad permite usar la respuesta observada de unas personas para representar resultados no observados de otras con la misma gravedad. La positividad permite que esa representación tenga apoyo en ambos grupos. Tener mil filas completas no reemplaza ninguna de esas condiciones.
Bajo ellas, el riesgo de respuesta si todas las personas iniciaran el programa se obtiene combinando los riesgos por gravedad con la distribución inicial: . Si todas continuaran con atención habitual, sería . La diferencia estandarizada es de quince puntos porcentuales a favor del programa.
Expresado sobre mil personas, el generador contiene seiscientas respuestas potenciales bajo el programa y cuatrocientas cincuenta bajo atención habitual. El análisis observacional recupera esas cantidades mediante los supuestos declarados. La comparación cruda utilizaba dos grupos de quinientas personas con distinta composición y encontraba una diferencia de signo contrario. No hemos cambiado el resultado de ninguna fila para obtener la nueva cifra.
Lo que aporta la estandarización
La fórmula general usada para una estrategia es
Las medias condicionales describen cómo responden los grupos observados dentro de cada gravedad. La distribución de establece a quiénes se quiere representar. Su combinación produce un promedio para esa población. Si el análisis informara únicamente el coeficiente de una regresión, habría que comprobar que ese coeficiente corresponde al mismo contraste y a la misma escala que esta fórmula.
Aquí los estratos son pocos y las cuatro proporciones se calculan directamente. No necesitamos asumir que el efecto es idéntico entre niveles, porque conservamos las diferencias de diez y veinte puntos. Una regresión que impusiera una diferencia constante tendría que reconciliar esos valores mediante restricciones adicionales. Añadir complejidad informática no mejora necesariamente una tabla cuyo problema puede resolverse mediante promedios explícitos.
El beneficio promedio de quince puntos tampoco describe a cada persona. En los datos observados, una respuesta favorable bajo el programa no permite saber si esa misma persona habría respondido con atención habitual. En el generador existen personas que responden con cualquiera de las estrategias, personas cuya respuesta cambia y personas que no responden bajo ninguna. La media resume sus resultados potenciales, sin identificar individualmente a quienes obtendrían el cambio.
La distinción entre resultado observado y efecto individual evita otro error del primer informe. Las doscientas cuarenta respuestas entre iniciadores no equivalen a doscientos cuarenta beneficios causados por el programa. Parte de esas personas habría respondido también bajo atención habitual. El efecto corresponde a una diferencia entre escenarios; el número observado de respuestas corresponde a un solo escenario realizado.
Preguntar por quienes efectivamente iniciaron
Un responsable del programa puede plantear una pregunta más acotada: entre quienes lo iniciaron, cuánto cambió la respuesta respecto de lo que habría ocurrido con esas mismas personas bajo atención habitual. Ese efecto promedio en tratados, habitualmente denominado ATT, se escribe . El efecto promedio general se denomina ATE. Son estimandos diferentes, aunque se utilicen las mismas cuatro proporciones para estimarlos (Imbens, 2004).
Los iniciadores tienen veinte por ciento de gravedad baja y ochenta por ciento de gravedad alta. Bajo el programa su respuesta promedio observada es cuarenta y ocho por ciento. Su respuesta contrafactual bajo atención habitual se calcula conservando esa composición: . La diferencia correspondiente es de dieciocho puntos porcentuales. Es mayor que el efecto general porque este grupo contiene más personas del estrato donde el efecto construido es mayor.
Podemos ahora descomponer exactamente la diferencia cruda. Al añadir y restar la respuesta contrafactual de los iniciadores bajo atención habitual, obtenemos un efecto de dieciocho puntos y una diferencia pronóstica de menos treinta puntos. Esta última compara treinta por ciento de respuesta esperada bajo atención habitual en los iniciadores con sesenta por ciento en los no iniciadores. La suma de ambos componentes es menos doce puntos, como en el informe inicial.
La descomposición aclara qué ocurrió. El contraste entre grupos mezcla un efecto favorable del programa con una composición inicial menos favorable entre quienes lo recibieron. El segundo componente supera al primero. En este mundo construido conocemos ambos porque fijamos los resultados potenciales; en una investigación observacional, estimar la parte contrafactual dependería de la intercambiabilidad y de la medición de las causas pertinentes de asignación.
El ATT también depende de cómo se seleccionó históricamente a quienes iniciaron. Si cambiara la política de acceso, podría cambiar la población de iniciadores y, con ella, su efecto promedio, aun manteniéndose los mismos efectos por gravedad. Por eso un efecto calculado entre usuarios actuales no responde automáticamente a la expansión del programa hacia personas que hoy no lo reciben.
Preguntar por quienes todavía no iniciaron
La pregunta de expansión puede formularse sobre los quinientos no iniciadores actuales. El efecto promedio en ese conjunto, denominado aquí ATC, es . Su composición contiene ochenta por ciento de gravedad baja y veinte por ciento alta. La respuesta observada con atención habitual es sesenta por ciento; la respuesta bajo el programa, estandarizada a esa mezcla, sería .
La diferencia es de doce puntos porcentuales. Coincide en magnitud con la comparación cruda, pero tiene el signo contrario y otro significado. La coincidencia numérica es una propiedad accidental de los valores elegidos. En un informe debe acompañarse cada cifra de su población y de los riesgos que se contrastan, para evitar que el nombre general «efectividad» reúna cantidades distintas.
| Pregunta | Respuesta con atención habitual | Respuesta con programa | Diferencia |
|---|---|---|---|
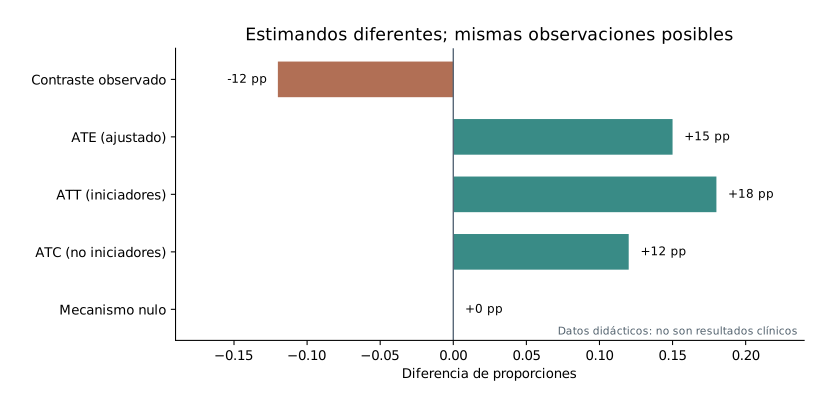
| Comparación descriptiva entre grupos observados | 0,60 | 0,48 | −0,12 |
| Misma población elegible: ATE | 0,45 | 0,60 | 0,15 |
| Mismos iniciadores actuales: ATT | 0,30 | 0,48 | 0,18 |
| Mismos no iniciadores actuales: ATC | 0,60 | 0,72 | 0,12 |
El contraste descriptivo conserva grupos diferentes a cada lado. Los otros tres conservan una misma población dentro de cada fila. Esa diferencia de construcción explica por qué no conviene presentarlos como cuatro estimadores rivales de un único efecto. Los tres últimos pueden ser simultáneamente correctos en el generador, mientras responden a decisiones distintas.
Para decidir una expansión real faltarían además resultados que aquí no se han definido, como efectos adversos, recursos requeridos y preferencias. El cálculo permite describir una respuesta funcional esperada bajo las condiciones del ejercicio. No convierte por sí solo ese desenlace en una medida completa del valor del programa ni establece a quién debería indicarse.
La escala del efecto también necesita un nombre
Hasta aquí hemos restado probabilidades. Si se utiliza una razón, la misma comparación para la población elegible pasa a ser . Esa razón expresa que la probabilidad de respuesta bajo el programa es aproximadamente un tercio mayor que bajo atención habitual, dentro del mecanismo y la población definidos. No significa un aumento de treinta y tres puntos porcentuales: el aumento absoluto continúa siendo de quince puntos.
En gravedad baja, la razón de probabilidades es ocho séptimos, aproximadamente uno coma catorce. En gravedad alta es dos. La diferencia absoluta entre estrategias también era mayor en gravedad alta, pero las dos escalas describen esa heterogeneidad con magnitudes distintas. Si otro ejemplo tuviera diferencias constantes y riesgos basales variables, sus razones podrían variar aun cuando la escala absoluta no mostrara esa variación. La afirmación «el efecto es el mismo» necesita indicar en qué escala se formula.
La razón marginal tampoco se obtiene promediando sin más las razones por estrato. En la población equilibrada, la media aritmética de ocho séptimos y dos es once séptimos, aproximadamente uno coma cincuenta y siete. La razón entre los riesgos estandarizados es cuatro tercios, aproximadamente uno coma treinta y tres. Las operaciones difieren porque dividir y promediar no son intercambiables. Para el contraste marginal deseado primero calculamos cada riesgo en la población objetivo y después formamos su razón.
Las odds introducirían otra transformación: para una probabilidad , son . No equivalen a la probabilidad cuando el resultado es frecuente, como ocurre aquí. Un programa de regresión logística puede entregar razones de odds sin que la pregunta original haya solicitado esa medida. Si la comunicación necesita diferencias de probabilidades, resulta necesario obtener las probabilidades predichas bajo cada estrategia y promediarlas en la población pertinente, respetando los supuestos del modelo.
Hernán y colaboradores (2011) también distinguen la confusión de la falta de colapsabilidad de algunas medidas. Una diferencia entre un coeficiente condicionado y una medida marginal puede surgir sin que una de las dos esté necesariamente sesgada. En este caso hemos elegido deliberadamente riesgos y diferencias explícitas para que el cambio de mezcla pueda verse directamente. Esa elección evita tratar como una corrección causal cualquier cambio numérico producido al añadir covariables a una regresión.
Repetir las cuentas mediante pesos
La probabilidad de iniciar el programa dada la gravedad es el puntaje de propensión . Rosenbaum y Rubin (1983) formalizaron su papel como puntaje de balance para covariables observadas. Aquí toma únicamente dos valores: un quinto y cuatro quintos. Podemos calcularlos directamente a partir de la tabla, sin un modelo de predicción complejo.
Para representar la población completa, cada iniciador recibe peso y cada no iniciador peso . Los cien iniciadores de gravedad baja reciben peso cinco y representan quinientas personas; los cuatrocientos de gravedad alta reciben peso uno coma veinticinco y también representan quinientas. Las ochenta respuestas del primer estrato contribuyen cuatrocientas respuestas ponderadas y las ciento sesenta del segundo contribuyen doscientas. El resultado es seiscientas entre mil.
En atención habitual, las cuatrocientas personas de gravedad baja reciben peso uno coma veinticinco y las cien de gravedad alta reciben peso cinco. Sus respuestas ponderadas son trescientas cincuenta y cien, respectivamente. La suma es cuatrocientas cincuenta entre mil. Así, la ponderación recupera exactamente los riesgos de la estandarización y el ATE de quince puntos porcentuales.
Los pesos cambian cuando cambia la población objetivo. Para el ATT conservamos peso uno en los iniciadores y ponderamos los no iniciadores por . En gravedad baja ese peso es un cuarto; en gravedad alta es cuatro. Los controles ponderados representan cien personas de gravedad baja y cuatrocientas de gravedad alta, la composición de los iniciadores. Sus respuestas ponderadas son setenta y ochenta, que suman ciento cincuenta entre quinientas.
Para el ATC conservamos peso uno en los no iniciadores y ponderamos a los iniciadores por . Los cien de gravedad baja representan cuatrocientos y los cuatrocientos de gravedad alta representan cien. Las respuestas ponderadas suman trescientas sesenta entre quinientas, es decir, setenta y dos por ciento. La misma tabla sustenta las tres operaciones, pero cada conjunto de pesos reconstruye una población distinta.
La coincidencia entre métodos es una comprobación algebraica útil. Detectaría, por ejemplo, una inversión accidental del puntaje de propensión o el uso del denominador de otra población. No demuestra que se hayan medido todos los factores de confusión pertinentes en un estudio real. Estandarización y ponderación pueden coincidir perfectamente y depender del mismo supuesto incorrecto sobre la información disponible.
Los pesos también muestran de dónde procede la información que sostiene una estimación. En el ATE, cien iniciadores de gravedad baja reciben el mismo peso total que cuatrocientos iniciadores de gravedad alta. Una variación de la respuesta entre los primeros puede influir más por persona en el promedio. Esto es una consecuencia del intento de representar una población equilibrada a partir de un grupo observado que estaba desequilibrado.
Una medida descriptiva de concentración es . Si todos los pesos son iguales, devuelve el número de personas; si unos pocos concentran más peso, disminuye. Para cada brazo ponderado del ATE, la suma de pesos es mil y la suma de sus cuadrados es tres mil ciento veinticinco. El cociente es trescientos veinte, aunque cada brazo observado contenga quinientas personas. Esa cantidad describe concentración de pesos; no convierte nuestro archivo determinista en una muestra aleatoria ni constituye por sí sola una fórmula de varianza válida para cualquier estimador.
En una aplicación, inspeccionar conjuntamente las celdas originales y sus contribuciones ponderadas permite localizar estimaciones apoyadas en pocos sujetos. Recortar pesos para que el diagnóstico parezca mejor modificaría la operación. Antes de hacerlo habría que especificar qué población y qué estimando se conservarían, en lugar de reemplazar silenciosamente los pesos de una pregunta por los de otra.
Abrir el archivo del generador
Para comprobar qué ocurrió en nuestro ejemplo, podemos consultar la versión didáctica que conserva ambas respuestas potenciales. Entre las quinientas personas de gravedad baja, trescientas cincuenta responderían bajo cualquiera de las estrategias, cincuenta solo bajo el programa y cien bajo ninguna. Entre las quinientas de gravedad alta, cien responderían bajo cualquiera, cien solo bajo el programa y trescientas bajo ninguna.
Dentro de cada uno de esos tipos, se asigna al programa la misma fracción correspondiente a la gravedad: un quinto en el nivel bajo y cuatro quintos en el alto. Todos los recuentos resultan enteros. Es una asignación balanceada construida para reproducir exactamente las proporciones condicionales, sin ruido de muestreo. No representa la afirmación de que cualquier sorteo finito produciría estos números.
En consecuencia, conocer la asignación no cambia la distribución de los resultados potenciales dentro de cada nivel de gravedad. En este mundo, el supuesto de intercambiabilidad condicional se cumple por construcción. Al contar directamente las respuestas potenciales obtenemos cuatrocientas cincuenta bajo atención habitual y seiscientas bajo el programa. Entre los iniciadores hay ciento cincuenta respuestas potenciales con atención habitual y doscientas cuarenta con programa; entre los no iniciadores, trescientas y trescientas sesenta.
El programa de comprobación verifica además la consistencia individual: el resultado observado de cada fila coincide con el resultado potencial correspondiente a su asignación. Esa comprobación evita que el ejemplo obtenga las medias esperadas mediante datos internamente contradictorios. El archivo observado contiene solo identificador, gravedad, estrategia y resultado; los resultados potenciales se mantienen fuera de la entrada del programa de estimación.
Un segundo mecanismo que produce el mismo archivo
Ahora podemos construir una alternativa que conserva todas las variables observadas. Para cada persona asignamos ambos resultados potenciales al valor que aparece en su fila: . Una persona que respondió habría respondido con cualquiera de las estrategias; quien no respondió no lo habría hecho con ninguna. Bajo este mecanismo, todos los efectos individuales y todos los efectos promedio son cero.
La consistencia sigue cumpliéndose: cualquiera que sea la estrategia efectivamente recibida, el resultado correspondiente coincide con el registrado. Las cuatro celdas de la tabla tampoco cambian. El programa de estandarización sigue produciendo quince puntos porcentuales, y los pesos siguen balanceando perfectamente la gravedad. Ningún cálculo que utilice solo identificador, gravedad, estrategia y resultado puede distinguir ambos mecanismos.
Lo que falla en el segundo mecanismo es la intercambiabilidad condicional. Dentro de gravedad baja, quienes iniciaron tienen una proporción de respuesta potencial de ochenta por ciento bajo cualquiera de las estrategias, mientras quienes no iniciaron tienen setenta por ciento. En gravedad alta las proporciones son cuarenta y veinte por ciento. Existe una selección adicional de tipos pronósticos que la variable de gravedad no representa. Podría describirse mediante una característica basal no medida que influye en asignación y respuesta.
Esta alternativa no demuestra que el efecto verdadero de un estudio observacional sea nulo. Demuestra que el archivo, por sí solo, es compatible con más de una explicación causal. Pearl (2009) sitúa la identificación causal precisamente en la combinación de distribuciones observadas y restricciones causales. Nuestro segundo mecanismo hace visible qué restricción estaba sosteniendo la interpretación del primero.
Las probabilidades marginales de respuesta potencial bajo el mecanismo alternativo son ambas cincuenta y cuatro por ciento: quinientas cuarenta personas responderían bajo cualquiera de las dos estrategias. La cifra coincide con el total de respuestas observadas, pero su interpretación procede de una asignación distinta de los valores contrafactuales. En el primer mecanismo, esos mismos datos surgían de riesgos de cuarenta y cinco y sesenta por ciento. Las diferencias entre mecanismos permanecen aunque se repita infinitamente la misma distribución observada.
Cambiar de población sin cambiar las respuestas por gravedad
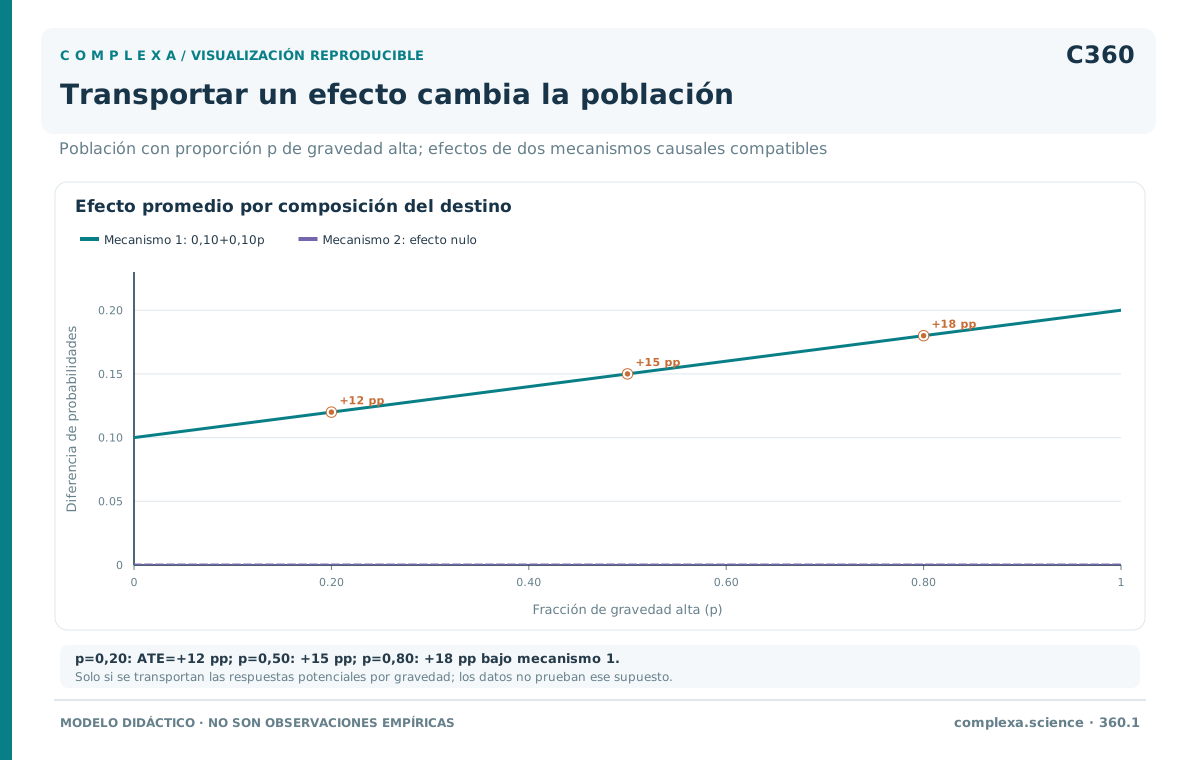
Supongamos que se desea aplicar el cálculo a una población donde la proporción de gravedad alta es . Manteniendo las respuestas potenciales por gravedad del primer mecanismo, la diferencia promedio sería . Si esa proporción fuera veinte por ciento, el efecto sería de doce puntos; con cincuenta por ciento, de quince; con ochenta por ciento, de dieciocho.
La fórmula permite reconocer que una diferencia entre instituciones podría reflejar distintas mezclas de gravedad, incluso sin un cambio de los efectos dentro de cada estrato. Para calcularla en una población nueva hemos supuesto que las respuestas potenciales condicionales se conservan. Conocer solo la nueva distribución de gravedad no verifica ese supuesto: podrían cambiar el contenido del programa, la atención comparadora o características relevantes dentro de cada nivel.
También puede cambiar la factibilidad de las estrategias. Si una nueva institución nunca ofrece el programa a personas de gravedad baja, sus propios datos no permiten aprender directamente la respuesta de ese estrato bajo esa opción. Si todas las personas de gravedad alta lo reciben, falta el contraste interno con atención habitual. Un modelo podría extrapolar, pero esa extrapolación añadiría estructura que nuestro ejemplo original no necesitó.
La comparación de los tres valores ayuda a formular una decisión antes de analizarla. Mantener el programa entre sus usuarios actuales apunta al ATT definido por la selección existente. Extenderlo a los no usuarios apunta al ATC para ese conjunto. Una política que ofreciera cualquiera de las estrategias a toda la población elegible exige especificar un contraste para esa población. Ninguna de esas preguntas se resuelve simplemente escogiendo la diferencia de mayor magnitud.
Lo que este archivo no permite preguntar todavía
Los datos no contienen número de sesiones, interrupciones ni cambios de estrategia posteriores. Por eso no permiten calcular el efecto de completar el programa ni el de adherir durante doce semanas. Reetiquetar como no tratados a quienes iniciaron y después interrumpieron cambiaría el significado de , y utilizaría acontecimientos posteriores para definir la exposición. El resultado sería otro análisis con condiciones que aquí no se han descrito.
Para estudiar una estrategia sostenida habría que definir cuándo se evalúa la adherencia, qué desviaciones están permitidas y cómo evoluciona el pronóstico antes de cada decisión. Una mejoría temprana puede influir tanto en continuar como en el resultado final. El ajuste necesario ya no se reduciría necesariamente a la gravedad basal. La comparación de iniciadores del caso conserva deliberadamente su pregunta inicial, sin atribuirse el efecto de un protocolo cuya ejecución no está registrada.
Tampoco se dispone de resultados a cuatro semanas o un año. Los efectos a doce semanas no pueden trasladarse a esos horizontes mediante una regla de proporcionalidad. Podría existir una respuesta temprana que se desvanece o un beneficio que aparece tarde. Hace falta observar o modelar explícitamente esa evolución. Añadir otra fecha al título de una tabla no modifica la información que contienen sus filas.
El carácter construido de los recuentos importa además para la incertidumbre. Los cálculos se presentan como identidades exactas de dos poblaciones didácticas. No se informa un intervalo de confianza pretendidamente clínico a partir de esas filas. En una muestra real habría variación al estimar las proporciones, los puntajes de propensión y la composición objetivo; también permanecería la incertidumbre sobre los supuestos causales. Un intervalo que solo refleja la primera parte no cubre automáticamente la segunda.
El informe que queda después de resolver el caso
La reproducción conserva los archivos observados y los dos mecanismos potenciales por separado. Incluye la tabla de estimandos, los pesos de cada registro y un programa de comprobación que coteja las cuentas con medias contrafactuales directas. Se puede repetir con Python sin bibliotecas adicionales. El cálculo del análisis no consulta la verdad del generador; el verificador sí lo hace, con esa función explícita.
La conclusión descriptiva original permanece: los iniciadores observados tuvieron doce puntos porcentuales menos de respuesta que los no iniciadores. Para la pregunta causal sobre toda la población elegible, el primer mecanismo produce un aumento de quince puntos, con riesgos de sesenta frente a cuarenta y cinco por ciento. Para los iniciadores actuales produce dieciocho puntos y para los no iniciadores doce. Cada resultado conserva su denominador y su horizonte de doce semanas.
La segunda construcción impide presentar la tabla ajustada como una demostración causal autosuficiente. Un mecanismo con efecto nulo genera el mismo archivo y el mismo balance de gravedad. Si estos fueran datos de un servicio, el trabajo pendiente sería establecer qué información sobre la asignación respalda la intercambiabilidad, o buscar un diseño que aporte esa información. En el ejercicio disponemos del generador y podemos verificar la condición; en el informe de un estudio real esa justificación tendría que acompañar a las cifras.
Referencias
Hernán, M. A., Clayton, D., y Keiding, N. (2011). The Simpson's paradox unraveled. International Journal of Epidemiology, 40(3), 780–785. https://doi.org/10.1093/ije/dyr041
Hernán, M. A., y Robins, J. M. (2016). Using big data to emulate a target trial when a randomized trial is not available. American Journal of Epidemiology, 183(8), 758–764. https://doi.org/10.1093/aje/kwv254
Imbens, G. W. (2004). Nonparametric estimation of average treatment effects under exogeneity: A review. The Review of Economics and Statistics, 86(1), 4–29. https://doi.org/10.1162/003465304323023651
Pearl, J. (2009). Causal inference in statistics: An overview. Statistics Surveys, 3, 96–146. https://doi.org/10.1214/09-SS057
Rosenbaum, P. R., y Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55. https://doi.org/10.1093/biomet/70.1.41
Rubin, D. B. (1974). Estimating causal effects of treatments in randomized and nonrandomized studies. Journal of Educational Psychology, 66(5), 688–701. https://doi.org/10.1037/h0037350