Una red de centros cambia su sistema de agenda. En el centro que lo incorpora primero, la espera media baja de veinte a doce días. Quien presenta el balance atribuye al programa una reducción de ocho días. Sin embargo, otro centro que todavía utiliza el sistema anterior pasa de doce a diez. Durante el mismo período se contrataron profesionales y cambió el volumen de solicitudes. La disminución observada reúne procesos que el informe todavía no ha separado.
El diseño de investigación establece de dónde saldrá la comparación con lo que habría ocurrido sin el cambio. Podemos asignar al azar qué centros lo reciben, aprovechar una regla administrativa que determine su acceso o estudiar una introducción cuya fecha ya fue decidida. Cada posibilidad proporciona información distinta y exige conocer cómo se produjo la exposición. El nombre del modelo estadístico llega después de esas decisiones.
Los centros, sus cifras y las reglas de asignación que siguen son construcciones didácticas. Definiremos el resultado como los días transcurridos entre una solicitud y la primera fecha de atención ofrecida. Para los cálculos suponemos que todas las solicitudes reciben una oferta y se observan completamente. La medida no representa mejoría clínica, satisfacción ni asistencia efectiva. Permite estudiar la comparación causal sin atribuir efectos sanitarios a un programa imaginario.
Una asignación cuyo azar puede reconstruirse
Supongamos que cuatro centros aceptan participar y dos recibirán inicialmente el programa. Antes de implementarlo se sortean dos entre los cuatro, con la misma probabilidad para cada pareja. Las seis asignaciones posibles quedan definidas por el protocolo. Ningún responsable puede cambiar la pareja elegida después de conocer qué centros mejoraron.
Ese mecanismo permite razonar sobre la incertidumbre sin suponer que las esperas siguen una distribución normal. Bajo la hipótesis de que el programa no modifica el resultado de ningún centro, los cuatro resultados serían los mismos cualquiera que fuese la pareja asignada. Podemos mantener esos valores fijos y reconstruir qué diferencias aparecerían al cambiar únicamente la asignación. Es la lógica de la inferencia por aleatorización descrita por Imbens y Rubin (2015).
Tomemos resultados de diez, doce, catorce y dieciséis días. Si la pareja que recibió el programa corresponde a los dos primeros centros, la media tratada es once y la media de comparación, quince. La diferencia observada es menos cuatro días. Al enumerar las seis parejas, las diferencias posibles son menos cuatro, menos dos, cero, cero, dos y cuatro.
Para una prueba bilateral que considera extremos los valores absolutos al menos tan grandes como el observado, dos de las seis asignaciones producen una diferencia de cuatro días en magnitud. El valor de probabilidad exacto es un tercio. La cuenta incluye la asignación observada y no emplea una aproximación basada en muestras grandes. Una diferencia que podría interesar a la gestión resulta compatible con bastante variación de asignación en un ensayo tan pequeño.
La hipótesis examinada afirma ausencia de efecto en cada centro. Es más restrictiva que afirmar un efecto promedio igual a cero. El promedio podría anularse si algunos centros mejoran y otros empeoran. Bajo esa segunda hipótesis no conocemos todos los resultados potenciales que faltan y no podemos aplicar sin más la misma enumeración manteniendo cada resultado fijo. El cálculo exacto debe corresponder a la hipótesis que efectivamente permite reconstruir.
También debe corresponder al sorteo realizado. Si se decidió formar previamente una pareja de centros de menor espera basal y otra de mayor espera, sorteando uno dentro de cada pareja, ya no existen seis asignaciones equiprobables. Solo hay cuatro. En una construcción donde los bloques previos reúnen los centros primero y segundo, por un lado, y tercero y cuarto, por otro, las diferencias bajo aquella hipótesis nula son menos dos, cero, cero y dos.
Los bloques se fijan con información anterior a la intervención. En este ejemplo conservan el mismo orden que los resultados utilizados para la cuenta, pero no se forman retrospectivamente con esos resultados. La varianza de las diferencias entre las seis asignaciones era veinte tercios; entre las cuatro asignaciones bloqueadas es dos. El bloqueo ha reducido aquí la variación asociada al sorteo al impedir que ambos centros de menor espera queden juntos en el mismo grupo.
Esta ganancia depende de que las características usadas para formar bloques sean informativas sobre el resultado. Añadir muchas restricciones sin una razón operativa puede dejar muy pocas asignaciones posibles y complicar el análisis. La evaluación conserva el mecanismo realmente utilizado: permutar libremente etiquetas después de una asignación restringida construye una distribución que el ensayo nunca pudo generar.
Centros, solicitudes y unidades de asignación
El programa modifica una agenda compartida. Asignarlo por solicitud individual podría ser inviable: reservar un espacio para una persona cambia los espacios disponibles para otras. Asignar centros completos hace que la intervención corresponda a una unidad organizativa que puede implementarla. La comparación resultante incluye las consecuencias internas de aplicar esa política a todo el centro.
Las solicitudes de un mismo centro comparten personal, calendario y capacidad de atención. Sus resultados suelen estar relacionados incluso cuando pertenecen a personas distintas. Registrar mil solicitudes no equivale a haber sorteado mil unidades si el programa se asignó únicamente a diez centros. La extensión de CONSORT para ensayos por conglomerados exige distinguir los niveles de asignación, observación y análisis (Campbell y colaboradores, 2012).
Una cuenta sencilla muestra cómo afecta esa dependencia a la precisión. Supongamos centros independientes, todos con cien solicitudes, igual varianza individual y correlación de un veinteavo entre cualquier par de solicitudes del mismo centro. La varianza de la media de todas las solicitudes se multiplica, frente al caso de independencia, por
donde es el tamaño común del centro y , la correlación interna. Hay cien términos de varianza y cien por noventa y nueve términos de covarianza dentro de cada suma de centro; esa contabilidad produce el factor. Con los valores elegidos, resulta cinco coma noventa y cinco.
Mil solicitudes tienen entonces, para la varianza de esa media y bajo esos supuestos, una equivalencia aproximada de ciento sesenta y ocho observaciones independientes. Esa equivalencia no aumenta el número de centros sorteados ni justifica usar grados de libertad correspondientes a ciento sesenta y ocho centros. Tamaños desiguales, correlaciones diferentes o una asignación no balanceada requieren un cálculo acorde con su estructura.
El promedio que interesa también debe fijarse. Dar el mismo peso a cada centro estima un promedio entre centros. Reunir todas las solicitudes da mayor peso a los centros más grandes y se aproxima a una pregunta sobre solicitudes. Si el efecto depende del tamaño, ambas preguntas pueden tener respuestas distintas aunque utilicen exactamente el mismo registro.
Imaginemos dos centros con veinte y ciento ochenta solicitudes, respectivamente, y mantengamos esos tamaños fijos bajo ambas alternativas. En esta construcción conocemos los efectos medios: una reducción de seis días en el primero y de dos en el segundo. El promedio entre centros es una reducción de cuatro días. Para una solicitud elegida al azar entre las doscientas, la reducción promedio es dos coma cuatro días, porque nueve de cada diez solicitudes pertenecen al segundo centro. Ninguna cuenta contiene un error. La unidad seleccionada para definir la población cambia la ponderación.
Esta distinción orienta una decisión concreta. Una autoridad que debe distribuir recursos entre centros puede querer saber cuánto cambia la espera del centro medio, mientras otra necesita estimar cuántos días de espera se evitan entre todas las solicitudes. Conviene expresar ambas cantidades si responden a decisiones diferentes, conservando sus denominadores. Si el programa modifica además cuántas solicitudes llegan a cada centro, los pesos posteriores pueden convertirse en otra consecuencia de la política. En tal situación se debe aclarar si se compara una población fijada antes de implementarla o el conjunto de solicitudes que se genera bajo cada alternativa.
La población incluida puede cambiar después del sorteo. Si los centros que reciben el programa reclutan solicitudes más sencillas o dejan de registrar las complejas, comparar solo las filas finalmente incluidas incorpora esa selección. Identificar la población antes de conocer la asignación, cuando sea posible, evita que el mecanismo de entrada dependa de ella. Cuando la incorporación es continua, hay que documentar cómo se determinó quién podía entrar y si esa regla funcionó igual en ambos grupos.
También puede haber conexiones entre centros. Compartir profesionales o trasladar solicitudes desde un centro tratado al otro modifica su resultado. En ese caso, el grupo de comparación puede estar recibiendo parte de las consecuencias de la política. Se necesita describir esos movimientos para saber si el contraste representa implementar el programa en centros aislados o distribuirlo dentro de una red conectada.
Comparar cambios cuando la asignación ya ocurrió
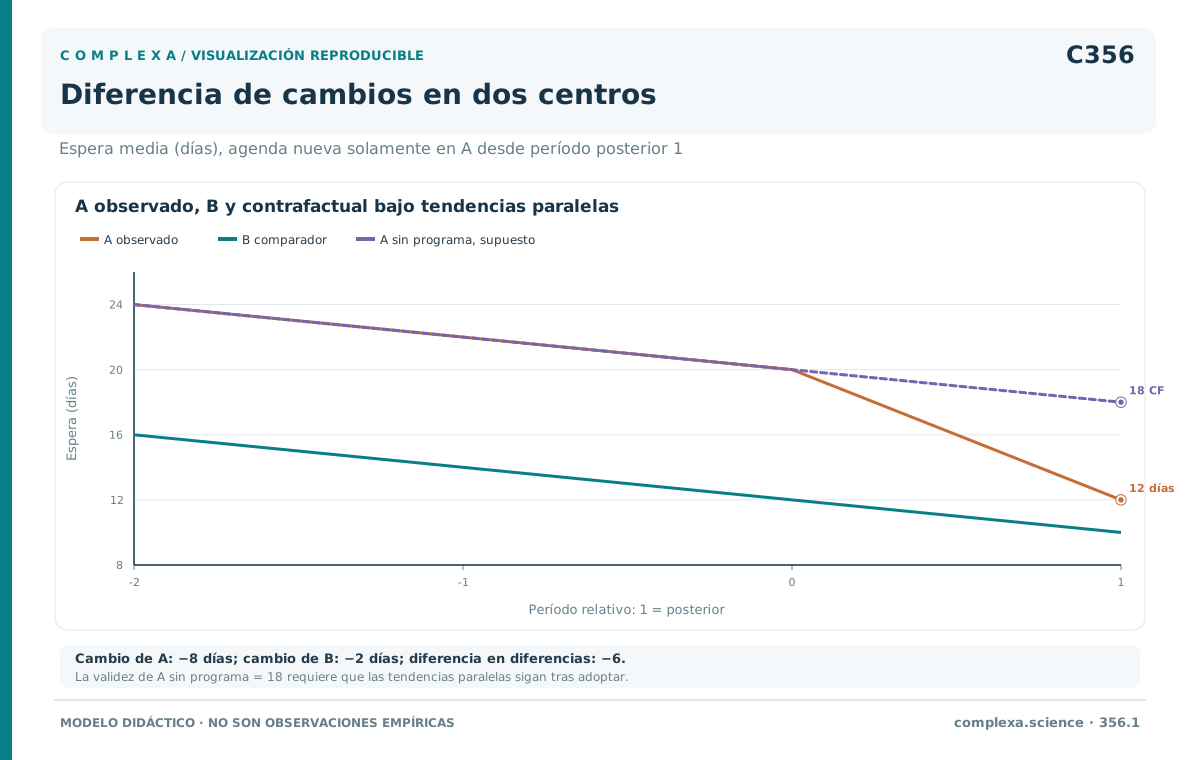
Volvamos a los centros A y B del comienzo. A incorpora el programa; B continúa con la agenda anterior. Para apreciar su historia añadimos dos períodos previos. Todas las entradas de esta tabla son medias construidas en días, con la misma definición del resultado.
| Centro | Dos períodos antes | Un período antes | Último período previo | Primer período posterior |
|---|---|---|---|---|
| A, incorpora el programa | 24 | 22 | 20 | 12 |
| B, conserva la agenda anterior | 16 | 14 | 12 | 10 |
La comparación posterior entre centros da dos días más de espera en A. La comparación de A consigo mismo da ocho días menos. Ninguna coincide con la diferencia de cambios: A disminuyó ocho días y B disminuyó dos, de modo que la diferencia en diferencias es menos seis días.
Escribiendo para el promedio del grupo en el período , la cuenta de dos períodos es
Para interpretarla como efecto sobre A necesitamos que, sin el programa, el cambio medio de A hubiese sido igual al cambio de B. Es la condición de tendencias paralelas para los resultados sin intervención. Bajo ella, A habría pasado de veinte a dieciocho días. Su promedio observado de doce queda seis días por debajo de ese resultado contrafactual.
La condición permite diferencias permanentes de nivel. A podía tener ocho días más de espera que B durante todos los períodos previos. Lo que se traslada desde B es el cambio esperado sin intervención, no necesariamente su nivel. También necesitamos que el programa no afecte a B y que no cambie anticipadamente los resultados de A en los períodos utilizados como referencia.
El origen de las medias merece tanta atención como sus diferencias. Las solicitudes de un mes pueden corresponder a personas distintas de las del mes siguiente. Supongamos dos categorías administrativas definidas antes de la intervención, con esperas constantes de diez y treinta días. Cuando cada categoría aporta la mitad de las solicitudes, el promedio es veinte. Si después tres cuartos pertenecen a la primera categoría, el promedio baja a quince sin que cambie la espera dentro de ninguna categoría.
Si este desplazamiento ocurre únicamente en A por una modificación externa del registro, puede generar una diferencia de cambios que no describe una mejora para solicitudes comparables. Conservar las categorías permite mostrar sus trayectorias y, si esa es la pregunta definida, calcular medias con una composición común previamente fijada. En el ejemplo, mantener pesos iguales conserva el promedio de veinte. Sin embargo, si el programa atrae deliberadamente un tipo distinto de solicitud, fijar la composición excluye esa vía de influencia. La elección depende de si interesa la experiencia de una población constante o el funcionamiento del servicio incluyendo su nueva demanda.
Los tres períodos previos muestran descensos iguales y una distancia constante de ocho días. Esa historia es compatible con la justificación propuesta. No demuestra qué habría ocurrido después. Construyamos otra explicación de las mismas cifras: justo al introducirse el programa, A recibe un aumento de capacidad que reduce seis días adicionales de espera, mientras el programa no produce ningún efecto. A habría llegado igualmente a doce días sin el programa. Todos los valores observados de la tabla permanecen idénticos.
En la primera explicación el efecto es menos seis; en la segunda es cero. La diferencia está en el proceso que determina el resultado no observado de A. Más decimales o una regresión que reproduzca perfectamente las cuatro medias no eligen entre esas explicaciones. Haría falta información sobre el cambio de capacidad, una comparación que lo represente o una modificación del diseño.
Examinar tendencias previas puede revelar incompatibilidades con el argumento causal. Una prueba que no detecta diferencias puede también carecer de precisión para identificarlas. Además, seleccionar análisis porque superaron una prueba previa modifica su distribución estadística; Roth (2022) muestra cómo ese procedimiento puede distorsionar estimaciones e intervalos. El análisis de la historia previa tiene que considerar el tamaño de las discrepancias plausibles y su incertidumbre, en lugar de convertir un valor de probabilidad alto en autorización automática.
Si los centros adoptan en fechas distintas, una única comparación entre tratados y no tratados se vuelve insuficiente. Un centro que todavía no adoptó puede servir de comparación para otro que acaba de hacerlo, bajo las condiciones correspondientes. El mismo centro ya tratado deja de representar una trayectoria sin intervención cuando se evalúa una adopción posterior.
Goodman-Bacon (2021) explica cómo las regresiones con efectos fijos de unidad y tiempo pueden combinar comparaciones entre momentos de adopción diferentes. Cuando los efectos cambian con el tiempo desde la intervención, usar como control una unidad ya tratada puede introducir su propio cambio de efecto en la comparación. Callaway y Sant’Anna (2021) desarrollan estimaciones por grupo de adopción y período, haciendo explícita la población que suministra cada trayectoria de referencia.
Esa organización permite preguntar, por ejemplo, por el efecto al primer mes en quienes adoptaron en enero y por el efecto al tercero en quienes adoptaron en marzo. No obliga a que ambos efectos sean iguales. Si al final todas las unidades están tratadas, dejan de existir controles nunca tratados o todavía no tratados para esos períodos. Obtener efectos posteriores exige información o supuestos adicionales. La disponibilidad de muchos meses tratados no sustituye esa comparación ausente.
Una interrupción dentro de una serie temporal
En otra situación, toda la red introduce el sistema en la misma fecha y conserva registros mensuales durante varios años. Una serie interrumpida utiliza la trayectoria previa para construir la evolución esperada sin intervención. La comparación depende de que esa prolongación siga siendo adecuada en el período posterior y de que otros cambios próximos a la fecha no expliquen la diferencia.
El mecanismo previsto orienta la forma del efecto. Una eliminación inmediata de trámites podría producir un salto de nivel. Un aprendizaje gradual podría cambiar la pendiente. Una acumulación de solicitudes pendientes podría demorar la respuesta. Lopez Bernal, Cummins y Gasparrini (2017) recomiendan formular ese modelo de impacto a partir del funcionamiento de la intervención antes de buscar la forma más favorable en los resultados.
Centremos el tiempo de modo que sea la primera observación posterior a la introducción, y llamemos al indicador que vale uno desde ese momento. Un modelo para la media esperada es
Aquí es el nivel que la tendencia previa proyecta en el momento cero; , la pendiente previa; , el salto inmediato; y , el cambio de pendiente. El dato observado puede diferir de esa media por variación residual. La diferencia respecto de la trayectoria sin intervención, en un tiempo posterior, es .
Construyamos una media que antes del cambio disminuye medio día por mes y que habría llegado a veinte días en el momento cero. El programa se representa mediante un salto de menos cuatro días y una disminución adicional de un cuarto de día por mes. La primera media posterior es dieciséis. Tres meses después, la trayectoria sin programa habría llegado a dieciocho coma cinco; la trayectoria con programa alcanza trece coma setenta y cinco. La diferencia es menos cuatro coma setenta y cinco días.
El salto inicial y la diferencia a los tres meses son cantidades distintas. También lo es la pendiente posterior, que aquí resulta de sumar menos medio y menos un cuarto. Conviene decidir qué horizonte responde a la pregunta de gestión, porque una sola etiqueta de «efecto» puede ocultar estas diferencias. Prolongar indefinidamente una recta decreciente acabaría prediciendo esperas imposibles; el modelo describe el intervalo en que su forma resulta defendible.
La definición del reloj determina cómo se interpretan los coeficientes. Si el programa comienza en el mes diez contado desde el inicio del estudio, el término de cambio de pendiente debe usar el tiempo transcurrido desde ese mes. El corrigendum del tutorial precisó esta formulación (Lopez Bernal y colaboradores, 2021). En nuestro ejemplo, escribir la interacción con el mes sin centrar produce un coeficiente del indicador igual a menos uno coma cinco; el salto real sigue siendo menos cuatro al sumar la contribución de la interacción en el mes diez. Confundir ese coeficiente con el salto altera la interpretación aunque las predicciones ajustadas sean idénticas.
El calendario puede introducir oscilaciones que una recta no representa. Si cada verano disminuye la capacidad y la implementación coincide con el comienzo del otoño, parte de la reducción puede ser estacional. También puede persistir la congestión entre meses cercanos. La dependencia de los residuos afecta a la incertidumbre y debe tratarse con una estructura temporal apropiada. Corregir esa dependencia no elimina un cambio simultáneo de personal: son problemas diferentes del análisis.
La resolución del registro establece qué cambio puede verse. Si la agenda se activa a mitad de mes, la primera media mensual mezcla solicitudes anteriores y posteriores. Un salto inmediato en cada solicitud expuesta puede aparecer como una transición entre dos meses. Cuando existen fechas individuales, es posible formar intervalos coherentes con la implementación; cuando solo quedan agregados, el modelo debe reconocer esa mezcla. También importa distinguir la fecha del anuncio de la fecha en que los centros comenzaron a operar el sistema: una capacitación anticipada puede modificar la trayectoria antes del día que figura en la resolución administrativa.
Agregar una serie de comparación permite representar algunos acontecimientos compartidos. Lopez Bernal y colaboradores (2018) examinan esta extensión. Un control útil debe estar expuesto a los factores que queremos descontar y conservarse suficientemente ajeno al programa. Otro servicio puede compartir el calendario de contrataciones pero tener demanda y estacionalidad distintas. Su simple disponibilidad no demuestra que su trayectoria pueda trasladarse a la red intervenida.
Una medición repetida puede volverse incomparable por cambios en el registro. Si antes se cuentan todas las solicitudes y después solo las que completaron los requisitos administrativos, la serie puede descender porque cambia quién entra en el promedio. En una evaluación real también habría que incorporar las solicitudes todavía sin oferta al finalizar el seguimiento, mediante una definición y un análisis que reconozcan ese resultado incompleto. La tabla mensual debe conservar una población y un reloj interpretables.
Una regla de acceso que cambia en un umbral
Consideremos ahora una política distinta: una oficina asigna apoyo adicional para organizar citas cuando un puntaje administrativo alcanza cincuenta. El puntaje se calcula antes de ofrecer el apoyo. Todas las solicitudes por encima del umbral acceden y las inferiores no. Esa discontinuidad de asignación puede permitir una comparación local aunque el puntaje esté relacionado con la espera.
En esta construcción el puntaje admite valores continuos y hay observaciones arbitrariamente próximas al umbral desde ambos lados. Si el sistema solo conserva números enteros, existe una separación que no desaparece al aumentar la cantidad de solicitudes. Comparar cuarenta y nueve con cincuenta requeriría entonces un argumento adicional sobre la evolución entre esos valores; no dispondríamos directamente de la aproximación por límites que utilizaremos aquí. Los números enteros del ejemplo siguiente son únicamente puntos escogidos para ilustrar la cuenta.
La idea consiste en aproximarse al umbral desde ambos lados. Si la media de los resultados potenciales bajo cada condición varía continuamente con el puntaje en ese lugar, un salto en el resultado observado puede atribuirse al cambio de tratamiento. Lee y Lemieux (2010) exponen esta identificación y sus condiciones. La continuidad requerida se refiere a lo que habría ocurrido bajo cada alternativa; el resultado observado puede ser discontinuo precisamente porque cambia la asignación.
En un diseño de discontinuidad nítida, el puntaje determina completamente el tratamiento. No vemos solicitudes tratadas y no tratadas en el mismo valor del puntaje. La información que falta se aproxima mediante valores a ambos lados cada vez más próximos. Su justificación descansa en la continuidad, no en encontrar dentro de cada puntaje una mezcla observada de ambas condiciones.
Sea el puntaje. Construyamos una espera sin apoyo igual a días y supongamos que el apoyo reduce cuatro días para cada solicitud de esta ilustración. Sin apoyo, los puntajes cuarenta y ocho y cuarenta y nueve tienen medias de veinte coma dos y veinte coma uno. Con apoyo, los puntajes cincuenta y uno y cincuenta y dos presentan medias de quince coma nueve y quince coma ocho.
La diferencia entre las medias de esos dos pequeños grupos es menos cuatro coma tres días. Incluye los cuatro días del apoyo y una diferencia de tres décimas debida al puntaje. Al aproximarnos al umbral, la media izquierda converge a veinte y la derecha a dieciséis. El salto límite es menos cuatro. Agrupar observaciones «cercanas» en un intervalo finito no elimina automáticamente la tendencia de fondo.
La anchura de ese intervalo regula un compromiso. Incorporar solicitudes más alejadas suele aportar más información para estimar una curva, pero exige representar adecuadamente cómo cambia el resultado con el puntaje. Una aproximación lineal que funciona cerca del umbral puede deformarse al extenderse. El análisis debe distinguir el efecto local que pretende estimar de los supuestos de suavidad y forma necesarios para utilizar observaciones a cierta distancia.
En nuestro ejemplo el efecto se definió constante, por lo que coincide también con el efecto lejos del umbral. Esa igualdad procede de la construcción y no del diseño de discontinuidad. Si el apoyo beneficia de otra manera a puntajes mucho mayores, los datos inmediatos a cincuenta no determinan ese efecto. Para decidir una ampliación a toda la población haría falta estudiar cómo cambia la respuesta o disponer de otras comparaciones.
La regla puede ser manipulable. Si un funcionario puede aumentar a voluntad el puntaje de las solicitudes que espera resolver con facilidad, las situadas justo arriba del umbral pueden tener un pronóstico distinto de las situadas justo abajo. La documentación de cómo se genera y conserva el puntaje es parte del diseño. Una concentración inusual de observaciones puede aportar indicios de clasificación estratégica, pero una densidad aparentemente suave no demuestra por sí sola la continuidad de todos los resultados potenciales.
Las variables medidas antes del acceso ofrecen comprobaciones adicionales. Podemos representar, a ambos lados del umbral, la complejidad administrativa inicial o la disponibilidad de horarios de las personas. Un salto en alguna de ellas exige averiguar qué proceso lo produce y si compromete la comparación. Lee y Lemieux (2010) discuten el papel de estas comprobaciones de covariables. Se examinan características que el apoyo todavía no pudo modificar; comparar variables posteriores como si fueran antecedentes confundiría la evaluación del diseño con el estudio de sus consecuencias.
El historial anterior a la regla también puede aportar información. Si el resultado ya presentaba un salto en cincuenta cuando todavía nadie recibía apoyo, habría una razón para investigar una discontinuidad preexistente. Si no aparecía, la nueva diferencia resulta más compatible con la explicación propuesta, dentro de la precisión disponible. Estas comprobaciones sirven para orientar la investigación institucional: un cambio de formulario o un segundo programa pueden explicar un patrón que una curva ajustada solo describe. Su utilidad aumenta cuando se conserva el puntaje original, sin redondearlo ni reemplazarlo por categorías amplias que impidan acercarse al umbral.
Tampoco basta con que el apoyo cambie en cincuenta. Si en ese mismo punto se activa una segunda vía de atención, el salto del resultado puede reflejar el conjunto de ambas medidas. La comparación identifica entonces el efecto del cambio administrativo que realmente sucede allí, bajo sus condiciones, y no permite atribuirlo exclusivamente a un componente sin información adicional.
Hay reglas que producen un aumento de la probabilidad de recibir apoyo, sin determinarlo perfectamente. En ese caso puede estudiarse una discontinuidad difusa. Si el resultado salta menos dos coma cuatro días y la probabilidad de tratamiento aumenta seis décimas, el cociente es menos cuatro. Interpretarlo como efecto local para quienes cambian de tratamiento por el umbral requiere, además de la continuidad pertinente, una vía de influencia del umbral restringida al tratamiento y que cruzarlo no induzca a algunas solicitudes a abandonar el apoyo mientras induce a otras a recibirlo. La división numérica, por sí sola, no establece esas condiciones.
Qué información conviene recoger antes de decidir
Estos diseños necesitan expedientes diferentes. Para reconstruir el sorteo hacen falta las asignaciones permitidas, sus probabilidades y las restricciones anteriores. Para una comparación de cambios importa saber por qué cada centro adoptó en esa fecha y qué otras modificaciones coincidieron con ella. Una discontinuidad exige conservar el puntaje original y la regla que lo transforma en acceso, incluidos cambios de versión y excepciones.
Ese conocimiento puede obtenerse antes de que comiencen los resultados. Entrevistar a quienes implementan la agenda, revisar la secuencia de decisiones y registrar los cambios de capacidad ayuda a reconocer comparaciones viables. Una regla que parece arbitraria en la tabla puede responder a una priorización deliberada de los centros más congestionados. Una fecha de adopción puede haberse aplazado precisamente porque la espera estaba aumentando.
Si todavía se puede organizar la introducción, el diseño puede incorporar aleatorización donde existe incertidumbre práctica. Sortear el orden entre centros disponibles conserva una fuente conocida de variación, aunque la implementación ocurra por etapas. El análisis seguirá necesitando separar los efectos del calendario y reconocer qué centros proporcionan comparación en cada período. Que todos terminen recibiendo el sistema no convierte sus fechas en intercambiables.
La precisión de la medida también se planifica. Más solicitudes dentro de un centro permiten estimar mejor su media, pero pueden aportar poco para distinguir un efecto del programa de una perturbación compartida por ese centro. Más períodos ayudan a describir una trayectoria; no garantizan que su prolongación sea válida. Más observaciones lejos de un umbral pueden mejorar un ajuste global y dejar intacta la incertidumbre sobre el comportamiento local.
En la red del comienzo, la decisión pendiente es cómo ampliar el programa. Si se conservan los dos centros originales y solo se agregan solicitudes, habrá más información sobre sus promedios, pero seguirá siendo necesario explicar la contratación simultánea. Si hay nuevos centros elegibles, un sorteo previamente acordado puede construir otra comparación. Antes de realizarlo se registrará la capacidad prevista de cada centro y se fijará cómo se medirá la espera de todas sus solicitudes. Así, cuando aparezca una nueva reducción de ocho días, habrá una regla documentada para establecer con qué trayectoria debe compararse.
Referencias
Callaway, B., y Sant’Anna, P. H. C. (2021). Difference-in-differences with multiple time periods. Journal of Econometrics, 225(2), 200–230. https://doi.org/10.1016/j.jeconom.2020.12.001
Campbell, M. K., Piaggio, G., Elbourne, D. R., y Altman, D. G. (2012). CONSORT 2010 statement: extension to cluster randomised trials. BMJ, 345, e5661. https://doi.org/10.1136/bmj.e5661
Goodman-Bacon, A. (2021). Difference-in-differences with variation in treatment timing. Journal of Econometrics, 225(2), 254–277. https://doi.org/10.1016/j.jeconom.2021.03.014
Imbens, G. W., y Rubin, D. B. (2015). Causal inference for statistics, social, and biomedical sciences: An introduction. Cambridge University Press. https://doi.org/10.1017/CBO9781139025751
Lee, D. S., y Lemieux, T. (2010). Regression discontinuity designs in economics. Journal of Economic Literature, 48(2), 281–355. https://doi.org/10.1257/jel.48.2.281
Lopez Bernal, J., Cummins, S., y Gasparrini, A. (2017). Interrupted time series regression for the evaluation of public health interventions: a tutorial. International Journal of Epidemiology, 46(1), 348–355. https://doi.org/10.1093/ije/dyw098
Lopez Bernal, J., Cummins, S., y Gasparrini, A. (2018). The use of controls in interrupted time series studies of public health interventions. International Journal of Epidemiology, 47(6), 2082–2093. https://doi.org/10.1093/ije/dyy135
Lopez Bernal, J., Cummins, S., y Gasparrini, A. (2021). Corrigendum to: Interrupted time series regression for the evaluation of public health interventions: a tutorial. International Journal of Epidemiology, 50(3), 1045. Publicado anticipadamente en 2020. https://doi.org/10.1093/ije/dyaa118
Roth, J. (2022). Pretest with caution: Event-study estimates after testing for parallel trends. American Economic Review: Insights, 4(3), 305–322. https://doi.org/10.1257/aeri.20210236