Para recibir una revisión de mantenimiento el próximo lunes, una máquina tiene que llegar funcionando hasta ese día. Si después clasificamos todo su historial como perteneciente al grupo «con mantenimiento», habremos incorporado esa supervivencia a la definición del grupo. Una avería ocurrida antes del lunes impedirá recibir la revisión y enviará la máquina al grupo contrario. La comparación puede favorecer al mantenimiento aunque este no cambie ninguna avería.
El problema se introduce al construir los grupos, antes de elegir un modelo estadístico. Un ensayo asignaría planes cuando las máquinas todavía pudieran seguir cualquiera de ellos. La avería posterior no cambiaría retrospectivamente esa asignación. Emular un experimento objetivo consiste en precisar esa comparación y reconstruirla con datos recogidos por otros motivos, hasta donde lo permitan sus fechas, variables y mecanismos de selección.
El marco desarrollado por Hernán y Robins (2016) convierte un interés general por los efectos de una intervención en un protocolo explícito. Permite examinar qué partes de un experimento pueden reproducirse con registros observacionales y cuáles dependen de supuestos adicionales. Una base de datos muy extensa puede contener información insuficiente para alguna de esas partes; otra más pequeña puede registrar exactamente las decisiones y el seguimiento necesarios.
Escribir el ensayo antes de formar los grupos
El protocolo comienza por la población que podría participar. En nuestro ejemplo construido serán máquinas operativas que alcanzan una antigüedad determinada, no han recibido la revisión en los últimos treinta días y disponen de una medición basal de carga. La elegibilidad se evalúa con información disponible al comenzar. Exigir además que la máquina permanezca operativa durante la semana siguiente seleccionaría por un acontecimiento posterior.
Las estrategias comparadas deben describir acciones posibles. Una consiste en realizar una revisión especificada el día siete si la máquina sigue operativa; la otra, en no realizarla durante los treinta días siguientes. La revisión tiene una duración y unas operaciones definidas. Ambas estrategias mantienen las mismas reglas de carga y las mismas actuaciones ante una avería. Supondremos que una máquina no modifica el funcionamiento de las demás. Así podemos atribuir un resultado a cada estrategia individual sin tener que especificar también la asignación de toda la red.
La frase «recibir mantenimiento» sería demasiado amplia para ese protocolo. Podría significar una inspección breve o la sustitución completa de una pieza, con tiempos distintos de parada. Si esas versiones tienen consecuencias diferentes, mezclarlas cambia la intervención estudiada. En un registro real habría que averiguar qué procedimiento representa cada código y qué parte de la estrategia se puede reconocer.
La asignación del ensayo se realizaría al cumplir los criterios. Desde ese momento comenzaría el seguimiento, aunque la revisión estuviera programada para una semana después. El resultado será la primera avería terminal antes de treinta días: una avería que impide continuar en servicio y recibir la revisión prevista. Las detenciones breves que permiten volver a operar no cuentan como ese resultado. La definición distingue el evento de interés de incidencias que solo modifican el uso.
Podemos expresar el contraste mediante , el riesgo de avería antes del día treinta bajo la estrategia . La diferencia compara ambas estrategias en la misma población inicialmente elegible. También podríamos estudiar tiempo acumulado de funcionamiento o número de interrupciones reparables. Esas salidas contestan preguntas diferentes y necesitan reglas de observación propias. No se obtiene el mismo estimando sustituyendo una por otra porque resulte más completa en el archivo.
El protocolo precisa asimismo qué ocurre ante una desviación. Si una máquina asignada al mantenimiento no recibe la revisión por falta de personal, podemos conservarla en su grupo original para estudiar el efecto de asignar el plan. Otra pregunta sería qué ocurriría si todas las máquinas siguieran las estrategias especificadas. La avería terminal previa al día siete no es aquí un incumplimiento: la estrategia ya establece que la revisión se realiza solo mientras la máquina permanece operativa.
Esta diferencia obliga a definir el análisis junto con el diseño. El primero conserva las consecuencias de la organización real, incluidos retrasos y falta de ejecución. El segundo intenta separar el efecto de seguir la estrategia de la frecuencia con que se consigue seguirla. Ambos pueden interesar a quien gestiona una instalación, pero sus resultados no se intercambian sin cambiar la pregunta.
En la emulación conviene escribir, junto a cada componente del ensayo, cómo se reconoce en los datos. Una columna puede indicar «fecha en que se cumplen los criterios» y la otra «primera inspección registrada que confirma esos criterios». La diferencia entre ambas fechas permite detectar un retraso de entrada. Una anotación de compra de repuestos tampoco equivale necesariamente a la ejecución de una revisión. Ese trabajo de correspondencia determina qué ensayo se está reproduciendo realmente.
La declaración TARGET organiza la comunicación de estas decisiones y de sus supuestos, con un alcance explícito para emulaciones de ensayos paralelos con asignación individual y ajuste de confusores basales (Cashin y colaboradores, 2025). Una descripción transparente permite juzgar las discrepancias entre protocolo y datos. La lista de información que debe comunicarse no demuestra por sí misma que la comparación sea válida.
Asignar una estrategia y observar que se sigue
En un ensayo correctamente aleatorizado, la asignación se genera mediante un mecanismo conocido. Antes de que ocurran los resultados, las características pronósticas no determinan qué estrategia recibe cada unidad. Esto no exige que cada muestra tenga idénticas medias basales: el equilibrio es una propiedad probabilística del procedimiento, y una realización finita puede presentar diferencias.
Con seguimiento completo y las condiciones correspondientes a la intervención definida, comparar por asignación permite estimar el efecto de ofrecer o imponer esos planes. Esa comparación suele denominarse análisis por intención de tratar. Si la asignación modifica también la supervisión, la disponibilidad de repuestos o la conducta del operador, esas consecuencias forman parte del efecto de asignar el plan tal como se implementó.
La aleatorización inicial no decide quién cumplirá durante todo el seguimiento. Las máquinas con señales de desgaste pueden recibir una intervención no prevista; las que funcionan bien pueden posponerla. Seleccionar después solo las que obedecieron el protocolo vuelve a formar grupos según características relacionadas con el resultado. La comparación entre adherentes pierde la protección que tenía la asignación original.
Hernán y Robins (2017) distinguen las preguntas por asignación y por seguimiento del protocolo en los ensayos pragmáticos. Un efecto por protocolo requiere un análisis que represente las decisiones posteriores y sus determinantes. Eliminar simplemente a quienes se desviaron no equivale a estimar qué habría sucedido si toda la población hubiera seguido la estrategia.
En datos observacionales falta además la asignación aleatoria inicial. Las máquinas que reciben una revisión pueden ser precisamente las que el personal considera más próximas a fallar. También puede ocurrir lo contrario: los centros mejor dotados revisan antes y mantienen condiciones de operación más favorables. El protocolo hace visibles esas vías de confusión; no las cancela.
Para una comparación de inicio en el momento basal necesitamos información suficiente sobre las causas comunes de iniciar y de fallar. La antigüedad, la carga y las inspecciones previas podrían formar parte de esa información en un ejemplo concreto. Equilibrar las variables registradas no demuestra que se haya medido la valoración informal del técnico. La intercambiabilidad condicional es una condición causal que se razona a partir del proceso de decisión y del conocimiento del sistema.
Tampoco cualquier comparación de iniciadores es una intención de tratar observacional. Hernán y Robins (2016) explican que su analogía más cercana exige que asignación e inicio puedan representarse conjuntamente en el momento basal. Una orden registrada puede aproximarse a una decisión de asignación; la ejecución posterior representa otra cosa. Si se ignora esta distinción, la misma etiqueta puede ocultar comparaciones de ofrecer, iniciar o mantener una intervención.
Una estrategia sostenida necesita además apoyo a lo largo del seguimiento. No basta con que existan máquinas revisadas y no revisadas al principio. Si ante cierto historial de deterioro todas reciben una intervención urgente, los datos no muestran qué sucede bajo una estrategia que exige continuar sin ella. Restringir la población o modificar esa estrategia puede producir una pregunta identificable, pero también altera la población o el contraste que se pretendía estudiar.
El tiempo cero en una tabla de doscientas máquinas
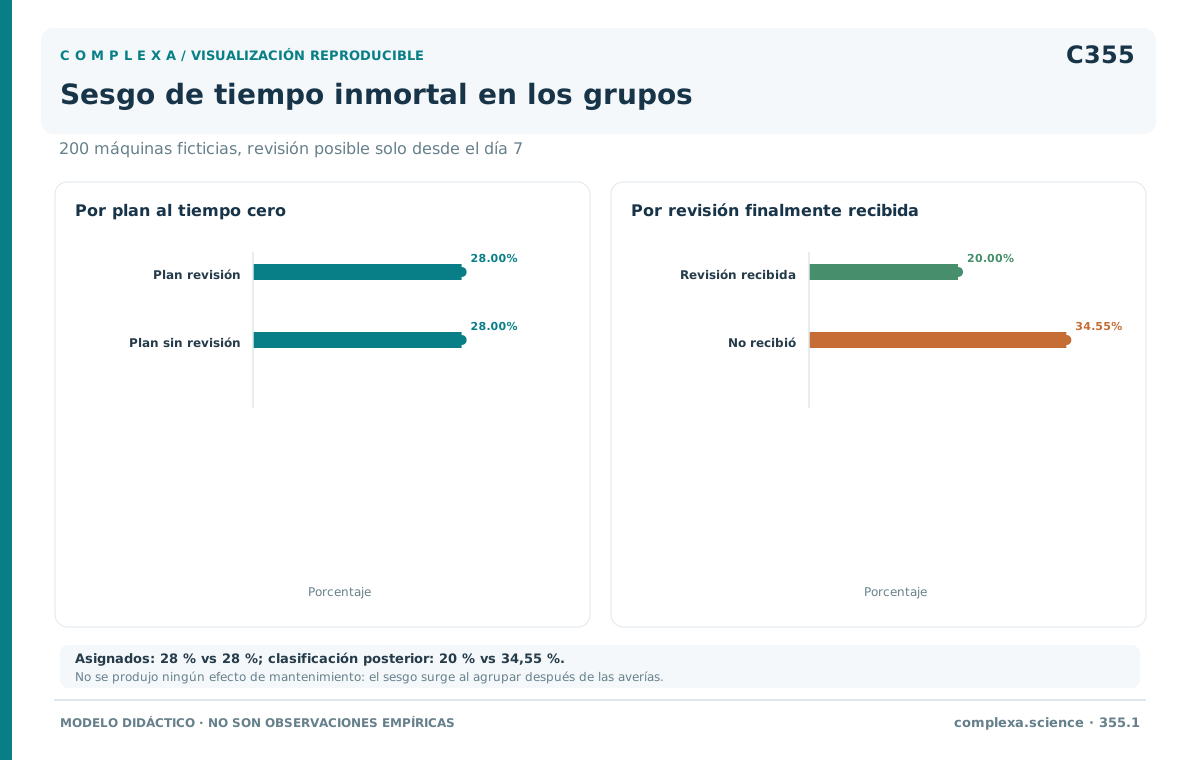
Construyamos un ensayo sin ningún efecto del mantenimiento. Hay doscientas máquinas, cien asignadas a cada plan. En cada grupo, diez sufren una avería terminal antes del día siete. Entre las noventa que alcanzan ese día, dieciocho fallan después y antes del día treinta. Las setenta y dos restantes completan el período. Supondremos que cada máquina habría tenido exactamente el mismo resultado bajo cualquiera de las dos estrategias.
| Plan asignado al comenzar | Máquinas iniciales | Averías antes del día siete | Averías posteriores | Riesgo a treinta días |
|---|---|---|---|---|
| Revisión el día siete si sigue operativa | 100 | 10 | 18 | 28/100 |
| Sin revisión durante treinta días | 100 | 10 | 18 | 28/100 |
La comparación por asignación da un riesgo del veintiocho por ciento en ambos grupos. Las máquinas que fallan pronto siguen contando en el plan que recibieron. No necesitaron llegar a la revisión para pertenecer a ese grupo.
Supongamos ahora que se pierde el registro de asignación y se conservan únicamente las revisiones realizadas. Noventa máquinas recibieron mantenimiento. Entre ellas hubo dieciocho averías, todas posteriores a la intervención. Las otras ciento diez no lo recibieron: incluyen las cien originalmente asignadas a no revisar y las diez que iban a ser revisadas pero fallaron antes.
La clasificación retrospectiva produce riesgos de y . La diferencia es de aproximadamente menos catorce coma cinco puntos porcentuales y la razón de riesgos es , aproximadamente . La intervención parece favorable pese a que, por construcción, no cambió el resultado de ninguna máquina.
El grupo «recibió mantenimiento» ha adquirido una condición de entrada que no figuraba en el protocolo basal: sobrevivir hasta el día siete. Durante esa semana no puede contener una avería terminal, porque cualquier máquina que la sufra dejará de reunir la definición retrospectiva del grupo. Ese es el intervalo inmortal en el ejemplo; no describe una propiedad protectora de la intervención.
La tabla permite distinguir el mecanismo de un desequilibrio habitual de covariables. Aunque todas las máquinas tuvieran la misma antigüedad y la misma carga registrada, la clasificación seguiría moviendo las averías tempranas al grupo sin mantenimiento. Ajustar esas variables no devuelve cada máquina a su estrategia basal. Es necesario reconstruir la comparación, no solamente ampliar la regresión.
Hernán y colaboradores (2025) separan dos estructuras que pueden generar tiempo inmortal. Una asigna estrategias usando información posterior a la elegibilidad, como en nuestra tabla. Otra impone criterios de inclusión después de la asignación y selecciona a quienes sobrevivieron o permanecieron observables hasta cumplirlos. Ambas pueden eliminar eventos tempranos, aunque lo hagan mediante operaciones distintas.
Comenzar el seguimiento el día siete ofrece una comparación diferente. En este ejemplo quedan noventa máquinas de cada plan y dieciocho averías posteriores en cada grupo: el riesgo condicionado a llegar operativo a ese día es del veinte por ciento. Es una cuenta coherente para esa población superviviente, pero ya no representa el riesgo de treinta días desde la elegibilidad inicial.
En otros sistemas, una intervención previa puede afectar quién llega al punto de referencia. Condicionar a esa supervivencia también puede seleccionar grupos de pronóstico diferente. Por eso desplazar el reloj no constituye una solución universal al problema. Un ensayo que empieza entre supervivientes debe declarar esa nueva población y qué información previa determina su elegibilidad y asignación.
La fecha de entrada tampoco tiene que ser un día común del calendario. Cada máquina puede alcanzar los criterios en una semana distinta. El tiempo desde elegibilidad y el tiempo histórico cumplen funciones diferentes: el primero mide el seguimiento; el segundo puede determinar disponibilidad de técnicos, condiciones ambientales o versiones del procedimiento. Alinear el origen individual no elimina la necesidad de considerar esos cambios históricos.
Mantener las estrategias compatibles desde el comienzo
Cuando la intervención puede iniciarse más tarde, una misma historia observada puede ser compatible temporalmente con varias estrategias. Una máquina que sigue funcionando el día tres y aún no ha recibido mantenimiento encaja tanto con revisar el día siete como con no revisar. Su conducta hasta ese momento no permite asignarla retrospectivamente a una sola opción.
La clonación crea una copia analítica para cada estrategia compatible al comenzar. No duplica máquinas físicas ni observaciones independientes. Cada copia conserva la misma historia hasta que esta deja de concordar con su estrategia. A partir de ese momento se censura artificialmente esa copia, mientras otras pueden seguir aportando información.
En nuestro ejemplo se crean dos copias de cada una de las doscientas máquinas. Las veinte averías anteriores al día siete se registran en ambos grupos de copias. Hasta la avería, esas historias eran compatibles con ambas estrategias. Ningún evento temprano se descarta por no haber podido recibir después la revisión.
Al llegar al día siete quedan ciento ochenta máquinas operativas. Noventa reciben mantenimiento y noventa no. En las copias asignadas a revisar se censuran las noventa que no lo reciben; en las asignadas a no revisar se censuran las noventa que sí lo reciben. Cada grupo conserva noventa historias para observar la etapa posterior.
La censura ha seleccionado quién continúa representando cada estrategia. En el ejemplo construido, la probabilidad de seguir la acción correspondiente es un medio y no depende del pronóstico entre las máquinas que llegan operativas. Cada historia retenida recibe entonces peso dos para representar las dos historias basales que, en promedio, tenían esa posibilidad de continuar.
Antes del día siete los pesos eran uno: todavía no había ocurrido esa selección. Después, las dieciocho averías de cada grupo de copias contribuyen como treinta y seis averías ponderadas. Sumadas a las veinte tempranas, representan cincuenta y seis eventos entre doscientas máquinas iniciales. El riesgo estimado vuelve a ser del veintiocho por ciento para cada estrategia.
La misma cuenta puede hacerse por etapas. El riesgo temprano es . Entre quienes llegan a la decisión, el riesgo posterior estimado es . La supervivencia hasta el final se calcula como , de modo que el riesgo acumulado es . Aplicar el peso posterior también a los eventos tempranos alteraría esa reconstrucción.
Esta sencillez procede de los supuestos del ejemplo. En una instalación real, la probabilidad de recibir mantenimiento podría depender de la temperatura reciente o de un aviso de fallo. Las historias retenidas tendrían que ponderarse según esa información previa a la decisión. Si el aviso no se registra, la censura puede seguir siendo selectiva respecto al resultado aunque el cálculo de los pesos sea impecable.
Los períodos de gracia permiten estrategias como iniciar una intervención durante una ventana. Hernán y colaboradores (2016) describen cómo la clonación y la censura mantienen los desenlaces tempranos en las estrategias con las que siguen siendo compatibles. El plazo y las reglas de inicio deben formar parte del protocolo. Si el día concreto dentro de la ventana puede modificar el resultado, interesa precisar también qué política determina ese día, en vez de tratar todas las ejecuciones como versiones indistinguibles.
Las fechas necesitan suficiente resolución para ordenar decisiones y eventos. Un registro mensual que solo diga «revisión y avería en marzo» puede no indicar cuál ocurrió primero. Dividirlo artificialmente en días no recupera ese orden. La ponderación se define a partir de la información disponible antes de cada decisión; utilizar mediciones tomadas después cambiaría la historia condicionante.
Los errores estándar deben reconocer que dos copias proceden de la misma máquina. Del mismo modo, si una unidad entra en varios ensayos secuenciales al cumplir repetidamente los criterios, sus contribuciones comparten historia. Las copias o las oportunidades de entrada no aumentan el número de unidades independientes en la misma proporción que el número de filas.
Qué debe explicar una ponderación por censura
La censura artificial por desviación y la pérdida ordinaria de seguimiento tienen causas diferentes, pero ambas pueden retirar selectivamente historias del análisis. Consideremos ahora un ejemplo separado con dos grupos de riesgo basal, cada uno de cien máquinas. En el grupo de riesgo bajo se observan noventa hasta el horizonte y nueve presentan la avería. En el de riesgo alto se observan cincuenta y veinte presentan la avería.
Entre los casos completos, el riesgo es , aproximadamente veinte coma siete por ciento. Supongamos que, dentro de cada grupo basal, permanecer observado es independiente del resultado y que las probabilidades de seguimiento son y . Las máquinas observadas de riesgo bajo reciben peso ; las de riesgo alto, peso dos.
El primer grupo representa cien máquinas y diez eventos; el segundo, cien máquinas y cuarenta eventos. La estimación ponderada es . La cuenta recupera el riesgo de la población inicial bajo la independencia condicional supuesta. En esta construcción podemos completar los resultados ausentes con un evento entre las diez máquinas de riesgo bajo y veinte entre las cincuenta de riesgo alto, obteniendo exactamente ese riesgo completo.
En datos reales esos resultados ausentes no están disponibles para comprobar la suposición. Si dentro del grupo de riesgo alto desaparecen sobre todo las máquinas con una señal no registrada de fallo inminente, sus compañeras observadas no las representan mediante un único peso dos. La corrección depende del contenido de la historia, además de depender del porcentaje que se pierde.
Con pérdidas sucesivas se multiplican probabilidades condicionales. Si una historia tiene probabilidad de conservarse de cuatro quintos en una etapa y de tres cuartos en la siguiente, dada su permanencia previa, la probabilidad conjunta es tres quintos y el peso inverso es cinco tercios. La segunda probabilidad se define entre quienes todavía podían seguir observándose, no sobre la cohorte original sin más condiciones.
Para una estrategia , podemos escribir de forma esquemática
Aquí indica si la copia ha sido censurada y reúne la información disponible antes de la decisión correspondiente. El producto se aplica a historias aún observadas y en riesgo; el estado previo al inicio se considera no censurado. La fórmula muestra pesos sin estabilizar. Otros numeradores pueden definir pesos estabilizados, con un análisis que respete las variables y el contraste incluidos en esa estabilización.
Cole y Hernán (2008) desarrollan las condiciones de la ponderación por probabilidades inversas: consistencia de la intervención, intercambiabilidad condicional, positividad y especificación adecuada de los modelos. Su aplicación concreta trata inicio de tratamiento y pérdida de seguimiento; la censura artificial de las copias se apoya aquí en la formulación de emulación de Hernán y colaboradores (2016).
La positividad tiene una interpretación operativa. Si ninguna máquina con cierto historial permanece observada, sus resultados no pueden reconstruirse a partir de otras máquinas con ese mismo historial. Una probabilidad pequeña también importa: con probabilidad de permanencia de un veinteavo, una historia conservada recibe peso veinte. Unos pocos eventos pueden dominar la estimación.
Limitar pesos cambia la corrección. En el ejemplo de dos grupos, si se fija un máximo de uno coma cinco, el grupo de riesgo alto deja de representar cien máquinas y pasa a representar setenta y cinco. La proporción ponderada se convierte en , aproximadamente veintidós coma nueve por ciento. Puede reducirse la variabilidad, pero ya no se reproduce el veinticinco por ciento de la construcción original.
El control de los pesos permite examinar concentración y sensibilidad. No certifica la ausencia de causas comunes sin medir. También importa el orden temporal de las covariables: una señal de desgaste puede ser consecuencia de una revisión previa y causa de la revisión siguiente. Ajustarla como una covariable basal ordinaria puede bloquear parte del efecto o introducir selección; los métodos longitudinales representan esa retroalimentación mediante historias de decisiones.
Comparar inicios y elegir una alternativa
La fecha de inicio también importa cuando la intervención ya estaba en curso al abrirse la base de datos. Una instalación puede registrar hoy las máquinas que llevan meses siguiendo cierto programa y compararlas con máquinas que nunca lo han seguido. Las primeras han tenido que permanecer en servicio y continuar con el programa hasta hoy. Las que fallaron al comienzo o cambiaron de plan ya no aparecen entre las usuarias actuales. La población observada puede haber perdido precisamente las unidades que permiten conocer el riesgo temprano.
Ray (2003) analiza este problema en los estudios de medicamentos que incluyen usuarios prevalentes. Además de seleccionar supervivientes de una exposición anterior, esos estudios pueden medir como «basales» variables que el tratamiento ya modificó. En términos de nuestra instalación, la temperatura actual de una máquina revisada durante meses puede reflejar los efectos de esas revisiones. Ajustar por ella como si precediera a la elección inicial no reproduce el mismo contraste que ajustar por su temperatura antes de entrar al programa.
Un diseño de nuevos usuarios sitúa la entrada al comenzar un curso de tratamiento. Esto permite observar su fase temprana y medir las covariables antes de ese inicio. La elección obliga a mirar hacia atrás: ¿durante cuánto tiempo consta que la unidad no recibió ninguna de las intervenciones comparadas? En nuestro protocolo original se exigían treinta días sin revisión. Esa regla define un período observable sin intervención reciente; no demuestra que la máquina jamás haya sido revisada desde que salió de fábrica.
La diferencia tiene consecuencias al interpretar el grupo elegible. Una máquina puede reiniciar después de una interrupción y cumplir el criterio registrado, aunque conserve una pieza instalada mucho antes. Si ese antecedente cambia la respuesta, habría que recogerlo o redefinir qué inicio se pretende estudiar. Aumentar el período previo requerido puede mejorar la clasificación de algunas historias, pero excluye las unidades que no tienen registros tan largos. Se gana información sobre el pasado de una población más restringida. La duración de esa ventana necesita una justificación ligada al proceso, además de una descripción reproducible.
Elegir el grupo contrario introduce otra decisión. Comparar a quienes empiezan una revisión especializada con quienes no reciben ninguna puede enfrentar máquinas con necesidades muy diferentes. Algunas no se revisan porque funcionan bien; otras, porque se consideran demasiado deterioradas para invertir en ellas. El mismo código «sin revisión» reúne así decisiones opuestas. Disponer de una variable binaria de intervención no vuelve homogénea la razón por la que se eligió cada alternativa.
Podríamos comparar el inicio de dos programas de mantenimiento que el personal considere opciones para una misma necesidad. El diseño con comparador activo y nuevos usuarios busca acercar de ese modo las situaciones de decisión y fijar un origen comparable (Lund, Richardson y Stürmer, 2015). La comparación seguiría necesitando datos sobre los determinantes que inclinan la elección hacia un programa. Si uno se reserva para los desperfectos más graves, ambos grupos comparten una indicación general pero no necesariamente el pronóstico.
Esa sustitución del comparador cambia también el efecto que se estima. Una diferencia pequeña entre dos revisiones eficaces puede coexistir con un beneficio importante de ambas frente a no revisar. Dos programas igualmente perjudiciales también pueden dar una diferencia próxima a cero. El resultado de compararlos entre sí no establece qué sucedería al retirar los dos. Para recuperar ese tercer contraste harían falta información y supuestos adicionales que el diseño entre iniciadores no incorpora automáticamente.
En el archivo de trabajo conviene poder reconstruir ambas decisiones: por qué cada máquina era candidata a cualquiera de los programas y cómo se determinó que estaba iniciando el curso definido. Los códigos de intervención, las fechas y la ventana previa deben corresponder al mismo protocolo en ambos grupos. Si una revisión queda registrada al solicitarla y la otra al completarla, la aparente comparación de nuevos usuarios vuelve a mezclar etapas distintas de la decisión. La simetría se comprueba siguiendo expedientes concretos hasta su primera observación de resultado, no únicamente comparando los nombres de las columnas.
El archivo disponible y el ensayo que permite representar
La fecha de un código no siempre coincide con la fecha del suceso. Una revisión puede cargarse al sistema al final de la semana; una avería, cuando se cierra su expediente. Antes de usar esas marcas como tiempo cero o como orden causal hay que distinguir fecha de ocurrencia, registro y disponibilidad para quien tomó la decisión.
También puede faltar el período previo necesario para establecer elegibilidad. La ausencia de una revisión registrada no implica que nunca se haya realizado: quizá la máquina pertenecía a otro centro o el sistema comenzó a registrar intervenciones recientemente. Exigir una ventana previa observable define qué trayectorias pueden clasificarse con suficiente información y puede restringir la población representada.
La detección del resultado requiere atención similar. Si la estrategia incluye más inspecciones, puede aumentar el registro de defectos sin aumentar su aparición. Para nuestro resultado terminal sería más sencillo confirmar la salida de servicio, pero aun así habría que distinguir avería de retirada administrativa. Una retirada por otra causa puede impedir una avería posterior y exige decidir cómo forma parte del resultado, en lugar de censurarla automáticamente como si fuera una pérdida de observación.
Un protocolo puede comparar iniciar ahora con no iniciar ahora y dejar las decisiones posteriores al funcionamiento habitual. Otro puede comparar iniciar y mantener un régimen con evitarlo durante todo el período. Las mismas fechas de intervención alimentan análisis diferentes según esa elección. En el segundo caso, las actuaciones posteriores determinan compatibilidad y posiblemente censura; en el primero, pueden ser consecuencias de la decisión inicial que interesa conservar.
Cuando existen muchas fechas posibles de entrada, pueden emularse ensayos secuenciales entre quienes cumplen criterios en cada fecha. Una máquina que todavía no inicia puede contribuir en varias oportunidades antes de hacerlo. Hay que especificar cómo se combinan los resultados, qué distribución de fechas representa el estimando y cómo se trata la dependencia entre contribuciones. Seleccionar a posteriori la fecha más favorable para cada grupo volvería a cambiar la comparación.
Las decisiones sobre el protocolo pueden revisarse al descubrir una limitación del archivo. Si falta el detalle de una revisión, quizá solo pueda estudiarse una política más amplia; si una estrategia nunca se observa en ciertos centros, quizá deba restringirse el ámbito. Esa revisión se documenta como cambio de pregunta o de población. Un nombre común de intervención no vuelve equivalentes dos protocolos distintos.
La incertidumbre estadística se calcula después de estas decisiones y expresa solo una parte de la incertidumbre total. Un intervalo estrecho alrededor del contraste retrospectivo de nuestra tabla no resolvería su sesgo de clasificación. El análisis de sensibilidad debe dirigirse al mecanismo que amenaza la interpretación: fechas ambiguas, determinantes no registrados de la decisión o seguimiento selectivo requieren comprobaciones diferentes.
Volvamos al expediente de una máquina asignada a revisión que falla el tercer día. En el ensayo conserva su asignación y aporta una avería temprana. Si solo conocemos su historia operativa, ambas estrategias siguen siendo compatibles hasta ese evento y sus copias lo conservan. La clasificación «nunca recibió mantenimiento» utiliza, en cambio, el fallo para determinar su grupo. Las tres filas pueden contener exactamente las mismas fechas; lo que cambia el riesgo estimado es la regla que decide a qué comparación pertenece esa avería.
Referencias
Cashin, A. G., Hansford, H. J., Hernán, M. A., Swanson, S. A., Lee, H., y colaboradores. (2025). Transparent reporting of observational studies emulating a target trial: the TARGET Statement. BMJ, 390, e087179. https://doi.org/10.1136/bmj-2025-087179
Cole, S. R., y Hernán, M. A. (2008). Constructing inverse probability weights for marginal structural models. American Journal of Epidemiology, 168(6), 656–664. https://doi.org/10.1093/aje/kwn164
Hernán, M. A., y Robins, J. M. (2016). Using big data to emulate a target trial when a randomized trial is not available. American Journal of Epidemiology, 183(8), 758–764. https://doi.org/10.1093/aje/kwv254
Hernán, M. A., y Robins, J. M. (2017). Per-protocol analyses of pragmatic trials. New England Journal of Medicine, 377(14), 1391–1398. https://doi.org/10.1056/NEJMsm1605385
Hernán, M. A., Sauer, B. C., Hernández-Díaz, S., Platt, R. W., y Shrier, I. (2016). Specifying a target trial prevents immortal time bias and other self-inflicted injuries in observational analyses. Journal of Clinical Epidemiology, 79, 70–75. https://doi.org/10.1016/j.jclinepi.2016.04.014
Hernán, M. A., Sterne, J. A. C., Higgins, J. P. T., Shrier, I., y Hernández-Díaz, S. (2025). A structural description of biases that generate immortal time. Epidemiology, 36(1), 107–114. https://doi.org/10.1097/EDE.0000000000001808
Lund, J. L., Richardson, D. B., y Stürmer, T. (2015). The active comparator, new user study design in pharmacoepidemiology: historical foundations and contemporary application. Current Epidemiology Reports, 2(4), 221–228. https://doi.org/10.1007/s40471-015-0053-5
Ray, W. A. (2003). Evaluating medication effects outside of clinical trials: new-user designs. American Journal of Epidemiology, 158(9), 915–920. https://doi.org/10.1093/aje/kwg231