Imaginemos que conocemos exactamente una distribución de tratamientos y resultados. No hay error de muestreo: sabemos qué proporción recibió cada tratamiento y qué ocurrió en cada grupo. Todavía puede faltar información para responder qué habría ocurrido si hubiéramos cambiado la asignación. Esa dificultad persiste aunque se amplíe el registro hasta incluir a toda la población. Procede de que diferentes procesos causales pueden producir la misma distribución observada y reaccionar de manera distinta a una intervención.
La identificación pregunta si una cantidad causal queda determinada por los datos disponibles y los supuestos adoptados. La pregunta se formula antes de decidir qué algoritmo estimará esa cantidad en una muestra. Puede quedar identificada una media sin que lo esté toda una distribución, o un efecto poblacional sin que se conozca quién se beneficia individualmente. Por ello, hablar de «un modelo identificado» sin nombrar el objetivo puede ocultar diferencias relevantes.
Los ejemplos numéricos de este texto son construcciones didácticas. Se conocen sus reglas generadoras para comparar lo que ocurre bajo observación y bajo intervención. No representan efectos de tratamientos reales ni permiten trasladar sus magnitudes a una población clínica.
Identificar una cantidad dentro de una clase de modelos
Sea una clase de modelos causales admitidos. Cada modelo determina una distribución de observaciones, que denotaremos , y una cantidad causal objetivo . El símbolo reúne las variables efectivamente observadas. La cantidad está identificada en esa clase cuando dos modelos que producen la misma distribución observacional necesariamente asignan el mismo valor al objetivo:
Esta definición permite que los modelos difieran en muchos otros aspectos. Podrían describir de manera distinta una variable latente o distribuir de otro modo ciertas perturbaciones. Para identificar una media causal basta que esas diferencias no cambien la media buscada. Si existe siquiera un par de modelos admitidos que coincide en las observaciones y discrepa en el objetivo, las observaciones no bastan para determinarlo en toda esa clase.
La expresión «admitidos» contiene el trabajo científico del problema. Podemos restringir los modelos mediante un mecanismo de aleatorización conocido, un grafo causal defendible o hipótesis sobre la selección de tratamientos. También podemos imponer formas funcionales específicas. Cuanto más restringida sea la clase, más posibilidades habrá de identificar una cantidad; eso no convierte automáticamente las restricciones en verdaderas. Es necesario explicar qué conocimiento permite excluir las alternativas.
Cuando existe identificación, el objetivo puede escribirse como una función de la distribución observada, . Una fórmula de estandarización es un ejemplo de esa función. La estimación reemplaza después la distribución desconocida por información muestral y debe controlar el error resultante. Un estimador puede ser inconsistente por mala especificación aunque el objetivo sea identificable. A la inversa, un algoritmo puede producir siempre un número único aunque el objetivo causal no esté identificado.
Greenland y Robins (2009) examinan esta relación entre identificación y comparabilidad. Las condiciones que permiten usar los resultados de unas personas como información sobre resultados no observados de otras no son un procedimiento de cálculo. Una vez justificadas, hacen posible el cálculo; si faltan, la precisión de las frecuencias no las reemplaza.
Una tabla compatible con dos respuestas causales
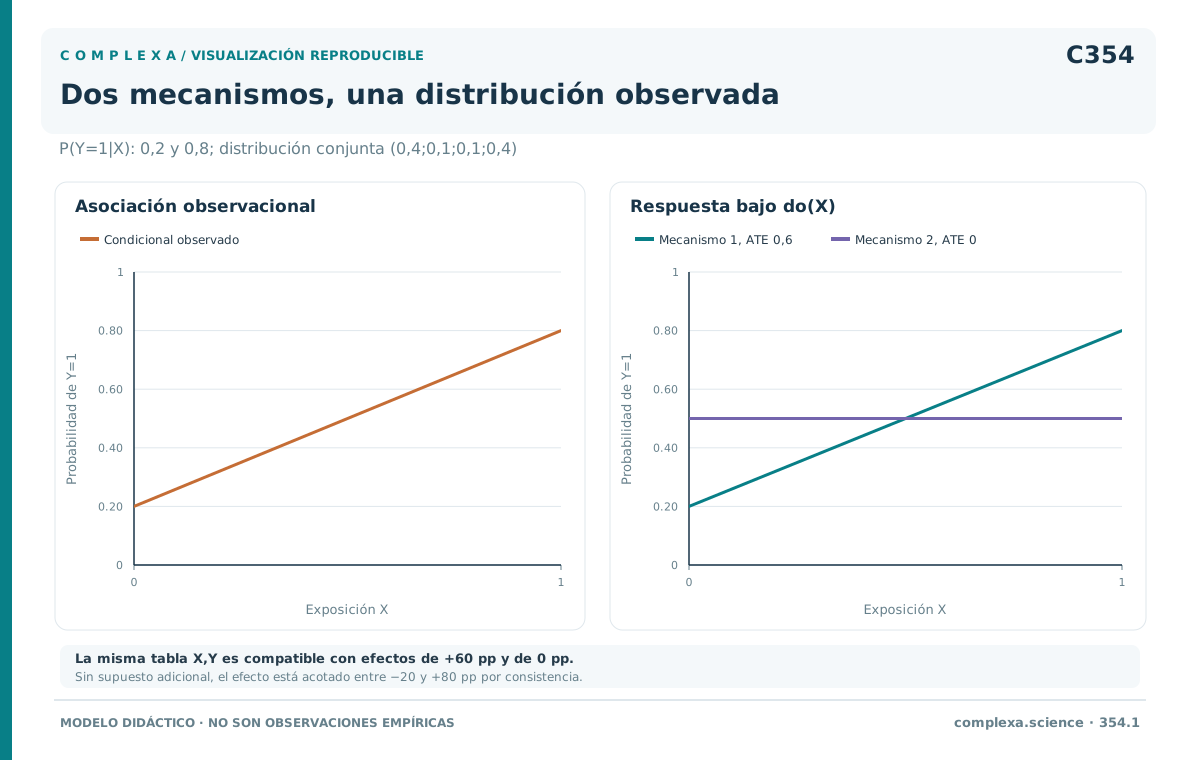
Consideremos dos variables binarias, una exposición y un resultado favorable . Supongamos conocida la siguiente distribución conjunta:
| 0,40 | 0,10 | |
| 0,10 | 0,40 |
La mitad de la población está expuesta. Entre quienes tienen , la probabilidad del resultado favorable es ochenta por ciento; entre quienes tienen , es veinte por ciento. La diferencia observacional es sesenta puntos porcentuales. Todas las combinaciones tienen probabilidad positiva, por lo que no estamos ante una tabla incompleta debido a una celda imposible.
Un primer modelo genera mediante una moneda equilibrada. Después toma una variable independiente que vale uno con probabilidad de un quinto y define , donde indica suma módulo dos: cuando , el resultado coincide con la exposición; cuando , se invierte. Este procedimiento genera exactamente la tabla. Fijar produce éxito con probabilidad cuatro quintos, y fijar lo produce con probabilidad un quinto. El efecto causal medio vale .
El segundo modelo introduce una condición no observada , también equilibrada. Define y , con dos errores independientes entre sí y de . Ambos errores valen uno con probabilidad
En este sistema, la exposición y el resultado comparten una causa, pero la ecuación del resultado no utiliza la exposición. Sus valores difieren cuando exactamente uno de los errores vale uno, lo que ocurre con probabilidad . Por simetría, las dos celdas concordantes valen y las dos discordantes valen . Obtenemos la misma tabla observada.
Al intervenir sobre en el segundo modelo, se reemplaza su ecuación y se conserva el mecanismo que genera e . El éxito sigue teniendo probabilidad de un medio bajo ambas opciones. El efecto causal medio vale cero. La intervención distingue los modelos aunque ninguna cantidad calculada exclusivamente a partir de la tabla observacional pueda hacerlo.
La falta de identificación no se debe aquí a que el segundo modelo asigne una exposición determinista dentro de cada valor de la causa común. Como está entre cero y uno, ambas exposiciones son posibles en ambos estratos de . El obstáculo es que la causa y el mecanismo de asignación no se observan ni quedan excluidos por las restricciones adoptadas. El soporte observado, aunque necesario en muchas estrategias, no demuestra comparabilidad causal.
Estos dos modelos no afirman que toda asociación tenga una explicación alternativa sin efecto. Demuestran algo más delimitado: si la clase admite ambos procesos, la tabla no identifica el efecto. Si un protocolo experimental garantiza el mecanismo del primer modelo, el segundo deja de ser compatible con toda la información disponible. La procedencia de los datos puede aportar conocimiento que no aparece como una columna adicional.
La comprobación de un contraejemplo exige comparar toda la información declarada disponible. Dos modelos con la misma media pueden tener varianzas diferentes y resultar distinguibles mediante las observaciones. Aquí se igualaron las cuatro probabilidades de una distribución binaria conjunta; cualquier resumen de esas dos variables queda determinado por ellas. Si también se observaran otras variables, habría que mostrar que los modelos coinciden en su distribución conjunta ampliada antes de mantener la misma demostración.
Un solo contraejemplo basta para refutar una afirmación de identificación válida para toda la clase. No determina, por sí solo, todas las respuestas compatibles ni demuestra que cualquier distribución particular plantee la misma ambigüedad. De ahí la utilidad de calcular después el conjunto identificado cuando sea posible. También conviene distinguir esta igualdad exacta de dos ajustes parecidos en una muestra: los modelos aproximados podrían separarse con datos adicionales del mismo tipo, mientras que los dos procesos de nuestra tabla continuarían siendo observacionalmente equivalentes aunque se conociera la distribución sin error.
Una preferencia previa no añade una observación
Supongamos que comparamos exactamente estos dos modelos mediante una inferencia bayesiana. Antes de observar la muestra asignamos una probabilidad previa de un medio a cada uno. Como ambos producen la misma probabilidad para cada combinación observable, asignan también la misma verosimilitud a cualquier muestra independiente de esas combinaciones. Las probabilidades posteriores de los dos modelos siguen siendo iguales, cualquiera que sea el tamaño de esa muestra.
La media posterior del efecto sería entonces , promedio de los efectos y cero con iguales pesos. Ese valor intermedio no es una nueva respuesta que la tabla haya distinguido. Resume la incertidumbre entre dos mecanismos bajo una elección previa. Si la probabilidad previa del primer modelo fuera nueve décimos, la media posterior del efecto sería , sin que hubiera cambiado una sola observación.
El cálculo es legítimo como inferencia condicionada a esa especificación, siempre que se conserve su dependencia de las probabilidades previas. No resuelve por sí mismo la identificación desde la distribución observacional. Las dos cantidades pueden coexistir en un informe: el conjunto de valores admitidos por datos y restricciones, y una distribución posterior que asigna pesos a esos valores mediante información adicional.
La regularización produce una situación relacionada. Un criterio que favorezca cierto mecanismo, una forma funcional o una distribución latente puede seleccionar una única solución entre varias compatibles. La unicidad del resultado computacional describe el comportamiento del procedimiento. Para atribuirla a los datos hay que mostrar qué restricción seleccionó la respuesta y si estaba justificada antes de conocer cuál convenía al argumento.
Esto afecta también a modelos muy flexibles. Ajustar mejor la distribución observada puede ser útil para estimar sus características, pero no permite separar dos procesos que, por construcción, generan exactamente esa misma distribución. Si una arquitectura impide representar uno de ellos, la distinción proviene de la arquitectura o de sus restricciones. Conviene explicitar esa exclusión antes de interpretar la salida del sistema como descubrimiento causal.
Qué agrega una condición de comparabilidad
Con resultados potenciales, escribimos y para los resultados bajo las dos opciones. La consistencia conecta el resultado observado con el correspondiente a la exposición recibida. La intercambiabilidad marginal, expresada como independencia de la asignación respecto de los resultados potenciales, permite identificar sus medias mediante las medias de los grupos observados, si ambas opciones tienen soporte.
En estudios observacionales puede proponerse intercambiabilidad después de condicionar en covariables previas . Bajo esa condición, consistencia y positividad, la media bajo intervención se obtiene promediando sobre la distribución de . La fórmula depende de que las covariables incluidas sean suficientes para la comparabilidad relevante. La similitud de medias observadas en algunas columnas no demuestra que también se hayan equilibrado los resultados potenciales.
La aleatorización constituye una forma de justificar independencia mediante el mecanismo de asignación. No garantiza que dos grupos finitos tengan exactamente la misma edad, gravedad o historia previa. Las diferencias por azar forman parte de la variabilidad del diseño. También hay que distinguir la asignación aleatoria de lo que ocurre después: cambios de tratamiento, pérdidas de seguimiento y selección de participantes con datos completos pueden modificar la cantidad observada. Greenland y Robins (2009) señalan que parte de la discusión sobre «ausencia de confusión» depende de si se habla del mecanismo probabilístico o del balance realizado en una muestra concreta.
En el ejemplo de las monedas, observar una diferencia de sesenta puntos y conocer una asignación aleatoria aporta información distinta de observar la misma diferencia en un registro de decisiones clínicas. Las celdas podrían coincidir y, aun así, las clases de modelos compatibles con el diseño serían diferentes. La identificación debe formularse usando tanto la distribución como el conocimiento justificado del proceso que produjo esa distribución.
Las restricciones también pueden ser más débiles que la independencia completa. Para identificar una diferencia de medias puede bastar una condición sobre medias potenciales, aunque otras características distribucionales difieran. Eso obliga a mantener el objetivo visible: una justificación suficiente para una media no autoriza automáticamente una conclusión sobre cuantiles, probabilidades conjuntas o efectos individuales.
Cuando una causa no medida no impide toda identificación
La confusión no medida entre exposición y resultado descarta algunas fórmulas, pero no elimina necesariamente toda posibilidad de identificación. Un mecanismo intermedio observado puede aportar una vía diferente si satisface restricciones específicas. El criterio de puerta delantera de Pearl (1995) es un ejemplo: permite recuperar el efecto total en una estructura donde no existe un ajuste ordinario suficiente por causas previas observadas.
Consideremos el grafo , acompañado por una causa latente que influye en y en . No hay una flecha directa desde a . Tampoco hay causas comunes no bloqueadas entre y ; las rutas no causales entre e quedan bloqueadas al condicionar en . Estas condiciones aseguran que el mediador recoge todas las vías causales pertinentes y que sus dos relaciones se pueden combinar de manera controlada.
La fórmula correspondiente es
El símbolo es un índice de suma que recorre las opciones de exposición. No debe confundirse con el valor fijado en la intervención externa. La suma interior utiliza la distribución marginal de la exposición para identificar una respuesta a la intervención sobre el mediador. La suma exterior combina esa respuesta con la distribución del mediador que produciría la exposición elegida.
La fórmula contiene distribuciones observacionales, pero su justificación no es una identidad de la probabilidad válida para cualquier sistema. Las restricciones causales permiten efectuar los reemplazos necesarios. Si existe una vía directa que evita al mediador, o una causa no medida que vincula mediador y resultado después de controlar la exposición, este argumento deja de justificar la misma expresión.
En aplicaciones, esas exclusiones pueden ser exigentes. Un indicador parcial de respuesta no captura por ello toda la mediación. Una medida registrada con error tampoco conserva automáticamente las propiedades del mediador verdadero. La disponibilidad de una columna intermedia es el comienzo de una pregunta sobre mecanismos; no demuestra que se haya encontrado una estrategia de puerta delantera.
Una recuperación numérica en dos etapas
Para comprobar la fórmula, fijemos un sistema binario con equilibrada. La exposición ocurre con probabilidad cuando y cuando . La probabilidad de es si y si . Finalmente,
Cada variable se genera con una perturbación independiente, dada la información que aparece en su ecuación. La exposición no entra directamente en el mecanismo del resultado. Todos los valores de probabilidad están entre cero y uno, y existe soporte para cada combinación necesaria del mediador y la exposición.
Como la causa latente es más frecuente entre expuestos, las probabilidades observacionales del resultado condicionadas en mediador y exposición son diferentes incluso cuando se mantiene fijo el mediador:
| Mediador | ||
|---|---|---|
| 0,16 | 0,34 | |
| 0,56 | 0,74 |
Las medias crudas del resultado son en no expuestos y en expuestos. Su diferencia es . Es una comparación que mezcla el mecanismo mediado con la distribución distinta de la causa latente.
La exposición tiene probabilidad marginal de un medio. La suma interior de la fórmula promedia, por tanto, las dos columnas con iguales pesos. Para produce ; para , . Después utilizamos la distribución del mediador inducida por cada opción de exposición. Bajo , el riesgo resulta . Bajo , resulta . La diferencia causal es .
Podemos comprobarlo directamente usando las ecuaciones generadoras. Una intervención sobre no cambia la proporción de , que permanece en un medio. La media del resultado es entonces . Sustituir las probabilidades del mediador da los mismos valores y . El cálculo directo usa la causa latente conocida por construcción; la fórmula de identificación recupera la respuesta sin observarla.
La operación es distinta de ajustar ordinariamente por el mediador. Si promediáramos sobre la distribución marginal de , cuya probabilidad de uno es , obtendríamos y . Su diferencia, , no coincide con el efecto total. Mantener al mediador en una composición común elimina parte de la respuesta que queríamos conservar, mientras la confusión por sigue afectando la comparación condicionada.
El ejemplo permite distinguir dos afirmaciones. La primera es que una fórmula concreta recupera el objetivo en el sistema especificado; eso se verificó mediante las cuentas. La segunda es que las restricciones del sistema son defendibles en una investigación particular. Esta última requiere evidencia del proceso y no queda demostrada porque el cálculo pueda ejecutarse sobre una base de datos real.
Puede ser útil examinar qué modificación del ejemplo destruiría la identificación propuesta. Si la causa latente influyera también en el mediador por una vía que evita la exposición, las probabilidades del mediador condicionadas en la exposición ya no representarían necesariamente su distribución bajo intervención. Si existiera un efecto directo de la exposición sobre el resultado, una parte de la respuesta quedaría fuera de la ruta utilizada para construir la fórmula. Son fallos distintos y requieren comprobaciones sustantivas diferentes.
Medir repetidamente el mediador no descarta por sí mismo ninguna de esas posibilidades. Las mediciones pueden precisar la distribución de la variable y su evolución, pero sigue haciendo falta justificar que todas las vías causales pertinentes pasan por ella y que la comparación necesaria está protegida de causas comunes. Tampoco basta que el efecto de la exposición disminuya al añadir el mediador a una regresión: esa observación puede deberse a mecanismos diferentes que no satisfacen las condiciones de puerta delantera.
Una evaluación útil registra las fuentes de cada restricción. El orden temporal puede apoyar la dirección de algunas relaciones; un experimento sobre el mecanismo intermedio puede informar otras; la descripción de cómo se decide la exposición puede ayudar a evaluar causas comunes. Si una restricción queda solo como hipótesis de trabajo, la conclusión identificada debe presentarse condicionada a ella. Eso permite señalar qué parte del razonamiento cambiaría al aparecer evidencia contraria, en lugar de tratar toda la inferencia como un bloque indivisible.
De una fórmula particular a procedimientos generales
Los criterios de puerta trasera y puerta delantera resuelven familias de problemas. El cálculo de intervenciones permite transformar expresiones causales mediante reglas que se justifican en relaciones gráficas. La finalidad es llegar a una expresión formada por distribuciones observables. Una manipulación algebraica que ignore las condiciones gráficas de una regla podría dar una fórmula computable sin conservar el significado causal original.
Tian y Pearl (2002) ampliaron las condiciones de identificación en modelos con variables latentes. Su resultado distingue el efecto de una variable sobre todo el conjunto restante del efecto sobre un subconjunto: identificar la respuesta conjunta completa es una exigencia mayor. Esta diferencia evita concluir que una pregunta parcial carece de solución simplemente porque una pregunta más amplia no la tiene.
Shpitser y Pearl (2006) desarrollaron un procedimiento completo para determinadas consultas de intervención en modelos causales recursivos semimarkovianos, formulado en el artículo con variables de dominio finito. Dentro de la clase y el problema formal considerados, el algoritmo obtiene una expresión identificadora o una estructura gráfica que certifica la falta de identificación. «Completo» se refiere a ese alcance matemático. No significa que el programa pueda decidir si las variables elegidas representan correctamente la exposición, si el grafo describe el servicio estudiado o si los registros tienen la calidad requerida.
Una declaración de fracaso debe conservar el nombre de la consulta, el conjunto de variables observadas y las restricciones de la clase. Si después se incorpora información experimental, una variable que antes era latente o una restricción funcional defendible, se plantea otro problema de identificación. También cambia el problema si se pasa del efecto total a una comparación más limitada que la información disponible sí puede determinar.
El tratamiento de probabilidades nulas merece atención separada. Las expresiones condicionales solo tienen significado estadístico en eventos con soporte. Una fórmula gráfica no justifica extrapolar automáticamente fuera de las combinaciones observadas. Incluso con soporte positivo, probabilidades muy pequeñas pueden producir estimaciones inestables: la identificación teórica y la calidad de una estimación finita son propiedades diferentes.
Por ejemplo, supongamos que un estrato previo reúne a la mitad de la población y que dentro de él la probabilidad de recibir una opción es uno por mil. La celda conjunta correspondiente tiene probabilidad de uno entre dos mil. En una muestra independiente de dos mil personas se espera una sola observación en esa celda. La probabilidad de no observar ninguna es aproximadamente . Hay soporte en la población y, sin embargo, una fracción considerable de muestras no contendrá la comparación necesaria para una estimación directa estable.
Una ausencia así no demuestra una prohibición estructural de la intervención. Puede ser una consecuencia del muestreo. El problema inverso también existe: encontrar unas pocas observaciones en cada categoría no garantiza solapamiento suficiente cuando se consideran simultáneamente varias covariables. El diagnóstico exige estudiar el soporte relativo a las condiciones de la fórmula, no únicamente contar tratamientos en toda la muestra.
La respuesta práctica puede consistir en ampliar la información en los estratos escasos, cambiar la estrategia evaluada o restringir explícitamente la población objetivo. Un procedimiento de extrapolación también puede producir una estimación, pero sus supuestos adquieren más peso donde los datos son débiles. La falta de precisión causada por escasez no debe confundirse con la ambigüedad entre mecanismos que hemos demostrado en la primera tabla: una requiere más información sobre cantidades observables; la otra requiere información capaz de distinguir respuestas a intervenciones.
Conocer un intervalo puede ser el resultado correcto
Regresemos a la primera tabla, sin suponer intercambiabilidad ni elegir uno de los dos mecanismos. La consistencia informa del resultado potencial correspondiente a la exposición recibida. Para quienes no estuvieron expuestos, el resultado bajo exposición sigue sin observarse; para los expuestos, falta el resultado bajo ausencia de exposición. Como ambos resultados son binarios, las contribuciones desconocidas quedan entre cero y uno.
La media de se descompone en una parte observada y otra desconocida:
La primera parte vale y la segunda está entre cero y . Por ello, la media bajo exposición pertenece a . De modo semejante, la media bajo ausencia de exposición pertenece a . Al considerar conjuntamente las posibilidades compatibles con la tabla, la diferencia media puede estar entre y .
Los extremos son alcanzables. Para obtener el límite inferior, asignamos resultado potencial bajo exposición igual a cero a todos los no expuestos y resultado potencial sin exposición igual a uno a todos los expuestos. Las medias resultantes son y . Para obtener el límite superior, invertimos esas asignaciones no observadas: las medias pasan a y . En ambos casos, los resultados efectivamente observados permanecen exactamente iguales.
Estas cotas son ajustadas a las restricciones indicadas: no puede estrecharse el intervalo excluyendo valores que todavía admite algún modelo compatible. La palabra «ajustadas» aquí describe esa propiedad de alcance y no un ajuste por covariables. La identificación parcial conserva el conjunto de respuestas permitidas, en lugar de seleccionar una mediante un supuesto que no se ha declarado. Richardson et al. (2014) desarrollan este enfoque y su relación con el análisis de sensibilidad.
El intervalo no tiene cobertura del noventa y cinco por ciento ni representa un intervalo de confianza. Fue obtenido tratando la tabla poblacional como conocida. Si las celdas son frecuencias de una muestra, también existe incertidumbre sobre los límites del conjunto. Entonces hace falta un procedimiento inferencial para esa variabilidad; no basta añadir la etiqueta de confianza a los extremos calculados.
Un conocimiento adicional puede estrechar las cotas. Si se justificara que la intervención nunca reduce el resultado favorable de ninguna persona, los efectos individuales no podrían ser negativos. Esa monotonía de respuesta descartaría parte del intervalo anterior. Sin embargo, imponerla porque se desea un límite positivo convertiría la conclusión en una consecuencia de la restricción elegida. La justificación tiene que proceder de conocimiento independiente del resultado que se quiere defender.
La información experimental también puede dejar un conjunto
Una asignación aleatoria puede identificar el efecto de ser asignado a una estrategia sin identificar por sí sola el efecto de recibir efectivamente una intervención. La diferencia aparece cuando algunas personas no siguen la asignación. El tratamiento recibido puede volver a depender de características que también influyen en el resultado. Comparar receptores y no receptores rompe la protección que ofrecía el mecanismo de asignación.
Balke y Pearl (1997) estudiaron restricciones sobre efectos de tratamiento con asignación aleatoria e incumplimiento. Bajo condiciones adicionales, incluida una restricción que excluye efectos de la asignación sobre el resultado por vías distintas del tratamiento, la información experimental limita las respuestas posibles. Esas restricciones pueden producir cotas ajustadas y, en algunos casos, identificación puntual. La existencia de un componente aleatorizado no obliga a que toda pregunta sobre recepción del tratamiento tenga una respuesta única.
El objetivo debe nombrar la intervención que se quiere cambiar. «Ofrecer», «asignar» y «recibir» pueden corresponder a variables distintas. Un estimador orientado al efecto de la oferta puede ser perfectamente pertinente para una política de oferta y resultar insuficiente para una pregunta biológica sobre recibir el tratamiento. Cambiar la etiqueta del efecto en la interpretación no transforma la información del experimento.
De manera semejante, identificar un efecto para un subconjunto definido por su respuesta a la asignación no identifica necesariamente el promedio de toda la población. Las restricciones que permiten ese contraste deben permanecer junto a su denominador. Antes de intentar mejorar el estimador conviene verificar si el desacuerdo entre análisis corresponde a objetivos diferentes que el mismo diseño informa de modo desigual.
Un promedio identificado no revela quién cambia
Supongamos ahora que un experimento bien definido permite conocer y . La diferencia media queda fijada en . Sin embargo, el experimento ordinario no observa los dos resultados potenciales de la misma persona bajo condiciones mutuamente excluyentes. Las distribuciones marginales no determinan automáticamente su distribución conjunta.
Una población compatible puede contener veinte por ciento que fracasa bajo ambas opciones, sesenta por ciento que pasa del fracaso al éxito con la intervención y veinte por ciento que tiene éxito bajo ambas. En esa población nadie empeora. Otra población compatible puede contener ochenta por ciento que pasa del fracaso al éxito y veinte por ciento que pasa del éxito al fracaso. Las medias bajo cada opción son las mismas en ambas poblaciones.
En consecuencia, la proporción que se beneficia puede ser en la primera población y en la segunda, mientras que la proporción perjudicada cambia de cero a . El efecto medio no distingue esas composiciones. En general, con estas dos marginales binarias, la proporción de personas que mejora está entre y . Una afirmación individual más precisa necesitaría restricciones sobre cómo se relacionan los dos resultados potenciales.
La distinción es especialmente útil al interpretar predicciones de respuesta. Un modelo que predice bien el resultado de personas tratadas estima una cantidad observacional o una marginal bajo ciertas condiciones. Para estimar el beneficio individual debe comparar resultados que no se observan juntos. Las covariables pueden definir efectos medios condicionados a perfiles, pero un perfil con efecto medio favorable todavía puede contener personas con respuestas diferentes.
Qué información conviene obtener después
La falta de identificación permite precisar una decisión de investigación. En el ejemplo de las dos monedas, aumentar el número de observaciones de e no separará los mecanismos. Una intervención sobre sí produce predicciones distintas: el primer modelo espera riesgos de y , mientras el segundo espera en ambos grupos. El diseño informativo es el que modifica esa ambigüedad concreta.
Medir una variable candidata a causa común también puede ayudar, siempre que su relación con los mecanismos sea suficientemente conocida. Registrar un indicador ruidoso o una consecuencia posterior no equivale a observar la causa que faltaba. Se debe demostrar cómo la nueva información restringiría los modelos compatibles. Una nueva columna que ambos modelos pueden reproducir de cualquier manera añade volumen sin asegurar una reducción de la ambigüedad causal.
Otra posibilidad es restringir el objetivo. Si el soporte solo permite comparar ciertas estrategias en una subpoblación, puede formularse una pregunta para esa población y explicitar el cambio. La restricción no debe hacerse únicamente porque produce una respuesta más favorable. También es posible conservar el objetivo amplio y presentar cotas o un análisis de sensibilidad que muestre qué supuestos controlan la conclusión.
Un informe del primer ejemplo podría conservar la tabla, declarar que el efecto no está identificado bajo consistencia solamente y presentar el intervalo compatible de menos veinte a más ochenta puntos porcentuales. Después distinguiría dos escenarios adicionales: bajo asignación independiente de los resultados potenciales, el efecto medio es sesenta puntos; bajo el mecanismo de causa común construido, es cero. La diferencia entre esas respuestas señala qué información debe justificar el estudio antes de elegir una cifra causal.
Referencias
Balke, A., & Pearl, J. (1997). Bounds on treatment effects from studies with imperfect compliance. Journal of the American Statistical Association, 92(439), 1171–1176. https://doi.org/10.1080/01621459.1997.10474074
Greenland, S., & Robins, J. M. (2009). Identifiability, exchangeability and confounding revisited. Epidemiologic Perspectives & Innovations, 6, 4. https://doi.org/10.1186/1742-5573-6-4
Pearl, J. (1995). Causal diagrams for empirical research. Biometrika, 82(4), 669–688. https://doi.org/10.1093/biomet/82.4.669
Richardson, A., Hudgens, M. G., Gilbert, P. B., & Fine, J. P. (2014). Nonparametric bounds and sensitivity analysis of treatment effects. Statistical Science, 29(4), 596–618. https://doi.org/10.1214/14-STS499
Shpitser, I., & Pearl, J. (2006). Identification of joint interventional distributions in recursive semi-Markovian causal models. En Proceedings of the Twenty-First National Conference on Artificial Intelligence (pp. 1219–1226). AAAI Press. https://cdn.aaai.org/AAAI/2006/AAAI06-191.pdf
Tian, J., & Pearl, J. (2002). A general identification condition for causal effects. En Proceedings of the Eighteenth National Conference on Artificial Intelligence (pp. 567–573). AAAI Press. https://cdn.aaai.org/AAAI/2002/AAAI02-085.pdf