Una misma tarea puede completarse con una herramienta de automatización o mediante el procedimiento habitual. Registramos cuánto tarda cuando se usa la herramienta. El dato no contiene, además, el tiempo que habría requerido esa misma tarea, en las mismas condiciones iniciales, si se hubiera seguido la otra opción. Repetirla mañana produce otra ejecución: quizá cambien la carga de trabajo, la experiencia del operador o el estado del equipo.
Los resultados potenciales permiten expresar la comparación que falta. Un modelo causal estructural añade una descripción de cómo se producen los resultados y de qué ecuaciones se modificarían al intervenir. Ambas representaciones pueden relacionarse de manera precisa dentro de modelos especificados. Esa relación no autoriza a convertir automáticamente una regresión observacional en un mecanismo causal ni a suponer que todos los modelos formulados en una representación tienen un equivalente irrestricto en la otra.
Usaremos dos ejemplos construidos. El primero describe tiempos de ejecución y permite comparar observación, intervención y un contrafactual individual. El segundo utiliza un resultado binario para mostrar cuánta información individual puede permanecer indeterminada aun cuando se conozcan exactamente las probabilidades de éxito bajo ambas opciones. Sus números y mecanismos son didácticos, sin datos experimentales o clínicos detrás.
Los dos resultados que una fila no muestra
Llamemos a la opción aplicada: vale uno cuando se usa la automatización y cero cuando se sigue el procedimiento habitual. Para una ejecución identificada por , escribimos y como sus tiempos potenciales bajo cada opción. El efecto individual, definido como una diferencia de tiempos, es
Un valor negativo indica que la automatización reduce el tiempo. La definición compara dos resultados para la misma unidad; no compara directamente a dos operadores distintos. La unidad debe estar suficientemente delimitada para que ambas alternativas tengan sentido: una tarea, sus condiciones iniciales y el período durante el que se medirá la ejecución.
El resultado observado será el correspondiente a la opción efectivamente aplicada. Bajo consistencia podemos escribir
Cuando la asignación vale uno, la expresión selecciona el primer resultado potencial; cuando vale cero, selecciona el segundo. La otra cantidad sigue formando parte de la pregunta, aunque no aparezca observada en esa fila. Un resultado potencial tampoco significa necesariamente un resultado contrario a lo ocurrido: el correspondiente a la opción realizada coincide con el factual bajo esta condición de consistencia.
Holland (1986) llamó problema fundamental de la inferencia causal a la imposibilidad de observar ambos resultados para la misma unidad en la comparación planteada. El término se refiere a la observación, no a una prohibición de razonar sobre ellos. Los experimentos repetidos pueden aportar información si hay razones para asumir estabilidad y ausencia de efectos persistentes, pero esas razones forman parte de la inferencia. En un sistema que aprende, la segunda ejecución puede ser distinta precisamente por haber realizado la primera.
La consistencia requiere que la etiqueta de la opción corresponda a la intervención definida. Si «automatización» reúne versiones que actúan de manera diferente, el símbolo puede omitir información necesaria. Una versión que solo precompleta campos y otra que también verifica errores no tienen por qué producir el mismo tiempo. VanderWeele y Hernán (2013) muestran cómo explicitar versiones o políticas de asignación de versiones. La notación abrevia una intervención; no reemplaza su descripción.
También hemos supuesto, por ahora, que el tiempo de una ejecución no depende de las opciones asignadas a otras. Si varias tareas comparten un servidor y compiten por capacidad, el resultado podría depender del conjunto de asignaciones. En ese caso, habría que ampliar el índice del resultado potencial para representar esa dependencia. Tener dos símbolos por unidad es suficiente para ciertos problemas, no una propiedad universal de todos los sistemas.
Qué puede conocerse de un promedio
El efecto promedio en una población de ejecuciones se define como . Por linealidad de la esperanza, es igual a , siempre que las medias estén definidas. Esta igualdad permite estudiar el promedio sin identificar cada diferencia individual. Aun así, hay que justificar cómo las unidades observadas bajo cada opción informan esas medias poblacionales.
Una condición suficiente es que la asignación sea independiente de los resultados potenciales y que ambas opciones tengan probabilidad positiva. Con consistencia, tendríamos
para cada opción . El primer paso usa la conexión entre observación y resultado potencial; el segundo usa independencia. Si las tareas más difíciles reciben preferentemente la herramienta, el segundo paso no está justificado por la mera presencia de ambas opciones en los datos.
La aleatorización busca construir una asignación con propiedades conocidas que permitan esa comparación. Rubin (1974) examina su papel en la estimación de efectos, junto con el uso de datos no aleatorizados cuidadosamente controlados. Una asignación aleatoria no obliga a que todos los rasgos de dos grupos finitos coincidan exactamente. Proporciona un mecanismo para evaluar cómo variarían las diferencias por la asignación y para fundamentar estimadores de cantidades causales bajo las demás condiciones del estudio.
Es útil distinguir la igualdad poblacional de una igualdad entre medias calculadas en una muestra. Aunque el mecanismo sea aleatorio, las medias observadas fluctúan. Además, perder resultados de manera relacionada con la opción y con el tiempo de ejecución puede deteriorar la comparación disponible. La asignación inicial y el proceso que decide qué resultados terminan observados son componentes distintos.
En un estudio observacional podríamos postular independencia condicional dada una variable previa . Entonces la comparación se hace dentro de sus valores y se promedian los resultados usando la distribución de esa variable en la población objetivo. La validez depende de que lo incluido en baste para la condición propuesta. Introducir muchos predictores en una regresión no demuestra esa suficiencia.
El lenguaje de resultados potenciales hace visible dónde entra el supuesto. Escribimos una independencia entre cantidades hipotéticas y la asignación, condicionada en información previa. Para decidir si tiene sentido necesitamos entender el proceso que generó las tareas y las decisiones. Un modelo estructural puede hacer explícita una propuesta sobre ese proceso y permitir examinar las consecuencias de modificarlo.
Un mecanismo construido para calcular las tres preguntas
Consideremos una carga de trabajo inicial , baja cuando vale cero y alta cuando vale uno. Cada nivel tiene probabilidad un medio. Introducimos una variable , uniforme sobre los enteros del uno al cinco, y una variable que vale menos uno o uno con igual probabilidad. Ambas son independientes entre sí y de la carga inicial. Todos estos elementos se fijan como parte del ejemplo.
La asignación y el tiempo, medido en minutos, siguen las ecuaciones
El símbolo indicador vale uno cuando se cumple la condición entre llaves. Con carga baja, la herramienta se utiliza si , por lo que su probabilidad de uso es un quinto. Con carga alta, se utiliza para cuatro de los cinco valores posibles. La política favorece así la automatización cuando la carga es mayor.
La segunda ecuación estipula que la carga alta añade dos minutos y que usar la herramienta resta tres. El término representa una variación adicional de un minuto en cualquiera de las direcciones. No lo interpretamos como un error de medición: en este ejemplo forma parte del tiempo que realmente se produce. Podría ampliarse el modelo con una ecuación de medición si también quisiéramos representar errores del cronómetro.
El modelo es recursivo. Primero se determina la carga; luego se aplica la regla de asignación; finalmente se obtiene el tiempo. Para unos valores dados de las variables externas, las ecuaciones entregan un resultado definido. La aleatoriedad poblacional proviene de cómo varían esas variables entre ejecuciones. Que una función estructural sea determinista cuando sus argumentos están fijados no significa que la población carezca de incertidumbre.
Pearl (2009) representa una intervención mediante la sustitución de la ecuación de la variable sobre la que se actúa. Para imponer el uso de la herramienta, reemplazamos su regla de asignación por . La ecuación del tiempo y la distribución de las condiciones iniciales permanecen como se especificaron. El resultado potencial derivado del modelo es entonces
La diferencia es menos tres para cualquier ejecución. El efecto constante no se descubrió mirando los resultados: lo incorporamos en la ecuación estructural. Si el ahorro dependiera de la carga o de una característica del operador, habría que modificar esa ecuación. La sencillez del ejemplo facilita comprobar operaciones, pero no proporciona evidencia a favor de una homogeneidad semejante en situaciones reales.
Las medias bajo intervención se obtienen conservando la mitad de ejecuciones en cada nivel de carga y la media cero de la variación adicional. El tiempo promedio sería cuatro minutos al imponer la herramienta y siete minutos al imponer el procedimiento habitual. La diferencia causal promedio es, por tanto, menos tres minutos, igual al efecto individual estipulado en este caso particular.
La interpretación estructural agrega contenido a una expresión algebraica. Una regresión puede escribir el tiempo como una combinación de carga, uso y un residuo. Si ese residuo se define simplemente como lo que falta para reproducir el dato, la igualdad se cumple por construcción. Para usarla al intervenir necesitamos justificar que la relación restante conserva su significado cuando se cambia la asignación. La ortogonalidad de un residuo respecto de los predictores en un ajuste no establece por sí misma esa estabilidad.
Tampoco podemos despejar cualquier variable de una ecuación y convertir el despeje en una instrucción causal. De la ecuación del tiempo puede obtenerse una expresión algebraica para la asignación, pero imponer un tiempo mediante alguna acción externa no equivale a ejecutar esa expresión como mecanismo de elección de la herramienta. Las ecuaciones estructurales indican qué variable recibe el valor producido por una función y qué componente se reemplaza al actuar.
Esta distinción puede comprobarse con otro ejemplo mínimo. Sea una asignación binaria que vale cero o uno con igual probabilidad y un resultado observado siempre idéntico a ella. Un primer modelo dice que la asignación es externa y que el resultado copia su valor. Un segundo dice que ambos copian una variable previa no observada, también binaria. Los dos modelos producen exactamente los mismos pares observados: la mitad son cero–cero y la otra mitad uno–uno.
En el primer modelo, imponer la asignación a uno hace que todos los resultados valgan uno; imponerla a cero hace que todos valgan cero. La diferencia causal promedio es uno. En el segundo, reemplazar únicamente la ecuación de asignación deja intacta la variable previa que produce el resultado. Bajo cualquiera de las intervenciones, la probabilidad de resultado uno permanece en un medio y la diferencia causal es cero.
No existe una prueba basada exclusivamente en esa distribución observacional que permita elegir entre los dos mecanismos. Haría falta información que los distinguiera, como un experimento pertinente o conocimiento externo sobre cómo se generan las variables. Una predicción perfecta del resultado a partir de la asignación sería compatible con ambos. El ejemplo separa así la capacidad de reproducir datos de la capacidad de anticipar qué cambiará al actuar sobre una parte del sistema.
Condicionar en lo observado cambia la composición
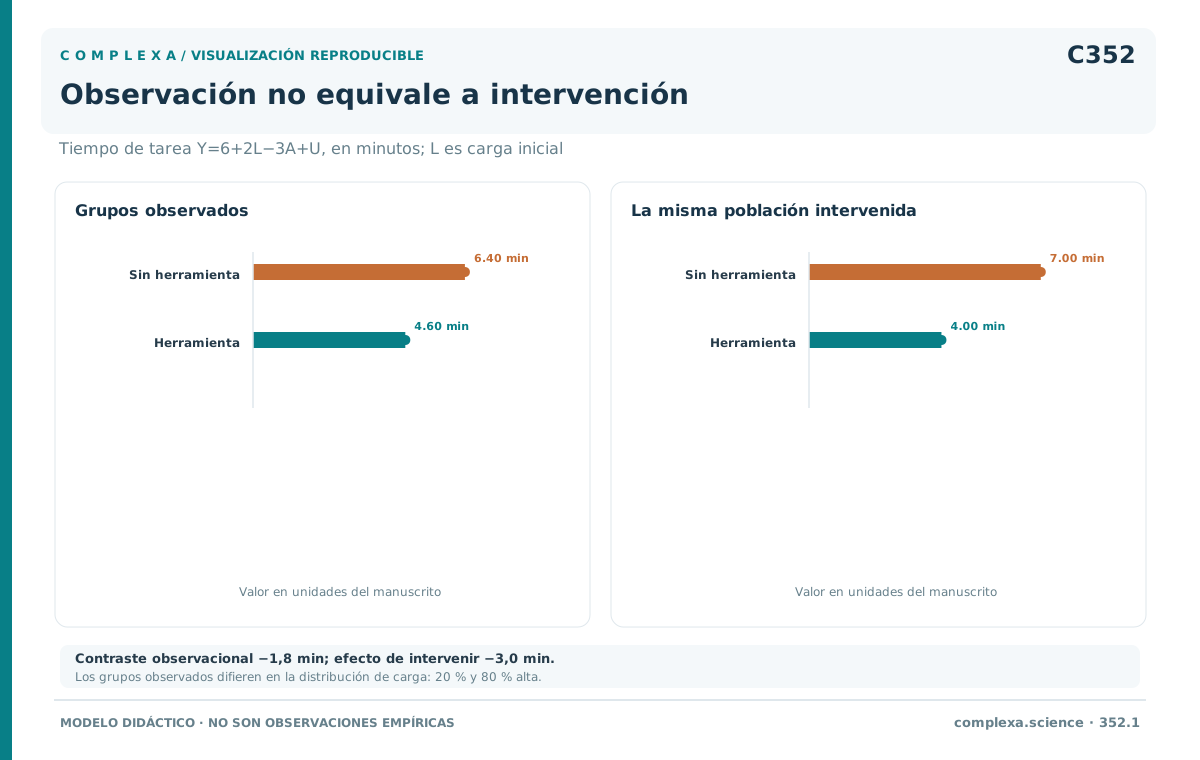
En la práctica observacional del modelo, la mitad de las ejecuciones recibe la herramienta. De ellas, cuatro quintas partes tienen carga alta. Entre las que siguen el procedimiento habitual, solo una quinta parte tiene carga alta. La asignación selecciona composiciones distintas porque depende de la carga inicial.
Para quienes usan la herramienta, la media observada es minutos. Para quienes no la usan, es minutos. La diferencia observacional resulta ser menos 1,8 minutos. El ahorro causal de tres minutos aparece parcialmente contrarrestado por la mayor carga de quienes reciben automatización.
| Comparación | Media con herramienta | Media sin herramienta | Diferencia |
|---|---|---|---|
| Grupos observados bajo la regla de asignación | 4,6 | 6,4 | −1,8 |
| Intervenir sobre la misma población | 4,0 | 7,0 | −3,0 |
La primera fila condiciona en una variable producida por la política de asignación. La segunda reemplaza esa política. En ambos casos los cálculos son correctos; describen operaciones diferentes. La notación retiene las circunstancias bajo las cuales se observó el uso. La notación se refiere al modelo en que el uso se impone mediante la intervención definida.
La diferencia no depende de que los datos sean pequeños o de que se haya elegido un estimador impreciso. Podemos enumerar exactamente las veinte combinaciones posibles de carga, variable de asignación y variación del tiempo, cada una con la misma probabilidad. Incluso con conocimiento perfecto de esa distribución observacional, la diferencia entre grupos seguiría siendo menos 1,8. Aumentar la muestra haría más preciso el cálculo de esa cantidad.
Dentro de cada nivel de carga, en cambio, el mecanismo construido deja la asignación independiente de . La comparación condicional recupera los tres minutos de diferencia. Promediar ambas opciones con la misma composición de carga devuelve cuatro y siete minutos. Esta operación funciona porque hemos especificado un modelo donde la carga es suficiente para eliminar la selección relevante; no constituye una demostración general de que ajustar por la carga observada siempre baste.
Supongamos que un operador experimentado recibe con mayor frecuencia la herramienta y además completa más rápido las tareas, sin que su experiencia esté registrada. Esa modificación introduce otra fuente compartida de variación. En el modelo ampliado, condicionar únicamente en la carga podría dejar una diferencia de experiencia entre opciones. La fórmula de ajuste necesitaría otra justificación y posiblemente información adicional.
Las variables externas de un modelo estructural pueden representar precisamente esos factores no medidos. No tienen que ser independientes por definición. En nuestro ejemplo impusimos independencia para construir un caso sencillo. En otros modelos, su dependencia representa causas comunes ausentes de las variables observadas. Dibujar ecuaciones para cada variable no demuestra que se hayan incluido todas las causas comunes pertinentes.
Reconstruir un resultado de la misma ejecución
Ahora sabemos que una ejecución tuvo carga alta, utilizó la herramienta y terminó en seis minutos. Dentro del modelo estipulado, esos datos implican por lo que su variación externa fue de un minuto. Para preguntar cuánto habría tardado esa misma ejecución sin herramienta, conservamos esa condición externa y cambiamos la asignación a cero. El tiempo contrafactual resulta ser nueve minutos.
La media poblacional sin herramienta era siete. Los nueve minutos no la contradicen: hemos condicionado la pregunta en información particular de una ejecución, incluida su carga y su resultado factual. La media bajo intervención pregunta por toda la población. La reconstrucción individual utiliza un modelo para actualizar lo que sabemos de sus condiciones y resolver la alternativa correspondiente.
Podemos describir el procedimiento como inferir condiciones a partir de los hechos, modificar la ecuación de acción y predecir con el modelo resultante. En el ejemplo, el dato permite recuperar exactamente . En general, varias combinaciones de variables externas pueden ser compatibles con la observación. El resultado sería entonces una distribución de contrafácticos, cuya forma dependería del modelo y de la distribución de esas condiciones.
Si el cronómetro añade un error desconocido, los seis minutos registrados tampoco fijarían exactamente la variación del tiempo real. Habría que distinguir ese error de las condiciones que afectan la ejecución. Una ecuación para el proceso de medición podría conservar varias explicaciones del registro, que se propagarían hasta la respuesta contrafactual.
La inferencia de nueve minutos usa más información estructural que el contraste promedio. Supone que el ahorro es siempre tres, que la ecuación se conserva al cambiar la opción y que la variación recuperada debe mantenerse al comparar los dos escenarios. Un ensayo que mostrara medias de cuatro y siete minutos no demostraría por sí mismo todas esas propiedades.
La diferencia entre ambas tareas se vuelve relevante cuando un programa genera explicaciones individuales. Que pueda calcular «habría tardado nueve minutos» no significa que ese número esté identificado por la evidencia disponible. Puede ser una salida coherente de un modelo entre varios compatibles con los datos. Para evaluar su respaldo hay que revisar qué restricciones distinguen ese modelo de las alternativas.
Tampoco se debe cambiar arbitrariamente el término externo al pasar de un escenario al otro. Si lo sorteáramos otra vez sin aclararlo, estaríamos simulando una ejecución distinta o introduciendo una hipótesis adicional sobre la correspondencia entre escenarios. Conservar un contexto externo en una ecuación estructural es parte de cómo el modelo define el contrafactual individual. La evidencia necesaria para justificar esa correspondencia requiere un examen separado.
Dos poblaciones de efectos con las mismas probabilidades de éxito
Para ver la indeterminación sin depender de una regresión, consideremos un resultado binario de éxito. Suponemos conocidas las probabilidades poblacionales: 0,40 bajo la opción cero y 0,60 bajo la opción uno. El efecto promedio sobre la probabilidad de éxito es 0,20. Hay distintas distribuciones conjuntas de resultados potenciales que producen esas mismas probabilidades.
La tabla siguiente ofrece dos. Cada fila describe un tipo de respuesta individual. Las columnas indican qué proporción de la población pertenece a ese tipo en cada modelo construido.
| Resultado sin opción uno | Resultado con opción uno | Modelo M | Modelo N |
|---|---|---|---|
| Fracaso | Fracaso | 0,40 | 0,00 |
| Fracaso | Éxito | 0,20 | 0,60 |
| Éxito | Fracaso | 0,00 | 0,40 |
| Éxito | Éxito | 0,40 | 0,00 |
En el modelo M, una quinta parte se beneficia y nadie pierde un éxito debido al cambio. El resto conserva su resultado. En el modelo N, tres quintas partes se benefician y dos quintas partes pierden el éxito. Todos cambian, pero sus cambios se compensan parcialmente. Las dos columnas suman uno y producen la misma diferencia promedio de veinte puntos porcentuales.
Si asignáramos la opción al azar, los dos modelos generarían la misma distribución observada de asignación y éxito para una misma probabilidad de asignación. Veríamos éxitos en el cuarenta por ciento del grupo asignado a cero y en el sesenta por ciento del asignado a uno, salvo variación muestral. Ni siquiera un ensayo ilimitadamente grande distinguiría estas distribuciones conjuntas con ese diseño y esas variables solamente.
La diferencia aparece en preguntas que relacionan ambos resultados de la misma unidad. Entre quienes tienen éxito bajo la opción uno, el modelo M atribuye un tercio a personas que habrían fracasado con la opción cero. El modelo N atribuye la totalidad. Las fracciones se obtienen dividiendo, respectivamente, 0,20 y 0,60 por la probabilidad de éxito de 0,60. Si la asignación es aleatoria, esas mismas fracciones describen la distribución contrafactual entre los éxitos observados del grupo asignado a uno.
Podemos expresar también cuánto varían los efectos individuales. En M, la diferencia vale uno para el veinte por ciento y cero para el resto; su varianza es 0,16. En N, vale uno para el sesenta por ciento y menos uno para el resto; su varianza es 0,96. Conocer las dos medias y las dos distribuciones marginales no determina esta variabilidad, porque falta conocer cómo se emparejan los resultados potenciales dentro de las unidades.
La indeterminación puede describirse sin elegir uno de esos extremos. Denotemos por la proporción que tendría éxito bajo ambas opciones. Las probabilidades restantes deben ser para éxito solo bajo cero, para éxito solo bajo uno y para fracaso bajo ambas. Para que ninguna sea negativa, debe estar entre cero y 0,40.
Por consiguiente, la proporción beneficiada puede variar entre 0,20 y 0,60, mientras la perjudicada puede variar entre cero y 0,40. El efecto promedio sigue siendo 0,20 para cualquier valor permitido. Esta familia de distribuciones muestra que un promedio identificado puede convivir con límites amplios para preguntas individuales. Los límites son consecuencia de las probabilidades postuladas y de las reglas de probabilidad, sin atribuirles información que no contienen.
Si añadimos el supuesto de que la opción uno nunca transforma un éxito en fracaso, fijamos en cero la proporción perjudicada. La familia queda reducida al modelo M. El supuesto se denomina monotonicidad en este contexto. No lo hemos comprobado con las probabilidades marginales; lo utilizamos para seleccionar una distribución conjunta compatible. Incluso así, conocer que una quinta parte se beneficia no identifica por nombre a sus integrantes.
Las ecuaciones también pueden conservar esa indeterminación
Los dos modelos binarios anteriores admiten representaciones estructurales sencillas. Sea uniforme en el intervalo entre cero y uno, e independiente de una asignación aleatoria. Para M, definimos éxito bajo cero cuando , y éxito bajo uno cuando . Los intervalos de éxito están anidados: quien tendría éxito bajo cero también lo tendría bajo uno.
Para N, mantenemos el éxito bajo cero cuando , pero definimos el éxito bajo uno cuando . Los intervalos son ahora complementarios, salvo el punto de frontera, que tiene probabilidad cero. Ambas representaciones generan las mismas probabilidades marginales y distintos emparejamientos de resultados individuales.
Podemos construir una única ecuación de resultado para cada modelo seleccionando la función correspondiente según . Cada intervención reemplaza la ecuación de asignación por el valor elegido y deja fija la ecuación de resultado del modelo. Por tanto, escribir un modelo estructural no hace desaparecer la indeterminación que mostraba la tabla. La función concreta elegida incorpora la correspondencia entre los escenarios.
Este ejemplo también evita confundir independencia entre variables externas con independencia entre resultados potenciales. Aunque la asignación aleatoria sea independiente de , ambos resultados potenciales dependen del mismo . En M están positivamente asociados; en N, negativamente. La independencia del mecanismo de asignación respecto de las respuestas no determina la asociación entre las respuestas hipotéticas de una misma unidad.
La misma precaución vale al comparar cuantiles. Saber cómo cambia un percentil de la distribución bajo intervención describe una diferencia entre dos distribuciones marginales. No identifica necesariamente el percentil de la distribución de efectos individuales. Una correspondencia entre posiciones relativas de las unidades bajo las dos opciones sería otra restricción del modelo, que requiere una justificación propia.
Introducir características observadas de las unidades puede estrechar la incertidumbre, pero no la elimina por definición. Podemos repetir la comparación dentro de grupos definidos por esas características y conocer, para cada grupo, las probabilidades bajo ambas opciones. Mientras varias distribuciones conjuntas sigan produciendo las mismas probabilidades condicionales, permanecerán varias distribuciones de efectos individuales compatibles con la información.
En particular, un promedio condicional debe conservar su nombre. La diferencia promedio para personas con cierto perfil no es necesariamente el efecto exacto de cada persona que comparte ese perfil. Las variables disponibles pueden dejar heterogeneidad sin representar. Que un programa devuelva una cifra específica para cada fila de una base puede reflejar que evalúa una función condicional en los valores de esa fila; la forma de presentación no convierte el objetivo estadístico en un efecto individual identificado.
La tabla de M y N permite comprobarlo incluso antes de añadir ruido de estimación. Si no se dispone de variables que distingan sus tipos de respuesta, ambos modelos generan los mismos perfiles observables y el mismo efecto promedio. Un algoritmo con acceso ilimitado a esos datos no puede resolver una diferencia que la distribución disponible no contiene. La información adicional tendría que restringir los mecanismos o aportar observaciones que fueran distintas bajo las alternativas.
Qué conexiones son automáticas y cuáles se suponen
En nuestros modelos recursivos, sustituir ecuaciones define resultados potenciales y garantiza la consistencia con el mundo observado. También garantiza relaciones de compatibilidad entre intervenciones sobre varias variables. Si una intervención ya hace que una variable tome cierto valor, imponer además ese mismo valor conserva la solución dentro de este tipo de modelo. La relación depende de que se mantengan los mecanismos restantes y exista una solución definida.
Un conjunto de variables potenciales formulado de manera abstracta necesita expresar las restricciones pertinentes. Introducir símbolos para varias intervenciones no asegura que todas sus combinaciones puedan generarse mediante el mismo sistema de ecuaciones. Ibeling e Icard (2023) estudian condiciones precisas para esa representabilidad y muestran por qué la equivalencia irrestricta entre ambos marcos es demasiado amplia. Su análisis distingue representar directamente un modelo de obtenerlo como una abstracción de otro.
Esa diferencia importa al cambiar de nivel de descripción. Una categoría amplia puede agrupar estados que responden de forma distinta a una intervención. Las relaciones entre categorías agregadas pueden perder propiedades que existían en una descripción más detallada. Para usar conjuntamente resultados potenciales y ecuaciones hay que comprobar que las intervenciones representadas correspondan a las mismas operaciones y al mismo nivel de variables.
También existen representaciones que conectan grafos y resultados potenciales sin introducir de inmediato todas las relaciones entre escenarios alternativos. Los grafos de intervención de un solo mundo de Richardson y Robins (2013) representan variables contrafactuales asociadas con una intervención específica y permiten expresar independencias pertinentes para esa intervención. No deben leerse como una identificación automática de la distribución conjunta de resultados de mundos incompatibles. El tipo de distribución representada sigue importando.
Para el modelo de tiempos, una representación de un mundo con permite organizar las relaciones entre carga y tiempo bajo esa intervención. Comparar esa distribución con la del mundo con informa el efecto promedio. La pregunta sobre nueve minutos para una ejecución particular añade una vinculación entre su resultado factual y su respuesta alternativa. Esa vinculación estaba contenida en nuestra ecuación de ahorro constante.
Usar el modelo sin perder la pregunta original
La utilidad de una formalización se aprecia al comprobar qué información exige. Para estudiar el efecto promedio de la herramienta, el modelo construido requiere medir la carga antes de la asignación si se utiliza la comparación observacional. Registrar carga después de comenzar podría representar una variable distinta, modificada por la propia herramienta. En tal caso, la cuenta de composición que hicimos dejaría de corresponder al proceso descrito.
Si el ahorro puede variar entre operadores, una ecuación con un único coeficiente de menos tres impone una homogeneidad que los datos podrían no sostener. Un modelo más flexible puede permitir interacciones o variación individual. Esa flexibilidad aumenta las respuestas representables, pero no crea información sobre emparejamientos contrafactuales que el diseño nunca observa. Ajustar mejor las distribuciones marginales y conocer mejor efectos individuales son logros diferentes.
La estructura temporal requiere atención semejante. Un efecto sobre experiencia adquirida puede modificar resultados de tareas futuras. Entonces la unidad de intervención podría ser una secuencia de uso y el resultado depender de la historia. Repetir una prueba bajo ambas opciones necesitaría especificar el orden y considerar arrastre o aprendizaje. El par de resultados de una tarea aislada no responde por sí mismo al efecto de mantener la herramienta durante meses.
Finalmente, el carácter recursivo facilitó resolver cada intervención en un orden definido. Sistemas con retroalimentación instantánea o formulados mediante equilibrios requieren condiciones adicionales para determinar qué solución se alcanza. Si una intervención admite varios equilibrios, reemplazar una ecuación sin establecer una regla de selección puede dejar el contrafactual sin un valor único. Una representación temporal más detallada puede aclarar el mecanismo, aunque cambie el objeto que se está modelando.
En la ejecución de seis minutos, el cálculo de nueve bajo la alternativa permanece correcto dentro del modelo escrito. Para presentarlo como una conclusión empírica habría que respaldar el mecanismo de ahorro constante y la conservación de las condiciones que usamos. Si solo contamos con las medias poblacionales, podemos informar el contraste correspondiente. La tabla binaria conserva a la vista lo que esas medias dejan abierto: varias poblaciones de respuestas individuales pueden seguir siendo compatibles con ellas.
Referencias
Holland, P. W. (1986). Statistics and causal inference. Journal of the American Statistical Association, 81(396), 945–960. https://doi.org/10.1080/01621459.1986.10478354
Ibeling, D., & Icard, T. (2023). Comparing causal frameworks: Potential outcomes, structural models, graphs, and abstractions. Advances in Neural Information Processing Systems, 36. https://papers.nips.cc/paper_files/paper/2023/hash/fd83f4e0dcaf1c64ea15bbb1695bb40f-Abstract-Conference.html
Pearl, J. (2009). Causal inference in statistics: An overview. Statistics Surveys, 3, 96–146. https://doi.org/10.1214/09-SS057
Richardson, T. S., & Robins, J. M. (2013). Single world intervention graphs (SWIGs): A unification of the counterfactual and graphical approaches to causality (Working Paper 128). Center for Statistics and the Social Sciences, University of Washington. https://csss.uw.edu/files/working-papers/2013/wp128.pdf
Rubin, D. B. (1974). Estimating causal effects of treatments in randomized and nonrandomized studies. Journal of Educational Psychology, 66(5), 688–701. https://doi.org/10.1037/h0037350
VanderWeele, T. J., & Hernán, M. A. (2013). Causal inference under multiple versions of treatment. Journal of Causal Inference, 1(1), 1–20. https://doi.org/10.1515/jci-2012-0002