Una base de datos permite añadir al modelo la gravedad inicial, los controles posteriores, la adherencia y el número de consultas. Todas parecen variables pertinentes para estudiar un tratamiento. Sin embargo, incorporarlas juntas puede alejar la estimación del efecto buscado. La gravedad previa interviene en la decisión de tratar; una consulta posterior puede ocurrir precisamente porque hubo mejoría o porque apareció una complicación. Sus posiciones en el proceso son diferentes aunque ambas columnas predigan bien el desenlace.
Un grafo causal obliga a describir esas posiciones antes de elegir el ajuste. Sus flechas expresan relaciones que el investigador considera posibles dentro de una representación determinada. Las flechas ausentes también comprometen: excluyen relaciones directas que podrían alterar el razonamiento. El trabajo consiste en examinar qué comparaciones permitiría esa representación y qué conocimientos hacen defendible cada exclusión. Una base de datos extensa no decide por sí misma qué flechas deben dibujarse.
Los ejemplos que siguen son construidos. Sus números sirven para comprobar operaciones de separación y ajuste; no representan resultados clínicos ni efectos de una intervención real. El mismo conjunto de variables se mantendrá a través de varios cálculos para mostrar qué cambia cuando se modifica el análisis.
Qué afirma una flecha
En un grafo dirigido, los nodos representan variables y las flechas tienen orientación. La expresión indica que puede intervenir directamente en el mecanismo que determina , dentro de las variables que hemos decidido representar. «Directamente» depende de esa resolución. Si después se introduce una variable intermedia, la relación puede describirse mediante dos flechas y desaparecer la conexión directa original. Cambiar la resolución exige revisar el significado de los nodos, no solamente la apariencia del dibujo.
Un grafo dirigido acíclico, o DAG, carece de recorridos dirigidos que regresen al punto de partida. Esta propiedad permite ordenar sus nodos de modo que cada causa representada preceda a sus consecuencias. No exige que la vida carezca de retroalimentación. Una intervención de hoy puede cambiar un estado de mañana que, a su vez, modifique la intervención posterior. Al distinguir , y , ese proceso puede desplegarse en un grafo acíclico. Representarlo con dos variables sin fecha y flechas en ambos sentidos requeriría otro marco formal.
La flecha tampoco fija la magnitud, el signo o la forma funcional del efecto. Puede representar una relación no lineal, una interacción o un efecto que solo aparece en ciertas circunstancias. Una línea dibujada junto a otra no implica contribuciones aditivas. Para calcular un efecto harán falta especificaciones adicionales; para determinar si una ruta puede transmitir asociación suelen bastar las relaciones de parentesco del grafo.
Los padres de un nodo son las variables con flechas que llegan directamente a él. Sus descendientes se alcanzan siguiendo una o más flechas hacia adelante. Una ruta, en cambio, puede recorrer conexiones sin respetar su orientación. Esta diferencia entre ruta y recorrido dirigido evita un error frecuente: buscar únicamente caminos de causa a consecuencia al estudiar confusión. La ruta comunica estadísticamente a con aunque ninguna flecha conduzca desde hasta por ese trayecto.
Para interpretar causalmente el DAG se necesita que represente adecuadamente las dependencias relevantes del proceso y las causas comunes pertinentes. Una variable omitida que causa dos nodos puede cambiar las conclusiones sobre ajuste. Cuando se reconocen causas comunes no observadas, pueden incorporarse explícitamente como nodos latentes. Existen representaciones con aristas bidirigidas para resumir algunas de esas situaciones, pero no deben confundirse con un DAG de variables observadas sin confusión oculta (Pearl, 1995).
Tres configuraciones locales y una regla para las rutas
La d-separación examina las posiciones de los nodos internos de cada ruta. En una cadena como , el nodo intermedio es un no colisionador. Condicionar en él bloquea esa ruta. La misma regla se aplica a una bifurcación como : fijar el valor de la causa común bloquea ese trayecto. «Condicionar» puede corresponder a estratificar, seleccionar valores o trabajar con una distribución condicional; su traducción a una estimación concreta requiere cuidado posterior.
La configuración funciona de otra manera. Las dos puntas de flecha se encuentran en , que es un colisionador en esa ruta. Sin condicionar en él ni en alguno de sus descendientes, la ruta queda bloqueada. Condicionar en el colisionador, o en un descendiente suyo, puede abrirla. La clasificación corresponde a la posición del nodo en una ruta particular. Un mismo nodo puede ser colisionador en un recorrido y no colisionador en otro.
Un ejemplo algebraico muestra por qué puede aparecer esa asociación. Sean , y variables normales independientes, con media cero y varianza uno. Definimos . Antes de conocer , saber no informa sobre . Una vez fijada la suma ruidosa, un valor mayor de uno de sus componentes hace más probable que el otro sea menor. La covarianza condicional es
La dependencia negativa no existía en la población sin condicionar. Tampoco prueba que cause . La hemos producido al restringir la comparación a un resultado común. En este ejemplo la normalidad permite expresar la dependencia mediante una covarianza condicional constante; el mecanismo gráfico no se limita a variables normales. La introducción epidemiológica de Greenland, Pearl y Robins (1999) y el desarrollo de Shrier y Platt (2008) muestran por qué las reglas basadas solamente en asociaciones observadas pueden seleccionar variables de ajuste inadecuadas.
Para decidir si una ruta está abierta se revisan todos sus nodos internos. Cada no colisionador debe quedar fuera del conjunto condicionado, y cada colisionador debe tenerse a sí mismo o a un descendiente dentro de ese conjunto. Si falla cualquiera de esas condiciones, la ruta está cerrada. Dos conjuntos de variables están d-separados por un tercero cuando todas las rutas entre ambos quedan bloqueadas. No basta encontrar una ruta cerrada si otra permanece abierta.
Esta regla impide tratar el número de variables incluidas como una medida de protección. Añadir una covariable puede cerrar una ruta y abrir otra. Incluso puede abrir una ruta en un punto y volver a bloquearla en otro. La decisión se toma para el conjunto completo, con las posiciones causales especificadas.
Que una variable preceda al tratamiento tampoco garantiza que convenga ajustarla. Consideremos una estructura adicional, distinta del ejemplo principal: una característica recibe influencia de dos condiciones previas independientes, y . La primera influye en el tratamiento y la segunda en el resultado. La ruta es . Sin ajustar por , queda cerrada en ese colisionador. Fijar puede abrirla, aunque su medición ocurriera antes de decidir el tratamiento.
El error de una regla exclusivamente cronológica sería confundir la ausencia de influencia del tratamiento sobre una covariable con la ausencia de otros mecanismos problemáticos. La cronología descarta ciertas flechas, pero todavía hay que examinar las que permanecen. En esta estructura, la distribución de recoge información sobre las dos condiciones que la producen. Al comparar sujetos con el mismo valor de , conocer una de esas condiciones modifica lo que puede esperarse de la otra y conecta sus respectivas consecuencias.
Si además hubiera una flecha directa desde al tratamiento y otra hacia el resultado, el análisis tendría que considerar las nuevas rutas. Podrían coexistir una razón para ajustar y otra fuente de sesgo inducida por el ajuste. El problema ya no se resolvería con la etiqueta única de «confusor» o «colisionador» aplicada a toda la variable. Habría que recorrer las rutas del grafo modificado y preguntar qué conjunto disponible permite bloquear las asociaciones no causales sin eliminar el efecto de interés.
De la separación gráfica a una independencia
La propiedad de Markov conecta el dibujo con una distribución de probabilidad. En un DAG apropiado, la distribución conjunta puede factorizarse como el producto de las distribuciones de cada nodo condicionadas en sus padres. Bajo esa propiedad, una d-separación implica la independencia condicional correspondiente. La conclusión es relativa al modelo representado, no una garantía obtenida por dibujar flechas con suficiente seguridad.
La dirección inversa requiere un supuesto adicional. Una independencia observada en la distribución no obliga, por la propiedad de Markov solamente, a que exista la separación gráfica. Puede resultar de una cancelación entre mecanismos. La fidelidad excluye esas independencias adicionales. Esta distinción se vuelve especialmente relevante cuando se pretende aprender flechas a partir de pruebas de independencia, pero también ayuda a interpretar la comprobación de un DAG ya propuesto (Uhler et al., 2013).
Consideremos otro ejemplo normal con perturbaciones independientes: y , donde tiene varianza uno. El grafo contiene , y . Al sustituir la primera ecuación en la segunda se obtiene . Por tanto, e son independientes aunque estén conectados en el grafo. El efecto por la vía mediada y el efecto por la vía directa se cancelan exactamente con estos coeficientes.
La cancelación no autoriza a borrar una de las relaciones estructurales: cada una tiene un papel que podría aparecer al modificar las otras condiciones. Tampoco convierte la falta de significación de una correlación muestral en prueba de independencia. Una muestra pequeña puede ser compatible con un rango amplio de dependencias. La fidelidad fuerte añade restricciones que mantienen determinadas correlaciones parciales alejadas de cero; sus dificultades estadísticas son distintas de la posibilidad matemática de una cancelación exacta.
Una implicación contrastable del grafo puede ayudar a descubrir una representación incompatible con los datos, pero superar esas comprobaciones no lo demuestra verdadero. Algunos grafos diferentes implican las mismas independencias. Además, las pruebas usadas para examinarlas pueden tener poca potencia o suponer formas funcionales incorrectas. La información temporal y el conocimiento del proceso siguen siendo necesarios cuando las distribuciones observacionales no distinguen orientaciones.
Por ejemplo, las estructuras , y comparten, con las condiciones habituales, la independencia entre los extremos al condicionar en el nodo intermedio. Sin embargo, sus interpretaciones causales difieren: en la primera, transmite el efecto de ; en la segunda, es una causa común; en la tercera, la dirección causal conduce desde hacia . La misma instrucción estadística, condicionar en , puede bloquear una vía causal o una ruta de confusión según cuál sea la estructura defendible.
La cronología puede descartar algunas orientaciones. Si fue determinado antes de que existiera , una flecha desde ese hacia aquel carece de la interpretación temporal ordinaria. Pero el momento de registrar una variable no siempre coincide con el momento del fenómeno que representa. Una encuesta realizada después del tratamiento puede preguntar por una condición anterior. En ese caso hay que distinguir la condición recordada del proceso posterior que produce la respuesta, porque el tratamiento podría influir en el recuerdo o en la disposición a comunicarlo.
Un grafo completo para elegir el ajuste
Construyamos ahora un sistema con tratamiento , resultado , gravedad previa , respuesta intermedia , una característica previa , un registro posterior y una variable producida a partir de ese registro. Los nombres son ayudas de lectura; las relaciones exactas del ejemplo son
No hay otras flechas ni causas comunes ocultas en el modelo construido. Buscamos el efecto total de intervenir sobre y dejar que sus consecuencias evolucionen según estos mecanismos. Esa definición conserva la contribución de : impedir que el mediador cambie correspondería a otra intervención.
Hay cuatro rutas simples entre e . Dos son causales: la flecha directa y el recorrido a través de . La ruta por empieza entrando a y permanece abierta mientras no se condicione en la causa común. La ruta por y está inicialmente cerrada porque es un colisionador. El nodo no crea una quinta ruta simple hacia ; su relevancia procede de ser descendiente del colisionador.
Ajustar por bloquea la ruta de confusión sin modificar las dos vías causales. Añadir mantiene un conjunto válido. En cambio, añadir a abre la ruta que antes estaba cerrada y deja a libre para comunicar asociación con el resultado. Añadir también puede abrirla, porque el condicionamiento alcanza a un descendiente de . Los datos posteriores no tienen que coincidir con el colisionador para afectar la selección.
Ajustar por y bloquea la confusión, pero también interrumpe una vía que forma parte del efecto total. Ese ajuste cambia la comparación. Obtener un coeficiente preciso después de incluir no resuelve la diferencia entre el objetivo planteado y la cantidad estimada. La interpretación de un efecto directo requiere, además, sus propias condiciones; no se obtiene universalmente al añadir un mediador a una regresión.
El criterio de puerta trasera y su alcance
Para un tratamiento y un resultado individuales, el criterio clásico de puerta trasera ofrece una condición suficiente para ajustar: el conjunto no debe contener descendientes del tratamiento y debe bloquear todas las rutas que empiezan con una flecha dirigida hacia el tratamiento. En nuestro grafo, y cumplen ambas condiciones. El criterio permite justificar una fórmula a partir del grafo, en lugar de elegir controles según cuánto cambia un coeficiente (Pearl, 1995).
Conviene distinguir dos operaciones sobre flechas. Una intervención ideal que fija sustituye su mecanismo de asignación y elimina las flechas que entraban en . Para comprobar el criterio simple de puerta trasera puede examinarse, en cambio, la separación entre e después de eliminar las flechas que salen de , junto con la prohibición de descendientes. Confundir ambas operaciones lleva a borrar precisamente las rutas que se pretendía investigar.
El criterio simple no caracteriza todas las posibilidades de ajuste. En el grafo construido, es un conjunto válido para el efecto total aunque contenga al descendiente . Condicionar en abre la ruta del colisionador, pero condicionar simultáneamente en vuelve a bloquearla. Además, está fuera de las rutas causales de a y no desciende de un nodo intermedio de esas rutas. Por eso este caso requiere un criterio más general que la regla simple.
Perković et al. (2018) desarrollan una caracterización completa del ajuste para varias clases de grafos. En nuestro DAG basta comprobar que el conjunto evita los descendientes prohibidos de nodos situados en las rutas causales propias y bloquea todas las rutas no causales pertinentes. El ejemplo con ilustra por qué una condición suficiente más restrictiva no debe presentarse como una prohibición universal. No ofrece una licencia general para ajustar por variables posteriores: su validez depende de las relaciones particulares que acabamos de especificar.
La ausencia de un conjunto que cumpla puerta trasera tampoco demuestra que el efecto sea imposible de identificar. Pueden existir otras fórmulas y otras fuentes de información. Antes de concluir que falta identificación hay que precisar qué clase de procedimiento se ha descartado. Aquí estamos comparando conjuntos de ajuste para una distribución definida bajo intervención, dentro de un modelo causal explícito.
Los coeficientes permiten comprobar el razonamiento
Asignemos ecuaciones al mismo grafo. Todas las perturbaciones que aparecen a continuación, así como y , son normales independientes con media cero y varianza uno:
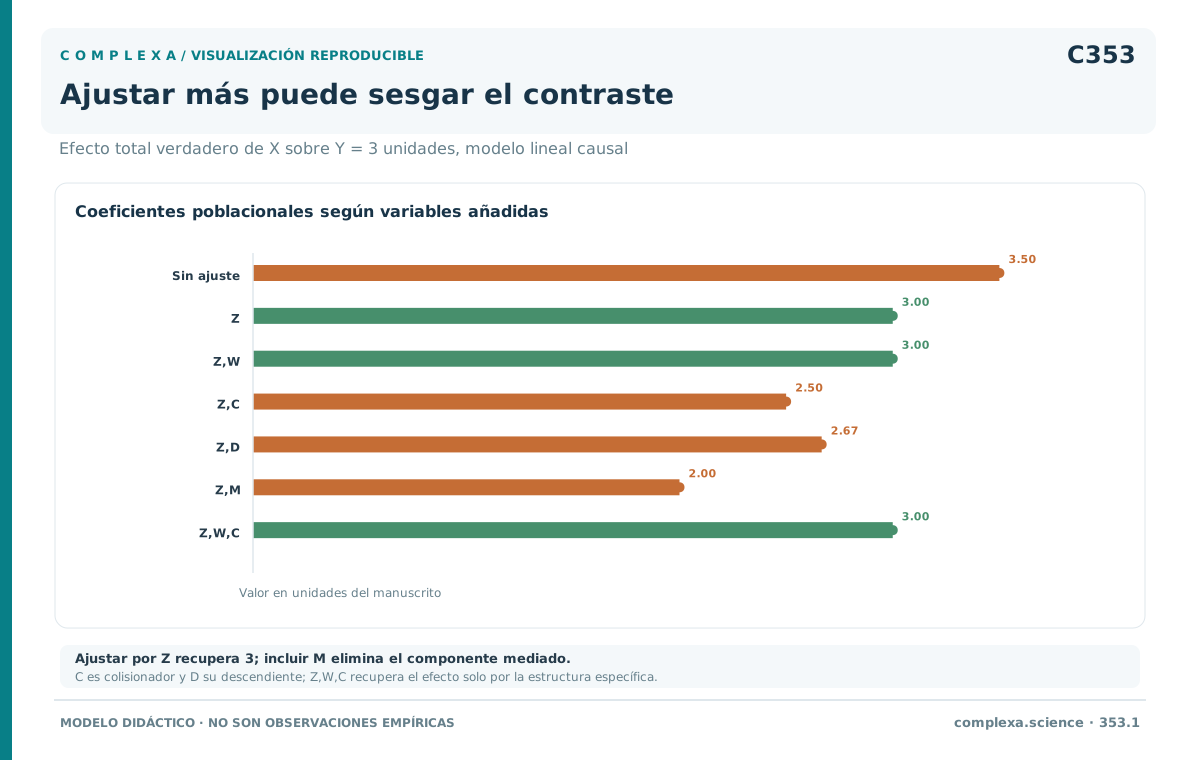
Al intervenir sobre , una unidad adicional contribuye dos unidades por la flecha directa y una a través de . El efecto total sobre la media de es tres. Las variables y mantienen sus distribuciones, mientras que el mediador responde a la intervención. Esta cuenta describe el sistema generador y puede compararse con los coeficientes que produciría cada regresión poblacional.
La regresión de solamente sobre tiene coeficiente . Para verlo, sustituimos y obtenemos . La varianza de es dos y su covarianza con es uno. El cociente entre covarianza y varianza añade medio punto al efecto total. Ese exceso corresponde a la ruta compartida por .
Al incorporar , el coeficiente de pasa a tres. Si incorporamos también , baja a . Dentro de un valor fijo de , el residuo de es , mientras que el residuo de es . Mantener ese registro constante hace que los cambios en se acompañen de información sobre , que también determina . El coeficiente ya mezcla esa asociación inducida con el efecto causal.
| Variables adicionales a | Coeficiente poblacional de | Lectura para el efecto total buscado |
|---|---|---|
| Ninguna | Persiste la ruta de confusión por | |
| Ajuste válido en el modelo | ||
| Ajuste válido en el modelo | ||
| Se abre la ruta del colisionador | ||
| Se condiciona en un descendiente del colisionador | ||
| Se elimina la contribución mediada | ||
| bloquea la ruta abierta al condicionar en |
Estas son cantidades poblacionales exactas, no resultados de una muestra simulada. Una simulación finita oscilaría alrededor de ellas. Su comparación permite comprobar la dirección de los cambios sin atribuir cada discrepancia al azar. También muestra que el ajuste inválido no necesariamente produce un resultado extravagante: puede parecer cercano a tres y seguir respondiendo de manera incorrecta al objetivo establecido.
La fila con admite una interpretación sencilla aquí porque las ecuaciones son lineales y no incluyen causas comunes ocultas entre mediador y resultado. El coeficiente dos coincide con la contribución directa del modelo. Esa coincidencia no convierte el procedimiento en una receta general para mediación. Una causa no medida de e , o interacciones no representadas, modificaría el argumento.
Ajustar también exige elegir cómo promediar
Cuando satisface las condiciones causales y hay soporte suficiente, una fórmula de ajuste para un tratamiento discreto es
La distribución de que aparece al final corresponde a la población objetivo representada. Las distribuciones de gravedad entre personas tratadas y no tratadas pueden ser diferentes; utilizar cada una por separado devolvería la comparación observacional original. La estandarización coloca las dos condiciones de tratamiento sobre una misma composición de población.
Consideremos una población didáctica donde la mitad tiene y la otra mitad . La probabilidad de recibir tratamiento es veinte por ciento en el primer estrato y ochenta por ciento en el segundo. El evento es adverso. Las probabilidades condicionales del evento son las siguientes:
| Estrato previo | Sin tratamiento | Con tratamiento |
|---|---|---|
| 0,10 | 0,05 | |
| 0,60 | 0,30 |
Con esas asignaciones, el ochenta por ciento de los tratados pertenece al estrato de mayor riesgo, mientras que solo el veinte por ciento de los no tratados pertenece a él. El riesgo observado entre tratados es . Entre no tratados es . La diferencia cruda sugiere cinco puntos porcentuales más de eventos con tratamiento.
Al estandarizar ambas condiciones a la mitad de personas en cada estrato, los riesgos son con tratamiento y sin él. La diferencia es menos diecisiete coma cinco puntos porcentuales y la razón de riesgos es un medio. El cambio de signo surge de las composiciones distintas, no de una contradicción aritmética. Para leer la comparación estandarizada como causal sigue siendo necesario que el modelo causal y las condiciones de la fórmula sean adecuados.
La positividad es una condición adicional: cada opción comparada debe tener probabilidad positiva en los estratos que reciben peso. Si todas las personas del estrato grave fueran tratadas, su riesgo sin tratamiento no podría recuperarse directamente de ese registro. La separación gráfica podría seguir siendo correcta, pero faltaría información observacional para evaluar la fórmula. Una regresión extrapolaría hacia esa celda mediante sus supuestos funcionales; no haría aparecer personas comparables que nunca fueron observadas.
Con variables continuas, la suma se sustituye por una integral y el soporte requiere una formulación acorde con densidades y vecindades. Tampoco basta introducir linealmente si la respuesta depende de ella de otro modo. El grafo ayuda a elegir qué condicionar; la especificación y el ajuste estadístico determinan cómo se estiman las distribuciones necesarias.
Un cambio de coeficiente no diagnostica confusión
El ejemplo binario anterior tenía una asignación diferente según gravedad. Podemos construir otra población donde el tratamiento se asigne independientemente de , con probabilidad de un medio en ambos estratos. Ahora no hay flecha de hacia , aunque siga modificando el riesgo del resultado. Esa modificación del grafo elimina la ruta de confusión correspondiente. Aun así, algunos coeficientes pueden cambiar al incorporar al análisis.
Sean los riesgos sin tratamiento y en los dos estratos. Fijemos una razón de momios igual a dos dentro de cada uno. Los momios son la probabilidad del evento dividida por la probabilidad de que no ocurra. En el primer estrato, pasar de momios a produce un riesgo tratado de . En el segundo, pasar de momios uno a dos produce un riesgo de . Estas probabilidades fueron elegidas para el cálculo y no describen un tratamiento real.
Con la mitad de personas en cada estrato, el riesgo marginal sin tratamiento es y con tratamiento es . La razón de momios marginal resulta
La comparación dentro de cada estrato vale dos, mientras que la comparación marginal vale aproximadamente uno coma setenta y dos. Ambas se calcularon en una población sin confusión por . La diferencia corresponde a la no colapsabilidad de esa medida, estudiada por Greenland, Robins y Pearl (1999). No es evidencia de una ruta causal omitida ni demuestra que la versión marginal esté sesgada para su propio objetivo.
Si ajustamos una regresión logística correcta con tratamiento y estrato, su coeficiente de tratamiento expresa el logaritmo de dos. Si ajustamos la comparación marginal, el coeficiente expresa el logaritmo de la otra razón. Para estimar riesgos poblacionales desde el modelo ajustado debemos obtener las probabilidades predichas bajo cada opción y promediarlas sobre la misma población. Comparar directamente los dos coeficientes logísticos mezcla cantidades distintas.
Esta distinción afecta la selección automática de covariables. Una regla que incluya cualquier variable capaz de modificar el coeficiente puede incorporar predictores del resultado que no eran confusores. También puede descartar una causa común relevante cuando su contribución numérica es pequeña en una muestra particular. El grafo aporta la justificación causal de la comparación; el cálculo de la medida aclara qué parámetro cambia entre los modelos. Ambos análisis deben conservarse separados al interpretar una tabla de resultados ajustados.
El mismo problema aparece cuando se informa un «efecto ajustado» sin decir si representa un contraste dentro de estratos o un promedio poblacional. En presencia de heterogeneidad, incluso una medida colapsable necesita especificar qué pesos reciben los estratos. Un estudio centrado en la población tratada y otro centrado en toda la población pueden tener objetivos diferentes con el mismo conjunto de ajuste. La etiqueta de la covariable no determina esos pesos.
Medir una variable no equivale a disponer de ella
Supongamos que la gravedad verdadera no se registra y solo se dispone de una escala ruidosa . El grafo incluye entonces , además de las flechas desde hacia tratamiento y resultado. Condicionar en no bloquea gráficamente la ruta , porque la medición no está situada sobre esa ruta. Puede aportar información útil sobre la causa común y reducir confusión en algunos modelos, pero no garantiza su eliminación.
Podemos cuantificarlo en el sistema lineal anterior. Si , donde el nuevo error es independiente de todas las variables exógenas y tiene varianza uno, la regresión poblacional sobre y produce un coeficiente de tratamiento de . Está entre el valor crudo y el efecto total tres. En general, si la varianza del error de medida es , el coeficiente es . El exceso desaparece cuando la medición es exacta y se aproxima al exceso crudo cuando el error domina.
La cuenta demuestra una reducción parcial para este modelo concreto. Un error que dependa del tratamiento o del resultado no tendría necesariamente esa dirección. Tampoco basta reemplazar por el promedio de muchas preguntas si todas comparten un componente de error. La descripción del instrumento debe aclarar qué parte de la causa común permanece sin medir; de lo contrario, la palabra «ajustado» ocultará que el mecanismo causal relevante solo fue observado parcialmente.
El problema se vuelve menos visible cuando la columna conserva el nombre «gravedad». Ese nombre puede hacer olvidar que el dato es una operación de medida con error, cobertura parcial o momento de aplicación diferente. Un cuestionario posterior al inicio del tratamiento tampoco sustituye automáticamente al estado previo, aunque ambos se expresen en la misma escala. Si el tratamiento ya cambió las respuestas, la variable medida ocupa otra posición en el grafo.
La selección merece una representación igualmente explícita. Si solo analizamos registros con por encima de un umbral, hemos condicionado en información del colisionador aunque no añadamos la columna a la regresión. La ruta puede abrirse durante la construcción de la muestra. Eliminar después esa variable del modelo estadístico no revierte la selección realizada. Debe examinarse qué información se conserva sobre quienes quedaron fuera y qué objetivo poblacional sigue siendo defendible.
En una aplicación clínica hipotética, el número de visitas posteriores podría depender de la intervención y de dificultades que también influyen en el resultado. Esa descripción hace plausible una estructura de colisión, pero no demuestra que sea la adecuada para un servicio real. Algunas visitas preceden a la intervención, otras son parte de ella y otras ocurren después del desenlace. Agruparlas en un único contador puede borrar el orden que necesita el argumento causal.
Conjuntos mínimos, comprobaciones y decisiones documentadas
Un conjunto suficiente mínimo deja de ser suficiente cuando se elimina cualquiera de sus miembros. «Mínimo» no significa que produzca siempre la menor varianza ni que sea el único conjunto defendible. En el ejemplo, es suficiente y mínimo; también es suficiente, pero incluye una variable adicional. Su utilidad estadística depende de la relación con el resultado, la calidad de medida y el método de estimación, además de su admisibilidad causal.
Si hay varios conjuntos válidos, la elección puede considerar disponibilidad, precisión y soporte. Una variable difícil de medir quizá introduzca más error práctico que otra alternativa. Un conjunto muy grande puede fragmentar la muestra en estratos casi vacíos. Estas consideraciones se aplican después de establecer qué conjuntos son causalmente admisibles; una ganancia aparente de precisión no corrige una ruta que quedó abierta.
El software puede enumerar rutas y conjuntos de ajuste, además de derivar independencias contrastables. DAGitty incorpora estas operaciones y permite estudiar la robustez de algunas conclusiones frente a representaciones alternativas (Textor et al., 2016). El programa trabaja con el grafo introducido. Si se omite una causa común o se orienta una flecha por comodidad, la respuesta puede ser formalmente correcta para ese archivo y poco pertinente para el fenómeno.
La revisión de un análisis puede conservar dos versiones del DAG cuando existe desacuerdo sustantivo. En una, una medición precede a la decisión terapéutica; en otra, recibe ya su influencia. Se calcula el ajuste válido en cada versión y se identifica qué diferencia causal hace cambiar la conclusión. Documentar ese punto permite orientar la recogida de datos o buscar antecedentes temporales, en lugar de resolver la disputa mediante el valor p de una columna.
Para el sistema trabajado, una decisión razonada conserva como ajuste suficiente para el efecto total, utiliza si hay razones estadísticas y de medición para incorporarlo, y deja , y fuera de la especificación principal. El conjunto ampliado sirve como demostración matemática de que el criterio simple es restrictivo; su validez depende de conocer bien relaciones posteriores que aquí fueron fijadas por construcción. Con datos reales habría que justificar esas relaciones antes de adoptar esa alternativa.
El registro de la decisión puede terminar con una afirmación verificable: la comparación principal estandariza los riesgos de ambos tratamientos sobre la misma distribución previa de ; la ruta por gravedad queda bloqueada, la vía por permanece como parte del efecto y la muestra no se restringe mediante ni . Si posteriormente se descubre que la selección utilizó uno de esos registros, habrá cambiado una condición concreta de la estimación y será necesario revisar esa comparación.
Referencias
Greenland, S., Pearl, J., & Robins, J. M. (1999). Causal diagrams for epidemiologic research. Epidemiology, 10(1), 37–48. https://doi.org/10.1097/00001648-199901000-00008
Greenland, S., Robins, J. M., & Pearl, J. (1999). Confounding and collapsibility in causal inference. Statistical Science, 14(1), 29–46. https://doi.org/10.1214/ss/1009211805
Pearl, J. (1995). Causal diagrams for empirical research. Biometrika, 82(4), 669–688. https://doi.org/10.1093/biomet/82.4.669
Perković, E., Textor, J., Kalisch, M., & Maathuis, M. H. (2018). Complete graphical characterization and construction of adjustment sets in Markov equivalence classes of ancestral graphs. Journal of Machine Learning Research, 18(220), 1–62. https://jmlr.org/papers/v18/16-319.html
Shrier, I., & Platt, R. W. (2008). Reducing bias through directed acyclic graphs. BMC Medical Research Methodology, 8, 70. https://doi.org/10.1186/1471-2288-8-70
Textor, J., van der Zander, B., Gilthorpe, M. S., Liśkiewicz, M., & Ellison, G. T. H. (2016). Robust causal inference using directed acyclic graphs: the R package ‘dagitty’. International Journal of Epidemiology, 45(6), 1887–1894. https://doi.org/10.1093/ije/dyw341
Uhler, C., Raskutti, G., Bühlmann, P., & Yu, B. (2013). Geometry of the faithfulness assumption in causal inference. The Annals of Statistics, 41(2), 436–463. https://doi.org/10.1214/12-AOS1080