Una persona no responde al cuestionario de seguimiento porque cambió de teléfono. Otra continúa localizable, pero falleció antes de la fecha prevista para evaluar su calidad de vida. Las dos filas pueden mostrar una celda vacía. La semejanza termina allí: en la primera existe una respuesta que podría haberse obtenido; en la segunda, la calidad de vida en esa fecha carece de un valor definido. Un procedimiento que complete ambas celdas con la misma regla habrá decidido, sin decirlo, qué significa el desenlace.
La ausencia de información también modifica quiénes entran en las comparaciones. Una intervención puede facilitar la asistencia a controles, prolongar la supervivencia o producir una recuperación que haga innecesario seguir acudiendo al mismo servicio. El conjunto observado al final puede tener una composición distinta en cada grupo, incluso cuando la asignación inicial fue aleatoria. Para interpretar una diferencia hay que reconstruir tanto el resultado buscado como las condiciones que permitieron observarlo.
Los ejemplos siguientes son construcciones didácticas. Sus tamaños, riesgos y puntuaciones se eligen para hacer transparentes los cálculos; no corresponden a pacientes reales ni estiman beneficios de un tratamiento. Utilizaremos primero un desenlace binario definido para todas las personas, después una puntuación definida solo entre quienes sobreviven y, finalmente, un evento que puede quedar impedido por otro. Cada situación conserva un denominador diferente.
La población que permanece en el archivo
Sea la estrategia asignada al inicio, con valores cero y uno. Llamaremos a una característica basal que distingue dos niveles de riesgo y a la ocurrencia de un resultado adverso durante el seguimiento. El indicador vale uno cuando se obtiene la información final y cero cuando no se obtiene. En esta primera construcción, existe para todos, independientemente de que el equipo consiga registrarlo.
Suponemos asignación aleatoria de la estrategia. Representamos dos grupos iniciales de doscientas personas, cada uno con cien personas de riesgo basal bajo y cien de riesgo alto; la tabla reproduce exactamente las proporciones poblacionales, sin variación muestral. Dentro de cada nivel, la estrategia no cambia el resultado: el riesgo es diez por ciento en el nivel bajo y cincuenta por ciento en el alto. Por tanto, el riesgo de cada grupo completo es treinta por ciento. Esta igualdad forma parte del mecanismo construido, no de una conclusión extraída del archivo incompleto.
La retención cambia con la estrategia. Bajo el control se obtiene información de ochenta personas de riesgo bajo y veinte de riesgo alto. Bajo la intervención se obtiene de cincuenta personas de cada nivel. Elegimos las observaciones de modo que reproduzcan exactamente sus riesgos dentro de cada estrato. La tabla permite seguir todas las operaciones sin añadir variación de muestreo.
| Estrategia | Riesgo basal | Personas iniciales | Personas observadas | Resultados adversos observados |
|---|---|---|---|---|
| Control | Bajo | 100 | 80 | 8 |
| Control | Alto | 100 | 20 | 10 |
| Intervención | Bajo | 100 | 50 | 5 |
| Intervención | Alto | 100 | 50 | 25 |
El análisis de casos completos encuentra dieciocho resultados adversos entre cien controles observados y treinta entre cien intervenidos observados. La diferencia es de doce puntos porcentuales. El porcentaje total de seguimiento es idéntico en ambos grupos: cincuenta por ciento. Informar únicamente ese porcentaje habría ocultado que los controles observados contienen una proporción mucho menor de personas de alto riesgo.
Los datos dentro de los estratos conservan, en cambio, la igualdad inicial. Ocho de ochenta y cinco de cincuenta representan el mismo diez por ciento. Diez de veinte y veinticinco de cincuenta representan el mismo cincuenta por ciento. La discrepancia aparece al combinar esas cantidades con pesos distintos. El análisis incompleto otorga cuatro veces más peso al estrato bajo en el control y pesos iguales en la intervención.
Este ejemplo muestra por qué un balance de características al inicio no garantiza balance en el subconjunto analizado. La asignación puede estar correctamente ejecutada y, aun así, la disponibilidad posterior de la información alterar la comparación. También muestra que perder el mismo número de participantes en cada grupo no establece una pérdida comparable. Importa qué personas faltan y cómo sus resultados se relacionan con lo que sí se conoce.
Condicionar en la observación
El mecanismo anterior puede representarse mediante las relaciones . La estrategia y el riesgo basal influyen en la observación; el riesgo basal influye además en el resultado. Si se restringe el análisis a , se condiciona en un efecto común de la estrategia y del riesgo. Dentro de ese subconjunto puede aparecer una asociación entre ambos, aunque fueran independientes antes del seguimiento.
La explicación no requiere atribuir una acción misteriosa al acto de seleccionar filas. Entre los controles que permanecen, conocer la estrategia aporta información sobre la distribución del riesgo basal. En la tabla, ser un control observado implica una probabilidad de veinte por ciento de pertenecer al nivel alto; ser un intervenido observado implica cincuenta por ciento. El resultado refleja esa diferencia de composición. La independencia inicial no describe automáticamente la distribución condicional posterior.
Hernán, Hernández-Díaz y Robins (2004) desarrollaron una clasificación estructural que organiza distintos problemas de selección mediante el condicionamiento en efectos comunes. Ese marco permite examinar pérdidas, criterios de inclusión y ajustes realizados después de la exposición. Conviene mantener explícita la definición empleada: el vocabulario de selección también se utiliza para problemas de representatividad y discrepancias respecto de una población objetivo. Identificar un colisionador concreto explica un mecanismo; no sustituye la especificación de la población y del contraste.
Tampoco todo criterio restrictivo produce el mismo daño. Seleccionar una población antes de asignar una intervención puede definir legítimamente a quiénes se desea estudiar. Restringir después a quienes adhieren, sobreviven o conservan un registro completo introduce otra estructura. La posición temporal de la selección y sus causas permiten distinguir ambas situaciones. La palabra «seleccionado» por sí sola no establece que una estimación esté sesgada.
En el ejemplo, conocer proporciona una salida porque la pérdida depende de información registrada y porque queda representación de los dos niveles bajo ambas estrategias. Si el riesgo basal relevante no estuviera medido, el mismo esquema señalaría una dificultad sin proporcionar los números necesarios para corregirla. Dibujar la estructura organiza la pregunta; identificar sus componentes en los datos exige revisar cómo se generaron los registros.
Recuperar una media bajo supuestos declarados
La condición utilizada en nuestro mecanismo puede escribirse : dentro de cada combinación de estrategia y riesgo basal, la disponibilidad del resultado no aporta información adicional sobre su valor. Definimos además , la probabilidad de observación. Necesitamos que sea positiva en los estratos de la población objetivo. Estas condiciones permiten representar los resultados no observados mediante personas observadas del mismo estrato.
Una primera solución consiste en estandarizar. Se estiman los riesgos dentro de cada estrato y se combinan con la distribución basal elegida como objetivo. Como ambos grupos iniciales tenían mitad de personas en cada nivel, obtenemos bajo cada estrategia. Los pesos describen la población inicial, no la composición que quedó disponible al final.
La misma operación puede expresarse mediante ponderación por la inversa de la probabilidad de observación. Cada control de riesgo bajo observado representa personas iniciales de su estrato. Cada control de riesgo alto representa cinco. Los intervenidos observados representan dos personas cada uno. Al ponderar los resultados adversos, el control aporta y la intervención . El denominador inicial es doscientos en ambos casos.
En términos poblacionales, la identidad que sostiene esa cuenta es
Se obtiene calculando primero la esperanza dentro de cada estrato: bajo la independencia indicada, la probabilidad de observar multiplica la media del resultado y se cancela con su inversa. Aquí la asignación inicial permite interpretar además el contraste entre estrategias como causal. En un estudio observacional harían falta condiciones adicionales sobre la asignación; corregir la observación no elimina automáticamente la confusión.
Los números exactos de la tabla hacen coincidir la suma de pesos con el tamaño inicial. En una muestra ordinaria, probabilidades estimadas y cantidades aleatorias pueden producir pequeñas diferencias entre dividir por el tamaño inicial o por la suma de pesos. Esas variantes requieren describir el estimador utilizado. Su fundamento común permanece ligado al mecanismo de observación y a la población que se pretende representar.
La positividad tiene una consecuencia concreta. Si no quedara ninguna persona de riesgo alto observada bajo el control, su riesgo final no podría aprenderse mediante comparación interna en ese estrato. Asignar un peso enorme a otra persona no crea esa información. Si quedaran muy pocas, la estimación dependería intensamente de ellas. Revisar la distribución de pesos permite detectar fragilidad, aunque una distribución aparentemente tranquila tampoco demuestra la independencia condicional asumida.
Lo que significa que un dato falte al azar
La terminología de datos faltantes se refiere a relaciones probabilísticas, no a la impresión de que una pérdida parece accidental. En el escenario simple que hemos definido, con y completamente observados y solo incompleto, la independencia condicional anterior expresa ausencia al azar respecto de esas variables observadas. Una ausencia completamente al azar exigiría una independencia más fuerte respecto del conjunto de valores de los datos. Rubin (1976) formuló las condiciones de ignorabilidad que sustentan esta distinción.
Que alguien pierda su teléfono puede parecer un accidente, pero la pérdida de contacto podría relacionarse con condiciones sociales que también influyen en el desenlace. A la inversa, un seguimiento claramente desigual entre estratos puede ser manejable si las características relevantes están registradas y el supuesto condicional resulta defendible. La plausibilidad se evalúa reconstruyendo el proceso de observación, junto con información externa y conocimiento del contexto.
La denominación ausencia no al azar se utiliza cuando la disponibilidad sigue dependiendo de valores no observados después de condicionar en la información disponible pertinente. En nuestro caso, podría ocurrir que, entre personas con el mismo riesgo basal y estrategia, quienes empeoran fueran menos localizables. Las respuestas de quienes sí se encuentran ya no representarían directamente las respuestas de quienes faltan. Un modelo de observación basado solo en y dejaría intacta esa dependencia.
La imputación múltiple expresa una distribución para los datos ausentes y propaga parte de su incertidumbre mediante varias versiones completadas del archivo. Su utilidad depende de cómo se construye esa distribución y de la compatibilidad con el análisis. Generar muchas imputaciones no convierte un supuesto de observación en un hecho comprobado. Del mismo modo, obtener pesos mediante un algoritmo flexible puede mejorar un ajuste predictivo sin demostrar que se midieron todas las causas pertinentes de la pérdida.
Los datos disponibles permiten examinar diferencias basales y patrones de respuesta; también permiten buscar incoherencias en un modelo. No revelan por sí solos la distribución completa de los resultados que no se obtuvieron. Por eso resulta útil conservar las fechas y razones de cada interrupción, intentar recuperar resultados por vías independientes y distinguir traslado, rechazo de entrevista y error administrativo. Agruparlos bajo un único código elimina información que podría justificar modelos distintos.
Cuánto pueden cambiar los resultados ausentes
Podemos analizar la tabla sin aceptar todavía la representación por estratos. En cada grupo faltan cien resultados binarios. Sea la proporción de resultados adversos entre los controles ausentes y la proporción entre los intervenidos ausentes. Los riesgos completos serían
Los términos iniciales son los eventos observados divididos por las doscientas personas originales. Cada proporción desconocida aporta la mitad del riesgo total porque falta la mitad de los resultados. La diferencia completa es . Esta expresión deja visible qué parte de la conclusión depende de información que no está en el archivo.
Si solo sabemos que ambas proporciones están entre cero y uno, la diferencia puede variar entre menos cuarenta y cuatro y más cincuenta y seis puntos porcentuales. Son cotas amplias, pero se deducen sin un modelo de pérdida. No constituyen un intervalo de confianza: describen valores compatibles con la información parcial y con los límites del desenlace. La variabilidad muestral sería una fuente adicional de incertidumbre.
En el mecanismo didáctico conocido, los controles ausentes incluyen veinte personas de riesgo bajo y ochenta de riesgo alto. Su riesgo promedio es cuarenta y dos por ciento. Los intervenidos ausentes conservan la mezcla equilibrada y su riesgo es treinta por ciento. Sustituir y devuelve una diferencia nula. La igualdad no surge de imponer riesgos idénticos a todos los ausentes, sino de representar sus distintas composiciones.
La fórmula también permite localizar un umbral: el contraste cambia de signo cuando . Un análisis de sensibilidad podría explorar cuánto menor tendría que ser el riesgo entre los intervenidos ausentes para sostener una dirección del efecto. La elección de valores plausibles requiere argumentos ajenos a la sola tabla observada. Resulta más informativo mostrar esa dependencia que ofrecer una estimación puntual cuya precisión aparente oculta el supuesto decisivo.
Una investigación adicional podría buscar una muestra de quienes faltan utilizando otra vía de contacto. Si se seleccionaran al azar personas ausentes de cada grupo y se consiguiera su resultado con un mecanismo conocido, esa información permitiría estimar directamente las proporciones desconocidas. El diseño debería conservar tanto la probabilidad de selección para ese segundo esfuerzo como la respuesta que finalmente se obtiene. Seleccionar al azar a quién llamar no asegura que quienes contesten constituyan una muestra aleatoria de quienes faltaban.
Por ejemplo, encontrar resultados administrativos completos para un subconjunto elegido con probabilidades conocidas puede permitir ponderar esa segunda fase. Recuperar solo a quienes vuelven espontáneamente al servicio añade una selección distinta, posiblemente relacionada con su evolución. Las dos ampliaciones aumentan el número de filas disponibles, pero aportan evidencias diferentes sobre los ausentes originales. El registro de procedencia de cada dato permite conservar esa diferencia en el análisis.
También conviene separar el porcentaje de ausencia de su impacto sobre el contraste. Una pérdida pequeña concentrada en un estrato raro y de alto riesgo puede cambiar una estimación específica de ese estrato. Una pérdida extensa con probabilidades bien conocidas puede permitir una estimación válida, aunque menos precisa. El criterio para cerrar la revisión del seguimiento será entonces si los datos y supuestos sostienen el estimando declarado, junto con la incertidumbre que permanece, en vez de un umbral universal de porcentaje recuperado.
Cuando el resultado deja de estar definido
Pasemos ahora a una puntuación de calidad de vida medida en una fecha fija. Definimos como el indicador de estar vivo en esa fecha bajo la estrategia . La puntuación potencial existe únicamente si . Una persona viva cuyo cuestionario se perdió tiene un dato faltante; una persona fallecida antes de la evaluación tiene una puntuación posterior no definida. La distinción entre ambos problemas es central en el tratamiento del truncamiento por muerte de Zhang y Rubin (2003) y Rubin (2006).
Podría definirse otra variable que atribuyera un valor a la muerte, pero esa sería una nueva medida. Por ejemplo, un resultado binario «estar vivo y superar cierto umbral funcional» queda definido para toda la población. Un fallecimiento implica que esa condición conjunta no se cumple. El contraste obtenido responde entonces a una pregunta sobre supervivencia con ese nivel de funcionamiento, no a una diferencia media en la puntuación original.
Asignar cero a todos los fallecidos es también una elección sustantiva si cero ya corresponde a una situación vivida dentro de la escala. Equipara estados que la medición original quizá nunca pretendió comparar. Puede ser una convención útil para un objetivo concreto, pero necesita justificarse y mantenerse separada de una recuperación de datos perdidos. La operación no descubre una calidad de vida que habría quedado escondida en el archivo.
Otra posibilidad consiste en describir la puntuación entre supervivientes de cada estrategia. Esa descripción es observable, aunque compara grupos cuya composición puede depender de la intervención. Su diferencia no corresponde, en general, al efecto sobre un conjunto fijo de personas. La pregunta acerca de quiénes sobrevivieron reaparece dentro del significado mismo de la comparación, incluso si todas las entrevistas disponibles fueron realizadas sin error.
Estratos definidos por supervivencias potenciales
La estratificación principal agrupa a las personas mediante resultados potenciales de una variable posterior a la intervención (Frangakis y Rubin, 2002). Para la supervivencia hay cuatro combinaciones posibles: sobrevivir bajo ambas estrategias, sobrevivir solo bajo la intervención, sobrevivir solo bajo el control y no sobrevivir bajo ninguna. Solo en la primera combinación están definidas las dos puntuaciones que se desean restar.
El efecto causal promedio entre quienes sobrevivirían bajo ambas estrategias se escribe
Este parámetro conserva la misma población a ambos lados del contraste. La pertenencia a esa población es latente: observar supervivencia bajo una estrategia no informa automáticamente qué habría ocurrido bajo la otra. La aleatorización permite identificar distribuciones marginales bajo cada asignación, pero no empareja las dos supervivencias potenciales de cada persona.
Construyamos dos poblaciones potenciales expresadas por cada cien personas elegibles. No son recuentos que una aleatorización finita garantice reproducir exactamente en cada brazo; representan proporciones poblacionales. No hay otras covariables observadas que distingan los tipos que describiremos. En ambas poblaciones, sesenta personas sobrevivirían bajo el control y ochenta bajo la intervención. Todas las supervivientes bajo el control tendrían una puntuación de sesenta.
En la primera población, las sesenta personas que sobreviven bajo ambas estrategias pasan de sesenta a setenta puntos. Otras veinte sobreviven solo bajo la intervención y tienen veinte puntos cuando la reciben. Las veinte restantes no sobreviven bajo ninguna estrategia. Entre supervivientes intervenidos se observan, por tanto, sesenta puntuaciones de setenta y veinte puntuaciones de veinte. Su promedio es .
Comparar los promedios observables da una diferencia de menos dos coma cinco puntos: cincuenta y siete coma cinco frente a sesenta. Sin embargo, el efecto entre quienes sobrevivirían bajo ambas estrategias es más diez. La intervención añade a la población superviviente personas con una puntuación menor, y esa incorporación cambia el promedio. También mejora la supervivencia marginal en veinte puntos porcentuales; ese resultado tiene su propia interpretación.
Dos mundos con la misma información observable
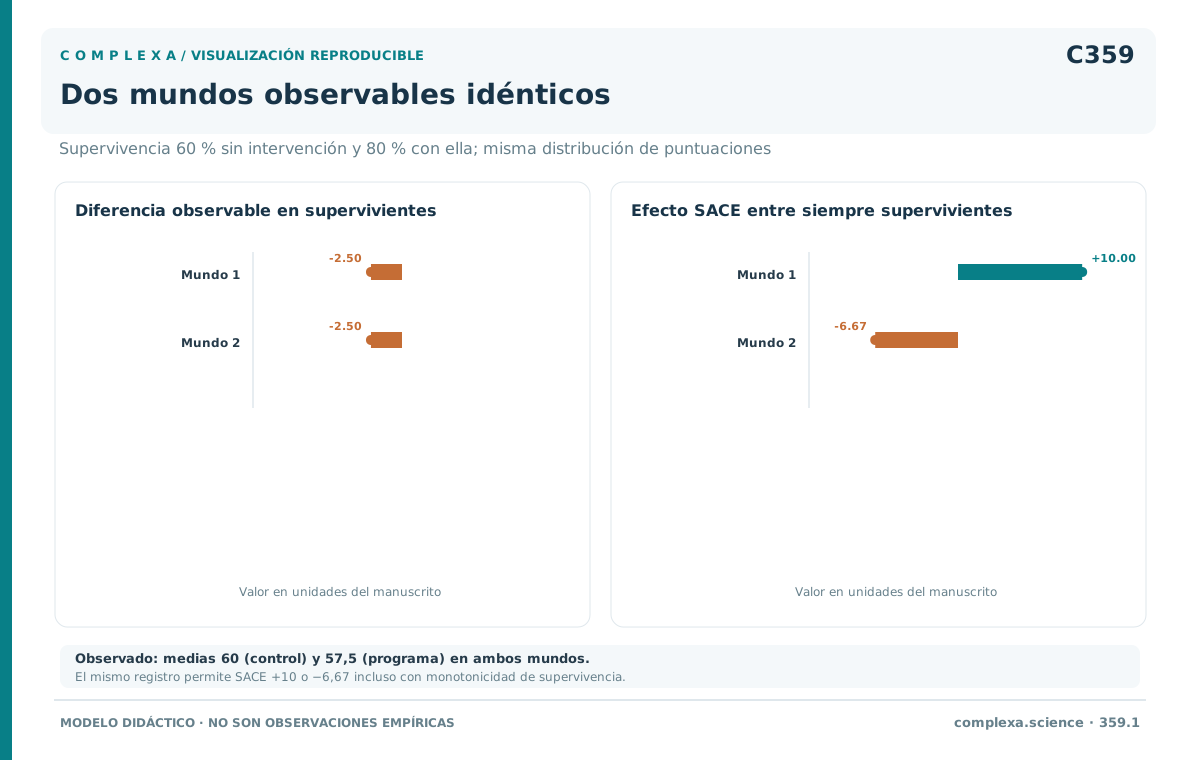
En la segunda población, cuarenta personas sobreviven bajo ambas estrategias y pasan de sesenta a setenta puntos. Otras veinte también sobreviven bajo ambas, pero pasan de sesenta a veinte. Las veinte que sobreviven exclusivamente bajo la intervención obtienen setenta puntos. Las últimas veinte no sobreviven bajo ninguna. Las proporciones de supervivencia siguen siendo exactamente las mismas que en la primera población.
La distribución de puntuaciones observadas tampoco permite distinguirlas. Bajo el control, las sesenta personas supervivientes tienen sesenta puntos. Bajo la intervención, sesenta tienen setenta puntos —cuarenta del primer tipo y veinte del tercero— y veinte tienen veinte puntos. Ambas poblaciones generan la misma ley conjunta de supervivencia y puntuación observable bajo cada asignación. La diferencia reside en la correspondencia entre resultados potenciales que nunca se observan simultáneamente.
Ahora, la puntuación media bajo intervención en el estrato que siempre sobrevive es . Su efecto promedio es menos seis coma sesenta y siete puntos aproximadamente. Hemos construido así dos mecanismos compatibles con todas las distribuciones observadas, con efectos principales de signos opuestos. Disponer de una muestra arbitrariamente grande de esas mismas variables no resolvería la ambigüedad.
Los dos mecanismos satisfacen monotonicidad de supervivencia: nadie moriría bajo la intervención y sobreviviría bajo el control. Esta condición excluye uno de los cuatro estratos, pero no revela quiénes integran la mezcla de supervivientes intervenidos. Por ello, monotonicidad y aleatorización juntas siguen sin identificar un valor único del efecto principal en este ejemplo. La restricción es científicamente discutible en una aplicación y aquí se impone solo para estudiar sus consecuencias.
La distribución observada permite obtener cotas más informativas. Bajo monotonicidad, las personas que siempre sobreviven constituyen sesenta de las ochenta supervivientes intervenidas. Para minimizar su media se incluyen las veinte puntuaciones bajas y cuarenta de las sesenta altas. Para maximizarla se seleccionan sesenta puntuaciones altas. La media del estrato queda entre cincuenta y tres coma treinta y tres y setenta; al restar sesenta, el efecto queda entre menos seis coma sesenta y siete y más diez.
Esas cotas son alcanzables porque acabamos de construir poblaciones que realizan ambos extremos. No provienen de clasificar personas mediante sus puntuaciones observadas; recorren asignaciones latentes compatibles con los datos y el supuesto. Una clasificación individual basada en un modelo añadiría información supuesta sobre esa pertenencia. Reportar solo su resultado puntual borraría la diferencia entre lo identificado y lo que el modelo decidió completar.
Eventos que impiden otros eventos
La muerte puede afectar otro desenlace de una manera diferente. Si interesa la primera readmisión antes de una fecha y una persona fallece sin haber sido readmitida, sabemos que no tendrá una primera readmisión posterior. El indicador de haber sido readmitida antes del horizonte queda definido. Esto difiere de una puntuación de calidad de vida posterior a la muerte. En análisis de tiempos, un evento que imposibilita el de interés se denomina evento competitivo.
Consideremos dos intervalos iguales. Entre quienes siguen vivos y sin el evento al inicio de cada intervalo, la probabilidad de ese evento es diez por ciento bajo ambas estrategias. La probabilidad de muerte competitiva es diez por ciento bajo el control y cuarenta por ciento bajo la intervención. Definimos tres resultados mutuamente excluyentes dentro de cada intervalo: evento de interés, muerte competitiva o permanencia sin eventos. Los valores son artificiales y se mantienen constantes entre intervalos.
Después del primer intervalo quedan sin eventos ochenta por ciento de los controles y cincuenta por ciento de los intervenidos. Durante el segundo, el evento de interés ocurre en diez por ciento de esos conjuntos restantes. La incidencia acumulada resulta bajo el control y bajo la intervención. La probabilidad condicional del evento es idéntica, pero su probabilidad acumulada es menor donde más personas mueren antes.
La incidencia acumulada depende de la probabilidad condicional del evento de interés y también de las probabilidades de los eventos competitivos, porque estas modifican cuántas personas permanecen expuestas. Andersen y colaboradores (2012) explican la distinción entre tasas específicas e incidencias acumuladas. En nuestra construcción basta multiplicar probabilidades para verla: el cambio de tres puntos porcentuales no expresa una reducción del evento entre personas todavía elegibles para experimentarlo.
Tratar cada muerte competitiva como una pérdida ordinaria y construir el complemento de una curva de supervivencia produciría aquí diecinueve por ciento para el evento en ambas estrategias: . Esa cantidad no es la incidencia acumulada observada de quince o dieciocho por ciento. Una interpretación hipotética bajo eliminación del evento competitivo requiere definir esa intervención y justificar los supuestos que permiten identificarla. La operación informática de censurar no los suministra.
Young y colaboradores (2020) distinguen efectos sobre riesgos manteniendo los eventos competitivos y efectos bajo intervenciones que los eliminan. Además, un contraste de tasas instantáneas condiciona en los conjuntos que continúan en riesgo; identificar estadísticamente ese contraste no le otorga automáticamente interpretación causal. En una aplicación habría que decidir si interesa el riesgo total en la población inicial o una pregunta diferente sobre mecanismos, y evaluar cada objetivo con sus condiciones.
Entrar tarde también selecciona
Hasta ahora todas las personas estaban presentes al inicio y algunas dejaron de ser observadas. La selección puede ocurrir antes de que aparezca la primera fila. Un registro que recluta personas varios meses después del comienzo de una enfermedad solo incluye a quienes alcanzaron ese momento y cumplieron las condiciones de entrada. Las personas que murieron antes no figuran como pérdidas: nunca estuvieron en el archivo. Su ausencia puede pasar inadvertida si el análisis empieza contando únicamente a los participantes inscritos.
Conviene distinguir la fecha de inicio del proceso, la fecha de entrada al registro y la fecha desde la cual comienza la pregunta causal. Si la pregunta se refiere a quienes estaban vivos y eran elegibles al inscribirse, esa selección puede formar parte de la definición de la población objetivo. Si se pretende estudiar a todas las personas desde el inicio de la enfermedad, el mismo registro ofrece una observación truncada. Cambiar retrospectivamente el nombre del tiempo cero no recupera las trayectorias que quedaron fuera.
La entrada tardía puede manejarse en ciertos análisis de supervivencia incorporando a cada persona al conjunto en riesgo solo desde su entrada y declarando las condiciones que hacen informativa esa comparación. Eso no autoriza a tratar como observados los intervalos previos ni resuelve por sí mismo la selección causal. El procedimiento estadístico y la población a la que se quiere generalizar siguen siendo decisiones separadas. Una asociación entre supervivencia previa y posibilidad de reclutamiento puede exigir información que el registro nunca recogió.
Pensemos en dos servicios que evalúan funcionamiento al primer control disponible. Uno atiende pronto después del alta y el otro varios meses después. Si solo se incluyen quienes acudieron, ambos servicios aplican filtros temporales distintos. La diferencia de puntuaciones podría reflejar recuperación durante intervalos diferentes, requisitos de supervivencia y reglas de asistencia. Ajustar una regresión por la fecha del control no define automáticamente cuál habría sido el resultado bajo un calendario común de observación.
Para revisar ese problema necesitamos recuperar el criterio de elegibilidad y el calendario previsto, además del calendario realizado. Un control programado que no ocurrió deja un tipo de información ausente distinto de una persona para la que nunca se programó control. La distinción permite preguntar si se está estimando la experiencia de todas las personas elegibles, de quienes accedieron a cierto circuito o de quienes permanecieron disponibles durante un período mínimo. Cada denominador puede ser útil, pero responde a una población diferente.
Volver al registro con una pregunta definida
Un archivo puede contener simultáneamente cuestionarios perdidos, fallecimientos y eventos competitivos. Resulta útil conservar indicadores separados. Para una puntuación entre personas vivas, indica si la medida está definida y si fue observada cuando podía obtenerse. La selección hacia y la falta de información dentro de ese conjunto plantean problemas distintos. Imputar entre supervivientes podría abordar el segundo bajo supuestos adecuados, mientras el efecto principal seguiría dependiendo de pertenencias contrafactuales no conocidas.
La misma lógica permite revisar qué se informa al final. Si el objetivo es supervivencia marginal, todas las personas elegibles aportan al denominador inicial. Si se presenta una media entre supervivientes observados, deben declararse las pérdidas adicionales de medición. Si se estima un efecto principal, hace falta especificar qué restricciones o modelos permiten pasar de las mezclas observadas al estrato latente. El nombre general «análisis ajustado» no describe esas decisiones.
En el primer ejemplo, recuperar diez cuestionarios de controles de alto riesgo podría reducir una incertidumbre que pesos e imputaciones solo representan mediante supuestos. En el ejemplo de supervivencia, obtener más cuestionarios de quienes están vivos mejora la descripción de sus puntuaciones, pero nunca revela por observación directa la supervivencia bajo la estrategia no recibida. La utilidad de una nueva medición depende del tipo de información ausente.
Si tuviéramos que entregar las cifras de nuestras dos poblaciones potenciales sin conocer sus mecanismos internos, podríamos informar supervivencia de sesenta y ochenta por ciento, medias de sesenta y cincuenta y siete coma cinco entre supervivientes y las distribuciones completas de esas puntuaciones. Bajo monotonicidad, podríamos añadir la cota del efecto principal, desde aproximadamente menos seis coma sesenta y siete hasta más diez. Elegir un único signo para ese último efecto exigiría aportar una razón adicional que el registro construido todavía no contiene.
Referencias
Andersen, P. K., Geskus, R. B., de Witte, T., y Putter, H. (2012). Competing risks in epidemiology: possibilities and pitfalls. International Journal of Epidemiology, 41(3), 861–870. https://doi.org/10.1093/ije/dyr213
Frangakis, C. E., y Rubin, D. B. (2002). Principal stratification in causal inference. Biometrics, 58(1), 21–29. https://doi.org/10.1111/j.0006-341X.2002.00021.x
Hernán, M. A., Hernández-Díaz, S., y Robins, J. M. (2004). A structural approach to selection bias. Epidemiology, 15(5), 615–625. https://doi.org/10.1097/01.ede.0000135174.63482.43
Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
Rubin, D. B. (2006). Causal inference through potential outcomes and principal stratification: Application to studies with “censoring” due to death. Statistical Science, 21(3), 299–309. https://doi.org/10.1214/088342306000000114
Young, J. G., Stensrud, M. J., Tchetgen Tchetgen, E. J., y Hernán, M. A. (2020). A causal framework for classical statistical estimands in failure-time settings with competing events. Statistics in Medicine, 39(8), 1199–1236. https://doi.org/10.1002/sim.8471
Zhang, J. L., y Rubin, D. B. (2003). Estimation of causal effects via principal stratification when some outcomes are truncated by “death”. Journal of Educational and Behavioral Statistics, 28(4), 353–368. https://doi.org/10.3102/10769986028004353