Un registro puede tener más observaciones de los momentos difíciles justamente porque en ellos se decide medir, o menos si esos mismos momentos hacen que una persona no responda o que un dispositivo falle. En ambos casos la frecuencia de las filas depende de la trayectoria que se quiere estudiar, de manera que una media calculada sobre esas filas mezcla el comportamiento del sistema con la forma de observarlo.
Otra situación se da cuando una pregunta, una prueba o una solicitud de atención modifica lo que ocurre después. El protocolo deja entonces dos huellas. Selecciona cuándo habrá un dato y puede alterar el proceso que generará los datos siguientes. Para separarlas hay que describir las decisiones de observación con la misma precisión que las ecuaciones del estado.
La irregularidad del calendario no determina por sí sola este problema. Un sensor puede registrar a intervalos variables fijados de antemano, sin relación alguna con las fluctuaciones que medirá; un calendario adaptativo también puede apoyarse exclusivamente en información anterior ya observada. Lo decisivo es qué vincula la decisión de medir, el resultado obtenido y los valores que quedaron fuera del registro.
Ocasiones esperadas y mecanismos de ausencia
Para hablar de ausencia conviene definir primero qué observación se esperaba. Una pregunta omitida en un cuestionario programado, un sensor desconectado y una visita que nunca estuvo prevista no son necesariamente el mismo tipo de hueco. En el primer caso hay una ocasión definida cuyo resultado falta, mientras que en el último puede haber un proceso continuo sin una cuadrícula natural de resultados que deberían haberse registrado.
Cuando sí hay ocasiones definidas, los datos completos pueden representarse por y su patrón de observación por , que vale uno para un valor observado y cero para uno ausente. Dado un patrón concreto, designa los componentes observados e los restantes. Las covariables se suponen aquí observadas en todas las unidades y el mecanismo de ausencia es la probabilidad de cada patrón dados esos valores.
La sigla MCAR, del inglés missing completely at random, indica que el patrón es independiente de los valores de las variables consideradas. Si una parte de los cuestionarios se pierde por un sorteo ajeno a sus respuestas y covariables, ese mecanismo cumple la condición. Una avería informática no la cumple por el simple hecho de ser una avería, ya que podría aparecer más en jornadas de alta carga, relacionadas a su vez con el resultado.
En MAR (missing at random) la ausencia puede depender de información observada. Para el patrón examinado, la condición se escribe
Una vez fijada la información observada, cambiar los valores que faltan no cambia la probabilidad de ese patrón. El nombre puede hacer pensar en ausencias repartidas sin estructura. Sin embargo, un grupo observado puede responder con mucha menos frecuencia que otro y el mecanismo seguir siendo MAR si, dentro de cada grupo y tras el condicionamiento pertinente, la respuesta no depende del valor que falta.
MNAR (missing not at random) describe la dependencia que subsiste respecto de valores no observados. Si una persona decide responder según su estado actual y ese estado solo se conoce cuando responde, la ausencia puede depender precisamente del resultado que no quedó registrado. Que el investigador conozca una explicación verbal plausible no hace que la variable explicativa haya quedado observada.
Estas condiciones atañen al mecanismo y al conjunto de variables definido. Una covariable adicional puede volver más plausible MAR si recoge el motivo relevante de la selección; añadir una aproximación ruidosa de ese motivo, en cambio, no garantiza que desaparezca toda dependencia con el valor ausente. Además, una variable que también falta no puede tratarse sin más como información disponible para todas las unidades.
Seaman y colaboradores (2013) distinguen dos versiones de MAR. La primera, llamada MAR realizado, se limita al patrón y a los valores observados que efectivamente aparecieron; la segunda, MAR en todas partes, se exige para todos los patrones y valores posibles. En ambos casos la condición debe valer para todos los valores admitidos de los parámetros del mecanismo de ausencia. La diferencia importa al pasar de una inferencia sobre el registro disponible a afirmaciones sobre el comportamiento de un procedimiento en muestras repetidas.
Condiciones para ignorar el mecanismo
Rubin (1976) estableció condiciones bajo las cuales puede hacerse inferencia sin modelar explícitamente el proceso de ausencia. El adjetivo «ignorable» designa aquí una propiedad de la inferencia sobre ciertos parámetros. No significa que las filas incompletas puedan eliminarse sin consecuencias ni que sea indiferente qué variables se incluyan en el modelo.
Sea el modelo de los resultados y el del patrón de observación, con parámetros y . La contribución de los datos observados a la verosimilitud conjunta integra sobre los valores que faltan,
Bajo MAR para la realización observada, el segundo factor es constante respecto de los valores integrados y puede salir de la integral. Queda así un factor que depende del mecanismo de ausencia multiplicado por la verosimilitud del resultado observado. Si los espacios de parámetros son distintos (las posibilidades de uno no restringen las del otro), esa factorización autoriza a prescindir del primer factor en la inferencia directa por verosimilitud sobre .
En una formulación bayesiana importa también la distribución previa conjunta. La independencia previa entre los parámetros del resultado y los del mecanismo, junto con MAR en la formulación pertinente, da la misma posterior marginal para con o sin el factor de ausencia. Si la previa acopla ambos parámetros, la integración puede trasladar información de un mecanismo al otro aunque la factorización de la verosimilitud parezca sencilla.
Seaman y colaboradores (2013) precisan, además, que las garantías de muestreo repetido requieren condiciones más amplias que una factorización válida solo para el patrón observado. MAR en todas partes, separación de parámetros y las condiciones regulares del modelo permiten justificar ciertos procedimientos de verosimilitud. La etiqueta MAR, separada de esas condiciones y del método de inferencia, no certifica cualquier intervalo o prueba.
En un estudio longitudinal, el modelo del resultado debe representar la dependencia entre fechas. Integrar una observación ausente dentro de ese modelo conserva la incertidumbre sobre su valor y su relación con las observaciones vecinas. Reemplazarla por una constante y analizar después la serie como si estuviera completa cambia el problema probabilístico. La factorización anterior no autoriza esa sustitución.
El arrastre del último valor disponible puede fabricar memoria aun con ausencias MCAR. Consideremos una secuencia de valores verdaderos independientes, de media cero y varianza uno, en la que cada fecha se observa tras un sorteo independiente con probabilidad un medio. Cuando falta un valor, el archivo completado repite el último observado; cuando llega uno nuevo, lo incorpora. Supondremos que el proceso lleva el tiempo suficiente como para haber registrado algún valor anterior.
La serie completada mantiene media cero y varianza uno, aunque la mitad de las veces copia exactamente su valor previo y la otra mitad recibe un valor nuevo, independiente del anterior. Su covarianza en el primer retardo vale entonces un medio, igual que su autocorrelación, mientras que la serie verdadera tenía autocorrelación nula. En el segundo retardo la correlación de la serie completada es un cuarto, la probabilidad de no obtener ningún valor nuevo en dos sorteos seguidos.
Sin selección dependiente del estado ni reactividad de la medición, la dependencia nació aquí del procedimiento usado para completar el archivo. Si se estimara después una persistencia con esas repeticiones como si fueran datos genuinos, se atribuiría al sistema parte de la memoria introducida por el analista. Conservar el indicador de ausencia y usar un modelo que integre los valores no observados mantiene separadas ambas fuentes.
El parámetro de interés también cuenta. Un mecanismo puede omitirse al estimar una relación condicional correctamente especificada y ser, sin embargo, relevante para reconstruir una media marginal de la población. Para esa tarea hay que conservar la distribución de las covariables sobre las que se condicionó. El ejemplo siguiente muestra la diferencia sin recurrir a una muestra real.
Una ausencia MAR que altera la media de los casos completos
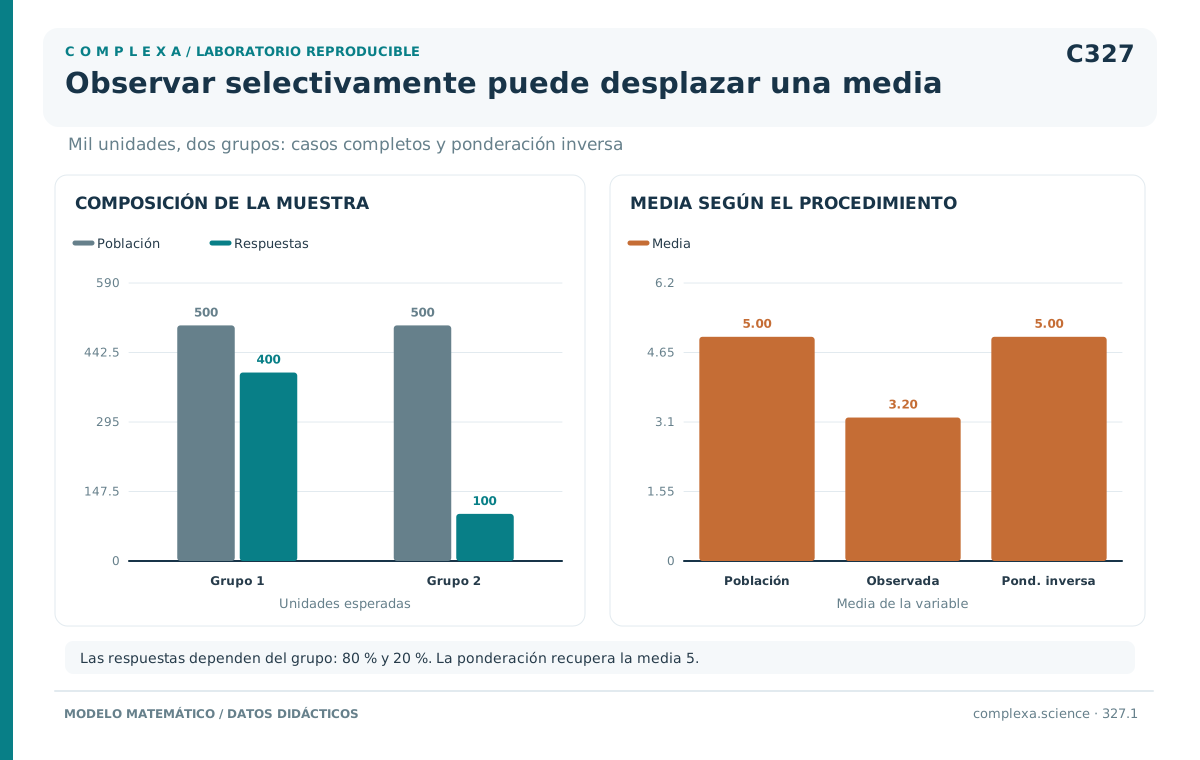
Supongamos una población didáctica de mil unidades repartidas en dos grupos conocidos de quinientas, con una media del resultado de dos en el primer grupo y de ocho en el segundo. La probabilidad de responder vale en el primero y en el segundo y, dentro de cada grupo, es independiente del resultado. El grupo se conoce también para quienes no responden.
La media de la población es cinco. Los números esperados de respuestas son cuatrocientas en el primer grupo y cien en el segundo, de modo que el promedio construido con esos recuentos esperados es
El mecanismo es MAR dado el grupo observado, pero la composición de los casos completos difiere de la poblacional, con el grupo de media alta muy subrepresentado. El promedio simple de las respuestas, sin ajustar por esa composición, apunta a una cantidad distinta de la media buscada.
| Grupo observado | Unidades | Media del resultado | Probabilidad de responder | Respuestas esperadas |
|---|---|---|---|---|
| Primero | 500 | 2 | 0,8 | 400 |
| Segundo | 500 | 8 | 0,2 | 100 |
Una posibilidad consiste en estimar las medias de cada grupo y combinarlas según sus proporciones originales, mitad y mitad. Otra usa pesos inversos a las probabilidades de responder, de para cada respuesta del primer grupo y de cinco para cada una del segundo. Aplicados a los recuentos esperados, ambos grupos recuperan un peso total de quinientos y el promedio ponderado vuelve a cinco.
El cálculo supone que las probabilidades usadas son correctas y positivas en todos los grupos relevantes. Si nadie respondiera en el segundo grupo, sus resultados no podrían reconstruirse a partir de respuestas de ese mismo grupo. Haría falta información adicional o una restricción que permitiera extrapolar desde otro lugar.
Incluso con probabilidades positivas, los pesos muy grandes concentran la estimación en unas pocas respuestas. El ajuste puede corregir una diferencia de representación mientras aumenta la variabilidad del estimador. En registros repetidos hay que considerar además la dependencia dentro de cada unidad al cuantificar esa variabilidad. Tratar cada respuesta ponderada como si representara varias observaciones independientes daría una precisión injustificada.
El ejemplo aclara también qué información auxiliar merece guardarse, pues saber a qué grupo pertenecían solo quienes respondieron no da directamente las proporciones poblacionales. El registro de invitaciones, oportunidades y no respuestas permite reconstruir el denominador del proceso de observación. La ausencia de una fila en el archivo de respuestas no debería borrar la existencia de la unidad o de la ocasión correspondiente.
Dos mecanismos compatibles con el mismo registro
Pasemos a un resultado binario, cero o uno, sin covariables observadas. Supongamos que en la población el 40 % tiene valor uno, que la probabilidad de responder es cuando el resultado vale uno y cuando vale cero. Es una construcción MNAR, ya que la respuesta depende del resultado y este permanece desconocido para quienes no responden.
En mil unidades, los recuentos esperados son ciento veinte respuestas con valor uno, quinientas cuarenta con valor cero y trescientas cuarenta ausencias. Entre las respuestas, la proporción de unos es , aproximadamente , frente a en la población completa. La selección retiró una fracción particularmente grande de los valores uno.
Construyamos ahora otro mecanismo, en el que todas las unidades responden con probabilidad sea cual sea su resultado y la proporción poblacional de unos es , aproximadamente . Este mecanismo es MCAR. Produce, sin embargo, las mismas probabilidades observables, para una respuesta con valor uno, para una respuesta con valor cero y para una ausencia.
Con unidades independientes en ambos casos, los dos mecanismos pueden generar cualquier archivo observado con la misma probabilidad, aunque asignen distribuciones distintas a los valores ausentes. Disponer de más unidades del mismo tipo permite estimar mejor esas tres probabilidades observables, pero no selecciona entre las dos explicaciones. El problema subsiste incluso si el porcentaje de ausencias se conoce con gran precisión.
La construcción muestra por qué, en general, ninguna prueba sobre datos incompletos puede demostrar MAR frente a todas las alternativas MNAR. Sí pueden detectarse incompatibilidades con hipótesis más fuertes o con modelos particulares; una relación entre el grupo observado y la respuesta, por ejemplo, contradice la independencia MCAR respecto de ese grupo. Que una prueba no detecte esa relación no informa sobre todos los valores que quedaron sin observar.
Para estudiar la sensibilidad, llamemos a la proporción de unos entre las unidades ausentes. Con las probabilidades observadas del ejemplo, la proporción total es
Con se obtiene , con se obtiene y con se obtiene , mientras que sin restricciones adicionales sobre los ausentes el intervalo compatible va de a . La construcción MNAR inicial corresponde a , aproximadamente , con la que se recupera la proporción total de .
El análisis de sensibilidad convierte una hipótesis no identificada en una cantidad que puede discutirse. Una nueva medición dirigida a una submuestra de quienes no respondieron, si se justifica su propio mecanismo de selección, puede aportar información sobre esa cantidad. También pueden usarse conocimientos externos o límites plausibles, manteniendo sus efectos separados de lo que enseñan las respuestas originales.
La imputación se enfrenta al mismo problema. Generar muchos valores ausentes bajo una única hipótesis MAR describe la incertidumbre dentro de esa hipótesis, pero no explora automáticamente los mecanismos MNAR. Para evaluar la sensibilidad hay que variar la distribución atribuida a los ausentes, además de producir distintas realizaciones bajo una distribución fija.
Intensidad de visitas y composición del registro
En tiempo continuo puede no existir una lista de ocasiones programadas. Las observaciones llegan mediante un proceso de visitas, solicitudes o detecciones cuya intensidad es la tasa instantánea esperada de llegada, dada la historia relevante. Esa tasa se mide en observaciones por unidad de tiempo y puede variar según el estado del sistema.
Pullenayegum y Lim (2016) revisaron los métodos para registros longitudinales con tiempos irregulares, con especial atención a las hipótesis sobre el proceso de visitas. La distinción afecta al significado de una media. El promedio de los valores encontrados en las visitas describe la distribución en esas ocasiones, pero la media respecto del tiempo transcurrido puede ser otra si algunos estados provocan más observaciones.
Consideremos un sistema didáctico que pasa el 80 % del tiempo en un estado bajo y el 20 % en uno alto, a los que atribuimos los valores cero y uno. En el estado bajo las observaciones llegan con intensidad de una por hora; en el alto, de cuatro por hora. Supondremos un proceso de observación de Poisson condicionado a la trayectoria, sin que medir altere esa trayectoria.
En mil horas, con ochocientas en el estado bajo y doscientas en el alto, se esperan ochocientas observaciones de cada estado. La fracción del estado alto en el registro tiende a la mitad aunque su ocupación temporal sea de un quinto. En general, bajo estabilidad y con condiciones que permitan promediar una trayectoria larga,
donde es la fracción temporal del estado alto y son las intensidades en cada estado. Con los valores propuestos, el numerador y la contribución del estado bajo son iguales. El calendario alteró la composición del archivo sin cambiar el tiempo que el sistema pasa en cada estado.
Si las intensidades se conocen, la representación puede corregirse con pesos inversos, un cuarto para cada observación del estado alto y uno para cada observación del estado bajo. Aplicados a los recuentos esperados, los pesos totales son doscientos y ochocientos, con lo que se recupera la proporción temporal de un quinto. En una muestra finita el cociente ponderado tiene también su variabilidad; el cálculo con recuentos esperados solo muestra la operación que se pretende hacer.
Lin, Scharfstein y Rosenheck (2004) desarrollaron estimadores ponderados por la inversa de la intensidad de visitas para modelos marginales longitudinales. Cuando la intensidad se modela a partir de la historia observada, la justificación requiere hipótesis que relacionen esa historia con el proceso de visitas, una intensidad bien representada y una posibilidad suficiente de observar. La ponderación modifica cuánto aporta cada medición a la estimación del objetivo marginal.
En nuestro ejemplo, las intensidades por estado se dieron como parte de la construcción y no se aprendieron únicamente de la proporción de estados observados. Si el estado actual no observado determina cuándo ocurre una visita, estimar esas intensidades desde el archivo puede exigir información adicional o un modelo conjunto. La mitad de observaciones altas, por sí sola, no indica cuánto tiempo estuvo alto el sistema ni con qué preferencia se acudió a observarlo.
Dividir cada observación por el número total de visitas de su unidad tampoco resuelve el problema. Ese número resume decisiones tomadas a lo largo de toda la trayectoria y puede esconder cambios de intensidad dentro de ella. Una persona observada muchas veces puede haber tenido largos periodos de baja intensidad y episodios breves de intensidad alta. El objetivo temporal obliga a representar esa variación, además de las diferencias entre personas.
Modelos conjuntos y pausas informativas
Un modelo conjunto describe la trayectoria latente, el mecanismo que genera las visitas y los valores medidos en ellas. Para una trayectoria , una forma habitual del factor de observación temporal es
donde son las fechas de las visitas, la historia que define su intensidad y el tiempo de seguimiento. La intensidad debe definirse de manera compatible con la información anterior a cada evento. Este factor se combina con el modelo de la trayectoria y con la distribución de las mediciones condicionadas al estado.
El producto recoge las visitas que ocurrieron; la exponencial, la exposición durante la cual podrían haber ocurrido, incluidas las pausas sin visitas. Si solo se guardan las filas con resultados y se pierde el periodo en que el dispositivo estuvo activo, falta parte de la información necesaria para evaluar ese mecanismo.
Para ver el papel de una pausa, imaginemos una hora durante la cual el estado permanece fijo. Antes de mirar el calendario asignamos probabilidad al estado alto, con las mismas tasas de cuatro y una observaciones por hora. Si en esa hora no llega ninguna observación, la probabilidad actualizada del estado alto es
La ausencia de visitas favorece al estado de menor intensidad. Para mostrar la actualización de forma exacta, el cálculo no incluye transiciones de estado dentro de la hora. Si el estado cambiara durante el intervalo, habría que integrar sobre las trayectorias posibles y sus exposiciones.
La interpretación depende de que el mecanismo siga operativo. Una hora sin datos porque el dispositivo estuvo apagado no aporta la misma evidencia que una hora de funcionamiento sin eventos. Registrar el tiempo activo, las pérdidas de conexión y los criterios para solicitar una medición permite distinguir ambos casos. La propia ausencia puede informar sobre el estado únicamente a través de un mecanismo especificado.
Los modelos conjuntos pueden compartir efectos individuales entre la trayectoria y las visitas, o hacer depender la intensidad del estado latente actual. Esa flexibilidad introduce hipótesis que quizá no puedan identificarse bien a partir del archivo. Si varios modelos de estado e intensidad explican de forma parecida los datos observados, una distribución previa muy restrictiva puede determinar la reconstrucción de los intervalos sin observar. El análisis de sensibilidad y la comprobación de las predicciones sobre el calendario de visitas ayudan a ver de dónde viene la información.
Una comprobación útil debe incluir tanto las mediciones como los tiempos. Reproducir el histograma de valores sin reproducir las pausas largas, los agrupamientos de visitas o su asociación con lecturas anteriores deja una parte del modelo sin contrastar. Pueden generarse calendarios y mediciones de forma conjunta para comparar esas características con las observadas. Las discrepancias indicarán qué componente necesita revisión.
Calendarios adaptativos e ignorabilidad
Supongamos que una lectura ya registrada determina la fecha de la medición siguiente; tras un valor alto se programa una visita próxima y tras uno bajo se espera más. La decisión usa información observada. Una adaptación así puede ser compatible con la ignorabilidad para ciertos parámetros si, dada la historia pertinente, no queda una relación adicional entre la decisión y el resultado siguiente que deba modelarse.
Farewell, Huang y Didelez (2017) formularon esta cuestión en términos de procesos longitudinales de observación, sin exigir una cuadrícula de datos completos que faltan. Su condición de estabilidad compara la distribución de una nueva medición bajo el régimen natural de observación con la que tendría bajo un régimen que impone las fechas, una vez condicionada la historia relevante. Es una condición suficiente que liga el proceso de observación con la inferencia deseada.
El mismo calendario puede dejar de cumplirla si quien decide cuándo medir percibe un cambio que no aparece en los registros anteriores. Una señal informal, un deterioro del equipo o una impresión del participante pueden influir a la vez en la próxima visita y en su resultado sin quedar necesariamente recogidos en las lecturas previas.
La distinción tiene consecuencias prácticas al diseñar el registro. Si la decisión adaptativa sigue una regla explícita basada en variables conservadas, puede reconstruirse qué información la produjo, mientras que si depende de señales no registradas, la hipótesis necesaria para omitir su mecanismo será más difícil de sostener.
Observación reactiva
Hasta aquí, observar consistía en seleccionar datos de una trayectoria que no cambiaba por ser medida. La observación reactiva añade otro mecanismo. Una solicitud puede interrumpir una actividad, dirigir la atención hacia una sensación o provocar una comprobación que afecta al comportamiento posterior. Puede también cambiar solo el criterio con que se responde, sin tocar el estado que se pretendía medir.
Para separar selección y reacción consideremos un modelo didáctico de actividad centrada en cero,
El indicador vale uno cuando se solicita una medición. La lectura corresponde al estado inmediatamente anterior a la posible reacción; después, la solicitud introduce el cambio representado por su coeficiente. Las innovaciones tienen media cero y varianza . Las solicitudes se sortean con probabilidad , de forma independiente entre ocasiones y respecto del estado previo.
En régimen estacionario la media cumple , de donde . Un protocolo que solicita medir en una quinta parte de las ocasiones da una media de ; otro que lo hace en cuatro quintas partes, de . La diferencia es de unidades. Sin solicitudes, la media del proceso definido sería cero.
La selección actual no favorece a ningún estado, puesto que el sorteo de la solicitud es independiente del estado que se lee. Las solicitudes anteriores, sin embargo, ya cambiaron la distribución de ese estado. Corregir probabilidades de observación no devuelve automáticamente la dinámica que existiría bajo un protocolo sin solicitudes. La pregunta pasa a ser causal y concierne al efecto de cambiar una política de medición.
El signo y la magnitud del coeficiente son supuestos del ejemplo y no son estimaciones de ningún efecto psicológico general. La ecuación distingue dos preguntas que un mismo registro puede suscitar. Una es cómo se comporta el sistema durante un protocolo y la otra, cómo se comportaría si el protocolo cambiara. Responder a la segunda exige condiciones sobre la intervención y sobre los mecanismos que siguen vigentes.
Si la medición cambia la respuesta comunicada sin alterar la actividad subyacente, el efecto debería entrar en la ecuación de observación, sin que tenga que afectar necesariamente a la transición del estado. Una persona puede aprender a usar una escala de forma más consistente, o responder con menos detalle a medida que se habitúa. Una reducción de variabilidad en los informes puede surgir de ese cambio de medición sin que la actividad real se haya estabilizado.
Diseños para estudiar la reactividad
McCambridge, Witton y Elbourne (2014) revisaron estudios sobre los efectos de participar en investigaciones y encontraron una heterogeneidad considerable en exposiciones, diseños y resultados. La etiqueta «efecto Hawthorne» agrupa situaciones distintas y no da una magnitud universal con la que corregir un registro. Identificar el contraste concreto entre protocolos resulta más informativo que atribuir cualquier tendencia al hecho de haber sido observado.
Ottenstein, Hasselhorn y Lischetzke (2024) compararon, por asignación aleatoria, protocolos de tres y de nueve solicitudes diarias durante la primera semana analizada de un estudio con 313 estudiantes. La claridad emocional aumentó a lo largo de la semana sin una diferencia detectable en su evolución entre grupos. Las preguntas específicas sobre claridad se hacían tres veces al día en ambos grupos; la mayor frecuencia afectaba a otros contenidos del protocolo.
Ese diseño permite examinar la consecuencia de asignar uno u otro de los protocolos comparados, pero no enfrenta medición repetida con ausencia de medición. Una tendencia compartida podría deberse a la reactividad, a cambios corrientes durante la semana o a otra característica común de la participación. Tampoco una diferencia no significativa establece la equivalencia exacta entre protocolos. Estas son limitaciones del contraste disponible, se interprete como se interprete la tendencia descriptiva.
Para estudiar el efecto de medir sobre un estado posterior puede sortearse la exposición a solicitudes y mantener una medida de resultado comparable entre grupos. El momento de esa medida importa, porque tomada varios días después evalúa el efecto acumulado del protocolo, mientras que tomada justo tras una solicitud responde a una perturbación de corto plazo. El diseño debe separar, además, el acto de preguntar de cualquier retroalimentación o recomendación que lo acompañe.
En estudios de una sola persona, alternar protocolos obliga a considerar efectos que persisten entre periodos, ya que el estado con que empieza un periodo puede depender de las solicitudes del anterior. Un orden aleatorio ayuda a separar ciertas diferencias, pero no borra esa memoria. Si se espera un arrastre relevante, la transición entre protocolos debe incorporarse al análisis o al diseño.
Que las solicitudes se asignen al azar tampoco asegura que todas reciban respuesta. Si el cumplimiento depende del estado, el contraste entre quienes contestaron puede perder la comparabilidad inicial. Guardar las solicitudes enviadas, su asignación y las respuestas permite distinguir el efecto de ofrecer un protocolo del efecto de completar sus mediciones. Ambas cantidades pueden interesar y requieren argumentos distintos.
Registrar por qué aparece cada fila
Un archivo que conserva solo respuestas completas pierde el denominador de oportunidades. Conviene distinguir ocasiones programadas, solicitudes efectivamente emitidas y respuestas recibidas. En una visita espontánea interesan la regla de entrada y la exposición durante la cual podría haberse producido. En los dispositivos automáticos, el tiempo de funcionamiento ayuda a separar un silencio del proceso de un silencio del instrumento.
Los motivos de ausencia pueden ser informativos, aunque también deben evaluarse. Una categoría administrativa como «no disponible» puede reunir fallos técnicos, rechazos y estados que dificultan responder. Tratarla como si identificara un mecanismo único introduciría una homogeneidad que el registro no respalda. Hacer un seguimiento de una parte de esas ausencias puede resultar más útil que multiplicar indiscriminadamente las solicitudes al resto.
En el ejemplo binario, el registro inicial contiene ciento veinte unos observados, quinientos cuarenta ceros observados y trescientas cuarenta unidades sin resultado. Saber si la proporción total ronda o exige distinguir una proporción de unos entre los ausentes cercana a un quinto de otra cercana a cuatro quintos. Un seguimiento diseñado para estimar esa proporción aborda directamente la incertidumbre que los datos originales dejaron abierta.
Referencias
Farewell, D., Huang, C., & Didelez, V. (2017). Ignorability for general longitudinal data. Biometrika, 104(2), 317–326. https://doi.org/10.1093/biomet/asx020
Lin, H., Scharfstein, D. O., & Rosenheck, R. A. (2004). Analysis of longitudinal data with irregular, outcome-dependent follow-up. Journal of the Royal Statistical Society: Series B, 66(3), 791–813. https://doi.org/10.1111/j.1467-9868.2004.b5543.x
McCambridge, J., Witton, J., & Elbourne, D. R. (2014). Systematic review of the Hawthorne effect: New concepts are needed to study research participation effects. Journal of Clinical Epidemiology, 67(3), 267–277. https://doi.org/10.1016/j.jclinepi.2013.08.015
Ottenstein, C., Hasselhorn, K., & Lischetzke, T. (2024). Measurement reactivity in ambulatory assessment: Increase in emotional clarity over time independent of sampling frequency. Behavior Research Methods, 56, 6150–6164. https://doi.org/10.3758/s13428-024-02346-y
Pullenayegum, E. M., & Lim, L. S. H. (2016). Longitudinal data subject to irregular observation: A review of methods with a focus on visit processes, assumptions, and study design. Statistical Methods in Medical Research, 25(6), 2992–3014. https://doi.org/10.1177/0962280214536537
Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
Seaman, S., Galati, J., Jackson, D., & Carlin, J. (2013). What is meant by “missing at random”? Statistical Science, 28(2), 257–268. https://doi.org/10.1214/13-STS415