Cuatro transiciones seguidas sin cambiar de estado pueden parecer señal de una gran persistencia. También pueden ser una secuencia poco informativa, porque con tan pocas ocasiones todavía no hemos visto cómo responde el sistema cuando cambia. Si otro individuo muestra diez permanencias y dos cambios, su proporción de permanencias es menor y su trayectoria, sin embargo, contiene más información. Comparar ambos cocientes como si tuvieran la misma precisión confunde una diferencia estimada con una diferencia bien establecida.
Los modelos jerárquicos permiten estudiar esas trayectorias en conjunto. Cada individuo conserva sus propios parámetros dinámicos, mientras una distribución compartida describe cómo varían de un individuo a otro. La trayectoria propia informa sobre el parámetro personal y las demás, sobre los valores plausibles para individuos comparables. Cuánta información circula entre ambos niveles depende de la heterogeneidad admitida y de lo que enseña cada registro.
Nivel habitual, persistencia y amplitud
Una representación sencilla de una medida continua separa el nivel habitual de la desviación momentánea,
El subíndice identifica al individuo y una ocasión de medida. El parámetro es su media bajo el régimen descrito y indica qué parte de una desviación anterior persiste, en promedio, una ocasión después. Las innovaciones tienen media cero y varianza y, bajo este modelo, se suponen independientes del pasado. Por ahora las ocasiones están igualmente espaciadas y no hay error de medición adicional.
Dos individuos pueden tener medias muy distintas y compartir la misma dinámica de desviaciones, como en una construcción didáctica en la que uno tiene media diez y el otro treinta, ambos con . En los dos, una desviación de dos unidades por encima de la media propia anticipa una desviación de unidades en la ocasión siguiente. El mecanismo de retorno es el mismo, aunque sus valores habituales estén separados por veinte unidades.
Si la ecuación se escribe directamente para la medida observada, el intercepto es , que en esos dos casos vale cuatro y doce. El intercepto de una autorregresión y la media de su proceso son, pues, cantidades diferentes. Comparar interceptos sin tener en cuenta la persistencia puede mezclar diferencias de nivel con diferencias dinámicas.
La amplitud de las fluctuaciones es un tercer parámetro. Para , la varianza estacionaria de las desviaciones es . Con la persistencia fija en , innovaciones de varianza dan una varianza total de y, si la varianza de las innovaciones sube a , la total pasa a uno. El segundo registro fluctúa más, aunque conserva exactamente la misma fracción de una desviación entre ocasiones.
Jongerling, Laurenceau y Hamaker (2015) desarrollaron un modelo autorregresivo multinivel que admite diferencias individuales en el nivel, la autorregresión y la varianza de innovación. La separación importa porque atribuir a la persistencia toda diferencia de variabilidad restringe sin motivo las explicaciones posibles. En sus simulaciones, imponer una varianza de innovación común cuando había heterogeneidad podía sesgar las estimaciones. La consecuencia depende del modelo y del diseño, sin que haya una corrección numérica aplicable a cualquier serie.
Diferencias dentro de cada persona y entre personas
Una asociación dentro de una persona compara sus ocasiones entre sí y una asociación entre personas compara sus características habituales. La diferencia existe antes de elegir cualquier estimador. Si se registran una actividad y un resultado, preguntar qué ocurre cuando alguien hace más actividad que de costumbre exige conocer esa costumbre individual, mientras que comparar a las personas habitualmente más activas con las demás responde a otra pregunta.
El modelo puede representar ambas relaciones descomponiendo el predictor temporal en un nivel personal y una desviación respecto de él, con cada coeficiente ligado a la variación que lo identifica. Usar una sola pendiente para los valores sin descomponer impone entre ambos niveles una relación que puede ser poco razonable. La formulación jerárquica hace explícitas esas restricciones y deja decidir cuáles conservar.
En una autorregresión surge una dificultad especial, porque el predictor rezagado procede de la misma serie que se quiere explicar. Una media calculada con pocas observaciones no es una constante conocida y ajena al proceso. Al restarla se combinan valores serialmente dependientes y, además, el procedimiento de estimación de la pendiente arrastra sus propios efectos de muestra pequeña.
Hamaker y Grasman (2015) mostraron que centrar por individuo el resultado rezagado puede sesgar a la baja la estimación de la autorregresión media en varias de las formulaciones que examinaron. Sus recomendaciones cambian cuando el objetivo es estimar cómo se relaciona una covariable individual con esa autorregresión. El trabajo no prohíbe el centrado en general, pero exige especificar qué parámetro se quiere estimar y con qué modelo.
Una alternativa es tratar las medias individuales como cantidades desconocidas dentro del modelo conjunto. Asparouhov, Hamaker y Muthén (2018) distinguen ese centrado latente del uso directo de medias muestrales en su formulación de ecuaciones estructurales dinámicas. La incertidumbre sobre el nivel personal pasa entonces a formar parte de la inferencia. Esa decisión evita tratar como exacta una estimación previa, pero no convierte automáticamente cualquier estimador ni cualquier serie corta en una fuente de información suficiente.
La distribución compartida
En el modelo continuo anterior, una distribución poblacional podría describir a la vez las medias, las persistencias y las escalas de innovación. Conviene respetar el dominio de cada parámetro. Una normal aplicada directamente a una varianza admitiría valores negativos. Aplicada sin restricciones a la autorregresión, podría dar masa a procesos no estacionarios aunque el análisis pretenda describir fluctuaciones estacionarias.
Una parametrización posible asigna una normal multivariante a , con y . Al deshacer la transformación quedan y escalas positivas. La matriz de covarianzas admite que los individuos con mayor persistencia tiendan a tener también mayor, o menor, variabilidad de innovación.
La parametrización elegida condiciona la distribución compartida. Suponer independientes un intercepto autorregresivo y una persistencia no equivale a suponer independientes la media personal y esa persistencia, ya que la media se obtiene dividiendo el intercepto por uno menos el coeficiente autorregresivo. En otro cálculo didáctico, un intercepto de cuatro corresponde a una media de diez cuando la persistencia es y a una media de cuarenta cuando es .
Una distribución en apariencia sencilla para interceptos y persistencias puede inducir así valores extremos o relaciones fuertes entre las medias resultantes. Antes de ajustar es buena práctica generar parámetros desde la previa y traducirlos a las cantidades que se van a interpretar (niveles habituales, amplitudes, tiempos de retorno), para detectar restricciones involuntarias. Si se cambia de parametrización conservando exactamente la distribución conjunta transformada, la inferencia probabilística es la misma; si se imponen previas independientes nuevas, el modelo es otro.
En una dinámica multivariante, donde cada individuo tiene una matriz de coeficientes, restringir por separado sus elementos al intervalo entre menos uno y uno no es suficiente para asegurar la estabilidad conjunta. Cuando esa propiedad forma parte del modelo, la distribución jerárquica debe respetar las condiciones de estabilidad de cada matriz. Comprobar solo la matriz promedio dejaría pasar individuos cuyas ecuaciones producen trayectorias incompatibles con el régimen que se quiere describir. Las simulaciones previas tienen que conservar, por eso, matrices individuales completas y examinar sus trayectorias.
Las covarianzas de la distribución poblacional describen asociaciones entre características dinámicas de los individuos. Esas covarianzas no muestran que modificar un parámetro provoque un cambio en otro y pueden reflejar también características omitidas del entorno o del instrumento. La jerarquía organiza la comparación estadística; una explicación causal exige identificar mecanismos y variaciones pertinentes.
La intercambiabilidad entre individuos se entiende de forma condicional. Una vez incorporadas las covariables que el modelo considera relevantes, los parámetros individuales proceden de una misma distribución, lo que no les asigna el mismo valor. Si dos grupos tienen contextos muy diferentes, puede hacer falta darles distribuciones distintas o explicar esa diferencia mediante covariables.
El ajuste separado estima cada trayectoria sin compartir información; el completamente agrupado impone parámetros comunes. La combinación parcial ocupa un lugar intermedio, pues admite diferencias y usa la distribución compartida para regularizar los parámetros poco informados. Con trayectorias breves, el resultado puede depender mucho de esa distribución, mientras que con trayectorias largas y bien observadas suele pesar más la información individual, siempre que el modelo represente adecuadamente el proceso.
La distribución compartida no tiene por qué ser conocida y sus parámetros reciben una inferencia propia. Reemplazarlos por una única estimación y seguir como si fueran ciertos omite una fuente de incertidumbre. Un modelo dinámico binario muestra cómo se conserva esa fuente sin recurrir a aproximaciones complicadas.
Tres trayectorias y cuatro poblaciones posibles
El ejemplo siguiente es artificial. Cada individuo ocupa uno de dos estados, representados por menos uno y uno. En cada intervalo tiene probabilidad de permanecer en el estado actual y de cambiar, con probabilidades iguales en ambas direcciones, constantes durante el registro y propias de cada individuo. Dados el estado actual y , el pasado anterior no aporta información adicional y las trayectorias se suponen independientes dados sus respectivos parámetros.
La matriz de transición tiene en la diagonal y fuera de ella, de modo que la esperanza del estado siguiente es . El valor expresa persistencia positiva cuando permanecer es más probable que cambiar y alternancia en el caso contrario. En régimen estacionario los dos estados se ocupan por igual y la autocorrelación en el primer retardo vale . Variar este parámetro modifica la duración de las secuencias sin tocar esa ocupación estacionaria.
Todos los intervalos observados duran una unidad temporal. El estado inicial se fija en uno, la inferencia se condiciona a él y las secuencias se registran completas, sin ausencias. A muestra cuatro unos, cuatro valores menos uno y cinco unos; B, cinco unos consecutivos; C alterna bloques de dos valores iguales y termina con un uno adicional. La tabla resume sus transiciones.
| Individuo | Transiciones observadas | Permanencias | Cambios | Proporción de permanencias |
|---|---|---|---|---|
| A | 12 | 10 | 2 | 0,833 |
| B | 4 | 4 | 0 | 1,000 |
| C | 12 | 6 | 6 | 0,500 |
Bajo estos supuestos concretos, los números de permanencias y de cambios contienen la información de la trayectoria sobre . Si valen y , la verosimilitud de la secuencia condicionada al inicio es . El resumen dejaría de bastar si la transición dependiera del tiempo que lleva ocupado un estado, del calendario o de estados anteriores adicionales.
La jerarquía supone que los parámetros individuales son independientes entre sí dadas una media poblacional y una concentración ,
La media de esta distribución es y su varianza entre individuos, , por lo que, para una misma media, una concentración grande describe parámetros más parecidos entre sí. La concentración no corresponde al número de individuos realmente observados, aunque aparezca algebraicamente como una cantidad de información previa.
Para que el cálculo pueda seguirse entero, admitimos cuatro configuraciones, con medias de o combinadas con concentraciones de cuatro o veinte, cada una con probabilidad previa de un cuarto. Es una elección didáctica explícita, con apenas cuatro posibilidades para la población. Un análisis aplicado podría requerir distribuciones continuas mucho más flexibles, pero aquí interesa ver con exactitud cómo cambia el peso de cada posibilidad.
Inferencia conjunta sobre la heterogeneidad y los parámetros personales
Si y fueran conocidos, la posterior individual sería
donde designa las tres trayectorias. Su media es . Dados esos hiperparámetros, la información de las otras trayectorias no entra de nuevo en la distribución individual y su aporte consiste en modificar lo que sabemos de los hiperparámetros compartidos.
La probabilidad marginal de cada trayectoria se obtiene integrando su parámetro. Si denota la función beta, el factor resultante es
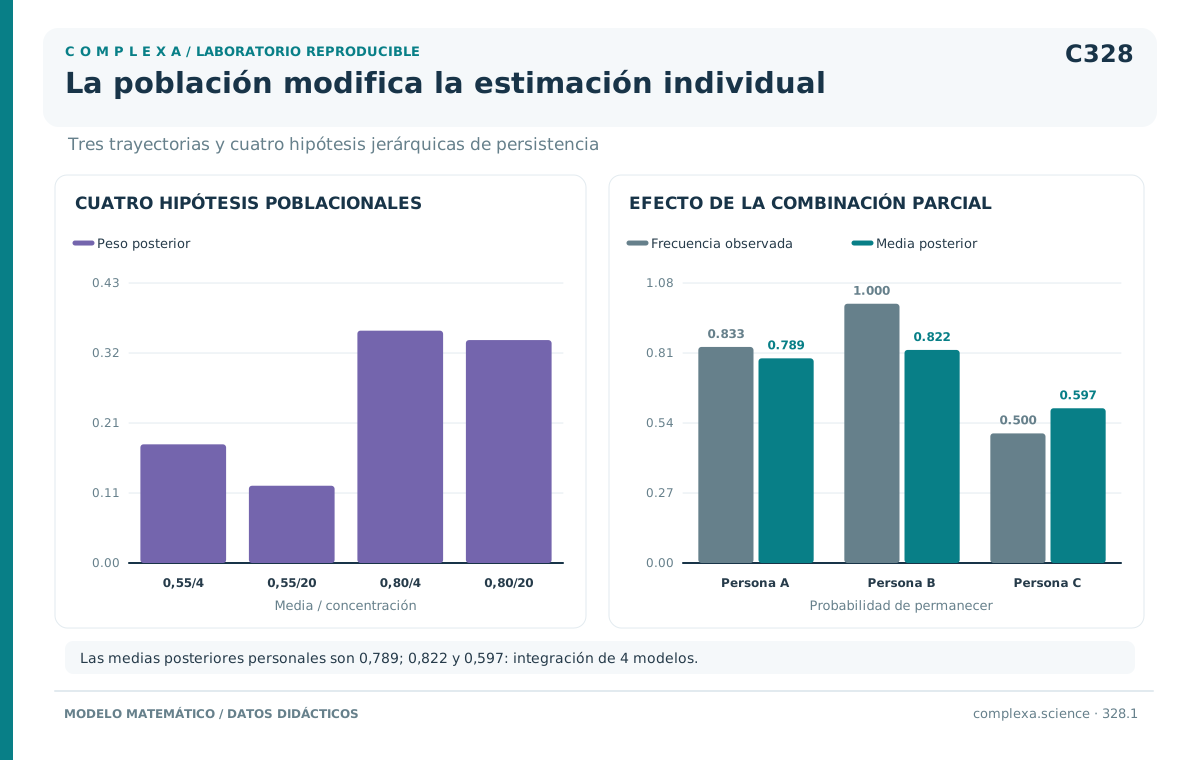
Se multiplican los tres factores por la probabilidad previa de la configuración y se normaliza entre las cuatro posibilidades, sin elegir de antemano la configuración de máxima verosimilitud ni fijar la heterogeneidad en su valor más probable. La tabla muestra los pesos posteriores.
| Media poblacional | Concentración | Probabilidad posterior |
|---|---|---|
| 0,55 | 4 | 0,182 |
| 0,55 | 20 | 0,119 |
| 0,80 | 4 | 0,357 |
| 0,80 | 20 | 0,342 |
Los datos favorecen la media poblacional alta, con una probabilidad posterior marginal de alrededor de 0,699, pero distinguen bastante peor la concentración, cuya probabilidad de valer veinte es 0,461, cerca de la mitad. Tres individuos con estas trayectorias no determinan bien cuánto varían los parámetros entre los miembros de la población.
La posterior de cada es una mezcla de cuatro distribuciones beta ponderadas por esos pesos. Para B, las medias condicionales son, en el orden de la tabla, y su dispersión muestra cuánto cambia la lectura de cuatro permanencias según la población de referencia. El promedio posterior integra todas esas posibilidades y evita quedarse con una ocultando las demás.
Su incertidumbre puede descomponerse en dos partes. Dentro de cada configuración persiste la incertidumbre sobre el parámetro personal, mientras que entre configuraciones cambian las medias que se le atribuyen. La varianza posterior total es la suma del promedio de las varianzas condicionales y de la varianza de las medias condicionales, ambos términos calculados con los pesos posteriores.
Para B, la primera parte vale aproximadamente 0,0101 y la segunda 0,00722, de modo que la varianza total es 0,0173 y la desviación típica 0,132. La incertidumbre sobre la población supone una fracción considerable de ese total. Fijar una configuración eliminaría la segunda parte y cambiaría además la varianza individual utilizada. Calcular con cuidado un intervalo condicionado a una población seleccionada no basta para recuperar la incertidumbre que se descartó al seleccionarla.
La combinación parcial tampoco obliga a que todos se desplacen la misma distancia hacia un centro único, porque los recuentos individuales tienen distinta fuerza y la distribución poblacional es incierta. En este ejemplo, la estimación de C sube respecto de su proporción observada y las de A y B bajan, en direcciones que dictan los datos y la jerarquía especificada.
Incertidumbre de las comparaciones individuales
Las medias posteriores de las probabilidades de permanencia son para A, para B y para C. Los intervalos centrales de credibilidad del 90 % son, respectivamente, , y . Se obtienen con los cuantiles de cada mezcla completa; promediar los extremos de cuatro intervalos separados no daría el mismo resultado.
B conserva la media más alta, pero su intervalo es ancho. No haber observado ningún cambio en cuatro transiciones no demuestra que cambiar sea imposible. La estimación separada por máxima verosimilitud cae en el borde, igual a uno, mientras que la inferencia jerárquica admite probabilidades menores y cuantifica el apoyo que reciben.
Para comparar A y B puede calcularse directamente , que resulta cercana a 0,620. El orden de las medias, por sí solo, escondía que la evidencia sobre cuál de los dos es más persistente es modesta. Los parámetros, además, no son marginalmente independientes en la posterior, ya que comparten la incertidumbre sobre la población. El cálculo de la comparación conserva esa dependencia integrando primero dentro de cada configuración y después entre configuraciones.
Expresada como autorregresión, la persistencia media posterior de C es , aproximadamente . Su intervalo para la probabilidad de permanencia, sin embargo, incluye el valor un medio, de manera que el modelo todavía admite alternancia, ausencia de persistencia o persistencia positiva. Una sola etiqueta basada en el signo de la estimación central borraría esa información.
La influencia de la previa puede medirse. Si se asigna una probabilidad previa total de 0,8 a la concentración veinte, repartida por igual entre las dos medias, su probabilidad posterior sube a 0,774. La media posterior de B baja de 0,822 a 0,797 y la de C sube de 0,597 a 0,626. Las trayectorias son las mismas; lo que cambió es cuánto apoyo inicial recibe una población relativamente homogénea.
La comparación sitúa la sensibilidad en un supuesto interpretable. La previa de mayor concentración acerca más los parámetros entre sí y, con solo tres individuos, los datos no contrarrestan del todo esa preferencia. Informar ambos resultados ayuda a separar una conclusión sólida sobre las transiciones observadas de otra que depende más del modelo de heterogeneidad.
El reparto de las transiciones entre individuos
Los tres registros suman veinte permanencias y ocho cambios. Si impusiéramos un único parámetro común, su estimación de máxima verosimilitud sería , aproximadamente . Bajo esa restricción, el reparto de esas transiciones entre personas no modificaría la estimación, porque todos los factores individuales se reducen al mismo parámetro elevado al número total de permanencias o de cambios.
La jerarquía usa además dónde ocurrieron. Mantengamos el número de transiciones de cada individuo y los totales conjuntos, pero cambiemos el reparto para que A tenga doce permanencias y ningún cambio, B conserve sus cuatro permanencias sin cambios y C presente cuatro permanencias y ocho cambios. Es otro conjunto didáctico posible, con los mismos totales de permanencias y de cambios.
Ahora A y C contrastan mucho más. Con la misma previa de cuatro configuraciones, la probabilidad posterior de la concentración veinte cae de 0,461 a 0,069 y las configuraciones con más dispersión entre individuos se quedan con casi toda la probabilidad restante. La estimación completamente agrupada seguiría en 0,714 porque no utiliza esa asignación individual.
El cálculo explica por qué un mismo total de observaciones puede significar cosas diferentes. Doce transiciones de una persona aportan información repetida sobre su parámetro, pero una transición de cada una de doce personas corresponde a doce parámetros potencialmente distintos. La contribución a la heterogeneidad poblacional cambia aunque el número de filas y el de permanencias coincidan.
Aclara también qué puede conservarse al resumir los datos. Para la cadena simétrica y homogénea, los recuentos separados por individuo bastan para estimar los parámetros propuestos, pero agregarlos elimina información que la jerarquía necesita. Ni siquiera los recuentos por individuo permiten comprobar todas las hipótesis temporales, porque dos trayectorias con los mismos recuentos pueden concentrar los cambios al principio o al final y esa ubicación ayuda a ver si la probabilidad fue realmente constante.
Por ello, una reducción suficiente para estimar bajo un modelo no es necesariamente suficiente para revisarlo. El archivo completo permite investigar cambios de régimen y dependencias del tiempo transcurrido. Los recuentos vuelven transparente el cálculo del ejemplo y el orden original permite interrogar las restricciones que lo hicieron tan sencillo.
Predicción con la posterior completa
Supongamos que B termina en el estado uno, como en el registro. La probabilidad predictiva de que siga en uno en la ocasión siguiente es la media posterior de , cerca de 0,822. Para esa predicción a un paso basta la media del parámetro, ya que la probabilidad condicional es lineal en él.
A dos pasos la situación cambia, porque B puede estar en uno tras permanecer dos veces o tras cambiar dos veces. Dado su parámetro, la probabilidad de terminar en el mismo estado es . Integrando sobre la posterior completa se obtiene 0,742. Si se reemplazara el parámetro por su media antes de calcular, se obtendría 0,707.
La diferencia equivale a dos veces la varianza posterior de , aproximadamente 0,0347. Procede de la curvatura de la función predictiva. Una distribución de parámetros y un parámetro promedio pueden dar la misma respuesta a una pregunta lineal y respuestas distintas a otra. Terminar en el mismo estado al cabo de dos pasos y no haber cambiado durante el intervalo son sucesos diferentes, porque el primero incluye la trayectoria de ida y vuelta.
Para cuatro permanencias futuras consecutivas, la probabilidad condicional es , cuyo promedio posterior vale 0,520, frente a 0,456 si se eleva la media posterior a la cuarta potencia. Las posibilidades de persistencia muy alta que contiene la mezcla pesan especialmente en las secuencias largas y se pierden al reducir la posterior a su centro.
En una predicción de varios pasos, el parámetro personal se mantiene fijo dentro de cada trayectoria simulada. Se extrae de su posterior y luego se generan las transiciones condicionadas a él. Extraer un parámetro independiente antes de cada paso describiría otro proceso, en el que la propensión individual cambia al azar entre ocasiones. El error puede pasar inadvertido porque reproduce algunas probabilidades a un paso mientras altera las secuencias completas.
Para un individuo nuevo, todavía sin transiciones observadas, la predicción usa la distribución poblacional posterior. Su probabilidad esperada de permanecer es 0,725, distinta de la de B, con una incertidumbre que incluye tanto la dispersión entre individuos como lo que ignoramos de la población. A medida que llegan observaciones del nuevo individuo, la inferencia se desplaza hacia las probabilidades compatibles con su trayectoria.
En aplicaciones continuas ocurre algo parecido. Predecir la próxima observación de una persona conocida integra sus parámetros, su estado actual si es latente y la innovación futura. Predecir para alguien nuevo agrega la distribución de sus parámetros personales. Un intervalo para la media poblacional no reemplaza ninguno de esos intervalos predictivos.
La evaluación debe ajustarse a la pregunta. Reservar el tramo final de las personas ya observadas pone a prueba la extrapolación temporal dentro de sus trayectorias; reservar personas enteras, la transferencia a individuos nuevos. En este segundo caso, sus datos deben quedar fuera de la estimación de la distribución compartida durante el entrenamiento. Si se admite una etapa inicial de calibración personal, hay que definir cuántas observaciones estarán disponibles antes de evaluar las siguientes.
Persistencia y unidad de tiempo
El parámetro de transición de nuestro ejemplo corresponde a un intervalo fijo. Si unas personas se observan cada hora y otras cada tres, comparar directamente sus coeficientes discretos puede crear diferencias aparentes, porque una fracción menor conservada tras tres horas puede deberse al mismo ritmo de retorno que una fracción mayor conservada tras una.
En un proceso continuo de retorno lineal con tasa positiva , la persistencia tras un intervalo es . Para una tasa didáctica de por hora vale a una hora y a tres horas. El tiempo que tarda en reducirse a la mitad una desviación media es , aproximadamente horas. Ambos coeficientes discretos describen aquí el mismo parámetro individual.
Driver y Voelkle (2018) presentaron una formulación jerárquica bayesiana de modelos dinámicos continuos con variación individual en los parámetros. Con ella puede compartirse información sobre tasas u otras propiedades dinámicas definidas en una escala temporal común, incorporando los intervalos reales de observación. La transformación exponencial anterior corresponde al proceso escalar de retorno lineal y no transforma cualquier cadena discreta, en especial una alternante, en ese mismo proceso continuo.
Hay que distinguir también entre escala temporal y cambio de régimen. Una noche puede ser un intervalo más largo dentro del mismo mecanismo o incluir actividades y condiciones que lo modifican. De Haan-Rietdijk, Kuppens y Hamaker (2016) estudiaron cómo separar la variación entre momentos, días y personas. Mostraron que un desplazamiento compartido por las observaciones de un día puede confundirse con persistencia entre momentos si el modelo omite ese nivel.
Añadir de oficio un efecto diario tiene sus propios riesgos, ya que una estructura innecesaria puede absorber variación atribuible a la dinámica que se quiere estimar. La elección debe hacerse confrontando modelos que representen la dependencia temporal relevante. En diseños con interrupciones nocturnas, enlazar el último registro de un día con el primero del siguiente como si fueran dos ocasiones corrientes impone una equivalencia temporal que necesita justificación.
Diferencias del proceso y diferencias del registro
Una autocorrelación observada menor puede deberse a un mayor error de medición. Supongamos una trayectoria latente estacionaria de varianza uno y autorregresión , observada en cada lectura con un error de varianza uno, independiente entre lecturas y de la propia trayectoria. La covarianza entre lecturas consecutivas sigue siendo , pero la varianza de cada lectura sube a dos. La autocorrelación observada cae así a .
Si dos individuos difieren en la precisión con que se los mide, un modelo que trate ambas series como observaciones exactas puede atribuir al proceso diferencias que introdujo el instrumento. Separar estado y medición exige información capaz de hacerlo, como indicadores repetidos, conocimiento del instrumento o una estructura temporal suficientemente informativa. Dar nombres distintos a dos componentes de varianza no garantiza que los datos los distingan.
La escala de las variables condiciona además la comparación de relaciones multivariantes. Para una pendiente temporal que vincula una desviación de con una desviación posterior de , la estandarización dentro de la persona usa sus desviaciones típicas propias. Estandarizar con la dispersión total de la muestra incorpora diferencias entre personas y responde a otra comparación.
Schuurman, Ferrer, de Boer-Sonnenschein y Hamaker (2016) desarrollaron esta distinción para modelos autorregresivos multivariantes multinivel. Una relación en unidades originales y una estandarizada expresan efectos de entradas de distinto tamaño y ambas pueden ser informativas, siempre que se indique cuál se compara. Una pendiente estandarizada grande no es prueba de que una intervención sobre el predictor tenga ese efecto.
Consideremos una pendiente no estandarizada de en dos personas, medidas en las mismas unidades. En la primera, la desviación típica individual de es uno y la de es dos, de modo que la pendiente estandarizada vale . En la segunda esas desviaciones típicas son dos y uno, por lo que la pendiente estandarizada resulta . La relación por unidad de entrada es la misma; lo que cambia es el tamaño relativo de una fluctuación habitual.
Si interesa una diferencia física fija en el predictor, las unidades originales conservan esa comparación; si interesa una desviación típica propia, los coeficientes estandarizados expresan la comparación pertinente. En series cortas las desviaciones típicas son también inciertas y pueden variar con el periodo observado. Incorporar su incertidumbre al modelo evita que una escala mal estimada pase por una característica individual conocida.
Los individuos pueden compartir, además, perturbaciones ajenas a sus parámetros personales. Un cambio ambiental simultáneo, una modificación del procedimiento o un acontecimiento común inducen dependencia entre trayectorias. Suponer independencia condicional dados solo los efectos individuales puede exagerar cuánta información independiente contiene la muestra. Un componente temporal compartido o unas covariables del entorno pueden recoger parte de esa dependencia.
Otra confusión surge cuando los parámetros cambian dentro del individuo durante el estudio, porque entonces un único coeficiente personal resume varios regímenes. La heterogeneidad estimada entre personas puede reflejar que se las observó en fases distintas. Antes de leer esa dispersión como una propiedad estable, conviene examinar si el periodo, las condiciones y el modelo dinámico son comparables.
El valor de una observación adicional
Ampliar el número de individuos, alargar sus trayectorias o cambiar la frecuencia de medición son decisiones de diseño que aportan información de distinta clase. Más individuos ayudan a describir la distribución poblacional; más transiciones informativas por individuo ayudan a separar su parámetro de esa distribución. Medir con más frecuencia dentro de un periodo muy corto puede producir muchas lecturas de un estado casi idéntico y poca evidencia sobre los retornos lentos.
En el ejemplo binario, las comprobaciones del modelo podrían comparar la duración de las secuencias, la frecuencia de cambios según el estado anterior y su evolución a lo largo del registro. La igualdad de las probabilidades de cambio en ambas direcciones es una restricción comprobable cuando hay suficientes transiciones de los dos tipos. Si falla, habría que estimar dos probabilidades y admitir diferencias individuales también en la ocupación habitual.
El modelo jerárquico facilita esa ampliación, aunque los datos deben sostenerla. B todavía no muestra ninguna salida del estado inicial. Su probabilidad de volver desde el otro estado no puede aprenderse de una transición que no ha ocurrido. La simetría del ejemplo permite compartir esa información entre direcciones; al retirarla queda a la vista qué parte de la predicción dependía de la restricción.
Imaginemos ahora que la siguiente lectura de B es menos uno, con lo que su registro suma un cambio a las cuatro permanencias anteriores. Al actualizar toda la jerarquía, su probabilidad media de permanecer baja de 0,822 a 0,725. La de A también se mueve un poco, de 0,789 a 0,764, aunque su trayectoria sea la misma, porque la nueva transición modificó la distribución poblacional que ambos comparten.
El pronóstico siguiente para B parte de su nuevo estado, menos uno, en el que la probabilidad de seguir es ahora 0,725, frente a 0,275 de volver a uno. El cambio recién observado no obliga a declarar que B se volvió otro individuo. Añade a su registro una transición que faltaba y resta apoyo a las explicaciones que volvían muy improbable esa salida.
Referencias
Asparouhov, T., Hamaker, E. L., & Muthén, B. (2018). Dynamic structural equation models. Structural Equation Modeling: A Multidisciplinary Journal, 25(3), 359–388. https://doi.org/10.1080/10705511.2017.1406803
De Haan-Rietdijk, S., Kuppens, P., & Hamaker, E. L. (2016). What's in a day? A guide to decomposing the variance in intensive longitudinal data. Frontiers in Psychology, 7, 891. https://doi.org/10.3389/fpsyg.2016.00891
Driver, C. C., & Voelkle, M. C. (2018). Hierarchical Bayesian continuous time dynamic modeling. Psychological Methods, 23(4), 774–799. https://doi.org/10.1037/met0000168
Hamaker, E. L., & Grasman, R. P. P. P. (2015). To center or not to center? Investigating inertia with a multilevel autoregressive model. Frontiers in Psychology, 5, 1492. https://doi.org/10.3389/fpsyg.2014.01492
Jongerling, J., Laurenceau, J.-P., & Hamaker, E. L. (2015). A multilevel AR(1) model: Allowing for inter-individual differences in trait-scores, inertia, and innovation variance. Multivariate Behavioral Research, 50(3), 334–349. https://doi.org/10.1080/00273171.2014.1003772
Schuurman, N. K., Ferrer, E., de Boer-Sonnenschein, M., & Hamaker, E. L. (2016). How to compare cross-lagged associations in a multilevel autoregressive model. Psychological Methods, 21(2), 206–221. https://doi.org/10.1037/met0000062