Dos distritos publican resultados de una evaluación. En el primero, sesenta de cada cien personas se habían inscrito en un curso preparatorio y aprobaron cuarenta, mientras que en el segundo se inscribieron veinte y aprobaron sesenta. La comparación territorial parece jugar en contra del curso, ya que donde hubo más inscripciones la proporción de aprobados fue menor.
Falta todavía una columna, la de quiénes aprobaron entre quienes se habían inscrito. Sin ese cruce, los mismos porcentajes territoriales son compatibles con una asociación individual positiva, negativa o nula. Los recuentos pueden ser exactos y dejar indeterminada la asociación porque el resumen no conserva quién figura en ambas categorías.
Las cifras de este capítulo son ejemplos didácticos construidos para seguir esa pérdida y ver sus consecuencias. El problema reaparece cuando se conserva el registro individual pero se mezclan personas, ocasiones o composiciones distintas al calcular una sola asociación.
Márgenes conocidos y cruces desconocidos
Cada distrito tiene cien personas. En el primero sabemos que sesenta se inscribieron y cuarenta aprobaron, aunque la intersección puede ir de ninguna a cuarenta personas. En el segundo, con veinte inscritas y sesenta aprobadas, puede ir de ninguna a veinte.
El límite inferior aparece porque no pueden repartirse más personas distintas que las presentes (si entre cien hay ochenta inscritas y setenta aprobadas, al menos cincuenta deben estar en ambas categorías). En general, con población , recuento en la primera categoría y recuento en la segunda, el cruce cumple
Estos límites se deducen solo de que las cuatro celdas sean no negativas, sin necesidad de suponer independencia, normalidad ni relación causal alguna entre las variables. Para los dos distritos del ejemplo admiten 861 combinaciones de cruces enteros.
Supongamos primero que todas las personas aprobadas del primer distrito estaban inscritas (cuarenta aprobadas entre sesenta inscritas y ninguna entre las cuarenta restantes). En el segundo aprobaron las veinte inscritas y cuarenta de las ochenta no inscritas. Al juntar ambos distritos, aprobaron sesenta de las ochenta personas inscritas y cuarenta de las ciento veinte restantes, con proporciones individuales de tres cuartos y un tercio.
Otra distribución igualmente compatible con los datos publicados es aquella en la que ninguna persona inscrita aprobó en ninguno de los dos distritos y los cuarenta aprobados del primero y los sesenta del segundo pertenecen a quienes no se inscribieron. Ahora la proporción de aprobación es cero entre las ochenta personas inscritas y de cinco sextos entre las ciento veinte restantes.
| Distrito | Personas | Inscritas | Aprobadas | Cruce en la primera distribución | Cruce en la segunda |
|---|---|---|---|---|---|
| Primero | 100 | 60 | 40 | 40 | 0 |
| Segundo | 100 | 20 | 60 | 20 | 0 |
La tabla territorial queda intacta mientras la asociación individual cambia de signo. Ni más decimales en los porcentajes ni una regresión más sofisticada sobre esas dos filas recuperan el cruce que falta; harían falta datos conjuntos o supuestos adicionales que restringieran cómo se reparten las personas dentro de cada distrito.
Robinson (1950) formuló el problema de sustituir correlaciones individuales por correlaciones ecológicas, calculadas sobre propiedades de grupos. El adjetivo «ecológico» designa aquí el nivel de agregación, que puede ser el de municipios, centros de trabajo o aulas. Una relación entre distritos es una propiedad de esos distritos y puede servir para una pregunta territorial, pero se incurre en un error cuando se lee como si describiera automáticamente a sus integrantes.
En nuestro ejemplo, la diferencia entre las proporciones individuales de aprobación puede ir de menos cinco sextos a cinco doceavos. Los márgenes sí acotan el resultado, aunque no determinen su signo. La inferencia ecológica puede trabajar con esos límites y explorar supuestos, pero presentar un valor único obliga a declarar qué información adicional permitió elegirlo.
Aun con el cruce real en la mano, la asociación entre inscripción y aprobación no identificaría sin más el efecto del curso. Quienes se inscriben podrían diferir en preparación, tiempo disponible o dificultad inicial. Recuperar la unidad de análisis correcta repara una pérdida de información, pero identificar la respuesta a una intervención plantea otra tarea.
Covarianza dentro y entre grupos
La relación entre niveles puede expresarse sin apelar a ninguna paradoja particular. Sea la pertenencia a un grupo y sean e dos variables con segundos momentos finitos. La identidad de la covarianza total establece
El primer término promedia las covarianzas dentro de los grupos y el segundo mide la covariación de sus medias. Ambos pueden tener signos opuestos. Una asociación global negativa puede convivir con asociaciones positivas dentro de todos los grupos si la separación entre las medias domina la suma.
La identidad se obtiene descomponiendo cada observación en la media de su grupo más una desviación respecto de ella. Al multiplicar las dos descomposiciones aparecen productos dentro del grupo, productos entre medias y términos cruzados cuyo promedio es cero, porque las desviaciones respecto de cada media suman cero dentro de su grupo.
Los pesos forman parte de la igualdad. Si se elige una fila al azar del archivo, la probabilidad de caer en un grupo es proporcional a su número de filas. Si primero se elige una persona con igual probabilidad y después una de sus observaciones, el reparto cambia cuando las personas tienen distinto número de registros. La identidad sigue valiendo, aunque debe aplicarse a la distribución de muestreo que se haya definido.
Veamos un panel mínimo de dos personas observadas durante tres jornadas, en el que son las horas de actividad programada e una puntuación de cansancio, con una escala comparable para ambas personas. Los valores son artificiales.
| Persona | Primera jornada: | Segunda jornada: | Tercera jornada: |
|---|---|---|---|
| A | 1; 7 | 2; 8 | 3; 9 |
| B | 7; 1 | 8; 2 | 9; 3 |
Dentro de cada persona, una hora adicional va acompañada de un punto más de cansancio y la pendiente de cada pequeña recta es uno. Entre personas, en cambio, las medias son y , por lo que quien tiene más horas de actividad muestra menos cansancio medio y la pendiente entre esas dos medias es menos uno.
Para verificar la mezcla usaremos los momentos de la distribución empírica, con divisor igual al número de observaciones. Dentro de cada persona las desviaciones de ambas variables son menos uno, cero y uno, con covarianza de dos tercios. Las medias generales de las dos variables valen cinco y los productos de las desviaciones de las medias personales valen menos nueve para ambas personas, por lo que la covarianza entre medias es menos nueve.
La covarianza global resulta
La varianza global de las horas suma dos tercios dentro de las personas y nueve entre sus medias, en total veintinueve tercios. La pendiente de una regresión que mezcla las seis filas es, por tanto,
Las seis observaciones contienen dos relaciones ascendentes y, cuando se ignora quién es quién, producen una recta descendente. No hay ningún error aritmético. La regresión combinada responde a toda la variación disponible en el archivo, dominada aquí por las diferencias entre personas.
Tampoco sería correcto reemplazar automáticamente la pendiente global por la pendiente entre medias personales y llamarla efecto individual. En este panel esa sustitución daría menos uno, cuando las variaciones dentro de ambas personas tienen pendiente positiva. Para separar las preguntas, el registro tiene que conservar la correspondencia entre persona y ocasión.
Curran y Bauer (2011) desarrollaron la distinción entre asociaciones dentro y entre personas en modelos longitudinales. Una manera de representar el predictor consiste en conservar por un lado su media personal y por otro la desviación de cada ocasión respecto de esa media. La primera variable describe diferencias de nivel habitual; la segunda, desviaciones dentro de cada persona.
Esa separación no suprime por sí sola las tendencias temporales. Si la actividad y el cansancio aumentan a medida que avanza una temporada, restar una media fija deja parte de esa evolución en las dos desviaciones y, para interpretar fluctuaciones alrededor de una trayectoria esperada, habría que modelar esa trayectoria. Dos personas observadas en fases distintas de un proceso pueden tener también medias diferentes por el tramo del calendario que cubrieron.
En el panel construido, las tres jornadas y sus pesos están fijados y sus pendientes describen con exactitud esos seis puntos. Para estimar una relación que se repita fuera del panel habría que representar el error, la dependencia entre jornadas y la variación de las pendientes. La descomposición ayuda a localizar qué componente necesita ese modelo.
La palabra «grupo» no fija una partición única del archivo, puesto que las mismas seis observaciones pueden agruparse también por jornada. En la primera jornada las dos parejas son y , con medias que valen cuatro, mientras que en las jornadas siguientes ambas medias valen cinco y seis, respectivamente.
Dentro de cada jornada, las desviaciones de las dos personas tienen ahora signos contrarios y la covarianza vale menos nueve; entre jornadas, en cambio, las dos medias crecen juntas y su covarianza es dos tercios. La suma sigue siendo menos veinticinco tercios porque ninguna observación ni ningún peso han cambiado y solo cambió la pertenencia a los grupos con que se interpretan los componentes.
Con la partición por personas, la pregunta interna comparaba jornadas de una misma persona; con la partición por jornadas, compara personas observadas el mismo día. Ambas descomposiciones son correctas y responden a contrastes distintos. Si se informa una «asociación dentro de los grupos» sin decir cuál es la agrupación, queda una ambigüedad que puede afectar incluso a su signo.
En los estudios territoriales ocurre algo parecido cuando se modifican los límites de los barrios o se fusionan municipios. La relación entre medias puede cambiar porque cada nuevo grupo reúne otra combinación de observaciones. Conviene conservar la definición de las áreas y comprobar si coincide con la unidad sustantiva de la pregunta. Elegir una partición porque produce la asociación preferida añade al análisis una decisión de selección.
Pesos de personas y de observaciones
Una base longitudinal puede crecer sin sumar personas. Quien aporta muchas mediciones recibe más peso si cada fila cuenta igual. Si una persona tiene dos registros con media dos y otra tiene ocho con media ocho, el promedio de las diez filas es 6,8, mientras que el que da el mismo peso a cada persona es cinco.
Ninguno de los dos resultados es necesariamente un cálculo defectuoso. El primero describe una observación elegida del archivo y el segundo, el nivel medio de una persona elegida entre las dos. Para una pregunta sobre la carga acumulada de registros puede interesar el primero, pero para comparar personas con igual representación el objetivo pertinente es el segundo.
La ponderación interviene también cuando se estima una pendiente común después de centrar por persona. En una regresión sin otros predictores, esa pendiente combina las pendientes individuales con pesos proporcionales a la suma de cuadrados de sus desviaciones en . Una persona cuyo predictor apenas varía aporta poca información sobre su propia pendiente, aun con bastantes registros.
Tomemos otra construcción breve. Para una persona, las desviaciones de y las de son iguales y valen menos uno, cero y uno. Para otra, las desviaciones de son menos tres, cero y tres; las de tienen el signo contrario. Las pendientes individuales valen uno y menos uno, con una media simple de cero.
Como la suma de cuadrados del predictor vale dos en la primera persona y dieciocho en la segunda, una pendiente común ajustada a las seis desviaciones vale
El resultado queda cerca de la pendiente de la segunda persona porque ella aporta nueve veces más variación del predictor. Describirlo como «la pendiente de una persona promedio» ocultaría esa ponderación. Es una pendiente común de mínimos cuadrados para el archivo centrado, bajo la restricción de usar un único coeficiente.
Un modelo jerárquico puede representar la heterogeneidad de pendientes y compartir información entre personas, como vimos en el capítulo anterior, pero su utilidad no transforma una media de parámetros en el parámetro de cada participante. Deben distinguirse la distribución estimada de las diferencias individuales, un promedio elegido dentro de ella y la predicción para una persona concreta.
También hay que comprobar que las variables conserven su significado al cambiar de nivel. Una misma puntuación de cuestionario puede mezclar diferencias en la interpretación de los ítems con diferencias en el atributo de interés. Comparar medias o covarianzas latentes entre personas y ocasiones exige examinar la medición. Centrar los números no produce esa comparabilidad.
El cambio de escala puede alterar el agregado aunque los datos se midan sin error. Dos grupos del mismo tamaño con probabilidades de un décimo y cuatro décimos dan una probabilidad global de un cuarto, con un cociente de un tercio entre la probabilidad del suceso y la de su complemento. Si ese cociente se calcula primero en cada grupo y luego se promedian ambos valores, el resultado es siete dieciochoavos. Cuando la transformación es no lineal, transformar y promediar son operaciones distintas.
Por eso, una discrepancia entre un resumen ajustado y otro agregado no basta para diagnosticar confusión o una paradoja sustantiva. Primero debe establecerse qué escala se usó, cómo se ponderaron las unidades y qué cantidad se está comparando.
Mejora por categoría y caída del total
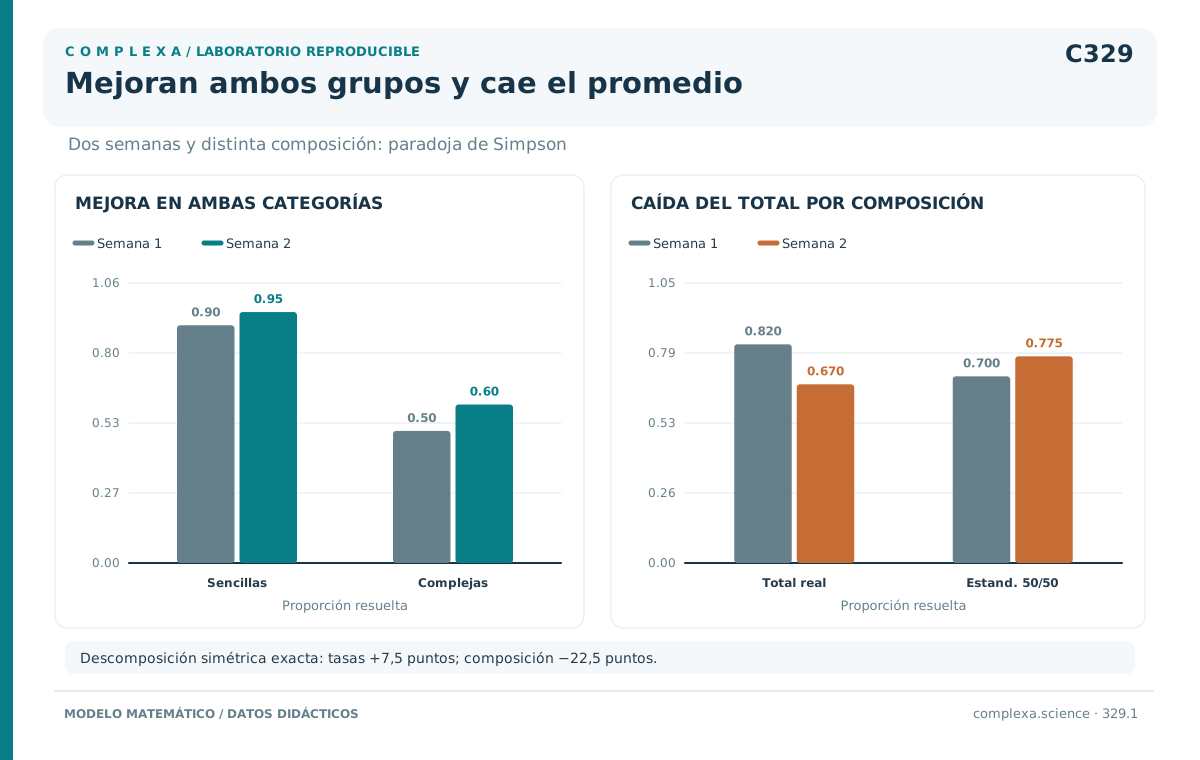
Un servicio de mantenimiento clasifica las incidencias en sencillas y complejas. En una primera semana resuelve 72 de 80 incidencias sencillas y 10 de 20 complejas, con tasas del 90 % y del 50 %. En conjunto resuelve 82 de 100.
Otra semana recibe 20 incidencias sencillas y 80 complejas, de las que resuelve 19 y 48, respectivamente. Las tasas suben al 95 % y al 60 %, pero el total resuelto baja a 67 de 100.
| Semana | Sencillas resueltas/recibidas | Complejas resueltas/recibidas | Total resuelto |
|---|---|---|---|
| Primera | 72/80 | 10/20 | 82/100 |
| Segunda | 19/20 | 48/80 | 67/100 |
La proporción total cae quince puntos porcentuales aunque mejora dentro de ambas categorías, porque el cambio de composición concentra la segunda semana en las incidencias más difíciles. La inversión entre asociaciones condicionadas y agregadas se relaciona con el problema clásico de las tablas de contingencia que examinó Simpson (1951).
Para expresar la cuenta, sea la proporción de incidencias de la categoría en la semana y su tasa de resolución. La tasa total es , que puede cambiar porque varían las tasas específicas, porque cambia la composición o por ambas cosas a la vez.
Una comparación estandarizada aplica los mismos pesos a las dos semanas. Si se da la mitad del peso a cada categoría, las tasas estandarizadas pasan del 70 % al 77,5 % y esa diferencia responde a cómo habrían cambiado los resultados con la composición de referencia definida.
Elegir otra referencia cambia la pregunta. Con la composición de la primera semana, las tasas estandarizadas serían del 82 % y del 88 %, con una mejora de 6 puntos frente a los 7,5 de la referencia anterior. Los pesos de referencia deben acompañar al resultado, porque no hay un promedio estandarizado único que represente todas las composiciones posibles.
La tradición de descomponer diferencias entre tasas se remonta a Kitagawa (1955). Una formulación simétrica reparte la diferencia usando el promedio de las composiciones y el promedio de las tasas de ambos periodos,
El primer sumando recoge la variación de las tasas con composiciones promediadas; el segundo, la variación de la composición con tasas promediadas. Al desarrollar los productos, los términos cruzados se cancelan y queda exactamente la diferencia observada. Oaxaca y Sierminska (2025) examinan esta descomposición y su relación con las formulaciones basadas en regresión.
En el servicio, el componente de tasas suma y el de composición , que juntos dan . La caída total puede describirse entonces como una mejora de 7,5 puntos en el componente de tasas, compensada por una reducción de 22,5 puntos asociada a la composición.
Estos componentes son una atribución contable respecto de la referencia elegida. No identifican cuánto mejoró causalmente el servicio. La dificultad dentro de cada categoría, el personal disponible o el criterio de clasificación podrían haber cambiado. La tabla permite comparar con más precisión lo observado y deja ver qué información adicional exigiría una explicación causal.
Si lo que se quiere es prever cuántas incidencias quedarán pendientes, la composición real sigue siendo pertinente. Estandarizar ayuda a comparar tasas bajo una referencia común, pero no reemplaza la carga que recibió el servicio. En la segunda semana quedaron treinta y tres incidencias sin resolver, pese a que las tasas específicas fueron mejores.
Promedios temporales y promedios de conjunto
Las diferencias entre niveles toman otra forma cuando el grupo es una colección de trayectorias. Una distribución transversal reúne personas en un momento y una distribución temporal reúne ocasiones de una misma persona; aunque tengan el mismo número de observaciones, ambas recorren fuentes de variación distintas.
Molenaar (2004) puso esta distinción en el centro de una discusión sobre la investigación psicológica y la inferencia individual. El concepto de ergodicidad ayuda a precisar cuándo ciertos promedios temporales pueden representar las expectativas de una distribución de conjunto. La pregunta exige definir tanto el proceso como la población a la que corresponde ese conjunto.
En un proceso estacionario ergódico, los promedios temporales de funciones integrables convergen, dentro del marco correspondiente, a sus expectativas respecto de la distribución estacionaria; eligiendo distintas funciones se estudian medias, momentos o relaciones entre variables. Se trata de un enunciado sobre un límite y sus condiciones. No afirma que una media calculada durante diez días deba coincidir exactamente con la de diez personas.
La estacionariedad por sí sola no garantiza esa convergencia hacia una constante común. Puede comprobarse con un modelo completamente especificado,
El término personal se sortea una vez y queda fijo durante toda la trayectoria de esa persona. Los términos personales son independientes entre personas. Los ruidos son independientes entre ocasiones y personas e independientes también de los términos personales. Todos los parámetros se mantienen constantes. Se trata de una construcción matemática y no procede de mediciones de una población real.
En cualquier ocasión, la distribución de conjunto tiene media diez y varianza cinco. Como desplazar el calendario no altera la distribución conjunta de las observaciones, el proceso es estacionario. Por construcción es también gaussiano. Dos ocasiones de la misma persona comparten, sin embargo, el término , por lo que su covarianza vale cuatro sea cual sea la distancia temporal positiva entre ellas.
El promedio de cien ocasiones de una persona contiene su término personal más el promedio de cien ruidos,
Considerando personas y realizaciones del ruido, su varianza es , mientras que si las cien observaciones se trataran como independientes con varianza marginal cinco se obtendría erróneamente . La parte personal no se divide entre cien porque aparece repetida en todas las ocasiones.
Al alargar indefinidamente la trayectoria, el promedio del ruido tiende a cero, pero el promedio observado tiende a . Las diferencias personales persisten (su distribución entre personas conserva varianza cuatro en el límite) y la media de conjunto, igual a diez, no es el promedio temporal de cada trayectoria individual.
El ejemplo separa operaciones que se confunden con frecuencia. Medir más veces a una persona mejora la estimación de su nivel personal. Incorporar más personas independientes mejora, en cambio, la de la media del conjunto. La primera operación no sustituye a la segunda y la segunda no revela automáticamente la evolución temporal de cada integrante.
Dado un valor personal, el ruido del modelo es independiente y su varianza, igual a uno en todas las personas, sí se comparte por construcción. La falta de ergodicidad del proceso mezclado no impide transportar este parámetro particular si se sostiene la estructura que acabamos de declarar.
Adolf y Fried (2019) insisten precisamente en que la ergodicidad no es una condición necesaria para cualquier inferencia imaginable entre niveles. La equivalencia de un parámetro concreto puede apoyarse en supuestos más débiles o en un condicionamiento adecuado. Lo que debe justificarse es esa equivalencia, especificando qué heterogeneidad se ha representado y durante qué intervalo se considera estable.
También puede ocurrir que dos niveles coincidan en una media y difieran en su variabilidad o en su dependencia temporal. Comprobar una sola igualdad no demuestra la equivalencia completa de los procesos. En datos finitos, una diferencia estimada arrastra además incertidumbre de muestreo y de medición. La evaluación debe apuntar a las cantidades cuya equivalencia importa para la decisión.
Un parámetro de persistencia, por ejemplo, depende de la escala temporal. Una relación a intervalos de un día no describe automáticamente lo que ocurre entre dos mediciones separadas por un mes. Si se quiere trasladar una dinámica entre personas, esas diferencias de resolución deben conservarse o modelarse. Comparar coeficientes obtenidos con calendarios distintos puede producir discrepancias aunque el mecanismo continuo subyacente sea el mismo.
Agregación y forma de la dinámica
La agregación puede cambiar también la forma de una serie temporal. Dos procesos sencillos pueden dar un agregado cuya memoria no corresponda a la de ninguno de sus componentes.
Consideremos dos procesos autorregresivos independientes, estacionarios y de media cero, con coeficientes 0,2 y 0,8 y varianza marginal uno en ambos casos. Para conservar esas varianzas, las innovaciones independientes deben tener varianzas 0,96 y 0,36, respectivamente; tienen media cero y son independientes del pasado de ambas series. Supondremos que los dos procesos se observan con la misma separación temporal.
Definimos el agregado como su promedio, . Por la independencia entre componentes, su varianza es un medio y su covarianza en el retardo es la suma de las dos covarianzas individuales dividida por cuatro. Su autocorrelación es, por tanto,
Los tres primeros retardos dan autocorrelaciones de . Una autorregresión de primer orden con coeficiente 0,50 tendría, en cambio, . La coincidencia en el primer retardo no se mantiene en los siguientes. El promedio de las dos series no pertenece, en general, a la misma familia de primer orden con un coeficiente promedio.
Hay una manera de entenderlo sin calcular todas las covarianzas. Un valor agregado igual a uno puede provenir de dos componentes que valen uno o de que el componente de coeficiente 0,2 valga dos y el de coeficiente 0,8 valga cero. En el primer caso, el promedio esperado en el paso siguiente es un medio; en el segundo, 0,2. El agregado actual tiene el mismo valor en ambos casos, pero oculta cuánto corresponde al componente persistente y cuánto al que cambia deprisa.
Conocer solo el promedio actual deja indeterminada esa composición interna. La historia del agregado puede aportar información sobre ella, por lo que reducir la predicción a un único retardo pierde parte de la estructura. Si se mantienen los dos componentes como estado, puede expresarse la transición sencilla que generó el ejemplo.
La diferencia importa al interpretar la persistencia observada en una población. Esa persistencia puede surgir de combinar unidades con velocidades distintas aun cuando cada una tenga una dinámica elemental. En el ejemplo, la autocorrelación sigue siendo una suma finita de decaimientos exponenciales. Un ajuste adecuado del agregado describe el agregado; para atribuir su persistencia a cada individuo se necesita información que separe los componentes.
La independencia entre las dos series fue un supuesto explícito. Si respondieran a una perturbación común, aparecerían covarianzas cruzadas en la varianza y en las autocovarianzas del promedio, con lo que la reducción de variabilidad al agregar sería distinta. Aumentar el número de unidades no hace desaparecer una fluctuación que todas comparten.
Del mismo modo, cambiar quiénes forman el promedio en cada fecha modifica la serie resultante. Una variación agregada puede combinar cambios dentro de las unidades presentes con la entrada de unidades nuevas y la salida de otras. Una curva suave de promedios, sin otra información, no muestra cuál de esos movimientos ocurrió.
Para distinguirlos conviene conservar los identificadores y ver cuánto cambia el resultado cuando se mantiene fijo el conjunto de unidades. Esa comparación tiene un objetivo acotado, que es separar el cambio de composición del cambio entre quienes permanecen. El hecho de poder seguir a un subconjunto estable no lo hace representativo y su relación con la población de interés debe describirse.
La unidad de la pregunta
Las preguntas poblacionales tienen valor propio. Un municipio puede necesitar prever la demanda total de transporte y un servicio anticipar el número de incidencias pendientes. Para esos objetivos, una asociación entre agregados puede ser pertinente aunque no describa la respuesta de cada persona. Lo importante es mantener la interpretación en el nivel que los datos y el diseño sostienen.
Una pregunta individual es de otra naturaleza, por ejemplo cuánto cambiará el cansancio de una persona si modifica sus horas de actividad. La pendiente transversal del panel no responde a ella. La pendiente dentro de la persona se acerca más al contraste pertinente, aunque todavía podría reflejar causas comunes, efectos retardados o una respuesta en la dirección contraria.
Si una persona reduce su actividad cuando empieza a sentirse cansada, la asociación observada incorpora esa decisión. Una intervención que impusiera un cambio de horario tendría otra estructura. Identificar su efecto exigiría un diseño y unos supuestos que vincularan las observaciones con ese cambio, además de distinguir personas y ocasiones.
Un efecto promedio identificado no debe interpretarse como el efecto idéntico de todos los integrantes. El promedio puede ser útil para una decisión poblacional aun con heterogeneidad de respuestas, pero orientar una predicción individual exige saber qué características explican esa heterogeneidad o disponer de suficientes observaciones de la persona.
El muestreo y la medición determinan qué parte de esa tarea es posible. Muchas personas con pocas ocasiones ayudan a caracterizar las diferencias entre personas; muchas ocasiones de pocas personas, a estudiar sus trayectorias. Un diseño que combine ambas dimensiones puede estimar la variación en las dinámicas, siempre que el calendario y la precisión de las medidas sean adecuados.
Las observaciones repetidas tampoco convierten automáticamente un estado estadístico en una categoría fisiológica compartida, ya que dos modelos pueden dar el mismo nombre a componentes que representan escalas o mezclas distintas. Antes de comparar proporciones de estados entre personas hay que comprobar qué observaciones definen esos estados y qué información sostiene su correspondencia.
La elección del análisis puede empezar por una frase concreta que diga qué cantidad se quiere conocer, para qué unidad y en qué intervalo. Después se decide si los registros contienen variación suficiente en ese nivel. Así se separa una cantidad no identificada por los datos de otra que sí puede estimarse, aunque sea con poca precisión. Añadir personas no recupera cruces borrados y añadir ocasiones no exime de definir el parámetro que se quiere transportar.
Volvamos a los distritos. Si se recupera el cruce del primero y se sabe que aprobaron treinta y dos personas inscritas, el segundo todavía admite entre cero y veinte, por lo que el total de aprobados entre inscritos queda entre treinta y dos y cincuenta y dos. La diferencia de proporciones individuales se estrecha a un rango que va de menos un sexto a un cuarto, de modo que la información nueva reduce la indeterminación sin excluir todavía ninguno de los dos signos.
Por último se recupera el cruce del segundo distrito, donde aprobaron dieciséis personas inscritas. Hay entonces cuarenta y ocho aprobados entre ochenta inscritos y cincuenta y dos entre ciento veinte no inscritos, con proporciones de 0,60 y cerca de 0,433, cuya diferencia es un sexto. Los porcentajes territoriales del comienzo siguen siendo los mismos. Lo que se añadió fue la correspondencia entre inscripción y resultado dentro de cada distrito, con la que quedó determinada la asociación individual que antes no podía calcularse.
Referencias
Adolf, J. K., & Fried, E. I. (2019). Ergodicity is sufficient but not necessary for group-to-individual generalizability. Proceedings of the National Academy of Sciences, 116(14), 6540–6541. https://doi.org/10.1073/pnas.1818675116
Curran, P. J., & Bauer, D. J. (2011). The disaggregation of within-person and between-person effects in longitudinal models of change. Annual Review of Psychology, 62, 583–619. https://doi.org/10.1146/annurev.psych.093008.100356
Kitagawa, E. M. (1955). Components of a difference between two rates. Journal of the American Statistical Association, 50(272), 1168–1194. https://doi.org/10.1080/01621459.1955.10501299
Molenaar, P. C. M. (2004). A manifesto on psychology as idiographic science: Bringing the person back into scientific psychology, this time forever. Measurement: Interdisciplinary Research and Perspectives, 2(4), 201–218. https://doi.org/10.1207/s15366359mea0204_1
Oaxaca, R. L., & Sierminska, E. (2025). Oaxaca-Blinder meets Kitagawa: What is the link? PLOS ONE, 20(5), e0321874. https://doi.org/10.1371/journal.pone.0321874
Robinson, W. S. (1950). Ecological correlations and the behavior of individuals. American Sociological Review, 15(3), 351–357. https://doi.org/10.2307/2087176
Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x