Entre los segundos 261 y 262 de un electrocardiograma, una medida de la variación rápida del voltaje vale 0,07154 milivoltios. El modelo ajustado reparte casi por igual la probabilidad de ese segundo entre dos estados, 0,506 y 0,494. Si hubiera que colorearlo con una sola etiqueta bastaría una diferencia mínima para cambiar el color; cuando se incorporan las observaciones posteriores, las probabilidades pasan a 0,824 y 0,176. Los datos de ese segundo siguen siendo exactamente los mismos y lo que cambió es la información con que se reconstruye su lugar dentro de la secuencia.
El ejemplo procede de una señal real y permite seguir una inferencia completa, desde los conteos del instrumento hasta las probabilidades de estado, además de comprobar el rendimiento del modelo en observaciones posteriores al ajuste. La pregunta es acotada. Si se resume la variación del voltaje en cada segundo, ¿ayuda una dinámica de estados ocultos a anticipar el resumen siguiente? Para responderla compararemos cuatro familias de modelos, guardaremos sus errores y examinaremos algunas asignaciones ambiguas. No disponemos de etiquetas que permitan calcular aciertos diagnósticos.
El registro y la cantidad que se observa
Los datos son los cinco minutos de ECG que SciPy distribuye en su conjunto electrocardiogram. Corresponden a la derivación MLII del registro 208 de la MIT-BIH Arrhythmia Database, entre los minutos 19:35 y 24:35 del registro original, adquiridos a 360 muestras por segundo. El extracto contiene 108.000 muestras consecutivas y las usamos todas. La base de Moody y Mark (2005) y el artículo de 2001 en que los mismos autores describen su trayectoria tienen identificadores bibliográficos distintos.
El tiempo cero de nuestros cálculos es el comienzo del extracto, que no coincide con el del registro original. La muestra de índice cero corresponde al instante relativo cero y la última, de índice 107.999, cae poco antes de los trescientos segundos. Esta convención evita añadir una observación ficticia en el extremo derecho. Los intervalos que se usan más adelante incluyen su comienzo y excluyen su final.
El archivo guarda los conteos del convertidor y su conversión a milivoltios,
donde es el conteo entero de la muestra . Los tres primeros conteos son 975, 981 y 987, que corresponden a y milivoltios; la resolución de la conversión es de 0,005 milivoltios. El promedio del extracto completo ronda los −0,1651 milivoltios, con una desviación estándar de 0,5992. Con estas cifras se comprueba que se está leyendo el mismo archivo que describe SciPy; todavía no son parámetros de nuestro modelo.
La medición corresponde a un canal de una persona durante un intervalo concreto. La abundancia de muestras aumenta la resolución temporal dentro de ese intervalo, pero no equivale a una colección de personas independientes ni justifica afirmaciones sobre la frecuencia poblacional de los patrones encontrados. La documentación del extracto menciona también artefactos junto a distintas morfologías del ECG. Ni una variación grande, que puede tener varios orígenes, ni una pequeña tienen una interpretación clínica automática.
La investigación de Clifford y colaboradores (2012) sobre la calidad del ECG ayuda a delimitar la cuestión. Su evaluación combina propiedades espectrales, momentos de la distribución y concordancia entre detectores o canales y se apoya en registros etiquetados. Nuestro análisis no dispone de ese conjunto de medidas ni de esas etiquetas. El resumen que calcularemos puede mostrar cuándo cambia la señal bajo una definición precisa de variación, aunque aquí no se ha validado como indicador de aceptabilidad clínica.
Se conservan el binario descargado del repositorio oficial de SciPy y un CSV con índice, tiempo, conteo y voltaje. El conjunto original se distribuye bajo la Open Data Commons Attribution License v1.0; la atribución a George Moody y Roger Mark, el registro de procedencia y la descripción de la transformación acompañan a los archivos del caso. Ningún valor del ECG fue simulado.
De las muestras a una observación por segundo
Tomemos las tres primeras muestras, cuyos incrementos de voltaje son 0,030 y 0,030 milivoltios. Se repite la operación entre muestras consecutivas dentro del primer bloque de 360 valores, se elevan al cuadrado los 359 incrementos, se promedian y se extrae la raíz, lo que da 0,08149 milivoltios para el primer segundo. La misma operación se aplica a cada uno de los trescientos bloques,
El índice señala el segundo en que empieza el bloque, de manera que usa las muestras adquiridas desde el segundo 240 hasta justo antes del 241 y solo está disponible cuando termina ese bloque. Aunque las muestras tengan una resolución mucho mayor, el sistema que usa estos resúmenes emite una observación nueva cada segundo.
La medida es la raíz del promedio de los incrementos al cuadrado, o RMS de los incrementos, expresada en milivoltios. Como los incrementos no se dividen por el intervalo entre muestras, lo calculado no es una derivada en milivoltios por segundo. Si cambiara la frecuencia de adquisición, habría que repensar la definición y el significado de la medida antes de comparar valores.
Tampoco se incluye el incremento que cruza la frontera entre dos segundos, de modo que cada resumen usa solo diferencias internas de su bloque. Entran 107.700 diferencias y se omiten 299 entre bloques. La omisión, deliberada y reproducible, fija exactamente qué observaciones componen cada resumen. Desplazar las fronteras de los bloques podría alterar los resultados, sobre todo cuando una variación pronunciada quedara junto al límite.
Restar dos voltajes elimina cualquier desplazamiento constante común a ambos. Una línea de base que cambia dentro del bloque sigue contribuyendo a la medida, igual que los cambios rápidos propios de la forma de las ondas y las perturbaciones del instrumento. Para ver por qué la medida no separa esas contribuciones, imaginemos, solo como cálculo auxiliar, un ruido de media cero, independiente entre muestras y de la señal, con varianza , sumado a cada muestra. La diferencia entre dos ruidos consecutivos tendría varianza y el valor esperado del cuadrado medio de los incrementos aumentaría aunque la señal subyacente no cambiase. Este cálculo no atribuye ese modelo de ruido al registro observado. Explica una sensibilidad de la transformación.
La operación pierde también información. Dos segmentos con incrementos de signos diferentes pueden dar el mismo RMS y distintas ordenaciones de unos mismos incrementos conservan la suma de cuadrados. El resumen no retiene la posición exacta de un pico dentro del segundo ni permite reconstruir la forma completa del ECG. La pregunta estadística concierne, pues, a la dinámica de una característica de la señal, elegida para trabajar con una secuencia manejable y una definición transparente.
En los datos, el RMS mínimo es 0,01248 milivoltios, en el bloque que empieza en el segundo 211. El máximo, 0,14491, aparece en el segundo 28. Para modelar una cantidad positiva sin dar densidad gaussiana a valores negativos usamos el logaritmo,
El cociente dentro del logaritmo es adimensional. Un desplazamiento aditivo en esta escala corresponde a un cambio multiplicativo del RMS. La serie no se centra ni se normaliza con los trescientos segundos, porque eso incorporaría datos de evaluación a una transformación estimada. La unidad de referencia y la fórmula quedan fijas desde el principio.
Información disponible para cada pronóstico
Los primeros ciento ochenta segundos se usan para ajustar los candidatos. Los sesenta siguientes, del segundo 180 al 240, se reservan para elegir entre dos y tres componentes en la mezcla y entre dos y tres estados en el HMM. Por último, los procedimientos seleccionados se reajustan con los primeros doscientos cuarenta segundos y sus predicciones se evalúan en el minuto restante. La partición se fijó antes de calcular ningún resultado de los modelos.
La predicción para el bloque que empieza en el segundo 240 se prepara con la información disponible al cerrar el bloque anterior. Después llegan sus 360 muestras, se calcula el resumen y se evalúa la densidad que el modelo le había asignado. El HMM actualiza entonces sus probabilidades de estado y esa actualización influirá en la predicción del segundo siguiente, aunque sus parámetros siguen fijos durante todo el minuto de evaluación.
La autorregresión recibe el mismo último resumen disponible. Los modelos independientes mantienen una distribución que no cambia con el valor precedente. Esa diferencia forma parte de sus hipótesis. Todos usan el mismo calendario y predicen exactamente las mismas sesenta observaciones; ninguno consulta el resumen de un bloque antes de que termine su adquisición.
La selección se basa en la suma de los logaritmos de las densidades predictivas en las observaciones de validación. Una distribución recibe una fuerte penalización cuando asigna muy poca densidad a lo que ocurre; el criterio tiene en cuenta la localización, la dispersión y la forma de la predicción. La propiedad del puntaje logarítmico que estudiaron Gneiting y Raftery (2007) atañe a su comportamiento esperado bajo una distribución de referencia. Un resultado favorable en sesenta observaciones sigue siendo un resultado finito de este caso.
Todas las puntuaciones se calculan sobre la misma variable logarítmica, sin mezclar densidades de voltaje, de RMS y de logaritmo del RMS, ya que un cambio de variable introduciría su jacobiano. Los valores absolutos de las densidades dependen también de la escala, por lo que una puntuación positiva o negativa no significa, sin más, éxito o fracaso.
El registro digital tiene una resolución finita y las densidades continuas son aquí una aproximación para describir la distribución de sus resúmenes. El suelo de varianza que fijaremos impide construir componentes de anchura arbitrariamente pequeña en torno a un valor observado. Las puntuaciones deben leerse dentro de esa aproximación común, que permite comparar todos los modelos con una misma regla.
Ajuste de distribuciones y transiciones
La referencia más sencilla es una gaussiana independiente para cada resumen, con media y varianza estimadas en el tramo de entrenamiento. La mezcla gaussiana admite que la distribución tenga varias zonas de concentración. Para generar una observación se elige un componente según unos pesos fijos y se usa su distribución gaussiana, con elecciones independientes de un segundo a otro.
La autorregresión propone otra organización. Su media condicional depende linealmente del resumen anterior y su error es gaussiano con varianza constante; puede recoger la persistencia sin introducir categorías ocultas. Se estima por mínimos cuadrados, con la varianza residual calculada como promedio de los residuos al cuadrado. Al compararla con el HMM puede preguntarse si una dependencia continua sencilla explica ya parte del beneficio que se atribuye a los estados.
En el HMM, cada resumen depende de un estado no observado y, dado ese estado, la emisión tiene media y varianza ,
La matriz describe cómo se distribuye el estado siguiente a partir del actual y se supone constante en el tramo al que se aplica el modelo. La dependencia entre observaciones se transmite a través de la cadena oculta; dada esa cadena, las emisiones se consideran independientes. La distribución inicial de estados se estima por separado, por lo que la constancia de la matriz no impone por sí misma que el proceso empiece en equilibrio.
La estimación alterna probabilidades de ocupación y de transición, calculadas con los parámetros actuales, con nuevas estimaciones de medias, varianzas y probabilidades de transición. Para estimar una media, cada observación pesa según su probabilidad de pertenecer al estado; para estimar una transición, se acumulan las probabilidades conjuntas de estados consecutivos. El procedimiento EM y las recursiones que lo hacen viable se exponen en Rabiner (1989). Nuestro código trabaja con logaritmos y normaliza en cada paso para mantener la estabilidad numérica.
Antes del ajuste se fijó una desviación estándar mínima de 0,05 en la escala logarítmica, equivalente a una varianza de 0,0025. Ese límite vale para las emisiones, los componentes de la mezcla y las varianzas de los modelos sencillos. La mezcla y el HMM se inicializan cinco veces de forma reproducible. Las medias parten de cuantiles del entrenamiento con pequeñas perturbaciones; en el HMM, las persistencias diagonales iniciales van de 0,60 a 0,90 y las probabilidades iniciales de estado son uniformes.
Cada ejecución se detiene cuando la mejora de la logverosimilitud por observación baja de una diez millonésima o al llegar a quinientas iteraciones. Se conserva la de mayor verosimilitud de entrenamiento antes de comparar su rendimiento en validación. Así quedan separadas dos decisiones, la de buscar un buen ajuste dentro de cada candidato y la de elegir entre candidatos con distinto número de estados.
Todas las ejecuciones alcanzaron el criterio de convergencia antes del límite, ninguna terminó apoyada en el suelo de varianza y las verosimilitudes aumentaron en cada actualización comprobada. Hubo soluciones distintas según la inicialización, sobre todo en algunos ajustes de tres componentes o estados. Quedarse con el mejor de cinco intentos mejora la búsqueda, aunque no demuestra haber encontrado el máximo global. Los resultados y las historias de convergencia quedan guardados para que esa elección pueda revisarse.
Resultados en validación y en evaluación
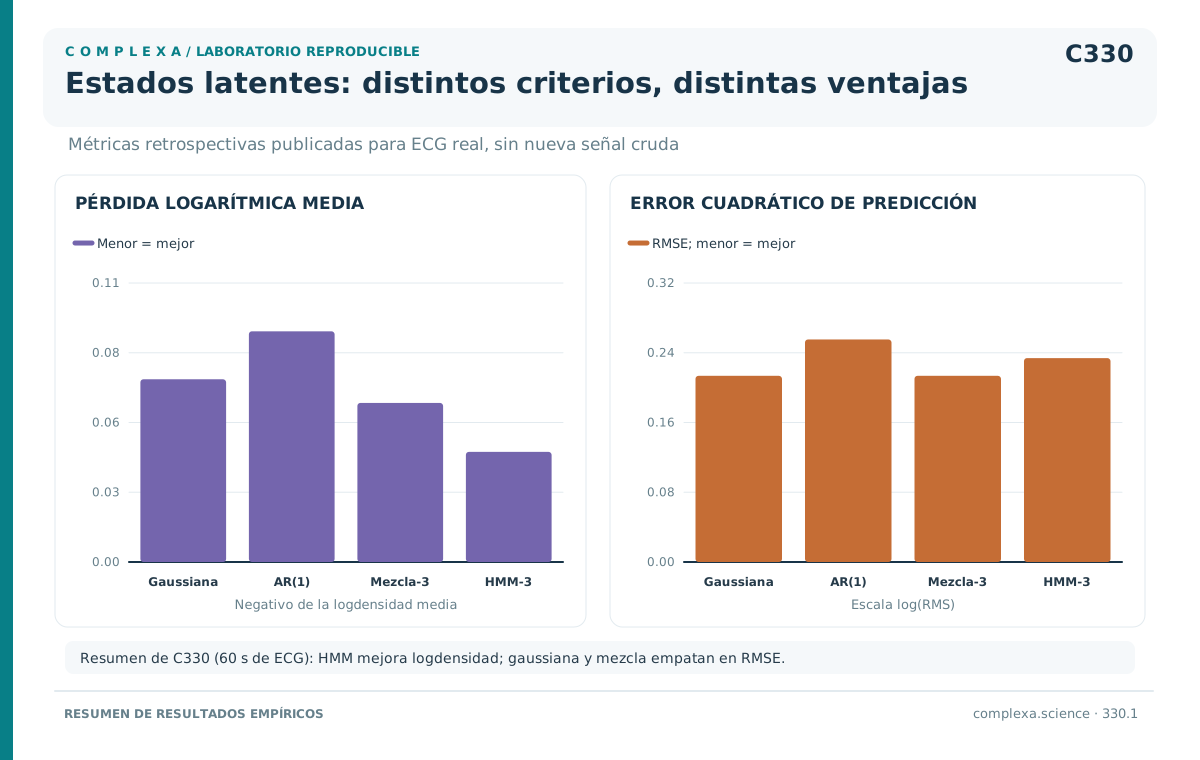
En validación, la mezcla de tres componentes supera a la de dos en puntuación logarítmica y el HMM de tres estados supera al de dos. La tabla muestra las medias por observación y, según este criterio, los valores mayores son mejores.
| Candidato | Logdensidad media, segundos 180 a 240 |
|---|---|
| Gaussiana independiente | −1,18255 |
| Autorregresión de primer orden | −0,74488 |
| Mezcla de dos componentes | −0,56474 |
| Mezcla de tres componentes | −0,52913 |
| HMM de dos estados | −0,52829 |
| HMM de tres estados | −0,40505 |
Conservamos tres componentes para la mezcla y tres estados para el HMM. Esa cifra cumple una función operativa, la de identificar qué candidato obtuvo la mejor puntuación en ese intervalo entre los considerados. No equivale a haber contado tres estados fisiológicos existentes en el organismo.
Tras el reajuste con los primeros doscientos cuarenta segundos, la gaussiana tiene media −2,74167 y una desviación estándar de unos 0,36009. La autorregresión obtiene un coeficiente de 0,48325 para el valor previo y un intercepto de −1,41772, de modo que sus predicciones responden con intensidad moderada al resumen más reciente. En ambos modelos, varianzas y coeficientes quedan fijos durante la evaluación.
La tabla siguiente recoge los resultados del minuto final. El error cuadrático medio aparece como su raíz (RMSE) y, junto con el error absoluto medio (MAE), se calcula en la escala logarítmica. La predicción puntual de cada modelo es la media de su distribución predictiva.
| Modelo reajustado | Logdensidad media | RMSE | MAE |
|---|---|---|---|
| Gaussiana independiente | −0,07335 | 0,21353 | 0,16245 |
| Autorregresión de primer orden | −0,09261 | 0,25523 | 0,19798 |
| Mezcla de tres componentes | −0,06386 | 0,21353 | 0,16245 |
| HMM de tres estados | −0,04421 | 0,23386 | 0,17814 |
El HMM asigna en conjunto más densidad a los valores que aparecieron. Su suma de logdensidades es −2,65237, frente a −3,83141 para la mezcla y −4,40106 para la gaussiana, con una ventaja sobre la mezcla de alrededor de 1,179 a lo largo de sesenta observaciones. Es una ventaja observada en este tramo y la tabla no aporta una estimación de su estabilidad entre personas o registros.
Para anticipar el valor medio, en cambio, la gaussiana y la mezcla cometen menos error. Que ambas coincidan en RMSE y MAE tiene una explicación algebraica, ya que la mezcla independiente ajustada por EM reproduce con su media ponderada el promedio del entrenamiento. Su predicción puntual es la misma que la de la gaussiana, aunque reparta la densidad de otro modo alrededor de ese promedio. La igualdad de sus errores puntuales es compatible con puntuaciones probabilísticas diferentes.
El HMM deja que los pesos predictivos cambien con el pasado, lo que le permite situar mejor la densidad sin que la media de esa distribución se acerque más a cada observación. La autorregresión aprendió una relación positiva con el resumen previo, pero esa reacción produjo más error durante el minuto final. La flexibilidad temporal tiene que evaluarse en la tarea elegida, porque sus parámetros no garantizan una mejora por el hecho de describir dependencia.
La igualdad entre las medias de la mezcla y de la gaussiana puede comprobarse sin apelar a una coincidencia numérica. En una actualización de la mezcla, el peso de cada componente es su ocupación probabilística dividida por el número de observaciones, mientras que su media es la suma ponderada de los valores dividida por esa misma ocupación. Al multiplicar peso por media la ocupación se cancela. Como las probabilidades de pertenencia de cada observación suman uno, al sumar los componentes queda exactamente el promedio del entrenamiento. La mezcla puede describir mejor la distribución aunque la tarea de predecir ese promedio no cambie.
El contraste entre validación y evaluación no se reduce a una transformación de los números de la tabla. Los intervalos contienen valores distintos y las distribuciones se reajustaron antes del minuto final. En particular, la dispersión observada del logaritmo del RMS es mayor en la validación que en la evaluación. Comparar puntuaciones dentro de cada columna mantiene común el problema, pero leer la mejora entre columnas como una ganancia debida solo al reajuste mezclaría ambos cambios.
Los tres estados ajustados
Ordenemos los estados del HMM final por su media de emisión. Así se elimina la ambigüedad nominal de poder intercambiar los números de los estados sin alterar la distribución observada. Los parámetros son los siguientes.
| Estado | Media de | Desviación estándar de | Mediana modelada del RMS, mV |
|---|---|---|---|
| 1 | −4,20441 | 0,19091 | 0,01493 |
| 2 | −2,80297 | 0,30059 | 0,06063 |
| 3 | −2,58387 | 0,12379 | 0,07548 |
La última columna aplica la exponencial a la media logarítmica y da la mediana del RMS bajo la lognormal correspondiente. Su media exigiría incorporar también la varianza logarítmica. La distinción evita presentar como promedio de amplitud una cantidad que expresa el centro en otra escala.
El primer estado concentra valores de variación especialmente pequeña, mientras que el segundo es más disperso que el tercero y sus distribuciones se solapan bastante. Ordenar las medias no produce, por tanto, tres intervalos separados por umbrales. Un mismo RMS puede ser compatible con más de un estado y la probabilidad de cada uno depende también de la trayectoria previa.
La mezcla independiente organiza los mismos datos de otra forma. Su componente de menor media logarítmica queda en −3,03992, con una desviación estándar cercana a 0,570 y un peso de alrededor de 0,254. Es bastante más ancho que cualquiera de las emisiones del HMM final. Una distribución ancha puede acoger con sus colas valores alejados de su centro, aunque otro ajuste puede reservarles un componente más específico. Contar tres componentes en ambos modelos oculta esta diferencia de representación. Para saber qué distribución se ajustó, la tabla de medias debe acompañarse de las dispersiones y de las reglas temporales.
La matriz de transición estimada, redondeada, es
Los ceros de esta presentación corresponden a probabilidades numéricamente diminutas. El diseño no prohíbe esas transiciones. Las filas indican el estado de origen y las columnas el de destino. Si el estado actual fuese el segundo, la probabilidad de seguir en él en el bloque siguiente sería de 0,833 aproximadamente.
En este modelo homogéneo, la duración de una permanencia iniciada en el estado sigue una distribución geométrica de media , que da unos y segundos para los tres estados. Son duraciones implícitas en la matriz estimada y no se obtuvieron cronometrando episodios fisiológicos etiquetados. Tampoco deben confundirse con la duración de las rachas que produciría una secuencia de etiquetas elegidas por máxima probabilidad marginal.
Otro resultado ayuda a interpretar los nombres. El HMM de tres estados ajustado al principio con ciento ochenta segundos tenía medianas de RMS de unos y milivoltios. Al incorporar el intervalo de validación al reajuste, la mediana menor bajó a 0,01493. Mantener tres estados y ordenarlos por su media no conservó el significado cuantitativo de cada componente.
El ajuste final destinó a los valores muy bajos un estado más específico, cuya ocupación suavizada acumulada durante el entrenamiento ronda los siete segundos. Cinco segundos consecutivos, desde el comienzo del 209 hasta el final del 213, reciben probabilidades altas de ese estado, igual que los bloques que empiezan en los segundos 43 y 97. En el minuto de evaluación su ocupación probabilística es prácticamente nula. Todo ello describe cómo el modelo repartió sus componentes entre las observaciones, incluida una región poco representada.
Pohle y colaboradores (2017) mostraron, en otro ámbito de aplicación, cómo los estados adicionales pueden absorber estructura que la familia de emisiones o las hipótesis temporales no representan. Aquí, la comparación entre los dos ajustes deja ver directamente cuánto depende la representación del tramo usado. El modelo de tres estados es una herramienta predictiva concreta, pero atribuir identidades fisiológicas estables a sus componentes exigiría una evidencia que este análisis no contiene.
Una actualización calculable a mano
Consideremos el primer segundo de evaluación. Antes de recibir su resumen, las probabilidades de los estados son aproximadamente
Se obtienen propagando con la matriz de transición las probabilidades filtradas del bloque anterior e indican que el tercer estado es el más probable antes de observar el bloque nuevo. El resumen que finalmente llega es 0,04969 milivoltios, equivalente a .
Las densidades gaussianas de ese valor bajo los estados primero, segundo y tercero son, aproximadamente, y . La del segundo estado puede superar uno porque corresponde a una variable continua y no es la probabilidad de un evento puntual. Multiplicando cada densidad por su probabilidad previa se obtienen unos y .
La suma de esos productos es la densidad predictiva asignada a la observación y al dividir cada producto por la suma se actualizan las probabilidades de estado,
La operación combina la información temporal de la matriz con la del bloque recién observado. La distribución previa favorecía al tercer estado, pero el valor recibido es mucho más compatible con la emisión del segundo y la probabilidad posterior cambia de forma marcada. El algoritmo no necesita declarar con certeza un estado para continuar, porque utiliza el vector completo en la predicción siguiente.
La contribución del pasado se aprecia al comparar dos bloques de evaluación con resúmenes casi iguales. Los que empiezan en los segundos 252 y 289 tienen RMS de 0,06600 y 0,06615 milivoltios, pero las probabilidades filtradas del segundo estado son aproximadamente 0,807 y 0,307. En el primero, ese estado ya tenía una probabilidad previa de 0,833; en el segundo, de 0,386. El valor que llega actualiza antecedentes distintos.
Estos dos bloques se eligieron después del análisis para ilustrar la recursión y no intervinieron en la elección del número de estados. La comparación muestra por qué una regla que asigne etiquetas solo según la amplitud del resumen no reproduce el HMM, que necesita conservar las probabilidades anteriores y propagarlas con la matriz. Muestra también qué podría fallar si la dinámica cambiara, pues una persistencia aprendida en otro tramo seguiría pesando en la asignación hasta que las emisiones nuevas aportaran evidencia suficiente para contrarrestarla.
Las probabilidades así obtenidas son filtradas. Para reconstruir a posteriori un segundo se puede añadir la información de todos los bloques posteriores y obtener probabilidades suavizadas. En el segundo 242, por ejemplo, la probabilidad filtrada del tercer estado es 0,69802. Una vez incorporado el resto del registro baja a 0,35468 y el segundo estado pasa a ser el más probable. El suavizado cambió la asignación preferida porque evalúa la coherencia de ese bloque con una secuencia más amplia.
Ese cambio no comprueba cuál asignación era la correcta. Las observaciones posteriores son evidencia adicional dentro del mismo modelo y no son etiquetas externas del estado. En los sesenta segundos de evaluación, el estado con mayor probabilidad filtrada difiere del de mayor probabilidad suavizada en diez ocasiones, que pueden localizarse en el archivo de probabilidades sin esconderlas detrás de una única secuencia de colores.
La incertidumbre marginal puede resumirse también sin convertirla en una medida de exactitud. En 33 segundos de evaluación ninguna probabilidad filtrada llega a 0,80 y tras el suavizado la situación se da en 23. La entropía media baja de unos 0,4283 a 0,3633 nats, por lo que en este conjunto concreto incorporar el futuro produce en promedio una reconstrucción más concentrada.
Sumar probabilidades da una descripción distinta de la que se obtiene contando etiquetas. Para el segundo estado, las probabilidades filtradas del minuto final suman alrededor de 43,07 y las suavizadas 49,04. Esta segunda suma es el número esperado de bloques asignados a ese estado, condicionado al registro completo y a los parámetros. Cada bloque puede aportar una fracción. Redondear primero todas las asignaciones elimina esa contribución parcial y responde a otra operación. Por eso una ocupación probabilística de 49 segundos no señala necesariamente un episodio continuo de esa duración.
No todos los segundos se comportan igual. En el bloque 240, la probabilidad del segundo estado pasa de 0,98585 en el filtrado a 0,97139 en el suavizado, con lo que la información posterior reduce ligeramente su concentración. Una reducción promedio de la incertidumbre no obliga a que cada observación adicional refuerce la opción que antes parecía más probable. El bloque 261 con que abrimos el caso ilustra el comportamiento opuesto, al resolver en parte un reparto que estaba casi empatado.
Todas estas probabilidades están condicionadas a los parámetros ajustados y a la estructura elegida. Las diferencias entre inicializaciones, la elección de tres estados y los cambios del ajuste al ampliar el entrenamiento son fuentes de variación distintas de la incertidumbre marginal que calcula el filtro. Los archivos las guardan por separado. La probabilidad de 0,98585 es el cálculo del modelo final para ese bloque bajo sus parámetros y no incorpora una distribución de todos los modelos que también podrían haberse considerado.
Reproducibilidad y último dato
El material del caso permite volver al conteo original de cada observación. El archivo de características identifica el primer y el último índice de cada bloque y el instante en que su resumen queda disponible. Los archivos de predicciones guardan los valores observados, las medias y varianzas predictivas y las puntuaciones de cada segundo, mientras que otro archivo recoge las probabilidades previas, filtradas y suavizadas.
El programa principal requiere Python y NumPy. Sus rutas se resuelven a partir de la ubicación del propio programa, que admite indicar un CSV de entrada y un directorio de salida. Antes de recalcular las características comprueba que el archivo de observaciones coincida con la huella digital registrada. Las instrucciones de ejecución y los parámetros numéricos acompañan al código.
Una segunda implementación verifica los resultados con operaciones escalares y recursiones en probabilidades, distintas de las recursiones logarítmicas del ajuste. Recalcula además el RMS directamente desde las diferencias de los conteos enteros. Para una ventana de seis segundos enumera las 729 secuencias posibles de tres estados y suma sus contribuciones, con un resultado que coincide con la verosimilitud y las probabilidades marginales de las recursiones. La comprobación valida las operaciones del caso, pero no convierte las hipótesis del modelo en hechos fisiológicos.
Al presentar una curva filtrada sobre los primeros doscientos cuarenta segundos hay que hacer una precisión temporal, porque sus parámetros se estimaron con todo ese tramo. La curva es retrospectiva aunque la fórmula avance hacia delante. En el minuto final, en cambio, los parámetros ya estaban fijados y cada actualización del filtro usa solo las observaciones recibidas hasta ese momento, mientras que el suavizado de ese mismo minuto espera al final del registro.
Volvamos al último bloque, entre los segundos 299 y 300. Antes de observarlo, el modelo asigna alrededor de 0,47167 al segundo estado y 0,51678 al tercero; el resto corresponde al primero. Su RMS observado es 0,05308 milivoltios. Tras recibirlo, la probabilidad del segundo estado sube a 0,95106 mientras la del tercero baja a 0,04894.
En ese extremo el filtrado y el suavizado coinciden, porque dentro del extracto ya no hay observaciones posteriores. Para preparar la distribución del bloque siguiente bastaría propagar ese último vector con la matriz estimada, lo que da probabilidades de unos y . Esa predicción puede calcularse, pero el resumen que permitiría evaluarla no forma parte de los cinco minutos disponibles.
Referencias
Clifford, G. D., Behar, J., Li, Q., & Rezek, I. (2012). Signal quality indices and data fusion for determining clinical acceptability of electrocardiograms. Physiological Measurement, 33(9), 1419–1433. https://doi.org/10.1088/0967-3334/33/9/1419
Gneiting, T., & Raftery, A. E. (2007). Strictly proper scoring rules, prediction, and estimation. Journal of the American Statistical Association, 102(477), 359–378. https://doi.org/10.1198/016214506000001437
Moody, G. B., & Mark, R. G. (2001). The impact of the MIT-BIH Arrhythmia Database. IEEE Engineering in Medicine and Biology Magazine, 20(3), 45–50. https://doi.org/10.1109/51.932724
Moody, G. B., & Mark, R. G. (2005). MIT-BIH Arrhythmia Database (versión 1.0.0) [Conjunto de datos]. PhysioNet. https://doi.org/10.13026/C2F305
Pohle, J., Langrock, R., van Beest, F. M., & Schmidt, N. M. (2017). Selecting the number of states in hidden Markov models: Pragmatic solutions illustrated using animal movement. Journal of Agricultural, Biological, and Environmental Statistics, 22(3), 270–293. https://doi.org/10.1007/s13253-017-0283-8
Rabiner, L. R. (1989). A tutorial on hidden Markov models and selected applications in speech recognition. Proceedings of the IEEE, 77(2), 257–286. https://doi.org/10.1109/5.18626. Consultado junto con las correcciones del autor a la comparación y al escalado: https://web.ece.ucsb.edu/Faculty/Rabiner/ece259/Reprints/hmm%20tutorial%20errata.pdf
SciPy. (s. f.). scipy.datasets.electrocardiogram. Documentación del extracto y acceso a su procedencia. https://docs.scipy.org/doc/scipy/reference/generated/scipy.datasets.electrocardiogram.html