Una señal alta puede aparecer en pleno régimen de actividad baja; basta un movimiento aislado, una fluctuación del sensor o la variabilidad habitual del proceso. Si cada lectura alta se interpreta de inmediato como un cambio de régimen, la reconstrucción se fragmenta. Si se exige una larga sucesión de lecturas altas antes de admitir el cambio, este se detecta tarde. Un modelo oculto de Markov formula ambas posibilidades dentro de un mismo cálculo, en el que el régimen persiste con cierta probabilidad y, mientras persiste, produce observaciones variables.
La duración entra en ese planteamiento antes de que nadie decida analizarla. Una probabilidad constante de permanecer en un estado impone una distribución concreta para el número de instantes consecutivos que se pasan en él. Un modelo puede ajustar razonablemente el histograma de las observaciones y, al mismo tiempo, representar mal la longitud de los episodios. Para estudiar el problema conviene mantener separados el proceso que cambia de estado, el mecanismo que genera las mediciones y la información que se usa para reconstruir lo ocurrido.
Estados, transiciones y emisiones
Consideremos un ejemplo didáctico con cuatro lecturas de un dispositivo, tomadas a intervalos iguales y clasificadas como altas o bajas. Proponemos dos estados latentes, y , sin atribuirles todavía un significado fisiológico. La variable indica el estado en el instante y contiene la lectura. Los estados se relacionan mediante la matriz
Las filas indican el estado de origen y las columnas el de destino, en el orden . Si el sistema está en , sigue allí en la lectura siguiente con probabilidad ; desde , la probabilidad de pasar a es . Cada fila suma uno porque enumera todos los destinos posibles.
Las distribuciones de emisión se fijan como
Las probabilidades de una lectura baja son, respectivamente, y , por lo que una lectura alta favorece a aunque también es compatible con . La matriz de transición describe la persistencia y los cambios, mientras que las probabilidades de emisión indican cuánto informa cada lectura sobre el estado.
La división en lecturas altas y bajas simplifica las cuentas, aunque el HMM no la exige. Si el dispositivo entrega una amplitud continua, cada estado puede tener una densidad sobre esa amplitud; al actualizar se evalúan las densidades en el valor registrado y se normalizan los pesos resultantes. Una densidad no es la probabilidad de un punto y puede superar uno, lo que no impide usarla en la verosimilitud. Conservar la amplitud tiene además la ventaja de mantener diferencias entre lecturas que un umbral agruparía en la misma categoría.
La elección de las emisiones afecta a la segmentación. Un estado con una distribución ancha puede explicar un valor excepcional sin cambiar de régimen, mientras que si sus emisiones se restringen a una banda estrecha, ese mismo valor puede inclinar la balanza hacia una transición o hacia un estado adicional. Por eso la capacidad de producir una observación y la tendencia a permanecer en un estado se estiman conjuntamente, sin tratarlas como dos ajustes independientes que puedan hacerse ignorando sus consecuencias mutuas.
El modelo básico contiene dos independencias condicionales. Dado el estado actual, la distribución del siguiente estado no depende de la historia anterior. Una vez conocida la trayectoria completa de estados, las observaciones se generan además de forma independiente, cada una según la distribución de su estado. La segunda condición puede fallar aunque la primera sea adecuada. Un sensor con errores correlacionados en el tiempo, por ejemplo, puede mantener dependencia entre lecturas incluso dentro de un régimen constante.
Esta formulación no afirma que las observaciones sean marginalmente independientes. Si el estado persiste, las lecturas cercanas comparten una causa latente y pueden estar correlacionadas. La independencia se afirma después de condicionar a los estados. Si en una extensión autorregresiva de las emisiones la distribución de la lectura dependiera también de valores observados anteriores, habría que incorporar esa dependencia al cálculo modificando los términos correspondientes de las fórmulas básicas.
Para iniciar el ejemplo asignamos probabilidades y a los estados y . Esta distribución inicial expresa la situación al comienzo del registro y puede diferir de la distribución estacionaria de la cadena. Si el experimento empieza tras una preparación conocida, esa preparación puede justificar una distribución inicial distinta de la que se encontraría al observar el sistema en un momento elegido al azar.
Llamemos a la probabilidad de emitir en el estado y a la probabilidad inicial. Para una trayectoria concreta, la probabilidad conjunta se factoriza como
La notación designa todos los estados desde el primero hasta el último. Con dos estados y cuatro observaciones hay dieciséis trayectorias posibles, cada una con un peso que depende de sus transiciones y de la compatibilidad de sus emisiones. La probabilidad del registro observado es la suma de esos dieciséis pesos. En registros largos el número de trayectorias crece exponencialmente, aunque muchas comparten el mismo estado final y eso permite reutilizar cálculos.
El algoritmo hacia delante y el filtrado
La variable hacia delante, que suele llamarse forward, reúne la probabilidad del fragmento observado y de su estado final,
Su inicialización y su recurrencia son
A puede llegarse desde cualquiera de los estados anteriores. Primero se suman esas posibilidades y después se incorpora la emisión actual. El resultado sigue siendo una probabilidad conjunta, sin normalizar sobre los estados, cuya suma final es la verosimilitud del registro para los parámetros fijados. El algoritmo evita enumerar trayectorias al conservar solo el peso acumulado en cada estado. Con una matriz de transición densa de estados, su coste crece como .
Tomemos la secuencia alta, baja, baja, alta. En el primer instante los pesos son para y para . Al dividir cada peso por su suma, , que es la probabilidad de esa primera lectura, se obtienen las probabilidades filtradas, y . El filtrado responde qué estado resulta plausible ahora usando únicamente las observaciones disponibles hasta ese momento.
Antes de incorporar la segunda lectura, la probabilidad predictiva de es
La lectura baja favorece entonces a . Con los pesos conjuntos, la actualización produce 0,1376 para y 0,0536 para , con los que la probabilidad filtrada de pasa a 0,7197. La lectura no ha fijado el estado con certeza. Ha modificado una distribución que ya contenía la información del instante anterior.
La tabla muestra el cálculo completo. En cada fila, los pesos de las dos columnas centrales suman la probabilidad del fragmento observado hasta ese instante.
| Instante | Lectura | Peso en | Peso en | Probabilidad filtrada de |
|---|---|---|---|---|
| 1 | Alta | 0,12000000 | 0,32000000 | 0,7273 |
| 2 | Baja | 0,13760000 | 0,05360000 | 0,2803 |
| 3 | Baja | 0,10764800 | 0,01132800 | 0,0952 |
| 4 | Alta | 0,01982976 | 0,01586176 | 0,4444 |
La última lectura alta no basta para que supere la mitad de la probabilidad filtrada, porque las dos lecturas bajas anteriores habían concentrado el peso en , cuya elevada persistencia sigue influyendo. A diferencia de un clasificador basado únicamente en la distribución de emisión, el modelo pondera la lectura actual junto con la historia.
El pronóstico siguiente vuelve a separar estados y emisiones. Después de las cuatro lecturas, al propagar el filtro con la matriz de transición, la probabilidad de estar en en el quinto instante es aproximadamente 0,4111. La de obtener una lectura alta, que resulta de ponderar la emisión alta de cada estado por la probabilidad de llegar a él, es cercana a 0,4467. La probabilidad del estado y la de su señal más característica no coinciden. A horizontes largos y sin mediciones nuevas, la cadena converge a ocupaciones de dos tercios en y un tercio en , con una probabilidad predictiva de lectura alta que tiende a 0,4.
La verosimilitud de las cuatro lecturas, 0,03569152, es la probabilidad que el modelo, con estos parámetros, asigna a esta secuencia concreta. No es la probabilidad de que el modelo sea verdadero. Su pequeñez tampoco indica por sí sola un mal ajuste, porque la probabilidad de una secuencia específica suele disminuir a medida que se añaden observaciones.
En una implementación larga, multiplicar probabilidades puede agotar la precisión numérica. Una solución es normalizar tras cada actualización y guardar las constantes de normalización. Si es la probabilidad predictiva de la observación nueva, calculada a partir del filtro ya normalizado, la logverosimilitud es . En esta convención es el divisor; algunos textos llaman coeficiente de escala a su inverso. La hoja de erratas del tutorial de Rabiner (1989) precisa justamente la diferencia entre las variables locales antes de escalar y las ya escaladas. Esa distinción evita mezclar factores acumulados con factores de un solo paso.
Suavizado y decodificación
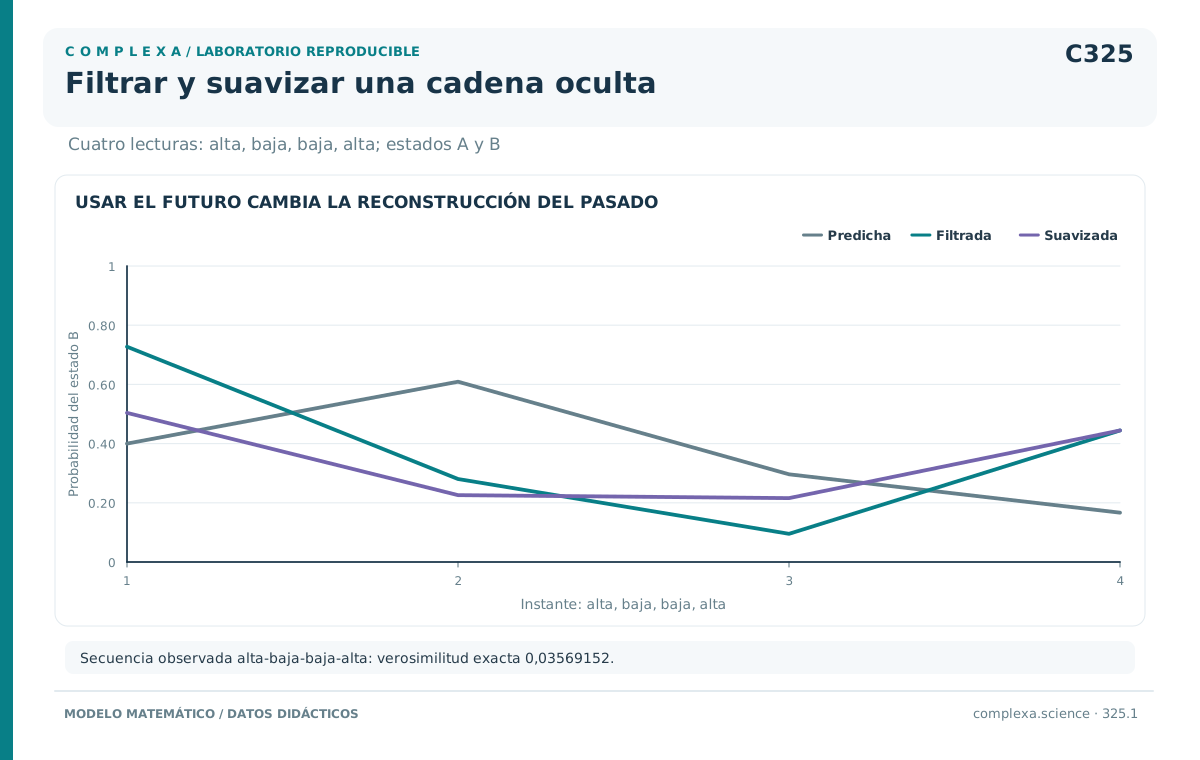
Una lectura posterior puede cambiar la interpretación de un estado pasado. Para aprovecharla se introduce la variable hacia atrás
Al final se fija , porque tras la última lectura no queda ninguna emisión por incorporar. La recurrencia suma sobre los destinos del paso siguiente, combinando para cada uno la transición, su emisión y la probabilidad de lo que viene después,
El producto reúne el registro completo con el estado en ese instante. Al dividirlo por la verosimilitud total se obtiene la probabilidad suavizada
En el ejemplo, las probabilidades suavizadas de son y . La primera lectura alta había dado una probabilidad filtrada de 0,7273, pero una vez conocidas las lecturas bajas posteriores la asignación queda casi empatada. En cambio, la última lectura alta eleva la probabilidad de que el tercer instante perteneciera a desde 0,0952 hasta 0,2158. Suavizar puede mover la distribución en cualquiera de las dos direcciones.
En el último instante la distribución suavizada coincide con la filtrada, ya que ambas usan el mismo conjunto de observaciones. En los instantes anteriores responden a preguntas diferentes. Para reconstruir un episodio a posteriori puede emplearse todo el registro, mientras que para describir lo que un dispositivo habría sabido en tiempo real solo sirve el filtro. Evaluar un sistema de alarma con probabilidades suavizadas introduciría información futura en una decisión que debía tomarse antes.
Hay también varias maneras de condensar las probabilidades suavizadas en una secuencia de etiquetas. Elegir el estado más probable en cada instante da y minimiza el número esperado de errores individuales cuando todos los errores de clasificación cuestan lo mismo. La trayectoria completa más probable, en cambio, es .
El algoritmo de Viterbi conserva, para cada estado final, el peso de la mejor trayectoria que llega a él. En la recurrencia hacia delante reemplaza la suma sobre los estados anteriores por un máximo, guarda de dónde procede ese máximo y, al final, retrocede por esas elecciones para reconstruir una trayectoria completa. Nació en la decodificación de códigos de comunicación (Viterbi, 1967); aquí el mismo criterio se aplica a la secuencia latente del HMM.
Para el peso conjunto es 0,01119744, equivalente a una probabilidad posterior de aproximadamente 0,3137, frente a 0,1859 de la secuencia de máximos marginales, . La asignación instante a instante puede favorecer ligeramente a al comienzo porque reúne muchas trayectorias distintas que empiezan allí, aunque ninguna de ellas supera por separado a la mejor trayectoria que permanece en . Maximizar una suma de pesos y elegir el mayor peso individual son operaciones distintas.
En esta matriz todas las transiciones están permitidas. Cuando algunas tienen probabilidad cero, concatenar máximos marginales puede llegar a producir una secuencia imposible, porque las decisiones individuales no imponen compatibilidad entre estados consecutivos. Viterbi, en cambio, respeta las restricciones de transición del modelo. Rabiner (1989) desarrolla esta diferencia entre clasificación individual y decodificación global.
Una trayectoria elegida no contiene toda la incertidumbre sobre la ocupación. El resultado de Viterbi permanece siempre en , mientras que el número esperado de instantes en , suma de sus probabilidades suavizadas, es 1,3899. El número esperado de cambios de estado es aproximadamente 0,6670, aunque la trayectoria seleccionada no tenga ninguno. Contar episodios en esa única trayectoria como si sus estados se hubieran observado descarta alternativas que todavía concentran una parte considerable de la probabilidad.
El criterio de decisión depende además del uso previsto. Si confundir una lectura en con una en tiene un coste distinto del error inverso, el umbral de clasificación puede alejarse de la mitad. Eso modifica la decisión tomada con la distribución posterior sin modificar necesariamente la distribución misma. Una trayectoria global óptima bajo pérdida de coincidencia completa y una secuencia que minimiza errores individuales resuelven problemas de decisión diferentes. Es posible mantener las probabilidades como resultado principal y presentar una etiqueta solo cuando una tarea posterior la necesite.
Estimación de parámetros y simetría de etiquetas
Para estimar los parámetros se necesitan probabilidades de pares de estados consecutivos, como , la probabilidad posterior de estar en en el instante y en en el siguiente. Su numerador combina el peso hacia delante, la transición, la emisión siguiente y el peso hacia atrás,
Sumadas en el tiempo, estas cantidades dan los conteos esperados de transiciones con los que el procedimiento de Baum y colaboradores (1970) actualiza los parámetros, integrando sobre las trayectorias no observadas. En una actualización sin restricciones adicionales,
El denominador termina en el penúltimo instante porque el registro no contiene una transición saliente observada desde el último. Las emisiones se actualizan con las frecuencias de cada lectura ponderadas por las probabilidades de pertenencia a cada estado, lo que da conteos fraccionarios, coherentes con la idea de que una observación puede atribuirse en parte a varias trayectorias.
En nuestras cuatro lecturas, los conteos esperados de hacia y hacia son aproximadamente 1,7507 y 0,3038. Su cociente normalizado lleva la probabilidad de permanecer en de 0,9 a 0,8521 y la fila de pasa a 0,3842 y 0,6158. Si se actualizan también las emisiones y la distribución inicial, la verosimilitud sube de 0,03569 a cerca de 0,06212.
El cálculo ilustra una iteración, sin pretender que cuatro observaciones basten para una estimación precisa. Repetir el procedimiento puede conducir a soluciones distintas según la inicialización; que cada actualización exacta no disminuya la verosimilitud no garantiza encontrar el máximo global. Con más estados o con emisiones flexibles conviene comparar varios puntos de partida y verificar que las soluciones no dependan de una única ejecución.
Hasta aquí las probabilidades de los estados se han calculado condicionadas a valores concretos de los parámetros. Si esos valores se estiman con una muestra limitada, aparece una segunda fuente de incertidumbre. Un procedimiento bayesiano puede integrar sobre sus distribuciones posteriores; una evaluación por remuestreo puede reestimar el modelo en registros reproducidos con un diseño adecuado. En ambos casos hay que alinear las etiquetas antes de comparar parámetros de estado. Cambiar las probabilidades de transición cambia también las duraciones esperadas, por lo que la incertidumbre sobre una permanencia larga no se resuelve solo con mostrar una trayectoria segmentada.
Las etiquetas introducen otra ambigüedad. Si se intercambian y , permutando a la vez la distribución inicial, las filas y columnas de la transición y las distribuciones de emisión, todas las probabilidades de las observaciones quedan iguales y nuestro registro sigue teniendo verosimilitud 0,03569152. Dos ajustes pueden describir así lo mismo con nombres opuestos. En inferencia bayesiana, como estudió Stephens (2000) en modelos de mezcla, combinar muestras de ambas denominaciones sin alinearlas puede producir promedios de parámetros que no corresponden a ninguna de las configuraciones ajustadas.
En este ejemplo, ordenar los estados por su probabilidad de emisión alta es una convención útil para comparar soluciones, pero no demuestra que los estados sean categorías naturales. Si las distribuciones de emisión fueran idénticas en ambos estados y las observaciones fueran condicionalmente independientes, la ley de las observaciones ni siquiera dependería de la matriz de transición, porque al sumar sobre todas las trayectorias quedaría el mismo producto de probabilidades de emisión. La permutación de nombres y esta falta de información sobre la dinámica son problemas distintos.
El número de estados depende también de la familia de emisiones y de la dependencia admitida. Pohle y colaboradores (2017) mostraron, con escenarios de simulación, que los estados adicionales pueden absorber desviaciones respecto de esas hipótesis, entre ellas observaciones extremas y duraciones mal representadas. Un estado estadístico que mejora el ajuste necesita, por tanto, una justificación adicional antes de recibir un nombre biológico. En un registro instrumental, esa justificación podría venir de anotaciones independientes, de otra medición o de un contraste experimental previsto antes de examinar la segmentación.
La duración impuesta por una transición constante
Supongamos conocido el comienzo de un episodio en el estado y llamemos al número de instantes consecutivos que ocupa, contando el de entrada. Si la probabilidad de permanecer es , un episodio de duración exige permanecer veces y salir después,
Es una distribución geométrica, con media y varianza . Para el estado , la media es de diez lecturas y la varianza de noventa; para , la media es cinco. Aunque la media sugiera episodios agrupados en torno a diez, la duración individual más probable en es de una sola lectura. Desde allí la distribución decrece y conserva una cola, pues la probabilidad de alcanzar al menos veinte lecturas es , aproximadamente .
La conversión entre persistencia y duración es especialmente sensible cerca de la permanencia segura. Subir la probabilidad de permanecer de 0,9 a 0,95 duplica la duración media, que pasa de diez a veinte lecturas, de modo que una diferencia en apariencia pequeña en la matriz puede ser considerable expresada en tiempo. Al comunicar una estimación interesa transformar también su incertidumbre. Un intervalo simétrico para la persistencia no se convierte, en general, en un intervalo simétrico para la duración. La parte del intervalo de persistencia cercana a uno puede generar una cola muy extensa de medias compatibles.
El rasgo que produce esta forma es la probabilidad constante de salida. Haya permanecido una lectura o nueve, el riesgo de abandonar en el paso siguiente sigue siendo 0,1, siempre que se conozca el estado actual y la matriz sea homogénea. La edad del episodio no aporta información adicional. Esa propiedad puede ser útil para algunos procesos y demasiado restrictiva para otros.
Un mecanismo con una fase de preparación obligatoria difícilmente tendrá la misma probabilidad de salida justo después de entrar que tras completar esa fase. Puede haber también una duración característica con poca dispersión, incompatible con la relación entre media y varianza de la geométrica. Como aumentar la persistencia ensancha la distribución además de desplazar su media, un solo parámetro no permite ajustar ambos aspectos por separado.
La homogeneidad temporal forma parte de la afirmación. Si la probabilidad de salida cambia con la hora, con una intervención externa o con una covariable observada, la supervivencia de un episodio depende del producto de las probabilidades de esos instantes. Puede dejar de ser geométrica aunque el estado siga siendo de Markov condicionado a esas covariables. Una dependencia de la hora del día no debe confundirse con una dependencia de la edad del episodio. Comparar episodios iniciados a horas distintas permitiría separar ambas explicaciones.
Las duraciones anteriores se miden en pasos del modelo y pueden expresarse en minutos si cada paso equivale a un minuto completo de ocupación. Si el estado de un proceso continuo solo se observa en una rejilla de instantes, una racha de etiquetas iguales puede esconder salidas y regresos entre mediciones. En ese caso, la duración de la racha en la rejilla y la permanencia física hasta el primer salto son cantidades diferentes. El modelo discreto debe leerse en la escala que realmente representa.
Modelos semi-Markov y edad del episodio
Un modelo oculto semi-Markov especifica una distribución de duración para cada estado. En una formulación sencilla se elige el estado de destino al terminar un episodio y, al entrar en el nuevo, se genera su duración; durante ese segmento las observaciones siguen la distribución de emisión correspondiente. Para no partir arbitrariamente un episodio en segmentos consecutivos con la misma etiqueta, la cadena de estados de los segmentos se formula habitualmente sin autotransiciones. Es una construcción entre varias, pues hay variantes en que la duración y el destino dependen conjuntamente del estado de origen (Yu, 2010).
Conservemos las emisiones del ejemplo y reemplacemos la duración geométrica de por
La duración media es tres y la varianza . Una geométrica con la misma media requeriría una probabilidad de permanencia de , tendría varianza seis y admitiría salir tras la primera lectura. Las dos distribuciones coinciden en el promedio y difieren en el mecanismo temporal que describen.
La probabilidad de salir después de la lectura de edad , dado que se alcanzó esa edad, es
Para las edades de una a cuatro lecturas, los valores son y . No se permite salir durante el primer paso y después la posibilidad de terminar aumenta. El modelo puede representar así una duración mínima junto con una salida casi obligada al cumplirse cierto tiempo.
Para predecir hacen falta ahora probabilidades sobre el estado y sobre su edad. Dos filtros que asignan la misma probabilidad total a pueden dar pronósticos distintos si uno concentra los episodios en su primera lectura y el otro en la tercera. Si la edad está oculta, las probabilidades de salida de cada edad se ponderan por su distribución filtrada. Reemplazar esa distribución por una edad promedio no es, en general, equivalente, porque la función de salida puede ser no lineal.
El cálculo puede organizarse sumando segmentos posibles y sus duraciones, o bien ampliando el espacio de estados. En nuestro ejemplo se introducen , que comparten exactamente la misma distribución de emisión y corresponden a edades distintas. Desde se pasa obligatoriamente a . Desde se sale hacia con probabilidad o se continúa a con probabilidad ; desde la salida tiene probabilidad , mientras que termina siempre.
La probabilidad de salir tras tres lecturas es entonces y la de llegar a cuatro y salir allí, . Se recupera así exactamente la distribución propuesta. Al volver desde se entra en y la edad del episodio se reinicia.
Langrock y Zucchini (2011) desarrollaron esta representación mediante un HMM ampliado. Para duraciones de soporte finito puede obtenerse una representación exacta y las de soporte infinito admiten aproximaciones cuya precisión se controla al ampliar la representación. Los subestados guardan memoria de la duración. Sería incorrecto interpretar automáticamente y como dos regímenes observables distintos, ya que en esta construcción emiten lo mismo y solo difieren en el tiempo transcurrido desde la entrada.
En una recurrencia por segmentos, el peso de un episodio combina la probabilidad de haber llegado a su comienzo, la masa de su duración y el producto de las emisiones comprendidas entre sus extremos. El peso total en un instante se obtiene sumando sobre los comienzos posibles y los estados de procedencia. Una misma observación puede formar parte de muchos segmentos candidatos sin que se cuente varias veces dentro de una trayectoria, porque cada candidato pertenece a una explicación alternativa del registro. Cuando se impone una duración máxima por razones computacionales, hay que aclarar si esa cota define el modelo o aproxima una distribución que en realidad admite episodios más largos.
Las duraciones pueden compararse reproduciendo registros completos bajo el modelo ajustado. Si lo que se compara son rachas de etiquetas decodificadas, los registros reproducidos deben pasar por el mismo algoritmo de decodificación y tener los mismos bordes de observación que los datos originales. Comparar directamente la distribución teórica de las duraciones ocultas con las rachas de Viterbi mezclaría dos cantidades distintas. La incertidumbre de las emisiones puede unir o fragmentar episodios durante la reconstrucción aunque las duraciones generadas antes de observar sean exactamente las especificadas.
Episodios cortados por los bordes del registro
El final de una grabación no tiene por qué coincidir con la salida de un estado. Si un episodio empieza dentro del registro y lleva cuatro lecturas cuando se apaga el dispositivo, solo sabemos que su duración es de al menos cuatro. Para el estado geométrico , esa contribución vale . Afirmar que el episodio termina exactamente allí introduciría el factor de salida y daría . La diferencia proviene de un cambio de estado que no se ha observado.
La censura debe incorporarse a la verosimilitud de las trayectorias. En un HMM ordinario, terminar después de la última emisión sin añadir una salida obligatoria ya integra las continuaciones posteriores. En una formulación por segmentos, el último segmento exige sumar sobre las duraciones compatibles con seguir presente al final. Yu (2010) distingue estas condiciones de borde de la simplificación que obliga al último estado a terminar justo con la última observación.
Un ejemplo con estados conocidos aísla el efecto. Supongamos tres episodios completos, de longitudes dos, cuatro y tres, más otros dos que siguen abiertos tras cinco y seis lecturas. Los episodios completos aportan tres salidas y seis permanencias; los censurados, nueve permanencias y ninguna salida observada. Para una duración geométrica común, la probabilidad de salida estimada es de tres salidas en dieciocho oportunidades observadas, es decir, , con una duración media estimada de seis.
Si los dos cortes se tratan como finales reales, se inventan dos salidas y el cálculo pasa a cinco salidas en veinte oportunidades, con una media de cuatro. Los datos registrados son los mismos; lo que cambió fue la información atribuida a su borde derecho. Con estados ocultos estos conteos se reemplazan por expectativas sobre trayectorias, aunque el apagado del dispositivo sigue sin ser una transición observada.
El borde izquierdo plantea otra cuestión. Si la grabación empieza durante un episodio ya iniciado, la primera lectura no informa de su edad. Una distribución inicial concentrada en la edad uno supondría un comienzo que no se conoce. Puede formularse en su lugar una distribución conjunta de estado y edad al abrir el registro, basada en el diseño o en una hipótesis de equilibrio del proceso.
La información externa puede resolver parte del problema. Si un evento observable marca el comienzo del régimen, su edad puede iniciarse en ese momento y la incertidumbre queda limitada a las emisiones posteriores. Si solo se sabe que el proceso ya estaba en marcha, hay que repartir la probabilidad entre varias edades. Ambas situaciones producen pronósticos diferentes aunque la primera amplitud registrada sea idéntica. La condición inicial describe qué se sabe al abrir la ventana de observación, por lo que es aconsejable decidirla a partir del protocolo, al margen de la comodidad del algoritmo.
Además, los episodios que se encuentran al elegir un instante al azar están seleccionados por su longitud, porque uno largo abarca más instantes en los que puede ser encontrado. En un régimen de renovación estacionario, dado el estado y bajo las condiciones habituales de media finita, la probabilidad de que el episodio completo tenga longitud es proporcional a . Para la geométrica de media diez y varianza noventa, la longitud media de ese episodio completo es diecinueve, pues vale . El resultado describe otra selección de episodios y no cambia la propiedad geométrica del tiempo restante.
La distribución semi-Markov propuesta muestra el peso de la edad sin necesidad de un registro largo. Si una observación externa confirma que el episodio va en su tercera lectura, sabemos ya que no duró dos. Entre las duraciones compatibles, tres recibe probabilidad y cuatro . Tras la lectura actual, el número esperado de lecturas futuras que todavía pertenecerán a es un tercio. Si el registro termina justo ahí, se conserva la supervivencia de correspondiente a haber alcanzado esa edad. Una nueva lectura en en el paso siguiente llevaría toda la probabilidad a la duración cuatro y, bajo este modelo concreto, obligaría a predecir la salida en el paso posterior.
Referencias
Baum, L. E., Petrie, T., Soules, G., & Weiss, N. (1970). A maximization technique occurring in the statistical analysis of probabilistic functions of Markov chains. The Annals of Mathematical Statistics, 41(1), 164–171. https://doi.org/10.1214/aoms/1177697196
Langrock, R., & Zucchini, W. (2011). Hidden Markov models with arbitrary state dwell-time distributions. Computational Statistics & Data Analysis, 55(1), 715–724. https://doi.org/10.1016/j.csda.2010.06.015
Pohle, J., Langrock, R., van Beest, F. M., & Schmidt, N. M. (2017). Selecting the number of states in hidden Markov models: Pragmatic solutions illustrated using animal movement. Journal of Agricultural, Biological and Environmental Statistics, 22(3), 270–293. https://doi.org/10.1007/s13253-017-0283-8
Rabiner, L. R. (1989). A tutorial on hidden Markov models and selected applications in speech recognition. Proceedings of the IEEE, 77(2), 257–286. https://doi.org/10.1109/5.18626. Consultado junto con la hoja de correcciones del autor: https://web.ece.ucsb.edu/Faculty/Rabiner/ece259/Reprints/hmm%20tutorial%20errata.pdf
Stephens, M. (2000). Dealing with label switching in mixture models. Journal of the Royal Statistical Society: Series B, 62(4), 795–809. https://doi.org/10.1111/1467-9868.00265
Viterbi, A. J. (1967). Error bounds for convolutional codes and an asymptotically optimum decoding algorithm. IEEE Transactions on Information Theory, 13(2), 260–269. https://doi.org/10.1109/TIT.1967.1054010
Yu, S.-Z. (2010). Hidden semi-Markov models. Artificial Intelligence, 174(2), 215–243. https://doi.org/10.1016/j.artint.2009.11.011