El termómetro sumergido en un recipiente marca veinte grados y, un minuto después, veintidós. Esa subida puede deberse a que el agua se calentó, a un error de lectura o a ambas cosas a la vez. Repetir el último valor no despeja la duda y promediar las dos cifras tampoco dice qué parte del cambio debería conservarse en el minuto siguiente. Hacen falta dos descripciones, una de cómo evoluciona la temperatura del agua y otra de cómo esa temperatura termina convertida en un número del registro.
Un modelo de espacio de estados mantiene separadas esas dos descripciones. El estado reúne las variables con que se describe la evolución del proceso; la observación es lo que entrega el instrumento. Entre uno y otra puede haber ruido, un cambio de escala o una proyección que deje parte del estado fuera de la vista. Esa separación permite combinar lo que se sabe de la dinámica con lo que informan las mediciones y obliga también a especificar qué parte de la reconstrucción descansa en cada supuesto.
Los ejemplos numéricos de este capítulo son didácticos. El recipiente, sus lecturas y los parámetros de ruido se eligieron para que las cuentas pudieran seguirse a mano y no provienen de un experimento físico. Esa sencillez permite estudiar una dificultad que reaparece en señales fisiológicas, registros conductuales o indicadores económicos, donde también hay que estimar una variable que nunca se observa tal como figura en el modelo.
Qué debe contener el estado
Llamaremos al estado en el instante y a la observación correspondiente. El estado puede ser un escalar (una temperatura, por ejemplo) o un vector con varias cantidades. Su dimensión la decide la estructura que hace falta para describir la evolución. Una componente adicional se justifica cuando guarda información que cambia la distribución del futuro y que las demás componentes no contenían.
Supongamos que dos recipientes están ahora a veinte grados. Uno venía calentándose desde diecinueve y el otro se enfriaba desde veintiuno. Si las tendencias persisten, la misma temperatura actual puede llevar a futuros distintos. Un modelo cuyo estado fuera solo la temperatura tendría que recoger esa diferencia mediante una dependencia más larga del pasado; otra posibilidad es agregar al estado una tasa de cambio.
Una representación local sencilla contiene un nivel y una pendiente ,
Aquí el nivel se mide en grados, la pendiente en grados por minuto y es el intervalo entre observaciones, en minutos. La perturbación desplaza el nivel respecto de la extrapolación lineal, mientras que modifica la pendiente. Con un intervalo de un minuto, pendientes actuales de uno y menos uno y perturbaciones de media cero, los niveles esperados al minuto siguiente son veintiuno y diecinueve, respectivamente.
Conocer el vector formado por nivel y pendiente puede bastar para escribir la distribución del estado siguiente sin consultar toda la historia. Esa es la propiedad de Markov que adopta la representación, según la cual, dado el estado actual, el siguiente no necesita información adicional de estados anteriores. La propiedad pertenece al modelo y a las variables elegidas para él y no afirma que el sistema físico carezca de memoria; parte de esa memoria se ha incorporado al estado.
La secuencia observada, en cambio, puede conservar una dependencia más compleja. Cuando el termómetro añade error, la lectura de hoy no determina exactamente el estado de hoy; las lecturas anteriores ayudan a estimarlo y por esa vía siguen siendo útiles para predecir. Un estado de primer orden no obliga a que las observaciones formen una autorregresión de primer orden.
La representación por componentes describe niveles, tendencias y otros elementos con reglas propias, como desarrolla el tratamiento de Durbin y Koopman (2012). Ponerle nombre a un componente no demuestra su interpretación sustantiva; un estado llamado «activación» necesita todavía una relación defendible con las medidas disponibles. Si su escala puede cambiarse y el cambio compensarse en la ecuación de observación sin alterar ninguna predicción, su unidad no ha quedado fijada por los datos.
Imaginemos, para verlo, un instrumento que registra el doble de un estado latente. El mismo registro admite otra descripción, con un estado que vale dos veces el primero y un instrumento que lo registra directamente, sin que cambie la variable observada. En aplicaciones físicas, una calibración puede fijar la unidad, mientras que en los modelos de factores latentes es habitual fijar alguna carga o varianza para establecer la escala. Esa elección define las coordenadas en que se comunicarán los resultados.
Una ecuación para la dinámica y otra para el instrumento
En una formulación probabilística general, la evolución se describe con una distribución de transición y la medición con una distribución de observación . El símbolo agrupa los parámetros que esta formulación mantiene fijos, como coeficientes dinámicos o varianzas. Se necesita además una distribución inicial .
Si las observaciones son condicionalmente independientes dado el estado correspondiente y la dinámica cumple la propiedad de Markov, la distribución conjunta se factoriza como
La notación designa la trayectoria completa, desde el instante inicial hasta el final; agrupa todas las observaciones. Cada factor contesta una pregunta distinta (qué estados eran posibles al comienzo, cómo podían sucederse, qué lecturas podía producir cada uno). Al integrar sobre los estados desaparecen las variables no observadas y queda una distribución para los datos que efectivamente se registraron.
En el caso lineal estas relaciones suelen escribirse así,
La matriz propaga el estado y lo lleva al espacio de la medición. El ruido de proceso recoge la variación que la parte determinista de la transición no explica, mientras que el ruido de medida corresponde a las discrepancias entre el estado y su observación. Sus matrices de covarianza se escriben habitualmente y . La versión más sencilla supone que ambos ruidos tienen media cero, son independientes entre tiempos y entre sí e independientes también del estado inicial.
Esos supuestos tienen que corresponder a lo que hace el instrumento. Si un sensor responde con retraso, su lectura puede depender de temperaturas anteriores aun cuando se conozca la actual; en ese caso una ecuación instantánea con error independiente puede ser insuficiente. Es posible incorporar al estado la temperatura interna del propio sensor y describir cómo responde, lo que amplía el estado para dar cuenta de una dependencia concreta que el modelo anterior dejaba en los residuos.
No todo error instrumental fluctúa alrededor de cero. Un sesgo constante de un grado exige un término de calibración o un componente adicional. Inflar la varianza del ruido para cubrirlo mezcla dos propiedades distintas de las lecturas, su dispersión y su desplazamiento sistemático. Muchas mediciones del mismo sensor pueden reducir la incertidumbre sobre su promedio sin revelar que ese promedio está desplazado.
Las unidades son una buena herramienta para revisar la especificación. Si el estado contiene temperatura y tasa de cambio, sus componentes se miden en unidades distintas y la entrada de la matriz que convierte pendiente en cambio de temperatura debe llevar una duración. Las covarianzas también tienen unidades (grados al cuadrado para la varianza del nivel, grados al cuadrado por minuto para su covarianza con la pendiente). Quien trata todas esas entradas como números puros se expone a errores en cuanto cambia la frecuencia de registro.
La observación no necesita usar la misma escala que el estado. Si la temperatura se expresa internamente en grados Celsius y el sensor entrega Fahrenheit, la relación de medida multiplica por 1,8 y suma 32, de modo que un estado de 20 °C produce una lectura esperada de 68 °F. Un error de varianza uno en Fahrenheit al cuadrado se convierte, al pasar la lectura a Celsius, en una varianza de aproximadamente 0,31. Conservar el número uno tras el cambio de unidad describiría otro instrumento, con otra precisión; la transformación de la medida debe acompañarse de la de su incertidumbre.
A la transición puede añadirse una entrada externa conocida, por ejemplo una secuencia de potencia térmica fijada por el experimentador. Habría que declarar cómo y cuándo actúa. En cambio, incluir como entrada una acción tomada en respuesta a información que no quedó registrada puede alterar la interpretación de la ecuación. Escribir un término de entrada no identifica automáticamente el efecto de intervenir sobre él.
Dos ruidos que dejan huellas diferentes
Para el recipiente adoptaremos, de forma provisional, un modelo de nivel local,
con ruidos independientes de media cero, varianza de proceso y varianza de medida . El estado es la temperatura y la observación es la lectura. La aproximación describe un periodo corto sin incorporar una ley completa de intercambio térmico y admite que la temperatura cambie entre mediciones, pero no trata cada variación de la lectura como una variación exacta del agua.
El ruido de proceso no tiene por qué corresponder a una fuente física elemental de azar y puede recoger perturbaciones que el modelo decidió no describir una por una, como pequeñas entradas de calor desconocidas. Si esas entradas tienen una estructura persistente, tratarlas como errores independientes es una aproximación que habrá que revisar. Medir una entrada que antes se ignoraba puede trasladar parte de la variación desde el término de ruido hacia una componente explícita de la transición. El significado de depende, por ello, de qué variables se hayan incluido en el modelo.
Un error de medida positivo eleva la lectura de un instante, pero por sí mismo no modifica el estado siguiente. Una perturbación del proceso, en cambio, modifica el estado y se propaga a las temperaturas posteriores a través de la transición. Esa diferencia temporal aporta información para separar ambos componentes, siempre que la estructura supuesta sea adecuada.
Al restar observaciones consecutivas se obtiene
La varianza de esta diferencia es . Dos diferencias consecutivas comparten un error de medida con signos opuestos, por lo que su covarianza vale . Con y , esos valores teóricos son y . En este modelo la covarianza negativa aporta información sobre el error de medida que la amplitud de los cambios, considerada aisladamente, no contiene.
Si llamamos a la varianza de las diferencias y a su covarianza con un retardo, se cumplen y . Son identidades de la distribución postulada. En un registro finito las estimaciones fluctúan. Al reemplazar los momentos teóricos por los muestrales puede aparecer una varianza de proceso negativa. Esa cantidad es físicamente imposible y señala un problema de estimación o una incompatibilidad entre los datos y las condiciones del modelo.
La separación puede fallar de un modo más profundo cuando falta una huella temporal que la sostenga. Pensemos en otro modelo, escrito en desviaciones respecto de veinte grados, en el que el estado de cada minuto es independiente del anterior, normal, de media cero y varianza . Como la medición le suma un error normal independiente de varianza , todas las observaciones centradas resultan independientes y normales, con varianza .
Los pares y generan exactamente la misma distribución observada. Aun así, ante una lectura de veintidós, el primer reparto asigna a la temperatura una media condicional de 20,4 (una vez repuesta la referencia) y el segundo una de 21,6, con varianza condicional de 0,2 en ambos casos. Las lecturas no distinguen qué reparto produjo el registro, aunque ese reparto cambie la reconstrucción del estado.
La equivalencia abarca la serie entera y va más allá de la varianza muestral. Con cualquiera de los dos repartos cada lectura tiene la misma densidad normal y las lecturas son independientes, por lo que toda secuencia observada recibe la misma verosimilitud. Un optimizador podría devolver uno de los dos por efecto de sus restricciones o de su punto de partida, sin haber hallado evidencia que lo distinga del otro. La distribución condicional del estado responde correctamente a los parámetros suministrados y, aun así, queda pendiente qué parámetros describen el proceso.
Se trata de una falta de identificación estructural de las dos varianzas en esa especificación; una serie arbitrariamente larga de observaciones del mismo tipo seguiría revelando solo su suma. El caso difiere del de una estructura identificable cuya separación resulta imprecisa con los datos reunidos. Auger-Méthé y colaboradores (2016) mostraron mediante simulaciones que incluso modelos lineales gaussianos sencillos pueden tener problemas serios para estimar parámetros y estados, sobre todo cuando el error de medida domina la variación del proceso. De su resultado no se sigue que todo modelo de estados sea imposible de estimar.
Una medición adicional bien diseñada puede aportar información de otra naturaleza. Si dos sensores independientes, con igual varianza de error, observan el mismo estado en el mismo instante, la diferencia entre sus lecturas cancela el estado y tiene una varianza igual al doble de la de cada sensor. Con las réplicas puede estudiarse entonces la medida sin confundir su dispersión con cambios reales ocurridos entre instantes.
La cuenta descansa en la independencia entre sensores. Si ambos comparten una fluctuación de referencia, esa fluctuación también se cancela al restar; la diferencia permite estimar el ruido propio de cada lectura, pero no revela el componente común. Dos instrumentos conectados a la misma referencia pueden coincidir estrechamente entre sí y compartir, aun así, una incertidumbre importante sobre el estado.
Observabilidad e identificabilidad
La observabilidad pregunta si la información contenida en las salidas basta para distinguir estados iniciales cuando la dinámica se da por conocida. La identificabilidad hace la misma pregunta respecto de los valores de los parámetros. Bellman y Åström (1970) formularon la identificabilidad estructural en términos de lo que puede aprenderse sobre la estructura interna de un sistema a partir de medidas de entrada y salida. Que dos configuraciones sean distinguibles en principio no equivale a obtener estimaciones precisas con cualquier registro ruidoso.
Volvamos al modelo de nivel y pendiente con un intervalo de un minuto, sin perturbaciones y con observación exacta del nivel. La primera observación entrega el nivel inicial y la segunda ese nivel más la pendiente. Entre las dos determinan ambos componentes (la pendiente es la diferencia de niveles dividida por el intervalo). Gracias a la dinámica, la observación instantánea de una sola componente puede hacer observable un estado de dos dimensiones.
Con lecturas ruidosas, la diferencia que informa sobre la pendiente arrastra ese ruido. Acortar mucho el intervalo reduce el cambio que produce una pendiente dada y, al dividir por un intervalo pequeño, el error de las lecturas se amplifica en la estimación de la tasa. Con errores independientes de varianza uno, la varianza del error de la pendiente calculada con dos lecturas es . El modelo sigue siendo observable con cualquier intervalo no nulo, aunque la precisión puede empeorar mucho a medida que las dos mediciones se acercan.
Agregar mediciones próximas puede ayudar si con ello aumenta la información total. La cuenta anterior compara exactamente dos lecturas con el mismo ruido y no afirma que una frecuencia mayor sea perjudicial en cualquier diseño. Si se mantiene la duración del registro y se suman observaciones independientes, el problema cambia. La precisión depende del patrón completo de observación, de la duración y de las dependencias del error.
Un sesgo desconocido crea una ambigüedad de otro tipo. Supongamos que el instrumento registra con un sesgo constante y que el estado sigue un paseo aleatorio. Si se suma una misma cantidad a todos los estados y se resta del sesgo, las observaciones previstas quedan iguales, lo mismo que los incrementos del estado. Mientras ninguna información externa ancle el nivel inicial, el registro no separa el nivel absoluto del sesgo.
Fijar el sesgo en cero elimina esa libertad desde el punto de vista matemático, a costa de introducir una afirmación de calibración. Una distribución previa muy estrecha para el sesgo también puede concentrar la estimación, aunque en ese caso la información venga sobre todo de la previa. Conviene indicar qué dato externo, restricción de unidades o supuesto fijó cada dirección que las observaciones no distinguían.
Los parámetros pueden aprenderse junto con los estados, aunque se trata de objetivos distintos. Dados los parámetros, se calcula una distribución sobre las trayectorias posibles. Para estimarlos por máxima verosimilitud se usa, en cambio, la probabilidad marginal de las observaciones, que se obtiene integrando sobre los estados. Shumway y Stoffer (1982) propusieron un procedimiento que combina el suavizado con el algoritmo EM para estimar parámetros en modelos de estados, incluso cuando faltan observaciones.
Que un algoritmo produzca una trayectoria para cada valor candidato de las varianzas no demuestra que los datos prefieran claramente uno de esos valores. Un perfil de verosimilitud plano o una estimación situada en la frontera del espacio de parámetros obligan a examinar la identificación y la información disponible. Cuando los parámetros estimados se usan como si fueran conocidos, la incertidumbre que se comunica para los estados queda condicionada a esa sustitución. Incorporar la incertidumbre de los parámetros puede ensanchar la distribución resultante y cambiar también su forma.
El ejemplo de las dos varianzas permite calcular esa diferencia. Supongamos que solo se consideran los dos repartos mencionados, cada uno con probabilidad previa de un medio. Como ambos generan la misma distribución de observaciones, ningún registro modifica esas probabilidades. Después de una lectura de veintidós, la temperatura sigue entonces una mezcla de dos normales centradas en 20,4 y 21,6, ambas con varianza 0,2.
La mezcla tiene media 21 y varianza 0,56, que resulta de sumar la varianza dentro de cada modelo (0,2) y la dispersión entre sus medias (0,36). Quien elige uno de los repartos y comunica solo su varianza condicional borra esta segunda fuente de incertidumbre. Sin inventar información que resuelva la ambigüedad, la mezcla conserva explícitamente dos explicaciones que las mediciones disponibles no separan.
Filtrado, predicción y suavizado
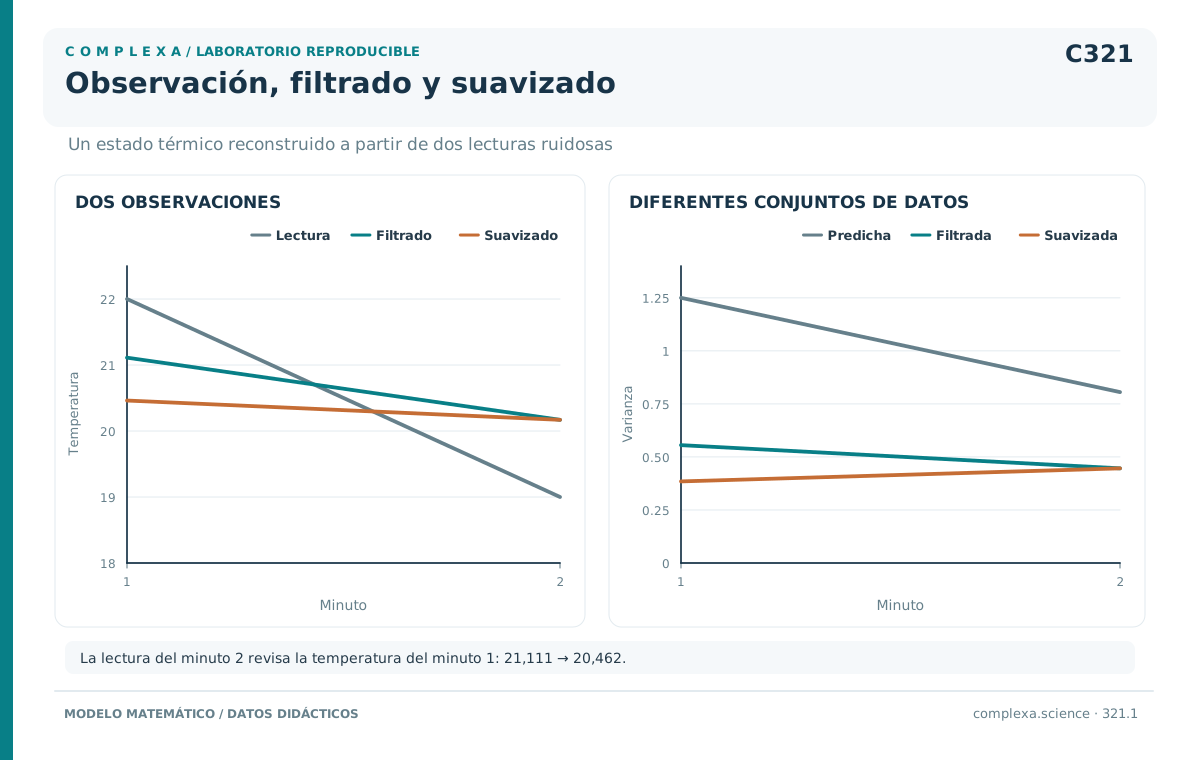
El filtrado estima el estado actual con las observaciones disponibles hasta ese instante, es decir, . La predicción lleva esa información hacia un estado futuro, como en . El suavizado estima un estado pasado usando también observaciones posteriores, con . Los tres cálculos pueden hacerse con el mismo modelo; lo que cambia es la variable de interés o el conjunto de datos al que se condiciona.
La formulación de Kalman (1960) resuelve de manera recursiva la estimación lineal bajo las condiciones correspondientes. Rauch, Tung y Striebel (1965) obtuvieron las relaciones entre estimaciones filtradas y suavizadas para sistemas lineales con ruido gaussiano. El suavizado permite revisar la reconstrucción histórica a medida que llegan lecturas nuevas, pero esas lecturas no pasan por ello a ser información que estuviera disponible al emitir una decisión anterior.
En la formulación general, la predicción integra la transición sobre la incertidumbre del estado previo. La actualización multiplica la distribución predictiva del estado por la probabilidad de la observación recibida y normaliza el resultado. No se propaga únicamente un valor central, porque dos distribuciones con la misma media pueden producir predicciones distintas cuando la dinámica o la medida dependen de su forma. Las fórmulas simples para medias y covarianzas requieren supuestos adicionales.
Volvamos al recipiente con un modelo completamente especificado. El estado inicial es normal, con media veinte y varianza uno. Cada minuto se suma una perturbación normal de media cero y varianza 0,25, mientras que el error de cada lectura es normal, de media cero y varianza uno. Estado inicial, perturbaciones y errores son mutuamente independientes. Recibimos una lectura de veintidós en el primer minuto y otra de diecinueve en el segundo.
Antes del primer dato, la temperatura del primer minuto tiene media veinte y varianza 1,25. Al incorporar la lectura de veintidós, la media sube a 21,11 y la varianza baja a 0,56. El modelo reparte la discrepancia entre un estado más alto y el error de medida, sin pretender que la temperatura reconstruida se haya observado exactamente.
A partir de esa actualización, la temperatura prevista para el segundo minuto mantiene la media y su varianza sube a 0,81 al sumarse la perturbación del minuto nuevo. La lectura futura tiene una varianza todavía mayor, 1,81, ya que a la incertidumbre del estado se agrega el error del termómetro. La incertidumbre sobre un estado y la incertidumbre sobre la lectura que ese estado podría producir no son intercambiables.
Con la segunda lectura, diecinueve, la estimación del estado actual baja a 20,17, con varianza 0,45. También el primer minuto puede revisarse. Su media suavizada queda en 20,46 y su varianza en 0,38. La lectura posterior vuelve menos probable que toda la subida inicial se debiera a una temperatura alta y persistente.
| Cantidad reconstruida | Observaciones utilizadas | Media | Varianza |
|---|---|---|---|
| Estado del minuto 1, filtrado | Primera lectura | 21,1111 | 0,5556 |
| Estado del minuto 2, predicho | Primera lectura | 21,1111 | 0,8056 |
| Lectura del minuto 2, predicha | Primera lectura | 21,1111 | 1,8056 |
| Estado del minuto 2, filtrado | Ambas lecturas | 20,1692 | 0,4462 |
| Estado del minuto 1, suavizado | Ambas lecturas | 20,4615 | 0,3846 |
Las medias están en grados y las varianzas en grados al cuadrado, todas obtenidas condicionando distribuciones gaussianas conjuntas con parámetros conocidos. En este modelo la covarianza condicional se reduce al incorporar la lectura adicional. Fuera de él no puede suponerse que cualquier medida de incertidumbre disminuya con cada resultado particular de una observación.
Una media estimada por encima de un umbral puede dejar mucha probabilidad por debajo de él. En el ejemplo gaussiano, tras la primera lectura la probabilidad de que el agua estuviera sobre veintiún grados es de alrededor de 56 %. La media filtrada supera el umbral, aunque una parte considerable de la distribución queda bajo él. Cuando se incorpora la segunda lectura, la probabilidad suavizada para ese mismo primer minuto cae a cerca de 19 %.
Ambos porcentajes se calculan bajo las varianzas y la dinámica declaradas y no son frecuencias observadas de acierto del sensor ni garantías de calibración empírica. Si la reconstrucción alimenta una decisión, debe quedar registrada la probabilidad que estaba disponible en el momento de tomarla.
Cuando se llama «causal» a un filtro que usa solo información presente y pasada, el término tiene un sentido temporal que describe qué información entra en el cálculo. Ese uso no demuestra que una variable observada cause otra ni que la transición estimada describa el efecto de una intervención. Una relación predictiva con un estado latente puede seguir siendo compatible con varias explicaciones causales.
La procedencia de los parámetros también afecta al calendario informativo. Una curva puede calcularse con recursiones de filtrado y tener, sin embargo, varianzas estimadas con el registro completo, observaciones posteriores incluidas. Esa curva queda condicionada a parámetros que contienen información del futuro. Puede servir para una descripción retrospectiva, pero no reproduce la estimación que habría podido emitirse en su momento con los datos de entonces. Una evaluación operativa debe fijar los parámetros con información disponible previamente o especificar cómo se fueron actualizando en cada fecha.
La distribución inicial
La distribución inicial forma parte del modelo. Expresa lo que se sabe antes de procesar la primera observación y no es un detalle que el programa pueda elegir sin consecuencias. En el ejemplo, la varianza inicial de uno admitía temperaturas distintas de veinte. Fijarla en cero equivaldría a afirmar que la temperatura inicial se conoce con exactitud, aunque la varianza de proceso positiva volvería a introducir incertidumbre en los minutos siguientes.
Algunos modelos estables tienen una distribución estacionaria que puede usarse para iniciar el cálculo. Otros, como el paseo aleatorio de este capítulo, no tienen una distribución estacionaria de varianza finita. Aplicarles la misma inicialización exige otra justificación. Dentro de un mismo vector de estado también puede haber componentes bien conocidos junto a otros sobre los que apenas se sabe algo.
Una inicialización difusa trata el desconocimiento amplio de ciertas componentes con un procedimiento específico. No equivale simplemente a escribir un número enorme en cada posición de una matriz. Las unidades, la estructura del estado y el comportamiento numérico intervienen en esa aproximación. Durbin y Koopman (2012) dedican un tratamiento propio a la inicialización de filtros y suavizadores, separado del resto de las recursiones. Al comunicar un resultado conviene informar la distribución inicial utilizada y comprobar cuánto pesa en el primer tramo del registro.
La primera observación no debe contarse dos veces. Si una lectura se usó para construir la estimación inicial, su información ya entró en el cálculo. Procesarla después como una medición nueva e independiente puede producir una concentración artificial de la distribución, ya que dos copias del mismo número no son dos observaciones con errores independientes. El registro tiene que indicar si la inicialización proviene de una calibración externa, de datos anteriores o del primer dato de la propia serie.
La influencia de la inicialización puede disminuir a medida que se acumulan mediciones informativas, pero no desaparece por el mero paso del tiempo. En el ejemplo del sesgo desconocido, la dirección que las observaciones no distinguen seguirá dependiendo del anclaje inicial por largo que sea el registro, mientras no llegue la información de calibración que falta.
Evaluación y registro de las reconstrucciones
Una trayectoria estimada puede verse más regular que las lecturas y ser compatible con ellas sin que eso valide su interpretación como estado físico. Su regularidad depende de la proporción entre variación del proceso y error de medida que se haya supuesto o estimado. Un modelo que admite mucho ruido de observación y pocos cambios reales tiende a atribuir las fluctuaciones rápidas al instrumento, mientras que con otra proporción entre varianzas la trayectoria puede seguir más de cerca los datos.
Cuando el estado real no se observa, pueden evaluarse las predicciones de mediciones que todavía no se han usado. La distribución predictiva debe incluir tanto la incertidumbre del estado como la del instrumento. También pueden examinarse las innovaciones, es decir, las discrepancias entre cada lectura y su predicción basada en el pasado. Comparar la trayectoria con observaciones que ya se usaron para suavizarla responde a otra pregunta y puede dar una impresión exagerada del desempeño prospectivo.
En simulaciones con parámetros y estados conocidos puede comprobarse si un procedimiento recupera lo que debe en condiciones controladas. Variando las varianzas, la duración o la calidad de la inicialización se localizan sus puntos débiles. Sin embargo, acertar en un modelo simulado no demuestra que la misma estructura describa el proceso empírico. Una calibración externa del sensor o una medición ocasional más precisa pueden comprobar aspectos inaccesibles para la observación ordinaria.
Si falta una lectura y su ausencia no aporta información adicional sobre el estado bajo el mecanismo supuesto, puede propagarse la distribución y omitirse la actualización de medida. No hace falta rellenar el hueco con una observación inventada. Otra cosa ocurre si el instrumento deja de informar justamente cuando la temperatura sale de cierto rango. Ahí la ausencia sí puede contener información y el mecanismo de observación debe formar parte del modelo, ya que omitirlo cambia el conjunto de datos al que se está condicionando.
En el caso del recipiente, un archivo reproducible guardaría las lecturas originales, las estimaciones emitidas después de cada lectura y las reconstrucciones posteriores, cada una con su etiqueta. Al terminar el primer minuto la estimación disponible era 21,11. Tras el segundo, la reconstrucción del primer minuto pasó a 20,46. El registro operativo conserva el primer número como el resultado emitido en su momento y agrega el segundo como revisión histórica, fechada un minuto después.
Referencias
Auger-Méthé, M., Field, C., Albertsen, C. M., Derocher, A. E., Lewis, M. A., Jonsen, I. D., & Mills Flemming, J. (2016). State-space models’ dirty little secrets: Even simple linear Gaussian models can have estimation problems. Scientific Reports, 6, 26677. https://doi.org/10.1038/srep26677
Bellman, R., & Åström, K. J. (1970). On structural identifiability. Mathematical Biosciences, 7(3–4), 329–339. https://doi.org/10.1016/0025-5564(70)90132-X
Durbin, J., & Koopman, S. J. (2012). Time series analysis by state space methods (2.ª ed.). Oxford University Press. https://doi.org/10.1093/acprof:oso/9780199641178.001.0001
Kalman, R. E. (1960). A new approach to linear filtering and prediction problems. Journal of Basic Engineering, 82(1), 35–45. https://doi.org/10.1115/1.3662552
Rauch, H. E., Tung, F., & Striebel, C. T. (1965). Maximum likelihood estimates of linear dynamic systems. AIAA Journal, 3(8), 1445–1450. https://doi.org/10.2514/3.3166
Shumway, R. H., & Stoffer, D. S. (1982). An approach to time series smoothing and forecasting using the EM algorithm. Journal of Time Series Analysis, 3(4), 253–264. https://doi.org/10.1111/j.1467-9892.1982.tb00349.x