Un instrumento que registra el cuadrado de una magnitud pierde su signo. Una lectura cercana a cuatro puede venir de un estado próximo a dos o de otro próximo a menos dos. Reducir el ruido del instrumento estrecha esas dos posibilidades, pero no permite escoger entre ellas. Un algoritmo que guarde únicamente una media y una varianza tendrá que resumir una información cuya forma ya no se parece a una campana centrada en un solo lugar.
La dificultad puede aparecer aunque el estado anterior y todos los errores se hayan descrito con distribuciones normales, porque la transformación introduce la asimetría o las alternativas que el modelo lineal no generaba. Al extender un filtro de Kalman hay que decidir, por tanto, qué se aproxima (la transformación, los momentos que produce o la distribución posterior que queda después de observar). Cada una de esas decisiones tiene consecuencias propias y puede comprobarse por separado.
Los ejemplos que siguen son construcciones didácticas en unidades normalizadas, con parámetros que se suponen conocidos. Ese control hace posible comparar las aproximaciones con integrales calculadas directamente, sin mezclar los errores del algoritmo con la incertidumbre sobre los parámetros.
La distribución que hay que actualizar
Consideremos un estado, escalar o vectorial, que evoluciona según una función conocida y se observa de manera indirecta,
El ruido de proceso tiene media cero y covarianza ; el de observación , media cero y covarianza . Por ahora los supondremos gaussianos e independientes entre sí, de los estados y de los errores anteriores. Las funciones y pueden ser no lineales. Con la distribución del estado antes de observar se puede calcular una distribución predictiva de la lectura, aunque para ello haya que integrar sobre todos los estados posibles.
La actualización bayesiana multiplica la densidad previa por la verosimilitud de la nueva lectura y normaliza el producto. Si ambas piezas son gaussianas y la observación es lineal, el producto conserva la forma gaussiana. Con una observación cuadrática, en cambio, la verosimilitud lleva una potencia cuarta del estado dentro del exponente y la posterior puede tener dos máximos aunque la previa tuviera uno solo.
Un filtro gaussiano describe el estado con una media y una covarianza . De esa representación parte en cada paso para hacer la siguiente propagación. Ese resumen tiene una ventaja computacional concreta, ya que el número de parámetros no crece con la longitud del registro. El precio es que la forma descartada después de una actualización ya no está disponible para la siguiente y, si había dos regiones separadas de alta probabilidad, una media intermedia no conserva sus posiciones ni sus pesos.
Ito y Xiong (2000), que distinguen entre la formulación de filtros gaussianos y las representaciones mediante mezclas de gaussianas, estudian además cómo evaluar numéricamente las integrales que unos y otras requieren. La precisión de una integral y la flexibilidad de la familia de distribuciones son problemas diferentes. Se puede calcular con mucha exactitud la media de una distribución bimodal y seguir sin disponer de una representación adecuada de sus dos modos.
En una aplicación conviene tener claro qué cantidad se necesita. Para minimizar un error cuadrático puede bastar una media. Para decidir si el estado supera un umbral hace falta una probabilidad; para describir alternativas incompatibles, la distribución completa. Un filtro que acierta con la primera cantidad puede equivocarse con las otras, por lo que la comparación entre métodos debe hacerse con ese objetivo a la vista, además de contabilizar su coste.
Linealización de la transición
El filtro de Kalman extendido, que suele abreviarse EKF, reemplaza cada transformación por una aproximación afín en torno al estado estimado. Si la media anterior es , la expansión de primer orden de la transición es
En varias dimensiones es la matriz jacobiana, cuyas entradas miden la sensibilidad local de cada componente de la salida a cada componente del estado. La media predictiva se aproxima por y su covarianza por , donde el superíndice menos indica que la lectura actual todavía no se ha usado.
Poder calcular la derivada es apenas la primera condición. La región que ocupa la incertidumbre tiene que quedar razonablemente bien descrita por la expansión. Una función suave puede curvarse de forma apreciable a lo largo de una distribución amplia; otra, muy no lineal a escala global, puede comportarse casi como una recta dentro de una región pequeña. La escala que importa depende a la vez de la función y de la incertidumbre del estado.
Para un estado escalar, el primer término omitido es la segunda derivada multiplicada por el cuadrado del desplazamiento. Al promediarlo aparece una contribución aproximada de a la media transformada y por eso aplicar a la media no suele coincidir con transformar primero cada estado posible y promediar después. El signo de la curvatura indica hacia dónde puede desplazarse ese promedio; la varianza previa, cuánto pesa la región explorada.
Tomemos la transición más un ruido independiente de varianza 0,04, con un estado previo normal de media dos y varianza un cuarto. El EKF predice una media de 2,4, mientras que el promedio exacto de la transición es 2,425. La diferencia de 0,025 se debe a la varianza previa, que entra a través del término cuadrático.
La derivada en dos vale 1,4, de manera que el EKF propaga una varianza de 0,53 una vez añadido el ruido. La varianza exacta, obtenida con los momentos de la normal, es 0,53125 e incluye un término adicional proporcional al cuadrado de la varianza previa. En este ejemplo la corrección de la dispersión es pequeña, pero no nula. Media y varianza se equivocan por razones emparentadas y en magnitudes distintas.
Estas cuentas corresponden a la predicción antes de recibir un dato nuevo y, por tanto, todavía no describen una posterior completa. Aun conociendo exactamente sus primeros momentos, la transformación cuadrática de una normal da en general una distribución que no es normal. Si después se sigue adelante con una aproximación gaussiana, todavía se está simplificando la forma de la distribución.
La observación cuadrática permite medir directamente el término omitido. Si escribimos el estado como su media más una desviación de media cero, al elevarlo al cuadrado aparecen un término lineal en esa desviación y otro cuadrático. Para una desviación normal, el término cuadrático tiene media y varianza ; el lineal tiene varianza . Su covarianza es nula porque el tercer momento de una desviación normal se anula.
Con media dos y varianza un cuarto, la contribución cuadrática a la varianza de la observación es 0,125, frente a 4 de la contribución lineal (un 3,125 % de esta última). Si la media se acerca a cero manteniendo la varianza, la contribución lineal desaparece y la cuadrática se mantiene. El coeficiente de la función es el mismo en ambos casos. Lo que cambia es la región de estados sobre la que se pretende usar la recta tangente.
Actualización del filtro extendido
En el paso de observación, el EKF calcula otra jacobiana, , esta vez de la función en torno a la media predictiva. La lectura prevista es . Con ruido aditivo e independiente, la covarianza aproximada de esa lectura y la ganancia son
La nueva media es y la covarianza se actualiza según el problema linealizado, que en el caso escalar da . Estas operaciones son exactas para la aproximación lineal construida, pero su exactitud algebraica no demuestra que esa aproximación describa la observación original.
La inversa de requiere que la matriz sea no singular. Un ruido de observación con covarianza definida positiva asegura esa propiedad cuando el resto de la construcción es válido. En la práctica puede resolverse el sistema lineal correspondiente sin formar la inversa. Una observación redundante o una dirección con varianza exactamente cero obligan a revisar la representación del problema y no justifican reemplazar automáticamente cualquier matriz por una inversa numérica sin considerar qué información contiene.
Pasemos a una situación nueva, independiente del ejemplo de transición. La distribución previa del estado es normal, con media dos y varianza 0,25. El instrumento, que observa con ruido normal independiente de varianza 0,25, entrega una lectura de 4,5. Como la previa concentra casi toda su masa en la región positiva, donde la función cuadrática es creciente, hay una justificación local para trabajar en torno a esa región.
La derivada de la observación en dos vale cuatro. El EKF prevé una lectura de cuatro, obtiene una varianza predictiva de 4,25 y usa una ganancia de aproximadamente 0,235294, con lo que la media actualizada resulta 2,117647 y la varianza 0,014706. El dato reduce mucho la incertidumbre local, ya que allí una variación pequeña del estado produce una variación apreciable de la lectura.
Si se evalúa directamente el producto entre la densidad normal previa y la verosimilitud cuadrática mediante una integración numérica precisa, se obtiene una media posterior de 2,105791 y una varianza de 0,013549. El EKF se acerca a ambos valores, con una media algo más alta. La comparación usa el mismo dato y el mismo modelo, de modo que ninguna discrepancia viene de haber cambiado las varianzas del ruido.
Parte de la reducción de incertidumbre se explica por la pendiente local. Cerca de cero, la observación cuadrática tiene pendiente nula; cerca de dos, una diferencia pequeña del estado cambia claramente su cuadrado. Por eso una matriz de observación calculada en una sola posición no describe la capacidad informativa del instrumento en todas las posiciones. En un problema vectorial puede haber direcciones bien observadas junto a otras que siguen siendo ambiguas.
Al construir deben respetarse además las unidades. La covarianza del estado se transforma mediante para llevarla a unidades de observación antes de sumarle . Sumar directamente una varianza de estados y una de lecturas sin esa transformación puede parecer un ajuste inocente en una hoja de cálculo, cuando en realidad cambia el problema probabilístico y el peso que recibe el dato.
Linealización iterada y método de Gauss-Newton
El punto en torno al cual se hizo la expansión puede quedar lejos de la nueva estimación. Una variante iterada recalcula la aproximación local y busca una solución más acorde con la observación no lineal. Bell y Cathey (1993) relacionaron esta actualización iterada con el método de Gauss-Newton. Esa interpretación aclara a la vez su utilidad y sus límites, puesto que lo que se resuelve es un problema de optimización local.
Con previa normal y ruido aditivo normal, la estimación de máxima densidad posterior minimiza, salvo una constante,
El primer término guarda la información previa y el segundo penaliza la discrepancia con la lectura. En el ejemplo de media previa dos, ambos denominadores llevan varianzas de 0,25. Si se linealiza de nuevo el segundo término y se resuelven sucesivamente los problemas cuadráticos, la iteración iniciada en dos converge hacia 2,114908.
Ese valor es el modo positivo de la posterior, mientras que la media obtenida por integración era 2,105791. La diferencia no desaparece por hacer más iteraciones, porque el algoritmo y la integral calculan resúmenes distintos de una distribución ligeramente asimétrica. Presentar la convergencia del optimizador como prueba de haber encontrado la media posterior sería confundir el objetivo con la precisión numérica.
Durante la iteración se conserva la distribución previa original. El dato se representa localmente una y otra vez, pero sigue siendo una única observación. Si en cada repetición se tomara la posterior anterior como nueva previa y se incorporara otra vez la misma verosimilitud, la misma evidencia quedaría contada varias veces, lo que reduciría artificialmente la covarianza incluso en un problema lineal.
Por ejemplo, una previa de varianza uno y una observación directa con ruido de varianza uno producen una varianza posterior de un medio. Contar cinco veces esa lectura como si fueran cinco mediciones independientes daría una varianza de un sexto, aunque las cinco pasadas del algoritmo no hayan generado ningún dato nuevo. En las ecuaciones debe verse con claridad si se está iterando una optimización o repitiendo una actualización probabilística.
Gauss-Newton no asegura encontrar todos los máximos. Una inicialización puede favorecer una región y otra conducir a una solución distinta; cerca de una derivada nula puede faltar incluso una dirección útil para el paso. El número de iteraciones y el descenso de informan sobre el cálculo local, pero no miden por sí mismos cuánta masa posterior hay fuera de la región visitada.
La transformación unscented
La transformación unscented usa un conjunto pequeño de puntos deterministas, elegidos para reproducir la media y la covarianza de la distribución de entrada. Se aplica la función no lineal a esos puntos y se combinan los resultados. Julier, Uhlmann y Durrant-Whyte (2000) desarrollaron esta forma de propagar momentos, cuyo uso en estimación no lineal examinaron después Julier y Uhlmann (2004a).
Los puntos sigma, cuyas posiciones y pesos responden a una regla de integración, no son una muestra aleatoria del estado. Ejecutar muchas veces la misma regla no añade información ni produce la variabilidad propia de una simulación de Monte Carlo. Tampoco debe interpretarse cada punto como una hipótesis que recibe automáticamente una probabilidad posterior propia.
Veamos una versión escalar explícita. Para una entrada de media y varianza se toman los puntos , y . Los pesos para la media son cero, un medio y un medio; para la covarianza, dos, un medio y un medio. La elección corresponde a los parámetros , y de la transformación escalada en una dimensión.
Los pesos de covarianza cumplen una función distinta de la de los pesos de media. Aquí suman tres, así que tratarlos como probabilidades llevaría a una cuenta equivocada. Se aplican a productos de desviaciones respecto de la media transformada. La corrección del peso central incorpora información sobre momentos superiores de la entrada gaussiana.
Para la transición del ejemplo anterior, los puntos son , con imágenes . La media ponderada vale 2,425 y la varianza transformada, antes del ruido, 0,49125, a la que basta sumar 0,04 para recuperar la varianza exacta de 0,53125. En este caso la regla reproduce los dos momentos calculados analíticamente.
La coincidencia depende de condiciones precisas (una entrada escalar gaussiana, una transformación cuadrática y los pesos declarados). Con otra función u otra distribución pueden quedar términos que la regla no reproduce. Los enunciados sobre el orden de exactitud de una integración conciernen a clases de funciones y de momentos y no significan que cualquier posterior obtenida tras una observación arbitraria vaya a ser exacta hasta ese mismo orden.
Julier y Uhlmann (2004b) publicaron una corrección de su artículo de 2004 que afecta al ejemplo de reentrada, a sus fuerzas y a la especificación del ruido de la simulación y del filtro, por lo que cualquier comparación basada en aquel ejemplo debe usar los parámetros corregidos. Los ejemplos de este capítulo emplean funciones y varianzas declaradas aquí y se comprueban directamente, sin extrapolar a otros problemas la ventaja observada en aquella simulación.
Momentos exactos y condicionamiento aproximado
Una actualización gaussiana construida con puntos sigma necesita la media prevista de la lectura, su covarianza y la covarianza cruzada entre estado y lectura. La media actualizada tiene la forma y la covarianza se aproxima por . Se trata de una actualización basada en una relación lineal entre las variables dentro de una representación conjunta gaussiana.
Para una variable normal de media y varianza , la observación cuadrática tiene momentos conocidos,
El ruido independiente suma a la varianza de la lectura y deja intacta la covarianza cruzada. La transformación escalar elegida reproduce exactamente estas tres cantidades, aunque el par formado por y su cuadrado ruidoso no es conjuntamente gaussiano. Por eso, utilizar sus momentos exactos dentro de una fórmula de condicionamiento gaussiano sigue siendo una aproximación.
Volvamos a la previa de media dos y varianza 0,25, con lectura 4,5 y ruido de varianza 0,25. Con una media prevista de la lectura que ahora es 4,25, una varianza de 4,375 y una covarianza cruzada igual a uno, la actualización unscented da una media de 2,057143 y una varianza de 0,021429.
Con este dato, la media posterior exacta (2,105791) queda más cerca de la aproximación del EKF que de la unscented. No hay contradicción, porque la transformación de momentos fue exacta, pero el condicionamiento gaussiano no lo fue. Mejorar una etapa no ordena automáticamente el error final de todos los métodos para todas las lecturas posibles.
Una comparación con un solo dato tampoco dice qué método tendrá menor error promedio en una secuencia de experimentos. Para responder a eso habría que definir la distribución de estados y lecturas, el criterio de error y las condiciones de inicialización. La conclusión que el ejemplo autoriza es más modesta, a saber, que la exactitud de los momentos previos y la de los momentos posteriores son propiedades diferentes.
La ganancia construida con y admite además una interpretación que prescinde de la gaussianidad conjunta. Si esos momentos se conocen exactamente, da la mejor predicción afín del estado a partir de la lectura bajo pérdida cuadrática. El adjetivo «afín» restringe la clase de reglas a una constante más una matriz que multiplica la observación. La esperanza condicional exacta puede ser una función no lineal de la observación y lograr, dentro de una clase más amplia, un error promedio menor.
La matriz que resulta de restar a el producto formado con y la inversa de es, en ese problema, la covarianza del error afín promediada sobre las lecturas posibles. Leerla como la covarianza posterior para cada lectura individual supone una condición adicional. En el caso conjuntamente gaussiano ambas interpretaciones coinciden y la covarianza condicional es la misma para cualquier valor recibido; en el caso no lineal pueden separarse. Una matriz constante para todas las lecturas puede describir bien un error promedio y mal la incertidumbre que queda después de una lectura concreta.
Entre las reglas de cubatura, que son otra manera de aproximar integrales gaussianas, Arasaratnam y Haykin (2009) usaron una regla esférico-radial de tercer grado para construir un filtro. El grado indica qué polinomios integra exactamente la regla bajo la distribución correspondiente. Como al calcular la varianza de una transformación cuadrática aparece un momento de cuarto grado, hace falta examinar la integral concreta.
En una dimensión, la regla de dos puntos situados en menos uno y más uno con pesos iguales reproduce el segundo momento de una normal estándar. Para el cuarto momento devuelve uno, cuando el de la normal es tres. Basta elevar los puntos a las potencias correspondientes para comprobarlo, sin confiar en el nombre del método ni en su grado nominal.
Una posterior con dos modos
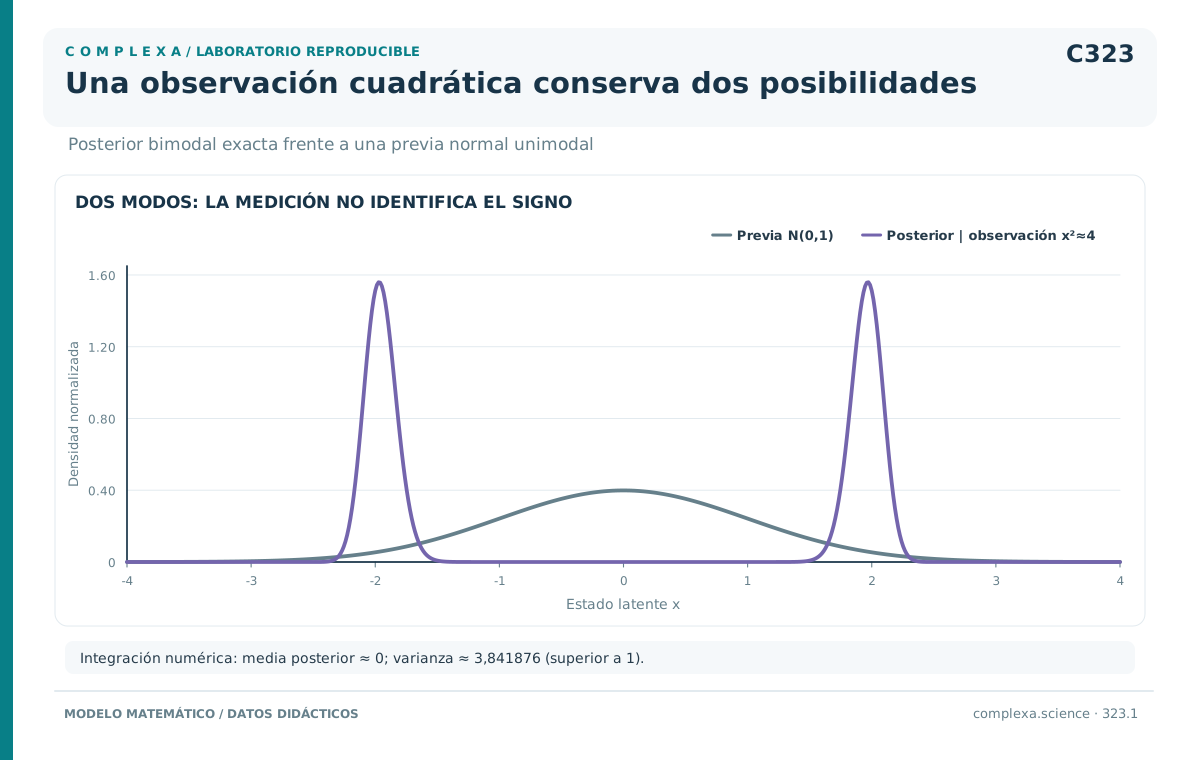
Pongamos ahora como previa una normal de media cero y varianza uno, conservemos la observación cuadrática con ruido de varianza 0,25 y supongamos que llega la lectura cuatro. La densidad posterior es proporcional a
La expresión toma el mismo valor en y en . Por simetría la media posterior es cero, aunque los valores cercanos a cero son muy improbables porque sus cuadrados concuerdan mal con la lectura. Derivando el logaritmo de la densidad aparecen dos máximos, aproximadamente en y .
La integración directa da una varianza posterior de 3,841876, mayor que la previa. El dato desplazó la masa hacia regiones alejadas del centro sin resolver el signo. Esto es compatible con las propiedades generales del condicionamiento, porque la reducción de incertidumbre no exige que la varianza condicional sea menor que la previa para cada valor observado.
El EKF calcula una derivada nula en el centro, de modo que su ganancia es cero y mantiene media cero y varianza uno. La transformación unscented mejora la media prevista de la lectura (obtiene uno en vez de cero) y acierta con su varianza previa, que es 2,25 después del ruido. Sin embargo, la covarianza cruzada entre y su cuadrado es cero, por lo que la actualización gaussiana vuelve a dejar sin cambios la media y la varianza del estado.
Ambos métodos aciertan aquí con la media posterior. Una evaluación que mirara solo el error de esa media pasaría por alto la información perdida. Si se pregunta por la probabilidad de que el estado esté entre menos un medio y más un medio, la normal que ambos conservan asigna cerca del 38 %, mientras que la posterior exacta asigna alrededor de una billonésima. La discrepancia afecta directamente a una pregunta sobre regiones del estado.
La simetría permite ir más lejos. La esperanza condicional del estado es cero para cualquier lectura del instrumento cuadrático, cuatro incluida. Por la descomposición de la varianza total, el promedio de las varianzas posteriores sobre todas las lecturas que genera el modelo sigue valiendo uno; las lecturas compatibles con magnitudes pequeñas reducen esa varianza y otras, como la que acabamos de estudiar, la aumentan. Un resumen que informe siempre una varianza de uno coincide con ese promedio y borra la variación entre lecturas.
Por eso, revisar únicamente la dispersión del error a lo largo de muchas simulaciones podría pasar por alto el defecto. Hay que examinar también grupos de lecturas o probabilidades condicionadas a regiones observables. El sensor informa sobre la magnitud, pero no sobre el signo. Una comprobación alineada con esa información detecta algo que un único promedio global no permite distinguir.
Una gaussiana de media cero y varianza 3,841876 tampoco representaría las dos regiones de alta densidad, por mucho que acertara con los dos primeros momentos, ya que seguiría poniendo su máximo en cero. La media es el estimador que minimiza la pérdida cuadrática posterior, pero no tiene por qué ser un estado de alta densidad; en una distribución con alternativas simétricas, esas dos descripciones pueden separarse mucho.
Volver a linealizar desde cero tampoco rompe la simetría, ya que la pendiente sigue siendo nula y la actualización iterada puede quedarse allí. Mover arbitrariamente la inicialización a un valor positivo puede llevar a una solución positiva, lo que mostraría cuánto depende la búsqueda local de su punto de partida. La observación cuadrática sigue siendo igual de compatible con el signo negativo. Una decisión sobre el signo necesita información adicional o, en su defecto, conservar ambas posibilidades.
Ruido, coordenadas y coste computacional
Las fórmulas anteriores suman y porque el ruido entra de forma aditiva e independiente. Si la transición tuviera la forma , la expansión debería incluir derivadas respecto del estado y del ruido, cuya covarianza conjunta determinaría los términos resultantes. Pasar por alto una dependencia entre esas cantidades puede alterar tanto la dispersión como las covarianzas cruzadas que se usan después.
Con puntos sigma se puede ampliar el vector para incluir el ruido y transformar los puntos conjuntos. En modelos aditivos apropiados cabe también propagar primero los puntos del estado y sumar luego la covarianza del ruido. Cualquiera de las dos construcciones debe corresponder a la ecuación generadora, porque si se transforma un ruido que ya estaba incluido en los puntos y después se suma de nuevo su covarianza, la misma fuente de variación queda contada dos veces.
La dimensión del estado pesa en el coste. Una regla simétrica habitual usa dos puntos por dimensión más un punto central, de modo que ampliar el estado con variables de ruido aumenta ese número. Una cuadratura construida como producto de reglas escalares puede crecer mucho más deprisa, porque combina sus nodos en todas las coordenadas. Elegir una integración más precisa obliga a considerar cuántas evaluaciones de la función caben entre dos lecturas y qué error de aproximación importa para la pregunta que se quiere responder.
Las coordenadas elegidas también influyen en una aproximación local. Un estado positivo puede representarse por su logaritmo, lo que evita asignar probabilidad a valores negativos en esa coordenada. Llevar una distribución gaussiana de vuelta a la escala original cambia, sin embargo, su media y su asimetría. Exponenciar la media del logaritmo da un resumen distinto de la media aritmética del estado.
En problemas angulares, dos valores cercanos a los extremos de una vuelta pueden estar próximos físicamente y lejanos en una resta ordinaria. Antes de atribuir esa discrepancia al algoritmo es preciso definir cómo se representan las diferencias y la incertidumbre, porque promediar y linealizar dependen de la geometría que se haya asignado al estado.
Una matriz de covarianza simétrica y semidefinida positiva es un requisito de la representación. Mantenerla mediante factorizaciones estables ayuda a contener los errores de redondeo. Una matriz numéricamente impecable puede, con todo, describir una región equivocada o una dispersión demasiado pequeña. Cuando una variante unscented usa pesos negativos, conviene revisar con especial cuidado la construcción y la estabilidad de las sumas, sin leer esos pesos como probabilidades negativas de estados.
Reif y colaboradores (1999) obtuvieron resultados de estabilidad del EKF bajo condiciones de observabilidad y con restricciones sobre el error inicial y el ruido. El alcance del resultado lo fijan esas hipótesis. Tener funciones diferenciables o conseguir que una rutina termine no establece por sí mismo que el error vaya a permanecer controlado desde cualquier punto de partida. La evolución del estado estimado y de su incertidumbre debe contrastarse con la región donde la aproximación tiene respaldo.
Comprobaciones de referencia
En estos ejemplos escalares la posterior puede integrarse directamente, variando el espaciado o el procedimiento de integración para validar la referencia numérica. Gracias a ello puede distinguirse un error de programación de una limitación de la aproximación. Si el filtro falla en un caso lineal conocido, hay que revisar las operaciones antes de interpretar su comportamiento no lineal; si lo resuelve bien y aun así pierde uno de los dos modos, la limitación puede estar en la representación elegida.
Para las cifras de este capítulo se compararon una integración adaptativa y una regla de mil veinticuatro nodos y se duplicó también el intervalo de integración. Las medias, varianzas y probabilidades indicadas conservaron los dígitos mostrados. Una malla que cubriera solo la región positiva habría eliminado por construcción la mitad de la posterior simétrica, de ahí que la referencia deba abarcar todo el dominio relevante, incluidas las regiones que una aproximación local podría haber descartado.
También importa examinar cantidades distintas de la media, como probabilidades de regiones, dispersión condicional y respuesta a nuevas observaciones. Una evaluación por simulación debe generar estados y lecturas con un mecanismo declarado, repetir el experimento y observar qué ocurre cuando aumenta la incertidumbre inicial o cambia la relación entre ruido y señal. El error medio puede esconder una minoría de trayectorias que salen de la región de linealización.
En el instrumento que mide cuadrados, repetir mediciones independientes y precisas del mismo estado puede concentrar más las dos regiones compatibles con el dato. Mientras todas dependan solo del cuadrado, el signo seguirá sin identificarse bajo una previa simétrica, por mucho que aumente la frecuencia de medición. Una mezcla que conserve ambos modos, u otra representación más flexible, puede mantener visible la alternativa a la espera de información que la resuelva.
Añadamos entonces un segundo instrumento que observa directamente el estado con ruido normal de varianza 0,25. Si registra 1,5, los candidatos dos y menos dos dejan de tener el mismo respaldo, ya que la razón de sus verosimilitudes bajo esta lectura es , unos veintiséis mil millones a favor de dos. Antes de esa lectura, la previa simétrica y el instrumento cuadrático asignaban a ambos puntos la misma densidad. La nueva medición suma veinticuatro unidades al logaritmo de esa razón y la actualización siguiente puede incorporar esa cantidad sin haber descartado a ninguno de los dos candidatos.
Referencias
Arasaratnam, I., & Haykin, S. (2009). Cubature Kalman filters. IEEE Transactions on Automatic Control, 54(6), 1254–1269. https://doi.org/10.1109/TAC.2009.2019800
Bell, B. M., & Cathey, F. W. (1993). The iterated Kalman filter update as a Gauss-Newton method. IEEE Transactions on Automatic Control, 38(2), 294–297. https://doi.org/10.1109/9.250476
Ito, K., & Xiong, K. (2000). Gaussian filters for nonlinear filtering problems. IEEE Transactions on Automatic Control, 45(5), 910–927. https://doi.org/10.1109/9.855552
Julier, S., Uhlmann, J., & Durrant-Whyte, H. F. (2000). A new method for the nonlinear transformation of means and covariances in filters and estimators. IEEE Transactions on Automatic Control, 45(3), 477–482. https://doi.org/10.1109/9.847726
Julier, S. J., & Uhlmann, J. K. (2004a). Unscented filtering and nonlinear estimation. Proceedings of the IEEE, 92(3), 401–422. https://doi.org/10.1109/JPROC.2003.823141
Julier, S. J., & Uhlmann, J. K. (2004b). Corrections to “Unscented filtering and nonlinear estimation”. Proceedings of the IEEE, 92(12), 1958. https://doi.org/10.1109/JPROC.2004.837637
Reif, K., Günther, S., Yaz, E., & Unbehauen, R. (1999). Stochastic stability of the discrete-time extended Kalman filter. IEEE Transactions on Automatic Control, 44(4), 714–728. https://doi.org/10.1109/9.754809