Cuatro candidatos pueden describir una incertidumbre que una sola campana resume mal. Dos de ellos pueden estar cerca de un estado positivo, otro cerca de cero y el cuarto en una región negativa. Una observación nueva cambia el respaldo de cada candidato y, si se conservan sus posiciones y sus pesos, todavía es posible preguntar cuánto apoyo recibe cada región, aunque el promedio se encuentre entre ellas.
Un filtro de partículas organiza esa representación a lo largo del tiempo. Propone estados posibles, calcula cuánto contribuye cada uno a la distribución que se busca y decide cuáles tendrán descendencia en el paso siguiente. Gracias a esa flexibilidad puede representar asimetrías y varios modos. El cálculo sigue siendo aproximado, porque una región que nunca recibe partículas no aparece por el hecho de normalizar correctamente los pesos.
Para separar estas cuestiones usaremos un modelo didáctico de tres estados, lo bastante sencillo como para calcular exactamente su distribución filtrada y comprobar el algoritmo entero, sorteos y remuestreo incluidos. No se presentan aquí datos observados ni se pretende que tres estados describan un mecanismo clínico concreto.
Una nube ponderada de estados
En cada instante el filtro guarda estados con pesos normalizados , no negativos y de suma uno. La distribución aproximada asigna a cada partícula la masa que indica su peso y, cuando varias partículas ocupan el mismo estado, sus masas se suman al calcular la probabilidad de ese estado.
Para estimar la esperanza posterior de una función del estado se usa
La media se obtiene tomando como función la propia coordenada; la probabilidad de una región, con una función que vale uno dentro de ella y cero fuera. Ambas cuentas usan la misma nube, pero su precisión puede diferir; una nube capaz de aproximar bien el promedio puede representar mal una región poco frecuente.
En un estado continuo esta representación es una distribución discreta de masas, mientras que una curva suavizada dibujada sobre las partículas añade una elección de suavizado y no es la distribución empírica original. Conviene distinguir esas dos operaciones cuando un gráfico parece mostrar o borrar un modo. El ancho de banda elegido para dibujar una densidad puede unir regiones que la nube mantiene separadas.
Gordon, Salmond y Smith (1993) propusieron el filtro bootstrap como procedimiento recursivo basado en muestras para modelos no lineales y no gaussianos. Kitagawa (1996) desarrolló métodos de Monte Carlo para la predicción, el filtrado y el suavizado en modelos de espacio de estados. Estos trabajos permiten mantener formas distributivas más amplias que una sola normal, siempre que la simulación llegue a las regiones relevantes.
Una partícula no tiene que interpretarse como una persona, un individuo biológico o una trayectoria real observada. Es un objeto del cálculo. Lo que contiene (según el algoritmo, solo el estado actual o también parte de su historia o variables auxiliares) determina qué preguntas podrán responderse después.
Propuesta y corrección por importancia
Escribamos para la distribución de transición y para la verosimilitud de una lectura. En estados discretos son probabilidades; en estados continuos, densidades respecto de las medidas correspondientes. Supondremos que el estado es de Markov y que las observaciones son independientes dada la secuencia de estados, cada una dependiente de forma directa solo del estado de su mismo instante.
Si una partícula previa se propaga con una propuesta , su nuevo peso sin normalizar es proporcional a
La fórmula corresponde a propagar cada partícula previa sin sortear de nuevo los antepasados en ese paso. El cociente corrige la diferencia entre la distribución que generó los candidatos y la que se quiere representar, tras lo cual se divide cada peso por la suma de todos. La propuesta forma parte del algoritmo; y pertenecen al modelo.
La propuesta debe dar probabilidad o densidad positiva a todas las regiones que contribuyen al objetivo condicionado al antepasado. Si excluye una región con respaldo posterior, ninguna ponderación finita puede recuperar candidatos que nunca se generan. Una propuesta muy estrecha puede producir pesos de aspecto regular dentro de una región equivocada y omitir otra región importante.
Doucet, Godsill y Andrieu (2000) organizaron estos métodos en el marco del muestreo secuencial de importancia. La elección más sencilla toma la transición como propuesta, caso en que se cancela en el cociente y el peso previo queda multiplicado por la verosimilitud de la lectura. El filtro bootstrap combina esa idea con un remuestreo que redistribuye el esfuerzo entre los candidatos.
Si los antepasados se remuestrearon según sus pesos antes de propagar, los descendientes empiezan con pesos iguales. Multiplicar otra vez por los antiguos pesos de los antepasados contaría dos veces aquella preferencia. Como hay varias ordenaciones válidas de propagación, ponderación y remuestreo, para comprobar una implementación hay que escribir la ordenación concreta y derivar el cociente que le corresponde.
Un modelo de tres estados con solución exacta
Los estados posibles son menos uno, cero y uno, con probabilidades de un cuarto, un medio y un cuarto antes de la primera lectura. Entre dos lecturas, la transición viene dada por la matriz
Las filas indican el estado de origen y las columnas el de destino, en el orden declarado. Desde cero, por ejemplo, se permanece allí con probabilidad 0,8 y se pasa a cada extremo con probabilidad 0,1, mientras que desde menos uno no se puede llegar directamente a uno en un solo paso. Cada fila suma uno y todos sus elementos son no negativos.
El sensor entrega cero o uno. La probabilidad de recibir uno es 0,1 en el estado negativo, 0,2 en cero y 0,8 en el positivo, con lo que la de recibir cero es, respectivamente, y . Estos valores especifican por completo el mecanismo de observación y no son pesos elegidos para favorecer un resultado.
Supongamos que la primera lectura es uno. Al multiplicar las probabilidades previas por las tres verosimilitudes se obtienen masas de y , cuya suma, 0,325, es la probabilidad predictiva de esa lectura. Normalizando queda
La notación enumera las tres probabilidades, sin afirmar que el estado pueda adoptar los tres valores simultáneamente. Con una media aproximada de 0,538462 y una varianza de 0,402367, la posterior da al estado positivo más respaldo que la previa, pero conserva probabilidad en los otros dos.
Este resultado exacto servirá de referencia. Una ejecución del filtro puede aproximarlo mejor o peor según su nube inicial y sus sorteos. Si usamos cuatro representantes situados en menos uno, cero, cero y uno, con pesos iniciales iguales, la distribución previa del ejemplo queda representada sin error. Es una elección didáctica deliberada, distinta de sortear cuatro estados y esperar que sus frecuencias coincidan con esas probabilidades.
Concentración de los pesos y tamaño muestral efectivo
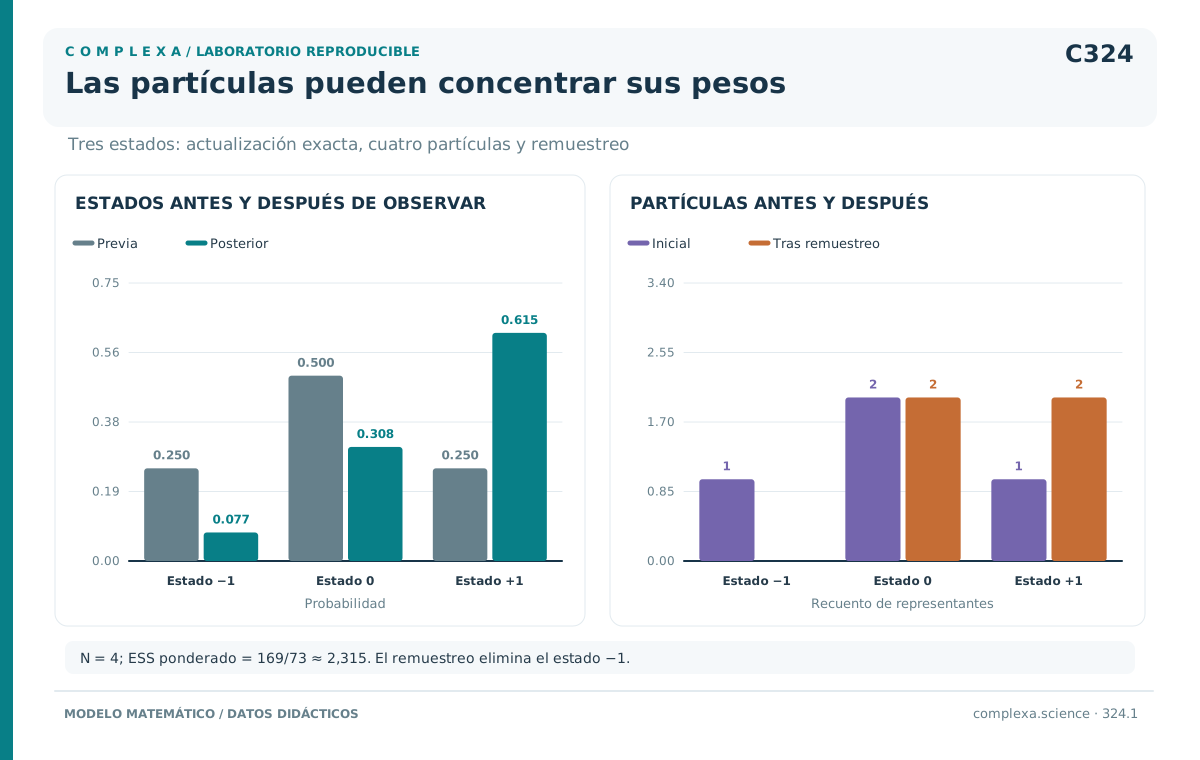
Para esos cuatro representantes las verosimilitudes son y , de donde resultan los pesos normalizados , , y . Agrupando las dos partículas situadas en cero se recupera la posterior exacta. La partícula positiva concentra más de la mitad del peso pese a ser solo uno de los cuatro objetos guardados.
Un indicador habitual de concentración es
Con pesos normalizados no negativos, su valor está entre uno y , alcanza cuando todos los pesos son iguales y se acerca a uno cuando una sola partícula concentra casi toda la masa. En la nube de cuatro representantes vale , aproximadamente 2,31507, lo que revela una desigualdad de pesos invisible en el simple recuento de cuatro partículas.
El indicador suele llamarse tamaño muestral efectivo, o ESS por su sigla en inglés. Elvira, Martino y Robert (2022) examinaron las aproximaciones que conectan esa fórmula con comparaciones de varianza entre estimadores. La eficiencia real depende también de la función que se quiere integrar, de cómo se generaron las partículas y de su dependencia mutua. Un indicador construido solo con los pesos no contiene esa información.
En nuestro ejemplo la nube ponderada reproduce exactamente las tres probabilidades aunque su ESS sea menor que cuatro. La coincidencia se debe a la representación inicial exacta y al tamaño reducido del espacio. Un ESS moderado no demuestra por sí mismo un error grande y, a la inversa, unos pesos iguales no demuestran que las posiciones cubran correctamente la posterior.
La concentración se vuelve preocupante cuando casi todo el cálculo descansa en unos pocos candidatos y las propagaciones siguientes gastan recursos en candidatos de peso insignificante. El remuestreo reorganiza ese trabajo. La decisión de remuestrear puede depender de un umbral del ESS, pero ese umbral es una regla del algoritmo que debe declararse. Ningún valor certifica la precisión posterior en todos los modelos.
En la nube de cuatro representantes, una regla que remuestreara por debajo de la mitad de no se activaría, pues 2,31507 supera dos. Otra que usara tres cuartos de sí se activaría, porque el umbral sería tres. El remuestreo que estudiamos a continuación se hace deliberadamente, para ver sus consecuencias. La auditoría posterior fija también de antemano cuándo se remuestrea, de manera que sus resultados no dependan de una regla adaptativa sin especificar.
Remuestreo multinomial y sistemático
Remuestrear consiste en elegir antepasados con probabilidades ligadas a sus pesos y reemplazar la nube por copias con pesos iguales. En el método multinomial las selecciones son independientes dada la nube actual y una partícula puede tener varios descendientes o ninguno. Para una nube de descendientes, el número esperado de copias de la partícula es .
Ese promedio no significa que una ejecución produzca exactamente el número esperado. En el ejemplo, el número esperado de copias del representante negativo es , que no es un entero, pero una ejecución tendrá cero, una u otra cantidad de copias. El promedio describe lo que ocurre al repetir el sorteo manteniendo fija la nube ponderada.
El remuestreo sistemático usa un único desplazamiento uniforme entre cero y un cuarto para la nube de cuatro partículas, al que se suman cero, un cuarto, un medio y tres cuartos. Los cuatro puntos resultantes se ubican sobre la distribución acumulada de los pesos. Con el desplazamiento didáctico 0,1, los puntos son y .
Las selecciones correspondientes son cero, cero, uno y uno, así que la nube remuestreada ya no contiene el estado negativo. Cada copia pesa un cuarto y el ESS sube a cuatro, mientras la posterior exacta conserva una probabilidad de en el estado negativo. El aumento del indicador refleja la igualdad de pesos que el propio procedimiento acaba de imponer, sin que se haya ganado información alguna sobre el estado.
La probabilidad de perder ese representante en el remuestreo sistemático puede calcularse. Solo se conserva si el primer punto cae dentro de su intervalo acumulado, de longitud . Como el desplazamiento es uniforme en un intervalo de longitud un cuarto, la probabilidad de conservarlo es y la de perderlo, , aproximadamente 0,692308.
Douc, Cappé y Moulines (2005) compararon distintos esquemas de remuestreo. El residual asigna primero la parte entera de los números esperados de copias; el estratificado sortea de forma independiente dentro de intervalos. Ambos tienen ventajas de varianza condicional frente al multinomial en el marco que estudiaron. Para el sistemático no hay una ventaja universal, ya que el orden de las partículas puede influir en el resultado.
En la nube que hemos usado, la varianza condicional de la media después de remuestrear es aproximadamente 0,046598 con el esquema sistemático y 0,100592 con el multinomial. El cálculo integra todos los desplazamientos posibles del primero y todas las selecciones del segundo. La comparación vale para esta nube, estos pesos y esta función del estado, porque cambiar la función u ordenar las partículas de otra manera cambia el problema comparado.
Sesgo de la normalización
Los esquemas de remuestreo anteriores conservan en esperanza, dada la nube, sus integrales ponderadas. En el ejemplo, si se repite muchas veces el remuestreo, el promedio de las medias resultantes recupera 0,538462. Una ejecución concreta con la nube cero, cero, uno, uno da 0,5 y la diferencia es ruido de Monte Carlo introducido por la redistribución.
La propiedad tiene como referencia la nube ponderada que entra en el procedimiento. Si esa nube ya representa mal la posterior, el remuestreo conserva en promedio sus errores de representación, porque no compara las partículas con una distribución exacta que desconoce. Por eso la ausencia de sesgo condicional del remuestreo no demuestra ausencia de sesgo en todo el filtro.
La normalización introduce un cociente aleatorio. La suma ponderada del numerador y la suma de pesos del denominador dependen de las mismas partículas y, en general, la esperanza de ese cociente no es el cociente de sus esperanzas. Un estimador normalizado puede estar sesgado con finito aunque los sorteos y el remuestreo estén bien implementados.
Con solo dos partículas sorteadas de forma independiente desde la distribución previa del ejemplo hay nueve parejas ordenadas posibles, que pueden ponderarse todas sin simular. La esperanza de la media filtrada tras observar uno resulta aproximadamente 0,213889, frente a una media posterior exacta de 0,538462. Con dos partículas es frecuente quedarse con una representación pobre de los estados antes de normalizar.
La diferencia no contradice la coincidencia obtenida antes con los cuatro representantes elegidos. En aquel cálculo la nube inicial representaba exactamente la previa; aquí la nube es aleatoria y contiene apenas dos extracciones. El algoritmo, la distribución de sus entradas y la forma de evaluarlo deben describirse juntos, porque comparar solo el número de partículas esconde esta diferencia de diseño.
Propuestas adaptadas y filtros auxiliares
El filtro bootstrap propaga con la transición antes de considerar la lectura nueva. Si esa lectura es muy informativa, muchos estados propuestos pueden terminar con verosimilitud pequeña. Una propuesta que incorpore la lectura puede situar más candidatos en las regiones relevantes, a condición de que el cociente de importancia corrija la elección.
Para un antepasado concreto , consideremos la propuesta proporcional a , cuya constante de normalización es la probabilidad predictiva de la lectura desde ese antepasado, que llamaremos . Cuando puede calcularse y simularse exactamente, esta propuesta coincide con la distribución del nuevo estado condicionada al antepasado y a la lectura.
En el modelo de tres estados y para una lectura uno, las constantes predictivas desde menos uno, cero y uno son y . Desde cero, por ejemplo, las masas conjuntas de llegar a cada estado y observar uno son y , que al dividirse por 0,25 dan las probabilidades y de la propuesta condicionada.
La propuesta da al estado positivo más oportunidades que la transición original desde cero, que le asignaba 0,1. Para ese antepasado, el cociente entre transición por verosimilitud y propuesta vale siempre 0,25; para los otros dos vale 0,12 o 0,68. Desaparece así la variación del peso debida al nuevo estado dentro de cada antepasado, aunque persiste la variación entre antepasados.
Por tanto, utilizar esta propuesta no garantiza automáticamente pesos iguales en toda la nube, porque si unos antepasados hacen la lectura mucho más probable que otros, esa diferencia todavía debe incorporarse. La palabra «óptima», aplicada a esta propuesta, corresponde a un criterio condicional concreto y a una clase de propuestas, sin que eso signifique que resuelva cualquier dificultad del filtro.
Pitt y Shephard (1999) desarrollaron los filtros auxiliares, que usan la información de la lectura para favorecer a los antepasados prometedores. En el caso completamente adaptado, cada antepasado se elige con probabilidad proporcional a su peso previo multiplicado por y el nuevo estado se genera con la propuesta condicionada. La ponderación de segunda etapa queda entonces constante respecto de la mezcla empírica que se está actualizando.
Si los antepasados tienen exactamente las probabilidades previas de nuestro ejemplo, sus nuevas probabilidades de selección son , y . Al combinarlas con las propuestas condicionadas se recuperan para el nuevo estado los pesos , y . En este caso finito cada término de la combinación puede comprobarse.
La observación interviene en la selección y en la propuesta porque ambas operaciones organizan los sorteos, aunque el objetivo probabilístico la contiene una sola vez. Cuando se usan aproximaciones de las probabilidades predictivas, los pesos deben corregirlas; omitir esa corrección convierte una estrategia para generar candidatos en una modificación inadvertida de la posterior.
Esa modificación puede medirse desde el antepasado cero. La propuesta condicionada asigna ya y a los tres destinos. Si se genera desde ella y se multiplica de nuevo por la verosimilitud sin dividir por la propuesta, las masas límite quedan proporcionales a y . Normalizando, la probabilidad del destino positivo pasa a ser , aproximadamente 0,659794, cuando debía ser 0,32.
El error persistiría aunque el número de partículas creciera indefinidamente, ya que una nube mayor solo aproximaría con más precisión una distribución equivocada. El origen del problema está en el objetivo inducido por la ponderación, al margen de la variabilidad de los sorteos. Antes de comparar velocidades o errores entre dos implementaciones hay que asegurarse de que ambas aproximan la misma distribución, con las correcciones que exige cada propuesta.
Diversidad de estados y diversidad de historias
Tras el remuestreo, varias partículas pueden descender del mismo antepasado. La propagación puede separarlas si el modelo contiene ruido o transiciones diversas. En el ejemplo, la nube cero, cero, uno, uno puede volver a generar un estado negativo desde cualquiera de sus dos representantes en cero. Como cada uno tiene probabilidad de transición 0,1 hacia menos uno, la probabilidad de obtener al menos un estado negativo en el paso siguiente es 0,19.
Recuperar un estado negativo actual no recupera una historia negativa que ya desapareció, puesto que, si se guardan trayectorias completas, todos los descendientes de un antepasado comparten su pasado. Tras muchos remuestreos pueden quedar pocas historias antiguas distintas aunque los estados actuales vuelvan a dispersarse. La diversidad actual y la genealógica responden a preguntas diferentes.
La distinción afecta a una estimación retrospectiva. Un filtro que representa razonablemente el estado presente puede conservar una representación pobre de una trayectoria lejana; guardar más columnas de los mismos antepasados no crea historias adicionales. Los métodos de suavizado y los movimientos sobre trayectorias requieren un tratamiento específico de esa dependencia.
Los parámetros estáticos son especialmente delicados. Si se incorporan como componentes del estado sin dinámica, copiar una partícula no genera valores nuevos del parámetro. Una vez perdido un valor o una región, la transición determinista no los recupera. Una perturbación artificial puede mantener la diversidad, al precio de convertir un parámetro fijo en uno variable cuando faltan una justificación y una corrección apropiadas.
Otra posibilidad es aplicar movimientos cuya distribución invariante sea la posterior correspondiente. Esa invariancia requiere un objetivo y una regla de aceptación o actualización válidos y no se establece sacudiendo las partículas hasta que se vean más dispersas. El ruido físico de proceso, la propuesta de simulación y un movimiento de Monte Carlo cumplen funciones distintas.
Pesos en escala logarítmica y estimación de la verosimilitud
Las verosimilitudes pueden ser muy pequeñas, sobre todo al multiplicar contribuciones de varias observaciones. Trabajar directamente con ellas puede producir ceros por limitaciones numéricas aunque sus razones sigan siendo informativas, por lo que lo habitual es guardar los logaritmos de los pesos y restar el mayor antes de exponenciar.
Si tres logaritmos valen menos mil, menos mil uno y menos mil dos, sus exponenciales directas pueden perderse en la representación numérica. Al restar menos mil quedan cero, menos uno y menos dos, cuya normalización da aproximadamente y . Restar una constante común no cambia los pesos relativos.
El procedimiento resuelve una dificultad de representación numérica. Si todas las partículas tienen verosimilitud exactamente cero bajo el modelo, ni la resta del máximo ni una mayor precisión crean una posterior empírica normalizable. Es preciso distinguir entre un producto redondeado a cero y una incompatibilidad real entre los candidatos y la observación. En el modelo didáctico todas las probabilidades de observación son positivas, por lo que ese segundo problema no aparece.
También interesa conservar las constantes de normalización cuando se necesita evaluar la probabilidad de la secuencia observada. En el filtro bootstrap con pesos iguales antes de ponderar, el promedio de las verosimilitudes estima la probabilidad predictiva de la lectura. El producto de esos factores da un estimador de la probabilidad de la secuencia bajo la ordenación y la ponderación correspondientes.
Esa cantidad no debe confundirse con la media posterior normalizada. En la enumeración completa del filtro de dos partículas que presentamos más abajo, el estimador del producto de probabilidades predictivas tiene una esperanza exactamente igual al valor verdadero, mientras que la media posterior estimada conserva su sesgo. Son dos funciones distintas del mismo procedimiento aleatorio.
La insesgadez de una cantidad positiva no pasa automáticamente a su logaritmo, ya que la transformación logarítmica es no lineal. Si se usa una estimación aleatoria de la verosimilitud para comparar modelos o parámetros, deben considerarse tanto su variabilidad como la transformación aplicada. Una cifra estable de logverosimilitud necesita su propia comprobación.
Comparación con la solución exacta
Si se propaga la posterior exacta mediante después de la primera lectura uno, las probabilidades de menos uno, cero y uno antes de la segunda lectura son , y . Si ahora llega un cero, al multiplicar por sus verosimilitudes y normalizar se obtiene
La media es aproximadamente 0,043478 y la varianza 0,376992. La probabilidad predictiva de la segunda lectura es , que multiplicada por la de la primera, , da una probabilidad conjunta de 0,161 para la secuencia uno, cero.
Para comprobar el filtro con dos partículas se enumeraron las nueve parejas iniciales, las cuatro parejas ordenadas de índices de antepasados del remuestreo multinomial y los nueve pares de destinos. Son 324 combinaciones, de las cuales doscientas tienen probabilidad positiva bajo las transiciones. Se guardaron sus probabilidades exactas, con todos los destinos permitidos.
En cada combinación se ponderó la primera lectura, se remuestreó, se propagó y se ponderó la segunda. La esperanza de la media final estimada es 0,075325, frente al valor exacto de 0,043478, mientras que la esperanza del estimador de la probabilidad conjunta es exactamente 0,161. La enumeración comprueba la regla completa y descarta que la diferencia entre ambos tipos de estimador sea un error de simulación.
Los pesos finales se conservan para calcular la media, sin un segundo remuestreo antes de informar el resultado. Ese remuestreo adicional podría conservar la esperanza condicionada a la nube y añadir variabilidad a la estimación entregada. Si hubiera que seguir filtrando, el paso siguiente se decidiría según la regla adoptada; para evaluar estas dos lecturas, conservar el resumen ponderado permite examinar el resultado antes de introducir otro sorteo.
Después se ejecutó el mismo algoritmo tres mil veces para cada tamaño de nube, con las dos lecturas fijas y variando solo los sorteos. La semilla del generador fue 324. La tabla recoge la raíz del error cuadrático medio de la media filtrada respecto del valor exacto.
| Partículas por ejecución | Raíz del error cuadrático medio |
|---|---|
| 20 | 0,18315 |
| 100 | 0,08046 |
| 500 | 0,03490 |
Son resultados de una simulación reproducible de este modelo, que no deben tomarse como cotas para otros problemas. En esta comparación el error de aproximación disminuye al crecer , aunque una ejecución individual puede quedar más lejos de la referencia que otra con menos partículas. La tabla resume repeticiones para describir el comportamiento del procedimiento.
El cálculo usó el generador PCG64, con los tamaños de nube en el orden de la tabla y sin reiniciar la secuencia entre tamaños. Cada repetición generó partículas iniciales nuevas y nuevos sorteos de antepasados y de transiciones, mientras las lecturas se mantenían fijas. La variación medida es, por tanto, condicional a esa secuencia de datos, sin mezclarse con la variabilidad que aparecería si también se generaran lecturas nuevas.
La incertidumbre del estado no desaparece al aumentar . Su desviación estándar posterior exacta sigue siendo aproximadamente 0,613996 con las dos lecturas disponibles. Los errores de la tabla miden cuánto se equivoca el cálculo de la media por usar una nube finita; la dispersión posterior describe qué estados siguen siendo posibles bajo el modelo y los datos. Confundir ambas cantidades llevaría a tomar más tiempo de cómputo por observaciones adicionales.
Las probabilidades de transición y de observación se trataron como conocidas. Si se hubieran estimado con datos limitados, habría además una incertidumbre sobre esos parámetros que no incorpora un filtro repetido con más partículas y los mismos valores fijos. Habría que especificar cómo se representa y se propaga la incertidumbre paramétrica. Incluir los parámetros como estados estáticos, por ejemplo, reintroduce el problema de diversidad descrito antes, que exige algo más que agrandar una nube con pocas regiones distintas.
La interpretación de una comprobación cambia también cuando el modelo generador es desconocido. Coincidir con la solución exacta del modelo prueba que el cálculo reproduce ese objetivo. La adecuación del modelo a las observaciones requiere otra evaluación, basada en su comportamiento predictivo y en el conocimiento del mecanismo de medición. Mantener separados ambos errores ayuda a localizar una discrepancia, puesto que cambiar el algoritmo y cambiar las probabilidades del modelo responden a problemas distintos.
Las regiones que nunca se visitaron
Una región de probabilidad pequeña puede quedar vacía por azar. Si una propuesta asigna probabilidad 0,01 a cierta región y se hacen cien extracciones independientes, la probabilidad de que ninguna caiga allí es , aproximadamente 0,366032. Una región ausente en la nube no tiene por ello probabilidad posterior cero.
Los diagnósticos basados en pesos evalúan los candidatos que sí se generaron y no pueden examinar directamente los que faltan. Es útil comparar ejecuciones independientes, observar las probabilidades de las regiones relevantes y estudiar la sensibilidad a propuestas más amplias o dirigidas de otra manera. Un recuento de posiciones distintas informa sobre la diversidad, aunque tampoco asegura, sin más, que se haya visitado cada modo importante.
Una observación muy precisa puede convertir una región antes marginal en una parte importante de la posterior. Si el bootstrap generó sus candidatos antes de tenerla en cuenta, puede que conserve muy pocos allí. La propuesta adaptada intenta adelantarse a ese problema. El remuestreo, en cambio, solo selecciona entre los candidatos existentes y no puede situar por sí mismo una partícula nueva fuera de sus posiciones.
Snyder y colaboradores (2008) estudiaron el colapso de los pesos en filtros que proponen desde la distribución previa. Bajo las condiciones de su análisis, la variabilidad del logaritmo de la verosimilitud impone exigencias muy fuertes sobre el tamaño de la nube. En ejemplos con componentes observadas de forma independiente, esas exigencias crecen exponencialmente con la dimensión.
La dimensión bruta del vector no es una regla universal suficiente para decidir el coste, porque importa cuántas direcciones informa la observación, cómo se relacionan con la incertidumbre previa y cuánto varía la verosimilitud entre candidatos. Una estructura que permita integrar analíticamente parte del estado puede reducir lo que debe simularse. Cambiar la propuesta también modifica el problema de ponderación, sin que eso garantice eliminar todas las dificultades.
En la ficha del ejemplo quedan ahora tres probabilidades para el segundo instante, aproximadamente 0,167702 en menos uno, 0,621118 en cero y 0,211180 en uno. Tras la lectura cero el estado central recibe el mayor respaldo y los dos extremos conservan masa. Con esas probabilidades y la media de 0,043478 pueden comprobarse las estimaciones que entregue una ejecución.
Para preparar la tercera lectura se propagan las tres masas mediante . Las probabilidades predictivas pasan a ser , y . Combinadas con las probabilidades del sensor, dan una previsión de , aproximadamente 0,319006, para la lectura uno. En ese cálculo siguen presentes las contribuciones de los tres estados mientras se espera la observación siguiente.
Referencias
Douc, R., Cappé, O., & Moulines, E. (2005). Comparison of resampling schemes for particle filtering. Proceedings of the 4th International Symposium on Image and Signal Processing and Analysis, 64–69. https://doi.org/10.1109/ISPA.2005.195385
Doucet, A., Godsill, S., & Andrieu, C. (2000). On sequential Monte Carlo sampling methods for Bayesian filtering. Statistics and Computing, 10(3), 197–208. https://doi.org/10.1023/A:1008935410038
Elvira, V., Martino, L., & Robert, C. P. (2022). Rethinking the effective sample size. International Statistical Review, 90(3), 525–550. https://doi.org/10.1111/insr.12500
Gordon, N. J., Salmond, D. J., & Smith, A. F. M. (1993). Novel approach to nonlinear/non-Gaussian Bayesian state estimation. IEE Proceedings F: Radar and Signal Processing, 140(2), 107–113. https://doi.org/10.1049/ip-f-2.1993.0015
Kitagawa, G. (1996). Monte Carlo filter and smoother for non-Gaussian nonlinear state space models. Journal of Computational and Graphical Statistics, 5(1), 1–25. https://doi.org/10.1080/10618600.1996.10474692
Pitt, M. K., & Shephard, N. (1999). Filtering via simulation: Auxiliary particle filters. Journal of the American Statistical Association, 94(446), 590–599. https://doi.org/10.1080/01621459.1999.10474153
Snyder, C., Bengtsson, T., Bickel, P., & Anderson, J. (2008). Obstacles to high-dimensional particle filtering. Monthly Weather Review, 136(12), 4629–4640. https://doi.org/10.1175/2008MWR2529.1