Una medición de posición puede cambiar la velocidad estimada de un objeto aunque el instrumento no mida velocidades. Imaginemos un pequeño carro que se observa cada segundo. Si aparece más adelantado de lo previsto, parte de la discrepancia puede venir de una posición inicial mal estimada y parte de una velocidad mayor que la supuesta; cuánto corresponde revisar cada componente depende de lo que se sabía antes de la lectura. El cálculo necesita conservar la relación entre los dos errores, que se pierde si solo se guarda una precisión para la posición y otra para la velocidad.
El filtro de Kalman organiza esta revisión con una media y una matriz de covarianzas. Entre lecturas, ambas se propagan según la dinámica del sistema. Al llegar una observación, se la compara con lo que esa misma dinámica anticipaba y se calcula una corrección cuyo tamaño depende de la incertidumbre previa, de la calidad del instrumento y de las dependencias entre variables. Una lectura precisa puede mover mucho una coordenada del estado y casi nada otra.
El carro es un ejemplo didáctico, sin mediciones de un dispositivo real, con parámetros elegidos para que las cuentas se vean con claridad. Las unidades tendrán su papel a lo largo del ejemplo, porque una covarianza entre posición y velocidad se mide en unidades distintas de las varianzas de cada una. De ahí que leer la matriz de ganancia completa como una colección de porcentajes lleve a error.
Kalman (1960) formuló la estimación lineal en términos de estados y de relaciones recursivas para el error. Su resultado matemático incluye la estimación óptima dentro de una clase lineal. Leer el filtro como el cálculo de una distribución condicional completa exige precisar supuestos adicionales, incluso cuando las ecuaciones de movimiento y de observación son lineales.
Supuestos que cierran la recursión
Consideremos un estado vectorial y un vector observado . Una especificación habitual es
La matriz de transición transforma el estado anterior. El término con la entrada conocida describe una influencia cuya magnitud quedó registrada, como una orden enviada a un motor. La matriz de observación lleva las coordenadas del estado a las magnitudes que entrega el instrumento. Los términos restantes corresponden a las perturbaciones del proceso y a los errores de medición. Podrían incluirse desplazamientos conocidos en ambas ecuaciones, aunque aquí se omite el de la observación para aligerar la escritura.
Supondremos de entrada que el estado inicial es normal, con media y covarianza . Las perturbaciones, de media cero y covarianzas y respectivamente, son además normales, independientes entre instantes, independientes entre sí e independientes del estado inicial. Las matrices y las entradas se consideran conocidas y quedan fijadas para el cálculo. Con estas condiciones, estados y observaciones forman un vector gaussiano conjunto para cualquier horizonte finito. Al condicionar un vector gaussiano se obtienen de nuevo distribuciones gaussianas.
Por eso la distribución filtrada queda descrita exactamente por dos objetos, su media y su covarianza, sin necesidad de arrastrar una densidad de forma cambiante. Como los errores nuevos son independientes de las observaciones anteriores, se puede avanzar un paso sin rehacer todas las integrales de la historia. Esa es la estructura de la solución lineal gaussiana que exponen Durbin y Koopman (2012) en su tratamiento de los modelos de espacio de estados.
Antes de operar fijaremos la notación. Escribiremos y para la media y la covarianza del estado actual condicionadas a las lecturas anteriores, mientras que y designarán esas mismas cantidades tras incorporar la lectura actual. Los signos marcan un orden en la información disponible y no indican el signo de las cantidades ni dos estados físicos distintos.
Una covarianza describe la incertidumbre sobre el estado, aunque el objeto físico tenga en ese momento una posición bien definida. La covarianza condicional del estado también se distingue de la dispersión de los datos observados, que incluye el error del instrumento. Para saber dónde podría estar el carro se usa la distribución del estado; para saber qué podría marcar el sensor debe sumarse la incertidumbre de la medición.
Las matrices de covarianza deben ser simétricas y semidefinidas positivas. Esa condición admite que alguna combinación de variables se conozca con exactitud, con varianza cero. Las fórmulas que usan una inversa ordinaria requieren además que la covarianza de la innovación sea invertible. Un ruido de medición definido positivo basta para asegurarlo, aunque hay situaciones legítimas con errores degenerados.
Propagación de errores relacionados
La predicción del estado siguiente se obtiene aplicando la transición a la media anterior. Para la incertidumbre hay que transformar la covarianza y sumar la perturbación nueva,
La segunda expresión contiene algo que se pierde cuando se propagan solo barras de error individuales. Si la posición futura depende de la velocidad actual, toda incertidumbre sobre esa velocidad contribuye a la incertidumbre sobre la posición futura y ambas coordenadas pasan a compartir parte del mismo error. Las entradas fuera de la diagonal registran ese origen común.
En el ejemplo, el estado contiene la posición en metros y la velocidad en metros por segundo. La transición usa un intervalo de un segundo,
La entrada superior derecha de la transición es un intervalo de un segundo, cuyo valor numérico es uno porque así se eligieron las unidades. Las varianzas de posición se miden en metros cuadrados, las de velocidad en metros cuadrados por segundo al cuadrado y la covarianza entre ambas en metros cuadrados por segundo. La perturbación de proceso es aquí una elección discreta hecha para el ejercicio y no se deriva de una aceleración blanca en tiempo continuo.
Al comienzo, la media sitúa el carro en el origen con una velocidad de un metro por segundo y, en esa distribución inicial, posición y velocidad son independientes. Un segundo después, la media predicha es de un metro para la posición y de un metro por segundo para la velocidad, mientras que la covarianza pasa a ser
La covarianza positiva tiene una lectura directa. Si la velocidad inicial superaba su media, el carro habrá avanzado más de lo previsto, por lo que, antes de medir, un error positivo de posición tiende a ir acompañado de un error positivo de velocidad. Esa relación surge aunque al principio ambas coordenadas tuvieran covarianza nula.
Sumar ruido de proceso aumenta la incertidumbre respecto de la que daría la misma transición sin ruido nuevo, pero no implica que la varianza tenga que aumentar respecto del instante anterior. Una dinámica contractiva puede reducirla. En una dimensión, multiplicar el estado por , partir de varianza y sumar una perturbación de varianza da una varianza predicha de , menor que la de partida pese al ruido añadido.
Innovación, ganancia y actualización
El sensor del carro observa la posición. Su matriz es y su error tiene varianza metros cuadrados. Antes de recibir la lectura, el filtro puede calcular la observación que espera. La diferencia entre la lectura efectiva y esa expectativa se llama innovación,
La covarianza de la innovación suma dos contribuciones independientes, la incertidumbre del estado proyectada sobre el instrumento y la imprecisión del propio instrumento. Una discrepancia de un metro puede sorprender poco cuando la predicción es muy incierta y bastante cuando ambos términos son pequeños, por lo que su valor aislado no permite juzgar la calidad del ajuste.
Para convertir esa discrepancia en una revisión del estado hace falta su covarianza con el error de predicción, que bajo los supuestos establecidos es . La ganancia, la nueva media y su covarianza son
La ganancia puede entenderse buscando una corrección lineal del error. Se pide que, después de corregir, el error restante no conserve una asociación lineal aprovechable con la innovación. La condición de ortogonalidad da la ecuación , cuya solución es la ganancia anterior. Si quedara alguna correlación residual, otra corrección lineal podría todavía reducir el error cuadrático.
La observación del primer segundo es metros. Como la predicción para el sensor era un metro, la innovación vale , con varianza . Las componentes de la ganancia son aproximadamente y . Al aplicarlas se obtiene una posición media de metros y una velocidad media de metros por segundo. La velocidad subió porque el error de posición anticipado estaba correlacionado con ella.
La primera componente de la ganancia es adimensional. La segunda transforma una discrepancia de posición en una corrección de velocidad y se expresa en segundos elevados a menos uno, por lo que no corresponde describirla como el porcentaje de confianza depositado en una medición de velocidad (esa medición nunca ocurrió). En problemas multivariantes, las entradas de la ganancia, cuyos valores dependen de las escalas y de las covarianzas, pueden ser negativas o mayores que uno sin infringir ninguna regla probabilística.
La covarianza actualizada del primer segundo es
La observación reduce mucho la incertidumbre de posición y menos la de velocidad. Las desviaciones estándar quedan en torno a metros para la primera y metros por segundo para la segunda. La media de velocidad cambió, pero sigue siendo imprecisa. Si solo se informa el aumento de su valor central, esa imprecisión se pierde de vista.
La reducción de incertidumbre puede examinarse también en direcciones que combinan coordenadas. Dentro del modelo gaussiano especificado, la varianza posterior de cualquier combinación lineal fija es menor o igual que la predicha, ya que la matriz que se resta es semidefinida positiva. Esto no quiere decir que todas sus entradas deban ser positivas ni que todas las covarianzas cruzadas disminuyan numéricamente; la afirmación concierne a las varianzas de combinaciones, que son las cantidades con interpretación de incertidumbre.
Con una sola lectura escalar, la corrección inmediata actúa a lo largo de una dirección fijada por la covarianza entre el estado y esa lectura. Si una combinación del estado tiene covarianza nula con la innovación, esa lectura no modifica su media ni reduce su varianza. En el carro, la velocidad sí está relacionada con la innovación. Esto permite distinguir dos causas de una actualización pequeña, un instrumento poco preciso o una observación que aporta poca información sobre la coordenada de interés. Mejorar el instrumento aborda la primera; la segunda puede exigir observar otra magnitud o esperar a que la dinámica establezca una relación informativa.
Restricciones de una matriz de covarianzas
Que las entradas diagonales sean positivas no basta para garantizar una covarianza válida. Cualquier combinación lineal de las variables debe tener varianza no negativa. En notación matricial, esa condición exige para todo vector de coeficientes compatible con las unidades. En particular, las covarianzas cruzadas no pueden elegirse con independencia de las varianzas marginales.
Supongamos dos errores de sensores que miden la misma magnitud en las mismas unidades. Una matriz con diagonal unitaria y ambas entradas fuera de la diagonal iguales a es imposible, porque la diferencia entre esos errores tendría varianza . El problema existe antes de ejecutar cualquier filtro y ninguna elección posterior de la ganancia puede convertir esa matriz en una descripción probabilística coherente.
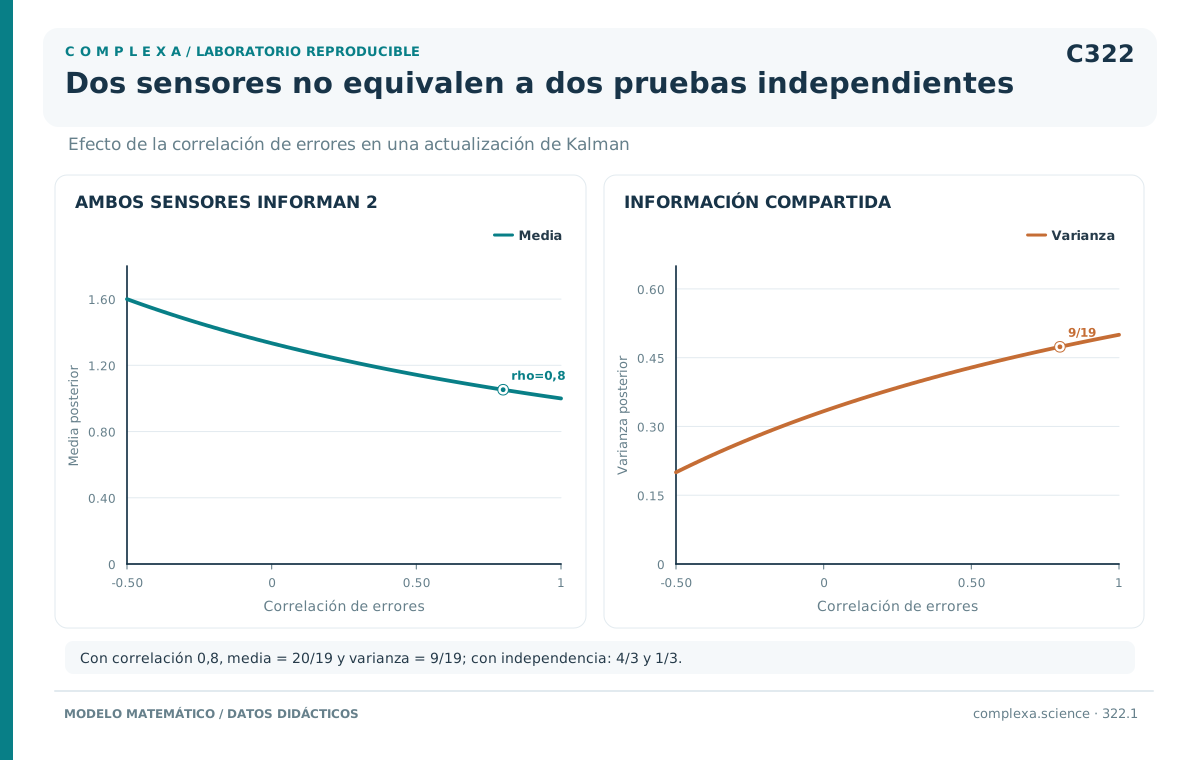
Usemos ahora una matriz válida para dos sensores correlacionados, en un ejercicio aparte del carro. El estado es un escalar con media previa cero y varianza uno. Ambos sensores lo miden directamente, cada error tiene varianza uno y la covarianza entre ellos es . La matriz de errores es
Los errores siguen siendo independientes del estado. Si ambos instrumentos marcan dos, la ganancia asigna cerca de a cada lectura, la media posterior es y la varianza . Si los errores se trataran como independientes, las mismas lecturas y el mismo conocimiento previo darían una media de y una varianza de . Ese segundo cálculo atribuye a la concordancia de los instrumentos una información que el modelo correlacionado no le concede.
Los dos sensores podrían compartir una referencia de calibración. Si así fuera, que ambos se desvíen en la misma dirección no equivaldría a dos confirmaciones independientes. La covarianza positiva expresa justamente esa posibilidad. Sumar instrumentos con una fuente común de error puede aumentar la cantidad de datos mucho más que la información efectiva sobre el estado.
En el límite en que ambos errores fueran idénticos, las lecturas serían copias exactas y la covarianza de la innovación sería singular. Con dos valores iguales a dos, el problema se reduce a una sola medición, con media posterior uno y varianza un medio. Se puede eliminar la copia o trabajar en el subespacio informativo con un tratamiento adecuado del rango. Sumar arbitrariamente un número pequeño a la diagonal, en cambio, altera el modelo, aunque consiga que la rutina de inversión deje de fallar.
Si en ese modelo de copias exactas llegaran dos valores distintos, los datos serían incompatibles con el soporte de la distribución propuesta. Una pseudoinversa no explica por sí sola la discrepancia. Antes de interpretar esa salida como una posterior válida habría que revisar la representación de los errores, las unidades o el registro de las lecturas.
El mismo ejemplo puede resolverse separando el promedio de las lecturas de su diferencia. El promedio mide el estado con una varianza de error de , resultado de sumar ambas varianzas más dos veces la covarianza y dividir por cuatro. La diferencia tiene varianza y en ella el estado común se cancela. Como los dos errores tienen igual varianza y son conjuntamente gaussianos, el error del promedio y la diferencia son independientes, por lo que en este modelo simétrico toda la información de las lecturas sobre el estado está en el promedio.
Esta transformación muestra por qué dos observaciones concordantes no equivalen a dos observaciones independientes. Su promedio arrastra buena parte del error compartido. Con varianza previa uno, combinar ese promedio con el conocimiento previo da otra vez una varianza posterior de , la misma cifra obtenida antes. Que ambos procedimientos coincidan confirma que el resultado depende de la información representada, cualquiera que sea el sistema de coordenadas en que se haga la cuenta.
Cuando las covarianzas previa y de medición son invertibles, esa acumulación se expresa mediante precisiones, es decir, inversas de covarianzas,
La fórmula supone que el error previo y el de medición son independientes. Si varios instrumentos tienen errores mutuamente independientes, sus aportes de precisión pueden sumarse de una vez o incorporarse uno tras otro, con idéntico resultado en aritmética exacta. Con errores correlacionados, procesar las lecturas como independientes repite información. En ese caso hace falta usar la covarianza conjunta, o bien transformar y condicionar correctamente las observaciones antes de una actualización secuencial.
Error de predicción y ruido de medición correlacionados
Hasta aquí admitimos dependencia entre sensores, pero mantuvimos su independencia respecto del error de predicción del estado. Esa distinción es necesaria, porque un dispositivo que interviene tanto en la propagación del estado como en su observación puede introducir una fuente de error compartida por ambas etapas. En ese caso, modificar solo las entradas de la matriz de errores de medición no incorpora toda la dependencia.
Sea el error de predicción y su covarianza con el error de medición, calculada condicionando a la información anterior. Supondremos que los dos errores tienen media condicional cero. Al desarrollar la varianza de la innovación y su relación con el estado aparecen términos adicionales,
La reducción de covarianza se calcula entonces con la covarianza cruzada completa,
Estas expresiones se obtienen al condicionar la distribución conjunta del error de predicción y la innovación. La dependencia relevante está definida para un instante y una información condicionante precisos. No conviene sustituirla automáticamente por la covarianza entre dos perturbaciones escritas en otra parte del modelo, porque esas perturbaciones pueden corresponder a tiempos diferentes.
Un cálculo escalar muestra el efecto. Si las varianzas del error de predicción y del error de medición valen ambas uno, la observación es directa y la covarianza cruzada es , entonces la innovación tiene varianza tres, la ganancia es un medio y la varianza posterior un cuarto. Con covarianza cruzada la ganancia sigue siendo un medio y la corrección de la media es la misma, pero la varianza posterior sube a tres cuartos.
La explicación está en cómo se combinan los errores al corregir. El error final es el error previo menos la ganancia multiplicada por la innovación; con una asociación positiva parte del error compartido puede cancelarse en esa resta, mientras que con una asociación negativa la cancelación cambia. Para reconstruir esa información no bastaría con guardar la ganancia; habría que conservar también el modelo de covarianza que la produjo.
Estabilidad numérica de la actualización
La expresión compacta de la covarianza posterior resta dos matrices que en algunas direcciones pueden ser casi iguales. En aritmética exacta el resultado sigue siendo semidefinido positivo, pero en una computadora el redondeo puede destruir esa propiedad o borrar una varianza pequeña que todavía importa. El problema se agudiza cuando algunas coordenadas se conocen con mucha más precisión que otras.
Volvamos a suponer independencia entre el error de predicción y el de medición. Si definimos , el error posterior es y su covarianza puede calcularse directamente como
Esta es la forma de Joseph. Con la ganancia óptima coincide con la expresión compacta, aunque mantiene a la vista una suma de contribuciones semidefinidas positivas. La misma identidad da la covarianza del error para cualquier ganancia fija distinta de la óptima, bajo los mismos supuestos. Chin (2023, versión corregida) la presenta al estudiar las dificultades numéricas de preservar covarianzas válidas. Si existe la dependencia cruzada de la sección anterior, deben añadirse los términos ; la fórmula de independencia no puede reutilizarse sin cambios.
Un ejemplo en precisión simple hace visible la pérdida. Tomemos una predicción escalar con varianza de cien millones y una medición directa con varianza uno. El resultado exacto de la actualización es aproximadamente . En aritmética de treinta y dos bits, en cambio, sumar uno a cien millones puede devolver cien millones, en cuyo caso la ganancia calculada se redondea a uno y la expresión devuelve cero.
Con esa misma ganancia redondeada, la forma de Joseph conserva el término del ruido de medición y devuelve uno, con lo que evita que una pérdida de precisión aritmética se convierta en una afirmación de conocimiento exacto. Un cero tendría sentido si el instrumento fuera perfecto y su error tuviera de verdad varianza cero. Ambos casos se distinguen en el modelo de entrada, aunque una implementación defectuosa pueda producir la misma cifra en los dos.
La forma de Joseph reduce ciertos riesgos, pero no elimina todo problema de cálculo. La revisión de Kaminski, Bryson y Schmidt (1971) estudió alternativas que propagan factores de la covarianza y comparó sus propiedades numéricas. Si se conserva un factor tal que , se trabaja con una representación que lleva incorporada la estructura positiva. Los métodos de raíz cuadrada actualizan esos factores mediante transformaciones como la factorización QR, mientras que calcular la raíz de cada entrada de la matriz no daría una factorización de este tipo.
También conviene resolver sistemas lineales con la covarianza de la innovación sin formar explícitamente su inversa; si esa covarianza es definida positiva, una factorización de Cholesky permite hacerlo aprovechando su estructura. Escalar de forma coherente las coordenadas ayuda si sus magnitudes difieren mucho. La precisión numérica elegida, el análisis del rango y la comprobación de simetría son parte de una implementación fiel a las ecuaciones que dice ejecutar.
Un cambio de unidades es también una prueba útil para un programa. Si la posición pasa a expresarse en centímetros y la velocidad sigue en metros por segundo, el estado se multiplica por una matriz diagonal con entradas cien y uno. La covarianza se transforma en , de modo que la primera varianza queda multiplicada por diez mil y la covarianza cruzada por cien. La transición debe pasar a y, si el sensor sigue entregando metros, la matriz de observación a . La ganancia se transforma en .
Una vez deshecha la conversión, las estimaciones físicas y sus incertidumbres tienen que coincidir con las originales. Si solo se convierte la media de posición, el filtro termina combinando matrices referidas a escalas incompatibles. La prueba ayuda a detectar errores capaces de producir curvas de aspecto razonable, sobre todo cuando una coordenada influye poco en las observaciones.
La inicialización también puede fabricar una certeza artificial con una aritmética impecable. Si la covarianza inicial es nula y no se admite ruido de proceso, las covarianzas predichas seguirán siendo nulas y, con varianzas de medición positivas, la ganancia será cero y ninguna lectura moverá el estado estimado. Es la manera en que el modelo expresa su convicción de que ya conoce exactamente la trayectoria. Añadir ruido de proceso modifica esa convicción y permite que aparezca incertidumbre sobre los estados posteriores, pero su magnitud debe corresponder a una especificación defendible. Usarlo únicamente para que la curva siga a los datos mezcla una decisión sobre el proceso con el arreglo de un fallo numérico.
Linealidad sin normalidad
Las ecuaciones lineales propagan medias y covarianzas usando momentos de segundo orden. Si las distribuciones iniciales y los ruidos dejan de ser gaussianos, el filtro puede conservar su interpretación como estimador lineal de mínimo error cuadrático, bajo las condiciones apropiadas de momentos e incorrelación. La distribución condicional verdadera, sin embargo, puede contener información que sus dos primeros momentos no resumen. Anderson y Moore (2005) separan la formulación basada en estimadores y covarianzas de su interpretación condicional bajo normalidad.
Consideremos una variable que solo puede valer menos uno o más uno con igual probabilidad y que se observa sumándole un error normal independiente de media cero y varianza uno. La observación es lineal en el estado y el ruido es gaussiano, aunque el estado previo no es gaussiano. Como su media es cero y su varianza uno, el cálculo lineal da ganancia un medio y una estimación igual a la mitad de la lectura.
Si el instrumento marca tres, esa estimación vale , fuera del intervalo que contiene los dos estados posibles. La posterior puede calcularse directamente comparando las dos verosimilitudes normales. La razón de probabilidades entre el estado positivo y el negativo es , de donde se obtienen
Para la lectura tres, la media condicional es aproximadamente y su varianza , de modo que la lectura respalda casi por completo el estado positivo. La salida lineal no puede incorporar la restricción de que solo hay dos estados, ya que se calculó con una representación de momentos que también sería compatible con otras distribuciones previas.
La varianza de que dan las ecuaciones lineales conserva un significado preciso, el de error cuadrático medio del estimador lineal promediado sobre las observaciones posibles de este experimento. No es la varianza posterior exacta después de observar tres. Distinguir esos dos promedios evita atribuir al algoritmo una exactitud distribucional que sus supuestos no respaldan.
El ejemplo localiza además el origen de la diferencia sin necesidad de una dinámica complicada. La estimación lineal usa una sola pendiente para todas las lecturas. La media condicional exacta, en cambio, se acerca a uno cuando las lecturas son grandes y positivas y a menos uno cuando son grandes y negativas. Esa saturación procede de la distribución previa del estado y una transición lineal no obliga, por sí sola, a que desaparezca.
Diagnóstico con innovaciones
En el modelo lineal gaussiano con matrices y calendario de observación fijos, las covarianzas del filtro no dependen de los valores concretos que marcan los instrumentos y pueden calcularse antes de recibirlos. Las medias, en cambio, dependen de las lecturas. Por tanto, una observación sorprendente no ensancha automáticamente la incertidumbre posterior del filtro ordinario. Si se quiere que los datos modifiquen la confianza en el instrumento, hace falta especificar y estimar un mecanismo adicional.
Las innovaciones permiten examinar la predicción antes de cada actualización. Cuando el modelo y sus parámetros son correctos, tienen media cero y la covarianza que prevé el filtro y, bajo los supuestos gaussianos, son además independientes entre instantes. Dividiéndolas por la desviación prevista en el caso escalar, o transformándolas con una factorización de la covarianza en el caso vectorial, se pueden comparar discrepancias de escalas distintas. Desviaciones persistentes en la secuencia sugieren que la estructura de la predicción necesita revisión.
La comparación debe hacerse con las innovaciones calculadas antes de incorporar cada lectura, porque los residuos obtenidos después de corregir el estado ya se beneficiaron de ella. Un filtro que confía demasiado en las mediciones puede acercarse mucho a todos los datos y dejar residuos finales pequeños mientras la secuencia de errores de predicción queda sin explicar. La distinción afecta al diagnóstico aunque ambas curvas tengan el mismo aspecto en un gráfico.
Estimar las covarianzas de proceso y de medición es un problema aparte. Zhang y colaboradores (2020) estudian las condiciones de identificación ligadas a la estructura del sistema y al número de parámetros de covarianza desconocidos. Su análisis distingue entre la existencia de una solución identificable y la ejecución de un filtro con matrices ya especificadas. Una trayectoria de aspecto suave no resuelve esa cuestión, porque repartos distintos de la incertidumbre pueden producir ajustes plausibles.
Si los parámetros se ajustaron con la serie completa, las innovaciones reconstruidas con ellos no equivalen a una evaluación completamente prospectiva, porque los datos posteriores participaron indirectamente en el cálculo. Para juzgar el uso secuencial del procedimiento, la estimación de parámetros y la elección de variantes deben respetar el momento en que se habría emitido cada predicción. Una recursión del estado puede respetar el orden temporal y, a la vez, usar información futura a través de parámetros aprendidos después.
La segunda lectura del carro
Tras la primera observación disponíamos de una posición media de y una velocidad media de . Al avanzar otro segundo, la posición predicha pasa a metros y la nueva covarianza de predicción es
La incertidumbre de posición volvió a crecer, en buena medida porque la velocidad seguía siendo poco precisa. La segunda lectura es metros, de modo que la innovación vale aproximadamente , con varianza prevista . La ganancia tiene ahora componentes y , distintas de las del primer paso porque la observación anterior y la nueva propagación cambiaron la estructura del error.
Después de actualizar, la posición media queda en metros y la velocidad en metros por segundo. La lectura, inferior a lo previsto, rebajó ambas estimaciones. La posición queda todavía algo por encima de lo que marcó el sensor porque la predicción anterior contenía información, mientras que la velocidad baja porque su error estaba asociado al de posición.
Las desviaciones estándar resultantes son de alrededor de metros y metros por segundo. La covarianza cruzada sigue siendo positiva, cerca de metros cuadrados por segundo; habrá que conservarla para el tercer segundo, porque volverá a influir en la incertidumbre de la posición futura. El registro que se transmite al paso siguiente contiene las dos medias y la matriz completa, con sus unidades y el instante al que corresponden.
Antes de una tercera lectura, ese registro predice una posición media de unos metros, con varianza cercana a metros cuadrados. Para anticipar la lectura del sensor debe sumarse su varianza de error, con lo que la varianza de la lectura futura queda en torno a metros cuadrados. Las dos predicciones comparten la media porque en este modelo el instrumento no tiene sesgo, pero sus dispersiones difieren; la primera describe dónde podría estar el carro y la segunda agrega cómo podría equivocarse el instrumento. Si lo que se pide es una previsión de la próxima lectura, la distribución que debe guardarse es esta segunda, para compararla con el valor que llegue un segundo después.
Referencias
Anderson, B. D. O., & Moore, J. B. (2005). Optimal filtering. Dover Publications. Reimpresión de la edición de 1979. https://researchportalplus.anu.edu.au/en/publications/optimal-filtering/
Chin, T. M. (2023). Square-root formulas for Kalman filter, information filter, and RTS smoother: Links via boomerang prediction residual. The Interplanetary Network Progress Report, 42-233. Versión con correcciones de 2024. https://ipnpr.jpl.nasa.gov/progress_report/42-233/42-233A.pdf
Durbin, J., & Koopman, S. J. (2012). Time series analysis by state space methods (2.ª ed.). Oxford University Press. https://doi.org/10.1093/acprof:oso/9780199641178.001.0001
Kalman, R. E. (1960). A new approach to linear filtering and prediction problems. Journal of Basic Engineering, 82(1), 35–45. https://doi.org/10.1115/1.3662552
Kaminski, P. G., Bryson, A. E., & Schmidt, S. F. (1971). Discrete square root filtering: A survey of current techniques. IEEE Transactions on Automatic Control, 16(6), 727–736. https://doi.org/10.1109/TAC.1971.1099816
Zhang, L., Sidoti, D., Bienkowski, A., Pattipati, K. R., Bar-Shalom, Y., & Kleinman, D. L. (2020). On the identification of noise covariances and adaptive Kalman filtering: A new look at a 50 year-old problem. IEEE Access, 8, 59362–59388. https://doi.org/10.1109/ACCESS.2020.2982407