El consumo real registrado para el primer trimestre de 1990 fue de 5303,3 miles de millones de dólares encadenados de 2005, expresado como tasa anual desestacionalizada. Con el registro disponible hasta el trimestre anterior, una regla de persistencia habría pronosticado 5261,7, en tanto que un modelo que incorpora el crecimiento reciente produce 5304,6 en el ejercicio que desarrollaremos. La cercanía de esta segunda cifra es un buen punto de partida para revisar el cálculo, si bien su evaluación requiere seguir muchos orígenes posteriores.
La serie utilizada contiene observaciones reales. Corresponde a realcons, la variable de gasto real de consumo personal del conjunto macrodata distribuido por statsmodels. Todas las predicciones que siguen se calcularon sobre una copia fijada de ese archivo, sin simular observaciones ni sustituir valores difíciles para mejorar el resultado.
Un registro histórico con dos calendarios
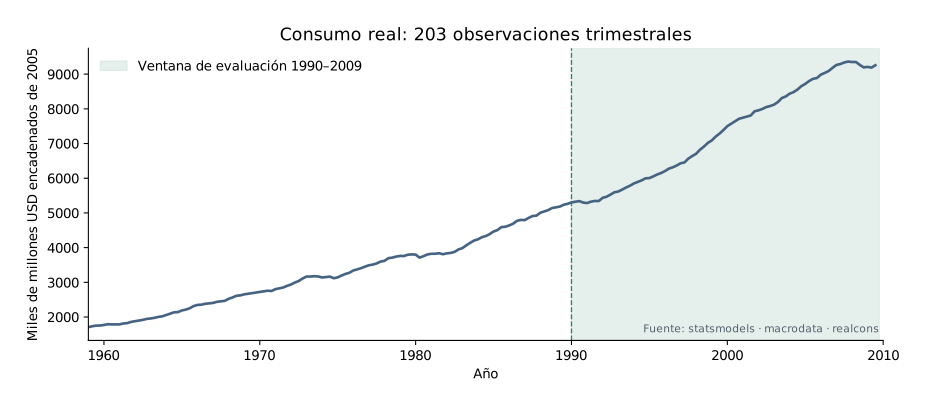
El archivo contiene doscientos tres trimestres consecutivos, desde el primero de 1959 hasta el tercero de 2009. Su documentación atribuye la recopilación a Skipper Seabold y señala como fuente del consumo a FRED, del Banco de la Reserva Federal de San Luis, con una consulta histórica declarada el quince de diciembre de 2009. Esa fecha sitúa la recopilación documentada y deja abierta la historia de revisiones que cada cifra tenía entonces.
La copia del CSV oficial, recuperada el veinticinco de octubre de 2026, quedó identificada mediante su huella digital. El archivo se conserva junto con la documentación de procedencia para que el ejercicio no dependa de una descarga futura cuyo contenido podría cambiar. La serie empieza en 1707,4 y termina en 9256,0, sin trimestres repetidos ni valores faltantes de consumo, con las unidades y el ajuste estacional que describe la documentación oficial (statsmodels developers, s. f.).
Intervienen aquí dos calendarios. Uno es el periodo al que se refiere una observación y el otro, la fecha en que su valor fue publicado o revisado. El CSV recoge el primero pero carece de una sucesión de versiones históricas del segundo. Al construir un pronóstico con datos hasta 1989 utilizaremos los valores de esos periodos tal como aparecen en esta instantánea, que no son literalmente las cifras que un analista habría podido consultar al terminar ese año.
Croushore y Stark (2001) construyeron un conjunto de versiones históricas precisamente para estudiar diferencias de esa naturaleza. Su estructura conserva qué datos estaban disponibles en fechas sucesivas, con lo cual puede examinarse el efecto de las revisiones sobre la evaluación predictiva. Nuestro archivo, en cambio, tiene una sola columna histórica de consumo.
Por ello, el resultado se interpretará como una evaluación retrospectiva sobre la instantánea distribuida por statsmodels, dentro de la cual se respetará el orden temporal de entrenamiento y evaluación. Quedará pendiente la incertidumbre que introducirían las primeras publicaciones, sus retrasos y sus revisiones. Con ambas condiciones separadas se describe con precisión qué parte de una evaluación operativa se ha reproducido.
El objeto medido también merece atención. La variable realcons es un gasto agregado real, distinto del gasto nominal de una familia y de una medida por habitante, por lo que su aumento puede combinar cambios de población y de consumo por persona. Las cifras encadenadas expresan volumen en una referencia monetaria histórica. El caso estudia la evolución de ese agregado. Asignar sus cambios a preferencias individuales, ingresos de hogares concretos o decisiones clínicas queda fuera de su alcance.
La anualización de la tasa tampoco convierte cada fila en una observación anual. La frecuencia del registro y las unidades de su valor son aquí propiedades distintas, pues cada fila corresponde a un trimestre y expresa la actividad de ese periodo en una escala de tasa anual. Sumar cuatro filas sin ajustar esa escala cuadruplicaría la magnitud que vamos a utilizar como promedio anual.
Pronosticar el cambio relativo
Como el nivel final es unas cinco veces y media el inicial, una discrepancia de veinte unidades tiene un peso relativo diferente al comienzo y al final del archivo. Por esa razón los modelos se construyen sobre el crecimiento logarítmico trimestral
donde es el consumo observado, una transformación bien definida porque todos los valores son positivos. El factor cien expresa los cambios pequeños en una escala cercana a la de los porcentajes. Al tratarse de crecimiento logarítmico, un valor de uno corresponde exactamente a multiplicar el nivel por , operación distinta de sumar una unidad monetaria.
No multiplicamos el crecimiento por cuatro. Aunque los niveles estén anualizados, el cociente entre dos filas consecutivas compara trimestres consecutivos y en él se cancela el factor de anualización de los niveles. Si quisiéramos expresar una tasa anualizada de crecimiento, tendríamos que definir una transformación adicional y mantenerla en todas las tablas.
La primera diferencia logarítmica utiliza dos observaciones, así que quedan doscientas dos tasas de crecimiento, cuya media en el registro completo es aproximadamente y cuya desviación estándar es . La caída logarítmica más pronunciada, con un valor cercano a , aparece en el segundo trimestre de 1980 y el aumento máximo, cerca de , en el cuarto de 1965. Estas cifras describen el archivo completo y ninguna de ellas interviene de antemano en el ajuste de los modelos.
Transformar el nivel orienta la pregunta hacia los cambios relativos. La estacionariedad del crecimiento queda, sin embargo, por establecer, ya que su promedio, su dispersión o su dependencia pueden variar. Por eso evaluaremos procedimientos sencillos capaces de actualizar sus parámetros y examinaremos sus errores por periodos, sin tomar una gráfica más estable como prueba de que el mecanismo permanece constante.
Se comparan tres reglas. La persistencia de nivel pronostica que el consumo siguiente será igual al último observado, es decir, un crecimiento logarítmico nulo. La segunda regla, basada en el promedio de todos los crecimientos disponibles hasta el origen, pronostica una expansión proporcional constante que se actualiza cada vez que llega otro dato.
La tercera regla ajusta al crecimiento una autorregresión de primer orden
Con el intercepto y el coeficiente estimados por mínimos cuadrados, el pronóstico del siguiente crecimiento depende del último crecimiento observado. Añadir el término del retardo aumenta la capacidad de adaptación e introduce a la vez un coeficiente que debe estimarse, por lo que su utilidad empírica habrá de comprobarse frente a las dos reglas anteriores.
La referencia de persistencia se utiliza aquí como una regla transparente. La literatura económica sobre consumo estudia restricciones predictivas derivadas de la optimización intertemporal, como las que examinó Hall (1978). Este ejercicio se aparta de aquella prueba económica, pues utiliza el gasto personal total y compara procedimientos estadísticos sin estimar una función de utilidad ni reconstruir el conjunto informativo de los hogares.
El regreso al nivel se realiza mediante , operación que define el pronóstico puntual que puntuaremos. Aunque exponenciar una predicción del logaritmo da, en general, un valor distinto de la esperanza condicional del nivel, aquí no se añade una corrección de media lognormal ni se presenta el resultado como una distribución predictiva calibrada.
Elegir la memoria antes de evaluar
La autorregresión puede estimarse con toda la historia disponible o con una ventana reciente. Una ventana corta responde con rapidez a cambios de relación a costa de estimar sus coeficientes con menos pares de observaciones. Una larga reduce esa variabilidad, pero conserva información que podría corresponder a condiciones anteriores.
La elección se hace en un tramo de desarrollo que va desde el primer trimestre de 1980 hasta el cuarto de 1989. En él se comparan ventanas de veinte, cuarenta y ochenta pares consecutivos de crecimientos, junto con una ventana expansiva. Cada par contiene el crecimiento que se quiere explicar y su retardo inmediato, de manera que veinte pares requieren veintiún crecimientos consecutivos.
Para cada trimestre de desarrollo se corta la serie en el trimestre anterior, se ajusta cada alternativa y se pronostica una sola observación, que queda fuera de ese ajuste. Los cuarenta errores así obtenidos se resumen en su valor absoluto medio, calculado en la escala del crecimiento logarítmico.
| Ventana de la autorregresión | Trimestres de desarrollo | Error absoluto medio del crecimiento |
|---|---|---|
| 20 pares | 40 | 0,6773 |
| 40 pares | 40 | 0,6205 |
| 80 pares | 40 | 0,6098 |
| Expansiva | 40 | 0,6027 |
La ventana expansiva obtiene el menor valor y se conserva para la evaluación posterior, con una diferencia pequeña respecto de la de ochenta pares. La tabla documenta la elección del procedimiento en ese tramo, sin atribuir a esa memoria el carácter de propiedad universal del consumo.
Desde ese momento la elección queda fija y solo los coeficientes se vuelven a estimar en cada origen, una distinción necesaria para reproducir el ejercicio. La expresión «modelo fijo» podría entenderse como mantener los coeficientes de 1989 durante veinte años. Lo que aquí se fija es la forma de actualización, que consiste en añadir la nueva observación al entrenamiento y reajustar.
El primer origen de evaluación es el cuarto trimestre de 1989. Contiene ciento veinticuatro niveles observados y ciento veintitrés crecimientos, de modo que la regresión de cada crecimiento sobre el anterior dispone de ciento veintidós pares. Como el último origen para el horizonte de un trimestre es el segundo de 2009, se generan setenta y nueve predicciones, con objetivos desde el primero de 1990 hasta el tercero de 2009.
Cada observación evaluada puede utilizarse después, cuando pasa a formar parte del pasado de un origen posterior, tal como haría un procedimiento que aprende de los registros recibidos. La elección de ventana, en cambio, nunca se revisa con sus errores futuros. Para comparar una regla que cambiara de ventana durante la evaluación habría que especificar y evaluar también esa regla.
La separación temporal alcanza también a la transformación. Cada ajuste calcula los crecimientos a partir del prefijo que recibe, sin centrarlos con una media de toda la serie ni corregirlos con información de trimestres posteriores. La aplicación usa únicamente el consumo y deja fuera ingresos, tipos de interés u otras variables cuya publicación exigiría reconstruir calendarios adicionales.
Seguir el primer pronóstico
Al terminar 1989, el último nivel registrado es 5261,7 y el crecimiento logarítmico medio calculado con el pasado es , por lo que la regla de crecimiento histórico pronostica
La autorregresión ajustada en ese mismo origen tiene un intercepto aproximado de y un coeficiente de . Al introducir el último crecimiento observado produce una predicción de crecimiento de , que se transforma en un nivel de .
El valor observado después es 5303,3. Si el error se define como observado menos pronosticado, la persistencia se queda corta en 41,60 unidades, el crecimiento histórico se excede en 6,77 y la autorregresión, en 1,32. Las tres diferencias se refieren al mismo trimestre y a la misma versión de los datos.
Esta cuenta reconstruye el procedimiento completo en un origen concreto, con los registros que entraron, el número de pares ajustados, el crecimiento pronosticado y la manera en que se recuperó el nivel. El buen resultado de la autorregresión en ese trimestre tendrá que juzgarse junto con los otros setenta y ocho errores.
El coeficiente autorregresivo cambia al ampliar el entrenamiento. Durante los orígenes de evaluación a un trimestre permanece aproximadamente entre y . La relación estimada con el crecimiento previo es, por tanto, positiva y bastante menor que uno. Con el resto del ajuste constante, una observación de crecimiento bajo reduce el pronóstico siguiente respecto del que correspondería a un crecimiento reciente alto.
El intercepto impide leer esa respuesta como una simple repetición de la última tasa. Incluso después de un crecimiento negativo, el modelo puede pronosticar un aumento si su componente de nivel medio domina la contribución del retardo, propiedad que se hará visible al examinar los últimos años del registro.
Comparar errores con una escala común
Para cada modelo se calcula el error absoluto medio, abreviado MAE, sumando las magnitudes de sus errores y dividiendo entre el número de objetivos evaluados. También se calcula la raíz del error cuadrático medio, o RMSE, que eleva al cuadrado antes de promediar y concede así más peso a las discrepancias grandes. Calculadas sobre niveles, ambas medidas vuelven a las unidades del consumo.
Qué medida elegir depende del coste que interesa describir. Si equivocarse en ochenta unidades es mucho más perjudicial que equivocarse dos veces en cuarenta, una pérdida cuadrática recoge esa preferencia mejor que una absoluta. Aquí se muestran ambas para que el lector pueda examinar la clasificación con cada forma de penalizar por separado. Hyndman y Koehler (2006) estudian las propiedades de estas medidas y los problemas que aparecen al comparar errores expresados en escalas diferentes.
La tabla siguiente utiliza los setenta y nueve objetivos trimestrales compartidos. El error medio conserva el signo definido antes, así que un valor negativo indica que los pronósticos excedieron, en promedio, lo observado. Todas las cifras de las tres últimas columnas están expresadas en miles de millones de dólares encadenados de 2005, a tasa anual.
| Regla, horizonte de un trimestre | MAE | RMSE | Error medio |
|---|---|---|---|
| Persistencia del nivel | 56,86 | 64,09 | 50,56 |
| Crecimiento histórico | 30,96 | 43,62 | −13,76 |
| Autorregresión del crecimiento | 28,26 | 38,14 | −9,83 |
La persistencia tiende a quedarse corta en una serie que crece con frecuencia, error que las dos reglas con crecimiento reducen aunque su promedio firmado cambie de dirección. La autorregresión obtiene un error absoluto medio aproximadamente un nueve por ciento menor que el de la regla de crecimiento histórico. En unidades del agregado, la reducción es de unos dos mil setecientos millones de dólares a tasa anual por objetivo evaluado.
Esa cantidad mide errores de pronóstico. Traducirla en dinero ahorrado, consumo recuperado o efecto de una intervención requeriría especificar una decisión que dependiera del pronóstico y calcular su coste.
En la escala del crecimiento logarítmico, los errores absolutos medios son aproximadamente 0,795, 0,415 y 0,383, en el mismo orden. La clasificación se conserva. Esta segunda lectura ayuda a comprobar que la ventaja no procede exclusivamente del mayor peso que los trimestres finales, con niveles más altos, tienen en los errores monetarios.
Las celdas resumen observaciones emparejadas, porque los modelos se equivocaron sobre los mismos objetivos. Si quisiéramos estimar la incertidumbre de la diferencia trabajaríamos con la diferencia entre las pérdidas de cada trimestre, puesto que comparar intervalos calculados por separado para dos promedios desperdiciaría esa correspondencia.
Diebold y Mariano (1995) formularon una comparación de precisión basada en diferencias de pérdida que, bajo sus condiciones, admite dependencia temporal. Aquí no se ha realizado una prueba de superioridad poblacional. Las tablas informan qué procedimiento acumuló menos error en esta evaluación y dejan disponibles las pérdidas individuales para examinar la estabilidad de esa diferencia.
Esperar cuatro trimestres
Ampliar el horizonte obliga a decidir cómo se utilizan los valores intermedios. Desde un origen determinado los coeficientes se estiman una sola vez y el primer crecimiento futuro se calcula con el último crecimiento observado. El segundo usa el primero pronosticado y los siguientes continúan la misma recursión.
En la autorregresión, por ejemplo,
El subíndice del origen indica que los parámetros siguen siendo los estimados con información hasta ese momento. Introducir el crecimiento realmente observado en el primer trimestre futuro produciría otra tarea, una predicción actualizada desde un origen posterior y emitida con una observación adicional que la primera decisión desconocía.
Los crecimientos pronosticados se acumulan en el logaritmo, o equivalentemente se aplican de manera sucesiva al nivel. El pronóstico a cuatro trimestres se compara con el nivel al final de ese horizonte. El promedio de los cuatro niveles será el objeto de la sección siguiente.
La trayectoria emitida al terminar 1989 muestra esa recursión. Los cuatro crecimientos previstos por la autorregresión son aproximadamente 0,8124, 0,8860, 0,9026 y 0,9064. Los niveles correspondientes, 5304,62, 5351,83, 5400,35 y 5449,52, se calcularon todos con el mismo intercepto y el mismo coeficiente estimados al cerrar 1989.
El crecimiento previsto se aproxima a la solución de equilibrio del modelo ajustado, igual al intercepto dividido entre uno menos el coeficiente autorregresivo. Como el coeficiente está entre cero y uno, la distancia respecto de esa solución se multiplica por él en cada paso y la trayectoria se va volviendo regular a medida que el último crecimiento observado pierde influencia.
Esa regularidad es propia del pronóstico. Los cuatro niveles registrados durante 1990 fueron 5303,3, 5320,8, 5341,0 y 5299,5. El último trimestre descendió. Por eso la predicción de horizonte cuatro termina unos ciento cincuenta mil millones de dólares a tasa anual por encima del valor observado, aunque el primer paso de la misma trayectoria había quedado muy cerca.
El pronóstico a un trimestre para el cuarto de 1990, en cambio, ya utiliza datos hasta el tercero. Ese ajuste actualizado produjo 5382,70, todavía demasiado alto pero distinto de los 5449,52 emitidos tres trimestres antes, porque ambas predicciones del mismo objetivo se hicieron con distinta información y a distinto horizonte.
Conservar ambos orígenes evita atribuir a la autorregresión una única predicción por fecha y ayuda a localizar la fuente de una mejora, que puede proceder de una regla distinta o de haber recibido nuevas observaciones. En las tablas cada regla se compara con las demás desde el mismo origen, sin que la actualización posterior reemplace retrospectivamente el pronóstico emitido antes.
Con los mismos orígenes iniciales quedan setenta y seis objetivos completos, desde el cuarto trimestre de 1990 hasta el tercero de 2009, pues el último origen posible es el tercero de 2008. Los errores absolutos medios son 220,54 para la persistencia, 95,93 para el crecimiento histórico y 91,11 para la autorregresión. Sus raíces del error cuadrático medio son, respectivamente, 240,14, 146,42 y 138,29.
Un horizonte más largo amplía la discrepancia entre conservar el nivel y dejarlo crecer, a la vez que da más margen para que una tasa histórica de expansión se aparte de la trayectoria posterior. La autorregresión conserva la ventaja media en esta comparación, pero las diferencias entre objetivos son grandes y el error cuadrático aumenta bastante más que el absoluto.
En la escala logarítmica, la evaluación a cuatro trimestres utiliza el cambio acumulado entre origen y objetivo, con lo cual el horizonte pasa a formar parte de la definición de la variable evaluada. Sería incorrecto enfrentar directamente ese error con el de una sola tasa trimestral, como si ambos describieran el mismo periodo.
Además, las ventanas futuras se solapan. Dos pronósticos emitidos en trimestres consecutivos comparten tres de los cuatro trimestres de crecimiento que deberán atravesar, por lo que una misma perturbación puede afectar a varios errores de horizonte largo. Los setenta y seis errores contienen, en consecuencia, menos información que setenta y seis experimentos independientes. Una comparación formal tendría que incorporar esta dependencia al cálculo de incertidumbre, ya que persiste por mucho que los errores ocupen filas diferentes.
Cuando cambia el balance entre errores
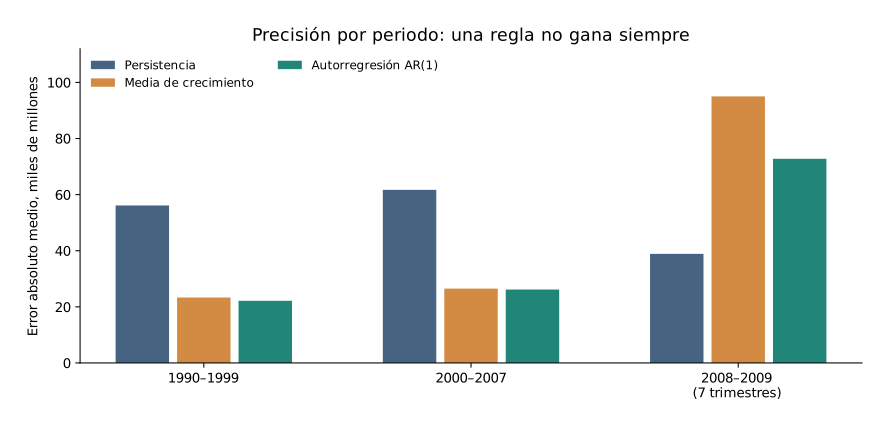
Una evaluación de casi veinte años puede favorecer a un modelo que funciona peor en su tramo final. Para localizar esa posibilidad, los errores a un trimestre se separan en tres intervalos de calendario, en una inspección que describe dónde se concentra el resultado y deja intacta la regla ya seleccionada.
| Periodo objetivo | Número de trimestres | MAE de persistencia | MAE de crecimiento histórico | MAE de autorregresión |
|---|---|---|---|---|
| 1990–1999 | 40 | 56,14 | 23,32 | 22,15 |
| 2000–2007 | 32 | 61,70 | 26,50 | 26,18 |
| 2008–2009, tercer trimestre | 7 | 38,89 | 95,01 | 72,76 |
En los dos primeros intervalos, incorporar crecimiento reduce claramente el error respecto de repetir el último nivel. En los siete trimestres finales gana la persistencia. La autorregresión amortigua parte del exceso de la regla histórica, pero ambas conservan una expectativa de expansión que supera con frecuencia los valores observados.
El mecanismo se aprecia en el pronóstico del tercer trimestre de 2008. A partir de un consumo de 9351,0 en el trimestre anterior, la regla histórica utiliza un crecimiento logarítmico cercano a 0,863 y pronostica 9432,07. El valor observado baja a 9267,7 y el error, de aproximadamente menos 164,37, combina una caída efectiva con una predicción que todavía apunta hacia arriba.
Con una historia larga, cada observación nueva tiene poco peso en la media y la modifica lentamente cuando el crecimiento reciente se aleja de ella. Hasta el final de 1989, el crecimiento logarítmico medio del registro era aproximadamente 0,915 por trimestre, frente a una media observada cercana a 0,715 en los objetivos posteriores. Los modelos expansivos incorporan esa diferencia de forma gradual, ya que desconocen de antemano el promedio del periodo que van a predecir.
El ejemplo muestra también por qué una ventana reciente podía haber sido una candidata razonable. Durante el desarrollo ya se comparó con la historia completa y perdió según la regla escogida. Su resultado posterior podría ser distinto. Elegirla ahora por los siete últimos errores, sin embargo, convertiría esos mismos errores en datos de selección y obligaría a someter la nueva regla a otra evaluación para medir su desempeño después del cambio.
Los intervalos de la tabla son simples tramos de calendario, ajenos a toda búsqueda de puntos de cambio que los estime como regímenes y a cualquier atribución de una causa a los errores. Lo que muestran es que el promedio general esconde una inversión de la clasificación. Un procedimiento operativo podría usar esa observación para proponer una regla de adaptación, siempre con una señal que pudiera calcularse antes del siguiente objetivo.
Por ejemplo, podría vigilar una secuencia de errores firmados y reducir la memoria cuando persistiera un exceso de pronóstico. El umbral, el número de observaciones y la nueva ventana pasarían entonces a ser componentes del procedimiento. Esa variante no se ejecuta aquí. Las cifras publicadas corresponden a la regla expansiva descrita, de manera que una propuesta posterior se distingue con claridad de una mejora ya observada.
Conservar los trimestres o trabajar con años
La pregunta sobre muestreo puede formularse sin inventar observaciones más frecuentes que las disponibles, comparando los trimestres con una representación anual construida a partir de ellos. Esa operación reduce la resolución temporal. No se realiza un muestreo aleatorio de hogares ni se interpola una serie mensual inexistente.
El objetivo anual se define como el promedio aritmético de los cuatro niveles trimestrales
Como cada nivel ya es una tasa anual desestacionalizada, el promedio conserva esa escala y resume la actividad de los cuatro trimestres. Es un agregado que el ejercicio construye a partir del propio archivo, sin recurrir a una segunda serie anual oficial recuperada de otra fuente.
La distinción puede comprobarse en 2008, cuyas cuatro cifras son 9349,6, 9351,0, 9267,7 y 9195,3, con un promedio de 9290,9. Tomar solo el cuarto trimestre produciría 9195,3, una cantidad inferior en 95,6. Las dos son medidas legítimas de cosas diferentes, una del año completo y otra de su último tramo.
El archivo contiene cincuenta años completos, desde 1959 hasta 2008. El año siguiente, con solo tres trimestres, queda excluido de esta parte del ejercicio, porque promediar esos tres valores y llamarlos promedio anual introduciría un objetivo distinto justo al final de la comparación.
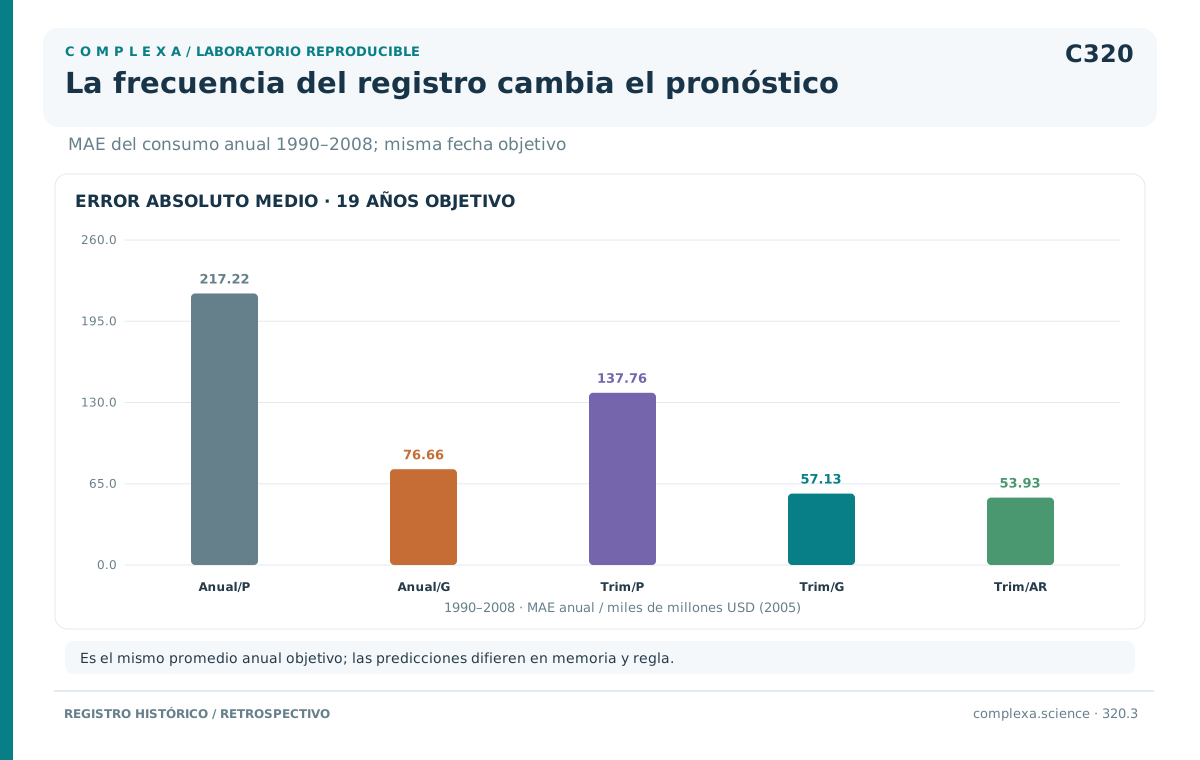
Los pronósticos anuales se emiten desde el cuarto trimestre del año anterior para diecinueve objetivos, desde 1990 hasta 2008. Con los datos agregados se utilizan dos reglas, una que conserva el promedio del año anterior y otra que lo aumenta según el crecimiento logarítmico medio de los promedios anuales anteriores.
Con los datos trimestrales se generan cuatro niveles futuros desde el mismo origen y después se promedian. Se repiten las tres reglas ya descritas. La autorregresión conserva la ventana seleccionada durante el desarrollo trimestral, que no se vuelve a escoger para favorecer su resultado anual.
Los cinco procedimientos apuntan así al mismo promedio anual y disponen de datos hasta el final del año anterior, aunque algunos reciben únicamente su representación agregada. En ningún caso se compara el error de un promedio con el de un trimestre suelto.
| Información y regla para el promedio anual | MAE | RMSE |
|---|---|---|
| Anual, persistencia | 217,22 | 237,34 |
| Anual, crecimiento histórico | 76,66 | 112,06 |
| Trimestral, persistencia | 137,76 | 148,61 |
| Trimestral, crecimiento histórico | 57,13 | 82,77 |
| Trimestral, autorregresión del crecimiento | 53,93 | 78,68 |
La persistencia trimestral toma el último nivel del cuarto trimestre y lo repite cuatro veces, con lo que su promedio pronosticado coincide con ese último nivel. La persistencia anual, por su parte, utiliza el promedio de los cuatro trimestres anteriores. La diferencia entre ambas explica ya parte del resultado, porque cuando existe crecimiento dentro del año su último trimestre contiene información reciente que el promedio anterior atenúa.
La agregación transforma también la dependencia temporal. Como un promedio anual mezcla niveles que respondieron a distintos cambios trimestrales, un modelo sencillo ajustado a esos promedios puede tener una estructura distinta de la de otro ajustado antes de agregarlos. Marcellino (1999) examina consecuencias de la agregación temporal sobre la especificación y la interpretación de modelos de series.
En esta comparación concreta, conservar los trimestres reduce el error de las reglas consideradas. La tabla combina, sin embargo, información disponible y forma del modelo, puesto que el crecimiento anual medio difiere algebraicamente de promediar cuatro pasos del modelo trimestral. El resultado identifica cuál de estos procedimientos funcionó mejor para este objetivo y estos años, sin estimar un efecto universal de aumentar la frecuencia.
La ventaja tampoco procede de recibir datos antes, puesto que se ha supuesto que el trimestre de cierre ya está disponible al emitir cada pronóstico. Un servicio que publicara el promedio anual con mayor retraso tendría otro calendario informativo. Aquí se aísla la representación de la historia dentro de la instantánea, con el mismo punto de corte temporal.
Revisar el año difícil y conservar las cuentas
Para el objetivo anual de 2008, la persistencia anual habría pronosticado el promedio de 2007, que era 9313,95. Como el valor construido con los cuatro trimestres de 2008 es 9290,9, el error absoluto de esa regla es de solo 23,05. La persistencia trimestral, que parte del último nivel de 2007, igual a 9363,6, se excede en 72,7.
La autorregresión trimestral pronostica un promedio de 9553,59 y se excede en 262,69, en tanto que las dos reglas de crecimiento histórico quedan todavía más lejos, la trimestral con 9570,60 y la anual con 9645,62. El procedimiento que gana en promedio durante los diecinueve años pierde, por tanto, ante la persistencia anual en este objetivo concreto.
El promedio anual suaviza parte del recorrido descendente de 2008, porque incluye también sus dos primeros trimestres, con niveles más altos. Esa propiedad explica por qué mirar únicamente el último trimestre daría otra impresión del error, de ahí que la evaluación deba conservar el agregado que la decisión necesitaba pronosticar desde el comienzo.
Para la reproducción se adjuntan el CSV observado, la descripción de procedencia y un programa que calcula los modelos con la biblioteca estándar de Python. Antes de operar, el programa verifica la huella del archivo, comprueba que los trimestres sean consecutivos y rechaza cualquier copia distinta de la utilizada aquí.
La salida conserva cada origen y cada objetivo junto con el pronóstico y el error, además de los coeficientes y el número de pares empleados cuando se trata de la autorregresión. Las predicciones de desarrollo, las trimestrales de evaluación y las de promedios anuales quedan en archivos separados, de manera que cualquier celda de una tabla puede reconstruirse sin volver a elegir modelos.
El cálculo de un pronóstico recibe solamente el prefijo de la serie hasta su origen y las observaciones posteriores se incorporan al puntuar el resultado. Las comprobaciones numéricas contrastan el ajuste centrado de mínimos cuadrados con sus ecuaciones normales y verifican que multiplicar los cambios previstos coincida con exponenciar su suma logarítmica.
Una comprobación separada rehace las trayectorias autorregresivas mediante la suma de una progresión geométrica, sin utilizar la recursión del programa. Ambas formas coinciden al redondear las tablas. Los promedios anuales se reconstruyen también a partir de sus cuatro componentes.
El producto empírico queda así acotado a pronósticos puntuales y errores sobre una instantánea histórica. Evaluar intervalos predictivos requeriría construirlos en cada origen y comprobar su cobertura posterior, mientras que para reconstruir una operación en tiempo real harían falta las sucesivas publicaciones.
Las cuentas se cierran con el último objetivo trimestral. Desde el segundo trimestre de 2009, cuyo consumo es 9189,0, la persistencia pronostica ese mismo nivel, el crecimiento histórico produce 9266,27 y la autorregresión, 9236,66. El tercer trimestre observado llega a 9256,0, con errores de 67,00, menos 10,27 y 19,34, respectivamente. En esa última fila, la regla de crecimiento histórico queda más cerca que la autorregresión, aunque esta conserve el menor error absoluto medio de las setenta y nueve filas.
Referencias
Croushore, D., & Stark, T. (2001). A real-time data set for macroeconomists. Journal of Econometrics, 105(1), 111–130. https://doi.org/10.1016/S0304-4076(01)00072-0
Diebold, F. X., & Mariano, R. S. (1995). Comparing predictive accuracy. Journal of Business & Economic Statistics, 13(3), 253–263. https://doi.org/10.1080/07350015.1995.10524599
Hall, R. E. (1978). Stochastic implications of the life cycle–permanent income hypothesis: Theory and evidence. Journal of Political Economy, 86(6), 971–987. https://doi.org/10.1086/260724
Hyndman, R. J., & Koehler, A. B. (2006). Another look at measures of forecast accuracy. International Journal of Forecasting, 22(4), 679–688. https://doi.org/10.1016/j.ijforecast.2006.03.001
Marcellino, M. (1999). Some consequences of temporal aggregation in empirical analysis. Journal of Business & Economic Statistics, 17(1), 129–136. https://doi.org/10.1080/07350015.1999.10524802
statsmodels developers. (s. f.). United States Macroeconomic data [Conjunto de datos y documentación]. Recuperado el 25 de octubre de 2026 de https://www.statsmodels.org/stable/datasets/generated/macrodata.html