Un taller necesita preparar materiales con dos días de antelación, de manera que al cerrar el día treinta debe estimar la demanda del día treinta y dos. Los registros confirmados de demanda llegan con un día de retraso, por lo que el último valor utilizable en ese momento es el del día veintinueve. Meses después, el archivo descargado contiene todas las fechas, incluidas las que faltaban cuando hubo que tomar la decisión. Si se entrega ese archivo completo al modelo y después se ocultan algunas respuestas, es fácil reconstruir una tarea más sencilla que la que enfrentaba el taller.
La evaluación temporal comienza por reproducir la situación de quien predice. Eso exige fijar cuándo emite el pronóstico, para qué fecha o intervalo, qué datos posee y qué actualizaciones puede realizar. Una columna de fechas informa a qué día se refiere cada dato, pero deja sin indicar la fecha de su publicación, que en un dato referido al pasado puede ser posterior a la predicción.
El taller es un ejemplo didáctico, sin datos de una organización real, elegido porque en él las restricciones de disponibilidad pueden seguirse hasta sus consecuencias numéricas. Con la demora de un día, un pronóstico emitido a dos días del objetivo se apoya en una observación situada tres días antes de ese objetivo, una separación adicional que afecta a la referencia más simple tanto como a un modelo elaborado.
Dos fechas para cada observación
Sea la información efectivamente disponible al emitir una predicción en el origen . Para un horizonte , el pronóstico debe poder calcularse con esa información. En el subíndice, lo que precede a la barra identifica la fecha que se pretende anticipar y lo que la sigue identifica el origen de emisión, de modo que la notación distingue dos pronósticos de la misma observación emitidos con anticipaciones diferentes.
En el taller, el valor se confirma al cierre de , por lo que al cierre de están disponibles los valores hasta . La demora forma parte del problema. Si una evaluación retrospectiva reemplaza ese último dato por , concede al modelo una ventaja que el sistema operativo no tenía.
También puede haber revisiones, cuando una cantidad publicada inicialmente se corrige al recibir registros pendientes. En ese caso hace falta conservar, además de la fecha a la que se refiere cada dato, la versión disponible en cada origen. Croushore y Stark (2001) desarrollaron un conjunto de datos macroeconómicos organizado en esas versiones históricas, llamadas vintages, con el propósito de que los análisis respetasen la información de cada momento.
Otra decisión concierne a la versión que se toma como respuesta de evaluación. Puede quererse anticipar el primer dato publicado o una estimación revisada posterior, dos tareas posibles cuyos errores tienen significados distintos. Medir con una respuesta final un pronóstico emitido antes puede ser coherente si ese era el objetivo declarado. Introducir esa misma respuesta final entre los predictores históricos, en cambio, alteraría la información concedida al modelo.
El archivo de una predicción debería conservar el origen de emisión, la fecha objetivo y la versión de los datos utilizada. Quien solo dispone del archivo final hace una evaluación retrospectiva con esa versión, cuyo resultado puede apartarse de lo que habría sido posible pronosticar en tiempo real incluso cuando la regla de ajuste respeta perfectamente el orden de las filas.
Parte de la información sobre el futuro sí se conoce por adelantado. El día de la semana o una parada programada antes del origen pueden utilizarse para una fecha posterior. Lo que decide su admisibilidad es el momento en que se conocían, así que una promoción decidida el día veintiséis para el día treinta y dos pertenece a la información del origen treinta y otra decidida después queda fuera de ella, aunque ambas aparezcan hoy en el calendario definitivo.
Mover el origen conserva la tarea
Una evaluación de origen fijo ajusta el modelo en un momento y examina sus predicciones posteriores. Si el modelo emite simultáneamente pronósticos para los próximos doce meses, cada uno de los doce errores corresponde a un horizonte distinto y solo el primero mide una predicción a un mes. Lo que se evalúa incluye, por tanto, la distancia al origen y la posibilidad de actualizar el modelo.
Una evaluación de origen móvil repite la tarea en fechas sucesivas. Se fija un horizonte, se ajusta o actualiza el procedimiento con los datos disponibles en el primer origen y se guarda su predicción. Luego se avanza el calendario, se incorporan los datos que hayan llegado y se emite otra predicción con el mismo horizonte. Tashman (2000) analiza esta forma de evaluación junto con la recalibración y el uso de varios períodos de prueba.
Si la ventana de entrenamiento crece con cada origen, conserva toda la historia disponible y el número de observaciones aumenta gradualmente. Una ventana de longitud fija, en cambio, descarta los registros más antiguos al incorporar otros nuevos y puede responder mejor a relaciones que cambian, a costa de estimar con menos información. La longitud elegida forma parte del procedimiento predictivo y debe evaluarse con las mismas restricciones que el resto.
Actualizar un estado y reestimar parámetros son operaciones diferentes. Un filtro puede incorporar diariamente una observación sin volver a estimar todos sus coeficientes, mientras otro sistema puede reajustarse una vez al mes. Una evaluación que recalibra cada día un modelo destinado a desplegarse con coeficientes mensuales mide un procedimiento distinto, de ahí que convenga reproducir también los días en que el sistema permanece sin actualizar.
El primer origen fija cuánto entrenamiento inicial se admite. Empezar muy pronto da más errores de evaluación, pero puede incluir una fase en la que el ajuste todavía es inestable. Empezar muy tarde acorta esa fase a cambio de dejar menos situaciones por evaluar. La decisión debería seguir el uso previsto, según el cual el rendimiento al arrancar con pocos datos puede interesar por sí mismo o quedar fuera de la evaluación cuando la aplicación dispone de una historia amplia.
Los orígenes no tienen que avanzar de uno en uno. Si el taller realiza pedidos cada lunes, una evaluación diaria incluye decisiones que nunca tomará, mientras que tomar los lunes como orígenes conserva la cadencia operativa y la relación con los fines de semana. Para generalizar a todas las fechas habría que cubrirlas expresamente y justificar sus pesos.
Respetar el calendario operativo es lo que exige esta tarea, aunque la validación cruzada aleatoria puede ser matemáticamente válida en ciertas series. Bergmeir, Hyndman y Koo (2018) estudian esa validez en problemas autorregresivos bajo supuestos específicos. Su argumento teórico incluye estacionariedad y ergodicidad, estimación consistente y condiciones sobre los errores más exigentes que una autocorrelación muestral pequeña. Aun cuando esos supuestos se cumplan, el resultado deja sin reproducir la secuencia histórica de decisiones y las entradas que aún no se habían publicado siguen siendo inadmisibles.
Las comparaciones empíricas también dependen del contexto. En un estudio de predicción univariante a un paso, Cerqueira, Torgo y Mozetič (2020) encontraron diferencias entre métodos de estimación del rendimiento según la estacionariedad de las series, con resultados favorables a las evaluaciones repetidas sobre tramos posteriores en las series no estacionarias analizadas. El problema operativo planteado aquí mantiene el orden porque busca reconstruir decisiones sucesivas bajo información cambiante.
La frontera temporal atraviesa todo el ajuste
La separación cronológica entre entrenamiento y evaluación es insuficiente si otras operaciones que también se estiman con datos, como una media para estandarizar, una selección de variables o una descomposición estacional, ya han utilizado la serie completa. En ese caso, parte de la información del período posterior entra en el modelo antes de que aparezca su primera ecuación predictiva.
En cada origen, los parámetros de transformación que deban aprenderse se calculan con el conjunto de entrenamiento disponible y después se aplican a las entradas de predicción sin reajustarlos con las respuestas futuras. Una transformación determinista fijada de antemano, como expresar una cantidad en otra unidad, no requiere ese aprendizaje, pues ninguna de sus decisiones depende de los datos.
El suavizado ilustra una fuga menos evidente. Una media centrada en una fecha utiliza valores anteriores y posteriores. Si se calcula sobre toda la serie y después se corta el resultado, las últimas observaciones del entrenamiento contienen información procedente del período de evaluación. Una media que solo utiliza valores anteriores puede ser admisible, siempre que todos ellos estuvieran publicados. Hewamalage, Ackermann y Bergmeir (2023) examinan las fugas de información que producen operaciones como el suavizado, la normalización y la descomposición.
Con la imputación sucede algo parecido. Un registro ausente puede reconstruirse retrospectivamente interpolándolo con el dato posterior, pero un pronóstico emitido antes de que llegase ese dato necesita otra regla, como una imputación basada en el pasado o un modelo que represente explícitamente la ausencia. Al evaluar, la decisión sobre cómo tratar el hueco debe tomarse en el origen correspondiente.
Una variable meteorológica da un ejemplo cuantificable. Supongamos que la demanda de una fecha futura sigue , donde es una condición ambiental y tiene media cero y varianza uno. En el origen de emisión solo se dispone de un pronóstico de esa condición, cuyo error se supone de media cero, varianza cuatro e independiente de . El pronóstico de demanda que sustituye por su pronóstico tiene entonces error cuadrático esperado
Si la evaluación introduce el valor ambiental observado posteriormente, el error cuadrático esperado se reduce a uno. Toda la diferencia procede de la información adicional, ya que la ecuación de demanda es la misma en ambos casos. Reproducir la tarea operativa exige los pronósticos ambientales que estaban disponibles en cada origen, con sus fechas de emisión, o bien un procedimiento histórico válido que los genere.
El resultado con información ambiental perfecta puede calcularse también como experimento separado, que en el ejemplo propuesto cuantifica la parte del error debida a desconocer la entrada futura. La comparación debe presentarlo como un escenario de información adicional, para que no se interprete como rendimiento alcanzable por el sistema que solo recibe pronósticos.
En modelos entrenados conjuntamente con varias series, la frontera debe aplicarse a todas ellas. Una sucursal puede tener registros más completos que otra o cerrar antes su jornada. Un modelo global puede usar esos registros si ya eran accesibles al emitir la predicción, mientras que las observaciones posteriores de otra serie pueden introducir información sobre un episodio compartido. Por eso, partir cada serie por su número de fila puede producir cortes informativos distintos entre ellas.
La respuesta de entrenamiento también tarda en conocerse
Un modelo directo aprende a predecir desde cada origen histórico . En el taller esa respuesta se confirma al cierre de , así que al entrenar en el origen treinta solo pueden incorporarse filas de aprendizaje con , es decir, con origen histórico hasta el día veintisiete.
Los predictores de cada fila deben representar lo que se conocía en su origen histórico. Si la fila del día veintisiete incluye como predictor el último dato confirmado, ese predictor es el del día veintiséis. Su respuesta, en cambio, corresponde al día veintinueve y se confirma el treinta. Una columna simula así la información de entrada y la otra contiene un resultado que ya puede emplearse para aprender.
Si el objetivo fuese la demanda acumulada de los tres días siguientes, la respuesta de la fila sería . Como su último componente se confirma en , el entrenamiento disponible el día treinta terminaría en la fila de origen veintiséis. En ambos casos, la separación necesaria entre los orígenes de entrenamiento y evaluación procede del horizonte y de la demora de publicación.
Esta construcción aclara por qué puede ser necesario un espacio vacío entre conjuntos y cómo se determina su longitud, que se obtiene al excluir las filas cuyas respuestas todavía no están disponibles y al respetar cualquier otra dependencia informativa de sus atributos. Un hueco de longitud arbitraria deja intacta la fuga que producen una estandarización calculada con toda la serie o una entrada futura ya incorporada.
Las ventanas pueden compartir observaciones pasadas sin que haya fuga. Dos pronósticos consecutivos pueden utilizar muchos de los mismos retardos porque ese pasado está disponible para ambos. El criterio es si la función en que entra cada observación habría podido calcularse en el origen declarado. Exigir que todas las ventanas sean disjuntas cambia innecesariamente muchas tareas operativas y reduce la información utilizable.
Las predicciones iteradas requieren un cuidado adicional. Un modelo ajustado para el siguiente paso puede aplicarse recursivamente, de forma que su primera predicción se usa como entrada para calcular la segunda. Si durante la evaluación esa primera predicción se sustituye por el valor observado después, la tarea pasa a ser una predicción actualizada desde otro origen, con un error que ya no corresponde al horizonte original.
En un pronóstico vectorial emitido una sola vez, todos los pasos se calculan con la información de ese origen. Si el sistema va a recibir observaciones intermedias y a revisar sus predicciones, las versiones revisadas deben guardarse por separado para evaluar cuánto añade la actualización y qué rendimiento tenía el pronóstico inicial cuando todavía faltaban esos datos.
Seleccionar dentro de cada pasado disponible
Elegir el número de retardos, la fuerza de regularización o la longitud de la ventana a partir de los errores de evaluación adapta el procedimiento a esos mismos errores. Aunque cada ajuste individual haya usado solamente datos anteriores, la elección final puede contener información de todo el período examinado, de modo que puede haber fuga en el proceso de selección sin que ninguna regresión la tenga.
Cawley y Talbot (2010) muestran que el criterio utilizado para seleccionar modelos también puede sobreajustarse y producir sesgo en la evaluación posterior. En una tarea temporal, una forma de separar ambas funciones es comparar las configuraciones en orígenes internos, anteriores al origen externo que se desea evaluar. La configuración elegida se reajusta después con los datos disponibles en el origen externo y se guarda su pronóstico.
Supongamos que el origen externo es el día treinta y que se comparan ventanas de siete y catorce días para predecir a dos días. Como las respuestas de validación interna deben estar confirmadas al cerrar el treinta, la demora establecida hace del veintisiete el último origen interno admisible, cuyo objetivo, el día veintinueve, se confirma el treinta.
El pronóstico interno del veintisiete, a su vez, solo se reproduce honestamente si sus filas de entrenamiento tienen respuestas disponibles en esa fecha. En el modelo directo a dos días, la última fila admisible tiene origen veinticuatro, porque su respuesta se confirma el veintisiete. Dentro de la frontera externa aparece así una segunda frontera, desplazada hacia atrás. Cada candidato recorre los mismos orígenes internos y respeta esa disponibilidad en sus ajustes y transformaciones.
Una vez elegida la ventana, el ajuste final del origen treinta puede utilizar todas las filas entonces admisibles, hasta el origen veintisiete. La predicción para el día treinta y dos se almacena y su error se calcula cuando llega la respuesta, el día treinta y tres, sin intervenir en la elección que produjo el pronóstico.
Si la regla de actualización se fijó previamente, el paso al siguiente origen externo puede incorporar los resultados ya confirmados de predicciones anteriores y reproduce así un procedimiento adaptativo válido. El error guardado de cada predicción anterior sigue correspondiendo a la decisión que efectivamente la produjo. Modificar retrospectivamente esa predicción para reflejar la configuración elegida después borraría el aprendizaje real del procedimiento.
La validación anidada evalúa el conjunto formado por selección y ajuste, con sus costes y su variabilidad. Cuando la aplicación va a elegir una configuración una sola vez y a mantenerla durante meses, puede ser más adecuado reservar un tramo para esa selección y otro posterior para evaluar la configuración congelada. Cada estrategia corresponde a un procedimiento distinto y el diseño debe expresar cuál se pretende desplegar.
Ocho pronósticos que pueden reconstruirse
Para un cálculo completo tomaremos como demanda de los días uno a diecisiete la secuencia artificial
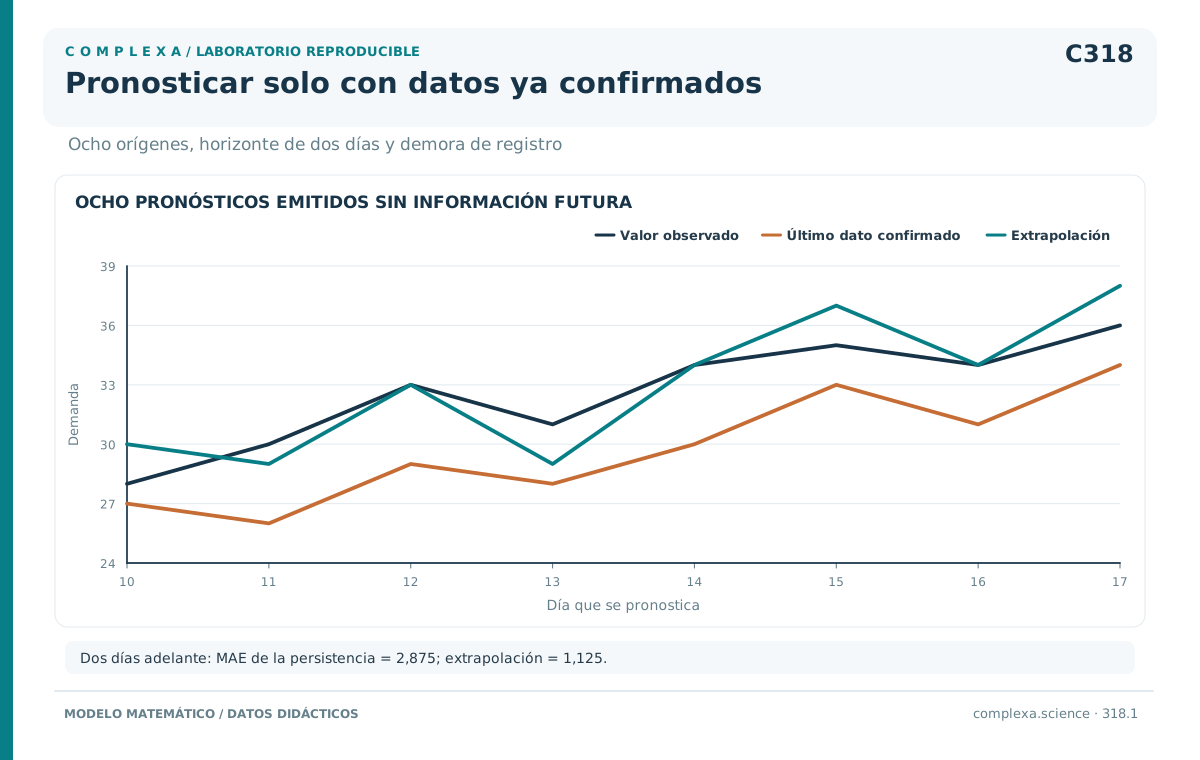
Se mantiene la demora de confirmación de un día y se supone que no hay revisiones posteriores. Evaluaremos ocho orígenes consecutivos, desde el día ocho hasta el quince, siempre para el valor situado dos días después de la emisión. Las dos reglas comparadas quedan fijadas antes del primer origen de este ejercicio, de manera que estos ocho resultados no intervienen en su selección.
La regla A mantiene el último valor confirmado, . La regla B extrapola la pendiente calculada entre los extremos de las cuatro observaciones confirmadas más recientes, y , que están separados por tres días. Como desde el último dato hasta el objetivo faltan otros tres días,
En el origen ocho, el último dato confirmado es el del día siete, igual a veintisiete. El otro extremo de la pendiente, el valor del día cuatro, es veinticuatro, de modo que la regla B calcula una pendiente diaria igual a uno y pronostica treinta para el día diez. La regla A pronostica veintisiete. Al cierre del once se confirma que el valor del día diez fue veintiocho.
La tabla siguiente conserva el origen y el objetivo, para que la comparación no dependa de una alineación implícita.
| Origen de emisión | Día objetivo | Valor observado | Predicción A | Predicción B |
|---|---|---|---|---|
| 8 | 10 | 28 | 27 | 30 |
| 9 | 11 | 30 | 26 | 29 |
| 10 | 12 | 33 | 29 | 33 |
| 11 | 13 | 31 | 28 | 29 |
| 12 | 14 | 34 | 30 | 34 |
| 13 | 15 | 35 | 33 | 37 |
| 14 | 16 | 34 | 31 | 34 |
| 15 | 17 | 36 | 34 | 38 |
Con el error definido como observado menos pronosticado, los ocho errores de A son y los de B son . Los errores absolutos medios valen y , respectivamente. Las raíces de los errores cuadráticos medios son aproximadamente y .
En este tramo artificial creciente la extrapolación obtiene errores menores, aunque se excede en varios objetivos. La comparación muestra cuánto ganó y dónde falló. Ocho predicciones de una secuencia construida son, sin embargo, demasiado pocas para hablar de una ventaja general del método. En un tramo donde el nivel dejase de crecer, la persistencia podría ser más competitiva.
La tabla completa solo puede puntuarse al cierre del día dieciocho, cuando se confirma el último objetivo. Hasta entonces hay pronósticos ya emitidos que siguen pendientes de evaluación. Un indicador de rendimiento que se actualiza diariamente debe conservar también esa diferencia entre predicciones almacenadas y respuestas confirmadas.
En este ejercicio la demora es fija. Si en una aplicación los días de mayor actividad tardan más en confirmarse, un promedio calculado solo sobre resultados ya cerrados puede sobrerrepresentar los días tranquilos. Una solución operativa consiste en definir para cada cohorte de pronósticos una fecha de evaluación suficientemente posterior y registrar cuántas respuestas siguen pendientes, cuyas pérdidas pueden completarse cuando lleguen sin alterar los valores pronosticados. Mientras se distinga entre actualizar una evaluación y reescribir una predicción, la llegada necesaria de datos futuros no se confundirá con una fuga en el entrenamiento.
La medida debe conservar horizonte y referencia
El error absoluto medio expresa la distancia típica en unidades de demanda. El error cuadrático da más peso a las desviaciones grandes y su raíz vuelve a las unidades originales. La elección entre ellos puede cambiar qué comportamiento se prefiere. Cuando una falta de material cuesta más que un excedente del mismo tamaño, una pérdida asimétrica puede representar la decisión mejor que cualquiera de esas medidas simétricas.
Antes de resumir varios horizontes es preferible mostrar sus resultados por separado, porque una mejora a un día puede convivir con un deterioro a una semana. El promedio conjunto depende de cuántos pronósticos haya de cada horizonte y de los pesos asignados. Si el usuario toma decisiones principalmente a una semana, un indicador dominado por predicciones del día siguiente puede ocultar el rendimiento relevante.
Al final del archivo quedan menos objetivos confirmados para los horizontes largos. Si se promedian todas las filas disponibles, los horizontes cortos reciben más peso y pueden incluir además un período reciente diferente. Una opción es usar un conjunto común de orígenes y otra, presentar los resultados por horizonte con sus fechas y tamaños, según interese comparar anticipaciones bajo los mismos episodios o describir todo el historial operativo. Algo parecido ocurre cuando los candidatos exigen longitudes iniciales distintas, ya que compararlos en fechas diferentes mezcla su rendimiento con la dificultad de los períodos que llegaron a cubrir.
La variable evaluada debería corresponder a la decisión para la que se emitió el pronóstico, de modo que las predicciones destinadas a sumas o promedios temporales han de puntuarse respecto de esos objetivos. La suma de las pérdidas diarias generalmente difiere de la pérdida de la suma. Dos errores de signo opuesto, por ejemplo, pueden compensarse en la demanda semanal y seguir siendo costosos si obligaron a mover materiales entre jornadas.
Hyndman y Koehler (2006) proponen el error absoluto escalado medio, conocido como MASE, para comparar errores con independencia de las unidades originales. En su versión no estacional, el error absoluto se divide por la media de las diferencias absolutas consecutivas de un conjunto de entrenamiento. En este ejemplo fijaremos la escala con los siete valores confirmados al emitir el primer pronóstico, cuyas seis diferencias absolutas suman once, con lo que la escala es .
Con esa escala inicial fija, los MASE de A y B valen aproximadamente y . Aquí la unidad equivale al error de persistencia a un paso calculado sobre la historia inicial, que es distinto del error de la referencia operativa a dos días con retraso de publicación. Esta última comparación ya puede leerse directamente en la tabla, donde ambos métodos comparten orígenes, horizontes y datos permitidos.
La escala también podría actualizarse en cada origen mediante una regla especificada de antemano. El promedio de errores escalados ponderaría entonces las fechas de otra forma, porque una misma desviación tendría distinto denominador. En una misma fecha, los modelos comparados deben compartir el denominador. Una escala calculada con el tramo futuro introduciría información adicional en la medida y dificultaría su interpretación operativa.
Los porcentajes de error pueden ser poco informativos cuando la demanda vale cero o está cerca de cero, situación en la que un denominador pequeño domina el resumen aunque la diferencia en unidades sea modesta. La escala propuesta también necesita atención si toda la historia inicial es constante, ya que su denominador sería cero. Conviene escoger una medida que esté definida para el tipo de serie observado y explicar qué tamaño de error representa.
Las referencias simples deben atravesar el mismo calendario que los modelos candidatos. Mantener el último dato disponible, repetir un patrón estacional conocido o utilizar una media histórica son comparaciones distintas, cuya pertinencia depende del problema. Cualquiera de ellas queda alterada si se dan a la referencia registros más antiguos que los concedidos al candidato o si se excluyen de un método las fechas donde falló.
Cuando un procedimiento no logra producir un pronóstico, el informe debe conservar ese resultado operativo, ya que eliminar la fecha sin dejar constancia puede mejorar su error aparente. Una alternativa es definir una regla de respaldo antes de evaluar, puntuar el pronóstico que habría llegado al usuario y registrar por separado cuántas veces se activó. La comparación abarca entonces el servicio completo que realmente puede prestarse.
Por qué ocho errores no equivalen a ocho experimentos independientes
El avance del origen reutiliza parte de la información y puede producir errores dependientes. Para aislar el efecto del horizonte, consideremos ahora un proceso distinto cuyas observaciones están disponibles inmediatamente, el paseo aleatorio con incrementos independientes de media cero y varianza uno. Bajo pérdida cuadrática, su pronóstico óptimo a tres pasos mantiene el valor actual.
Su error es . El error del pronóstico emitido un día después comparte con este dos incrementos y el del emitido dos días después, uno. Por tanto, la varianza del error es tres y sus covarianzas a los retardos uno y dos son dos y uno, con autocorrelaciones de dos tercios y un tercio, aunque las perturbaciones elementales sean independientes y el pronóstico utilice la media condicional correcta.
Esta dependencia modifica la incertidumbre del error medio, cuya varianza exacta para cien orígenes consecutivos es
El error estándar es aproximadamente . Si los cien errores se trataran como independientes, se obtendría , un valor considerablemente menor. El promedio sigue siendo calculable, pero el intervalo que expresa su precisión tiene que recoger los términos de covarianza.
Para comparar dos métodos interesa la secuencia de diferencias de pérdida, definida en cada origen como , sobre la que Diebold y Mariano (1995) desarrollan pruebas de igualdad de precisión predictiva. La varianza de largo plazo de esa secuencia combina la varianza de cada diferencia con sus covarianzas temporales, que se perderían si cada origen se contara como una repetición independiente.
La dependencia exacta de las diferencias de pérdida puede diferir de la de los errores individuales, dado que parte de ella puede cancelarse al comparar dos pronósticos afectados por el mismo episodio. Por eso la estimación de incertidumbre debe dirigirse a la cantidad que se está contrastando. Bajo condiciones apropiadas de estacionariedad, memoria corta y estimación consistente de su varianza de largo plazo, puede construirse una referencia asintótica para la diferencia media.
Tomar automáticamente el horizonte menos uno como máximo retardo de esa varianza es correcto en el paseo aleatorio conocido, donde se identifica exactamente dónde termina el solapamiento. Con parámetros reestimados, otras dependencias o una regla de selección adaptativa, la estructura puede ser más extensa. Los modelos anidados y la incertidumbre de estimación también pueden requerir tratamientos específicos, requisitos que siguen vigentes cuando se usa la fórmula de comparación incluida en un programa.
Otra forma de estudiar la incertidumbre bajo supuestos adecuados es remuestrear bloques de diferencias de pérdida, que conservan parte de su dependencia local, si bien el resultado sigue sujeto a la longitud del bloque y a la estabilidad del período. Separar mucho los orígenes puede reducir determinados solapamientos, pero descarta decisiones y, cuando existen procesos persistentes, los errores pueden seguir siendo dependientes.
Guardar la decisión antes de conocer su resultado
En un resultado final debería poder identificarse qué predicciones contribuyeron al promedio. Para ello basta una tabla de evaluación que conserve origen, objetivo, horizonte, pronóstico, respuesta utilizada y fecha en que esta se confirmó. El procedimiento de selección, la política de actualización y las versiones de las entradas explican, por su parte, cómo se obtuvo cada fila.
Si el ajuste utiliza aleatoriedad, conservar su semilla ayuda a reproducir los pronósticos. También conviene identificar la versión del procedimiento para distinguir una actualización prevista de un cambio posterior en sus reglas.
Las pérdidas deben examinarse también en su evolución temporal. Un promedio sobre varios años puede combinar una etapa favorable con otra donde el modelo pierde precisión de manera sostenida. Separar períodos definidos por el calendario ayuda a reconocer esa variación. Si después se eligiera únicamente el período donde un método vence, el resumen se transformaría en otra decisión de selección que necesitaría evaluación adicional.
La información de los ocho pronósticos del taller está completa al cierre del día dieciocho, cuando el último valor confirmado es treinta y seis, correspondiente al día diecisiete. El extremo anterior de la regla B es el valor del día catorce, igual a treinta y cuatro. Si esa regla se utiliza para el siguiente pronóstico a dos días, la pendiente calculada es de dos tercios de unidad diaria y la predicción para el día veinte vale treinta y ocho.
Ese valor se registra al cierre del dieciocho junto con los datos que lo produjeron. Cuando el resultado del día veinte se confirme, al cierre del veintiuno, podrá añadirse un nuevo error a la evaluación sin tocar la predicción de treinta y ocho, emitida cuando todavía faltaban esos tres días de información observada.
Referencias
Bergmeir, C., Hyndman, R. J., y Koo, B. (2018). A note on the validity of cross-validation for evaluating autoregressive time series prediction. Computational Statistics & Data Analysis, 120, 70–83. https://doi.org/10.1016/j.csda.2017.11.003
Cawley, G. C., y Talbot, N. L. C. (2010). On over-fitting in model selection and subsequent selection bias in performance evaluation. Journal of Machine Learning Research, 11, 2079–2107. https://www.jmlr.org/papers/v11/cawley10a.html
Cerqueira, V., Torgo, L., y Mozetič, I. (2020). Evaluating time series forecasting models: An empirical study on performance estimation methods. Machine Learning, 109, 1997–2028. https://doi.org/10.1007/s10994-020-05910-7
Croushore, D., y Stark, T. (2001). A real-time data set for macroeconomists. Journal of Econometrics, 105(1), 111–130. https://doi.org/10.1016/S0304-4076(01)00072-0
Diebold, F. X., y Mariano, R. S. (1995). Comparing predictive accuracy. Journal of Business & Economic Statistics, 13(3), 253–263. https://doi.org/10.1080/07350015.1995.10524599
Hewamalage, H., Ackermann, K., y Bergmeir, C. (2023). Forecast evaluation for data scientists: Common pitfalls and best practices. Data Mining and Knowledge Discovery, 37(2), 788–832. https://doi.org/10.1007/s10618-022-00894-5
Hyndman, R. J., y Koehler, A. B. (2006). Another look at measures of forecast accuracy. International Journal of Forecasting, 22(4), 679–688. https://doi.org/10.1016/j.ijforecast.2006.03.001
Tashman, L. J. (2000). Out-of-sample tests of forecasting accuracy: An analysis and review. International Journal of Forecasting, 16(4), 437–450. https://doi.org/10.1016/S0169-2070(00)00065-0