Una serie contiene información sobre otra cuando conocer su pasado mejora un pronóstico que ya utilizaba la información disponible. Antes de comparar hay que fijar qué se intenta predecir, a qué distancia temporal y con qué otros registros. Sin esas precisiones, decir que una variable «anticipa» a otra puede referirse a resultados muy diferentes.
La causalidad de Granger convierte esa idea en una pregunta estadística que, en su formulación clásica, compara la precisión de predicciones que incluyen o excluyen la historia de una serie. Granger (1969) propuso definiciones operativas de causalidad y de retroalimentación con las que podían estudiarse relaciones temporales mediante modelos econométricos. Aunque la palabra causalidad forma parte del nombre del criterio, lo que el análisis entrega de inmediato es información predictiva.
Esa información puede examinarse con ejemplos cuyas ecuaciones generadoras conocemos. Uno de ellos muestra una mejora predictiva producida por un efecto directo y otro obtiene una mejora semejante a través de una causa común que el observador no registra. Son construcciones didácticas, elegidas para que sus errores de predicción puedan calcularse exactamente.
Qué información se retira de la comparación
Sea la información que contiene las historias de X, Y y un conjunto de variables adicionales Z hasta la fecha t. La información reducida conserva las historias de Y y Z, pero excluye la de X. Al pronosticar , la comparación pregunta si incorporar la historia de X cambia lo que puede aprenderse sobre esa observación futura.
Bajo pérdida cuadrática el mejor pronóstico es la esperanza condicional y se comparan los errores de predecir con y con . Como la información completa contiene a la reducida y el predictor completo siempre podría ignorar la información adicional, el error cuadrático medio óptimo no puede aumentar al disponer de ella. Esa propiedad corresponde a los predictores poblacionales óptimos y deja de estar asegurada para un algoritmo estimado con una muestra pequeña.
Cuando los predictores se restringen a combinaciones lineales del pasado se estudia la causalidad de Granger lineal, cuya representación habitual es un VAR. La conclusión se refiere entonces a la información que esas combinaciones son capaces de extraer. Si el mecanismo es no lineal, un resultado negativo puede reflejar los límites del predictor utilizado.
Una formulación más amplia compara distribuciones condicionales mediante la igualdad
Esta igualdad expresa que X no contiene información adicional sobre la distribución futura de Y en el horizonte considerado, una condición más exigente que la igualdad de medias. Una serie puede ayudar a anticipar la variabilidad de otra sin cambiar su valor medio esperado, por lo que conviene indicar si la prueba estudia predicción lineal, media condicional o distribución completa.
La elección del conjunto Z también forma parte de la pregunta. Una relación bivariada compara el pasado de Y con el pasado conjunto de X e Y, mientras que una relación condicional conserva además las variables Z en ambos lados. Al preguntar por aportaciones informativas diferentes, los dos análisis pueden dar resultados distintos. Añadir Z modifica la propia información de referencia con la que se evalúa X.
El horizonte h completa la definición. Una prueba a un paso usa la siguiente observación del registro, que según el calendario de muestreo puede llegar un segundo, una hora o un mes después. Cuando hay variables intermedias, una aportación predictiva puede aparecer al cabo de varios pasos sin existir en el primero, de modo que cualquier afirmación concreta de causalidad de Granger debe declarar la dirección, el conjunto informativo y el horizonte.
Una mejora predictiva que puede calcularse exactamente
Definamos el proceso
Las secuencias y son gaussianas, de media cero y varianza uno, independientes entre sí y entre fechas. Consideramos Y en su solución estacionaria. La serie X cambia de manera independiente en cada fecha, en tanto que Y conserva parte de su valor anterior y recibe una contribución del valor anterior de X.
Con las historias de ambas variables disponibles hasta t, el pronóstico de la siguiente Y es y su error se reduce a , de varianza uno. Si retiramos toda la historia de X y conservamos la de Y, el mejor pronóstico pasa a ser . El valor actual de X es independiente de todos los valores de Y observados hasta esa fecha y no puede reconstruirse a partir de ellos.
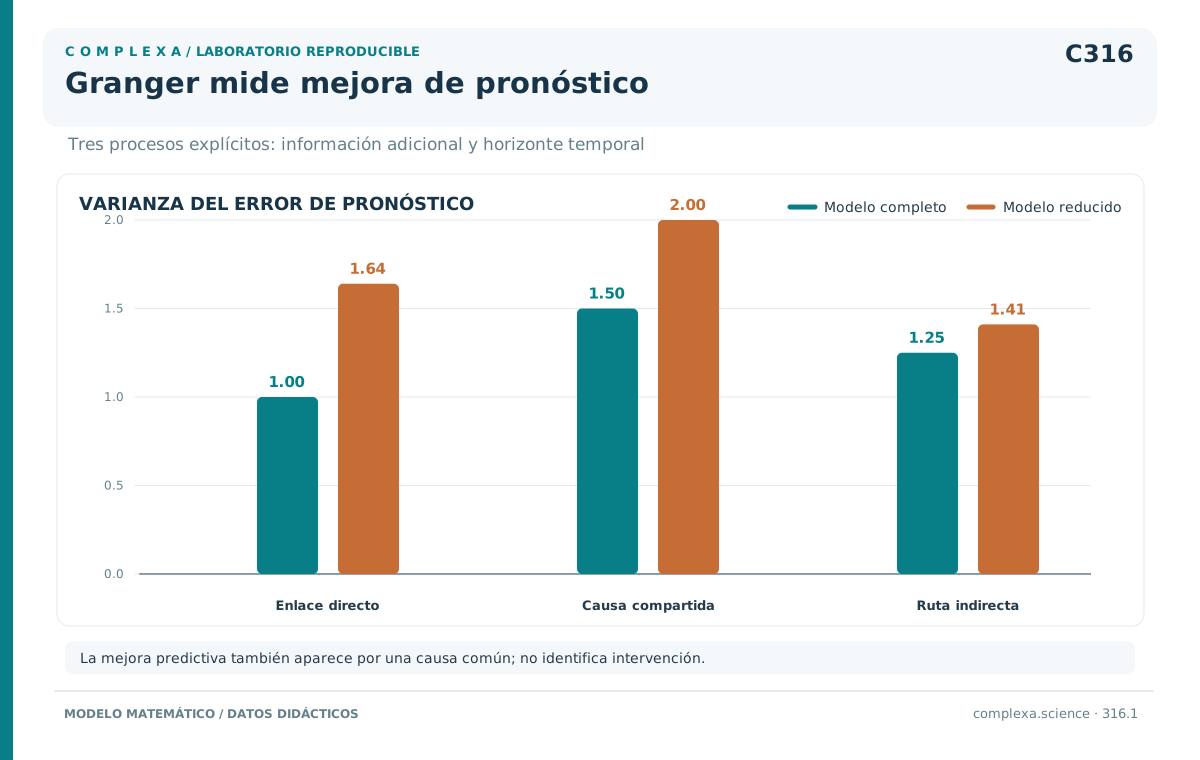
El error reducido es entonces . Como sus dos términos son independientes, su varianza vale . Incorporar X reduce el error cuadrático medio de 1,64 a uno, reducción que se deduce exactamente de la distribución definida, sin ajustar curva alguna a los datos.
Si en una fecha observamos X igual a 1,5 e Y igual a −0,4, el pronóstico completo es uno y el reducido es −0,2. Ambos usan la misma lectura actual de Y, de manera que la diferencia de 1,2 corresponde por entero a la información sobre X que la segunda comparación retira. La observación siguiente de Y puede, con todo, alejarse de los dos pronósticos, porque su innovación sigue siendo desconocida.
En la dirección inversa el resultado es otro. Como el valor siguiente de X es una innovación nueva e independiente, ninguna de las dos historias mejora su pronóstico de media cero. En este proceso hay, por tanto, información predictiva de X hacia Y y ninguna de Y hacia X, una asimetría que se obtiene al comparar dos problemas de predicción y que la correlación contemporánea entre las series no revela.
Una medida habitual expresa la mejora mediante el logaritmo del cociente entre las varianzas de error,
Geweke (1982) desarrolló esta forma de cuantificar relaciones entre series en sus medidas de dependencia lineal y retroalimentación. En nuestro ejemplo, con logaritmo natural, la medida vale , aproximadamente 0,495. La cifra es adimensional porque procede del cociente entre dos varianzas con las mismas unidades y cuantifica la reducción relativa del error de pronóstico, una magnitud distinta de la probabilidad de que X sea una causa y de un coeficiente de intervención.
Cambiar la unidad numérica de Y multiplica ambas varianzas por el mismo factor al cuadrado y deja intacto el cociente. El coeficiente que convierte una unidad de X en unidades de Y depende, en cambio, de sus escalas, de manera que la mejora predictiva relativa y el tamaño de una respuesta en unidades observables describen aspectos distintos del mismo modelo.
La medida tampoco conserva el signo de una contribución. Si sustituimos el coeficiente 0,8 por −0,8, la varianza reducida sigue siendo 1,64 y la completa sigue siendo uno. La medida de Granger queda idéntica aunque ahora un valor positivo de X desplace el pronóstico de Y en la dirección contraria, por lo que una flecha ponderada con ella es compatible tanto con una relación excitadora como con una inhibidora.
Con un coeficiente de 0,08, la varianza reducida sería 1,0064 y la medida bajaría aproximadamente a 0,00638. La aportación existe en la población, pero es pequeña frente a la innovación de Y. Una muestra suficientemente informativa podría distinguirla de cero sin que por ello dejara de ser una mejora de pronóstico modesta. La precisión de la prueba depende del tamaño de la muestra; la magnitud poblacional del ejemplo, del coeficiente y de las varianzas.
Una causa común llega antes a un registro
Construyamos ahora un proceso distinto del anterior, definido por
Las secuencias Z, a y b son gaussianas, independientes entre sí y entre fechas, cada una con media cero y varianza uno. La serie X da una lectura ruidosa del estado actual de Z, que la serie Y registra un período después acompañado de otra perturbación. En estas ecuaciones X no interviene en el mecanismo que genera Y.
Un observador que solo conserve X e Y encontrará, sin embargo, una relación predictiva. La historia de Y no contiene información sobre el nuevo , así que con ella el pronóstico de es cero y su error tiene varianza dos. Al añadir el observador dispone de una medida parcial de Z. La covarianza entre esa lectura y la futura Y vale uno y la varianza de X vale dos.
La esperanza condicional gaussiana da
El error de este pronóstico tiene varianza y la mejora corresponde a , aproximadamente 0,288. Con información suficiente, una prueba correctamente especificada puede detectar esa aportación de X. Ese hallazgo sería estadísticamente correcto, pues X contiene información sobre una perturbación que aparecerá después en Y.
Si el observador empieza a medir Z y lo incorpora al conjunto informativo, el pronóstico pasa a ser , con error de varianza uno. Añadir X ya no mejora nada. La parte de X que informaba sobre Z se conoce ahora directamente y el ruido a no afecta a Y. Al condicionar a la historia que incluye Z, la causalidad de Granger de X hacia Y desaparece.
Lo que se ha retirado es una ventaja informativa indirecta. La lectura de X era útil por estar disponible antes que la manifestación de Z en Y. Si se manipulara el canal X sin alterar Z ni el mecanismo que produce Y, la siguiente observación de Y conservaría su distribución.
Shojaie y Fox (2022) examinan cómo afectan a estas relaciones los factores omitidos y la elección del sistema observado. El ejemplo precisa el alcance de la limitación sin restar utilidad a la comparación bivariada. Para un pronosticador que no dispone de Z, la serie X sigue siendo un buen predictor. Quien busca decidir sobre qué componente intervenir necesita, en cambio, la información adicional contenida en las ecuaciones de generación, que las dos series observadas no recogen por sí solas.
Un paso y dos pasos pueden dar respuestas diferentes
La cadena siguiente, con un intermediario observado, está definida por
Las tres innovaciones son gaussianas independientes, con media cero y varianza uno. Como ninguna variable tiene persistencia propia, cada movimiento pasa de X a Z y de Z a Y antes de desaparecer. Con el vector ordenado como X, Z, Y, el sistema es un VAR de primer orden estable cuya matriz, elevada al cubo, es cero.
En la fecha t conocemos las historias de los tres componentes. El pronóstico de Y un paso adelante es entonces y la incorporación de X no lo modifica, porque el intermediario que alimenta la siguiente Y ya está observado. El error tiene varianza uno tanto con la información completa como con la que excluye X.
A dos pasos el intermediario necesario es , que todavía no se ha observado. Sustituyendo su ecuación obtenemos
Ahora X sí contiene información útil. El predictor completo es , con varianza de error 1,25. Si excluimos la historia de X y conservamos las de Z e Y, la nueva innovación no puede anticiparse, por lo que el pronóstico es cero y su error tiene varianza 1,41. La reducción de 0,16 se debe exclusivamente a la ampliación del horizonte.
| Horizonte de Y | Varianza de error sin X, conservando Z | Varianza de error con X y Z |
|---|---|---|
| Un paso | 1,00 | 1,00 |
| Dos pasos | 1,41 | 1,25 |
Dufour y Renault (1998) desarrollaron la distinción entre causalidad a distintos horizontes y mostraron el papel de las variables auxiliares. En nuestra cadena, la falta de contribución adicional de X a un paso y su presencia a dos pasos son coherentes entre sí, puesto que ambas reflejan el tiempo que tarda la información en atravesar el intermediario.
Excluir Z cambia también el significado de la prueba. Un modelo que observara solo X e Y encontraría, al sustituir las ecuaciones, una relación con dos retardos. La relación condicional a un paso responde a si X añade algo cuando ya conocemos el intermediario actual, mientras que el efecto total de modificar X y esperar a que cambie el intermediario corresponde a otra pregunta. Por esa razón, la ausencia de una arista en una red de Granger puede convivir con un efecto futuro.
La restricción que se contrasta en un VAR
Para una respuesta escalar Y y dos variables predictoras X y Z, escribamos una ecuación con p retardos,
La ausencia de aportación lineal de X a un paso corresponde a la hipótesis de que todos los coeficientes b son cero. Es una hipótesis conjunta sobre el bloque completo, que la significación de un retardo aislado deja sin contrastar. Por otra parte, varios coeficientes individualmente imprecisos pueden contener información conjunta si sus estimaciones están correlacionadas.
Para contrastarla se ajustan el modelo completo y un modelo reducido que impone la restricción, ambos con exactamente las mismas filas, la misma variable respuesta y los mismos términos restantes. Si al retirar X se recuperaran fechas que antes faltaban, la comparación directa de sumas de cuadrados mezclaría un cambio de modelo con un cambio de muestra.
Denotemos por y las sumas de cuadrados reducida y completa, por N el número de filas utilizables y por k el número de coeficientes del modelo completo. Un estadístico habitual es
El numerador mide cuánto aumenta el error al imponer las p restricciones y el denominador estima la escala residual del modelo completo. Cuando se comparan bloques de varias variables, el número de restricciones ocupa el lugar de p. La interpretación requiere además que el diseño tenga rango suficiente y que ambos ajustes correspondan a las hipótesis declaradas.
Como ejercicio numérico, supongamos que quedan 120 filas utilizables y que se incluyen dos retardos de cada una de las tres variables más una constante, con lo cual hay siete coeficientes por ecuación. Si las sumas de cuadrados son 150 para el modelo reducido y 120 para el completo, el estadístico vale 14,125. Con la referencia F de dos y ciento trece grados de libertad, el valor p es aproximadamente .
Las sumas de cuadrados son cifras ficticias, construidas para mostrar el cálculo. Con ellas la mejora relativa dentro de la muestra es del veinte por ciento y el logaritmo de su cociente es aproximadamente 0,223. El valor p pequeño cuantifica la incompatibilidad con la restricción bajo la calibración adoptada, una información de naturaleza distinta de la estimación de un efecto físico.
En modelos dinámicos la referencia F necesita justificación. Los regresores incluyen valores retardados de variables aleatorias y no satisfacen automáticamente las condiciones de una regresión con diseño fijo, de ahí que las pruebas VAR suelan apoyarse en aproximaciones asintóticas o en procedimientos de simulación apropiados. Incluso con innovaciones normales, una referencia finita cualquiera es en general aproximada. Barnett y Seth (2014) describen las distribuciones asintóticas que se usan en la inferencia de Granger y sus limitaciones en muestras pequeñas.
Retirar una serie puede cambiar la memoria necesaria
La comparación de varianzas poblacionales usa los mejores predictores compatibles con cada historia, algo que el ajuste de dos VAR del mismo orden no siempre reproduce con exactitud. Cuando se elimina una componente de un VAR finito, el proceso formado por las restantes puede necesitar una representación con medias móviles o una historia autorregresiva más larga. La información que transportaba la componente retirada sigue presente en la distribución marginal.
En el primer ejemplo la comparación era especialmente sencilla. Como X era una innovación independiente que la historia de Y no podía reconstruir, el predictor reducido de Y conservaba exactamente un solo retardo. Si X tuviera persistencia propia, los valores anteriores de Y podrían contener información parcial sobre su estado actual. El predictor reducido tendría que usar esa información antes de que toda la mejora restante pudiera atribuirse a la observación directa de X.
Barnett y Seth (2014) presentan una estrategia que calcula las magnitudes de Granger a partir de representaciones equivalentes del modelo completo, sin estimar explícitamente un segundo VAR reducido. La idea de fondo es que comparar historias exige representar correctamente la incertidumbre que queda al retirar una de ellas, ya que la diferencia entre dos ajustes mal especificados puede incluir errores de representación además de información predictiva.
Para la prueba de restricciones descrita antes, el alcance de esta dificultad depende de la hipótesis. Bajo la hipótesis nula y con un VAR completo correctamente especificado, los coeficientes de X son cero y la ecuación reducida conserva la estructura pertinente para Y. Bajo hipótesis alternativas, en cambio, el cociente entre los errores de dos ajustes finitos puede apartarse de la medida poblacional basada en historias completas, de modo que contrastar un bloque nulo y estimar con precisión la magnitud de la dependencia son tareas relacionadas que requieren comprobaciones distintas.
Las condiciones que sostienen la comparación
Una calibración convencional exige una estructura temporal adecuadamente representada. En un VAR estacionario y estable, con orden fijo correctamente especificado, momentos suficientes y condiciones regulares sobre las innovaciones y el diseño, pueden obtenerse distribuciones asintóticas para los estimadores y las restricciones. Con ellas puede separarse una variación muestral de una contribución predictiva persistente en la población definida por el modelo.
La autocorrelación residual puede indicar que el orden elegido dejó memoria sin representar. Si X contiene una parte de esa memoria, sus retardos pueden mejorar el ajuste aunque la comparación pretendida requiriera otro modelo para Y. Como aumentar el orden modifica la contribución adicional que se atribuye a X, el diagnóstico temporal del error forma parte de la justificación de la prueba, con procedimientos específicos que merecen un análisis propio.
La heterocedasticidad también afecta a la distribución de los estadísticos. Una covarianza robusta puede corregir, bajo sus propias hipótesis, determinados problemas de inferencia, pero deja sin resolver los retardos omitidos y una media condicional mal especificada. Si aparecen raíces unitarias o cointegración, la distribución usual de las pruebas puede cambiar y hace falta un tratamiento compatible con esa estructura, para cuya justificación es insuficiente declarar estacionario el registro después de mirarlo.
La existencia poblacional de información y su uso efectivo con datos limitados son cuestiones distintas. Incorporar muchos predictores reduce mecánicamente la suma de cuadrados del ajuste completo a costa de aumentar la incertidumbre de los coeficientes. Por eso un predictor estimado puede funcionar peor en fechas nuevas, si bien el predictor poblacional óptimo nunca pierde por disponer de más información.
Granger (1980) dio especial peso a la evaluación con datos posteriores al ajuste, que comprueba si la ventaja predictiva se mantiene cuando las observaciones objetivo ya no participaron en la estimación. Esa evaluación complementa la definición del conjunto informativo y, como ella, pertenece al terreno de la predicción, ajeno a la identificación de una intervención. En una comparación temporal, la selección de retardos y la elección de transformaciones también deben respetar el origen del pronóstico.
No rechazar la nulidad del bloque de coeficientes puede deberse a una contribución pequeña, a predictores redundantes, a escasa precisión o a una relación no lineal que la ecuación no representa. Informar la magnitud estimada y su incertidumbre ayuda a distinguir la evidencia de un efecto próximo a cero de una prueba incapaz de separar alternativas relevantes.
Un registro duplicado muestra la redundancia en su forma extrema. Supongamos que una columna Z copia exactamente los valores de X y que la siguiente Y depende de X como en el primer ejemplo. Con Z ya disponible, añadir X no mejora el pronóstico, pues toda la información está en la copia. Retirar conjuntamente X y Z sí eleva la varianza del error de uno a 1,64, de modo que la contribución del bloque completo difiere de la contribución adicional de cada columna cuando la otra permanece.
Una regresión que incluyera ambas columnas tendría un diseño de rango deficiente y no podría separar sus coeficientes. La igualdad informativa sigue bien definida, mientras que la prueba ordinaria basada en coeficientes necesita resolver antes la duplicación. Dos sensores casi idénticos dan una versión menos extrema del mismo problema, en la que la pequeña información exclusiva de cada uno puede estimarse con poca precisión aunque el conjunto sea útil para pronosticar.
Una relación que desaparece al buscar solo pendientes
Tomemos X como una secuencia de variables normales estándar independientes y definamos
con innovaciones epsilon independientes de varianza uno. Como valores de X de igual magnitud y signo opuesto producen la misma contribución a Y, el pronóstico condicionado a X tiene forma cuadrática y ninguna pendiente lineal describe su información.
La covarianza entre X y su cuadrado centrado es cero, al depender del tercer momento de una normal centrada, que se anula. Una regresión lineal de Y sobre X retardada tiene, por tanto, pendiente poblacional cero. La historia de Y tampoco ayuda. El nuevo X relevante es independiente de los que produjeron las observaciones anteriores.
Al incluir el cuadrado de X, sin embargo, la media se pronostica exactamente y la varianza del error pasa de 1,98 a uno, puesto que la varianza de es dos. Hay entonces una mejora predictiva clara que el contraste de pendientes lineales no detecta. El ejemplo delimita así el tipo de dependencia sobre el que informa la prueba lineal, que conserva su validez dentro de ese dominio.
La predicción de la media y la de la distribución pueden separarse todavía más. Si definimos , la media condicional sigue siendo cero para cualquier X y el pronóstico óptimo bajo error cuadrático no mejora al conocer X. Ese conocimiento sirve, con todo, para anticipar si la siguiente observación tendrá mayor o menor dispersión, ya que su varianza condicional es . La igualdad de distribuciones condicionales falla, por tanto, aunque las medias coincidan.
Las extensiones no lineales revisadas por Shojaie y Fox (2022) amplían las clases de relaciones que pueden estudiarse, si bien elegir una de ellas exige precisar qué se quiere predecir y disponer de información suficiente para estimar la relación. Con un método más flexible cambia la clase de dependencias detectables, pero la diferencia entre información predictiva y efecto de intervención permanece.
El registro y la cantidad de relaciones examinadas
La resolución temporal puede cambiar lo que se considera pasado y lo que aparece como simultáneo. Si una transmisión ocurre entre dos observaciones consecutivas, el registro puede situar su origen y su consecuencia en la misma fila, con lo cual una prueba que usa solo retardos la describirá de otra manera que un registro más frecuente. El primer trabajo de Granger (1969) ya discutía los problemas de la información registrada con lentitud y del conjunto de variables considerado.
La fecha escrita en una fila puede diferir, además, de la fecha en que la lectura estuvo disponible. Una medida corregida retrospectivamente puede contener información que el pronosticador no tenía. Para leer la comparación como una ventaja predictiva operativa, ambos conjuntos informativos deben recoger lo que podía conocerse en el origen elegido. Si se usa información futura, el análisis responde a otro problema, aunque las columnas conserven nombres de variables pasadas.
Las transformaciones del registro piden un examen parecido. Algunas transformaciones invertibles preservan la información poblacional disponible, pero una prueba basada en un VAR finito puede cambiar si el filtrado modifica el orden necesario para representar el proceso. Una operación que elimina información o mezcla fechas futuras requiere otro análisis. Barnett y Seth (2014) estudian condiciones de invariancia y problemas de representación que impiden resumir esta cuestión como una prohibición general de filtrar.
En registros de varias personas o dispositivos, unir el final de una trayectoria con el comienzo de otra crearía un retardo inexistente en el proceso observado. Las repeticiones pueden servir para estimar parámetros compartidos siempre que conserven sus límites y se justifique qué estructura se comparte. La relación temporal dentro de cada unidad y la asociación entre los promedios de las unidades son, por otra parte, magnitudes distintas.
Cuando se construye una red con muchas series crece también el número de comparaciones. Con veinte variables hay trescientas ochenta direcciones posibles entre pares distintos. Si todas las hipótesis fueran nulas y cada prueba tuviera realmente un nivel del cinco por ciento, el número esperado de rechazos falsos sería diecinueve, un cálculo de esperanza que vale también cuando las pruebas son dependientes.
La corrección por multiplicidad y los métodos de selección deben corresponder al conjunto de preguntas examinado. Elegir variables y retardos con las mismas observaciones y aplicar después una prueba que trata esa elección como fija modifica su interpretación. Las técnicas de regularización discutidas por Shojaie y Fox (2022) ayudan a estimar sistemas grandes, pero la selección de un coeficiente como distinto de cero deja pendientes tanto la validez de su valor p como su identificación causal.
Qué se necesita para hablar de una intervención
Una intervención requiere describir qué ecuación o mecanismo cambia y cuáles permanecen vigentes. Eichler y Didelez (2010) estudian precisamente la relación entre estructuras de Granger y efectos de intervenciones, con condiciones explícitas sobre el sistema y sobre la información observada. Su análisis distingue el comportamiento natural de las series del que muestran cuando una operación externa modifica una variable.
Las ecuaciones del primer ejemplo pueden interpretarse como un mecanismo estructural en el que se modifica X y se conserva la ecuación de Y. Sus innovaciones son independientes, no hay una causa común omitida en ese mecanismo y la medición recoge las variables y el intervalo relevantes. Bajo esas condiciones y con el estado anterior fijo, situar una unidad por encima de otro valor desplaza la media de en 0,8 unidades.
La diferencia persiste después en Y a través de su coeficiente propio. Si las X futuras vuelven a generarse con su regla original y se comparan las mismas perturbaciones, al sustituir la intervención en las ecuaciones se obtiene un efecto de 0,4 a dos pasos y de 0,2 a tres pasos. Aquí el resultado de Granger coincide con un efecto causal porque hemos especificado un mecanismo que sostiene esa lectura.
En un sistema observado, la misma lectura necesita justificar la suficiencia del conjunto de ajuste respecto de la intervención, la organización temporal y la conservación de los mecanismos que no se manipulan. Aunque no aparezca ninguna variable confusora evidente, puede haber simultaneidad sin resolver, mediciones mezcladas o cambios de régimen que alteren las ecuaciones durante la intervención.
Para estimar efectos a partir de datos observacionales es necesario también que las situaciones relevantes estén representadas. Si una combinación de historia y valor intervenido queda fuera del soporte observado, la distribución correspondiente no puede aprenderse directamente de los registros. Un modelo puede extrapolarla mediante restricciones, pero esa contribución debe distinguirse de la información suministrada por los datos.
La cadena con intermediario sirve para precisar qué efecto se busca. Condicionar a la Z actual, que ya contiene la transmisión pertinente, elimina la contribución adicional de X a la siguiente Y. Si se interviene ahora sobre X y se esperan dos pasos, la Z futura cambia y el efecto total sigue ese recorrido. Una comparación condicionada puede así describir adecuadamente la información adicional a corto plazo y responder solo en parte a una pregunta sobre efectos posteriores.
Dos mecanismos que los mismos registros no separan
Volvamos al proceso de causa común, con y . El par formado por X actual e Y siguiente es gaussiano, de media cero, con varianza dos en cada componente y covarianza uno. Los pares correspondientes a fechas diferentes se generan a partir de perturbaciones independientes.
Construyamos otra explicación mediante
donde xi tiene varianza dos, zeta tiene varianza 1,5 y ambas secuencias son gaussianas e independientes entre sí y entre fechas. La varianza de la siguiente Y es y su covarianza con X es , así que el par tiene exactamente la misma distribución que antes.
Como también coinciden las dependencias entre fechas, las historias observadas de X e Y tienen la misma distribución conjunta en ambas construcciones, con pronósticos condicionales iguales y una medida de Granger de aproximadamente 0,288. Más observaciones de esas dos series darían una estimación más precisa de esa distribución, pero dejarían los dos mecanismos tan indistinguibles como antes.
Las intervenciones declaradas sí los separan. En la construcción con causa común, la media de la Y siguiente es la misma si X actual se fija en dos o en cero, siempre que se mantengan la distribución de Z y la regla de Y. En la construcción con efecto directo, la misma sustitución cambia esa media en una unidad. En ambos registros naturales, observar X igual a dos lleva a pronosticar Y igual a uno, pero al fijar externamente ese valor la primera construcción conserva una media de cero y la segunda produce una media de uno.
Referencias
Barnett, L., y Seth, A. K. (2014). The MVGC multivariate Granger causality toolbox: A new approach to Granger-causal inference. Journal of Neuroscience Methods, 223, 50–68. https://doi.org/10.1016/j.jneumeth.2013.10.018
Dufour, J.-M., y Renault, É. (1998). Short run and long run causality in time series: Theory. Econometrica, 66(5), 1099–1125. https://doi.org/10.2307/2999631
Eichler, M., y Didelez, V. (2010). On Granger causality and the effect of interventions in time series. Lifetime Data Analysis, 16(1), 3–32. https://doi.org/10.1007/s10985-009-9143-3
Geweke, J. (1982). Measurement of linear dependence and feedback between multiple time series. Journal of the American Statistical Association, 77(378), 304–313. https://doi.org/10.1080/01621459.1982.10477803
Granger, C. W. J. (1969). Investigating causal relations by econometric models and cross-spectral methods. Econometrica, 37(3), 424–438. https://doi.org/10.2307/1912791
Granger, C. W. J. (1980). Testing for causality: A personal viewpoint. Journal of Economic Dynamics and Control, 2, 329–352. https://doi.org/10.1016/0165-1889(80)90069-X
Shojaie, A., y Fox, E. B. (2022). Granger causality: A review and recent advances. Annual Review of Statistics and Its Application, 9, 289–319. https://doi.org/10.1146/annurev-statistics-040120-010930