Dos registros que por separado son solo moderadamente predecibles pueden describirse con bastante más precisión cuando se estudian juntos. Es lo que ocurre cuando una desviación del primer canal reaparece después en el segundo, que conserva parte de ella y la devuelve al primero, de modo que la memoria pertenece al conjunto de las series. Ajustar una ecuación aislada a cada registro puede ocultar esa circulación aunque ambos ajustes parezcan razonables.
Un modelo autorregresivo vectorial, o VAR, organiza esas dependencias mediante ecuaciones que comparten un mismo pasado observado, de manera que cada variable se predice con sus propios retardos y con los de las demás. Con él se calculan pronósticos conjuntos y se sigue la propagación de una perturbación entre componentes. Para interpretar esa propagación hace falta especificar qué perturbación se introduce, porque dos descomposiciones de los mismos errores de predicción pueden producir respuestas diferentes.
La propuesta adquirió gran presencia en macroeconomía con Sims (1980), que cuestionó restricciones poco justificadas de los grandes sistemas de ecuaciones y defendió estudiar las relaciones dinámicas entre variables tratadas conjuntamente. Puede aplicarse a cualquier registro multivariado para el que sea adecuada una aproximación lineal con memoria finita. Aquí se trabaja con construcciones didácticas, cuyos coeficientes y covarianzas no proceden de observaciones económicas ni clínicas.
Un pasado común para todas las ecuaciones
Si es un vector con variables observadas en el instante t, un VAR de orden p se escribe
El vector c contiene las constantes. Cada matriz , donde j es el número de intervalos que separan predictor y respuesta, tiene una fila por variable predicha y una columna por variable retardada. El vector reúne las innovaciones, es decir, la parte del registro actual que no puede anticiparse con el pasado especificado. Todas las ecuaciones usan las mismas fechas y la misma resolución temporal.
El elemento situado en la segunda fila y la primera columna de describe la contribución del primer componente del período anterior al pronóstico del segundo cuando se mantienen fijos los demás predictores. Esa lectura depende de las variables y retardos que acompañan al coeficiente. Al añadir una tercera serie cambia la información con que se separan las contribuciones y el coeficiente puede variar, de ahí que una matriz estimada describa al par de variables dentro del modelo que la produjo.
En la forma reducida que hemos escrito, el lado derecho contiene valores pasados además de la innovación actual. Las relaciones entre variables dentro del mismo intervalo quedan recogidas en la distribución conjunta de las innovaciones. Stock y Watson (2001) distinguen esta representación de los VAR recursivos y estructurales, cuyas condiciones adicionales sobre las relaciones contemporáneas determinan qué interpretación puede darse a los movimientos inesperados del sistema.
Para que la parte determinista de la ecuación sea la esperanza condicional asumiremos que , donde denota la información disponible hasta el período anterior. Una condición más débil, la ausencia de correlación con los predictores pasados, basta para interpretarla como proyección lineal. Si existen patrones no lineales predecibles, las dos lecturas pueden separarse. En el ejemplo principal supondremos innovaciones gaussianas, independientes entre fechas y con una matriz de covarianzas constante.
La independencia entre fechas, que excluye la autocorrelación temporal de las innovaciones, es compatible con una dependencia entre los componentes de una misma innovación. Una sorpresa positiva en una serie puede acompañarse de otra positiva en la segunda durante esa misma hora. El VAR recoge esa coincidencia mediante una matriz de covarianzas que no tiene por qué ser diagonal.
Cuando existe una media constante , al tomar esperanzas en la ecuación se obtiene
Por tanto, la constante de una ecuación difiere en general de la media de su variable. Si a cada serie se le resta su media poblacional, la ecuación centrada tiene constante cero, pero en las aplicaciones esa media suele estimarse y la incertidumbre de la estimación también forma parte del problema. Para seguir los cálculos sin ese componente adicional, nuestro sistema estará centrado desde su definición.
Dos canales que devuelven información uno al otro
Consideremos dos variables x e y, medidas cada hora y expresadas en unidades previamente fijadas, que obedecen el sistema
La primera ecuación conserva la mitad del valor anterior de x y le añade cuatro décimas del valor anterior de y. La segunda conserva tres décimas de su propio valor y añade dos décimas del anterior de x. Por ahora son coeficientes de predicción del proceso definido, a los que todavía no se atribuyen mecanismos físicos separados.
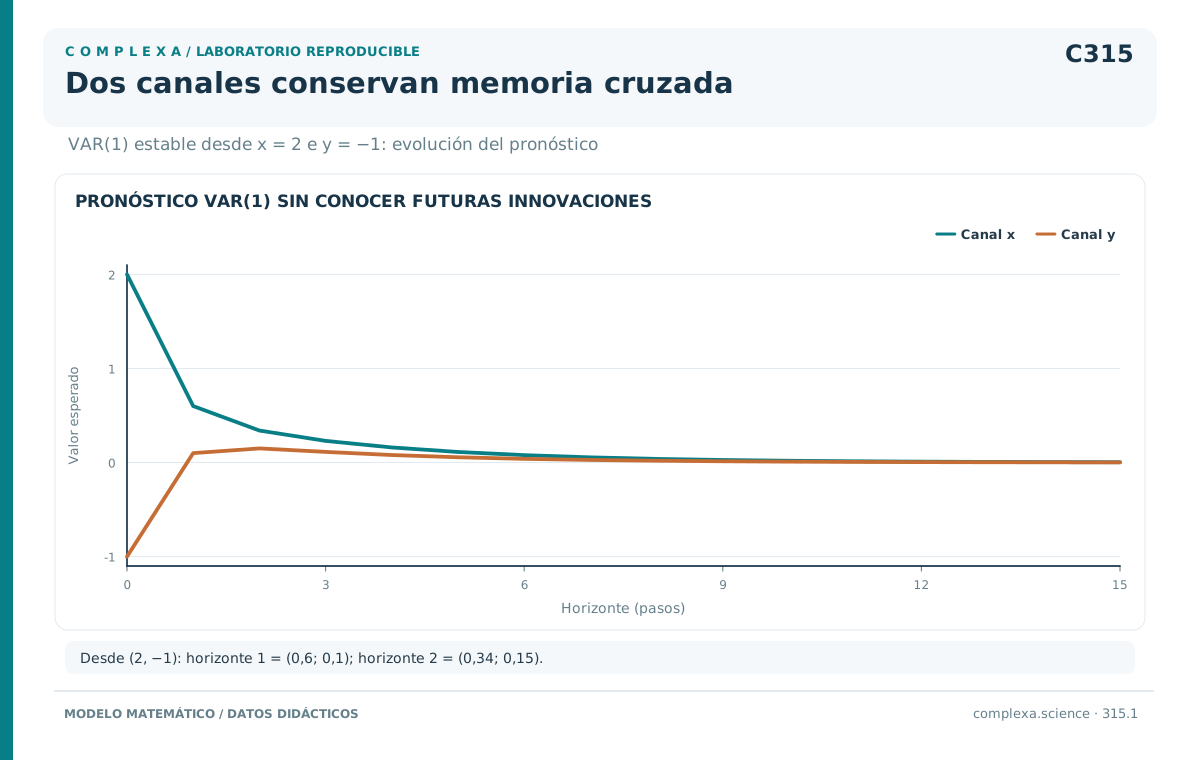
Si en la fecha de origen se observa x igual a dos e y igual a menos uno, el pronóstico para la hora siguiente es x igual a 0,6 e y igual a 0,1. La contribución negativa de y compensa parte de la persistencia positiva de x. Si se borrara de la primera ecuación el término que contiene y, el cálculo daría uno. Esa operación desecha la información sobre el estado observado de la segunda variable y es distinta de volver a estimar un modelo univariado.
El pronóstico a dos horas se obtiene aplicando de nuevo la misma matriz al vector pronosticado, puesto que, sin información posterior, las futuras innovaciones tienen esperanza cero. El resultado es x igual a 0,34 e y igual a 0,15. El segundo componente aumenta respecto de su pronóstico anterior pese a que el sistema es estable, propiedad que no exige que cada componente disminuya en cada paso.
| Horizonte desde el origen | Pronóstico de x | Pronóstico de y |
|---|---|---|
| Una hora | 0,600 | 0,100 |
| Dos horas | 0,340 | 0,150 |
| Tres horas | 0,230 | 0,113 |
La multiplicación de matrices muestra los recorridos que producen esas cifras y, con ellos, la parte de la persistencia futura que no procede del coeficiente propio inicial. En , la contribución de x actual a x dos horas después es , suma de una parte que permanece en x durante ambos pasos y de otra que pasa por y antes de volver.
Lo mismo ocurre entre variables distintas. La contribución de y actual a x dos horas después es , donde el primer término corresponde al recorrido que pasa primero a x y permanece allí; el segundo, al que permanece en y antes de pasar a x. Productos de este tipo explican que una relación pequeña a un paso pueda acumular una influencia considerable en horizontes posteriores.
Una conversión de unidades que multiplicara por diez los valores numéricos de y cambiaría la matriz de coeficientes aunque las trayectorias físicas descritas fueran las mismas. El coeficiente que transmite y hacia x se dividiría por diez y el que transmite x hacia y se multiplicaría por diez. Comparar coeficientes entre canales exige, por eso, atender a las unidades de las variables, de cuya escala depende el valor numérico de la flecha que las une.
La estabilidad pertenece a una matriz ampliada
En el VAR de primer orden la sustitución repetida de la ecuación genera potencias de A, de manera que la diferencia entre dos estados iniciales sometidos a las mismas innovaciones evoluciona como multiplicado por la diferencia inicial. El criterio de estabilidad exige que esas potencias tiendan a cero, condición que se cumple cuando todos los autovalores de A tienen módulo menor que uno.
En el sistema anterior los autovalores son siete décimas y una décima, de modo que distintas combinaciones de x e y decaen a ritmos diferentes y el primero gobierna la más persistente. Con las hipótesis declaradas sobre el ruido puede construirse una solución estacionaria como suma convergente de innovaciones pasadas, en la que hay persistencia pero el peso de una perturbación remota se reduce con el tiempo.
La estabilidad, que se comprueba con los autovalores de la matriz, es una propiedad distinta de la constancia de los parámetros durante una observación prolongada. Esta última obliga a examinar si una misma matriz sirve para todo el período. Un proceso podría seguir una matriz estable durante el invierno y otra, también estable, durante el verano. Cada régimen amortiguaría sus perturbaciones con sus propias ecuaciones, pero un único VAR de coeficientes constantes no describiría necesariamente la transición entre ambos.
Queda además la cuestión del comienzo. Aunque exista una distribución estacionaria, un proceso que parte de un estado fijado puede tener durante un transitorio una media y una covarianza que evolucionan. La estabilidad hace que la influencia de ese comienzo desaparezca con el tiempo, mientras que la estacionariedad desde la primera fecha requiere una inicialización compatible con la distribución correspondiente.
La condición se aplica a la matriz completa y es distinta de pedir que cada coeficiente sea menor que uno. Si las dos entradas diagonales valen ocho décimas y las dos cruzadas cinco décimas, los autovalores son 1,3 y 0,3. Todos los elementos son inferiores a uno y, sin embargo, crece una perturbación en la dirección en que ambos componentes aumentan juntos, una combinación que las conexiones cruzadas refuerzan y que la inspección aislada de las diagonales no detecta.
A la inversa, un elemento mayor que uno es compatible con la estabilidad, como muestra la matriz
Sus dos autovalores son ocho décimas. Una desviación inicial de una unidad en el segundo componente y cero en el primero produce en este tres unidades un paso después y 4,8 dos pasos después. El primer componente alcanza 6,144 tanto en el cuarto como en el quinto paso y luego disminuye hasta quedar, a los cincuenta pasos, en aproximadamente 0,00268.
La transferencia repetida desde el segundo componente genera aquí un crecimiento transitorio antes de que domine la amortiguación. En el paso h el primer componente vale , producto de un factor h creciente y de una potencia decreciente que acaba por prevalecer. Un pronóstico estable puede así sufrir una amplificación inicial considerable, que pasa a primer plano cuando interesa el máximo de una respuesta durante un intervalo corto.
Varios retardos obligan a ampliar el estado. En un VAR de segundo orden, el vector que reúne el estado actual y el anterior obedece una ecuación de primer orden con matriz compañera
El bloque superior calcula el nuevo estado a partir de las dos fechas retenidas y el inferior copia el estado actual para que ocupe el lugar del anterior en el paso siguiente. La construcción, que no añade datos ni parámetros, reorganiza la memoria ya presente en las ecuaciones. Con p retardos se apilan p vectores cuyas posiciones se desplazan en cada paso.
La estabilidad depende entonces de todos los autovalores de F. Si y , cada matriz de retardos tiene por separado autovalores de seis décimas, pero la compañera tiene un autovalor de aproximadamente 1,131. Las contribuciones de los dos retardos acumulan persistencia suficiente para producir crecimiento.
Una formulación equivalente exige que el determinante del polinomio matricial no se anule para ningún w de módulo menor o igual que uno. Las raíces de este polinomio quedan entonces fuera del círculo unidad y los autovalores de la compañera dentro. Son convenciones recíprocas. Lütkepohl (2005) estudia los procesos VAR estables y sus usos predictivos. La condición, tal como se usa aquí, describe una representación causal estable construida con innovaciones presentes y pasadas, sin ocuparse de las soluciones anticipativas basadas en perturbaciones futuras.
Pronosticar un vector incluye pronosticar su error
En el VAR centrado de primer orden el pronóstico a h pasos es . Esa trayectoria resume la esperanza condicional, pero una realización futura añade perturbaciones en todas las fechas intermedias. A dos pasos el error es , porque la primera innovación ya ha circulado por las ecuaciones cuando llega la segunda.
El error a h pasos tiene covarianza
Cada sumando mide la contribución de una fecha de innovación. Al estar incorrelacionadas las innovaciones de fechas diferentes, las contribuciones se suman. En nuestro ejemplo la matriz coincide con Sigma a una hora. A dos horas es
Los elementos diagonales indican la incertidumbre marginal de cada pronóstico y los cruzados describen la relación entre sus errores, que dos intervalos separados para x e y dejan fuera. Esa relación entra directamente en el error cuando se pronostica la suma o la diferencia de ambas variables. La covarianza se añade dos veces en el primer caso y se resta dos veces en el segundo.
A dos horas, la varianza del error es 4,768 para la suma y 0,936 para la diferencia, con los mismos pronósticos marginales en ambos cálculos. La diferencia es menos incierta porque la correlación positiva hace que muchas sorpresas desplacen ambos componentes en la misma dirección.
Si los coeficientes se conocen y el proceso es estable, estas matrices convergen hacia la covarianza de la distribución estacionaria. A horizontes largos la información del estado actual pierde peso y el pronóstico se aproxima a la media. Su error, en cambio, conserva la variabilidad de una nueva observación del proceso y no se acerca a cero por alargar el horizonte. Si los parámetros están estimados, a esta incertidumbre de las futuras innovaciones se suma la de haber aprendido las ecuaciones con una muestra finita.
La normalidad asumida convierte las varianzas en intervalos de predicción. Para x a dos horas, la desviación típica del error es aproximadamente 1,285. Al multiplicarla por el cuantil normal de 1,96 y colocar el margen alrededor del pronóstico 0,34 se obtiene un intervalo cercano a [−2,178; 2,858]. Se trata de un intervalo marginal para la futura lectura de x, condicionado al estado actual y a parámetros conocidos, que deja fuera la incertidumbre del coeficiente que relaciona las dos series.
Para cubrir conjuntamente las dos futuras lecturas, la distribución bivariada da una región elíptica cuya orientación depende de la covarianza. Dos intervalos marginales del noventa y cinco por ciento presentados juntos delimitan un rectángulo cuya cobertura conjunta difiere de esa cifra. Elegir entre una lectura individual, una suma de canales y el vector completo cambia el objeto de predicción aunque las ecuaciones y los datos de origen sean idénticos.
Qué se estima y cuánta información se necesita
La estimación de un VAR parte de una fila de predictores que contiene una constante y todas las variables retardadas y que se repite en cada ecuación. Con m variables y p retardos cada respuesta tiene coeficientes, antes de añadir tendencias, indicadores de calendario u otros términos. El sistema completo contiene coeficientes de media y una matriz de covarianzas de las innovaciones.
El número crece deprisa. Un sistema con diez variables y cuatro retardos tiene cuarenta y un coeficientes por ecuación y cuatrocientos diez en total. Con cien fechas, de las que se pierden cuatro al construir los retardos, quedan noventa y seis filas utilizables y cada ecuación conserva cincuenta y cinco grados de libertad residuales si su diseño tiene rango completo. Para ese cálculo se restan de las filas solo los coeficientes de la propia ecuación, pues todas las ecuaciones comparten predictores aunque tengan respuestas distintas.
Este conteo explica el coste de incorporar una variable, cuyos retardos entran en todas las ecuaciones y que exige además una ecuación nueva para predecirla. A cambio, la nueva serie puede traer información que antes faltaba, modificar la dependencia residual y separar relaciones confundidas, ganancias que se sopesan frente a la precisión con que podrán estimarse sus contribuciones.
Retirar una variable altera las demás ecuaciones. En nuestro ejemplo, al sustituir la ecuación de y dentro de la de x se obtiene
La trayectoria marginal de x contiene ahora dos retardos propios y una combinación de perturbaciones actuales y anteriores. Un componente aislado de un VAR de primer orden puede seguir, por tanto, un proceso distinto de un AR de primer orden. Parte de la memoria que antes recogía el estado observado de y reaparece en esa estructura cuando y se elimina.
La sustitución da así una razón concreta para que un ajuste univariado requiera una estructura distinta, ya que la variable omitida puede transportar información que un simple cambio del coeficiente propio no recupera. Con suficientes retardos, una ecuación aislada puede aproximar parte de ese comportamiento, pero entonces usa una representación diferente de la memoria y puede perder capacidad predictiva cuando el segundo canal contiene una sorpresa reciente.
Cuando todas las ecuaciones tienen los mismos regresores y no hay restricciones cruzadas, los mínimos cuadrados ordinarios pueden calcularse ecuación por ecuación. Aunque los errores estén correlacionados contemporáneamente, una regresión conjunta ponderada daría las mismas estimaciones puntuales. En este caso particular, la estimación del sistema por mínimos cuadrados generalizados coincide con la ordinaria. Con regresores diferentes o restricciones compartidas, esa coincidencia deja de estar garantizada.
La covarianza conjunta sigue haciendo falta para estimar la incertidumbre de combinaciones de coeficientes de distintas ecuaciones y para construir los errores de pronóstico multivariados. Descartarla tras ajustar por separado sería perder la parte del modelo que describe cómo siguen relacionadas las series aun cuando las regresiones se calculen una a una.
Disponer de más filas que columnas sirve de poco cuando las columnas están casi alineadas. Dos registros muy parecidos, o muchos retardos de una serie persistente, dan escasa información para distinguir sus coeficientes, así que el ajuste puede redistribuir las contribuciones entre variables y conservar pronósticos semejantes. La regularización reduce esa variabilidad al imponer restricciones o preferencias sobre los coeficientes. Como en otros modelos de regresión, su efecto depende de la escala y de la intensidad elegida.
El orden de retardos fija también el alcance temporal de la pregunta. Un modelo horario de cuatro retardos incluye explícitamente cuatro horas de historia, que en un modelo diario del mismo orden pasan a ser cuatro días. Algunos efectos más prolongados pueden transmitirse mediante la iteración, pero la estructura directa sigue limitada al orden elegido. Para seleccionar el orden se tienen en cuenta el fenómeno observado y el desempeño del modelo. Aquí basta con tener claro qué historia entra en cada ecuación, sin detenerse en las consecuencias de esa elección sobre los residuos y la evaluación prospectiva, que se estudian aparte.
El intervalo de registro forma parte del modelo
Si el proceso horario sigue siendo exactamente el de nuestro ejemplo pero solo se guarda una observación cada dos horas, entre dos lecturas conservadas ocurre una transición que no figura en el archivo. El registro resultante obedece la ecuación
La matriz autorregresiva es ahora , con filas (0,33; 0,32) y (0,16; 0,17). Las innovaciones tienen la covarianza calculada antes para el error a dos horas y, bajo la independencia temporal asumida, siguen siendo independientes entre intervalos, dado que dos intervalos de dos horas que no se superponen reúnen perturbaciones distintas.
Los autovalores de esta matriz son 0,49 y 0,01, pues cada modo ha evolucionado dos veces antes de la siguiente lectura. Quien comparara el coeficiente propio de x en el registro horario con el del registro espaciado podría tomar su reducción por un cambio del proceso cuando ningún mecanismo del modelo ha cambiado. Solo es distinta la duración de cada paso, cuyo coeficiente recoge ahora otra composición de recorridos.
Guardar el promedio de las dos lecturas horarias es una operación distinta de conservar una de ellas. Un promedio mezcla estados separados y, con ellos, perturbaciones que entran con pesos diferentes, por lo que su representación puede necesitar una estructura de memoria distinta. Antes de interpretar un VAR estimado sobre agregados debe quedar definido si cada fila corresponde a un instante, a un promedio o a una cantidad acumulada durante el intervalo.
Las fechas ausentes plantean otra dificultad. Si faltan algunas horas y las filas restantes se juntan como si fueran consecutivas, un mismo retardo puede corresponder a una hora o a varias según la fila. La matriz ajustada intenta entonces describir con los mismos coeficientes transiciones de duraciones diferentes. Con el calendario conservado puede decidirse si hace falta un modelo que maneje las observaciones faltantes, una representación de estados o un cambio explícito de resolución.
La relación entre escala temporal y ecuación ayuda también a interpretar la dimensión de un VAR. Al aumentar la frecuencia puede hacer falta un número mayor de retardos, ya que una transmisión que tarda varias horas ocupa más posiciones en un archivo registrado por minutos. El dominio de observación y la memoria retenida han de expresarse en el mismo reloj antes de comparar coeficientes o respuestas.
Innovaciones correlacionadas y perturbaciones separadas
En nuestro sistema cada innovación tiene varianza uno y su correlación contemporánea es seis décimas. El pasado del vector no las predice, pero observar una de ellas informa sobre la otra en la misma fecha. Con la distribución gaussiana asumida, una innovación de una unidad en x va acompañada de una esperanza condicional de seis décimas en la innovación de y.
Puede calcularse qué sucede si el vector de innovación toma el valor con las demás innovaciones iguales en las dos trayectorias comparadas. El impacto inmediato se limita a x. Una hora después la diferencia es y a las dos horas . Se trata de una perturbación de la coordenada reducida, bien definida como cálculo.
Describirla como una causa externa aislada exigiría explicar cómo se produce ese cambio sin alterar la otra innovación y por qué las ecuaciones seguirían vigentes. La correlación residual puede proceder de un factor compartido, de relaciones que ocurren dentro del intervalo o de mediciones que mezclan procesos. La matriz Sigma es compatible con cualquiera de esas explicaciones.
Una representación habitual escribe , donde las perturbaciones de tienen covarianza identidad y la matriz B, que transforma perturbaciones de varianza unitaria en innovaciones observables, cumple . Si B satisface la igualdad, también la satisface BQ para cualquier matriz ortogonal Q. Estas rotaciones cambian qué combinación de movimientos se denomina «una perturbación» sin alterar la covarianza observada.
Rubio-Ramírez, Waggoner y Zha (2010) estudian formalmente la identificación de VAR estructurales y las restricciones con que se distinguen parametrizaciones equivalentes. Nuestro caso muestra la dificultad sin entrar en sus resultados generales, con unas ecuaciones reducidas y una covarianza que admiten varias matrices de impacto. Elegir una requiere información adicional o una convención explícita sobre cómo se separarán las sorpresas.
Dos órdenes producen dos respuestas distintas
Una posibilidad es la factorización de Cholesky. Con x situado primero, da la matriz de impacto
La primera perturbación estandarizada desplaza inmediatamente x en una unidad e y en seis décimas. La segunda desplaza y en ocho décimas y deja x intacta en ese instante, restricción recursiva que expresa el cero de la esquina superior derecha. Ambas están incorrelacionadas por construcción.
Si se coloca y primero y luego se restituyen las filas y las etiquetas de las perturbaciones a su orden original, se obtiene otra matriz
También reproduce exactamente Sigma. La perturbación etiquetada por x tiene ahora un impacto inmediato de ocho décimas sobre x y ninguno sobre y, mientras la etiquetada por y mueve ambos componentes. La covariación contemporánea se ha repartido de otra manera sin que cambien las matrices del VAR reducido.
La tabla recoge las trayectorias que siguen a una perturbación estandarizada asociada a x, con el horizonte cero en la fecha del impacto.
| Horizonte | x primero: respuesta de x | x primero: respuesta de y | y primero: respuesta de x | y primero: respuesta de y |
|---|---|---|---|---|
| 0 | 1,000 | 0,600 | 0,800 | 0,000 |
| 1 | 0,740 | 0,380 | 0,400 | 0,160 |
| 2 | 0,522 | 0,262 | 0,264 | 0,128 |
Las columnas se obtienen aplicando las potencias de A al vector de impacto correspondiente. Parte de la diferencia está en el tamaño del impacto inicial sobre x, porque una desviación típica de una perturbación estructural puede corresponder a una cantidad distinta de una unidad de la variable observada. Si se dividiera la segunda pareja de columnas por ocho décimas para comparar impactos iguales sobre x, el efecto contemporáneo sobre y seguiría siendo cero, frente a seis décimas con el primer orden.
El orden de Cholesky adquiere interpretación estructural cuando hay razones para defender las exclusiones contemporáneas que impone. En una instalación con tiempos de transmisión conocidos, por ejemplo, ciertos movimientos podrían no alcanzar un canal dentro del intervalo observado. La plausibilidad de esa exclusión cambiaría al pasar de mediciones por segundo a promedios diarios, dado que una restricción temporal se refiere a la resolución efectiva del registro.
La factorización puede usarse también como convención descriptiva siempre que ese alcance quede explícito. Las respuestas siguen siendo entonces reproducibles y útiles para comparar patrones dentro de la misma convención. El problema aparece cuando una de esas columnas se presenta como si la distribución observada hubiera seleccionado por sí sola la intervención que representa.
Condicionar a una sorpresa sin escoger un orden
Pesaran y Shin (1998) propusieron respuestas generalizadas, invariantes al orden de las variables, que prescinden de ortogonalizar previamente las innovaciones. En nuestro modelo gaussiano, condicionar a que la innovación del componente j valga una desviación típica positiva da el vector medio de impacto , donde selecciona ese componente. La respuesta a h pasos es
La expresión se deriva aquí de la esperanza condicional gaussiana y de la propagación lineal. Para la sorpresa de x el impacto medio es , igual a la primera columna del orden que situaba x primero. Para la de y es , que corresponde al orden con y primero.
Las dos respuestas describen condicionamientos distintos sobre la distribución conjunta y no forman automáticamente las columnas de una única matriz de perturbaciones mutuamente ortogonales. Si se colocaran ambos vectores como columnas de una matriz y esta se multiplicara por su traspuesta, la primera varianza sería 1,36, cuando en Sigma vale uno. La covariación compartida se estaría contabilizando de un modo incompatible con esa supuesta descomposición independiente.
La invariancia al orden resuelve una ambigüedad de presentación, pero la interpretación intervencional depende de otras condiciones, porque condicionar a una observación y modificar un mecanismo son operaciones diferentes incluso cuando se expresan con las mismas variables. En nuestro cálculo, observar una sorpresa de x lleva a esperar parte de la sorpresa de y. Manipular x con un dispositivo que no actúe sobre el origen común de ambas sorpresas podría producir otro vector de impacto.
La incertidumbre de una respuesta y el reparto de su varianza
Hasta ahora conocíamos exactamente A y Sigma por haber definido el proceso. Con datos finitos ambas se estiman. Una respuesta a varios pasos combina sus estimaciones de forma no lineal y, al repetir la matriz estimada, multiplica también las consecuencias de pequeños errores en los coeficientes. Una línea de respuesta dibujada sin información sobre esa incertidumbre puede sugerir una duración o un signo mejor establecidos de lo que justifican las observaciones.
Kilian (1998) estudió intervalos bootstrap para respuestas a impulsos que corrigen el sesgo y tienen en cuenta la asimetría de su distribución en muestras pequeñas. Su trabajo justifica elegir con cuidado el procedimiento de inferencia, ya que una aproximación simétrica puede ser inadecuada en esas condiciones. Los intervalos obtenidos siguen condicionados al modelo y a la identificación utilizados, por lo que la variación de los datos simulados dentro de un orden fijo deja sin evaluar la incertidumbre de haber elegido ese orden.
Una banda calculada por separado para cada horizonte puede tener, para la trayectoria completa, una cobertura distinta de la nominal. Preguntar si una respuesta es positiva a una hora concreta difiere de preguntar si permanece positiva durante diez horas consecutivas. La segunda afirmación involucra a la vez varios valores estimados, relacionados además entre sí por proceder de las mismas matrices. Al presentar una respuesta debería quedar claro a cuál de esas preguntas corresponde la incertidumbre mostrada.
La descomposición de la varianza del error de pronóstico muestra el mismo problema con otra medida. Si las perturbaciones estandarizadas están incorrelacionadas, la contribución de cada una a la varianza de x en cierto horizonte se obtiene sumando los cuadrados de las respuestas de x a esa perturbación durante los pasos relevantes. Las contribuciones de todas las perturbaciones suman la varianza total.
Volvamos al pronóstico de x a dos horas, cuya varianza de error era 1,65. Con x primero, la perturbación etiquetada por x contribuye con , aproximadamente el 93,79 % del total. La otra perturbación da cuenta de las 0,1024 unidades de varianza restantes a través de su efecto retardado sobre x.
Con y primero, la perturbación etiquetada por x contribuye con , aproximadamente el 48,48 %. La etiquetada por y contribuye con . Ambos repartos, que conservan la varianza total de 1,65 y el pronóstico de x igual a 0,34, difieren solo en la asignación de esa incertidumbre a las perturbaciones que define cada orden.
Referencias
Kilian, L. (1998). Small-sample confidence intervals for impulse response functions. The Review of Economics and Statistics, 80(2), 218–230. https://doi.org/10.1162/003465398557465
Lütkepohl, H. (2005). New introduction to multiple time series analysis. Springer. https://doi.org/10.1007/978-3-540-27752-1
Pesaran, M. H., y Shin, Y. (1998). Generalized impulse response analysis in linear multivariate models. Economics Letters, 58(1), 17–29. https://doi.org/10.1016/S0165-1765(97)00214-0
Rubio-Ramírez, J. F., Waggoner, D. F., y Zha, T. (2010). Structural vector autoregressions: Theory of identification and algorithms for inference. The Review of Economic Studies, 77(2), 665–696. https://doi.org/10.1111/j.1467-937X.2009.00578.x
Sims, C. A. (1980). Macroeconomics and reality. Econometrica, 48(1), 1–48. https://doi.org/10.2307/1912017
Stock, J. H., y Watson, M. W. (2001). Vector autoregressions. Journal of Economic Perspectives, 15(4), 101–115. https://doi.org/10.1257/jep.15.4.101