Un sensor entrega una lectura por minuto, pero el programa que dibuja su trayectoria muestra el promedio de las tres lecturas más recientes. La curva visible cambia con suavidad. Dos valores consecutivos comparten parte de la información con que se calcularon, incluso si las lecturas originales fueran independientes. Antes de atribuir esa continuidad al sistema medido es preciso separar la duración propia del proceso de la que introduce el registro.
La autocorrelación compara una variable consigo misma a diferentes separaciones temporales y describe cuánto se parecen linealmente sus desviaciones respecto de la media cuando las observaciones están próximas o alejadas. Esa descripción ayuda a construir predicciones y a examinar modelos, aunque deja abierto el mecanismo responsable de la semejanza. Una inercia física, una entrada compartida y un promedio móvil pueden producir correlaciones parecidas.
Una segunda distinción separa las propiedades del proceso de los resultados obtenidos con un archivo finito. En un modelo ideal, la función de autocorrelación puede ser exactamente cero después de cierto retardo y, sin embargo, las barras calculadas con sus realizaciones fluctuarán alrededor de esos valores y rara vez coincidirán exactamente con ellos. Los ejemplos que siguen son construcciones didácticas, con números pensados para comprobar ambas diferencias sin atribuirlas a un experimento real.
El retardo necesita una escala temporal
Sea una serie observada en instantes equidistantes. El índice t cuenta observaciones, de manera que un retardo h abarca h intervalos de muestreo. Si se mide cada minuto, el retardo cinco corresponde a cinco minutos; si se mide cada hora, el mismo número equivale a cinco horas. Al comparar correlogramas sin conservar esa escala, dos procesos con duraciones físicas iguales pueden parecer distintos.
Para definir una función que dependa solo del retardo suponemos estacionariedad de segundo orden, es decir, media constante, varianza finita y una covarianza que depende únicamente de la separación entre instantes, sea cual sea su posición en el calendario. Si denota la media y la autocovarianza, las dos funciones básicas son
La segunda expresión requiere varianza positiva. Una serie constante carece de una autocorrelación definida mediante ese cociente, porque tanto el numerador como el denominador valen cero. La autocovarianza conserva las unidades al cuadrado de la variable y la autocorrelación es adimensional, por lo que multiplicar toda la serie por una constante no nula cambia la primera pero conserva la segunda.
En el retardo cero la autocorrelación vale uno. Para una serie real estacionaria los retardos positivos y negativos tienen el mismo valor, porque la covarianza no cambia al intercambiar sus argumentos. Esa simetría pertenece solo a los momentos de segundo orden y es compatible con un proceso irreversible en otros aspectos, cuya distribución conjunta conserve rasgos temporales que la covarianza no expresa.
La secuencia completa de autocorrelaciones tampoco puede elegirse arbitrariamente. Como la varianza de cualquier combinación lineal finita de observaciones debe ser no negativa, las matrices construidas con las autocovarianzas han de ser semidefinidas positivas. Esa restricción liga los retardos entre sí, de modo que varios números situados cada uno dentro del intervalo permitido para una correlación pueden no formar, en conjunto, una función válida.
La estimación a partir de una sola trayectoria añade una condición de otro tipo. Con la estacionariedad queda definida una misma media para todos los instantes, aunque el promedio temporal de una realización puede no acercarse a ella. Un proceso que toma una constante aleatoria al empezar y la mantiene para siempre es estacionario, pero observarlo durante más tiempo no revela su distribución entre realizaciones. Para que los estimadores converjan hacen falta condiciones adicionales, como una ergodicidad apropiada para los productos que se promedian.
El signo de la correlación es el del promedio de los productos de las desviaciones centradas, un promedio en el que cuentan tanto los signos como las magnitudes. Ninguno de los dos signos obliga a las trayectorias a subir o bajar monótonamente. La correlación resume en una sola cantidad muchas parejas de niveles centrados y deja fuera las pendientes.
Una función poblacional y varias estimaciones posibles
Con observaciones , una estimación habitual emplea la media de todo el registro y el mismo denominador para todos los retardos,
La suma recorre solo las parejas disponibles para cada retardo, sin conectar el último valor con el primero como si el archivo fuera circular. Esta convención conserva una estructura de autocovarianza semidefinida positiva, aunque sus estimaciones pueden tener sesgo en muestras finitas. La media estimada también afecta al resultado, puesto que la media poblacional que contiene el modelo es, en general, desconocida.
Tomemos ocho lecturas que, en su orden original, valen cero, uno, dos, tres, tres, dos, uno y cero. Su media es uno y medio. La suma de sus desviaciones al cuadrado vale diez. Con la regla anterior se obtienen los productos cruzados y las autocorrelaciones de la tabla.
| Retardo | Parejas utilizadas | Suma de productos centrados | Autocorrelación estimada |
|---|---|---|---|
| 1 | 7 | 4,75 | 0,475 |
| 2 | 6 | −1,50 | −0,150 |
| 3 | 5 | −5,75 | −0,575 |
| 4 | 4 | −5,00 | −0,500 |
El factor de normalización común se cancela en cada cociente. En los primeros retardos los productos suelen unir valores situados a un mismo lado de la media, mientras que las separaciones mayores emparejan la subida con la bajada del registro. Esa descripción corresponde a estas ocho observaciones, demasiado pocas para decidir si el proceso que pudiera haberlas producido oscila regularmente o para calcular un periodo estable.
Otra convención divide cada suma por el número de parejas disponibles. Si se mantiene el mismo estimador de varianza en el retardo cero, las cuatro correlaciones pasan a ser aproximadamente 0,543, −0,200, −0,920 y −1,000. El cambio es considerable porque el registro es corto y el último retardo usa solo la mitad de las observaciones. El sesgo tampoco desaparece en general con esta modificación, dado que en la correlación siguen interviniendo la media estimada y el cociente de cantidades aleatorias.
Normalizar cada retardo por separado puede romper también la compatibilidad entre las covarianzas. En este ejemplo, la matriz de cinco observaciones construida con la segunda secuencia tiene un determinante negativo, de aproximadamente −0,01104, con lo cual no puede ser una matriz de covarianzas normalizada válida. Con el denominador común el determinante vale aproximadamente 0,11182 y la matriz es definida positiva, una diferencia que repercute en los cálculos posteriores basados en la inversa de esa matriz.
Calcular la correlación de Pearson entre las dos columnas desplazadas es una operación diferente. En el primer retardo cada columna contiene siete valores, con medias y varianzas que pueden diferir de las del registro completo. Para las ocho lecturas anteriores ese cálculo da aproximadamente 0,596, frente a 0,475 con la convención declarada, dos cifras que pueden estar bien programadas y responder a definiciones muestrales diferentes.
Por eso, al intercambiar resultados entre programas, conviene registrar el centrado, los denominadores y el tratamiento de los extremos. Antes de atribuir una pequeña discrepancia entre bibliotecas a un error de implementación debe comprobarse que ambas estiman la misma cantidad mediante la misma regla. Las diferencias suelen crecer en los retardos grandes, donde quedan menos parejas y pesan más las decisiones sobre los bordes.
El centrado impone incluso una restricción exacta al conjunto de barras de esta convención. Como las desviaciones suman cero, también es cero el cuadrado de su suma, en cuyo desarrollo aparecen la suma de los cuadrados individuales y dos veces todos los productos entre posiciones distintas. Si estos últimos se agrupan por su separación, se obtiene que la suma de las autocorrelaciones estimadas de todos los retardos positivos disponibles vale menos un medio. El resultado se cumple para cualquier registro no constante centrado en su propia media, sin necesidad de suponer independencia.
La identidad deja libre el signo de cada retardo particular y tampoco da una corrección universal de su sesgo, pero muestra que la estimación de la media vincula entre sí las barras de todo el archivo. Con una media poblacional conocida, o con otra forma de normalizar cada retardo, la identidad cambia. Quien examine hasta el último desplazamiento y trate todas esas cifras como estimaciones separadas pasará por alto una restricción creada por el propio cálculo.
Qué elimina una autocorrelación parcial
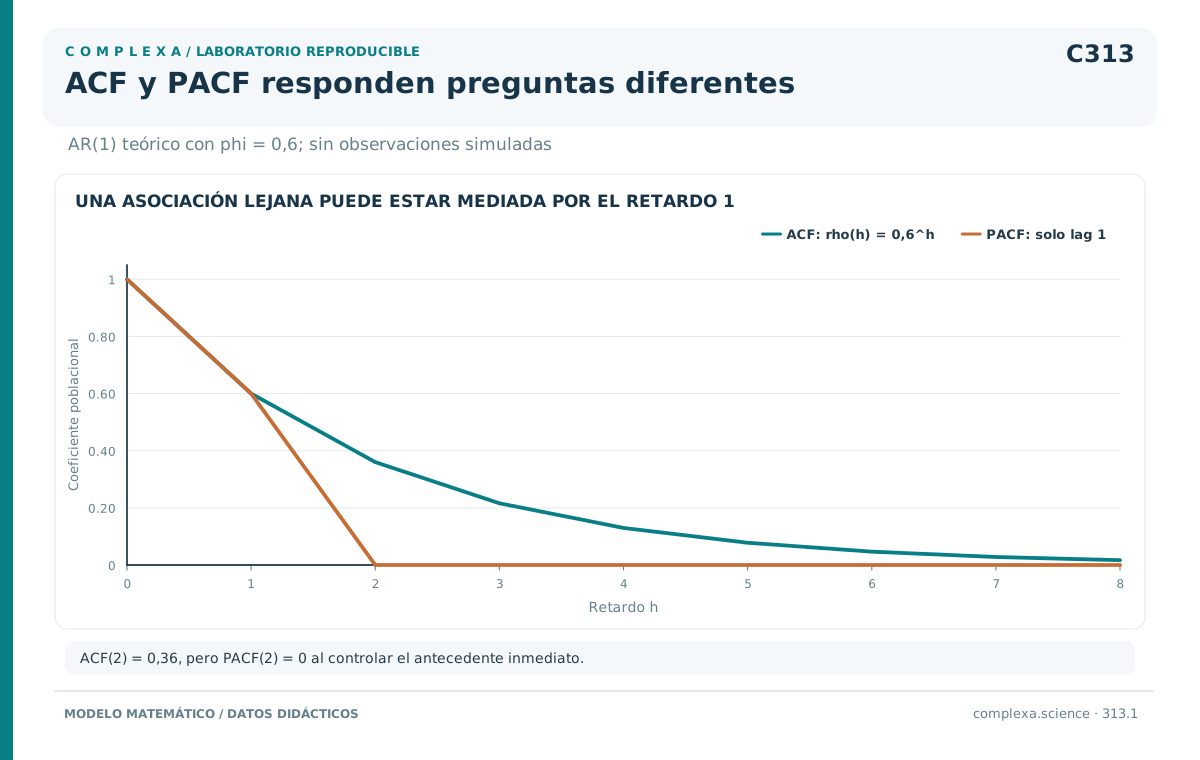
Una asociación a distancia puede transmitirse a través de las observaciones intermedias. En un proceso estacionario cuya autocorrelación es , la correlación vale 0,36 a dos intervalos y 0,216 a tres. Aun así, una predicción lineal de cada observación puede prescindir de los antecedentes más antiguos cuando su información está ya contenida en el inmediatamente anterior.
La autocorrelación parcial de orden h compara los dos extremos después de retirar de ambos su mejor predicción lineal basada en las observaciones intermedias. Para h igual a dos, el valor actual y el de dos intervalos atrás se proyectan sobre el valor que queda entre ellos y después se correlacionan los residuos. Ramsey (1974) caracteriza la relación entre estas correlaciones parciales y la estructura de segundo orden de una serie estacionaria.
La palabra parcial se refiere aquí a una proyección lineal. Otras dependencias respecto de los valores intermedios pueden subsistir en los residuos. Para que los coeficientes queden definidos de manera única suponemos matrices de covarianza no singulares y residuos con varianza positiva. Si una combinación de observaciones determina exactamente otra, el problema puede quedar degenerado y el cociente entre desviaciones residuales necesitar otro tratamiento.
Con varianza normalizada a uno, la fórmula de segundo orden es
En la secuencia geométrica el numerador es cero. Las dos observaciones extremas estaban correlacionadas, pero la intermedia explica linealmente esa correlación. Como la varianza residual de cada extremo es 0,64, el cociente está bien definido y su valor nulo procede únicamente del numerador. La autocorrelación ordinaria a dos pasos sigue en 0,36 porque responde a una pregunta distinta de la que contesta la parcial.
Para un orden general puede proyectarse el valor actual sobre los h anteriores. Bajo la estacionariedad y las condiciones de no degeneración, el coeficiente del antecedente más lejano coincide con la autocorrelación parcial de ese orden. Los demás coeficientes de la proyección pueden cambiar cuando se añade otro retardo, por lo que en cada ajuste solo el último coincide con la correlación parcial correspondiente.
La igualdad entre el último coeficiente y la correlación de residuos se apoya en la estructura temporal de las covarianzas. En una regresión arbitraria, un coeficiente y una correlación parcial pueden tener escalas diferentes, así que la relación debe derivarse dentro del problema estacionario y sin perder de vista qué variables se ajustan en cada lado. Si la predicción lineal se retirara de uno solo de los extremos, se obtendría una correlación semiparcial diferente.
Si el vector de observaciones tiene distribución normal multivariante, una correlación parcial poblacional nula expresa independencia condicional entre esos extremos dadas las observaciones intermedias. Fuera de esa hipótesis, la nulidad solo descarta una relación lineal residual. Una lectura causal requiere supuestos adicionales, porque los valores intermedios pueden compartir causas no observadas y el orden temporal no basta para que un ajuste estadístico describa una intervención.
La proyección cuantifica también lo que gana la predicción al añadir el antecedente más lejano. Una vez retirada la contribución de los intermedios quedan dos residuos que, por estacionariedad, tienen la misma varianza poblacional y cuya correlación es la parcial. Proyectar uno sobre el otro reduce su varianza en un factor igual a uno menos el cuadrado de esa correlación. Si es el error cuadrático mínimo al usar h antecedentes, la relación se cumple para el predictor lineal poblacional, cuyo error puede diferir del que muestra una regresión ajustada con pocos datos.
En el proceso geométrico de varianza uno, el primer antecedente reduce el error de uno a 0,64 y el segundo lo deja igual, porque la parcial correspondiente es cero. La relación poblacional indica qué información se busca. En una muestra finita, un segundo coeficiente estimado puede reducir siempre o casi siempre el error dentro de las filas usadas para ajustar, pero esa reducción empírica incluye la adaptación a fluctuaciones particulares y no toda ella es información nueva sobre el futuro.
La estimación parcial cambia con el procedimiento
Una forma de estimar las autocorrelaciones parciales consiste en sustituir las autocorrelaciones poblacionales por sus estimaciones y resolver las ecuaciones de proyección. La matriz resultante repite el mismo valor a lo largo de cada diagonal asociada a un retardo. Esa estructura impone la estacionariedad de segundo orden en el cálculo, aunque el archivo observado sea solo una realización corta y sus segmentos no tengan exactamente las mismas covarianzas empíricas.
En las ocho lecturas anteriores, la fórmula de segundo orden aplicada a las estimaciones de denominador común da aproximadamente −0,4851, un valor que combina la correlación negativa de segundo retardo con la positiva de primer retardo. Como el numerador y la varianza que lo normaliza difieren de los de la correlación ordinaria, la cifra mide algo distinto de cuánto disminuyó esta en términos porcentuales.
También puede construirse una regresión directamente con las filas que tienen dos antecedentes disponibles, que en este caso son seis. Al ajustar por mínimos cuadrados el valor actual sobre los dos anteriores, con intercepto, el coeficiente del segundo retardo es aproximadamente −0,9636, el del primero 1,4727 y el intercepto 0,6545. La diferencia con la estimación anterior es grande porque las matrices empíricas utilizadas son otras.
El ajuste por filas usa las medias y los productos cruzados del segmento que sobrevive al desplazamiento, mientras que el cálculo basado en autocovarianzas comparte un centrado y una estructura entre retardos. Con muestras amplias y bajo condiciones que aseguren consistencia, estimadores adecuados pueden aproximarse a la misma cantidad poblacional. En ocho observaciones no hay motivo para esperar igualdad numérica. Si después se eligiera el procedimiento que produce la barra más atractiva, la convención de cálculo se volvería una selección oculta del resultado.
Cada retardo añadido reduce el número de filas completas y aumenta el de coeficientes. Una regresión que usa casi tantas variables como observaciones puede ajustarse de forma extrema aun cuando la información sobre dependencias lejanas sea débil. La salida del programa muestra entonces una precisión aparente que encubre la información perdida al aumentar el orden. La regularización puede estabilizarla, pero entonces estima con una restricción adicional que debe quedar declarada.
Un informe debería acompañar la función parcial de una descripción del procedimiento que, junto al nombre del programa, indique el máximo retardo, el tratamiento del intercepto y si se eliminaron filas distintas para cada orden. Con esos datos puede reconstruirse por qué difieren dos estimaciones parciales sin atribuir toda discrepancia a cambios del sistema observado.
Una estructura de retardos no se lee barra por barra
La secuencia geométrica puede generarse con una relación lineal de primer orden en la que el valor centrado actual es seis décimas del anterior más una innovación independiente, de media cero y varianza constante positiva. En su solución estacionaria causal, construida con las innovaciones presentes y pasadas, la influencia lineal de una observación pasada se transmite repetidamente a través de las siguientes. Por eso la autocorrelación decrece a lo largo de muchos retardos aunque la predicción de un paso solo necesite el antecedente inmediato. La autocorrelación parcial poblacional es cero desde el segundo retardo.
En otra construcción, el valor actual depende de siete décimas del registrado dos intervalos antes más una perturbación independiente. Con la solución estacionaria causal y perturbaciones independientes e idénticamente distribuidas, de media cero y varianza positiva, las subsecuencias de instantes pares e impares se forman con historias de perturbaciones distintas. Su autocorrelación es cero en los retardos impares y forma una secuencia geométrica en los pares.
| Retardo | Dependencia de un intervalo | Dependencia de dos intervalos |
|---|---|---|
| 1 | 0,600000 | 0 |
| 2 | 0,360000 | 0,700000 |
| 3 | 0,216000 | 0 |
| 4 | 0,129600 | 0,490000 |
| 5 | 0,077760 | 0 |
| 6 | 0,046656 | 0,343000 |
La segunda construcción muestra que una serie con primera autocorrelación nula puede tener memoria lineal, situada en este caso a otra separación. Su autocorrelación parcial es cero en el primer orden, vale 0,7 en el segundo y se anula después. Quien hubiera conservado únicamente el primer retardo por comodidad habría omitido precisamente el antecedente relevante.
Estos patrones corresponden a valores poblacionales de modelos especificados. Al clasificar un correlograma concreto sirven solo de orientación, ya que una trayectoria corta puede mostrar valores pequeños en un retardo importante y valores grandes en retardos cuya correlación poblacional es cero. La identificación tentativa de un orden ha de considerar a la vez la forma, la precisión y las alternativas que podrían producir un patrón parecido.
Para interpretar una barra a siete intervalos como periodicidad semanal, cada intervalo tendría que corresponder a un día y habría que examinar cómo se repite la relación en otros múltiplos y durante distintas partes del registro. Una periodicidad determinista, una dependencia estacional y una coincidencia muestral son explicaciones diferentes de esa barra, cuya lectura pueden alterar los cambios de calendario o de frecuencia de muestreo antes de que cambie el proceso.
La estructura completa interviene también al estimar una media. Para n observaciones de una serie estacionaria, la varianza del promedio es
La expresión se obtiene al sumar todas las covarianzas entre las observaciones del promedio, suma en la que cada retardo aparece tantas veces como parejas existen con esa separación. Con lecturas independientes los términos adicionales se anulan. Con una persistencia positiva, en cambio, las lecturas contienen información en parte repetida y la varianza del promedio aumenta respecto de la fórmula de independencia. Correlaciones negativas pueden producir el efecto contrario, siempre dentro de una secuencia de covarianzas válida.
Con doscientas observaciones, varianza unitaria y autocorrelación geométrica de razón 0,6, la varianza exacta del promedio es aproximadamente 0,0198125, cuando bajo independencia habría sido 0,005. Si esa precisión se traduce a un número equivalente de observaciones independientes con la misma varianza marginal, se obtienen aproximadamente 50,47. El archivo sigue teniendo doscientas lecturas. La equivalencia se refiere solo a la estimación de su media bajo este modelo, porque los errores al estimar una tendencia, un cuantil o un coeficiente dinámico dependen de otras combinaciones de la distribución.
La incertidumbre del correlograma
La variación de las autocorrelaciones muestrales fue un problema central en el trabajo de Bartlett (1946). La precisión de una correlación estimada depende del número de parejas utilizadas y también de la dependencia entre los productos que se promedian, porque una misma observación puede repetirse en varios productos. El modelo bajo el que se calcula la incertidumbre determina qué covarianzas contribuyen.
Para una serie independiente e idénticamente distribuida, con momentos suficientes, las autocorrelaciones muestrales de un conjunto fijo de retardos tienen una aproximación normal de gran muestra alrededor de cero. De ahí procede la referencia habitual de límites , que son puntuales y aproximados, válidos bajo esa hipótesis para muestras grandes y retardos fijos.
Las líneas dibujadas alrededor de cero son una referencia para contrastar una hipótesis. Un intervalo para una autocorrelación desconocida intenta delimitar su valor. En algunos problemas regulares ambos cálculos utilizan aproximaciones relacionadas, que deben comprobarse antes de intercambiar uno por otro. Un gráfico debería indicar qué significan sus líneas y cómo se calcularon, puesto que ni el color habitual de una franja ni el nombre de una opción del programa especifican su cobertura estadística.
Si la serie tiene autocorrelación distinta de cero, la distribución de sus estimaciones cambia. La fórmula simple puede fallar también cuando la serie carece de correlación lineal pero conserva dependencia en otras características. Hwang y Vogelsang (2026) desarrollan una inferencia robusta válida con innovaciones no necesariamente independientes e idénticamente distribuidas. Su trabajo muestra la necesidad de estimar una variabilidad compatible con la dependencia, dentro de un marco que sigue exigiendo estacionariedad y condiciones de regularidad.
La fiabilidad de una barra depende además de la distancia temporal examinada en relación con la longitud disponible. Una aproximación derivada para retardos fijos y muestras crecientes puede fallar en retardos que ocupan una fracción grande del archivo. En el último retardo de una serie hay una sola pareja, con la cual la barra puede calcularse aunque sea una estimación muy imprecisa de una dependencia lejana.
El nivel de incertidumbre relevante depende de la pregunta. Estudiar un retardo elegido antes de ver los datos es distinto de buscar la mayor barra entre muchas. En el segundo caso interviene la selección. Al mostrar veinte límites puntuales del mismo nivel se obtienen veinte coberturas individuales, que son algo distinto de una banda que cubra simultáneamente los veinte parámetros con ese nivel.
Las autocorrelaciones de residuos ajustados tampoco se comportan exactamente como las de errores observados con parámetros conocidos. Los coeficientes se estimaron con las mismas observaciones y dejan restricciones en los residuos. Box y Pierce (1970) estudiaron esa diferencia. Ljung y Box (1978) propusieron después una modificación de la comparación conjunta de autocorrelaciones residuales, cuyo uso exige registrar qué se ajustó y bajo qué hipótesis se evalúa el ajuste, ya que la estimación previa condiciona cualquier suma de barras residuales.
Cuántas alarmas aparecen al mirar muchos retardos
El problema de las barras aisladas puede examinarse con una simulación cuyo mecanismo se conoce, en la que se generaron veinte mil series independientes entre sí, cada una con doscientas observaciones normales estándar independientes. En cada serie se restó su propia media y se calculó, con el denominador común ya definido, la autocorrelación de los veinte primeros retardos, fijados antes de examinar los resultados.
Los límites puntuales utilizados fueron aproximadamente ±0,13859. En el primer retardo los superaron 995 series, el 4,975 %, un porcentaje próximo al nivel nominal esperado para una sola comparación. En cambio, 11.500 series, el 57,5 %, mostraron al menos una superación entre los veinte retardos, aunque todas procedían del mismo mecanismo independiente y ninguna contenía en ese ejercicio una dependencia temporal real que explicar.
El resultado puede reproducirse con el generador PCG64 y la semilla 313, aplicando la regla de estimación indicada. El error estándar de Monte Carlo del segundo porcentaje, calculado a partir de las veinte mil realizaciones independientes, es de aproximadamente 0,35 puntos porcentuales y describe la incertidumbre del experimento de simulación, ajena a la de cualquier serie aplicada particular.
Si veinte comparaciones fueran independientes y cada una produjera una falsa alarma con probabilidad exactamente igual al cinco por ciento, la probabilidad de alguna alarma sería aproximadamente 64,15 %. El 57,5 % procede directamente de la simulación, que conserva la dependencia y las variaciones entre retardos de las barras estimadas con una misma serie, barras que en una muestra finita no satisfacen exactamente aquellas condiciones.
El cálculo separa dos decisiones, la de utilizar un límite puntual para un retardo especificado de antemano y la de elegir el retardo después de inspeccionar todo el gráfico. Para la segunda puede calibrarse, bajo una hipótesis explícita, la distribución del máximo de las barras estandarizadas, o bien recurrirse a una corrección conjunta apropiada. Quien simule esa distribución debe reproducir también el centrado, los datos ausentes y cualquier ajuste hecho antes de mirar las barras.
Un gráfico sin superaciones es compatible con una dependencia pequeña que la longitud disponible no alcanza a detectar, con una relación concentrada fuera del rango examinado o con una dependencia que no sea lineal. La simulación da la frecuencia de una señal gráfica bajo un mecanismo concreto. Interpretar una señal real exige comparar, además, las alternativas científicas y la magnitud que tendría consecuencias prácticas.
Una serie puede depender sin autocorrelación
Sean variables normales estándar independientes y construyamos , una serie de media cero y varianza uno. Dos valores consecutivos comparten uno de los factores aleatorios, pero su producto contiene otros factores con media cero y, al tomar la esperanza, la autocovarianza de primer retardo se anula. En retardos mayores los conjuntos de factores son disjuntos y las observaciones son independientes.
Todas las autocorrelaciones de retardos positivos son, por tanto, cero. Sin embargo, dos valores consecutivos son dependientes, como se comprueba al elevar ambos al cuadrado. El momento conjunto de los cuadrados es tres y el producto de sus esperanzas es uno, con lo que la diferencia, dos, es una covarianza positiva. Como la varianza de cada cuadrado vale ocho, su autocorrelación de primer retardo es un cuarto.
La discrepancia tiene una interpretación concreta. Un factor compartido de gran magnitud puede hacer grandes dos productos consecutivos aunque sus signos cambien de manera que la covarianza ordinaria se cancele. La dependencia aparece en el tamaño de las observaciones. El correlograma de los cuadrados responde a esa característica y revela una información que el de los niveles pierde.
McLeod y Li (1983) estudiaron el uso de autocorrelaciones de residuos cuadrados para detectar formas de dependencia no lineal en modelos ajustados. El ejemplo del producto se deriva directamente de los momentos normales, sin intentar reproducir todo su procedimiento de prueba. Para convertir una autocorrelación cuadrática estimada en una decisión estadística hacen falta además momentos suficientes y una distribución de referencia válida.
La transformación cuadrática capta un tipo particular de dependencia. Pueden construirse relaciones que no aparecen en los cuadrados y sí en otras funciones de los valores. Escoger la transformación después de probar muchas vuelve a introducir selección. La pregunta útil es qué característica de la distribución podría depender del pasado, ya sea el nivel medio, la dispersión, las colas u otra propiedad especificada, porque cada resumen que se elija descarta parte de la información original.
El registro puede modificar la estructura aparente
Supongamos que una señal estacionaria se observa con un error aditivo independiente a lo largo del tiempo e independiente de la señal. En los retardos positivos la autocovarianza observada coincide con la de la señal, pero el error aumenta la varianza total y la autocorrelación queda atenuada, multiplicada por la fracción de varianza que corresponde a la señal. Esta simplificación deja de valer si el error tiene su propia dependencia temporal.
Con una señal de autocorrelación geométrica de razón 0,6 y un error de igual varianza que la señal, las autocorrelaciones observadas en los dos primeros retardos son 0,3 y 0,18. Introducidas en la fórmula parcial dan un valor de segundo orden de aproximadamente 0,0989, cuando la señal original tenía en ese retardo una autocorrelación parcial nula. El cambio procede del modo de observación y deja intacta la relación dinámica interna.
La distinción afecta a la comparación entre instrumentos. Una serie medida con mayor ruido puede parecer menos persistente en su autocorrelación ordinaria y presentar además una estructura parcial diferente, de modo que antes de interpretar ambas diferencias como cambios del sistema habría que descartar una diferencia de precisión instrumental. Corregir la atenuación exige información sobre el error, ya que reescalar la gráfica deja intacta la autocorrelación, invariante ante cambios lineales de unidad.
Los intervalos irregulares plantean otro problema. Cuando dos filas consecutivas pueden estar separadas por minutos o por días, desplazarlas una posición mezcla duraciones distintas. Eliminar las filas ausentes y comprimir el tiempo cambia también el significado del retardo. Agrupar parejas por distancia temporal puede ser una opción descriptiva, siempre que se declaren las ventanas utilizadas y se reconozca que distintos retardos pueden apoyarse en distintos conjuntos de observaciones.
Interpolar valores para completar una rejilla incorpora sus propios supuestos. Un relleno suave fabrica relaciones entre puntos próximos y modifica los productos que usa el correlograma, así que, si la interpolación forma parte del análisis, la incertidumbre debe tener en cuenta ese paso. Tratar los puntos interpolados como nuevas observaciones independientes exageraría la información disponible y podría hacer parecer más precisa la estructura introducida por el propio método.
Volvamos al sensor que informa promedios de tres lecturas. Si las lecturas originales son independientes, con media cero y varianza uno, cada promedio tiene varianza un tercio. Dos promedios consecutivos comparten dos lecturas, con lo que su covarianza es dos novenos y su autocorrelación, dos tercios. A dos intervalos comparten una lectura y la autocorrelación baja a un tercio, mientras que desde el tercero no comparten ninguna y la correlación es cero. Con el archivo original y la regla de agregación declarada pueden comprobarse esos tres resultados, de modo que las dos primeras barras del registro suavizado tienen ya una explicación calculable en el procedimiento que lo produjo.
Referencias
Bartlett, M. S. (1946). On the theoretical specification and sampling properties of autocorrelated time-series. Supplement to the Journal of the Royal Statistical Society, 8(1), 27–41. https://doi.org/10.2307/2983611
Box, G. E. P., y Pierce, D. A. (1970). Distribution of residual autocorrelations in autoregressive-integrated moving average time series models. Journal of the American Statistical Association, 65(332), 1509–1526. https://doi.org/10.1080/01621459.1970.10481180
Hwang, T., y Vogelsang, T. J. (2026). Robust confidence intervals for autocorrelations of stationary time series. Journal of Business & Economic Statistics, 44(3), 823–839. https://doi.org/10.1080/07350015.2025.2561749
Ljung, G. M., y Box, G. E. P. (1978). On a measure of lack of fit in time series models. Biometrika, 65(2), 297–303. https://doi.org/10.1093/biomet/65.2.297
McLeod, A. I., y Li, W. K. (1983). Diagnostic checking ARMA time series models using squared-residual autocorrelations. Journal of Time Series Analysis, 4(4), 269–273. https://doi.org/10.1111/j.1467-9892.1983.tb00373.x
Ramsey, F. L. (1974). Characterization of the partial autocorrelation function. The Annals of Statistics, 2(6), 1296–1301. https://doi.org/10.1214/aos/1176342881