Una regresión temporal con intercepto puede producir residuos cuya media sea cero hasta el último decimal que muestra el ordenador y omitir, a la vez, una oscilación que recorre toda la serie. La primera propiedad procede de las ecuaciones del ajuste, mientras que la segunda concierne a lo que el modelo dejó sin representar. Tomar la una por indicio de la otra vuelve tranquilizador un resultado que estaba garantizado de antemano.
El significado de un residuo, diferencia construida con datos y un modelo, depende de qué se predijo, con qué información y mediante qué parámetros. Un error de predicción semanal, una diferencia respecto de una curva suavizada y una innovación estimada por un filtro pueden tener unidades idénticas y responder a preguntas distintas, por lo que antes de dibujar su autocorrelación es preciso establecer cuál de esas cantidades ocupa la columna llamada «residuo».
La innovación y su sustituto calculado
Sea una variable con segundo momento finito y sea la información disponible antes de observarla. Su innovación respecto de la media condicional es
Por construcción, , así que ninguna variable conocida en ese pasado puede correlacionarse con la innovación, siempre que existan los momentos necesarios. Si alguna función de los valores anteriores anticipa para la innovación un valor medio distinto de cero, la expresión utilizada como media condicional estaba incompleta. La propiedad abarca toda la información incluida en el condicionamiento, que puede contener variables externas además de la historia de la propia serie.
La innovación lineal tiene un alcance más estrecho. Se obtiene al restar la mejor predicción dentro del espacio de combinaciones lineales del pasado y es ortogonal a esas combinaciones, propiedad compatible con que subsista una relación no lineal todavía útil para predecir. Por eso es necesario declarar si un modelo propone una media condicional completa o una aproximación lineal, ya que la palabra «innovación», usada sin esa precisión, puede atribuir al modelo una capacidad que nunca se le exigió.
Incluso con una media condicional bien especificada, las innovaciones pueden compartir una estructura de variabilidad, porque el requisito de media condicional cero admite varianzas cambiantes, distribuciones distintas de una fecha a otra y dependencia entre fechas. Más adelante aparecerá un proceso cuya próxima innovación tiene signo impredecible, aunque la magnitud de su fluctuación depende del error anterior.
En la práctica se calcula , donde es la media propuesta y contiene parámetros estimados. Si esos parámetros se ajustaron con la serie completa, el residuo de una fecha antigua incorpora indirectamente observaciones posteriores. Ese residuo sirve para juzgar el ajuste retrospectivo. Un pronóstico que realmente pudiera emitirse en aquella fecha exigiría parámetros estimados con la información entonces disponible, una diferencia que será decisiva al evaluar predicciones temporales.
Hay restricciones algebraicas adicionales. En mínimos cuadrados con intercepto los residuos suman cero y son ortogonales a las columnas de la matriz de diseño. Una correlación muestral nula entre el residuo y un predictor incluido se limita, por tanto, a repetir una condición del procedimiento, sin indicar si la relación desaparece también en observaciones nuevas. Esa ortogonalidad tampoco se extiende a dos residuos consecutivos, porque el residuo anterior generalmente no coincide con ninguna columna del diseño.
Box y Pierce (1970) estudiaron precisamente cómo la estimación modifica la distribución de las autocorrelaciones residuales en modelos ARIMA, una modificación que se pierde cuando los residuos se tratan como errores verdaderos observados. Como la muestra se usa primero para elegir los parámetros y después para examinar una cantidad que depende de esa elección, la distribución de referencia ha de recoger ambas operaciones.
Qué merece verse antes de calcular una prueba
El gráfico de residuos contra el tiempo conserva información que una media o un histograma borran. Una sucesión prolongada de valores positivos y dos valores positivos grandes rodeados de fluctuaciones pequeñas corresponden a comportamientos diferentes que pueden contribuir lo mismo a una suma de cuadrados. La localización temporal permite distinguir una desviación persistente de un episodio breve y relacionarla con cambios documentados en el sistema de medición.
El tamaño de un residuo depende también de la escala, ya que uno de cinco unidades puede ser pequeño cuando la incertidumbre prevista es veinte y grande cuando es una. Por eso interesa mirar la diferencia en unidades originales, que expresa la magnitud del error, junto con su versión dividida por la desviación típica condicional estimada, que mide el tamaño de la sorpresa. Esta estandarización tiene sentido si el denominador corresponde a la distribución predictiva que produjo la media.
En los modelos de espacio de estados debe distinguirse el residuo respecto de una predicción hecha antes de incorporar la observación del residuo respecto de un estado suavizado con datos posteriores. El segundo puede ser mucho menor gracias a esa información adicional. La varianza de la innovación del filtro puede cambiar, además, durante la inicialización o cuando faltan observaciones. Si todos los errores se dividen por una única desviación típica, ese funcionamiento previsto puede confundirse con heterocedasticidad.
Los gráficos frente al nivel ajustado y frente a covariables relevantes completan la inspección. Una curvatura residual respecto de la temperatura sugiere revisar la forma de esa relación aunque la autocorrelación temporal sea pequeña. Un abanico cuya amplitud crece con el nivel apunta a una escala condicional mal representada, un patrón que, como el anterior, no se corrige automáticamente añadiendo retardos a la media.
Durante este trabajo deben conservarse las fechas originales. Si se elimina una observación ausente y se unen sus vecinas, el par de filas que queda contiguo está separado por dos intervalos físicos, con lo cual una autocorrelación calculada como si fueran fechas consecutivas mezcla duraciones. El procedimiento de diagnóstico tiene que respetar la definición del retardo o utilizar un modelo que represente los tiempos de observación. Rellenar antes el hueco mediante una interpolación también modifica las correlaciones, por lo que ese paso forma parte del análisis.
Un valor extremo merece examinarse en su contexto, ya que puede corresponder a una perturbación real, a un registro incorrecto o a una distribución con colas que el modelo subestima. Eliminarlo de forma automática altera la pregunta, porque se termina describiendo una serie de la que se han retirado precisamente los episodios difíciles. La corrección de un error de registro se justifica con el registro original. Cuando se conserva un episodio real, el modelo debe permitir evaluar su probabilidad y sus consecuencias.
La influencia sobre el ajuste es otra cuestión. Una observación puede tener un residuo pequeño porque ha desplazado considerablemente los parámetros hacia sí misma. En un modelo autorregresivo su valor reaparece como predictor de fechas posteriores, una propagación que pasa inadvertida si solo se examina el residuo de la fecha afectada. Una revisión de influencia puede comparar coeficientes y predicciones tras introducir en ese registro una perturbación pequeña y documentada, manteniendo explícita la construcción de los retardos.
Ese análisis tiene que respetar la cronología. Borrar una fila y volver a numerar las restantes cambia las distancias temporales, mientras que sustituir su valor modifica también las filas posteriores en las que figura como predictor. Por ello deben separarse el efecto de una observación sobre su propia diferencia ajustada y el que ejerce sobre la estimación y sobre las predicciones siguientes. Si unos pocos registros sostienen casi toda una relación dinámica, el informe debería mostrar esa sensibilidad y su localización, información que puede orientar una nueva medición o una revisión del mecanismo de observación incluso cuando el promedio del error apenas cambia.
La autocorrelación residual es una medición con incertidumbre
Para residuos comparables y regularmente espaciados, una estimación habitual de la autocorrelación al retardo es
donde es su media. Esta convención utiliza el mismo denominador para todos los retardos, a diferencia de otras que incorporan correcciones por el número de pares. En muestras pequeñas las distintas convenciones pueden dar valores diferentes, de modo que quien reproduce un resultado necesita saber qué fórmula se utilizó.
La interpretación del retardo depende del calendario. En una serie diaria, una asociación a siete pasos puede señalar una estructura semanal omitida, mientras que en una serie registrada cada siete días el primer retardo corresponde ya a una semana. Para decidir cuántos retardos examinar hay que relacionar la resolución de medida con los procesos que se espera detectar. Limitarse a retardos cortos deja fuera los ciclos largos, en tanto que extender la inspección hasta casi el tamaño muestral produce estimaciones apoyadas en muy pocos pares.
Para un ruido independiente con condiciones regulares suele utilizarse la aproximación como referencia puntual alrededor de cero. Con doscientas observaciones da aproximadamente y vale para cada retardo considerado por separado. Cuando los valores son residuos de parámetros estimados, su distribución puede apartarse de esa aproximación. Con muchos retardos inspeccionados aumenta, por otra parte, la posibilidad de encontrar alguno llamativo por azar.
El nivel del noventa y cinco por ciento de una banda puntual es marginal y se aplica a cada retardo aislado. Si se examinan veinte cantidades, cada una con una probabilidad marginal del cinco por ciento de exceder su banda, el número esperado de excedencias es uno, dependan o no entre sí las cantidades. La probabilidad de observar al menos una excedencia, en cambio, depende de su distribución conjunta.
La secuencia completa ayuda a formular una revisión. Varios retardos pequeños con el mismo signo pueden ser compatibles con un sesgo persistente que ninguno muestra con claridad por separado. Un pico en un retardo concreto sugiere, en cambio, un mecanismo temporal más localizado. Ambas lecturas orientan hacia modelos que después habrá que comprobar y describen la forma de la dependencia, cuya causa física queda por identificar.
Los signos también pueden reflejar el procesamiento. Al diferenciar una secuencia de errores de medida independientes, cada diferencia contiene el error actual con signo positivo y el anterior con signo negativo, de modo que dos diferencias vecinas comparten un término con signos opuestos. La operación genera autocorrelación negativa al primer retardo incluso si los errores originales eran independientes. Antes de atribuir una alternancia residual a una respuesta del sistema conviene, por tanto, revisar cómo se construyó la variable.
Cuando existe información externa aparece una limitación distinta. Supongamos que se registra una variable , normal estándar e independiente entre fechas, de la que depende la respuesta según , donde . La secuencia es también independiente normal estándar y ajena a toda la secuencia de . Como la variable explicativa del día anterior ya se conoce al predecir la respuesta de hoy, basta aplicarle esa transformación cúbica para anticipar una parte de la respuesta.
Un modelo que prediga siempre cero deja como residuo el propio valor de la respuesta. Esos residuos son independientes entre fechas, porque cada uno utiliza un valor distinto de la variable externa y un error nuevo. Su autocorrelación poblacional es, por tanto, cero en cualquier retardo positivo, pese a que el modelo ha desperdiciado información disponible.
La transformación tiene media cero y carece de correlación con el predictor sin transformar. Los momentos segundo, cuarto y sexto de la normal estándar valen uno, tres y quince, de donde la covarianza entre y es y la varianza de la transformación vale . La deficiencia aparece al relacionar el residuo con esa transformación, con la que tiene covarianza seis, asociación que omitiría quien buscara solamente una pendiente respecto de la variable original. El modelo constante tiene un error cuadrático esperado igual a siete, del que seis unidades proceden de la variación de la función cúbica y una del error independiente. Con la media condicional correcta queda solamente esa última unidad.
El ejemplo precisa el objetivo de la comprobación. Para una tarea que conoce únicamente la historia de la respuesta, el modelo constante utiliza toda la información disponible sobre su media. Para una tarea que también observa la variable externa, en cambio, su predicción es mejorable. Evaluar residuos exige mantener el mismo conjunto informativo que define el problema predictivo. En este caso es correcto llamar «independientes» a los errores del modelo constante, aunque su media deje sin usar parte de la información accesible.
Qué reúne Ljung–Box y qué necesita su referencia
Ljung y Box (1978) propusieron una modificación del estadístico de Box–Pierce que mejora su aproximación en muestras finitas. Para un máximo de retardos,
Las autocorrelaciones entran al cuadrado, de modo que una asociación negativa contribuye tanto como una positiva del mismo tamaño. El factor que depende del retardo tiene en cuenta que los retardos mayores utilizan menos pares. Al condensar en una sola cantidad la evidencia de varios retardos, el estadístico pierde la localización que conservaba el correlograma.
En el uso habitual con residuos de un ARMA de órdenes y , ajustado bajo condiciones regulares y con innovaciones independientes de varianza constante, se emplea una referencia aproximada , que exige . La resta recoge el efecto de estimar los parámetros dinámicos. Esa referencia responde a una estructura y a una aproximación determinadas y deja sin respaldo el procedimiento de insertar cualquier modelo en la fórmula y restar mecánicamente todos sus parámetros.
En particular, la convención usual para ese ARMA resta los órdenes autorregresivo y de medias móviles sin añadir automáticamente una resta por la media ni otra por la varianza estimadas. Los modelos con regresores externos, componentes estacionales o estructuras de estado pueden necesitar un tratamiento específico. Cuando un programa incluye una opción llamada «grados de libertad del ajuste», su valor requiere una decisión fundada en el modelo que se está comprobando.
La aproximación depende también de la relación entre el número de observaciones, los órdenes y el máximo retardo. Un valor de apenas superior al número de parámetros dinámicos deja pocos grados de libertad y puede producir una referencia pobre. Uno excesivo incorpora muchas correlaciones imprecisas y puede diluir una desviación localizada. Por eso es preferible declarar el máximo retardo antes de examinar los resultados y justificarlo por las escalas temporales relevantes.
El valor de probabilidad asociado a describe cuán extremo sería ese estadístico bajo la referencia utilizada. Un valor pequeño indica discrepancia con ella. Uno grande puede deberse a que el modelo describe bien las correlaciones examinadas, a que la muestra es poco informativa o a que la discrepancia está en otra propiedad, como ocurre con una varianza cambiante, capaz de dejar las autocorrelaciones ordinarias cercanas a cero.
La referencia clásica se apoya en errores independientes, una condición más fuerte que la ausencia de correlación. Francq, Roy y Zakoïan (2005) estudian diagnósticos ARMA cuando los errores pueden ser dependientes aunque carezcan de correlación lineal. En ese marco la covarianza asintótica de las autocorrelaciones residuales puede cambiar y las pruebas ordinarias pueden comportarse mal, por lo que la hipótesis sobre las innovaciones forma parte del diagnóstico junto con la ecuación de la media.
Un retardo que el primer ajuste dejó fuera
Consideremos un experimento didáctico con datos simulados mediante
independientemente entre fechas. Los dos valores propios de la representación autorregresiva son aproximadamente y , ambos dentro del círculo unidad. Se generó una trayectoria desde valores iniciales nulos, se descartó el comienzo y se conservaron doscientas observaciones para el ajuste, junto con los dos valores anteriores necesarios para formar los retardos.
Con exactamente las mismas doscientas respuestas se ajustaron por mínimos cuadrados dos modelos con intercepto. El primero incluyó solo el valor inmediatamente anterior y el segundo añadió el de dos fechas antes. Las ecuaciones estimadas fueron
Los coeficientes difieren de los generadores porque se han estimado en una realización finita. El primer ajuste intenta recoger con un solo retardo parte de la información que corresponde al segundo. En ambos modelos la media residual es numéricamente cero, incluido el que omite una parte de la ecuación generadora.
La tabla reúne las autocorrelaciones calculadas con la convención anterior y el estadístico que agrupa los diez primeros retardos.
| Ajuste | Grados de libertad usados | Probabilidad aproximada | |||
|---|---|---|---|---|---|
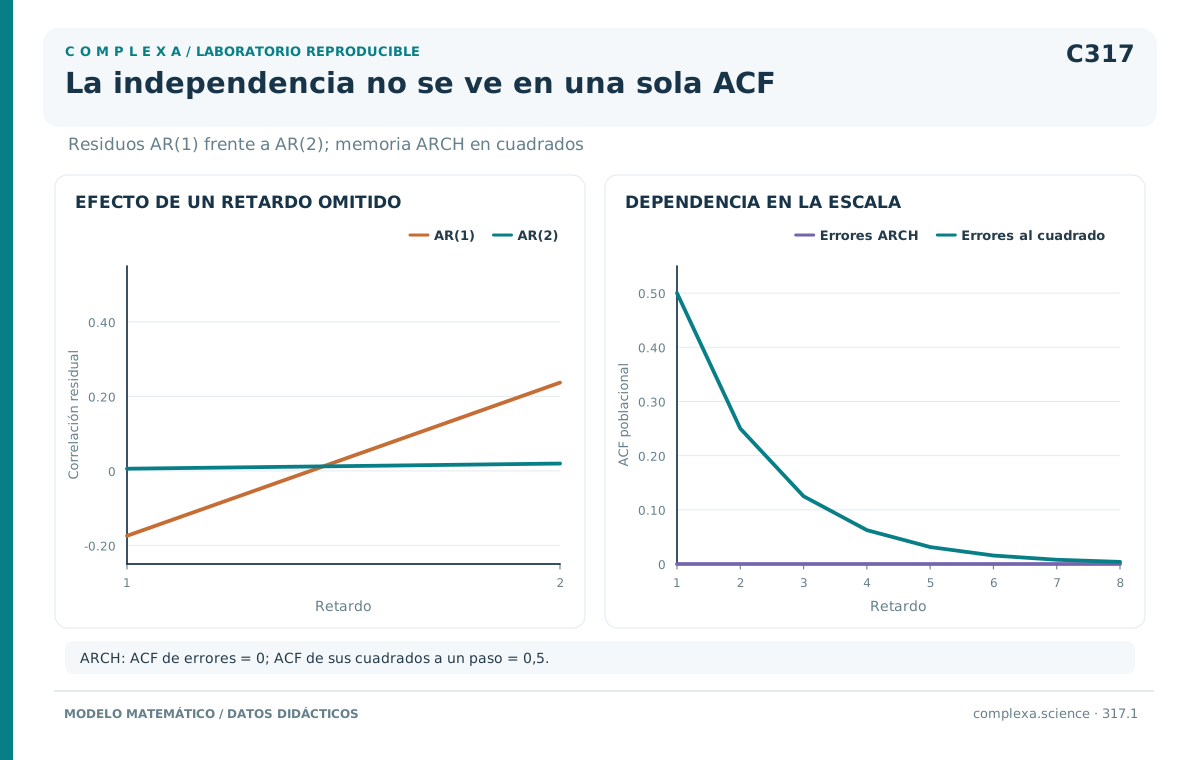
| AR(1) con intercepto | −0,1743 | 0,2370 | 25,6975 | 9 | 0,00229 |
| AR(2) con intercepto | 0,0058 | 0,0197 | 6,4977 | 8 | 0,59166 |
El primer ajuste deja una asociación positiva visible al segundo retardo y una negativa al primero, patrón que aparece entre los residuos pese a su ortogonalidad respecto de . Al incorporar el segundo retardo, ambas autocorrelaciones se reducen mucho y el conjunto examinado es compatible con la referencia utilizada.
Como aquí se conoce el mecanismo generador, puede explicarse exactamente qué información faltaba. En una serie observada, la misma mejora apoyaría una revisión de la estructura temporal sin identificar necesariamente una ecuación verdadera. Si, además, el segundo modelo se eligió después de mirar estos residuos, su diagnóstico posterior forma parte del proceso de selección y carece del valor de una validación independiente.
Los grados de libertad cambian el cálculo, aunque en este ejemplo la conclusión se mantiene. Con diez grados de libertad para ambos ajustes, las probabilidades serían aproximadamente y . El número que aparece en una salida informática depende de la referencia declarada además del valor de las autocorrelaciones. Si el registro dice únicamente «Ljung–Box satisfactorio», esta diferencia ya no puede reconstruirse.
Dependencia que se encuentra en los cuadrados
En el ejemplo siguiente los errores tienen media condicional cero, pero su escala evoluciona según
con independientes y normales estándar. Se trata de un ejemplo ARCH de primer orden, de la clase de modelos que Engle (1982) introdujo para representar varianzas condicionales que dependen del pasado, construido aquí para ilustrar la distinción entre correlación y dependencia.
La desviación típica es conocida cuando se condiciona en el pasado del proceso. Como tiene media cero y es independiente de ese pasado, se cumple también y, por la misma razón, la covarianza entre y cualquier error anterior es cero. El correlograma poblacional de los errores ordinarios no muestra, por tanto, ninguna memoria.
El valor esperado del cuadrado actual es, sin embargo, . Después de un error grande aumenta la variabilidad del siguiente. Dos distribuciones condicionales con medias iguales y varianzas diferentes bastan para descartar la independencia, porque el pasado informa sobre cuánto puede fluctuar la próxima observación.
En el régimen estacionario, la varianza incondicional satisface y vale, por consiguiente, uno. Existe también el cuarto momento, puesto que con innovaciones normales la condición correspondiente, , se cumple en este ejemplo. Al desarrollar el cuadrado de la varianza condicional y utilizar se obtiene
De ahí que la varianza de los errores al cuadrado sea ocho. Su covarianza al primer retardo vale cuatro, porque el coeficiente que transmite el cuadrado anterior es un medio, con lo que la autocorrelación de los cuadrados es , una dependencia fuerte y calculable que estaba fuera del alcance del correlograma ordinario.
El razonamiento depende de que exista el cuarto momento, porque solo así los cuadrados tienen varianzas finitas y sus correlaciones están bien definidas. Una distribución con colas suficientemente pesadas puede carecer de él aunque conserve una varianza ordinaria. El correlograma de cuadrados sigue pudiendo calcularse entonces en la muestra, si bien su precisión y su referencia habitual dejan de estar respaldadas por el mismo argumento.
McLeod y Li (1983) desarrollaron el diagnóstico de modelos ARMA mediante autocorrelaciones de residuos al cuadrado, una transformación que hace visible la clase de dependencia que el signo y la magnitud mezclaban en el producto ordinario. Como la transformación elegida define qué aspecto de la dependencia se está buscando, también pueden examinarse los valores absolutos, que reaccionan de otra manera a los episodios extremos.
Una media adecuada puede acompañarse de intervalos inadecuados
La consecuencia del ejemplo ARCH se aprecia al construir intervalos. Si el cuadrado del error anterior fue , la varianza condicional siguiente es . Si fue cuatro, pasa a . Bajo el modelo normal condicional y con parámetros conocidos, los intervalos centrales aproximados del noventa y cinco por ciento tienen las semiamplitudes diferentes que recoge la tabla.
| Cuadrado del error anterior | Varianza condicional | Desviación típica | Semiamplitud |
|---|---|---|---|
| 0,25 | 0,625 | 0,7906 | 1,5495 |
| 4,00 | 2,500 | 1,5811 | 3,0990 |
Si se utiliza siempre una semiamplitud de , con el argumento de que la varianza incondicional vale uno, las coberturas condicionales son de aproximadamente el y el en esas dos situaciones. La distribución incondicional tampoco es normal estándar, pues su cuarto momento vale nueve. Trasladar sin cambios un intervalo normal a la distribución agregada supone una normalidad que en este modelo solo existe de manera condicional.
El patrón que interesa diagnosticar es la concentración de los fallos de cobertura después de episodios grandes, que un porcentaje global de aciertos puede esconder. Para reconocerla ayuda agrupar los residuos según el nivel de incertidumbre previsto de antemano y estudiar sus magnitudes, siempre que cada grupo reúna suficientes observaciones.
Si se conoce la varianza del ejemplo, los residuos estandarizados coinciden con y son independientes normales estándar. En un ajuste real se utiliza . Después de estimar un modelo de varianza interesa comprobar tanto la autocorrelación ordinaria de esos residuos como la de sus cuadrados, además de la forma de su distribución. La desaparición de la correlación en cuadrados indicaría que se ha retirado esa señal particular de variabilidad predecible.
Una prueba habitual para buscar efectos ARCH parte de una regresión auxiliar de los residuos al cuadrado sobre un intercepto y varios de sus propios retardos. Si esos efectos están ausentes y se cumplen las condiciones de regularidad apropiadas, el tamaño efectivo de la regresión multiplicado por su coeficiente de determinación admite una referencia asintótica de tipo ji cuadrado. Los retardos incluidos determinan la alternativa examinada, por lo que una prueba con pocos retardos puede pasar por alto una dependencia de escala más lenta.
La situación cambia después de ajustar una ecuación de varianza, cuando los residuos estandarizados pasan a contener estimaciones tanto en el numerador como en el denominador. Tse (2002) muestra la necesidad de tener en cuenta ese efecto en diagnósticos basados en regresiones de residuos estandarizados al cuadrado y sus productos. Una referencia obtenida para errores observados puede atribuir a esas cantidades una precisión ficticia.
Un episodio aislado también puede inflar la autocorrelación de cuadrados. Conviene comprobar cuánto cambia el diagnóstico al examinar su influencia, conservando el resultado original. Una explicación sostenida de la varianza debería describir la sucesión de magnitudes y dar predicciones de escala contrastables. Añadir una ecuación de variabilidad solo para acomodar un punto requiere evidencia distinta de la presencia repetida de agrupamientos.
Una media incorrecta puede producir un efecto parecido. Si el nivel esperado cambia y el ajuste sigue prediciendo el nivel anterior, los residuos pasan a tener magnitudes grandes y signos persistentes, con cuadrados que también se agrupan. Ensanchar entonces los intervalos alrededor de la media antigua puede aumentar la cobertura sin corregir un sesgo identificable. Para distinguir esa situación del ejemplo ARCH, donde la media condicional permanece exactamente en cero, ayuda leer a la vez signos y magnitudes y acompañar el diagnóstico de la varianza con la comprobación de la media usada para construir sus residuos.
Residuos cuando la respuesta no es continua
La distribución de un residuo ordinario depende del tipo de respuesta. En un modelo para conteos, la diferencia entre el dato y su media puede tener una forma escalonada y una varianza que crece con el nivel esperado aun cuando el modelo esté correctamente especificado. Exigir a esas diferencias un histograma normal les impondría una propiedad ajena a la distribución propuesta.
Los residuos cuantílicos relacionan cada observación con su distribución ajustada. Para una respuesta continua, una transformación básica calcula su probabilidad acumulada y aplica después el cuantil normal correspondiente. Con la distribución verdadera y parámetros conocidos, esa probabilidad acumulada es uniforme. En una serie temporal ha de utilizarse la distribución condicional apropiada, porque una distribución marginal correcta puede coexistir con una dependencia temporal sin representar.
Dunn y Smyth (1996) proponen una aleatorización para respuestas discretas, cuya distribución acumulada tiene saltos. Considérese, como ejemplo didáctico, una variable que vale uno con probabilidad y cero con probabilidad . Su probabilidad acumulada evaluada en el dato toma solo dos valores, o uno, que no pueden formar una distribución uniforme.
Si se observa cero, se sortea un número con distribución uniforme entre cero y . Si se observa uno, el sorteo se hace entre y uno. La primera región recibe así probabilidad sobre una longitud y la segunda recibe probabilidad sobre una longitud , con lo que la mezcla tiene densidad uno en todo el intervalo. Al aplicar después el cuantil de la normal estándar se obtiene el residuo cuantílico aleatorizado.
En una serie binaria, donde la probabilidad del evento puede cambiar según el pasado, la construcción se repite con la probabilidad condicional de cada fecha y con aleatorizaciones independientes. Bajo las distribuciones condicionales correctas y conocidas se obtiene la referencia correspondiente. Cuando sus parámetros se estiman, reaparece el efecto de haber utilizado los datos para construir el residuo.
La aleatorización introduce una variación deliberada en el gráfico. Al repetirla se reconocen los patrones que persisten frente a los detalles producidos por un sorteo. La inspección temporal sigue siendo necesaria. Una distribución marginal aproximadamente normal de residuos cuantílicos es compatible con una secuencia dependiente, cuyo orden forma parte de la información que se pretende explicar.
Repetir el procedimiento, no solamente la fórmula
Cuando la referencia analítica es dudosa, el comportamiento del diagnóstico puede estudiarse mediante simulación bajo un modelo especificado. Se generan series con la longitud y el calendario de la serie original, cada una se ajusta mediante el mismo procedimiento y en todas se calcula el mismo estadístico. La comparación incorpora así efectos de estimación e inicialización que una referencia simple omite.
Para que esa comparación responda al análisis realizado, es preciso repetir los pasos que modifican sus resultados. Si el orden se eligió examinando varias alternativas, esa elección también puede formar parte de cada réplica. Es aconsejable reproducir igualmente cualquier regla utilizada para tratar ausencias o transformar observaciones. Simular errores verdaderos y compararlos con residuos estimados en la serie original volvería a ignorar la diferencia que motivó el diagnóstico.
Un bootstrap paramétrico basado en parámetros estimados aproxima una distribución que depende de parámetros desconocidos, así que da una prueba aproximada y específica del escenario simulado. Su utilidad está en representar explícitamente ese escenario y sus operaciones. Remuestrear residuos de manera independiente impone, por su parte, una estructura distinta de la que se obtiene al simular una varianza condicional dependiente, por lo que la forma de generar las réplicas debe corresponder a la hipótesis que se desea examinar.
La simulación tiene su propia incertidumbre numérica. Si una proporción de excedencias está cerca del cinco por ciento y se utilizan mil réplicas independientes, su error estándar binomial es de aproximadamente siete milésimas, suficiente para que dos ejecuciones sitúen el resultado a lados distintos de un umbral cercano sin que la serie haya cambiado. Esa variación disminuye al aumentar el número de réplicas, en tanto que guardar la semilla y el procedimiento hace reproducible cada ejecución. Un resultado que debe decidir entre probabilidades casi iguales exige más precisión que otro alejado del umbral.
Es mejor escoger el estadístico antes de generar sus réplicas. Si lo llamativo fue el pico máximo encontrado al recorrer muchos retardos, comparar únicamente ese retardo con una referencia puntual omite la búsqueda realizada. En cada serie simulada puede calcularse el máximo sobre el mismo conjunto de retardos, de manera que el máximo observado se compara con una distribución que responde a la pregunta que motivó la inspección. Otra opción es conservar la observación como hallazgo exploratorio y comprobar ese retardo concreto en un tramo posterior.
Tras una discrepancia, la revisión debería dirigirse al aspecto que la produjo. En el ejemplo autorregresivo, incluir el segundo retardo redujo una dependencia en la media. En el ejemplo ARCH, añadir más retardos lineales a una media ya condicionalmente nula dejaría intacta la diferencia entre coberturas, que requiere modelar y comprobar la escala.
Para esa segunda revisión puede fijarse una comprobación observable antes de recibir nuevos datos. Después de un error cuyo cuadrado sea cuatro, el modelo del ejemplo emitirá un intervalo con semiamplitud aproximada de , frente a una de después de uno cuyo cuadrado sea . Ambos pronósticos se guardarán con su fecha de emisión para que las observaciones siguientes muestren si el ensanchamiento previsto corresponde a la variabilidad que realmente aparece.
Referencias
Box, G. E. P., y Pierce, D. A. (1970). Distribution of residual autocorrelations in autoregressive-integrated moving average time series models. Journal of the American Statistical Association, 65(332), 1509–1526. https://doi.org/10.1080/01621459.1970.10481180
Dunn, P. K., y Smyth, G. K. (1996). Randomized quantile residuals. Journal of Computational and Graphical Statistics, 5(3), 236–244. https://doi.org/10.1080/10618600.1996.10474708
Engle, R. F. (1982). Autoregressive conditional heteroscedasticity with estimates of the variance of United Kingdom inflation. Econometrica, 50(4), 987–1007. https://doi.org/10.2307/1912773
Francq, C., Roy, R., y Zakoïan, J.-M. (2005). Diagnostic checking in ARMA models with uncorrelated errors. Journal of the American Statistical Association, 100(470), 532–544. https://doi.org/10.1198/016214504000001510
Ljung, G. M., y Box, G. E. P. (1978). On a measure of lack of fit in time series models. Biometrika, 65(2), 297–303. https://doi.org/10.1093/biomet/65.2.297
McLeod, A. I., y Li, W. K. (1983). Diagnostic checking ARMA time series models using squared-residual autocorrelations. Journal of Time Series Analysis, 4(4), 269–273. https://doi.org/10.1111/j.1467-9892.1983.tb00373.x
Tse, Y.-K. (2002). Residual-based diagnostics for conditional heteroscedasticity models. The Econometrics Journal, 5(2), 358–373. https://doi.org/10.1111/1368-423x.t01-1-00088