Durante cuatro días un indicador permanece elevado y después vuelve a su nivel anterior. En el registro completo el episodio parece delimitado con claridad. Quien recibió las mediciones día a día, en cambio, no sabía al principio si estaba ante una fluctuación, cuánto duraría ni si habría un retorno. Una segmentación retrospectiva puede usar ese retorno para localizar el comienzo del episodio. Una alarma emitida durante su desarrollo carecía de esa información.
Las fronteras dibujadas sobre una serie reúnen decisiones de este tipo. Dependen de qué propiedad se considera estable, qué variaciones se atribuyen al ruido y cuánto se exige para introducir otro segmento. Cuando esas decisiones quedan explícitas, un punto de cambio puede leerse como el resultado de una comparación estadística, aunque atribuirle un mecanismo requiere observaciones sobre el sistema y su proceso de medida.
La propiedad que se permite cambiar
Un modelo por segmentos divide las observaciones en tramos contiguos y asigna parámetros a cada uno. En la versión más sencilla, los tramos solo difieren en la media. Dentro de un segmento se supone que las fluctuaciones ocurren alrededor de un mismo nivel, con una estructura de error que también debe especificarse. La frontera estimada indica dónde es ventajoso sustituir ese nivel por otro.
La varianza puede cambiar aunque la media permanezca constante, como cuando un instrumento comienza a registrar valores mucho más dispersos alrededor de la misma referencia. También puede cambiar la dependencia. Si una fluctuación antes transitoria empieza a persistir durante varias mediciones, se altera la relación entre una observación y su pasado, un cambio ajeno a la pregunta que responde un procedimiento diseñado para detectar saltos de media.
La distinción puede comprobarse con dos bloques didácticos de seis observaciones. En el primero alternan menos uno y uno; en el segundo, menos tres y tres. Ambos promedios son cero. Por eso, en un ajuste que solo estima una media por bloque, colocar una frontera entre ellos deja la suma de cuadrados en sesenta, igual que sin ella. Las medias de los cuadrados son, sin embargo, uno y nueve, una diferencia de dispersión que el coste elegido tiene que representar.
Si estipulamos media conocida cero y errores normales independientes, podemos comparar una varianza común con dos varianzas, cuyas estimaciones de máxima verosimilitud serían cinco para el registro completo y uno y nueve para los bloques. En la escala de menos dos veces la logverosimilitud, omitidos los términos comunes, la mejora debida al corte es de aproximadamente , cantidad que aún debe compararse con una penalización apropiada. Detectar un cambio de varianza exige cambiar el modelo de segmento, cuyo coste deja entonces de tener las unidades de una suma de cuadrados sin normalizar.
Una tendencia gradual plantea otra elección. Aproximar una rampa mediante niveles constantes produce una escalera cuyos peldaños se multiplican al reducir la penalización. Esos cortes pueden comprimir el registro de manera útil aunque el sistema no haya cambiado bruscamente en ninguno de los peldaños. Una alternativa con pendiente continua puede describir los mismos datos con menos fronteras y con un significado temporal diferente.
Antes del ajuste conviene traducir la pregunta sustantiva a un parámetro cuya definición se mantenga estable, para no llamar «nuevo régimen» a cualquier diferencia que el programa encuentre. Una modificación sostenida del nivel corresponde a saltos de media y una alteración de la variabilidad, a un modelo para la escala. Para estudiar si cambió la influencia de una entrada sobre la respuesta puede segmentarse una regresión.
El coste de añadir una frontera
Denotemos las observaciones por . Por convención, una frontera será el índice de la última observación del tramo anterior, con lo que el segmento siguiente empieza en . Esa convención tiene que acompañar a las fechas que se informan. Una salida que dice «cambio en cuatro» puede referirse a un tramo nuevo que empieza en la quinta observación.
En un modelo de medias constantes, el coste de un segmento desde hasta , ambos incluidos, puede ser
La media del segmento minimiza la pérdida cuadrática. Con errores normales independientes de varianza común conocida, dividir este coste por esa varianza da, salvo constantes, una contribución a menos dos veces la logverosimilitud. Si se conserva la suma de cuadrados sin dividir, su escala depende de las unidades del indicador.
Para fronteras ordenadas, con extremos y , el criterio penalizado será
La penalización cobra por cada frontera. Sin ella, más segmentos suelen dar un ajuste mejor, porque dividir un tramo conserva la posibilidad de asignar a ambas partes la media anterior y añade otras posibilidades. En el extremo, si se admiten segmentos unitarios, cada observación puede tener su propia media y el error de ajuste se anula.
La penalización limita esa libertad y, con una suma de cuadrados en unidades físicas, también se expresa en unidades cuadradas. Si los datos se multiplican por cien, los costes lo hacen por diez mil y la penalización debe transformarse de manera coherente para conservar la misma decisión. Con un coste de verosimilitud normalizado la comparación se expresa en otra escala, por lo que trasladar una cifra de penalización entre ambos criterios sin conversión modifica el problema.
A la penalización se suma una longitud mínima , el menor número de observaciones que puede contener un segmento. La restricción puede reflejar la duración mínima de un episodio de interés o la cantidad de datos necesaria para estimar sus parámetros. Su función es distinta de la que cumple la penalización. Una frontera que mejora mucho el ajuste puede quedar excluida si produce un tramo demasiado corto.
La duración tiene que traducirse al calendario. Cinco observaciones horarias cubren un lapso muy distinto del de cinco observaciones semanales y, si el muestreo es irregular, cinco registros pueden abarcar duraciones muy diferentes dentro de la misma serie. En ese caso puede interesar imponer una duración mínima, una cantidad mínima de registros o ambas condiciones, elección de la que depende el conjunto de segmentaciones permitidas.
Debe considerarse también cuántos parámetros se intenta estimar dentro de cada tramo. Una única observación determina su propia media, pero con ella no puede estimarse de manera útil una varianza independiente. En el modelo normal con media y varianza libres por segmento, un tramo constante puede llevar la estimación de la varianza a cero y hacer que la verosimilitud crezca sin límite. El problema surge antes de interpretar ninguna frontera, pues el coste que se quería optimizar ya no tiene un mínimo finito de menos logverosimilitud.
En el ejemplo cuadrático, la varianza común conocida evita esa degeneración, que otras formulaciones pueden controlar con un límite inferior para la varianza, con información compartida entre tramos o con distribuciones previas apropiadas. Cada solución introduce una condición que debe figurar junto al resultado. Añadir un número pequeño al denominador para que el programa continúe también modifica el criterio, aunque se presente como un detalle técnico.
La elección de la penalización admite un control complementario. Si existe un modelo de referencia sin cambios, pueden generarse registros completos bajo ese modelo y aplicarles toda la búsqueda para observar con qué frecuencia el procedimiento introduce fronteras con cada penalización candidata. Esas simulaciones conservan la longitud del registro, el muestreo y la dependencia que se consideren relevantes.
El ejercicio calibra el comportamiento bajo la referencia especificada. Para estudiar la sensibilidad a cambios hace falta generar alternativas con duraciones y magnitudes definidas, ya que una penalización que casi nunca segmenta ruido puede perder episodios breves que sí interesan. Comparar ambos comportamientos ayuda a elegir una regla antes de examinar el registro reservado para evaluar su desempeño.
Un episodio que necesita dos cortes
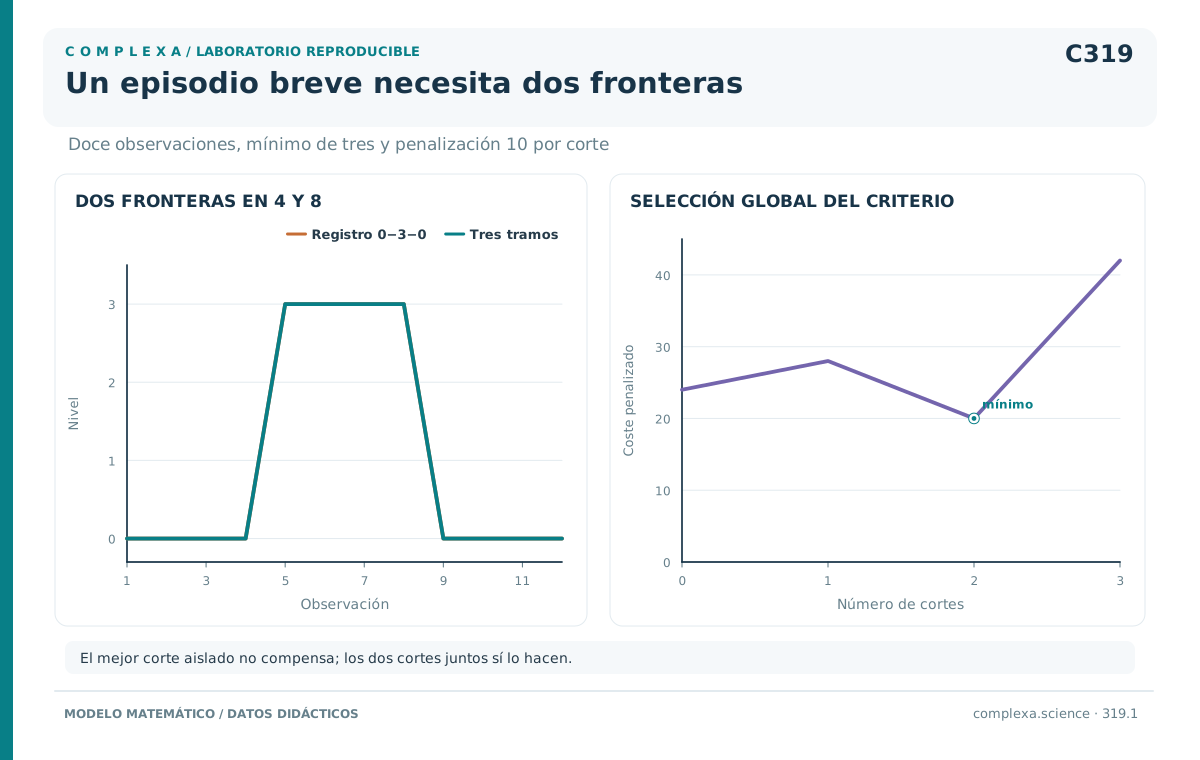
Consideremos ahora el registro didáctico
No procede de mediciones reales. Su forma sirve para comprobar exactamente la competencia entre segmentaciones, sin fluctuaciones que oculten la aritmética. Usaremos suma de cuadrados, longitud mínima de tres observaciones y penalización de diez por frontera.
Sin cortes, la media global es uno. Los ocho ceros contribuyen con una unidad cada uno y los cuatro treses con cuatro, así que el coste total es veinticuatro. Con un solo corte la mejor posición es después de la cuarta o de la octava observación y en ambos casos queda un tramo que mezcla valores cero y tres, con coste dieciocho.
Con dos cortes después de las observaciones cuarta y octava quedan tres segmentos constantes de cuatro observaciones, que cumplen la longitud mínima y dejan un coste residual nulo. Con tres cortes, la única posibilidad es dividir las doce observaciones en cuatro tramos de tres, con fronteras en tres, seis y nueve y una suma de cuadrados de doce.
| Número de fronteras | Mejor coste residual | Penalización total | Criterio |
|---|---|---|---|
| 0 | 24 | 0 | 24 |
| 1 | 18 | 10 | 28 |
| 2 | 0 | 20 | 20 |
| 3 | 12 | 30 | 42 |
La tabla procede de comparar las diecinueve particiones que cumplen la longitud mínima y conserva en cada fila la mejor para ese número de fronteras. La solución global introduce dos cortes y reconoce el bloque central.
Una búsqueda que comenzara con el mejor corte único encontraría una reducción residual de seis y, si exigiera que esa reducción superase la penalización de diez antes de continuar, se detendría sin segmentar. El episodio completo mejora el ajuste en veinticuatro a cambio de dos penalizaciones, pero ninguna frontera aislada consigue justificar el primer paso de esa regla.
El fallo se debe a que, con un solo corte, los valores del bloque elevado siguen compartiendo segmento con uno de los bloques bajos. Hace falta la segunda frontera para separar el episodio de ambos lados. Los métodos que optimizan conjuntamente las posiciones pueden captar esa interacción, mientras que una estrategia voraz necesita otras condiciones o mecanismos para no perderla.
Puede examinarse también todo el recorrido de la penalización, a lo largo del cual los mejores criterios son veinticuatro sin cambios, con uno y con dos. La opción de tres queda dominada para toda penalización positiva. Si la penalización es menor que doce, ganan los dos cortes; si es mayor, gana el registro sin cortes. Exactamente en doce hay empate. Aquí, una sola frontera nunca es óptima.
El resultado muestra que, al aumentar gradualmente la penalización, dos fronteras pueden desaparecer a la vez. Que las posiciones se mantengan durante un intervalo amplio de penalizaciones indica estabilidad frente a esa decisión de análisis, una propiedad distinta de la probabilidad de que las fronteras sean verdaderas.
Si exigimos ahora cinco observaciones por segmento, el episodio central de cuatro queda fuera del espacio permitido y solo son posibles cero o una frontera. El mejor coste con una frontera, alcanzado después de la quinta o de la séptima observación, es aproximadamente . Al sumarle la penalización de diez gana el modelo sin cambios, con lo cual la ausencia de un segmento central se debe aquí a la definición de duración mínima.
Buscar exactamente el criterio definido
La programación dinámica encuentra el mínimo sin enumerar por separado todas las combinaciones. Con ese fin guarda, para cada extremo del registro, el mejor coste que puede obtenerse hasta allí. Toda solución completa termina con algún último segmento y, conocido su comienzo, la parte anterior puede sustituirse por la mejor solución ya calculada para ese prefijo.
Si es el mínimo del criterio para las primeras observaciones y se adopta la convención de penalizar fronteras, se inicializa y se evalúa
considerando solo comienzos que respeten la longitud mínima y prefijos que admitan una partición válida. La inicialización negativa cancela la penalización del primer segmento. Si se guarda además qué comienzo alcanza cada mínimo, las fronteras se recuperan retrocediendo desde el último dato.
El algoritmo es exacto respecto del coste y de las restricciones especificadas, como puede comprobarse en el ejemplo pequeño comparando su resultado con la enumeración de las diecinueve particiones. Esa exactitud es independiente de que el indicador real siga el modelo de medias constantes, porque también un criterio inadecuado puede minimizarse con perfecta precisión.
Killick, Fearnhead y Eckley (2012) desarrollaron PELT, que acelera esta búsqueda descartando, bajo una condición sobre el coste, los candidatos que ya no pueden mejorar una solución futura. Cuando esa condición se cumple, la poda conserva el óptimo. El comportamiento computacional lineal que estudian requiere además supuestos sobre los segmentos y la ganancia de ajuste que no toda serie o penalización satisface.
La distinción entre exactitud y velocidad debe tenerse presente al interpretar una salida informática, en la que «óptimo» puede significar el mínimo global del criterio elegido, cosa distinta de haber recuperado un número verdadero de regímenes. Tampoco es exacta, en ese sentido, una implementación que para acelerar ha limitado de forma adicional las posiciones candidatas.
Buscar cortes solo cada siete días, por ejemplo, excluye todas las demás fechas. Si una frontera real cayera en miércoles y los candidatos fueran lunes, el ajuste tendría que aproximarla. La restricción puede ser razonable para decisiones semanales, pero debe constar al describir la resolución temporal, pues la rapidez se ha conseguido en parte resolviendo un problema más restringido.
Un valor extremo también puede fabricar un tramo
Sustituyamos ahora el episodio de cuatro observaciones por un único valor doce en la sexta posición, con ceros en las otras once, conservando la longitud mínima de tres y la penalización de diez. Sin cambios, la media es uno y la suma de cuadrados es ciento treinta y dos.
La mejor solución con una frontera tiene coste residual ciento veinte. Con dos fronteras, el valor extremo puede quedar dentro de un bloque de tres observaciones junto a dos ceros. Su media es cuatro. El extremo contribuye con sesenta y cuatro unidades y cada cero con dieciséis, por lo que el coste residual del tramo es noventa y seis. Los segmentos exteriores son constantes.
El criterio penalizado de esa solución vale ciento dieciséis y mejora el del registro sin cambios. El bloque de tres admite tres ubicaciones igualmente buenas, las observaciones cuarta a sexta, quinta a séptima o sexta a octava. La longitud mínima ha impedido un segmento unitario, pero el único valor extremo sigue bastando para introducir dos fronteras.
El resultado se debe a la pérdida cuadrática, en la que la contribución de una desviación aumenta sin límite con su magnitud. Fearnhead y Rigaill (2019) estudiaron este problema y desarrollaron segmentaciones con pérdidas acotadas, en las que alejar todavía más una observación deja de aumentar indefinidamente el beneficio de aislarla.
Si se reemplaza el cuadrado del residuo por su mínimo con cuatro y se conserva un único segmento centrado en cero, los once ceros tienen coste nulo y el extremo cuesta cuatro. Cualquier segmentación con una frontera o más paga al menos diez de penalización más un coste residual no negativo, así que ninguna puede ganar al segmento único. La conclusión se obtiene con una cota, sin recorrer todas las medias posibles de cada segmentación.
La modificación cambia qué discrepancias se consideran informativas para segmentar. Con pérdida acotada, una agrupación suficientemente larga de valores distintos puede seguir justificando un nuevo tramo, situación que el propio análisis de Fearnhead y Rigaill distingue de la protección frente a un extremo aislado. El resultado sigue dependiendo de la persistencia de las observaciones y de la escala elegida para acotar la pérdida.
El tratamiento robusto tampoco decide si el extremo es un error o un acontecimiento real y breve que interesa estudiar como tal. Si es lo segundo, conviene conservarlo en el registro y separar dos productos del análisis, la descripción del nivel sostenido y la de los acontecimientos puntuales. Borrar el dato para obtener una segmentación más limpia eliminaría precisamente la información con la que podría investigarse el episodio.
Las fluctuaciones pueden durar sin que cambie la media
Una secuencia de valores altos es más sorprendente bajo errores independientes que bajo errores persistentes, porque en el segundo caso una perturbación puede prolongarse durante varios instantes aunque la media del proceso permanezca constante. Si el coste ignora esa dependencia, un bloque de fluctuaciones correlacionadas puede parecer un nuevo nivel.
Tomemos un proceso autorregresivo estacionario de primer orden con media cero, coeficiente y varianza marginal uno. La covarianza entre observaciones separadas por posiciones es y, para conseguir esa varianza marginal, la innovación independiente debe tener varianza . Es un modelo didáctico de ruido persistente, sin saltos de media.
La varianza del promedio de veinte observaciones consecutivas es
Bajo independencia y con la misma varianza marginal sería . La media de un bloque fluctúa, por tanto, mucho más de lo que sugiere contar veinte valores como veinte réplicas independientes, con una varianza unas siete veces mayor. Un criterio calibrado para el caso independiente puede recompensar en exceso la división en niveles.
El cálculo se refiere al promedio de un único bloque y no da directamente una penalización válida para todas las fronteras, porque las diferencias entre bloques dependen también de sus covarianzas, de sus tamaños y de la búsqueda realizada. Multiplicar cualquier penalización por siete trasladaría una comparación concreta a otro problema sin derivarla.
Lavielle y Moulines (2000) estudiaron la estimación de cambios de media en clases de procesos dependientes, con condiciones sobre las fluctuaciones acumuladas y sobre la convergencia de los estimadores. Su trabajo muestra que la dependencia puede incorporarse a la teoría de segmentación. Las condiciones apropiadas forman parte del resultado, por sencilla que sea la expresión del coste.
En la práctica puede especificarse un modelo del ruido para calcular un coste que tenga en cuenta esa estructura, o bien calibrarse el procedimiento mediante simulaciones del modelo sin cambios que se desea usar como referencia. En ambos casos los parámetros del ruido deben estimarse con cuidado. Ajustar una única autocorrelación a una serie con saltos fuertes puede atribuir al ruido una persistencia que pertenece a los cambios.
La operación inversa también requiere atención. Filtrar una serie para reducir su dependencia transforma la forma de un salto. Una diferencia, por ejemplo, convierte una elevación sostenida en un impulso al comienzo y otro al final. Segmentar la serie filtrada con el mismo significado que la original confundiría objetos distintos. Conviene dejar escrito qué patrón de observaciones debe producir un cambio bajo cada transformación.
Buscar una frontera cambia la pregunta estadística
Supongamos que una fecha estaba fijada antes de observar los datos, quizá por una modificación documentada del instrumento. Bajo un modelo normal independiente con varianza conocida, los promedios anterior y posterior pueden compararse con una distribución de referencia establecida para esa fecha. Si en cambio se prueban todas las fechas y se elige la que maximiza la diferencia, el contraste que finalmente se presenta ya fue seleccionado por ser extremo.
Aplicar a ese contraste la referencia del corte fijado de antemano ignora la búsqueda. Incluso con una media constante habrá alguna fecha con la mayor diferencia observada, de modo que la selección concentra la atención en fluctuaciones favorables a la hipótesis de cambio. La descripción posterior del corte no le devuelve la condición de haber sido fijado antes de mirar.
Jewell, Fearnhead y Witten (2022) desarrollaron pruebas de cambios de media que consideran la selección de las fronteras en los mismos datos. Sus resultados principales suponen errores normales independientes y varianza conocida, con una inferencia condicionada a información del procedimiento que seleccionó la frontera. Con una varianza estimada, las garantías requieren argumentos adicionales y la misma exactitud finita deja de ser automática.
También hay que precisar el objeto contrastado, que puede ser la diferencia de medias entre dos segmentos vecinos o entre ventanas situadas a ambos lados de una frontera estimada. Una prueba de ese contraste se pronuncia sobre la diferencia de medias sin asignar probabilidad alguna a que la fecha exacta sea correcta. Dos ventanas pueden tener promedios semejantes aun cuando contengan variaciones internas que se compensan.
Las incertidumbres que suelen mezclarse en una única línea vertical deben separarse. Puede haber dudas sobre si existe algún cambio, sobre cuántos hay, sobre sus posiciones y sobre la magnitud de los saltos. Una localización muy estable, condicionada a que existan dos fronteras, puede coexistir con un apoyo considerable al modelo sin cambios, que un informe limitado al intervalo de localización dejaría oculto.
Una descripción bayesiana conserva distribuciones sobre particiones y parámetros. Fearnhead (2006) mostró cómo realizar inferencia y simulación posterior exactas para una clase de modelos cuya estructura de independencia entre segmentos admite recurrencias. El enfoque cuantifica la incertidumbre en número y posiciones, con resultados que siguen condicionados al modelo de observación y a las distribuciones previas sobre los cambios.
Cuando se admiten varios cambios, las probabilidades marginales de una frontera en cada posición suman el número posterior esperado de fronteras, que no tiene por qué ser uno. Dos posiciones vecinas pueden recibir probabilidad por ser alternativas para localizar un mismo salto, sin que se esperen dos saltos consecutivos. Leer esas probabilidades exige, por eso, tener presente cómo se distribuyen las particiones completas.
La variabilidad puede investigarse también repitiendo todo el procedimiento en series generadas por un modelo especificado. Cada repetición tiene que volver a seleccionar número y posiciones si esa selección forma parte del análisis. Mantener fijos los cortes originales y estimar solo sus medias responde a una incertidumbre condicionada más estrecha. Cuando el ruido es dependiente, generar observaciones independientes cambiaría la referencia que se pretende evaluar.
En el ejemplo de los doce valores, cuyo bloque central era deliberadamente nítido, el cálculo identifica el mínimo de un criterio y deja las fechas sin cobertura probabilística. Añadir intervalos o probabilidades exigiría especificar el mecanismo de ruido y el procedimiento inferencial, tarea adicional que queda oculta cuando una diferencia de costes se convierte automáticamente en un nivel de confianza.
La alarma llega después de las primeras señales
Una segmentación retrospectiva usa el registro hasta su último instante para colocar fronteras en cualquier posición anterior y, cuando llegan observaciones nuevas, puede revisar una frontera que parecía estable. Esa revisión es coherente con su objetivo, que es reconstruir el pasado con la información ahora disponible.
En vigilancia secuencial, en cambio, el instante de alarma solo puede depender de los datos recibidos hasta entonces. Lo que se evalúa es cuánto tarda el detector en señalar cambios de interés y con qué frecuencia avisa cuando no los hay. La fecha estimada de comienzo y la fecha de emisión de la alarma son variables distintas.
El esquema de sumas acumuladas asociado a Page (1954) ilustra esta diferencia. Supongamos observaciones normales independientes de varianza conocida uno en las que interesa detectar un desplazamiento de la media de cero a uno. El logaritmo de la razón de densidades a favor de la segunda media frente a la primera es , una cantidad cuya acumulación reúne evidencia de varias observaciones.
Una versión unilateral, que reinicia la acumulación cuando esta se vuelve negativa, se define por
La alarma se emite la primera vez que el estadístico alcanza o supera un umbral . El reinicio evita que una larga historia compatible con la media inicial imponga una deuda indefinida a un cambio reciente. La alternativa de media uno fija la magnitud de desplazamiento hacia la que se orienta el detector.
Con la secuencia didáctica de seis lecturas y umbral dos, el estadístico vale sucesivamente cero, cero, medio, uno, uno y medio y, por último, dos. La alarma llega en la sexta observación. Como los valores elevados comenzaron en la tercera, se necesitaron cuatro lecturas del nivel nuevo para alcanzar el umbral y la diferencia entre comienzo y alarma es de tres posiciones.
El umbral de este cálculo se eligió para mostrar el mecanismo, sin calibrarlo para una tasa especificada de falsas alarmas. Reducirlo adelantaría algunas señales, pero también haría más fácil que fluctuaciones bajo la media inicial produjeran un aviso. Aumentarlo desplaza el compromiso en sentido contrario. En el resultado influyen además el tamaño del cambio, la dependencia y la incertidumbre sobre el nivel inicial.
El diseño puede evaluarse con el tiempo medio hasta una falsa alarma bajo un proceso estable y con la demora ante cambios definidos, o también con las probabilidades de aviso dentro de un horizonte de vigilancia. Estas medidas responden a compromisos operativos diferentes. Un detector que se aplica de manera reiterada requiere sus propias tasas, distintas del porcentaje calculado para una inspección aislada.
La regla de reinicio después de una alarma forma parte del procedimiento. Puede requerir revisar el instrumento, recopilar un nuevo periodo de referencia o seguir vigilando con otra hipótesis. Si se reinicia de inmediato con los mismos parámetros, el número de alarmas de una campaña puede ser muy distinto del que produce una regla que se detiene tras el primer aviso.
La evaluación histórica de un detector exige reconstruir el registro como una sucesión de prefijos, en cada uno de los cuales se emplean solo los datos y las decisiones disponibles hasta ese punto. Ajustar la media de referencia con toda la serie y simular después que se conocía desde el comienzo introduce información posterior. Lo mismo ocurre cuando el umbral se elige porque reproduce especialmente bien episodios ya identificados en el tramo de evaluación.
La comparación retrospectiva sirve para estudiar las alarmas ya emitidas, por ejemplo midiendo cuánto separa cada una del comienzo que se estima con más datos. Al informar del tiempo de anticipación, sin embargo, la fecha que cuenta es la del aviso. En la secuencia anterior, situar el cambio después de la segunda observación sigue siendo compatible con que la señal operativa solo llegara al observar la sexta.
Qué puede afirmarse sobre los tramos
Una frontera estimada puede coincidir con una modificación documentada del proceso. Esa concordancia es informativa, aunque para atribuir la frontera a esa modificación es preciso comprobar también cambios en calibración, cobertura, composición de las unidades observadas o reglas de registro. Una media agregada puede variar porque cambió la población medida, aun cuando cada unidad conserve su comportamiento.
La fecha de una modificación conocida da lugar a una comparación distinta de la exploración libre, ya que puede fijarse como candidata por razones externas y las observaciones cercanas pueden estudiarse con un modelo explícito. Si se revisaron muchas modificaciones posibles después de ver las fronteras, esa búsqueda también pertenece al análisis. La explicación histórica debe dejar constancia de cómo se eligió la correspondencia.
La frecuencia de observación limita la localización. Un salto entre dos lecturas instantáneas puede asignarse al intervalo que las separa, sin que se conozca su instante dentro de él. Si cada lectura integra actividad durante un periodo, una transición dentro de ese periodo puede producir un valor intermedio. La frontera del modelo discreto resume entonces una mezcla temporal cuya interpretación debe tener en cuenta el mecanismo de adquisición.
Para el episodio central de nuestro ejemplo, un informe reproducible conservaría los doce valores, la pérdida cuadrática, la penalización de diez y la longitud mínima de tres. Declararía fronteras después de las observaciones cuarta y octava, de modo que el bloque elevado abarca de la quinta a la octava. Haría constar además que una búsqueda limitada al primer corte habría devuelto otra respuesta y que exigir cinco observaciones por tramo excluye el episodio.
Si la tarea fuera vigilar episodios semejantes a medida que aparecen, ese informe todavía no definiría un detector. Para ello habría que elegir una referencia inicial, una regla de acumulación y un umbral, que se evaluarían recorriendo los prefijos. El registro operativo guardaría tanto la fecha de alarma como la localización reconstruida después, con lo cual podría verificarse en cada episodio qué parte de la evidencia estaba disponible cuando se tomó la decisión.
Referencias
Fearnhead, P. (2006). Exact and efficient Bayesian inference for multiple changepoint problems. Statistics and Computing, 16(2), 203–213. https://doi.org/10.1007/s11222-006-8450-8
Fearnhead, P., & Rigaill, G. (2019). Changepoint detection in the presence of outliers. Journal of the American Statistical Association, 114(525), 169–183. https://doi.org/10.1080/01621459.2017.1385466
Jewell, S., Fearnhead, P., & Witten, D. (2022). Testing for a change in mean after changepoint detection. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 84(4), 1082–1104. https://doi.org/10.1111/rssb.12501
Killick, R., Fearnhead, P., & Eckley, I. A. (2012). Optimal detection of changepoints with a linear computational cost. Journal of the American Statistical Association, 107(500), 1590–1598. https://doi.org/10.1080/01621459.2012.737745
Lavielle, M., & Moulines, E. (2000). Least-squares estimation of an unknown number of shifts in a time series. Journal of Time Series Analysis, 21(1), 33–59. https://doi.org/10.1111/1467-9892.00172
Page, E. S. (1954). Continuous inspection schemes. Biometrika, 41(1–2), 100–115. https://doi.org/10.1093/biomet/41.1-2.100