Una persona puede terminar representando a cincuenta en un análisis ponderado. Eso no significa que el archivo haya ganado cuarenta y nueve observaciones independientes. Significa que se ha atribuido a esa observación una contribución grande para reconstruir una población que el grupo observado no representa por sí mismo. Cuando muy pocas personas sostienen una parte considerable de la comparación, conviene averiguar qué población se intenta reconstruir y por qué casi no hay observaciones que puedan representarla.
El peso grande puede ser una consecuencia correcta del mecanismo de asignación. También puede aparecer por errores al modelarlo. Incluso puede faltar precisamente donde el problema es más grave: una combinación de tratamiento y características completamente ausente no aporta ninguna fila a la que asignar un peso extremo. Interpretar los pesos exige conectar la operación numérica con las decisiones que originaron los datos.
La población antes que la fórmula del peso
Sea una intervención binaria decidida al comienzo del seguimiento, un conjunto de características anteriores a esa decisión y un resultado posterior. Los resultados potenciales y corresponden a las dos alternativas bien definidas. Para estimar su diferencia promedio en toda la población inicial, necesitamos que las comparaciones observadas permitan representar ambos resultados en esa misma población.
La intercambiabilidad condicional afirma que, dado , la asignación no contiene información adicional sobre los resultados potenciales. La consistencia vincula el resultado observado con el potencial correspondiente a la intervención recibida. La positividad exige que las alternativas necesarias para el contraste puedan observarse dentro de los perfiles incluidos en su población objetivo. Cole y Hernán (2008) examinan cómo estas condiciones y la especificación de los modelos intervienen en la construcción de pesos.
Definimos el puntaje de propensión como . Para representar toda la población, una observación tratada recibe peso y una no tratada recibe . Si solo una de cada cincuenta personas con cierto perfil recibe la intervención, cada integrante tratado de ese perfil debe compensar esa escasez relativa. La operación intenta reconstruir la distribución inicial de características en ambos brazos.
La identidad poblacional que lo permite es
Para la primera igualdad, al promediar inicialmente dentro de cada valor de , la probabilidad de recibir tratamiento cancela el denominador. Queda la media observada entre tratados de ese perfil. La intercambiabilidad y la consistencia permiten interpretarla como la media potencial bajo tratamiento. Finalmente se promedia sobre la distribución original de . La cancelación algebraica necesita que el denominador sea positivo donde se requiere ese resultado.
En una muestra se puede dividir la suma ponderada por el número original de personas, siguiendo una forma de Horvitz–Thompson, o normalizar por la suma de pesos de cada brazo, siguiendo una forma de Hájek. Estas operaciones comparten un objetivo bajo condiciones adecuadas, pero no tienen que coincidir exactamente en una muestra cualquiera. La segunda mantiene una media ponderada dentro del rango observado; introduce un cociente cuyo comportamiento debe tenerse en cuenta al estudiar su incertidumbre.
Una tabla donde las colas sostienen la comparación
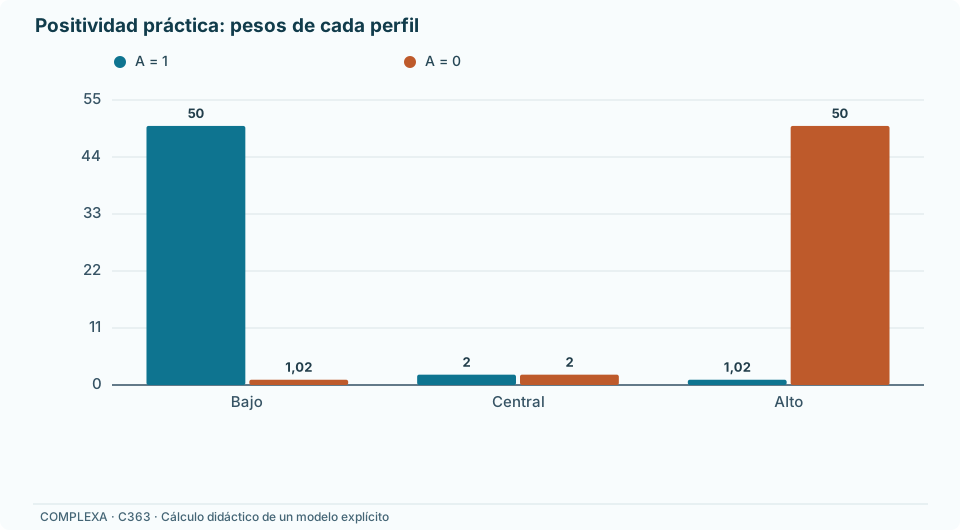
Consideremos una población didáctica de diez mil personas, repartidas entre tres perfiles basales. No representa pacientes ni evalúa una intervención real. El resultado es binario y favorable. Se han construido los recuentos para que, dentro de cada perfil, la asignación conserve exactamente las proporciones de los tipos de resultados potenciales. Así podemos estudiar los pesos sin confundir sus efectos con fluctuaciones de un sorteo particular.
| Perfil | Población | Propensión | Tratados: respuestas/personas | No tratados: respuestas/personas |
|---|---|---|---|---|
| Bajo | 2500 | 0,02 | 30/50 | 245/2450 |
| Central | 5000 | 0,50 | 1250/2500 | 1000/2500 |
| Alto | 2500 | 0,98 | 1960/2450 | 30/50 |
Las probabilidades potenciales de respuesta sin intervención son, respectivamente, diez, cuarenta y sesenta por ciento. Con intervención son sesenta, cincuenta y ochenta por ciento. Los efectos por perfil son cincuenta, diez y veinte puntos porcentuales. Una construcción individual compatible contiene únicamente personas que responden bajo ambas opciones, personas que responden solo con intervención y personas que no responden bajo ninguna. La asignación toma la misma fracción de cada tipo dentro de cada perfil.
En conjunto hay cinco mil tratados y cinco mil no tratados. Ese equilibrio global oculta que el perfil bajo aporta solo cincuenta tratados y el alto solo cincuenta controles. Las respuestas agregadas son tres mil doscientas cuarenta y mil doscientas setenta y cinco. La diferencia cruda entre probabilidades es . Los grupos están mezclando perfiles con pronósticos diferentes.
Los pesos tratados son cincuenta, dos y aproximadamente uno coma cero dos en los tres perfiles. Los controles reciben esos valores en orden inverso. Después de ponderar, ambos brazos representan dos mil quinientas personas del perfil bajo, cinco mil del central y dos mil quinientas del alto. Sus sumas de pesos son diez mil cada una. Las medias ponderadas son sesenta por ciento con intervención y treinta y siete coma cinco por ciento sin ella.
El efecto promedio de toda la población es, por tanto, veintidós coma cinco puntos porcentuales. También se obtiene directamente al combinar los tres efectos: una cuarta parte de cincuenta puntos, la mitad de diez y una cuarta parte de veinte. En este ejemplo, la suma de pesos coincide con el tamaño inicial, de modo que las dos normalizaciones mencionadas producen el mismo resultado. Esa coincidencia procede de los recuentos construidos.
Cada uno de los cincuenta tratados del perfil bajo aporta un peso de cincuenta sobre una suma de diez mil. Cambiar una respuesta individual de cero a uno elevaría la media tratada en medio punto porcentual. El mismo cambio entre los tratados centrales la elevaría en dos centésimas de punto. La primera observación tiene veinticinco veces más influencia directa en esta media, aunque ambas ocupen una sola fila.
Qué cambia al estabilizar
Para una intervención basal binaria, los pesos estabilizados habituales sustituyen el numerador uno por la probabilidad marginal de recibir la alternativa observada. Si , se usan entre tratados y entre controles. En la tabla, ambas probabilidades marginales son un medio. Todos los pesos quedan reducidos a la mitad y la suma de cada brazo pasa de diez mil a cinco mil.
El máximo se reduce de cincuenta a veinticinco. Sin embargo, al calcular una media normalizada dentro de cada brazo, ese factor común aparece tanto en el numerador como en el denominador y se cancela. Las medias continúan siendo sesenta y treinta y siete coma cinco por ciento. La contribución relativa de una observación extrema tampoco cambia: veinticinco sobre cinco mil equivale a cincuenta sobre diez mil.
Esta comparación precisa el sentido de estabilizar en ese cálculo. La escala numérica de los pesos cambia, pero la concentración relativa dentro de cada brazo permanece igual. No sería correcto anunciar una reducción de la sensibilidad de esas dos medias solo porque el máximo bajó. Tampoco se deben introducir los pesos estabilizados en una fórmula con denominador fijo y asumir que la misma identidad sigue vigente sin ajustar sus factores.
La distinción importa al leer aplicaciones longitudinales. Allí los pesos suelen ser productos de probabilidades a lo largo de una historia. Los numeradores pueden depender de tratamientos anteriores o de determinadas variables basales. Ya no constituyen necesariamente una constante común entre todas las personas que reciben la misma intervención actual. Cole y Hernán (2008) señalan además que incluir variables basales en el numerador puede requerir conservarlas en el modelo del resultado ponderado.
Una secuencia de seis decisiones, cada una con probabilidad condicional de un quinto para la opción efectivamente seguida, produce un factor inverso de quince mil seiscientos veinticinco. Si los numeradores correspondientes fueran todos un medio, el producto estabilizado sería aproximadamente doscientos cuarenta y cuatro. La reducción es grande, pero la trayectoria puede seguir dependiendo de muy pocas observaciones. Para interpretar esos productos hay que especificar qué historias se comparan y qué variables permanecen en cada numerador.
Una ausencia estructural y una celda vacía no dicen lo mismo
La positividad pertenece a la distribución de asignación y al contraste solicitado. Una prohibición que impide intervenir en cierto perfil produce una probabilidad cero incluso con registros ilimitados. Una muestra pequeña también puede contener cero tratados en un perfil cuya probabilidad poblacional es positiva. Westreich y Cole (2010) distinguen estas situaciones y muestran por qué su interpretación requiere conocer el proceso que genera los datos.
Como ejemplo separado de la tabla construida, supongamos que se observa una muestra de cincuenta personas de un perfil y que cada una recibe tratamiento independientemente con probabilidad de dos por ciento. La probabilidad de no observar ningún tratado es , aproximadamente treinta y seis coma cuatro por ciento. Una celda vacía resulta bastante plausible sin que el tratamiento sea imposible. Obtener más observaciones de ese perfil puede aportar el contraste que falta.
Si la probabilidad fuera exactamente cero, ampliar la muestra bajo la misma política no resolvería la ausencia. Un modelo logístico regularizado podría devolver una probabilidad pequeña y positiva; eso sería una propiedad de la representación estadística, no evidencia de que la alternativa haya sido factible. La diferencia entre cero y un número pequeño tiene consecuencias de identificación, aunque ambos generen dificultades numéricas.
También existe una situación intermedia relevante: todas las probabilidades pueden ser positivas y, aun así, algunas aproximarse tanto a los extremos que la estimación sea muy inestable. La positividad puntual no implica automáticamente que los pesos estén uniformemente acotados ni que se cumplan todas las condiciones necesarias para una aproximación normal sencilla. Petersen y colaboradores (2012) relacionan estos problemas con el parámetro y el estimador concretos.
Modifiquemos ahora el generador para que nadie del perfil bajo reciba la intervención. Conservemos las otras probabilidades y las respuestas bajo atención habitual. La probabilidad potencial de respuesta tratada en ese perfil, antes fijada en sesenta por ciento, ya no puede aprenderse de los datos observados sin restricciones adicionales. Puede tomar cualquier valor entre cero y uno compatible con lo que vemos.
La media tratada de toda la población quedaría entre cuarenta y cinco y setenta por ciento, mientras la media sin intervención seguiría siendo treinta y siete coma cinco. El efecto promedio estaría entre siete coma cinco y treinta y dos coma cinco puntos. Es un intervalo de valores compatibles con esa información y esos supuestos, no un intervalo de confianza. Su anchura persiste aunque conozcamos perfectamente las celdas que sí se observan.
La exigencia de soporte cambia si la población objetivo cambia. Para conocer el efecto entre quienes recibieron efectivamente la intervención, hace falta representar su resultado contrafactual sin ella. Los perfiles que nunca reciben tratamiento no forman parte de ese grupo. Su falta de resultados tratados impide recuperar el efecto en la población completa, pero no necesariamente el efecto entre los tratados que sí existen. En cambio, un perfil siempre tratado plantea un problema directo para ese último contraste porque carece de controles comparables.
En la tabla original, los tratados se distribuyen como uno por ciento del perfil bajo, cincuenta por ciento del central y cuarenta y nueve por ciento del alto. El promedio de los efectos correspondiente a esa población es quince coma tres puntos. Los no tratados presentan la mezcla inversa y su efecto promedio es veintinueve coma siete puntos. Ambas preguntas tienen soporte en esta construcción, aunque con grados de escasez diferentes. Su media, con iguales tamaños de los grupos, recupera veintidós coma cinco puntos.
Estas diferencias no autorizan escoger la población cuyo resultado parezca más favorable. Permiten reconocer qué información requiere cada pregunta. Al modificar el generador para que nadie del perfil bajo sea tratado, cambia la población de tratados y desaparece de ella ese perfil. El efecto en los tratados restantes puede seguir identificado bajo la intercambiabilidad asumida. El efecto de intervenir en toda la población original continúa requiriendo el resultado tratado del perfil ausente. La misma base puede ser suficiente para uno de esos objetivos e insuficiente para el otro.
Leer los diagnósticos en la población pertinente
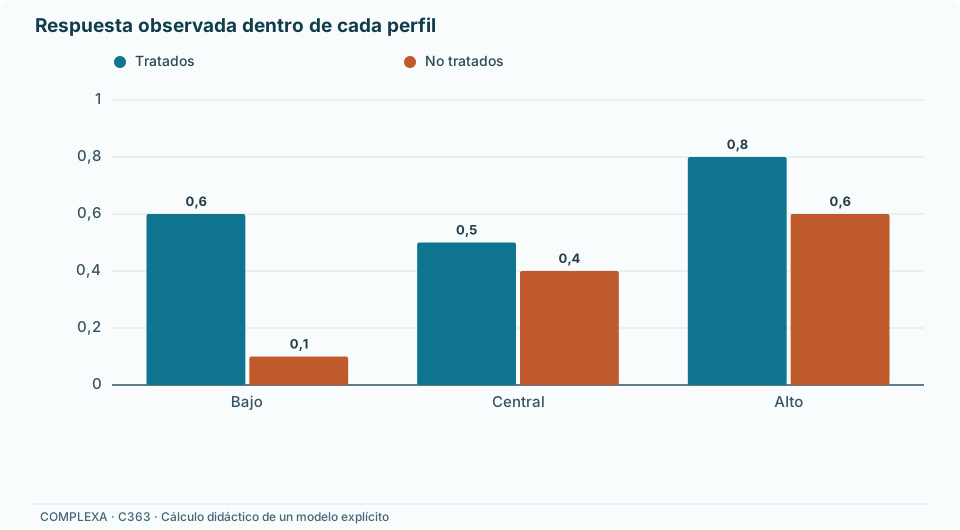
Conviene empezar por los recuentos y la distribución de características antes de resumir los pesos. La mitad tratada de la tabla no denuncia ningún problema global; las dos celdas de cincuenta personas muestran dónde se concentra la representación contrafactual. Un histograma de propensiones por brazo ayuda a localizar esas zonas, pero las variables que definen los perfiles permiten explicar por qué existen.
Después se examina si los pesos equilibran las características que debían ajustar. Austin y Stuart (2015) proponen comparar medias y prevalencias mediante diferencias estandarizadas, y extender la inspección a momentos superiores, interacciones y distribuciones. En nuestro ejemplo discreto podemos comparar las proporciones completas de los tres perfiles. En un problema continuo, igualar una media no implica igualar la dispersión ni la relación entre dos covariables.
Una diferencia estandarizada divide la diferencia entre medias por una medida de dispersión de referencia. Para que los cambios sean interpretables, hay que indicar qué dispersión se mantiene y cómo se calculan las medias ponderadas. Un umbral habitual de una décima puede servir como señal descriptiva; Austin y Stuart advierten que no existe un corte universal que convierta el balance en aceptable. El tamaño, el pronóstico asociado a la variable y la forma de su distribución siguen importando.
La media, los percentiles y el máximo de los pesos describen otro aspecto. En la tabla, los pesos no estabilizados tienen media dos en el conjunto, porque cada brazo reconstruye una población de diez mil sobre cinco mil registros. Los estabilizados tienen media uno. Por ello, pedir que cualquier clase de pesos tenga media uno sin especificar su definición puede generar una falsa alarma o una falsa tranquilidad.
Un resumen de concentración es , calculado aquí por brazo. Con nuestros pesos resulta aproximadamente setecientos veintisiete, pese a que cada brazo contiene cinco mil personas. Multiplicar todos sus pesos por un medio deja el cociente idéntico. Este índice resume cuánto se concentran las contribuciones ponderadas; no proporciona por sí solo una varianza del efecto ni acredita setecientas veintisiete observaciones aleatorias equivalentes para cualquier análisis.
Ninguno de estos diagnósticos verifica la intercambiabilidad respecto de información no registrada. Un archivo puede tener medias ponderadas perfectamente iguales para sus covariables y conservar selección por una causa no medida del resultado. A la inversa, pesos moderados pueden ocultar un estrato totalmente ausente. Petersen y colaboradores muestran que la ausencia de pesos extremos no descarta sesgo por falta de soporte.
Incluso con todas las variables registradas, un diagnóstico que solo compare sus medias puede pasar por alto una incompatibilidad conjunta. Consideremos dos características binarias. Entre los tratados, la mitad tiene ambas en cero y la mitad ambas en uno. Entre los controles, la mitad presenta cero y uno, y la otra mitad uno y cero. En cada grupo, la media de cada característica es un medio. Esas dos comparaciones marginales indican un balance perfecto.
Sin embargo, ninguno de los cuatro perfiles conjuntos contiene ambas alternativas. Si ese reparto representa la política poblacional, la asignación es determinista una vez conocido el par de características. Una regresión logística con solo los dos términos principales y grupos del mismo tamaño puede ajustar propensiones de un medio para todos: sus ecuaciones de medias quedan satisfechas. Los pesos resultantes son constantes y no parecen extremos. La interacción entre características y los recuentos conjuntos revelan lo que ese modelo ocultaba.
El ejemplo tampoco exige introducir automáticamente todas las interacciones posibles en cualquier base. Identifica una pregunta que el diagnóstico debe responder: si la asignación y el pronóstico dependen de combinaciones de características, ¿se han examinado esas combinaciones relevantes? Un modelo más flexible puede detectar la separación y mostrar que faltan comparaciones; no puede producir las observaciones ausentes. La mejora del diagnóstico puede dejar una respuesta causal menos determinada que el ajuste simple, porque hace visibles las restricciones que el primero estaba ocultando.
Con características continuas tampoco se exige encontrar otra persona con valores exactamente idénticos en todas las coordenadas. La condición se formula sobre probabilidades condicionales en el soporte poblacional, mientras la estimación utiliza vecindades o una estructura de suavizado. Dividir cada variable en categorías cada vez más estrechas puede vaciar las celdas de una muestra sin demostrar una imposibilidad estructural. La resolución del diagnóstico debe relacionarse con la cantidad de datos y con las variaciones del pronóstico que se necesitan representar.
Limitar el peso altera la comparación
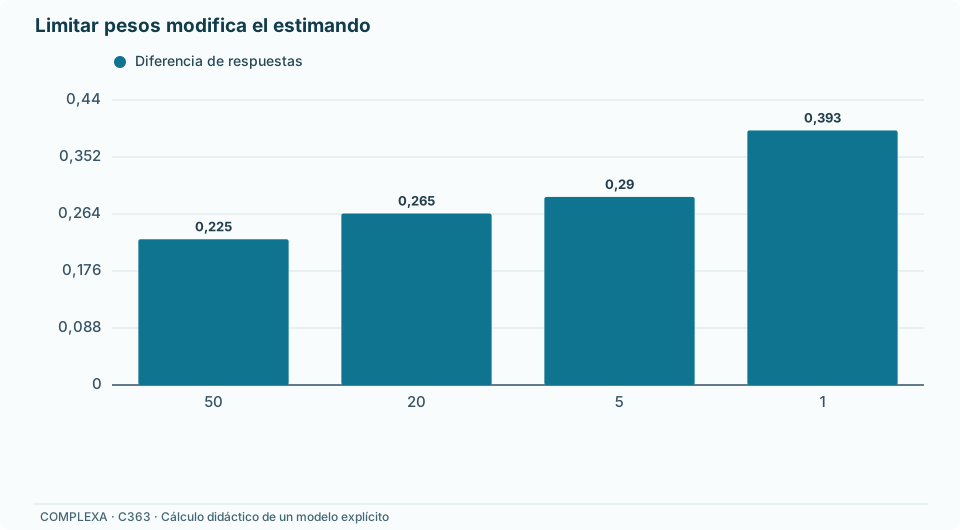
Supongamos que se sustituye cada peso superior a veinte por veinte, manteniendo todas las filas. Los cincuenta tratados del perfil bajo pasan a representar mil personas, mientras los otros dos perfiles tratados siguen representando cinco mil y dos mil quinientas. En los controles ocurre lo inverso: el perfil alto pasa a representar mil, y el bajo conserva dos mil quinientas. Ambos brazos suman ocho mil quinientos, pero sus composiciones ya no coinciden.
La media tratada permanece casualmente en sesenta por ciento con estos valores. La media de los controles desciende a aproximadamente treinta y tres coma cincuenta y tres. Su diferencia asciende a veintiséis coma cuarenta y siete puntos. Hemos reducido el máximo de los pesos y, al mismo tiempo, nos hemos alejado del efecto poblacional conocido de veintidós coma cinco puntos.
| Límite superior del peso | Media sin intervención | Media con intervención | Diferencia |
|---|---|---|---|
| 50, sin modificación | 0,37500 | 0,60000 | 0,22500 |
| 20 | 0,33529 | 0,60000 | 0,26471 |
| 5 | 0,30968 | 0,60000 | 0,29032 |
| 1 | 0,25500 | 0,64800 | 0,39300 |
Al imponer el límite uno, todos los pesos se vuelven iguales y reaparece la comparación cruda. Los valores intermedios ilustran un intercambio entre concentración y distorsión del ajuste. En una muestra real, un límite puede reducir el error cuadrático total al disminuir una variabilidad muy grande, pero esa ventaja debe estudiarse para el estimador y el objetivo correspondientes. La tabla determinista solo permite verificar cómo cambia su valor.
La razón del balance perdido puede escribirse con precisión. Al limitar los pesos inversos por una constante , la masa tratada de un perfil se multiplica por , mientras la masa de controles se multiplica por . Esos factores generalmente son distintos. El resultado no tiene por qué ser una diferencia de medias potenciales para una misma población redefinida.
También conviene distinguir limitar pesos, limitar propensiones y eliminar observaciones. Sustituir una propensión de dos por ciento por cinco modifica tanto el peso tratado como el de control correspondiente a ese perfil. Limitar solo los pesos por encima de veinte conserva algunos de esos pesos menores. Eliminar el perfil retira ambas clases de observaciones. Compartir la intención de reducir inestabilidad no convierte esas operaciones en equivalentes.
Restringir el soporte cambia a quién se describe
Otra decisión sería conservar únicamente perfiles con propensiones entre una décima y nueve décimas. En nuestro ejemplo solo permanece el perfil central, que contiene cinco mil personas. El contraste identificado para esa población es cincuenta frente a cuarenta por ciento, una diferencia de diez puntos. No cabe presentarlo como una estimación más precisa del efecto original de veintidós coma cinco puntos: las personas de los extremos han dejado de formar parte del objetivo.
Crump y colaboradores (2009) estudian cómo elegir subconjuntos con mejor precisión y hacen explícito ese cambio de estimando. El intervalo de propensiones mencionado aparece como una aproximación útil bajo las condiciones y distribuciones que examinan. Su trabajo no establece que ese corte sea óptimo para cualquier problema. La variabilidad condicional del resultado y la distribución de propensiones pueden modificar qué región ofrece una comparación más precisa.
La población retenida necesita una descripción sustantiva. Si los perfiles excluidos representan situaciones de acceso restringido, severidad poco frecuente o características relacionadas con una contraindicación, el informe debe decirlo. Expresar únicamente el porcentaje eliminado impide saber a quiénes se aplica el resultado. Además, una regla basada en propensiones estimadas puede seleccionar personas diferentes en otra muestra o bajo otra política de asignación.
La restricción puede ser adecuada cuando la pregunta admite concentrarse en una región con alternativas realmente observables. Si la pregunta exige conocer el efecto en toda la población original, la restricción deja una parte sin resolver. Para esa parte harían falta nueva información, supuestos de extrapolación defendibles o una presentación explícita de los valores todavía compatibles con los datos.
Una población de solapamiento definida por pesos comunes
Li, Morgan y Zaslavsky (2018) organizan estas decisiones mediante una función objetivo no negativa . La distribución de características que interesa es proporcional a la distribución inicial multiplicada por esa función. Para reconstruirla, se asigna peso entre tratados y entre controles. En ambos brazos, la probabilidad de asignación cancela el denominador y deja el mismo factor poblacional.
El efecto correspondiente es
La elección conserva toda la población. Para los pesos de solapamiento se usa . El peso tratado se simplifica a y el de control a . Son valores acotados entre cero y uno. La masa objetivo se concentra donde ambas alternativas son plausibles según las características observadas.
En la tabla, cada brazo ponderado aporta cuarenta y nueve unidades del perfil bajo, mil doscientas cincuenta del central y cuarenta y nueve del alto. La suma es mil trescientas cuarenta y ocho. Los perfiles extremos representan aproximadamente tres coma sesenta y cuatro por ciento cada uno, y el central cerca de noventa y dos coma setenta y tres por ciento. Esta composición es idéntica en ambos brazos.
Las probabilidades de respuesta en esa población son aproximadamente treinta y nueve coma sesenta y cuatro por ciento sin intervención y cincuenta y uno coma cuarenta y cinco por ciento con ella. El efecto es once coma ochenta y dos puntos. Su diferencia respecto del efecto original proviene de dar mucho menos peso al perfil bajo, donde el efecto construido era de cincuenta puntos. La reducción no indica que uno de los dos efectos haya corregido al otro.
Los perfiles con propensión exactamente cero o uno reciben masa objetivo nula bajo esta función. Si existe una región restante con solapamiento, se puede formular allí el contraste pertinente. Eso no recupera el efecto original en los perfiles excluidos. Si no existe solapamiento en ningún lugar, el denominador de la población objetivo es cero y ni siquiera queda definida esta comparación normalizada.
La función objetivo también permite describir otras ponderaciones conocidas. Elegir la propia propensión como función de inclinación produce una población proporcional a la distribución de características de los tratados. El peso tratado se vuelve uno y el control se convierte en las odds de tratamiento. Elegir uno menos la propensión orienta la comparación hacia los controles. Esta representación aclara por qué un peso pequeño o grande solo puede juzgarse después de especificar la población cuya distribución debe reproducir.
La población de solapamiento depende del mecanismo de asignación, además de las características de quienes participan. Supongamos que una nueva política asigna ambas opciones con probabilidad de un medio en los tres perfiles de nuestra tabla, conservando sus tamaños y sus respuestas potenciales. La función de solapamiento sería entonces constante. El efecto de solapamiento coincidiría con el efecto de toda la población, veintidós coma cinco puntos, aunque las respuestas potenciales por perfil no hubieran cambiado.
Bajo la política anterior habíamos obtenido cerca de once coma ochenta y dos puntos porque los extremos recibían poca masa objetivo. Comparar esas dos cifras como si fueran efectos contradictorios de una misma población sería engañoso. Se han mantenido las personas y los efectos por perfil, pero ha cambiado la manera de ponderarlas. Por ello, trasladar un resultado de solapamiento a otra institución requiere describir también cómo su política selecciona a quienes reciben cada opción.
Balance exacto y límites de la información
Los pesos de solapamiento tienen una propiedad adicional cuando las propensiones se estiman mediante regresión logística por máxima verosimilitud sin penalización, con intercepto y una solución finita. Las ecuaciones de estimación hacen que la suma de cada covariable multiplicada por sea cero. Al reorganizarlas, las sumas ponderadas de esas covariables coinciden entre tratados y controles; la ecuación del intercepto iguala sus denominadores.
Por eso las medias ponderadas de las variables incluidas en ese ajuste logístico coinciden exactamente, salvo tolerancias numéricas. Li y colaboradores (2018) demuestran esa propiedad. Su alcance son las variables representadas en las ecuaciones: una interacción o un término cuadrático quedan cubiertos si se incluyeron. No se obtiene automáticamente igualdad de todas las distribuciones, ni una garantía semejante para cualquier algoritmo predictivo o ajuste penalizado.
Es posible, por tanto, que una tabla muestre balance perfecto en las medias examinadas por una razón algebraica. El resultado sigue siendo útil, pero no reemplaza la justificación causal del conjunto de variables. Tampoco permite escoger un modelo únicamente por su capacidad de predecir la asignación. Predecir casi perfectamente quién recibe cada opción puede revelar precisamente la escasez de comparaciones que se intenta resolver.
La incertidumbre requiere un procedimiento compatible con el estimador completo. Contar las réplicas ponderadas como si fueran personas independientes produciría una precisión ficticia. Cuando los pesos se estiman, hay que considerar esa estimación y la estructura de dependencia de los datos; si además se aprende una regla de restricción, importa cómo entra en el análisis. Una fórmula robusta o un remuestreo deben corresponder a esas decisiones, no añadirse por su nombre.
La relación del índice de concentración con una varianza se ve en un experimento estadístico más limitado. Supongamos, por separado, que las respuestas son independientes, que los pesos están fijados y que todas tienen la misma varianza. La varianza de su media ponderada es esa varianza común multiplicada por la suma de los cuadrados de los pesos y dividida por el cuadrado de la suma de pesos. Bajo esas condiciones coincide con dividir la varianza común por el índice de concentración. De ahí procede una interpretación útil del llamado tamaño efectivo.
Si las varianzas cambian entre perfiles, cada peso al cuadrado multiplica una varianza distinta y la reducción anterior ya no resume toda la cuenta. En respuestas binarias, las probabilidades de sesenta y ochenta por ciento implican varianzas diferentes. La dependencia entre personas o la estimación de los pesos añade otras consideraciones. Nuestro archivo determinista no se convierte en un experimento de respuestas independientes por aplicar esa fórmula; las condiciones deben corresponder al mecanismo que se pretende analizar.
Una evaluación de sensibilidad al truncamiento debería conservar visibles estos elementos. Puede fijar antes de examinar el resultado varios límites razonados, informar cuántas observaciones afectan, repetir el balance y mostrar cómo cambian los estimadores. Si el límite se selecciona buscando una diferencia favorable o un intervalo que excluya cero, la elección depende del mismo ruido que se interpreta después como evidencia. En la tabla conocemos el valor poblacional y podemos medir la distorsión; en una aplicación se necesita justificar cómo se evaluará ese compromiso sin conocerlo.
Para la tabla construida, el informe puede mantener visibles tres preguntas resueltas. El efecto en la población inicial es veintidós coma cinco puntos; en el perfil central retenido es diez; en la población de solapamiento es aproximadamente once coma ochenta y dos. La comparación con pesos limitados a veinte entrega veintiséis coma cuarenta y siete, acompañada de composiciones distintas en ambos brazos. Esa última cifra permite localizar el costo del límite: los cincuenta tratados del perfil bajo y los cincuenta controles del alto ya no reconstruyen la misma población que sus contrapartes.
Referencias
Austin, P. C., y Stuart, E. A. (2015). Moving towards best practice when using inverse probability of treatment weighting (IPTW) using the propensity score to estimate causal treatment effects in observational studies. Statistics in Medicine, 34(28), 3661–3679. https://doi.org/10.1002/sim.6607
Cole, S. R., y Hernán, M. A. (2008). Constructing inverse probability weights for marginal structural models. American Journal of Epidemiology, 168(6), 656–664. https://doi.org/10.1093/aje/kwn164
Crump, R. K., Hotz, V. J., Imbens, G. W., y Mitnik, O. A. (2009). Dealing with limited overlap in estimation of average treatment effects. Biometrika, 96(1), 187–199. https://doi.org/10.1093/biomet/asn055
Li, F., Morgan, K. L., y Zaslavsky, A. M. (2018). Balancing covariates via propensity score weighting. Journal of the American Statistical Association, 113(521), 390–400. https://doi.org/10.1080/01621459.2016.1260466
Petersen, M. L., Porter, K. E., Gruber, S., Wang, Y., y van der Laan, M. J. (2012). Diagnosing and responding to violations in the positivity assumption. Statistical Methods in Medical Research, 21(1), 31–54. https://doi.org/10.1177/0962280210386207
Westreich, D., y Cole, S. R. (2010). Invited commentary: Positivity in practice. American Journal of Epidemiology, 171(6), 674–677. https://doi.org/10.1093/aje/kwp436