Tres variables cambian juntas. Conocer la primera ayuda a predecir la segunda, y conocer la segunda ayuda a predecir la tercera. Un programa dibuja una cadena de flechas y la presenta como estructura causal. Antes de interpretar esas flechas conviene examinar qué parte del dibujo está determinada por los datos. La misma distribución puede admitir una cadena en sentido contrario o una causa común situada en el centro. Esas posibilidades producen predicciones observacionales idénticas y respuestas distintas a una intervención.
El descubrimiento causal estudia qué estructuras pueden aprenderse al combinar propiedades de las distribuciones con supuestos sobre su generación. Su resultado puede ser una clase de grafos compatibles, algunas relaciones de ascendencia o un conjunto de posibles causas de una variable. Aprender un único grafo completo es una posibilidad dentro de ciertos modelos, no una propiedad general de disponer de muchas columnas.
Trabajaremos con distribuciones construidas para hacer visibles esas diferencias. Las variables se llamarán y representarán magnitudes centradas, cuya media puede ser cero. Todos los ejemplos son matemáticos y didácticos; no proceden de registros clínicos. Primero supondremos acceso a la distribución poblacional exacta. Después examinaremos qué cambia cuando las independencias tienen que estimarse en una muestra finita.
Las condiciones que convierten una independencia en información causal
Un grafo dirigido acíclico, o DAG, contiene flechas que no permiten regresar al punto de partida siguiendo sus direcciones. Una ecuación para cada variable especifica cómo responde a sus padres y a una perturbación externa. El grafo describe las dependencias causales postuladas entre las variables incluidas. Para interpretarlo de ese modo se necesita relacionar sus ecuaciones con intervenciones que sustituyen mecanismos, además de ajustar asociaciones.
La condición de Markov causal establece que las separaciones gráficas pertinentes implican independencias en la distribución. En un DAG se utiliza la separación dirigida, habitualmente llamada d-separación. En una cadena, condicionar por el nodo intermedio bloquea la conexión entre extremos. En una estructura donde dos flechas convergen en un nodo, ese nodo es un colisionador: el camino está bloqueado sin condicionamiento y puede abrirse al condicionar por él o por uno de sus descendientes.
La fidelidad añade la dirección inversa: las independencias de la distribución deben estar explicadas por esas separaciones. Excluye, entre otras situaciones, cancelaciones exactas entre vías que hacen desaparecer una asociación aunque exista un camino causal abierto. Markov y fidelidad son condiciones diferentes. Un sistema de ecuaciones puede satisfacer la primera y violar la segunda.
La suficiencia causal supone que las variables observadas no comparten causas omitidas relevantes para la representación utilizada. No exige medir cada antecedente imaginable de cada variable: pueden existir perturbaciones individuales no observadas. Lo que se excluye en el modelo inicial es que una perturbación compartida produzca dependencias entre nodos que el DAG observado no representa. Más adelante permitiremos causas comunes latentes y cambiará el tipo de grafo que puede recuperarse.
También fijamos una población sin selección dependiente de consecuencias del sistema y observaciones independientes generadas por el mismo mecanismo. Mezclar entornos con ecuaciones diferentes puede introducir dependencias que no pertenecen a ninguno por separado. Tratar visitas repetidas de una misma persona como observaciones independientes modifica la calibración de las pruebas. Estas condiciones tienen que corresponder al modo en que se formó el archivo.
La aciclicidad es otra decisión sustantiva. Un sistema puede contener realimentación entre sus componentes y, aun así, describirse mediante un DAG cuando cada nodo representa una variable en un momento distinto. En cambio, reunir toda una trayectoria en una sola medición por componente puede ocultar ese orden. La ausencia de ciclos en la salida del programa demuestra que el algoritmo impuso esa restricción, no que el sistema físico carezca de realimentación.
Tres mecanismos que producen los mismos registros
Construyamos primero las ecuaciones
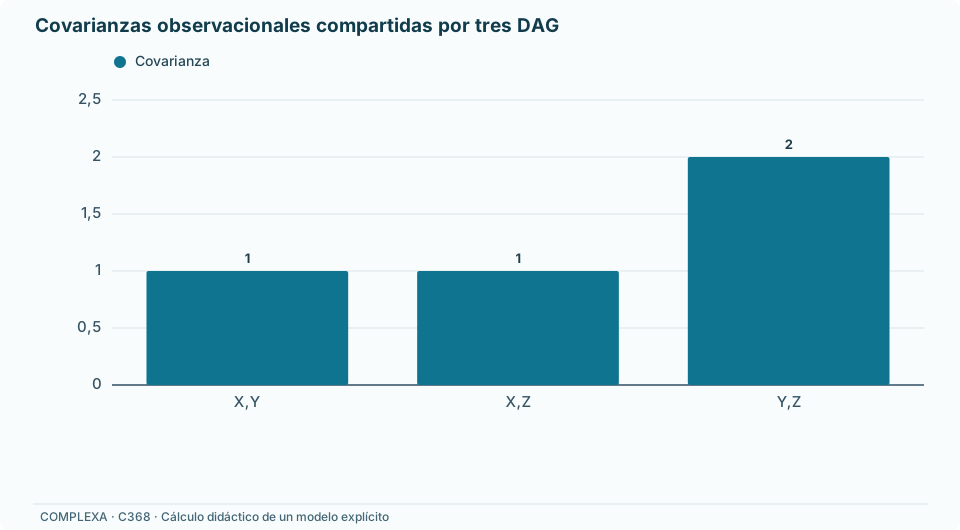
con perturbaciones gaussianas independientes, todas de media cero y varianza uno. El grafo correspondiente es . Las varianzas de las variables son uno, dos y tres. Sus covarianzas, en el mismo orden, forman la matriz
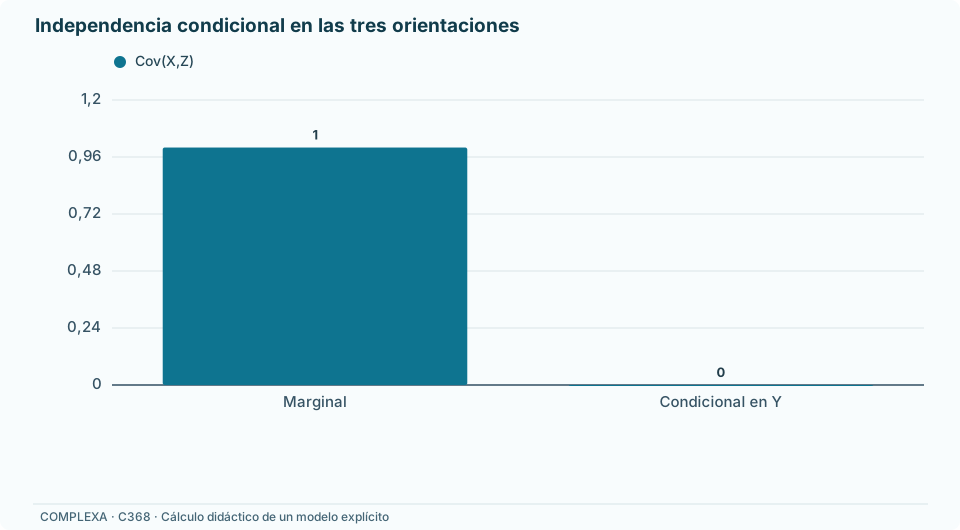
Los tres pares presentan asociación marginal. Sin embargo, la covarianza condicional entre los extremos, después de fijar el nodo intermedio, es uno menos el producto de uno por dos dividido entre dos: cero. En esta distribución conjuntamente gaussiana, esa covarianza condicional nula equivale a independencia condicional. Así obtenemos .
Ahora construyamos otro mecanismo. Generamos primero con distribución gaussiana de media cero y varianza dos. Después hacemos y , con perturbaciones independientes entre sí y de , cuyas varianzas son un medio y uno. El grafo es : el nodo central causa ambos extremos.
La varianza de vuelve a ser uno, porque una cuarta parte de la varianza de , más un medio, suma uno. La covarianza entre y es también uno; las demás entradas reproducen la matriz anterior. Como los dos modelos son gaussianos y tienen las mismas medias y covarianzas, generan exactamente la misma distribución conjunta. No se trata solo de que sus correlaciones sean parecidas.
Hay una tercera construcción. Generamos con varianza tres; luego , con varianza residual de dos tercios; finalmente , con varianza residual de un medio. Todas las perturbaciones son gaussianas independientes. El grafo queda , y su matriz de covarianzas vuelve a ser exactamente la misma.
Esta equivalencia tiene una consecuencia observable solo al cambiar el mecanismo. En el primer modelo, fijar externamente en un valor desplaza la media de hasta ese mismo valor. En los otros dos modelos, sustituir únicamente la ecuación de no cambia la media de , que permanece en cero. Sin embargo, observar personas o unidades con produce en los tres modelos una media condicional de igual a .
El contraste distingue observar un valor de producirlo mediante una intervención ideal. Las distribuciones observacionales completas coinciden, de modo que ninguna mejora del ajuste a esos mismos registros puede seleccionar entre las tres respuestas causales. Hacen falta restricciones adicionales o información procedente de otro tipo de observación.
Los tres DAG comparten el esqueleto, obtenido al quitar las direcciones, y carecen de colisionadores no protegidos: triples cuyos extremos no son vecinos y cuyas flechas convergen en el centro. Compartir esqueleto y esos colisionadores caracteriza la equivalencia de Markov entre DAG. Kalisch y Bühlmann (2007) utilizan esta equivalencia para distinguir el grafo individual de la clase identificable mediante independencias.
Un CPDAG representa esa clase mediante aristas dirigidas cuando su orientación es común a todos sus miembros y aristas sin dirección cuando puede variar. En nuestro caso es el camino , sin flechas. Esto no representa una relación física bidireccional. Tampoco permite orientar cada arista independientemente: elegir introduciría un colisionador y saldría de la clase. La representación conserva conjuntamente las restricciones sobre las orientaciones permitidas.
La incertidumbre de estructura puede trasladarse a una pregunta concreta. Dentro de estas tres representaciones gaussianas de la distribución fijada, el efecto de aumentar una unidad el valor impuesto de la primera variable sobre la media de la última puede ser cero o uno. Los dos valores forman un conjunto de respuestas compatibles; no son extremos de un intervalo de confianza obtenido por muestreo. Asignar probabilidad de un tercio a cada grafo tampoco se desprende de su enumeración. Para producir probabilidades sobre modelos habría que introducir y justificar una distribución previa y un procedimiento inferencial adicional.
Un método que busca el mejor ajuste penalizado afronta la misma equivalencia. Las tres factorizaciones gaussianas pueden representar exactamente esta distribución y tienen la misma cantidad de parámetros libres. Una puntuación que respete esa equivalencia no dispone de evidencia observacional para preferir una orientación. Si un programa devuelve un único representante mediante un orden de búsqueda o una regla de desempate, esa elección computacional necesita conservarse separada de las conclusiones sobre el mecanismo.
Cómo se construye el esqueleto y cuándo aparece una flecha
La versión poblacional del algoritmo PC comienza con todas las parejas conectadas. Busca conjuntos de variables que hagan independientes a los extremos de una arista y elimina la conexión cuando encuentra uno. Conserva el conjunto que produjo la separación, porque esa información interviene después en las orientaciones. La búsqueda reduce sus posibilidades utilizando las vecindades que van quedando, de modo que la estructura dispersa puede ahorrar muchas pruebas.
Podemos seguir cada paso para nuestra matriz de tres variables. Ningún par es independiente marginalmente, así que inicialmente no se elimina ninguna conexión. Al condicionar por una variable, el par de extremos se vuelve independiente y desaparece la arista entre y . En cambio, las covarianzas de condicionadas por , y de condicionadas por , son un tercio y uno. Se conservan esas dos aristas.
El conjunto separador de los extremos contiene . Por eso el triple no se orienta como colisionador. Tampoco existen otros nodos que obliguen a propagar una orientación. El procedimiento termina con el camino no dirigido, que expresa exactamente la ambigüedad de las tres construcciones. Entregar una de ellas con todas sus flechas, sin explicar que es solo un representante, ocultaría información que el análisis ha conservado.
Cambiemos la construcción. Generemos ahora y como gaussianas independientes de varianza uno y definamos , con otra perturbación gaussiana independiente de varianza uno. Los extremos son independientes sin ajustar; después de condicionar por , su covarianza es menos un tercio y su correlación condicional es menos un medio.
Aquí el algoritmo elimina la arista entre extremos usando el conjunto vacío. Conserva las otras dos, y el nodo intermedio no pertenece al conjunto separador. Bajo los supuestos declarados, el triple se orienta como . El patrón de independencias ha aportado una dirección que la intensidad de las asociaciones marginales no mostraba.
La dependencia condicional también admite una lectura concreta. Si conocemos un valor alto de la suma ruidosa y descubrimos que uno de sus componentes es bajo, el otro tiende a ser mayor para explicar ese valor. Condicionar por el resultado común relaciona causas inicialmente independientes. Un análisis que tomara cualquier asociación ajustada como vínculo causal directo podría interpretar al revés esta información.
En grafos mayores, las orientaciones de colisionadores permiten aplicar reglas adicionales que evitan nuevos colisionadores incompatibles o ciclos dirigidos. La versión final del trabajo de Kalisch y Bühlmann (2007) describe la extensión del esqueleto a CPDAG. La validez de esas reglas se refiere al conjunto de independencias y supuestos utilizados; no autoriza a inventar una dirección para resolver una incertidumbre gráfica.
La información temporal puede restringir la clase antes de buscar. Si se sabe que la primera variable precede causalmente a la segunda y esta a la tercera, y se excluyen efectos hacia el pasado, la cadena hacia la derecha es la única de nuestras tres candidatas compatible con ese conocimiento. La orientación adicional procede del orden impuesto, no de una diferencia oculta entre sus matrices de covarianza. Fechas de registro distintas requieren más cuidado: una variable medida tarde puede reflejar un estado que existía antes, y una pregunta retrospectiva puede referirse a otro momento. Para utilizar el orden como restricción causal hay que definir cuándo ocurre el estado representado por cada nodo.
Cancelaciones y decisiones estadísticas
La fidelidad puede fallar incluso con ecuaciones sencillas. Tomemos perturbaciones gaussianas independientes de varianza uno y definamos , y . El grafo tiene las dos flechas de la cadena y una flecha adicional de a , con coeficiente negativo.
Al sustituir la ecuación de , queda . Por tanto, y son independientes marginalmente aunque exista una conexión directa entre ellos. La influencia positiva por el nodo intermedio y la influencia negativa directa se cancelan. El efecto total de variar sobre es cero en este modelo, pero la intervención que variara manteniendo fijo tendría una consecuencia diferente.
Este sistema satisface la condición de Markov del DAG construido y viola fidelidad respecto de ese DAG. Si un procedimiento basado en fidelidad tratara la independencia marginal como información estructural, quitaría la arista directa. Además, el conjunto separador vacío lo llevaría a orientar un colisionador en el nodo intermedio. Conocer exactamente la distribución no impediría esa conclusión equivocada bajo el supuesto violado.
La cancelación exacta puede parecer especial, pero sus proximidades afectan a las muestras finitas. Si el coeficiente directo fuese menos uno más una cantidad pequeña, contendría esa pequeña cantidad multiplicada por , además de las dos perturbaciones. La covarianza entre extremos sería pequeña aunque ambas vías causales siguieran presentes. La distinción estadística entre cero y un valor próximo a cero depende de la información disponible.
En el caso gaussiano, PC puede contrastar independencias mediante correlaciones parciales. Una transformación habitual multiplica la función inversa de la tangente hiperbólica de la correlación estimada por la raíz cuadrada de un tamaño de muestra ajustado por las variables condicionadas. Con una sola variable de ajuste y una correlación estimada de una décima, el estadístico es aproximadamente cero coma sesenta y ocho para cincuenta observaciones y siete coma cero nueve para cinco mil.
Son dos muestras hipotéticas con la misma correlación estimada, pero con precisiones muy diferentes. No rechazar la independencia en la primera no demuestra una ausencia exacta de vínculo. Tampoco un rechazo en la segunda determina por sí solo una orientación: la flecha depende de cómo encaja esa decisión con el resto de separaciones y con los supuestos del modelo.
Los resultados de consistencia estudian qué ocurre cuando crece la muestra bajo condiciones especificadas. Las garantías de Kalisch y Bühlmann (2007) incluyen restricciones sobre dispersión del grafo y magnitudes de correlaciones parciales no nulas. La mera fidelidad poblacional, sin controlar lo cerca que pueden estar algunas dependencias de cero, no convierte cualquier tamaño finito en suficiente para recuperar la estructura.
Además, el algoritmo realiza muchas decisiones relacionadas entre sí. Eliminar una arista cambia las vecindades y puede modificar las pruebas posteriores. El nivel nominal de cada contraste no debe leerse como una probabilidad de error para todo el grafo. Repetir el análisis en remuestras permite estudiar estabilidad, pero la frecuencia con que aparece una flecha no es automáticamente una probabilidad posterior de que sea causal.
La selección del test importa tanto como su nivel. Fuera del contexto gaussiano, una correlación parcial nula puede coexistir con dependencia condicional. Un procedimiento que solo examine relaciones lineales podría quitar una arista asociada a una respuesta no lineal. Elegir una prueba más flexible cambia las necesidades de muestra y de ajuste; no elimina la dificultad de distinguir independencias aproximadas con información limitada.
Por ejemplo, generemos una variable uniforme entre menos uno y uno y una respuesta igual a su cuadrado más un ruido independiente centrado. La covarianza entre predictor y respuesta es cero, porque el tercer momento del predictor simétrico es cero. Sin embargo, la media de la respuesta cambia con el cuadrado del predictor: conocer un valor próximo a cero aporta información diferente de conocer un valor próximo a cualquiera de los extremos. Un test que use únicamente la correlación marginal sería incapaz de reconocer esa dependencia incluso con la distribución exacta. El fallo correspondería a la característica examinada por el test, no a una falta de flecha en el mecanismo construido.
La medición puede cambiar también el patrón que intenta recuperar el algoritmo. Volvamos a la cadena gaussiana inicial y supongamos que el nodo intermedio solo se observa con un error adicional independiente, de varianza uno. Denotemos por esa medición. Su varianza es tres, mientras sus covarianzas con los extremos siguen siendo uno y dos. La covarianza de los extremos condicionada por la medición es ahora uno menos dos tercios: un tercio, en lugar de cero.
Condicionar por una versión ruidosa del nodo intermedio no bloquea completamente la información que transmitía el estado verdadero. En esta nueva distribución, los tres pares conservan dependencia incluso al ajustar por la tercera variable. Un algoritmo aplicado a las columnas observadas puede conservar un triángulo. Interpretar su arista entre extremos como una nueva influencia directa ignoraría el cambio de variables producido por la medición. Medir dos veces el estado intermedio o conocer la precisión del instrumento puede aportar información para un modelo de medición, pero esa información debe entrar explícitamente en el análisis. Intervenir sobre el número registrado tampoco equivale necesariamente a modificar el estado que ese número pretende representar.
Cuando existen causas comunes no observadas
Consideremos dos variables generadas por y , con tres gaussianas independientes de varianza uno. La causa común no se observa. Las dos variables tienen varianza dos y covarianza uno. Una intervención que sustituya solo la ecuación de no modifica .
La misma distribución observada se obtiene con una causa directa: generamos con varianza dos y hacemos , con varianza residual de tres medios. También puede invertirse la dirección. Los tres modelos contienen la misma asociación, pero el efecto de intervenir sobre es cero en el modelo de causa común y un medio por unidad en el modelo con flecha directa.
Si permitimos variables latentes, el DAG de las observadas deja de ser una representación general suficiente. Los grafos ancestrales maximales, desarrollados por Richardson y Spirtes (2002), pueden representar las independencias que quedan al marginalizar variables y, en su marco más amplio, al condicionar por selección. Sus marcas contienen información de ascendencia que requiere una interpretación diferente de la utilizada para un DAG completamente observado.
Para explicar esa diferencia mantengamos aquí ausencia de selección. Una arista bidirigida en un grafo ancestral tiene puntas de flecha en ambos extremos y excluye que cualquiera sea ancestro del otro dentro de esa representación. Puede surgir al ocultar causas comunes. No identifica el número, el nombre ni una única configuración de variables omitidas. Una arista dirigida, por su parte, puede representar una relación ancestral que atraviesa variables no medidas, y no necesariamente un efecto directo sin mediadores.
Un PAG, o grafo ancestral parcial, representa una clase equivalente de esos grafos. Zhang (2008) define sus marcas comunes: una punta de flecha o una cola permanece cuando coincide en todos los miembros de la clase; un círculo deja ese extremo sin resolver. El círculo no es una variable latente dibujada en pequeño. Indica incertidumbre sobre la marca compatible con la información representada.
En nuestro ejemplo de dos variables, las independencias observadas no separan causa directa, causa inversa y causa común. La representación equivalente debe dejar ambos extremos abiertos mediante círculos. Dibujar directamente una arista bidirigida porque una asociación resulta difícil de explicar atribuiría a los datos una conclusión que no contienen.
Algoritmos como FCI permiten buscar estructuras compatibles con causas comunes latentes, manteniendo condiciones de Markov y fidelidad y las restantes restricciones de su marco. Su salida puede conservar mucha incertidumbre ancestral. Si además existe selección, se necesitan los tipos de arista y reglas correspondientes a ese problema ampliado. No basta con cambiar el nombre de un grafo obtenido bajo suficiencia causal y reinterpretar sus flechas como si ya incorporara esas posibilidades.
La selección puede introducir asociaciones aunque no haya causa común entre las variables originales. Consideremos dos indicadores independientes, cada uno con probabilidad de un medio, y conservemos únicamente unidades en las que al menos uno vale uno. Entre las seleccionadas quedan tres combinaciones equiprobables: primero solo, segundo solo y ambos. Cada indicador vale uno con probabilidad de dos tercios, pero la probabilidad de que ambos lo hagan es un tercio; su covarianza es menos un noveno. El vínculo aparece al condicionar por la inclusión. Eliminar filas por una regla relacionada con sus valores ha cambiado la distribución disponible para descubrir la estructura. Documentar esa regla permite estudiar el problema de selección en vez de atribuir la dependencia directamente a una influencia entre indicadores.
Información que no se reduce a independencias entre variables
Hasta ahora hemos utilizado principalmente el patrón de independencias. Una restricción sobre la forma de las ecuaciones puede aportar información adicional. Peters y colaboradores (2014) estudian modelos de ruido aditivo en los que cada variable es una función de sus padres más una perturbación independiente. Bajo condiciones de regularidad e identificabilidad, ese tipo de estructura puede distinguir direcciones que permanecen equivalentes para métodos basados solo en independencias.
La independencia del ruido es una condición más fuerte que su falta de correlación con el predictor. Podemos comprobarlo con una construcción continua de dos variables. Sean y independientes con distribución de Laplace centrada y escala uno, cuya densidad es . Cada una tiene varianza dos y cuarto momento veinticuatro. Definamos .
En la dirección propuesta, el residuo es exactamente , independiente de . En la regresión lineal inversa, el coeficiente es un medio y el residuo queda . La covarianza entre y es cero. Si solo inspeccionáramos esa covarianza, ambas direcciones parecerían satisfacer la condición buscada.
Los momentos de orden superior revelan la diferencia. La varianza de es cuatro y la de , uno. Si fuesen independientes, el valor esperado del producto de sus cuadrados sería cuatro. Sin embargo, expandir ese producto da diez: intervienen los cuartos momentos de las dos variables y el producto de sus varianzas. Por tanto, el residuo inverso y el predictor son dependientes.
La simetría entre y , condicionada por su suma, implica que la media de dado es . Así, cualquier representación inversa con ruido aditivo independiente y media cero tendría que utilizar esa misma función de regresión. La dependencia que acabamos de demostrar excluye esa representación inversa dentro de la clase considerada. No excluye cualquier mecanismo causal imaginable: la conclusión utiliza la restricción aditiva y la independencia de las perturbaciones.
Con perturbaciones gaussianas de las mismas varianzas, la situación cambia. El residuo inverso y el predictor son conjuntamente gaussianos y su covarianza nula implica independencia. La asimetría anterior desaparece. Por eso el modelo lineal gaussiano inicial admitía distintas orientaciones, mientras que ciertas restricciones no gaussianas permiten aprender más de la misma clase de datos observacionales.
La no linealidad tampoco garantiza por sí sola identificación. Existen combinaciones especiales de funciones y distribuciones que admiten modelos aditivos en ambas direcciones. Los resultados de Peters y colaboradores (2014) especifican condiciones para excluir esas excepciones, además de aciclicidad, perturbaciones independientes y minimalidad causal. Esta última impide añadir como padre una variable que la ecuación ignora por completo.
En una aplicación, los residuos se calculan después de estimar funciones con datos finitos. Una mala regresión puede dejar dependencia incluso en la dirección correcta; un ajuste demasiado flexible puede ocultarla en los datos usados para entrenar. Separar ajuste y evaluación, y estudiar sensibilidad a las funciones consideradas, permite reconocer parte de estos problemas. La selección de una dirección debe conservar el vínculo con los supuestos funcionales que la hicieron distinguible.
Intervenir para separar los modelos que quedan
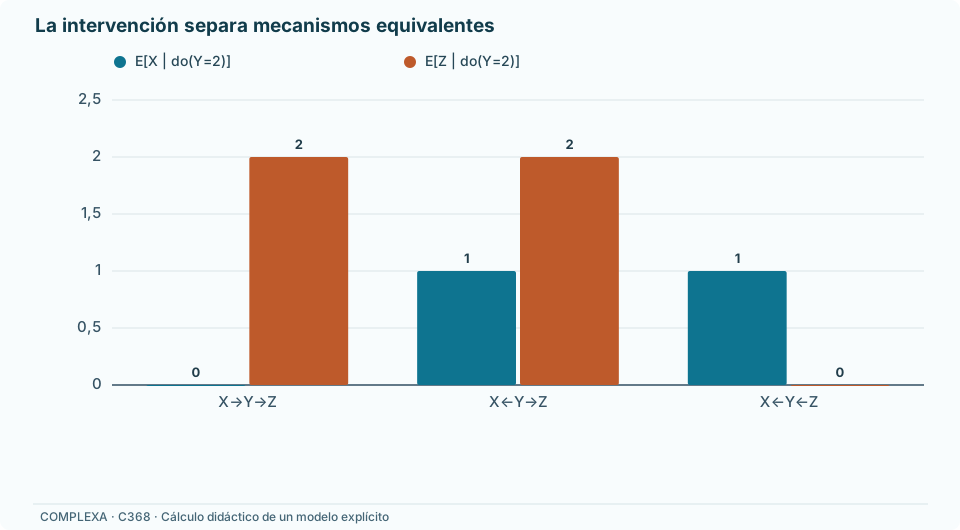
Regresemos a los tres mecanismos gaussianos del comienzo. Si podemos fijar experimentalmente el nodo intermedio en un valor , sustituyendo solo su ecuación, las predicciones se separan. En la cadena hacia la derecha, la media de permanece en cero y la de pasa a . En la bifurcación central, las medias pasan a y . En la cadena invertida, pasan a y cero.
| Modelo compatible con los registros iniciales | Media de al fijar | Media de al fijar |
|---|---|---|
| 0 | ||
| 0 |
Con valores experimentales que permitan distinguir esas respuestas, la intervención aporta una comparación que no existía en los registros iniciales. Hauser y Bühlmann (2012) formalizan cómo las intervenciones sobre blancos conocidos refinan las clases de equivalencia de Markov. En su marco, combinar datos observacionales con intervenciones ideales permite conservar información sobre el mecanismo sin intervenir y sobre las relaciones que sobreviven al sustituirlo.
El blanco elegido afecta a cuánta ambigüedad se resuelve. Intervenir únicamente sobre la primera variable separaría la cadena hacia la derecha de las otras dos: solo en ella se desplaza la última. La bifurcación y la cadena invertida seguirían produciendo la misma distribución de los dos nodos restantes. Intervenir sobre el centro resulta más informativo para esta clase concreta porque distingue las tres parejas de respuestas. Esa comparación puede guiar el diseño sin suponer que cualquier intervención identifica por completo cualquier red.
Por ejemplo, al fijar el centro en dos, las medias de los extremos serían cero y dos, uno y dos, o uno y cero. Asignar varios valores permite estimar la respuesta a su variación, además de comprobar una sola predicción puntual. En datos finitos aparecerá incertidumbre en esas medias; la planificación puede concentrarse en la precisión necesaria para distinguir las alternativas que cambiarían la decisión. El ejemplo determina qué comparar, mientras el diseño experimental debe establecer cómo producir esos valores de manera interpretable.
La precisión de la palabra «ideal» importa para el ejemplo. Si el procedimiento que modifica también actúa directamente sobre , las predicciones de la tabla ya no corresponden al experimento realizado. Del mismo modo, si solo se seleccionan unidades que espontáneamente tienen un valor alto de , no se han cortado las flechas que llegan a ese nodo. Una asignación experimental necesita describir qué mecanismo modifica y qué otras vías deja intactas.
Distintos entornos pueden aportar otra fuente de información si ciertas ecuaciones permanecen estables. Supongamos , con perturbación independiente de varianza uno, en dos entornos. En el primero, es gaussiana de varianza uno; en el segundo, gaussiana de varianza cuatro. Las medias permanecen en cero. El mecanismo condicional de dado conserva coeficiente dos y varianza residual uno.
La regresión inversa no conserva su coeficiente. En el primer entorno es dos quintos; en el segundo, ocho diecisieteavos. Sus varianzas residuales son un quinto y cuatro diecisieteavos. Cambiar la distribución de la causa, manteniendo el mecanismo del efecto, ha creado una diferencia útil entre las dos direcciones. La observación de estabilidad tiene aquí una explicación construida, que en una aplicación debería justificarse.
Peters, Bühlmann y Meinshausen (2016) desarrollan la predicción causal invariante para inferir posibles causas directas de un resultado especificado. La invariancia pertinente concierne al mecanismo condicional, no simplemente a obtener errores de predicción parecidos en dos bases. Bajo sus condiciones y pruebas válidas, intersectar los conjuntos de predictores cuya invariancia no se rechaza permite controlar inclusiones causales falsas. El conjunto resultante puede ser incompleto o vacío; no constituye necesariamente un descubrimiento de todo el grafo.
Los entornos deben aportar variación informativa y conservar el mecanismo del resultado que se intenta estudiar. Si cambia directamente la ecuación de , el supuesto utilizado en nuestro cálculo deja de sostenerse. Una colección de hospitales, años o dispositivos no se convierte automáticamente en una familia adecuada de intervenciones por disponer de etiquetas distintas.
Al terminar el análisis de las tres variables iniciales, podemos conservar el CPDAG y registrar las tres predicciones experimentales, en lugar de elegir una flecha por conveniencia visual. El siguiente experimento puede asignar varios valores del nodo intermedio y medir ambos extremos con el mismo procedimiento. Si sus medias siguen la respuesta cero y , la primera cadena recibirá apoyo frente a las otras dos dentro de la clase considerada. Si ninguna predicción se cumple, habrá que examinar la intervención y ampliar los mecanismos candidatos. Ese resultado también informa: muestra qué parte de la estructura propuesta necesita una comparación nueva.
Referencias
Hauser, A., y Bühlmann, P. (2012). Characterization and greedy learning of interventional Markov equivalence classes of directed acyclic graphs. Journal of Machine Learning Research, 13(79), 2409–2464. https://jmlr.org/papers/v13/hauser12a.html
Kalisch, M., y Bühlmann, P. (2007). Estimating high-dimensional directed acyclic graphs with the PC-algorithm. Journal of Machine Learning Research, 8(22), 613–636. https://jmlr.org/papers/v8/kalisch07a.html
Peters, J., Bühlmann, P., y Meinshausen, N. (2016). Causal inference by using invariant prediction: Identification and confidence intervals. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 78(5), 947–1012. https://doi.org/10.1111/rssb.12167
Peters, J., Mooij, J. M., Janzing, D., y Schölkopf, B. (2014). Causal discovery with continuous additive noise models. Journal of Machine Learning Research, 15(58), 2009–2053. https://jmlr.org/papers/v15/peters14a.html
Richardson, T. S., y Spirtes, P. (2002). Ancestral graph Markov models. The Annals of Statistics, 30(4), 962–1030. https://doi.org/10.1214/aos/1031689015
Zhang, J. (2008). Causal reasoning with ancestral graphs. Journal of Machine Learning Research, 9, 1437–1474. https://www.jmlr.org/papers/volume9/zhang08a/zhang08a.pdf