Un servicio registra cuántas solicitudes logra atender cada día. A partir de ese archivo puede construirse un pronóstico excelente de la actividad del día siguiente. El mismo archivo puede resultar insuficiente para averiguar por qué algunos días se atienden pocas solicitudes: quizá llegan pocas, quizá falta capacidad o quizá una regla administrativa impide registrarlas. También puede ser insuficiente para decidir si conviene contratar una reserva. Esta decisión requiere conocer cuánto cuesta disponer de ella, qué pérdidas evita y si modifica el comportamiento de quienes solicitan el servicio.
El registro observado interviene en las tres tareas, pero ocupa posiciones distintas. Para pronosticar, es una variable cuyo valor futuro se intenta anticipar. Para explicar el funcionamiento del servicio, es la salida de un proceso que debe especificarse. Para decidir, forma parte de las consecuencias que se comparan entre acciones. Un indicador calculado sobre ese registro no adquiere automáticamente las tres interpretaciones. El significado de su buen desempeño depende de qué se le pidió producir y de las condiciones de evaluación.
Esta distinción afecta incluso a expresiones aparentemente sencillas, como «el modelo comete menos errores». Puede significar que asigna mejores probabilidades, que acierta más veces una categoría o que reduce un gasto. Cada afirmación presupone una comparación diferente. Una predicción muy segura puede acertar tantas categorías como otra más prudente y, sin embargo, inducir reservas innecesarias. Una explicación del límite de capacidad puede permitir anticipar el efecto de ampliarlo aunque no diga qué día concreto aparecerá una demanda extraordinaria.
Los ejemplos que siguen son construcciones didácticas, con distribuciones y costes estipulados. No representan observaciones de un servicio real. Su ventaja es que permiten calcular por separado qué pertenece al pronóstico, qué depende de la función de pérdida y qué exige información adicional sobre el proceso generador de los registros.
La pregunta determina qué debe sobrevivir a una prueba
Shmueli (2010) distingue entre modelado descriptivo, explicativo y predictivo. En su discusión, reserva operativamente el término explicativo para contrastar explicaciones causales, mientras que la predicción se refiere a observaciones nuevas. Esa elección organiza su argumento estadístico; no pretende establecer que toda explicación científica posible tenga una única forma causal. La distinción muestra por qué seleccionar variables, tratar errores de medición o evaluar un ajuste requiere atender al propósito del análisis.
En el servicio de solicitudes, una explicación causal podría sostener que las jornadas con pocas atenciones se deben a un límite de personal. Debería especificar cómo ese límite restringe las solicitudes atendidas y qué otras condiciones permanecen estables al modificarlo. Una evaluación pertinente podría comparar momentos o unidades donde la capacidad varió de una manera informativa, acompañada de mediciones de la demanda y de las reglas de registro. La concordancia con el número total atendido es una comprobación del modelo, pero deja abiertas otras explicaciones capaces de producir ese mismo total.
Un objetivo predictivo más estrecho sería estimar la distribución del número registrado mañana, antes de abrir el servicio y bajo las condiciones habituales. Para esa tarea importa que la información utilizada exista a esa hora y que el modelo conserve su desempeño en jornadas posteriores. Una variable puede ayudar a anticipar el resultado sin representar un componente que convenga intervenir. Por ejemplo, el calendario de una institución vecina puede anticipar afluencia aunque el servicio no tenga poder para cambiarlo.
Breiman (2001) contrapuso una cultura centrada en modelos probabilísticos del mecanismo de datos y otra orientada a algoritmos predictivos. Su defensa de la evaluación predictiva externa no convierte el acierto de un algoritmo en prueba de un mecanismo causal. El debate permite reconocer una tensión práctica: ajustar una estructura interpretable y anticipar bien nuevas observaciones son logros que pueden coincidir, pero deben examinarse por sus propios criterios.
La evaluación de una explicación también puede incluir predicciones. Si el mecanismo propuesto exige que aumentar la capacidad eleve las atenciones únicamente cuando existe demanda insatisfecha, esa consecuencia genera una prueba útil. Lo que cambia es el contenido de la predicción y las condiciones bajo las cuales discrimina entre mecanismos. Predecir una cifra que muchas explicaciones comparten aporta menos información sobre ellas que anticipar una respuesta en una situación donde sus consecuencias divergen.
La decisión añade otro componente. Incluso si se conoce el efecto de ampliar capacidad, puede no compensar su coste o puede competir con una obligación prioritaria. Para juzgar una regla de reserva hay que comparar consecuencias de acciones factibles. El conjunto de acciones y la valoración de sus resultados forman parte del problema; no aparecen al final como una traducción automática de la calidad estadística.
Tres pronósticos ante el mismo evento
Supongamos que interesa anticipar un episodio de demanda extraordinaria, representado por la variable binaria . Su valor es uno si ocurre el episodio y cero en caso contrario. Antes de decidir se conoce un contexto, bajo o alto, y ambos aparecen con igual frecuencia. Las probabilidades verdaderas del episodio son, por construcción, en el contexto bajo y en el alto.
Comparamos tres pronósticos. El modelo A comunica esas probabilidades. El modelo B anuncia y : conserva el orden de los contextos, pero exagera la seguridad. El modelo C anuncia siempre , ignorando el contexto. Para hacer visibles los cálculos puede imaginarse una tabla construida con mil jornadas de cada contexto: doscientos episodios en el bajo y ochocientos en el alto. Estos recuentos expresan exactamente la distribución estipulada; no son una muestra aleatoria utilizada para estimarla.
Si se anuncia «habrá episodio» cuando la probabilidad es al menos la mitad, A y B aciertan el ochenta por ciento de las jornadas. En ambos casos se equivocan en los doscientos episodios del contexto bajo y en las doscientas ausencias del contexto alto. C acierta la mitad, tanto si resuelve su empate anunciando siempre episodio como si anuncia siempre ausencia. La exactitud de clasificación no distingue la prudencia de A de la seguridad excesiva de B porque descarta la magnitud de las probabilidades una vez aplicado el umbral.
La AUC tampoco los separa. Interpretada como la probabilidad de que un episodio reciba mayor puntuación que una ausencia, con medio punto para los empates, vale para ambos. Entre los episodios, el ochenta por ciento procede del contexto alto; entre las ausencias, el ochenta por ciento procede del bajo. Los pares correctamente ordenados aportan . Los empates, sumando ambos contextos y contando su mitad, aportan . Cambiar las puntuaciones sin alterar ese orden conserva el resultado.
Para evaluar las probabilidades podemos usar la pérdida de Brier, aquí definida como el promedio de , donde es la probabilidad anunciada. Gneiting y Raftery (2007) estudian las reglas de puntuación propias: en esperanza, favorecen anunciar la distribución que genera la observación; la propiedad estricta exige que ese óptimo sea único. Adoptamos la convención de pérdida, en la que un valor menor es mejor. La expresión binaria utilizada aquí es una versión escalada de la puntuación cuadrática sobre todas las categorías.
La propiedad se comprueba directamente. Si la probabilidad verdadera es , entonces
El primer término permanece aunque se anuncie la probabilidad correcta. El segundo penaliza apartarse de ella. A obtiene ; B añade el cuadrado de una desviación de en cada contexto y obtiene . C obtiene . La diferencia entre A y B queda expuesta aunque ambos acierten las mismas categorías.
Otra posibilidad es la pérdida logarítmica, , con logaritmos naturales. Da aproximadamente , y para A, B y C, respectivamente. Penaliza especialmente asignar probabilidad muy pequeña a un evento que ocurre. Si se asigna probabilidad cero a ese evento, la pérdida es infinita. Su escala difiere de la de Brier: comparar los números de ambas columnas como si fueran la misma unidad carecería de sentido.
C permite distinguir otra propiedad. Anuncia la mitad y el episodio ocurre exactamente en la mitad del conjunto: está calibrado respecto de su único nivel anunciado. Sin embargo, renuncia a la información del contexto. A también está calibrado y diferencia dos situaciones relevantes. Por eso comprobar solo que la frecuencia global coincide con la probabilidad media deja sin evaluar una parte de la información predictiva. En B sucede lo contrario: conserva la ordenación útil, pero sus probabilidades se apartan de las frecuencias correspondientes.
La pérdida residual de A ayuda a interpretar qué significa acertar una probabilidad. En cada contexto queda una pérdida de Brier de , aunque el pronóstico sea exactamente correcto. Algunos días de probabilidad baja tienen episodios y algunos de probabilidad alta no los tienen. Declarar erróneo el modelo cada vez que ocurre uno de esos resultados confundiría una probabilidad con una predicción determinista. Tampoco sería razonable exigir que unas pocas jornadas reprodujeran exactamente sus frecuencias. La propiedad de la regla se refiere a la pérdida esperada bajo la distribución, y su evaluación empírica necesita suficientes observaciones comparables.
Ese residuo no establece que el episodio sea impredecible a partir de cualquier información imaginable. Establece el límite para la información que hemos estipulado: solo se conoce el contexto. Si se midiera una señal adicional antes de abrir, podrían distinguirse situaciones que hoy reciben la misma probabilidad. Evaluar esa mejora requeriría repetir la comparación con el mismo desenlace y con una disponibilidad realista de la señal. En cambio, incorporar una medición hecha después del episodio reduciría artificialmente el error sin mejorar el pronóstico disponible para reservar.
Convertir probabilidades en reservas
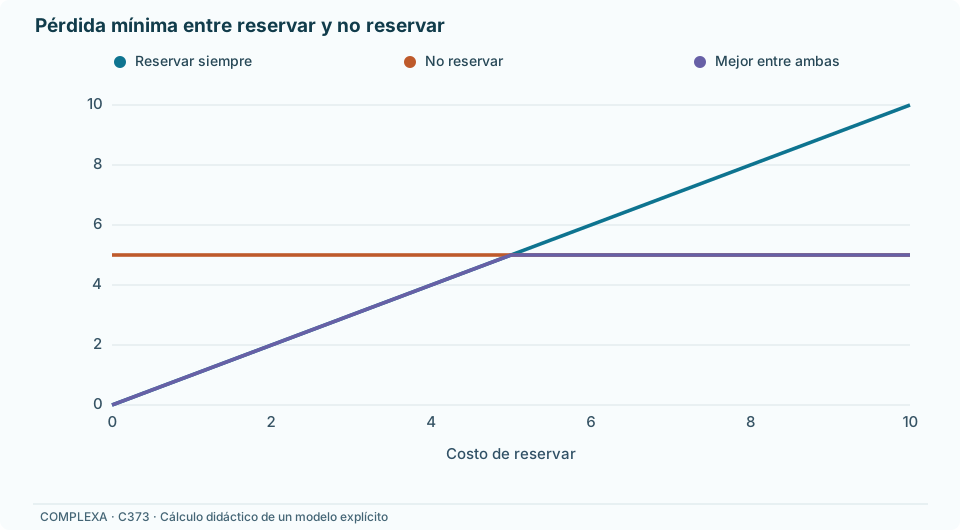
Ahora introducimos una acción concreta. Reservar capacidad cuesta unidades, ocurra o no el episodio. Si no se reserva y ocurre el episodio, la pérdida es diez; si no ocurre, la pérdida es cero. La reserva evita íntegramente esa pérdida. Suponemos que reservar no cambia la probabilidad del episodio y que los costes son conocidos y comparables en una misma unidad. Estas condiciones definen el ejemplo, incluida la eficacia completa de la reserva.
Con una probabilidad anunciada , la pérdida esperada de no reservar es , mientras que la de reservar es . La regla que minimiza la pérdida anunciada reserva cuando ; en la igualdad ambas acciones empatan. El umbral depende del coste. No hay una razón general para fijarlo en la mitad, pues la exactitud de clasificación trataba simétricamente errores que aquí tienen consecuencias diferentes.
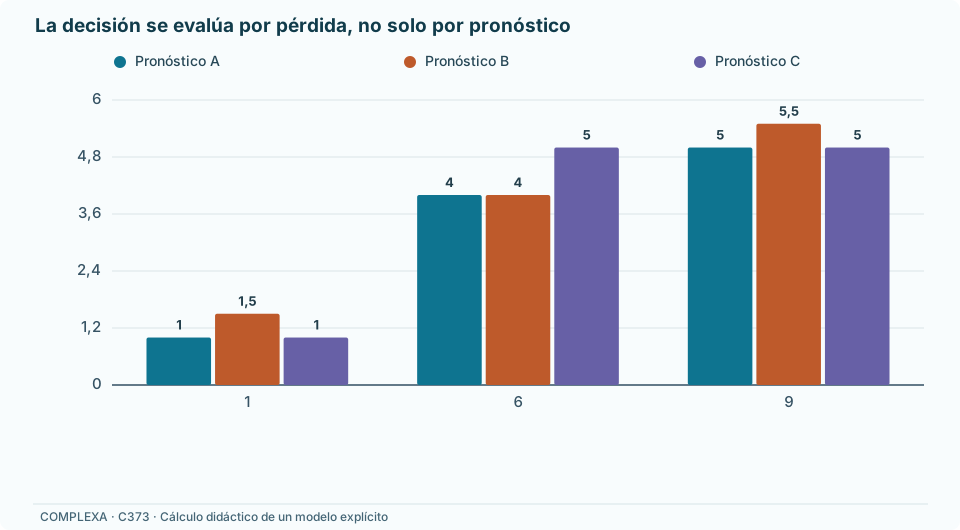
Para evaluar la regla usamos las probabilidades verdaderas de cada contexto, no las probabilidades anunciadas por el propio modelo. Con un coste de una unidad, el umbral es . A reserva en ambos contextos y su pérdida media es uno. B reserva solo en el alto. En el bajo queda una pérdida esperada de dos, y en el alto paga uno; como ambos aparecen con igual frecuencia, la media es . C reserva siempre y también obtiene uno.
El deterioro de B surge de su exceso de seguridad en el contexto bajo. Pronostica tan pocos episodios que rechaza una reserva cuyo coste sería inferior a la pérdida evitada. Su AUC de no detectaba este problema porque la acción depende de una probabilidad absoluta, comparada con un umbral económico. A y C coinciden en la acción pese a que sus probabilidades tienen distinta calidad. En este escenario, conocer el contexto no mejora la decisión de reservar siempre.
Con un coste de seis unidades, el umbral sube a . A y B reservan solo en el contexto alto y alcanzan una pérdida media de cuatro: la mitad de dos más la mitad de seis. C no reserva en ningún contexto y pierde cinco en promedio. Reservar siempre costaría seis, de modo que la comparación con reglas sencillas muestra una ganancia de una unidad respecto de no reservar y de dos respecto de reservar siempre.
Con un coste de nueve unidades, A y C no reservan y obtienen una pérdida de cinco. B continúa reservando en el contexto alto, donde anuncia una probabilidad de . Esa reserva cuesta nueve para evitar una pérdida esperada de ocho. Su pérdida media asciende a . La exageración que en el escenario anterior no cambiaba las acciones ahora induce un gasto excesivo.
| Coste de reservar | Pérdida con A | Pérdida con B | Pérdida con C | Reservar siempre | No reservar |
|---|---|---|---|---|---|
| 1 | 1 | 1,50 | 1 | 1 | 5 |
| 6 | 4 | 4 | 5 | 6 | 5 |
| 9 | 5 | 5,50 | 5 | 9 | 5 |
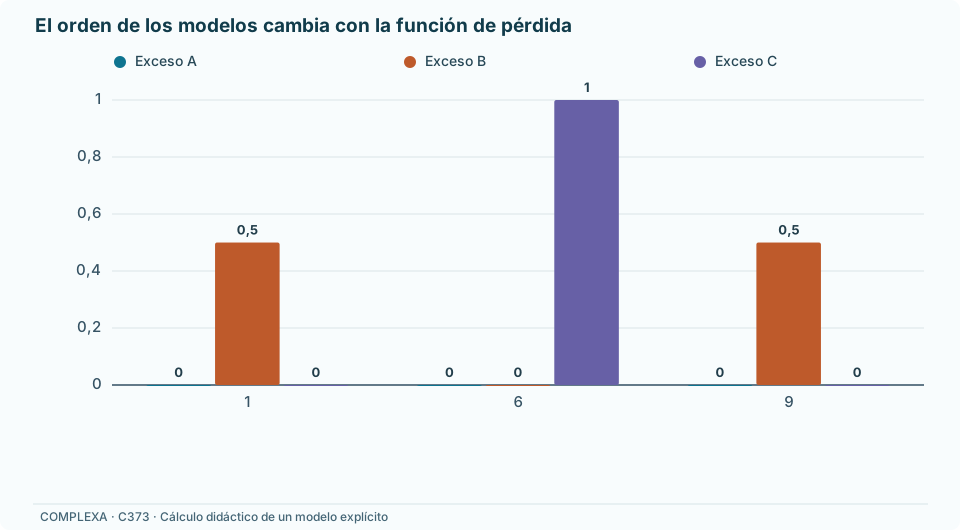
La tabla mantiene fija la población y modifica únicamente el coste. A conserva su superioridad como pronóstico probabilístico, pero el beneficio decisional de esa superioridad cambia. B empata con A para un coste y lo perjudica para otros. C, aun siendo poco informativo, produce decisiones óptimas cuando los costes hacen conveniente una acción uniforme. Una mejora en Brier puede tener valor para múltiples usos futuros sin generar ahorro en una decisión particular cuyo umbral nadie cruza.
Puede localizarse exactamente la pérdida adicional causada por una acción equivocada. Si la probabilidad verdadera en un contexto es , elegir la acción contraria a la óptima cuesta unidades adicionales en esperanza. Una regla que coincide con la óptima no tiene esa pérdida adicional, aunque anuncie una probabilidad imperfecta. B se equivoca al decidir en un contexto cuando el coste es uno y en el otro cuando es nueve; en ambos casos la diferencia local es una unidad. Al afectar a la mitad de las ocasiones, la diferencia global es media unidad. Con coste seis, sus acciones coinciden con las de A y esa diferencia es cero.
Esta expresión identifica qué errores de pronóstico afectan directamente a la decisión. Un error pequeño puede cambiar la acción si cruza el umbral, pero cuando la probabilidad verdadera está muy cerca de ese umbral la diferencia entre las dos acciones también es pequeña. Una discrepancia grande y situada al otro lado puede resultar mucho más costosa. Por ello, contar cuántas recomendaciones cambiaron tampoco basta para medir el valor de una actualización: hay que observar en qué contextos cambiaron y cuánto separa sus consecuencias.
Vickers y Elkin (2006) desarrollaron el análisis de curvas de decisión para comparar modelos mediante beneficios y daños relativos, incluyendo las alternativas de actuar sobre todos o sobre nadie. Su formulación clínica específica no es la función de coste que hemos estipulado aquí. El vínculo relevante es que una evaluación de decisiones debe mostrar cómo se valoran las consecuencias y con qué alternativas se compara la regla. La métrica predictiva, por sí sola, no determina esos valores.
La factibilidad también cambia el resultado. Si solo puede reservarse en la mitad de las ocasiones a largo plazo, la regla de A con coste uno deja de ser admisible. Bajo ese límite, destinar las reservas al contexto alto produce una pérdida de . La coincidencia con la pérdida anterior de B no rehabilita sus probabilidades: ahora existe una restricción diferente. Confundir ambas situaciones ocultaría si las ocasiones sin reserva responden a una escasez real o a un pronóstico demasiado confiado.
Una cifra óptima puede representar cosas distintas
La dependencia respecto de la pérdida aparece también al pedir una predicción puntual. Consideremos únicamente el contexto bajo y una demanda que vale cero con probabilidad y diez con probabilidad . Su media es dos, pero su valor más frecuente es cero. Queremos anunciar una cifra , o utilizarla para fijar capacidad. Antes de comparar cifras hay que establecer qué error se penaliza.
Si se usa error cuadrático, la pérdida esperada es
El óptimo es dos. Anunciar cero produce pérdida veinte, anunciar dos produce dieciséis y anunciar diez produce ochenta. La media minimiza este criterio aunque la demanda nunca sea exactamente dos. Una predicción puntual no necesita ser el valor más probable para cumplir su objetivo; aquí resume el equilibrio entre errores cuadrados de tamaños diferentes.
Si se usa error absoluto y se restringe la atención al intervalo de cero a diez, la pérdida esperada es . El óptimo es cero, una mediana de la distribución. Las pérdidas para las tres cifras anteriores son dos, y ocho. Fuera de ese intervalo, alejarse de todos los valores posibles aumenta la pérdida. La misma distribución conocida justifica una cifra óptima distinta cuando cambia el criterio.
Supongamos finalmente que representa capacidad disponible. Cada unidad de demanda no cubierta cuesta nueve y cada unidad de capacidad sobrante cuesta uno. Con , la pérdida es
Entre cero y diez, su esperanza es : disminuye hasta diez. Las pérdidas esperadas al escoger cero, dos o diez son dieciocho, dieciséis y ocho. El óptimo coincide con el cuantil de nivel , pues la penalización del déficit representa nueve de las diez unidades que suman ambos costes marginales. En este caso discreto, ese cuantil es diez.
No cambió lo que sabemos sobre la demanda. Cambió el uso de la cifra. Entregar la media a una persona que necesita capacidad para evitar faltantes costosos puede ser técnicamente correcto como pronóstico medio y resultar costoso como decisión. De modo inverso, anunciar diez como estimación de la media sería incorrecto aunque diez fuera la capacidad óptima bajo la pérdida asimétrica. Etiquetar la salida evita presentar una decisión conservadora como si fuera una descripción del comportamiento habitual.
La distribución completa permite calcular las tres respuestas sin entrenar tres modelos incompatibles. Sin embargo, una distribución estimada también tiene errores, especialmente en regiones poco observadas. La sensibilidad del cuantil relevante merece atención cuando los costes concentran la decisión en una cola. En el ejemplo todo es conocido; en una aplicación habría que evaluar si la muestra informa suficientemente sobre la probabilidad de demanda alta que sostiene la elección de diez unidades.
La interpretación de la capacidad presupone además un horizonte definido. Hemos cobrado el sobrante y el déficit al terminar una sola jornada. Si la capacidad sobrante pudiera transferirse a mañana, o si una solicitud no atendida quedara esperando, las consecuencias dependerían de estados posteriores. El cálculo de una jornada ya no describiría todo el problema. Habría que especificar el coste de esperar, la persistencia de la demanda y las posibilidades de reasignación. Una cifra óptima bajo pérdidas inmediatas no puede presentarse como solución de ese problema dinámico ampliado sin incorporar esas consecuencias.
Lo que desaparece cuando solo se observan atenciones
Hasta aquí hemos supuesto observable el episodio o la demanda. Volvamos al registro inicial del servicio. Supongamos un mecanismo sencillo: llegan solicitudes, existe capacidad , y las atenciones registradas son . Las solicitudes que exceden la capacidad se pierden y no quedan registradas. No hay espera para otro día, sustitución entre servicios ni respuesta de la demanda a la capacidad. Estas simplificaciones permiten aislar un problema de observación.
Durante el periodo histórico, la capacidad siempre fue cinco. Consideremos dos posibles leyes de demanda. En la primera, llegan cero solicitudes con probabilidad y cinco con probabilidad . En la segunda, llegan cero con probabilidad y diez con probabilidad . En ambos casos el registro observado vale cero o cinco, con esas mismas probabilidades. Ningún volumen adicional de registros obtenidos exclusivamente bajo esa capacidad distingue ambas leyes.
Un pronóstico que anuncie correctamente esa distribución de atenciones será igualmente bueno en ambos casos. También acertará la media histórica de una atención por jornada. Si la capacidad aumenta a diez y la demanda permanece como se ha especificado, la primera ley sigue dando una atención media, mientras que la segunda da dos. El incremento esperado es cero en un mecanismo y uno en el otro. La diferencia aparece al intervenir sobre una condición que antes ocultaba parte de la demanda.
Esta ambigüedad no se resuelve eligiendo un algoritmo más flexible para los mismos registros. Falta información que discrimine solicitudes iguales o superiores al antiguo límite. Medir las solicitudes rechazadas modificaría el sistema de observación. Variar la capacidad de manera informativa permitiría examinar qué ocurre por encima del límite anterior. Ambas estrategias hacen observables consecuencias que los datos históricos colapsaban en un mismo valor.
El mecanismo propuesto también puede fallar por razones comprobables antes de intentar identificar una ley de demanda. Si se registran más atenciones que unidades de capacidad, las variables no están midiendo lo que supone la ecuación o existe una posibilidad de sobrecarga que omitimos. Si quedan solicitudes sin atender mientras sobra capacidad utilizable, falta una regla de prioridad, una incompatibilidad de recursos o una demora. Estas observaciones cuestionan la relación entre demanda, capacidad y registro. Examinar tales discrepancias permite localizar qué componente debe revisarse, en vez de atribuir todos los residuos a un ruido indiferenciado. Una explicación mecanística gana contenido al indicar qué mediciones pondrían en dificultad cada relación. Que todavía no podamos distinguir las dos leyes de demanda no impide comprobar otras partes de esa estructura, ni autoriza a tratarlas como verificadas por el mero ajuste del total.
Tampoco bastaría observar que los días con más personal presentan más atenciones. Podría haberse asignado más personal precisamente cuando se esperaba mayor afluencia. Esa comparación mezcla el efecto de la capacidad con las razones para decidirla. El ejemplo de dos leyes mantiene la demanda estable al ampliar capacidad por definición; trasladar esa conclusión a un servicio exige justificar ese supuesto y el diseño que permite contrastarlo.
Kleinberg, Ludwig, Mullainathan y Obermeyer (2015) distinguen problemas de política cuyo componente desconocido principal es predictivo de aquellos que requieren estimar cómo una acción modifica un resultado. Su formulación permite separar la respuesta del entorno a la acción de la forma en que el estado del entorno afecta al valor de actuar. En la reserva didáctica, el episodio no cambia y la pérdida evitada está especificada; esas condiciones hacen posible decidir con una probabilidad. Cambiar precios, anunciar nueva capacidad o modificar reglas de acceso podría alterar la demanda y requerir información adicional sobre esa respuesta.
El requisito causal se localiza así en una parte concreta del cálculo. No toda decisión obliga a identificar de nuevo todos los mecanismos del sistema. Si la acción solo cambia cómo nos protegemos frente a un evento externo y sus consecuencias son conocidas, un pronóstico puede bastar. Cuando la acción transforma la distribución del evento, observarla bajo la política anterior no proporciona automáticamente la distribución que debe utilizarse para evaluar la nueva.
Evaluar antes de conocer el resultado
Los cálculos anteriores comparan distribuciones conocidas. Un proyecto real debe distinguir la selección del modelo de su evaluación. Si se elige la versión con mejor desempeño entre muchas variantes y se informa ese mismo desempeño, la cifra incorpora la ventaja de haber seleccionado un resultado favorable. La pregunta de uso exige observar qué ocurre cuando la regla ya está fijada y recibe casos que no participaron en esa selección.
El momento de predicción concreta qué datos están disponibles. Un modelo para reservar capacidad antes de abrir no puede utilizar el inventario al cierre, aunque ese campo aparezca junto a las demás variables en la base. Tampoco puede usar una clasificación administrativa que se completa después de conocer la demanda. Una partición aleatoria de filas no corrige esa filtración temporal: el campo contiene información futura en ambas partes. Hay que reconstruir las variables tal como existirían al emitir cada pronóstico.
Dawid (1984) formuló el enfoque prequential alrededor de pronósticos probabilísticos secuenciales para observaciones posteriores. Esa perspectiva sitúa la comprobación en la sucesión de anuncios y resultados. Una implementación para el servicio podría fijar una fecha de corte, producir diariamente las probabilidades con los datos disponibles y conservarlas antes de observar el desenlace. Si se actualiza el modelo, la regla de actualización también debe quedar especificada para saber qué procedimiento está siendo evaluado.
El diseño de la prueba depende además del destino de uso. Pronosticar días futuros del mismo servicio y trasladarse a otro con reglas de acceso diferentes son tareas distintas. Una evaluación temporal aborda la primera bajo las condiciones que efectivamente se observan durante el periodo de prueba. Evaluar otro servicio exige medir su población, capacidad y registro. La etiqueta «fuera de muestra» no convierte cualquier conjunto separado en una representación del destino relevante.
Incluso una modificación sencilla de la frecuencia de contextos cambia algunas comparaciones. Si el contexto alto pasa a representar una cuarta parte de las jornadas y las probabilidades condicionales permanecen iguales, la frecuencia global del episodio baja a . A sigue anunciando probabilidades correctas. C, que conserva su anuncio de , pierde su calibración global. Con coste seis, reservar solo en el contexto alto produce ahora pérdida tres, mientras que no reservar produce . La ganancia se reduce a media unidad porque existen menos ocasiones donde la reserva compensa. La calidad condicional de A permanece estable; cambió el peso de las situaciones sobre las que se calcula el valor.
Este cambio podría corregirse al describir la composición de la nueva población. Sería un problema diferente que, dentro del mismo contexto, el episodio se volviera más frecuente: entonces también cambiarían las probabilidades necesarias para decidir. Separar ambos desplazamientos ayuda a interpretar un deterioro observado. No basta conocer que bajó un indicador agregado; hay que reconstruir qué observaciones lo componen y si el modelo falló dentro de ellas o si se alteró la frecuencia con que aparecen.
Las medidas deben conservar esa referencia. En una evaluación de A, B y C se informarían sus pérdidas probabilísticas y su comportamiento por contexto, porque un promedio puede ocultar errores opuestos. Para la decisión se aplicarían reglas previamente fijadas y se calcularían las pérdidas con los costes acordados. Si esos costes no están fijados, puede mostrarse un rango explícito, como en la tabla, evitando seleccionar después el coste que favorece al modelo preferido.
Las diferencias observadas también tienen incertidumbre. En nuestros recuentos construidos, cada frecuencia reproduce exactamente la distribución estipulada. En jornadas reales, los episodios fluctúan y pueden agruparse por semanas o temporadas. Una comparación debería respetar esa dependencia y evaluar los modelos sobre las mismas ocasiones para no atribuir a su calidad diferencias debidas a otros días. Una ventaja pequeña necesita información suficiente sobre las ocasiones en que cambian las predicciones o las acciones.
La evaluación operacional puede modificar los datos disponibles. Si la reserva elimina la pérdida y el sistema solo registra incidentes con pérdida, dejarán de observarse algunos episodios. Reentrenar un pronóstico de episodios con ese registro sin reconocer el cambio confundiría ausencia de daño con ausencia del evento. Conviene conservar una medida del episodio independiente de la protección, o modelar explícitamente cómo la acción afecta al registro. En el ejemplo histórico, registrar solo atenciones ya producía una pérdida de información de esta clase.
Para el servicio descrito, un informe puede afirmar que A comunica mejor las probabilidades que B y mostrar cuánto cuesta su diferencia bajo cada escenario. Puede afirmar también que, con coste seis y sin restricciones adicionales, reservar únicamente en el contexto alto reduce la pérdida esperada respecto de las dos reglas uniformes. Ninguna de esas comprobaciones decide cuál de las dos leyes de demanda oculta opera cuando la capacidad es cinco. Antes de calcular la rentabilidad de ampliarla a diez, habría que observar solicitudes no atendidas o conseguir variación informativa de capacidad. Esa medición resolvería la parte del cálculo que el pronóstico del registro histórico dejó indeterminada.
Referencias
Breiman, L. (2001). Statistical modeling: The two cultures (with comments and a rejoinder by the author). Statistical Science, 16(3), 199–231. https://doi.org/10.1214/ss/1009213726
Dawid, A. P. (1984). Present position and potential developments: Some personal views: Statistical theory: The prequential approach. Journal of the Royal Statistical Society, Series A (General), 147(2), 278–290. https://doi.org/10.2307/2981683
Gneiting, T., y Raftery, A. E. (2007). Strictly proper scoring rules, prediction, and estimation. Journal of the American Statistical Association, 102(477), 359–378. https://doi.org/10.1198/016214506000001437
Kleinberg, J., Ludwig, J., Mullainathan, S., y Obermeyer, Z. (2015). Prediction policy problems. American Economic Review, 105(5), 491–495. https://doi.org/10.1257/aer.p20151023
Shmueli, G. (2010). To explain or to predict? Statistical Science, 25(3), 289–310. https://doi.org/10.1214/10-STS330
Vickers, A. J., y Elkin, E. B. (2006). Decision curve analysis: A novel method for evaluating prediction models. Medical Decision Making, 26(6), 565–574. https://doi.org/10.1177/0272989X06295361