De una ejecución correcta a un procedimiento reutilizable
En el capítulo 21 implementamos un intercambio discreto entre dos compartimentos y contrastamos sus resultados con una solución analítica. Aquella ejecución comprobaba una configuración, pero sus instrucciones estaban organizadas alrededor de valores escritos directamente en el programa. Para explorar otras condiciones podríamos copiar el bloque y modificar algunas líneas. El inconveniente es que cada copia puede adquirir diferencias no intencionales. Una copia podría empezar a registrar después del primer paso y otra calcular veintinueve rondas cuando se pedían treinta.
Ahora separaremos las operaciones que deben permanecer idénticas de las entradas que queremos cambiar. Una función implementará la regla de transición y otra organizará sus aplicaciones sucesivas. La trayectoria completa se almacenará en un arreglo con una estructura definida. Una operación de observación obtendrá, finalmente, cantidades comparables con datos sin modificar los estados calculados.
La separación no pretende demostrar que el sistema real esté formado por módulos independientes. Es una decisión sobre la representación computacional, en la que cada operación tiene una responsabilidad y unas entradas reconocibles. Gracias a ella el programa será más fácil de examinar. Cuando dos resultados difieran, podremos preguntar primero si cambió la regla de evolución o el estado inicial. Si ninguno de los dos cambió, la diferencia estará en el procedimiento de observación. Wilson y colaboradores (2017) recomiendan organizar el código en funciones reutilizables y conservar los datos originales separados de los productos del análisis. Este capítulo sigue esas recomendaciones.
Continuaremos con el mismo modelo para no confundir un cambio de organización del código con un cambio de mecanismo. Introduciremos NumPy, una biblioteca para operar con arreglos numéricos. El contenido necesario se explica aquí, de modo que no hace falta dominarla ni ejecutar los bloques para seguir los cálculos. Los bloques se verificaron con Python 3.13.5 y NumPy 2.3.5. Deben ejecutarse en el orden en que aparecen.
Función matemática, función de programa y argumentos
El estado sigue siendo el vector columna , con cantidades no negativas expresadas en la unidad . La ley de evolución es
Las fracciones y pertenecen a y corresponden a una ronda definida. El punto y coma separa el estado que evoluciona de los parámetros que permanecen fijos durante una ejecución. En Python, tanto el estado como esos parámetros pueden entregarse como argumentos. Por eso, en programación, un «parámetro de una función» puede ser el estado inicial o el número de rondas, que no son parámetros del modelo.
Una función matemática asocia una salida a cada entrada de su dominio. Una función de programa es un procedimiento ejecutable que, además de devolver un resultado, puede producir efectos laterales, como modificar los objetos que recibe o escribir archivos. Para nuestro mapa escogeremos un comportamiento más restringido. La función usará solo los argumentos recibidos y devolverá un estado nuevo, sin alterar el anterior ni consultar parámetros externos que puedan cambiar. Esto reduce las dependencias ocultas, aunque no elimina las diferencias numéricas entre entornos.
La instrucción def define una función y return especifica el resultado que devuelve. Definir la función no ejecuta todavía la transición. La llamada paso(estado, matriz) evalúa esa operación sobre los objetos entregados. Anotaciones como -> np.ndarray documentan el tipo previsto de la salida, aunque no sustituyen las comprobaciones durante la ejecución. Usaremos argumentos con nombre, como alpha=0.20, para hacer explícita su identidad. La documentación de Python describe estas reglas, incluida la restricción a argumentos nombrados mediante * (Python Software Foundation, s. f.).
Dividir el programa en muchas funciones no es un objetivo en sí mismo. Separaremos una operación cuando eso permita reutilizarla o comprobar una responsabilidad concreta. La definición matemática de la transición y la decisión de observar solo una de sus componentes merecen funciones distintas porque responden a preguntas distintas.
Valores, forma y ejes de un arreglo
Un arreglo de NumPy contiene elementos organizados mediante índices, con una forma y un tipo de dato (NumPy Developers, s. f.-e). El arreglo no guarda el significado científico de sus posiciones. En nuestro caso, np.array([100.0, 0.0]) construye el estado inicial, cuya forma es (2,), es decir, un eje con dos componentes. La coma indica que la forma es una tupla de un elemento. Un arreglo de forma (2, 1) tiene dos ejes y es otro objeto computacional.
Aunque la notación matemática use vectores columna, podemos guardarlos en arreglos de un eje siempre que las operaciones respeten esa convención. Hay que recordar, por ejemplo, que transponer un arreglo de forma (2,) no lo convierte en una columna bidimensional. La diferencia importa cuando se combinan operaciones cuyo comportamiento depende de los ejes.
Para guardar treinta transiciones y el estado inicial usaremos un arreglo de forma (31, 2), llamado historia, con el contrato
El primer eje identifica rondas y el segundo, componentes del estado. Como NumPy cuenta desde cero, historia[3, 0] es , la cantidad del primer compartimento después de tres rondas. La expresión historia[:, 0] selecciona la primera componente en todas las rondas y historia[0] selecciona el estado inicial completo. Estas operaciones siguen las reglas de indexación de la biblioteca (NumPy Developers, s. f.-d).
El estado se guardará separado de los metadatos de la ejecución. El arreglo contendrá cantidades, mientras que un registro asociado conservará las fracciones, la condición inicial, el número de pasos, el orden de las columnas y la unidad. No añadiríamos, por ejemplo, el identificador del experimento como tercera componente, porque podría entrar accidentalmente en un producto matricial. El índice de ronda tampoco pertenece al estado de este modelo autónomo. Si una regla futura dependiera explícitamente del tiempo, ese argumento tendría que aparecer en la especificación de la transición.
La distinción entre datos y metadatos depende de la tarea. Una fracción es un parámetro fijo en esta simulación, pero podría ser el resultado estimado de otro procedimiento. Su papel lo determina la operación científica en la que participa, cualquiera sea el formato en que esté almacenada.
La forma comprueba cuántas posiciones hay, pero nada dice de su contenido conceptual. Dos columnas intercambiadas siguen produciendo un arreglo de forma correcta. Por eso las salidas irán acompañadas de la unidad y del orden de las columnas, que es ("x", "y"). La definición de ronda también forma parte de esa documentación. Si más adelante reunimos varios escenarios, habrá que indicar además qué recorre el eje adicional. Puede tratarse de personas distintas o de configuraciones del modelo, entre otras posibilidades. Esa información debe acompañar al arreglo, porque dos ejes del mismo tamaño pueden recorrer categorías muy diferentes.
Construir la transición y elegir el tipo numérico
La función siguiente construye la matriz del modelo a partir de sus fracciones e incluye las comprobaciones de esos parámetros.
import numpy as np


def matriz_intercambio(alpha: float, beta: float) -> np.ndarray:
    alpha, beta = float(alpha), float(beta)
    if not (np.isfinite(alpha) and np.isfinite(beta)):
        raise ValueError("Las fracciones deben ser finitas.")
    if not (0.0 <= alpha <= 1.0 and 0.0 <= beta <= 1.0):
        raise ValueError("Cada fracción debe estar entre 0 y 1.")
    return np.array([[1.0 - alpha, beta],
                     [alpha, 1.0 - beta]], dtype=np.float64)


def paso(estado: np.ndarray, matriz: np.ndarray) -> np.ndarray:
    # Función interna que presupone formas (2,) y (2, 2).
    return matriz @ estado
La función np.isfinite excluye los infinitos y los valores NaN. Los argumentos previstos son escalares reales convertibles a float, de modo que una colección de fracciones distintas produce un error. La opción dtype=np.float64 pide almacenamiento en coma flotante de 64 bits. La documentación de NumPy distingue estos tipos de los enteros y describe sus límites de representación (NumPy Developers, s. f.-c). Esta elección admite cantidades fraccionarias, aunque las operaciones siguen sin ser aritmética real exacta.
La elección tiene consecuencias observables. Supongamos que los estados se guardan en un arreglo de enteros. Desde , con las fracciones , las dos primeras transiciones producen y . La transición siguiente debería producir , pero al asignar esos valores a posiciones enteras se descartan las fracciones y quedan y . El total almacenado baja a . La pérdida no es física, porque la produce la representación. Si el cálculo continúa, el total sigue bajando hasta que el arreglo queda fijo en desde la ronda 12, con un total de .
Redondear los resultados y llamarlos «personas» tampoco corregiría el problema. El modelo describe cantidades divisibles. Con redondeo al entero más cercano, el total se mantiene en este ejemplo, pero la regla adquiere tres estados fijos con total , que son , y , donde el modelo original tiene un solo equilibrio. Describir recuentos individuales exigiría especificar otra regla, por ejemplo una transición estocástica de individuos. Cambiar el tipo numérico no hace esa construcción.
La función paso presupone que recibe un estado y una matriz compatibles. La función que organiza la simulación comprobará ese contrato una sola vez. Así la operación matemática queda visible y los mismos controles no se repiten en cada ronda.
Producto matricial, operaciones por componentes y orientación
Con , y , el producto matricial debe dar
NumPy usa @ para el producto matricial de estos arreglos (NumPy Developers, s. f.-h). El operador *, en cambio, multiplica componente a componente y puede extender dimensiones compatibles mediante reglas que veremos enseguida. Para nuestra matriz y nuestro estado, A * z0 produce una tabla de dos por dos.
En este ejemplo, el producto por componentes es . Sumar sus filas recupera , porque aquí reproduce la definición del producto de matriz por vector. Sumar sus columnas devuelve , un arreglo con la forma y el total correctos que coincide con el estado inicial. Que no aparezca un error de dimensiones no demuestra que la operación corresponda a las ecuaciones.
El orden de los factores también importa. z0 @ A devuelve , porque trata el primer operando como vector fila. Si los estados se escriben como filas, el estado siguiente es . Para un conjunto de estados guardados por filas en un arreglo , la actualización simultánea es . La transposición procede de la identidad .
La biblioteca permite expresar esas operaciones, aunque no sabe qué compartimento envía material a cuál. Mantener una sola convención durante el ejemplo simplifica la comprobación. Generalizaremos a lotes de estados cuando una pregunta lo requiera; por ahora interesa construir correctamente una trayectoria.
Una función de simulación con entradas y salida explícitas
Añadimos una función que recibe las condiciones del experimento. El bloque se usa después de las definiciones anteriores.
def simular(inicial, *, alpha: float, beta: float,
            pasos: int) -> np.ndarray:
    if type(pasos) is not int or pasos < 0:
        raise ValueError("pasos debe ser un entero no negativo.")
    estado = np.array(inicial, dtype=np.float64, copy=True)
    if estado.shape != (2,) or not np.all(np.isfinite(estado)):
        raise ValueError("El estado debe tener dos valores finitos.")
    if np.any(estado < 0.0):
        raise ValueError("Las cantidades deben ser no negativas.")
    matriz = matriz_intercambio(alpha, beta)
    historia = np.zeros((pasos + 1, 2), dtype=np.float64)
    historia[0] = estado
    with np.errstate(over="raise", invalid="raise"):
        for n in range(pasos):
            historia[n + 1] = paso(historia[n], matriz)
    return historia


inicial = np.array([100.0, 0.0])
trayectoria = simular(inicial, alpha=0.20, beta=0.10, pasos=30)
Los controles exigen dos cantidades finitas no negativas y un número entero de pasos. En esta interfaz, pasos debe ser un entero de Python, así que el control excluye deliberadamente 30.0 y los valores lógicos. Es una regla de entrada que evita conversiones implícitas, sin contenido matemático propio. Con cero pasos, la función devuelve solo el estado inicial.
La llamada a np.zeros reserva el arreglo de salida. Cada fila calculada se copia en posiciones propias, de modo que no se guardan treinta referencias a un único estado mutable. La opción copy=True separa además el estado inicial de un posible arreglo entregado por quien llama. El bloque np.errstate hace que un desbordamiento o una operación inválida detengan el cálculo con una excepción (NumPy Developers, s. f.-g). Sin ese bloque, NumPy emitiría solo una advertencia y el cálculo continuaría con valores no finitos. El bloque no elimina los errores de redondeo.
El producto matriz @ estado devuelve un arreglo nuevo, porque no se le entrega un argumento de salida preasignado. Así, calcular la fila siguiente no sobrescribe la fila que se está leyendo. La dependencia temporal se conserva mediante el bucle, sin paralelismo alguno.
Esta función solo calcula estados. No abre archivos ni dibuja gráficos. Sus primeros resultados son , , y , iguales a los del capítulo 21. La modificación es organizativa, porque otra llamada puede cambiar las entradas sin reescribir la regla.
Copias y vistas de un arreglo
En NumPy, la indexación básica, como trayectoria[:, 0], devuelve una vista, es decir, un arreglo que comparte la memoria de sus valores con el original. Una copia duplica esos valores. La indexación avanzada, con listas de índices o máscaras lógicas, devuelve una copia. La documentación advierte que modificar una vista modifica también el contenido compartido (NumPy Developers, s. f.-b).
Consideremos el bloque siguiente, aplicado a una copia de trabajo para no destruir el ejemplo principal.
afectada = trayectoria.copy()
x_para_mostrar = afectada[:, 0]
x_para_mostrar /= 100.0
print(afectada[0])
La salida es [1. 0.]. La operación destinada a mostrar la primera componente como fracción cambió el estado almacenado, que era . En la primera ronda aparece donde debería estar . Sumar esas columnas ya no evalúa la conservación en una unidad común.
Para conservar el registro podemos escribir x_para_mostrar = trayectoria[:, 0].copy() antes de dividir, o producir un resultado separado con trayectoria[:, 0] / 100.0. La asignación aumentada /= modifica los valores existentes, mientras que la división ordinaria devuelve otro arreglo y deja intacta la trayectoria. Antes de extender esta regla a otros objetos o combinaciones de índices hay que conocer la operación concreta (NumPy Developers, s. f.-b).
Una comprobación hecha antes de la transformación visual no detectaría la alteración posterior. Por eso las funciones de presentación no deben escribir sobre los datos que reciben. La exigencia preserva la asociación entre el registro guardado y el modelo que lo produjo.
En un proyecto mayor también conservaríamos los datos originales fuera de las operaciones de limpieza. Esos datos pueden necesitar procesamiento, pero los valores recibidos y las transformaciones aplicadas deben seguir siendo recuperables, como recomiendan Wilson y colaboradores (2017).
Ejes de reducción y extensión automática de formas
Para obtener el total en cada ronda escribimos trayectoria.sum(axis=1), que suma sobre el eje de componentes y conserva el de rondas (NumPy Developers, s. f.-i). La llamada sum(axis=0) suma cada componente a lo largo de las rondas y, sin especificar eje, se suman todos los elementos. Los tres resultados son diferentes. Una suma de estados registrados tampoco equivale a una integral temporal, porque todavía faltaría definir intervalos y ponderaciones.
La extensión automática de formas, conocida como broadcasting, permite combinar arreglos cuyas formas no son idénticas (NumPy Developers, s. f.-a). NumPy compara los tamaños desde los ejes finales y admite tamaños iguales o un tamaño uno que puede extenderse. La regla sirve, por ejemplo, para multiplicar cada columna por un factor, pero no incorpora el significado de las posiciones.
Veamos un error concreto. Queremos comparar cuatro observaciones de con las predicciones de las mismas cuatro rondas. Si ambas series tienen forma (4,), la resta empareja las posiciones correspondientes. Si una tiene forma (4, 1) y la otra (4,), la resta produce una matriz (4, 4) que compara cada observación con todas las predicciones.
El promedio de los dieciséis errores cuadráticos se calcula sin advertencia alguna, aunque responde a otra comparación. Exigir la misma forma antes de restar evita este fallo. Aun así, cuatro fechas desordenadas conservarían la forma y producirían otro error, de modo que también hay que verificar la identidad y el orden de los registros.
Vectorizar consiste en expresar ciertas operaciones mediante arreglos. Las dependencias del algoritmo siguen existiendo, porque las rondas de nuestro modelo están encadenadas. Podemos operar a la vez sobre componentes o escenarios independientes, pero cada estado temporal depende del anterior.
Del estado simulado al observable
Una trayectoria completa puede contener variables que ningún instrumento observa. Separaremos la ley de evolución de una regla de observación y escribiremos
Aquí reúne los parámetros dinámicos y , los de la observación. El sombrero marca la salida predicha por las ecuaciones. Todavía no designa una esperanza probabilística, porque no hemos definido ningún modelo de error. El valor observado es y es su discrepancia respecto de esa salida. No hemos supuesto que las discrepancias sean aleatorias o independientes, ni que dependan solo del instrumento. Esa interpretación exigiría un modelo adicional.
Para este ejemplo elegimos una observación lineal , con pesos adimensionales fijos. Los pesos seleccionan y los pesos registran el total. Los dos observables se miden en , aunque son cantidades distintas. La implementación es la siguiente.
def observar(historia: np.ndarray,
             pesos: tuple[float, float]) -> np.ndarray:
    valores = np.asarray(historia, dtype=np.float64)
    w = np.asarray(pesos, dtype=np.float64)
    if valores.ndim != 2 or valores.shape[1] != 2:
        raise ValueError("Se requieren dos columnas de estado.")
    if w.shape != (2,):
        raise ValueError("Se requieren dos pesos.")
    if not (np.all(np.isfinite(valores)) and
            np.all(np.isfinite(w))):
        raise ValueError("Los valores deben ser finitos.")
    return valores @ w
Como los estados están guardados por filas, el producto por el arreglo de pesos entrega una salida por ronda. La función no modifica los valores recibidos, así que pueden aplicarse distintas reglas de observación a la misma trayectoria sin repetir la simulación.
La separación permite analizar qué información queda disponible. Si solo observamos , toda la trayectoria observada vale para cualquier par de fracciones admisibles con ese total inicial (figura 22.1). Ese registro no permite recuperar y , incluso sin error de medición. Observar más rondas tampoco añade variación que distinga las fracciones en este experimento. Algo parecido ocurrió en el capítulo 21, donde la proporción no distinguía en las rondas avanzadas la regla correcta de la defectuosa.
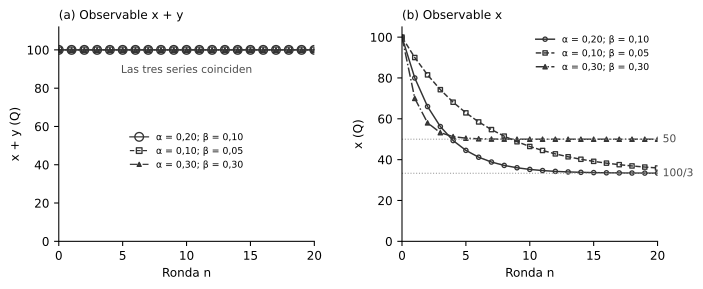
Registrar rompe esa equivalencia en muchos escenarios. Desde , el primer paso da y fija . Con se obtiene después . Aun así, registrar no garantiza identificar los parámetros en cualquier condición. Si el sistema comienza en un equilibrio común a varios pares de fracciones, la serie observada es constante. Desde , por ejemplo, todos los pares con producen en todas las rondas. Lo que puede recuperarse depende del observable elegido y del estado inicial, dentro de la estructura que impone el modelo.
Un contraste numérico completo con datos construidos
Definamos cuatro valores sintéticos, expresados en , para las rondas cero a tres. No proceden de mediciones, porque los construimos añadiendo discrepancias conocidas a la trayectoria de referencia. Por esa procedencia no pueden usarse como evidencia empírica del mecanismo.
Cuadro 22.1. Predicciones de y datos sintéticos construidos para las rondas 0 a 3, en .
| Ronda | Predicción de | Dato sintético | Dato menos predicción |
|---|---|---|---|
| 0 | 100,0 | 99,8 | −0,2 |
| 1 | 80,0 | 80,3 | 0,3 |
| 2 | 66,0 | 65,7 | −0,3 |
| 3 | 56,2 | 56,4 | 0,2 |
El bloque siguiente comprueba que las series tengan la misma forma antes de calcular la raíz del promedio de las diferencias cuadráticas, conocida como RMSE por su sigla en inglés.
predicho = observar(trayectoria, (1.0, 0.0))[:4]
observado = np.array([99.8, 80.3, 65.7, 56.4])
if observado.shape != predicho.shape:
    raise ValueError("Las series deben tener la misma forma.")
residuos = observado - predicho
rmse = float(np.sqrt(np.mean(residuos**2)))
print(f"RMSE = {rmse:.6f} Q")
En esta comparación, la posición cero de ambos arreglos corresponde a la ronda cero. Si un archivo empírico comenzara después de la primera transición, habría que alinear sus índices antes de restar. Tomar las primeras cuatro filas de dos archivos no demuestra que correspondan a los mismos instantes. Tampoco basta que compartan etiquetas como «día 1» si uno registra el comienzo del día y otro su cierre. En nuestro modelo discreto, elegir un estado entre dos rondas exigiría una regla adicional, porque todavía no tenemos una trayectoria continua que lo defina.
El cálculo manual confirma el resultado que imprime el bloque,
Si por error observado tuviera forma (4, 1) y se omitiera el control, la raíz del promedio de las dieciséis diferencias cuadráticas daría aproximadamente . La cifra no describe una nueva medición ni un deterioro del modelo, porque procede del emparejamiento equivocado.
Tampoco interpretaríamos la RMSE correcta como prueba de causalidad o de calibración. Elegimos las fracciones antes de comparar y construimos los datos alrededor de esa salida, así que el ejemplo solo verifica un procedimiento de comparación. Estimar parámetros con observaciones independientes exigiría una función de ajuste y criterios de evaluación que estudiaremos más adelante.
Existe otra decisión posible, que consiste en reemplazar cada estado calculado por el dato disponible antes de continuar. El resultado ya no sería la trayectoria libre que definimos. Sería un esquema con correcciones mediante observaciones, cuya regla de actualización habría que especificar. Guardar datos y estados en arreglos separados obliga a introducir ese esquema de manera deliberada y evita hacerlo por descuido durante una comparación.
Comprobar contratos, resultados y aislamiento de las operaciones
La reutilización exige comprobar qué permanece constante entre llamadas. Conservar el total es necesario en nuestro modelo, aunque no detecta todos los errores de parámetros. Usaremos otra vez la solución analítica, junto con verificaciones propias de esta organización del código.
n = np.arange(trayectoria.shape[0])
x_ref = 100.0 / 3.0 + (200.0 / 3.0) * 0.7**n
referencia = np.column_stack((x_ref, 100.0 - x_ref))
if trayectoria.shape != referencia.shape:
    raise RuntimeError("La estructura de salida es incorrecta.")
if not np.allclose(trayectoria, referencia,
                   rtol=1e-12, atol=1e-10):
    raise RuntimeError("Discrepancia con la solución analítica.")
if not np.array_equal(inicial, np.array([100.0, 0.0])):
    raise RuntimeError("La simulación alteró el estado recibido.")
En este bloque, np.allclose aplica a cada componente el criterio abs(a - b) <= atol + rtol * abs(b), que toma el segundo argumento como referencia (NumPy Developers, s. f.-f). La regla difiere de la de math.isclose presentada en el capítulo 21. La función admite también la extensión de formas compatibles, por lo que comprobamos la forma antes de invocarla. Las tolerancias elegidas corresponden a este ejemplo y a sus unidades, sin significado clínico.
También hay que comprobar una segunda llamada después de modificar una copia de presentación. Si la salida cambiara con las mismas entradas y el mismo entorno, habría que buscar memoria compartida o dependencias externas, porque la función no debe conservar un historial mutable entre ejecuciones. Del mismo modo, una prueba con pasos=0 debe devolver una sola fila. Con fracciones nulas, todos los estados registrados deben ser iguales al inicial.
Algunas propiedades permiten construir pruebas sin otra fórmula cerrada. Como la transición es lineal, multiplicar las dos cantidades iniciales por una constante no negativa debe multiplicar por esa misma constante todos los estados posteriores. Asimismo, las primeras once filas de una ejecución de treinta pasos deben coincidir con una ejecución de diez pasos, porque el horizonte de almacenamiento no interviene en la regla. Dentro de la tolerancia numérica apropiada, estas relaciones detectan normalizaciones introducidas en la función o dependencias indebidas del horizonte. Una versión que normalizara el estado inicial para que sumara uno, por ejemplo, fallaría la prueba de escala y aprobaría la del horizonte. Ninguna de las dos relaciones sería exigible a un modelo no lineal ni a una estrategia de control que usara el tiempo restante.
Estas pruebas amplían las del capítulo 21, porque además de valores examinan cómo se relaciona la salida con la entrada. Un conjunto finito de ejecuciones satisfactorias no se convierte por ello en una demostración universal. Las propiedades algebraicas aportan otra forma de justificación, complementaria de las pruebas hechas sobre el programa.
Consolidación y continuidad del procedimiento
Las distinciones del capítulo pueden recuperarse mediante variaciones precisas. Si cambia , cambia la transición. Otro valor de inicial selecciona otra trayectoria de la misma ley, mientras que otros pesos en observar modifican qué se registra de esa trayectoria. Los decimales impresos, en cambio, no deberían alterar ninguna de esas operaciones. Cada variante tiene un lugar identificable en el programa.
Si intercambiamos las etiquetas de los compartimentos, hay que intercambiar de manera consistente todo lo que depende de ellas, desde las componentes del estado hasta los pesos de observación. Cambiar solo los nombres de las columnas deja intactas las cifras y altera su interpretación. Sustituir un registro ausente por cero añade, por su parte, una afirmación sobre su valor que la ausencia no justifica.
En una aplicación clínica, esta separación exigiría definir qué cantidad corresponde a cada estado y qué mide el instrumento. También habría que precisar cómo se relacionan temporalmente sus registros. Con ello no se transforma una puntuación en una cantidad conservada ni una salida simulada en un dato observado. El ejemplo de dos compartimentos entrega operaciones verificables, mientras que cualquier correspondencia empírica tendría que formularse por separado.
El procedimiento desarrollado recibe condiciones explícitas y devuelve estados que pueden observarse sin modificarlos. El capítulo 23 usará esas salidas para comparar representaciones gráficas y examinar cómo elegir los ejes y los resúmenes de una figura sin confundir la trayectoria calculada con su imagen.
Ejercicios
Ejercicio 22.1. El arreglo h tiene forma (31, 2) y su primera fila es [100., 0.]. (a) Indique la forma de h[:, 0], h[0], h[3, 0], h[:4], h.sum(axis=0), h.sum(axis=1) y h.sum(). (b) ¿Cuáles de esas expresiones devuelven una vista de h? (c) Se ejecutan a = h[:, 0] y a *= 2. Después se ejecutan c = h[[0, 1], :] y c[0, 0] = -1. ¿Qué valores tiene ahora h[0]?
Ejercicio 22.2. Con y , calcule (a) A @ z0, z0 @ A y A * z0 para y (b) las sumas de A * z0 por filas y por columnas. (c) Calcule el estado siguiente de cada fila de mediante .
Ejercicio 22.3. Suponga que historia se crea con tipo entero y que cada asignación trunca la parte fraccionaria. (a) Calcule desde los estados de las rondas 3 a 5 y el total en cada una. (b) Con un programa, determine el estado en que el arreglo queda fijo y su total. (c) Repita (b) con np.round y encuentre todos los estados fijos con total 100. (d) ¿Qué muestran ambos resultados sobre el tipo numérico como decisión de modelamiento?
Ejercicio 22.4. Indique la forma del resultado, o si se produce un error, al restar a un arreglo de forma (31, 2) otro de forma (a) (2,), (b) (31,) o (c) (31, 1). (d) ¿Cuál de esas restas sirve para restar a cada ronda su propio total? ¿Cómo se obtiene el arreglo de totales?
Ejercicio 22.5. Una investigadora conoce el estado inicial y observa solo . (a) Si y , calcule y . (b) Muestre que, desde , cualquier par con produce en todas las rondas. (c) ¿Qué puede recuperarse si solo se observa ?
Ejercicio 22.6. Una versión modificada de simular divide el estado inicial por su suma antes de iterar y multiplica por 100 la trayectoria final. (a) ¿Coincide su salida con la original desde ? (b) ¿Qué ocurre desde ? (c) ¿Cuál de las pruebas de propiedades del capítulo detecta el cambio y cuál no?
Consultar las soluciones de los ejercicios
Soluciones de los ejercicios
Solución 22.1. (a) Las formas son (31,), (2,), un escalar de forma (), (4, 2), (2,), (31,) y otro escalar. (b) Devuelven vistas h[:, 0], h[0] y h[:4], que usan indexación básica. h[3, 0] devuelve un número y las sumas producen arreglos nuevos. (c) h[0] vale [200., 0.]. La variable a es una vista, así que duplicar sus valores duplica la primera columna de h. La variable c es una copia obtenida por indexación avanzada, de modo que cambiarla no afecta a h.
Solución 22.2. (a) A @ z0 da , z0 @ A da y A * z0 da . (b) La suma por filas es , igual al producto matricial. La suma por columnas es , es decir, el estado inicial sin transición. (c) Los estados siguientes son , y .
Solución 22.3. (a) Los estados son , y , con totales 99, 98 y 97. (b) El arreglo queda fijo en desde la ronda 12, con un total de 90. (c) Con np.round, el arreglo queda fijo en desde la ronda 11. Los estados fijos con total 100 son , y . (d) El tipo numérico cambia la regla. El truncamiento crea pérdidas que el modelo no contiene y el redondeo crea varios estados fijos donde el modelo tiene uno solo. Contar individuos exigiría formular otro modelo.
Solución 22.4. (a) El resultado tiene forma (31, 2) y resta el mismo par a cada fila. (b) Se produce un error, porque los ejes finales miden 2 y 31. (c) El resultado tiene forma (31, 2) y resta un mismo valor a las dos componentes de cada fila. (d) Sirve la resta (c), con el arreglo h.sum(axis=1, keepdims=True), de forma (31, 1). En la ronda 1 el resultado es .
Solución 22.5. (a) Como , se obtiene . Con , la ecuación da . (b) El equilibrio es para todo par con . El estado inicial es el equilibrio de todos esos pares, así que no cambia. (c) Solo el total, . El registro no contiene información sobre ni sobre .
Solución 22.6. (a) Sí, porque el estado normalizado multiplicado por 100 reproduce la trayectoria original. (b) La versión modificada devuelve la misma trayectoria que desde , mientras que la original duplica todos los estados. (c) La prueba de escala detecta el cambio. La prueba del horizonte lo deja pasar, porque la modificación no depende del número de pasos.
Referencias
NumPy Developers. (s. f.-a). Broadcasting. Recuperado el 19 de septiembre de 2026, de https://numpy.org/doc/stable/user/basics.broadcasting.html
NumPy Developers. (s. f.-b). Copies and views. Recuperado el 19 de septiembre de 2026, de https://numpy.org/doc/stable/user/basics.copies.html
NumPy Developers. (s. f.-c). Data types. Recuperado el 19 de septiembre de 2026, de https://numpy.org/doc/stable/user/basics.types.html
NumPy Developers. (s. f.-d). Indexing on ndarrays. Recuperado el 19 de septiembre de 2026, de https://numpy.org/doc/stable/user/basics.indexing.html
NumPy Developers. (s. f.-e). The N-dimensional array (ndarray). Recuperado el 19 de septiembre de 2026, de https://numpy.org/doc/stable/reference/arrays.ndarray.html
NumPy Developers. (s. f.-f). numpy.allclose. Recuperado el 19 de septiembre de 2026, de https://numpy.org/doc/stable/reference/generated/numpy.allclose.html
NumPy Developers. (s. f.-g). numpy.errstate. Recuperado el 19 de septiembre de 2026, de https://numpy.org/doc/stable/reference/generated/numpy.errstate.html
NumPy Developers. (s. f.-h). numpy.matmul. Recuperado el 19 de septiembre de 2026, de https://numpy.org/doc/stable/reference/generated/numpy.matmul.html
NumPy Developers. (s. f.-i). numpy.sum. Recuperado el 19 de septiembre de 2026, de https://numpy.org/doc/stable/reference/generated/numpy.sum.html
Python Software Foundation. (s. f.). The Python tutorial: More control flow tools. Recuperado el 19 de septiembre de 2026, de https://docs.python.org/3/tutorial/controlflow.html
Wilson, G., Bryan, J., Cranston, K., Kitzes, J., Nederbragt, L. y Teal, T. K. (2017). Good enough practices in scientific computing. PLOS Computational Biology, 13(6), e1005510. https://doi.org/10.1371/journal.pcbi.1005510