Qué añade una implementación a las ecuaciones
Con este capítulo comienza la tercera parte del tomo, dedicada a la simulación reproducible y al análisis numérico. En el capítulo 20 comparamos dos representaciones de un mismo proceso de intercambio entre compartimentos y examinamos sus equilibrios y sus reducciones. El paso siguiente consiste en transformar la descripción matemática en instrucciones ejecutables, de manera que pueda reconstruirse cómo se obtuvo cada resultado. Esa transformación obliga a tomar decisiones que una fórmula puede dejar implícitas. Hay que establecer en qué momento se actualiza cada variable y qué estado se conserva para el cálculo siguiente. También hay que decidir cómo se registran las observaciones.
Supongamos que dos programas reciben los mismos parámetros y producen trayectorias diferentes. Antes de buscar una explicación física habría que comprobar que ambos ejecutan la misma regla. Uno podría actualizar simultáneamente las dos variables; el otro, usar el valor recién modificado de la primera para calcular la segunda. En ese caso la discrepancia correspondería a dos dinámicas distintas, aunque ambos programas se presentaran como implementaciones de las mismas ecuaciones.
Trabajaremos con un modelo pequeño que también puede resolverse algebraicamente. Con esa referencia podremos examinar el programa sin depender solo de su propia salida. El propósito del capítulo es seguir una ejecución completa hasta reconocer sus dependencias y relacionar cada resultado con la especificación que lo produjo. Todavía no necesitamos una biblioteca científica ni un integrador de ecuaciones diferenciales.
Adoptaremos las definiciones de las National Academies of Sciences, Engineering, and Medicine (2019, cap. 3). La reproducibilidad computacional consiste en obtener resultados consistentes con los mismos datos de entrada y los mismos procedimientos de cálculo, en condiciones de análisis equivalentes. La replicabilidad consiste en obtener resultados consistentes en estudios que recogen datos nuevos para responder una misma pregunta. Según estas definiciones, reproducir una simulación no equivale a replicar empíricamente el mecanismo que el modelo supone. Como la terminología varía entre disciplinas, hay que declararla desde el principio.
Sandve y colaboradores (2013) recomiendan asociar cada resultado con el procedimiento que lo produjo, incluidos los parámetros y las versiones del software. En este capítulo aplicaremos esa recomendación a un ejemplo cuyas operaciones pueden revisarse íntegramente.
Especificación del intercambio discreto entre dos compartimentos
Sean e dos cantidades no negativas medidas en una misma unidad . El subíndice cuenta rondas de intercambio. En cada ronda, una fracción de lo que contenía al comenzar la ronda pasa a . Al mismo tiempo, una fracción de lo que contenía al comenzar esa misma ronda pasa a . No hay entradas externas ni pérdidas. La regla de actualización es
Los parámetros satisfacen y . Son fracciones adimensionales definidas para una ronda de duración fija, mientras que una tasa tendría unidades de tiempo inverso. Si una ronda dura un día, conservar las mismas fracciones y declarar después que la ronda dura una hora modifica la dinámica por unidad de tiempo. Cambiar la resolución temporal exigiría justificar otra regla de transición.
El modelo es discreto por definición. A diferencia del ejemplo continuo del capítulo 20, aquí no se aproxima ninguna derivada mediante diferencias. Iterar estas ecuaciones no introduce, por tanto, un error de discretización temporal respecto de una ley diferencial que no hemos supuesto. Sí pueden aparecer errores de implementación y de aritmética finita. Esta diferencia será necesaria al estudiar el método de Euler en el capítulo 24.
Al sumar las dos ecuaciones se obtiene de modo que el total permanece constante. Como todos los coeficientes son no negativos, un estado inicial no negativo conserva esa propiedad en aritmética exacta. Tenemos así dos propiedades deducidas antes de ejecutar ningún programa. La conservación es una restricción que impusimos al construir el modelo. Hasta aquí ningún dato ha intervenido en el razonamiento.
Si el estado se escribe como vector columna , la regla toma la forma con
Cada columna de suma uno porque distribuye el contenido previo de un compartimento entre los dos destinos. Las filas no tienen por qué sumar uno. Con los valores que usaremos, sus sumas son y . Normalizar las filas para que ambas sumen uno cambiaría la ley, aunque pareciera una operación rutinaria de preparación de datos. La orientación del vector de estado determina cómo se lee la matriz, así que una convención tomada de otro programa debe comprobarse antes de usarla. Aquí se reúnen la lectura por columnas del capítulo 13 y el balance del capítulo 18.
Usaremos , , e . Calcularemos treinta rondas y guardaremos también el estado inicial. El registro completo tendrá, por lo tanto, treinta y una filas. Esta decisión evita una ambigüedad frecuente, porque treinta observaciones y treinta actualizaciones no designan necesariamente el mismo registro.
Una solución de referencia independiente del bucle
Como , la primera ecuación puede escribirse
Si , el equilibrio compatible con el total es
Cada valor de tiene su propio equilibrio, de manera que no existe uno único para todos los totales posibles. Con nuestros parámetros, e . El intercambio continúa en el equilibrio. Lo que se iguala es la cantidad transferida en cada sentido durante una ronda, porque .
Al restar en ambos lados de la recurrencia desaparece el término constante,
Aplicada sucesivamente, esta identidad da la solución
Con nuestros parámetros el factor vale . La desviación de respecto de su equilibrio conserva el signo y se multiplica por en cada ronda. En general, la desviación tiende a cero cuando , es decir, cuando . Los dos casos extremos requieren un análisis aparte. Si ambas fracciones son nulas, nada cambia. Si ambas valen uno, los contenidos se intercambian por completo en cada ronda y una distribución desigual alterna sin converger.
El cuadro 21.1 se obtuvo evaluando la fórmula cerrada. El algoritmo que construiremos debe reproducirlo. Las cantidades están expresadas en y los seis decimales son solo un formato de presentación.
Cuadro 21.1. Estados del intercambio según la solución de referencia, con , y estado inicial .
| Ronda | Total | ||
|---|---|---|---|
| 0 | 100,000000 | 0,000000 | 100,000000 |
| 1 | 80,000000 | 20,000000 | 100,000000 |
| 2 | 66,000000 | 34,000000 | 100,000000 |
| 5 | 44,538000 | 55,462000 | 100,000000 |
| 10 | 35,216502 | 64,783498 | 100,000000 |
| 20 | 33,386528 | 66,613472 | 100,000000 |
| 30 | 33,334836 | 66,665164 | 100,000000 |
Después de treinta rondas, sigue separado de su equilibrio en unos , así que no diremos que lo alcanzó. Tampoco usaremos el redondeo del cuadro para decidir si una diferencia es nula. La propiedad matemática es una convergencia asintótica. Cualquier afirmación de proximidad después de un número finito de rondas necesita una tolerancia explícita.
Pseudocódigo y semántica de la actualización
El pseudocódigo describe las operaciones sin depender de la sintaxis de un lenguaje particular. Escribir «simular el intercambio» no basta, porque hay que explicitar qué valores utiliza cada operación. Para nuestro modelo es suficiente la secuencia siguiente.
Definir las fracciones y el número de rondas.
Comprobar que las entradas pertenecen al dominio permitido.
Asignar a x e y sus valores iniciales.
Guardar la fila inicial con índice 0.
Para cada ronda desde 1 hasta 30:
    Calcular nuevo_x usando x e y anteriores.
    Calcular nuevo_y usando x e y anteriores.
    Sustituir x e y por nuevo_x y nuevo_y.
    Guardar el índice de ronda y el nuevo estado.
Comparar las filas con las propiedades conocidas.
Presentar los resultados sin alterar los datos guardados.
Las variables temporales nuevo_x y nuevo_y preservan la simultaneidad de las ecuaciones aunque el procesador ejecute las instrucciones una tras otra. Lo que se requiere es que ambas instrucciones lean el mismo estado previo.
En la primera ronda se calculan y . Después, el par anterior se sustituye por . En la segunda ronda ambos cálculos usan ese par y dan y .
Esta especificación es una parte revisable del método. Si otro lenguaje implementa la misma secuencia, sus resultados deberían coincidir con la referencia dentro del error numérico pertinente. Aunque la sintaxis cambie de un lenguaje a otro, cada implementación puede contrastarse con esta secuencia.
Implementación mínima en Python
El bloque siguiente traduce directamente el pseudocódigo. Usa Python 3 y solo su biblioteca estándar, sin leer archivos ni descargar información. Se muestra completo para que ninguna variable inicial dependa de otra celda o de una instrucción omitida.
import math

alpha = 0.20
beta = 0.10
x0 = 100.0
y0 = 0.0
pasos = 30

for valor in (alpha, beta, x0, y0):
    if not math.isfinite(valor):
        raise ValueError("Las entradas deben ser finitas.")
if not (0.0 <= alpha <= 1.0 and 0.0 <= beta <= 1.0):
    raise ValueError("Las fracciones deben estar entre 0 y 1.")
if x0 < 0.0 or y0 < 0.0:
    raise ValueError("Las cantidades no pueden ser negativas.")
if type(pasos) is not int or pasos < 0:
    raise ValueError("pasos debe ser un entero no negativo.")

x, y = x0, y0
filas = [(0, x, y)]

for n in range(1, pasos + 1):
    nuevo_x = (1.0 - alpha) * x + beta * y
    nuevo_y = alpha * x + (1.0 - beta) * y
    x, y = nuevo_x, nuevo_y
    filas.append((n, x, y))

print("n x y total")
for n, xn, yn in filas:
    if n in (0, 1, 2, 5, 10, 20, 30):
        print(f"{n:2d} {xn:.6f} {yn:.6f} {xn + yn:.6f}")
La instrucción import math carga el módulo de funciones matemáticas de la biblioteca estándar. Cada if comprueba una condición de la especificación; raise ValueError detiene la ejecución cuando una entrada la viola. La comprobación type(pasos) is not int rechaza también 30.0 y los valores lógicos True y False, que en Python son un subtipo de los enteros. Las entradas de este ejemplo están escritas en el propio bloque, porque todavía no construimos una interfaz para cualquier tipo de dato.
La lista filas guarda un registro por ronda con el índice y las dos cantidades; append añade cada registro al final. La expresión range(1, pasos + 1) produce los enteros de uno a treinta, porque excluye el límite superior. La indentación delimita las instrucciones que pertenecen al bucle. La documentación oficial de Python describe estas reglas de control (Python Software Foundation, s. f.-d).
El formato :.6f pide seis decimales al imprimir, sin redondear los números almacenados. El bucle de impresión usa los nombres xn e yn para no reasignar las variables de estado x e y, que conservan el último estado calculado. La salida es la siguiente.
n x y total
 0 100.000000 0.000000 100.000000
 1 80.000000 20.000000 100.000000
 2 66.000000 34.000000 100.000000
 5 44.538000 55.462000 100.000000
10 35.216502 64.783498 100.000000
20 33.386528 66.613472 100.000000
30 33.334836 66.665164 100.000000
Python imprime punto decimal, aunque el texto y el cuadro usen coma decimal. Las cifras coinciden con las del cuadro 21.1. Como el cálculo y la presentación están separados, los decimales visibles pueden cambiarse sin repetir ni modificar la dinámica. En el capítulo 22 organizaremos este procedimiento mediante funciones y arreglos; por ahora interesa relacionar cada instrucción con una decisión matemática.
Un error ejecutable que cambia la ley de evolución
Supongamos que alguien reemplaza las tres instrucciones centrales del bucle por estas dos líneas.
x = (1.0 - alpha) * x + beta * y
y = alpha * x + (1.0 - beta) * y
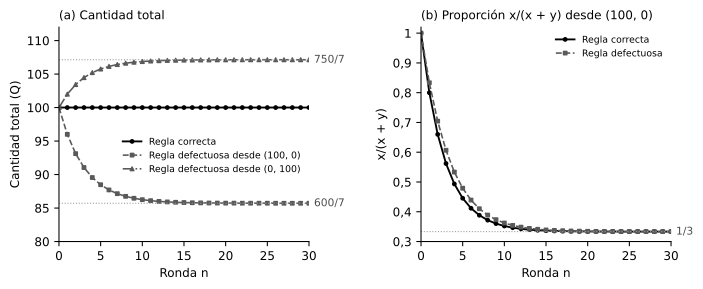
La línea que calcula y usa el valor de x ya actualizado. En la primera ronda se obtiene y después . El total baja a , pese a que el modelo no contiene ninguna salida. Si designa el estado que calcula esta versión, cada ronda aplica en realidad
Con nuestras fracciones, el total cambia en cada ronda en . Desde se pierden cuatro unidades y desde aparecen dos. Como el cambio depende del estado, no puede atribuirse a una pérdida externa constante ni a un redondeo. La implementación aplica otra matriz de transición.
La matriz indica adónde conduce el error. Su traza vale y su determinante, , de modo que sus valores propios son y . El valor propio unitario indica que la versión defectuosa también conserva una cantidad, aunque distinta del total. Esa cantidad es , que con nuestras fracciones vale . Como el otro valor propio es menor que uno, la trayectoria defectuosa converge a un estado de la recta , que tiene la misma proporción que el equilibrio correcto. Desde la cantidad conservada vale y el estado límite es , con un total de . Desde la cantidad conservada vale y el total tiende a .
En ambos casos la proporción tiende a , igual que con la regla correcta. Las proporciones difieren en las primeras rondas, pero las dos convergen al mismo valor (figura 21.1). El total, en cambio, se aparta de desde la primera ronda.
Python permite conservar el significado original con x, y = expresion_x, expresion_y, porque evalúa por completo el lado derecho antes de asignar (Python Software Foundation, s. f.-c). Con variables numéricas escalares, ambas expresiones consultan así el par anterior. Preferimos las variables temporales porque hacen visible esa dependencia.
Una actualización secuencial puede ser correcta en otro modelo, siempre que este especifique qué transferencia ocurre primero y cómo se contabiliza. Aquí es incorrecta respecto de las dos ecuaciones declaradas. La discrepancia se localizó comparando esas ecuaciones con las instrucciones del programa.
Qué comprobar antes de interpretar una trayectoria
Antes de interpretar la trayectoria se revisan el número de filas guardadas y el primer paso calculado a mano. Después se contrastan la conservación del total y la no negatividad de las cantidades. Con la fórmula cerrada se comparan, además, todos los estados guardados, desde el inicial hasta el trigésimo. Estas verificaciones no son equivalentes. Que el total se conserve no demuestra que se haya distribuido correctamente entre los compartimentos.
Supongamos que se programaron por error . El total seguiría siendo , pero el equilibrio pasaría a ser , distinto del correcto . La conservación detectaría el error secuencial de la sección anterior y no detectaría este cambio de parámetros. Por eso las pruebas deben examinar más de una propiedad del modelo.
Para la configuración principal puede añadirse el bloque siguiente después de generar filas. El bloque exige porque la fórmula del equilibrio divide por esa suma.
if alpha + beta <= 0.0:
    raise ValueError("Esta referencia requiere alpha + beta > 0.")
if len(filas) != pasos + 1:
    raise RuntimeError("Número de registros incorrecto.")

s0 = x0 + y0
x_equilibrio = beta * s0 / (alpha + beta)
factor = 1.0 - alpha - beta

for n, xn, yn in filas:
    x_ref = x_equilibrio + (x0 - x_equilibrio) * factor**n
    y_ref = s0 - x_ref
    for calculado, esperado in ((xn + yn, s0), (xn, x_ref), (yn, y_ref)):
        if not math.isclose(calculado, esperado,
                            rel_tol=1e-12, abs_tol=1e-10):
            raise RuntimeError(f"Discrepancia en la ronda {n}.")
    if xn < -1e-10 or yn < -1e-10:
        raise RuntimeError(f"Cantidad negativa en la ronda {n}.")

print("Verificaciones satisfactorias para esta configuración.")
La expresión factor**n es la potencia -ésima de factor. La función math.isclose acepta una diferencia cuando no supera el mayor de dos umbrales, uno absoluto y otro proporcional a la mayor magnitud de los valores comparados (Python Software Foundation, s. f.-b). Otras bibliotecas combinan las tolerancias de otra manera, como veremos con NumPy en el capítulo 22.
La tolerancia absoluta, , está expresada en la unidad elegida para las cantidades. La relativa, , es adimensional. Ambas son criterios de comprobación elegidos para este ejemplo y este horizonte. Carecen de significado clínico y habría que revisarlas si cambiara la escala de las cantidades. El bloque tolera valores negativos de magnitud menor que y detiene la ejecución ante valores más negativos, pero nunca los sustituye por cero. Esa sustitución añadiría al cálculo una operación que el modelo no contiene.
La tolerancia absoluta resuelve además un problema cerca de cero. En la ronda inicial, el valor esperado de es cero. Un error relativo que divida por ese valor no puede calcularse, mientras que la diferencia absoluta tiene sentido si se conocen sus unidades. Si todas las cantidades se expresaran en milésimas de , el umbral absoluto equivalente sería mil veces mayor en la nueva escala numérica. Conservar el número después de esa conversión exigiría una comprobación mil veces más estricta en términos de . La tolerancia relativa no necesita ese ajuste. Ninguna de las dos debe confundirse con la incertidumbre de una medición, porque el programa comprueba operaciones sobre cantidades definidas y en el ejemplo no interviene ningún instrumento.
Fracciones decimales como no tienen representación binaria finita exacta (Python Software Foundation, s. f.-a). Las operaciones ordinarias pueden acumular diferencias pequeñas aunque implementen la regla correcta. Por eso distinguimos la igualdad matemática de la comparación numérica, sin atribuir cualquier discrepancia al redondeo. La aritmética finita se estudia en el capítulo 27.
El cuaderno computacional y su estado de ejecución
Un cuaderno permite intercalar texto, fórmulas, instrucciones y resultados. En Jupyter las instrucciones se ejecutan en un proceso denominado kernel, que conserva las variables de la sesión (Project Jupyter, s. f.-b). El orden visual de las celdas no garantiza que se hayan ejecutado en ese orden, porque es posible volver a una celda anterior y ejecutarla de nuevo. El número entre corchetes junto a cada celda indica en qué orden se ejecutó por última vez. Reiniciar el kernel elimina el estado acumulado en memoria.
Organizaríamos el cuaderno con una celda inicial de especificación, otra de parámetros y cálculo, otra de comprobaciones y una última de presentación. La división no añade contenido matemático. Su utilidad es que los supuestos y las conclusiones puedan revisarse por separado del cálculo.
Supongamos que el cálculo se ejecuta con alpha = 0.20 y que luego se cambia esa asignación a 0.10 sin volver a ejecutar el cálculo. El cuadro guardado puede seguir mostrando el resultado anterior, de modo que quien lea el cuaderno verá unos parámetros junto a una salida que no les corresponde.
Como control, reiniciaríamos el kernel y ejecutaríamos todas las celdas desde arriba. También comprobaríamos que el estado inicial se asigna en la misma celda que ejecuta el bucle. En nuestro bloque, la asignación x, y = x0, y0 y la creación de filas preceden inmediatamente al bucle. Si se ejecutara otra vez solo el bucle, el cálculo partiría del estado ya evolucionado y agregaría treinta filas más a filas. La comprobación del número de registros detectaría el problema, porque encontraría sesenta y una filas.
El archivo del cuaderno, con extensión .ipynb, guarda junto al código y sus metadatos las salidas de la última ejecución de cada celda (Project Jupyter, s. f.-a). Esas salidas almacenadas no prueban que correspondan al código visible, así que hay que regenerarlas. La precaución se deriva de distinguir el documento guardado del proceso que lo ejecuta.
Las instrucciones también pueden guardarse en un archivo de texto con extensión .py y ejecutarse como un programa completo. La lectura secuencial de ese archivo facilita comprobar que cada asignación precede a los cálculos que la utilizan. El cuaderno añade la posibilidad de intercalar la explicación y guardar salidas, sin cambiar el modelo que se calcula. En este capítulo, cualquiera sea el formato, conservaríamos una versión en que toda la trayectoria se regenere a partir del bloque completo. La elección entre archivo y cuaderno depende de la presentación y del trabajo interactivo, puesto que las ecuaciones son las mismas en ambos casos.
Un reinicio tampoco comprueba dependencias externas, como archivos modificados o servicios remotos, que en este ejemplo no existen. Una ejecución limpia es, por tanto, una prueba útil cuyo alcance debe declararse. En este capítulo, los bloques de generación y de comprobación pueden ejecutarse uno tras otro sin intervención intermedia.
Registro de una ejecución y conservación de resultados
Para este modelo prepararemos un registro breve con el identificador de la ejecución, la versión del código, los parámetros, el estado inicial, el número de rondas, la unidad de cantidad y el resultado de cada comprobación. El registro indicará también que el modelo es determinista y que las transferencias son simultáneas. Ningún dato de entrada procede de observaciones empíricas. Un registro de este tipo podría tener la forma siguiente.
ejecución         intercambio-A-001
código            intercambio.py, revisión 1
modelo            intercambio discreto determinista, transferencias simultáneas
unidad            Q
alpha, beta       0.20, 0.10
estado inicial    x0 = 100.0, y0 = 0.0
rondas            30 (31 filas, incluida la ronda 0)
comprobaciones    filas, conservación, referencia analítica y no negatividad
resultado         satisfactorio
entorno           Python 3.13.5, biblioteca estándar
Guardaremos las treinta y una filas completas, aunque el cuadro muestre siete. Un archivo tabular debe indicar qué significa cada columna y si incluye el estado inicial. Si después se calcula una estadística o un tiempo de llegada, se conservará la regla utilizada junto con su relación con la trayectoria completa.
Wilson y colaboradores (2017) recomiendan mantener el código separado de los datos de entrada y de los productos generados. También recomiendan registrar los cambios con un sistema de control de versiones. Aplicado a este ejemplo, conservaríamos la especificación y el programa aparte de la tabla producida. Con control de versiones podría recuperarse qué modificación introdujo las fracciones usadas en una ejecución concreta.
Anotar la versión exacta del intérprete y de las bibliotecas reduce ambigüedades, aunque registrar una versión no equivale a conservar un entorno instalable. En proyectos mayores también habría que archivar las dependencias o instrucciones suficientes para reconstruirlas, como recomiendan Sandve y colaboradores (2013).
En la comparación de escenarios de la sección siguiente, las ejecuciones con fracciones y recibirían identificadores distintos. Ambas usarían la misma versión del código con registros de parámetros diferentes. Si se descubriera y corrigiera el error de actualización secuencial, cambiaría además la versión de la implementación. Esta separación permite saber si una diferencia proviene de otro escenario o de una corrección del procedimiento. Una tabla sin esas asociaciones no conserva la información necesaria para decidirlo después. Cuando el texto cite un valor, ese valor debe seguir vinculado a la ejecución que lo produjo y a la regla con que se resumió.
Nuestro programa no usa paquetes externos. Eso simplifica la reconstrucción, aunque no elimina la necesidad de identificar su versión y sus salidas, porque una copia modificada del archivo podría contener otro horizonte o invertir las fracciones. Para un proyecto personal basta un registro consistente y recuperable. No hace falta introducir ahora una infraestructura más difícil de mantener que la simulación.
Comparación de escenarios y alcance de la reproducibilidad
Comparemos la configuración principal con y , con el mismo estado inicial y la misma duración de cada ronda. La proporción sigue siendo un tercio, así que el equilibrio no cambia, mientras que el factor de contracción pasa de a . Las dos trayectorias se acercan al mismo punto, aunque tardan tiempos diferentes en aproximarse a él.
Antes de comparar definimos el criterio . Como la desviación inicial es , el primer entero que lo cumple es el menor que satisface
La configuración principal requiere doce rondas y la segunda, veintiséis. La expresión ya incorpora la inversión de la desigualdad al dividir por . En la primera trayectoria, las desviaciones de las rondas once y doce son aproximadamente y . El criterio se cumple desde la duodécima ronda porque las desviaciones posteriores disminuyen monótonamente.
La comparación depende también del horizonte guardado. Si hubiéramos simulado solo veinte rondas, podríamos identificar el primer cruce de la configuración principal, pero la segunda no habría cruzado todavía. La ausencia de cruce en ese registro no demostraría que el cruce nunca ocurre, porque la solución analítica lo sitúa en la ronda veintiséis. En modelos sin solución conocida habría que ampliar el horizonte o limitar explícitamente la conclusión al intervalo observado. Por eso el criterio de proximidad y el horizonte deben guardarse junto con los parámetros. Un resultado «no alcanzado» describe lo que contiene el registro y, sin más información, nada dice del comportamiento asintótico del sistema.
Las cifras de doce y veintiséis rondas valen para el estado inicial y la tolerancia elegidos. No demuestran que la primera configuración sea preferible según cualquier criterio. Ambas convergen al mismo equilibrio. Comparar, por ejemplo, los costos del intercambio requeriría una cantidad adicional que no hemos definido.
Reproducir el cuadro con el mismo programa comprueba una propiedad distinta de la que se examina al contrastarlo con la solución algebraica. Esta segunda comparación aporta evidencia de que la implementación es correcta, aunque no valida empíricamente el intercambio como explicación de un proceso real. Incluso dos programas que coinciden podrían compartir una traducción equivocada de las ecuaciones.
Cuando incorporemos azar habrá que especificar el generador de números aleatorios y su estado inicial, además del orden en que se hacen las llamadas. Una semilla aislada no garantiza resultados iguales entre versiones o entornos. La documentación de NumPy formula condiciones más estrictas para reproducir una secuencia (NumPy Developers, s. f.). Repetir una sola semilla tampoco informa sobre la variabilidad entre realizaciones. El ejemplo actual no necesita semillas porque no contiene operaciones aleatorias.
Interpretación aplicada y variaciones resueltas
Los dos compartimentos podrían usarse como descripción preliminar de personas distribuidas entre dos modalidades de atención. Esa interpretación exigiría justificar qué define cada modalidad y de dónde proceden las fracciones. También habría que examinar si la población se conserva realmente. Las cantidades fraccionarias del modelo no son recuentos individuales observados. Podrían interpretarse como cantidades esperadas o como una aproximación agregada, siempre que se especifique esa lectura y se evalúe su adecuación.
La diferencia importa al comunicar el resultado. «Con estas reglas, la desviación de respecto de su equilibrio no supera desde la ronda doce» es una conclusión del cálculo. «Una reorganización asistencial estabilizará la atención en doce semanas» añade supuestos que no hemos demostrado, entre ellos que una ronda equivale a una semana y que el mecanismo del modelo opera en el servicio real. El registro de la ejecución permite identificar qué supuestos añade cada afirmación, aunque justificarlos exige información externa al programa.
El procedimiento puede consolidarse con tres variaciones cuya respuesta conocemos de antemano. Si el estado inicial es , las ecuaciones lo mantienen fijo. La implementación debe reproducir esa constancia dentro del redondeo pertinente. Si , todo estado se conserva, aunque el bloque de comprobación, que divide por , debe sustituirse por una referencia apropiada. Si el estado inicial es con las fracciones originales, el primer paso correcto es .
Esta última prueba complementa la del estado . Desde el primer paso depende solo de la primera columna de , de modo que un error en los coeficientes que multiplican a pasaría inadvertido. Desde ocurre lo contrario. Como la regla es lineal, las dos pruebas juntas determinan la matriz completa. Cada variación examina una relación distinta entre la especificación y el código. Ninguna reemplaza a las demás, como tampoco las reemplaza el hecho de que el programa se ejecute sin errores de sintaxis. Las comprobaciones finitas no se extrapolarán a todos los valores de los parámetros sin argumentos adicionales.
En este capítulo, un balance discreto se tradujo a un procedimiento ejecutable que se contrastó con una referencia algebraica. Esa referencia permitió localizar un error de actualización por sus consecuencias. El capítulo 22 organizará el procedimiento mediante funciones y arreglos para reutilizarlo sin copiar bloques enteros. La integración numérica de ecuaciones diferenciales comenzará en el capítulo 24, donde será necesario distinguir la ley continua del algoritmo que la aproxima.
Ejercicios
Ejercicio 21.1. Con y , calcule a mano los estados de las rondas 1, 2 y 3 desde . (a) Compruebe que el total se conserva. (b) Compare con la fórmula cerrada. (c) Calcule cuánto pasa en cada sentido durante la tercera ronda y el flujo neto hacia .
Ejercicio 21.2. La actualización secuencial del texto aplica la matriz . (a) Demuestre que se conserva para cualesquiera fracciones con . (b) Demuestre que los valores propios de son y . (c) Obtenga el estado límite desde y desde . (d) Suponga ahora que el programa actualiza primero y después con el valor nuevo de . Escriba la matriz correspondiente e identifique la cantidad conservada. Calcule después el total límite desde .
Ejercicio 21.3. Para la configuración con y , (a) calcule las desviaciones en las rondas 25 y 26 y (b) confirme que la ronda 26 es la primera que cumple el criterio de . (c) ¿Cuántas rondas necesita cada configuración para que la desviación no supere ?
Ejercicio 21.4. Con rel_tol=1e-12 y abs_tol=1e-10, decida si math.isclose acepta cada par de valores. (a) y . (b) y . (c) y . (d) Repita (c) con abs_tol=0. (e) Si las cantidades se expresan en milésimas de , ¿qué tolerancia absoluta mantiene el criterio de (c)?
Ejercicio 21.5. Un cuaderno tiene cuatro celdas numeradas del 1 al 4. La celda 1 define los parámetros; la celda 2 asigna x, y = x0, y0 y crea filas; la celda 3 contiene el bucle; la celda 4, el bloque de comprobación. (a) ¿Qué ocurre si las celdas se ejecutan en el orden 1, 2, 3, 3, 4? (b) ¿Qué ocurre si se ejecutan las celdas 1, 2 y 3, después se cambia alpha a 0.10 en la celda 1 y se ejecutan solo las celdas 1 y 4? (c) ¿Qué procedimiento garantiza que la salida corresponde al código visible?
Ejercicio 21.6. Clasifique cada situación según las definiciones de reproducibilidad y replicabilidad adoptadas en el capítulo, o indique que corresponde a otra operación. (a) Otra persona ejecuta el mismo programa con los mismos parámetros en su computador y obtiene el cuadro 21.1. (b) Un segundo estudio, con datos nuevos de otro servicio, estima las fracciones de transferencia y obtiene valores compatibles con los de un primer estudio. (c) La salida del programa se contrasta con la fórmula cerrada. (d) El programa se ejecuta con y .
Consultar las soluciones de los ejercicios
Soluciones de los ejercicios
Solución 21.1. Los estados de las rondas 1, 2 y 3 son , y . (a) Las tres sumas valen . (b) La fórmula da . (c) Durante la tercera ronda pasan de a y de a . El flujo neto hacia es , que coincide con .
Solución 21.2. (a) Con se obtiene . Como , la cantidad no cambia de una ronda a otra. (b) La traza de es y su determinante, . Los números y tienen esa suma y ese producto, así que son los valores propios. (c) El vector propio del valor propio unitario satisface , es decir, . Desde la cantidad conservada vale . La condición da el límite , con total . Desde la cantidad vale y el límite es , con total . (d) La nueva regla aplica
Su primer paso desde da , con total . Conserva y su vector propio de valor propio unitario también está sobre . Desde la cantidad conservada vale y el límite es , con total . Invertir el orden de las instrucciones cambia el signo del sesgo desde ese estado inicial.
Solución 21.3. (a) Las desviaciones son y . (b) La desviación de la ronda 25 supera y la de la ronda 26 no. Las siguientes son todavía menores porque la desviación decrece monótonamente. (c) Con la condición es . La configuración principal necesita 19 rondas y la segunda, 41. En la ronda 40, la desviación de la segunda configuración todavía vale .
Solución 21.4. La función acepta una diferencia que no supere . (a) El umbral vale y la diferencia, , así que el par se acepta. (b) La diferencia de supera el umbral y el par se rechaza. (c) El término relativo es despreciable y rige el absoluto, de modo que el par se acepta. (d) Sin tolerancia absoluta, el umbral es y el par se rechaza. Cuando uno de los valores es cero, una tolerancia puramente relativa rechaza cualquier diferencia no nula. (e) Como equivalen a milésimas de , la tolerancia absoluta debe pasar a abs_tol=1e-7. La relativa no cambia.
Solución 21.5. (a) La segunda ejecución de la celda 3 parte del estado de la ronda 30 y agrega treinta filas, de modo que filas queda con 61 registros. La celda 4 se detiene con el mensaje «Número de registros incorrecto». (b) Las filas se calcularon con , mientras que la referencia usa , con equilibrio en y factor . La ronda 0 coincide. En la ronda 1 la referencia espera y la tabla contiene , así que la celda 4 se detiene con el mensaje «Discrepancia en la ronda 1». (c) Hay que reiniciar el kernel y ejecutar todas las celdas en orden, de la 1 a la 4.
Solución 21.6. (a) Es reproducibilidad computacional, porque se repite el mismo cálculo con los mismos datos y el mismo procedimiento. (b) Es replicabilidad, porque un estudio independiente con datos nuevos responde la misma pregunta. El resultado apoyaría los valores de las fracciones, aunque no demostraría que el mecanismo de intercambio del modelo sea correcto. (c) Es una verificación de la implementación. No corresponde a ninguna de las dos definiciones. (d) Es otro escenario del mismo modelo, que debe registrarse con su propio identificador.
Referencias
National Academies of Sciences, Engineering, and Medicine. (2019). Reproducibility and replicability in science. The National Academies Press. https://doi.org/10.17226/25303
NumPy Developers. (s. f.). Random sampling: Compatibility policy. Recuperado el 19 de septiembre de 2026, de https://numpy.org/doc/stable/reference/random/compatibility.html
Project Jupyter. (s. f.-a). The notebook file format. Recuperado el 19 de septiembre de 2026, de https://nbformat.readthedocs.io/en/latest/format_description.html
Project Jupyter. (s. f.-b). Running code. Recuperado el 19 de septiembre de 2026, de https://jupyter-notebook.readthedocs.io/en/stable/examples/Notebook/Running%20Code.html
Python Software Foundation. (s. f.-a). Floating-point arithmetic: Issues and limitations. Recuperado el 19 de septiembre de 2026, de https://docs.python.org/3/tutorial/floatingpoint.html
Python Software Foundation. (s. f.-b). math: Mathematical functions. Recuperado el 19 de septiembre de 2026, de https://docs.python.org/3/library/math.html#math.isclose
Python Software Foundation. (s. f.-c). The Python language reference: Expressions. Recuperado el 19 de septiembre de 2026, de https://docs.python.org/3/reference/expressions.html#evaluation-order
Python Software Foundation. (s. f.-d). The Python tutorial: More control flow tools. Recuperado el 19 de septiembre de 2026, de https://docs.python.org/3/tutorial/controlflow.html
Sandve, G. K., Nekrutenko, A., Taylor, J. y Hovig, E. (2013). Ten simple rules for reproducible computational research. PLOS Computational Biology, 9(10), e1003285. https://doi.org/10.1371/journal.pcbi.1003285
Wilson, G., Bryan, J., Cranston, K., Kitzes, J., Nederbragt, L. y Teal, T. K. (2017). Good enough practices in scientific computing. PLOS Computational Biology, 13(6), e1005510. https://doi.org/10.1371/journal.pcbi.1005510