Una matriz como operación sobre estados
En el capítulo anterior usamos vectores para representar estados y cambios de coordenadas. El paso siguiente es describir de manera sistemática las operaciones que reciben un vector y producen otro. Las matrices son una forma particularmente importante de hacerlo. Su relevancia para los sistemas dinámicos proviene de que codifican transformaciones lineales entre espacios vectoriales, lo que las hace mucho más que tablas cómodas de números.
Consideremos un estado bidimensional y la regla que produce un nuevo vector mediante e . La misma transformación se escribe de forma compacta como , con
La notación matricial conserva la estructura de las ecuaciones. Cada fila especifica cómo se construye una componente de salida a partir de las entradas y cada columna, cómo una componente de entrada contribuye al vector de salida. En los modelos dinámicos, las filas podrán leerse como reglas de actualización y las columnas como la respuesta del sistema ante las direcciones elementales del estado.
Una transformación es lineal si para vectores y y escalares y se cumple
condición que reúne la homogeneidad y la aditividad del capítulo 8 (Axler, 2015). Una matriz actúa linealmente sobre los vectores mediante la multiplicación estándar, lo que permite analizar la respuesta a combinaciones de estados a partir de la respuesta a estados elementales. El resultado es potente, aunque debe interpretarse dentro de su dominio. Muchos sistemas reales son no lineales y en ellos las matrices aparecen como aproximaciones locales, como operadores sobre variables transformadas o como componentes de modelos más amplios.
Dimensiones de una matriz y compatibilidad de la transformación
Una matriz de filas y columnas representa, una vez elegidas las bases, una transformación lineal desde un espacio de dimensión hacia uno de dimensión . Se escribe . Si , el producto pertenece a . La compatibilidad es algebraica, porque el número de columnas de debe coincidir con el número de componentes de . Por ejemplo,
La transformación no tiene por qué conservar la dimensión. Una matriz cuadrada de transforma un espacio de dimensión en sí mismo, mientras que una rectangular puede aumentar o reducir el número de coordenadas de salida. Aumentar el número de coordenadas no crea nuevos grados de libertad y reducirlo no implica necesariamente perder información sobre los estados que interesan. La cuestión decisiva es si la transformación es inyectiva en el dominio relevante, algo que se formalizará mediante el núcleo, el rango y la invertibilidad.
También hay que separar la dimensión algebraica del significado físico. Si contiene concentraciones, tiempos o indicadores clínicos, la suma ponderada de sus componentes solo tiene sentido cuando las unidades y las escalas están definidas de manera coherente, como vimos en el capítulo 11. Una matriz multiplica números sin dificultad. La legitimidad científica de esa operación depende del modelo, porque el álgebra garantiza la consistencia formal sin garantizar la pertinencia de lo que se suma.
Producto de una matriz por un vector
Sea
Con el estado se obtiene y con , . Estos resultados son exactamente las columnas de . Los vectores y forman la base canónica. Una transformación lineal queda completamente determinada por lo que hace con los vectores de una base. Para cualquier se tiene , de modo que las columnas de son las imágenes de los vectores básicos. Esta es la lectura por columnas (Strang, 2016).
La lectura por filas responde otra pregunta. Si , la primera salida es y la segunda, . Cada fila combina las componentes de entrada para construir una componente de salida. En un modelo de dos variables actualizado por pasos, la primera fila contendría los coeficientes que determinan el valor siguiente de la primera variable y la segunda fila, los de la segunda.
La distinción evita leer las entradas de una matriz de manera aislada. El número 0,2 ubicado en la primera fila y la segunda columna significa que la segunda componente de entrada contribuye con coeficiente 0,2 a la primera componente de salida. Su interpretación concreta depende del modelo, que puede tratarla como una transferencia, una asociación, una influencia lineal o un simple coeficiente de cambio de base. La posición en la matriz informa una relación algebraica sin establecer una relación causal.
Transformaciones lineales y transformaciones afines
No toda regla expresada con una matriz y una suma constante es lineal. Si con , la transformación es afín. La parte determina cómo se transforman las diferencias entre estados y el vector desplaza todos los resultados por la misma cantidad. La distinción, que parece terminológica, tendrá consecuencias al estudiar los equilibrios y la linealización.
Una transformación lineal envía siempre el origen al origen, porque , mientras que una afín puede desplazarlo. La función no es lineal, porque y difiere de . Las diferencias obedecen, sin embargo, a la parte lineal, porque si e se tiene . Por eso los modelos afines conservan muchas herramientas del álgebra lineal una vez separado el desplazamiento constante.
La observación será importante en los sistemas dinámicos. Cerca de un equilibrio , una dinámica no lineal puede aproximarse por una transformación lineal de las desviaciones . El origen de las coordenadas locales se coloca en el equilibrio y la matriz jacobiana describe cómo evolucionan las perturbaciones pequeñas. Hablar de linealidad sin indicar respecto de qué variables y de qué origen puede ocultar ese cambio de representación. En estadística, como vimos en el capítulo 8, un modelo con intercepto es afín respecto de sus predictores y lineal respecto de sus parámetros, usos compatibles siempre que se indique respecto de qué argumentos se predica la linealidad.
El determinante como factor de escala de área o volumen
En las matrices cuadradas, el determinante da otra manera de comprender la invertibilidad. En dos dimensiones, indica por qué factor cambia el área de una figura bajo la transformación. En tres dimensiones, el mismo papel corresponde al volumen. Un determinante negativo añade un cambio de orientación. Un determinante nulo indica que alguna dimensión colapsó y que el área o el volumen resultante es cero.
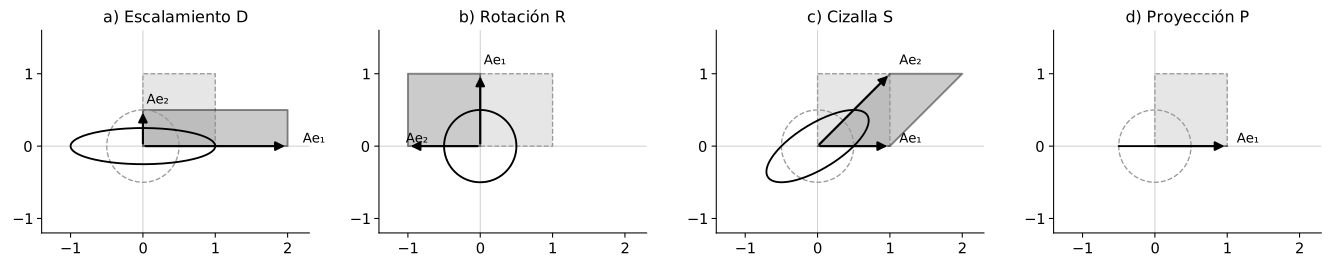
La matriz , con filas y , tiene determinante 1. Duplica una dirección y reduce la otra a la mitad, de modo que conserva el área aunque altere las longitudes. La proyección , con filas y , tiene determinante 0 y comprime cualquier región del plano sobre una recta, con pérdida del área. Esta interpretación geométrica muestra por qué una matriz singular no puede tener inversa global, ya que identifica estados que antes ocupaban posiciones distintas. La figura 13.1 muestra estas y otras transformaciones.
El determinante no mide cuánto cambia cada dirección. Dos matrices pueden tener el mismo determinante y deformar el espacio de maneras muy distintas. Tampoco cuantifica la sensibilidad numérica de la inversión, porque una matriz con determinante distinto de cero puede estar muy cerca de colapsar una dirección. El determinante es una condición estructural importante, aunque no resume toda la geometría de la transformación.
Matrices, bases y semejanza
En el capítulo 12 distinguimos un vector de sus coordenadas. La misma distinción vale para las transformaciones. Una transformación lineal abstracta puede representarse mediante matrices diferentes si cambian las bases usadas para describir la entrada y la salida. La matriz es una representación del operador en ciertas coordenadas.
Si la transformación va de un espacio en sí mismo y la base cambia de manera coherente mediante una matriz invertible , que convierte coordenadas nuevas en antiguas, la nueva matriz es
Esta relación se llama semejanza y ya apareció en el capítulo 12, donde la matriz del oscilador se transformó con . Para una transformación entre espacios distintos se usan en general dos cambios de base, , relación que no es de semejanza. En lo que sigue nos referimos al primer caso.
Las matrices semejantes pueden tener entradas muy diferentes y representar la misma transformación vista desde coordenadas distintas. Por eso ciertas propiedades, como el determinante, la traza, el rango y los valores propios, se conservan bajo semejanza. El interés científico de esta idea es general. Una conclusión que depende solo de haber elegido un sistema de coordenadas conveniente no es una propiedad intrínseca del proceso. Una buena elección de base puede, al mismo tiempo, volver visible una estructura que estaba mezclada en las coordenadas originales. Diagonalizar una matriz, cuando es posible, consiste precisamente en buscar coordenadas en que los modos de la transformación quedan desacoplados.
Transformaciones geométricas elementales
Algunas matrices describen operaciones geométricas que hacen visible la estructura algebraica. El escalamiento anisótropo duplica la primera coordenada y reduce la segunda a la mitad, de modo que un círculo centrado en el origen se transforma en una elipse sin que intervenga ninguna no linealidad. La rotación de noventa grados
envía a y a . Conserva las longitudes y los ángulos euclídeos porque es una transformación ortogonal, lo que muestra que una matriz no necesita deformar magnitudes para ser una transformación no trivial.
La cizalla
lleva el punto a . Las rectas paralelas siguen siendo paralelas, aunque los ángulos cambian en general. La proyección lleva cualquier punto a y destruye información, porque todos los puntos con la misma primera coordenada terminan en el mismo resultado. La diferencia entre deformar reversiblemente un espacio y colapsar direcciones completas se formalizará mediante el núcleo y el rango.
Composición de transformaciones
Si se aplica primero una transformación y luego una transformación , el resultado es , de modo que el producto de matrices representa la composición de transformaciones. Esa interpretación importa más que memorizar la regla de multiplicación. El elemento de acumula todas las rutas lineales por las que la componente de la entrada contribuye a la componente de la salida a través de la transformación intermedia. Es la misma lógica que hizo que las potencias de la matriz de adyacencia contaran recorridos en el capítulo 5.
La composición no suele ser conmutativa. Con la rotación y la cizalla , el vector no cambia al aplicar y luego lo lleva a , de modo que . Si primero se aplica se obtiene , que transforma en , de modo que . Por tanto . El orden de las operaciones forma parte del modelo. Dos intervenciones lineales con los mismos ingredientes pueden producir resultados diferentes si se aplican en otro orden, algo relevante en dinámica, control, procesamiento de señales y modelos secuenciales.
La no conmutatividad no debe interpretarse de manera excesiva. No demuestra dependencia de trayectoria en el sentido del capítulo 9, porque solo indica que dos operadores diferentes no pueden intercambiarse libremente. Para hablar de dependencia histórica hay que especificar cómo la secuencia de estados o de transformaciones condiciona la evolución posterior.
El núcleo de una transformación
El núcleo o espacio nulo de una transformación es el conjunto de vectores que se envían al vector cero,
En la proyección , cualquier vector de la forma pertenece al núcleo. La transformación elimina por completo esa dirección, de modo que a partir de no puede reconstruirse el valor de .
El núcleo caracteriza con precisión la pérdida de distinguibilidad. Si dos estados y producen la misma salida, , entonces y la diferencia pertenece al núcleo. Una transformación es inyectiva si y solo si su núcleo contiene únicamente el vector cero, equivalencia que conecta una propiedad geométrica con una condición algebraica verificable.
Consideremos
Resolver exige y . Con se obtiene y , de modo que el núcleo es la recta generada por . Sumar a un estado cualquier múltiplo de ese vector no modifica la salida. Los estados y , por ejemplo, producen ambos . Su diferencia, , pertenece al núcleo. La pérdida de información queda identificada por una dirección concreta del espacio de entrada.
Imagen, rango y teorema del rango y la nulidad
La imagen de es el conjunto de todas las salidas posibles, . El rango es su dimensión. Las dos filas de son independientes y sus columnas generan , de modo que su rango es 2. La transformación recibe vectores de dimensión tres y sus salidas ocupan todo un espacio de dimensión dos.
El teorema del rango y la nulidad relaciona la dimensión del dominio con la información que la transformación conserva o colapsa (Meyer, 2000),
Para , el dominio tiene dimensión 3, el rango es 2 y el núcleo tiene dimensión 1. La igualdad resume la estructura calculada, con una dirección perdida y dos direcciones independientes que siguen representadas en la salida.
El rango no es una medida universal de información científica. Una transformación no lineal puede codificar información de maneras que esta teoría no capta. Un problema puede, además, considerar irrelevantes ciertas direcciones del estado. Dentro de una representación lineal, el rango y el núcleo permiten responder con exactitud qué combinaciones de entrada son distinguibles a partir de la salida.
Invertibilidad
Una transformación lineal es invertible si existe tal que . Cada salida corresponde entonces a una única entrada y todo vector del espacio de salida tiene una preimagen. Para una matriz cuadrada de dimensión finita son equivalentes el núcleo trivial, el rango completo, la independencia lineal de las columnas y el determinante distinto de cero.
La matriz con filas y tiene determinante y es invertible, con
Si se observa , se recupera . La transformación cambió la representación del estado sin destruir información. La matriz con filas y , en cambio, tiene la segunda fila igual al doble de la primera. Su determinante es cero, su rango es 1 y su salida está restringida a una recta. No hay inversa global y cada salida alcanzable proviene de infinitas entradas, de modo que la imposibilidad de reconstruir se debe a la estructura de la transformación, con independencia de la precisión numérica.
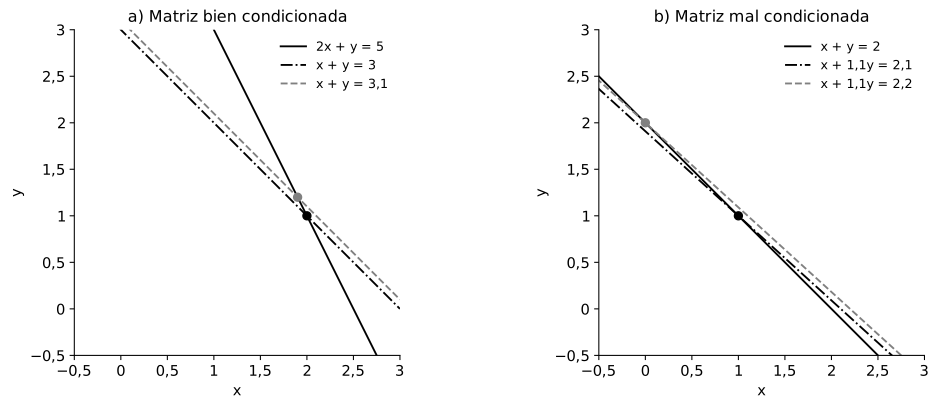
En los problemas empíricos hay una dificultad adicional, porque una matriz puede ser teóricamente invertible y estar muy cerca de ser singular. Los pequeños errores en la salida se amplifican entonces al recuperar la entrada. La matriz
tiene determinante 0,1. La solución de es , mientras que la de es , de modo que un cambio de 0,1 en una componente de la salida desplaza la solución en una unidad en cada componente. Con 1,001 en lugar de 1,1 bastaría un cambio de 0,001 para producir el mismo desplazamiento. Geométricamente, la solución es el cruce de dos rectas casi paralelas, que se desplaza mucho cuando una de ellas se mueve un poco, como muestra la figura 13.2. El número de condición cuantifica esta sensibilidad y vale cerca de 42 en el primer caso y cerca de 4000 en el segundo (Trefethen y Bau, 1997). Invertible no significa estable frente al ruido.
Reducción de dimensión y pérdida controlada de información
La proyección mostró un caso deliberado de pérdida de información. En el uso estricto del álgebra lineal, una proyección actúa sobre un espacio en sí mismo y cumple , porque proyectar dos veces equivale a proyectar una. Una matriz rectangular que extrae o agrega observables es una reducción lineal, aunque no necesariamente una proyección en ese sentido. Si , una transformación lineal de en no puede ser inyectiva en todo . Puede, sin embargo, distinguir todos los estados de un subconjunto admisible de menor dimensión, algo que exige explicitar ese subconjunto y comprobarlo.
En ciencia se hacen operaciones de este tipo constantemente. Se promedia, se construyen puntuaciones compuestas, se agregan regiones o se reduce el número de variables para obtener representaciones manejables (Boyd y Vandenberghe, 2018). La pregunta adecuada concierne a qué información se pierde y a si era necesaria para la tarea, porque no toda pérdida es inadmisible.
Supongamos un registro y una transformación que produce dos indicadores, e . Es la matriz de la sección sobre el núcleo. Su núcleo, generado por , tiene una lectura concreta, porque un aumento de una unidad en el sueño y en la ansiedad, acompañado de una disminución de una unidad en la actividad, deja intactos ambos indicadores. Si la pregunta solo depende de e , la reducción puede bastar. Si se quiere reconstruir las tres variables, no basta. Agregar un tercer indicador igual al sueño produciría una matriz cuadrada con determinante 1, que permitiría recuperar las tres variables.
Una representación reducida puede ser adecuada para predecir cierta salida e insuficiente para explicar mecanismos que dependen de las variables descartadas. La suficiencia siempre está ligada a una pregunta. El rango describe una propiedad algebraica, mientras que decidir si las direcciones eliminadas importan es una cuestión científica adicional.
Actualización lineal de un estado
Una de las formas más simples de un sistema dinámico discreto con varias variables es
en que la matriz especifica cómo el estado actual determina el siguiente (Hirsch, Smale y Devaney, 2013). Con la matriz de la sección sobre el producto y se obtiene , y . Después de pasos, , de modo que la composición repetida convierte la potencia de una matriz en un objeto dinámico.
La matriz tiene dos direcciones especiales. Para se cumple . Para se cumple . Como , la trayectoria completa es
que reproduce los valores calculados paso a paso. A largo plazo domina el primer término, de modo que el estado se alinea con la dirección y se contrae un 10 % por paso. El capítulo 14 estudiará de manera sistemática estas direcciones, llamadas vectores propios, junto con sus factores de escala, los valores propios.
Los coeficientes no deben interpretarse causalmente de manera automática. En un modelo construido a partir de mecanismos especificados, puede representar influencias causales bajo los supuestos correspondientes. En una matriz estimada a partir de asociaciones, sus entradas pueden representar solo relaciones predictivas o parámetros de una representación estadística. La misma notación algebraica aparece en problemas científicamente distintos.
Las matrices reaparecen también en las redes. Una matriz de adyacencia representa conexiones entre nodos y multiplicarla por un vector acumula información de los vecinos, aunque no es todavía una ley dinámica. Hay que especificar qué operación realiza el sistema sobre esas conexiones. La separación entre estructura y proceso del capítulo 5 sigue siendo necesaria.
Interpretar una transformación antes de calcularla
Consideremos la transformación de en dada por
Antes de multiplicar puede leerse por columnas. Cada unidad de la primera variable aporta , cada unidad de la segunda aporta y cada unidad de la tercera aporta . Con se obtiene . La lectura por filas da el mismo resultado, con e . Ambas lecturas son algebraicamente equivalentes y ponen de relieve preguntas distintas.
Comparemos ahora los estados , y . Se obtiene y , de modo que los tres comparten la segunda salida y difieren en la primera. La matriz conserva algunas diferencias y elimina otras. Los estados exactamente indistinguibles se obtienen sumando vectores del núcleo. Resolver da , de modo que y producen la misma salida, .
El procedimiento resume el objetivo del capítulo. Además de ejecutar una multiplicación, hay que interpretar qué combinaciones construye la matriz, qué direcciones conserva, cuáles colapsa y qué preguntas pueden responderse con la salida. Esa lectura estructural será necesaria cuando las matrices tengan cientos o miles de entradas y ya no puedan inspeccionarse a simple vista.
Consolidación
Una matriz representa una transformación lineal una vez elegidas las bases del dominio y del codominio. Sus filas describen cómo se construyen las componentes de salida y sus columnas son las imágenes de los vectores básicos de entrada. El producto de matrices representa la composición y el orden de las transformaciones importa en general.
El núcleo identifica las direcciones que la transformación envía a cero y, con ellas, las diferencias entre estados que resultan invisibles en la salida. La imagen reúne las salidas posibles y su dimensión es el rango. El teorema del rango y la nulidad reparte la dimensión del dominio entre las direcciones conservadas y las colapsadas. En las matrices cuadradas, el núcleo trivial y el rango completo equivalen a la invertibilidad.
Estas propiedades tienen consecuencias científicas solo después de interpretar qué representan las variables. Una reducción no es incorrecta por perder información si descarta justamente lo que la pregunta no necesita. Una transformación invertible puede ser numéricamente inestable, como mostraron las rectas casi paralelas. Una matriz estimada de datos tampoco adquiere significado causal por usarse como operador dinámico. El álgebra especifica relaciones entre representaciones y el modelo científico determina qué significan. El cuadro 13.1 reúne los conceptos del capítulo.
Cuadro 13.1. Conceptos de matrices y transformaciones lineales.
| Concepto | Definición operativa | Consecuencia | Error que conviene evitar |
|---|---|---|---|
| Matriz | Representación de una transformación lineal con bases elegidas | Permite calcular y componer operaciones sobre estados | Tratarla como una tabla sin interpretación |
| Semejanza | Cambio de base A′ = S⁻¹AS | Conserva determinante, traza, rango y valores propios | Atribuir al proceso una propiedad de las coordenadas |
| Núcleo | Vectores x tales que Ax = 0 | Identifica direcciones que la transformación vuelve indistinguibles | Confundir el núcleo con una ausencia de datos |
| Imagen y rango | Salidas posibles y su dimensión | Indican cuántas direcciones independientes sobreviven | Interpretar el rango como medida universal de información |
| Invertibilidad | Existencia de una inversa global | Permite reconstruir la entrada en ausencia de error | Confundir invertibilidad con buen condicionamiento |
| Composición | Aplicación sucesiva representada por un producto | El orden puede modificar el resultado | Suponer que AB = BA |
| Proyección | Transformación que cumple P² = P | Conserva su imagen y anula su núcleo | Considerar toda reducción como un cambio de coordenadas |
En el capítulo 14 estudiaremos los valores y los vectores propios. La pregunta dejará de ser qué hace la transformación con un vector cualquiera y pasará a ser si existen direcciones especiales que conserve. Esa estructura permitirá analizar la amplificación, la contracción y los modos dominantes. Será, además, una herramienta central para estudiar la estabilidad de los sistemas dinámicos.
Ejercicios
Ejercicio 13.1. Considere la matriz con filas y . (a) Calcule por columnas y por filas. (b) Interprete el elemento de la primera fila y la segunda columna. (c) Calcule y exprese su elemento de la primera fila y la segunda columna como suma de las rutas de dos pasos.
Ejercicio 13.2. Para las matrices , , y del texto, calcule el determinante e indique si conservan el área, si conservan las longitudes y si son invertibles. Describa la imagen del cuadrado unitario en cada caso.
Ejercicio 13.3. (a) Calcule las matrices y . (b) Aplíquelas al vector . (c) Calcule y e interprete los resultados geométricamente.
Ejercicio 13.4. Considere la matriz que produce e . (a) Calcule su núcleo y su rango. (b) Verifique el teorema del rango y la nulidad. (c) Interprete el núcleo en términos de las tres variables. (d) Agregue un tercer indicador, , calcule el determinante de la nueva matriz y recupere las tres variables a partir de .
Ejercicio 13.5. (a) Con la matriz de filas y , recupere a partir de . (b) Con la matriz de filas y , describa el conjunto de estados que producen . ¿Existe algún estado que produzca ? (c) Con la matriz del texto, compare el cambio relativo de la salida con el cambio relativo de la solución al pasar de a .
Ejercicio 13.6. Considere con la matriz del ejercicio 13.1 y . (a) Calcule , y . (b) Verifique que con y que con . (c) Descomponga en esas direcciones, escriba y compruebe el valor de . (d) ¿Desde qué paso la norma del segundo término es menor que el 1 % de la del primero?
Consultar las soluciones de los ejercicios
Soluciones de los ejercicios
Solución 13.1. (a) Por columnas, . Por filas, y . (b) La segunda componente de entrada contribuye con coeficiente 0,2 a la primera componente de salida. (c) La matriz tiene filas y . Su elemento de la primera fila y la segunda columna vale . El primer sumando corresponde a la ruta en que la segunda componente aporta a la primera y esta a sí misma. El segundo, a la ruta en que la segunda componente se aporta a sí misma y luego a la primera.
Solución 13.2. La matriz tiene determinante 1, conserva el área, no conserva las longitudes, es invertible y lleva el cuadrado a un rectángulo de 2 por 0,5. La rotación tiene determinante 1, conserva el área y las longitudes, es invertible y gira el cuadrado noventa grados. La cizalla tiene determinante 1, conserva el área, no conserva las longitudes, es invertible y lleva el cuadrado a un paralelogramo de vértices , , y . La proyección tiene determinante 0, pierde el área, no es invertible y lleva el cuadrado al segmento entre y .
Solución 13.3. (a) La matriz tiene filas y , mientras que tiene filas y . (b) Se obtiene y . (c) corresponde a un giro de 180°. es un giro completo que devuelve cada vector a su posición.
Solución 13.4. (a) El núcleo es la recta generada por y el rango es 2. (b) El dominio tiene dimensión 3, igual a . (c) Aumentar el sueño y la ansiedad en una misma cantidad mientras la actividad disminuye en esa cantidad deja intactos ambos indicadores. (d) La nueva matriz tiene filas , y , con determinante 1. De se obtiene el sueño, 3. Luego da una actividad de 4 e da una ansiedad de 5.
Solución 13.5. (a) . (b) Los estados cumplen , es decir, forman la recta . No existe estado para , porque toda salida de tiene la segunda componente igual al doble de la primera. (c) La salida cambia en 0,1, un 3,4 % de su norma. La solución pasa de a y cambia un 100 % de su norma. El error relativo se amplifica unas 29 veces, por debajo del número de condición, que es cercano a 42 y acota esa amplificación.
Solución 13.6. (a) , y . (b) y . (c) Las condiciones y dan , de modo que . Con se obtiene . (d) El cociente entre ambas normas es , que baja del 1 % desde .
Referencias
Axler, S. (2015). Linear algebra done right (3.ª ed.). Springer.
Boyd, S. y Vandenberghe, L. (2018). Introduction to applied linear algebra: Vectors, matrices, and least squares. Cambridge University Press.
Hirsch, M. W., Smale, S. y Devaney, R. L. (2013). Differential equations, dynamical systems, and an introduction to chaos (3.ª ed.). Academic Press.
Meyer, C. D. (2000). Matrix analysis and applied linear algebra. SIAM.
Strang, G. (2016). Introduction to linear algebra (5.ª ed.). Wellesley-Cambridge Press.
Trefethen, L. N. y Bau, D., III. (1997). Numerical linear algebra. SIAM.