Cuando la solución exacta no existe
En los capítulos anteriores tratamos las matrices como operadores que transforman estados y estudiamos los valores propios como modos invariantes de las matrices cuadradas. Ahora aparece un problema diferente. A menudo se conoce un conjunto de observaciones que se quiere representar con un modelo más simple, sin que ninguna elección de parámetros reproduzca exactamente todos los datos. El sistema de ecuaciones correspondiente es incompatible o, en términos geométricos, el vector observado no pertenece al subespacio de resultados que el modelo puede generar.
Esta situación es la regla en buena parte del trabajo empírico. Si se miden tres valores y se quieren describir con una recta de dos parámetros, la recta tiene menos grados de libertad que los datos. Si una matriz de muchas variables contiene redundancia, puede intentarse representarla con menos dimensiones. Si una medición está contaminada por error, forzar una igualdad exacta puede producir una descripción peor que aceptar una discrepancia y cuantificarla.
La pregunta matemática deja de ser qué satisface y pasa a ser qué produce el vector más próximo a según un criterio definido. La palabra próximo exige elegir una geometría, que en este capítulo será la distancia euclídea. Esa elección no es neutral, porque define qué discrepancias se consideran grandes o pequeñas, aunque permite introducir las proyecciones, los mínimos cuadrados y la descomposición en valores singulares dentro de un marco común.
El propósito es comprender una familia de operaciones que reaparecerá en la regresión, la reducción de dimensión, el análisis de datos, la identificación de sistemas, las redes y los métodos numéricos, sin convertir toda inferencia científica en una aproximación lineal. Aprenderemos también una distinción metodológica recurrente. Encontrar una representación compacta de los datos es distinto de identificar las causas que los produjeron.
Ortogonalidad y proyección sobre una dirección
Dos vectores y de tienen producto interno euclídeo y son ortogonales cuando . Si , cualquier vector puede separarse en una componente paralela a y otra perpendicular a . Se busca el escalar tal que sea el punto de la recta generada por más cercano a (Strang, 2016).
La condición geométrica es que el residuo sea ortogonal a , es decir, . De ahí se obtiene
Si tiene norma uno, . El residuo contiene la parte de que esa dirección no puede representar. Como y son ortogonales, el teorema de Pitágoras da .
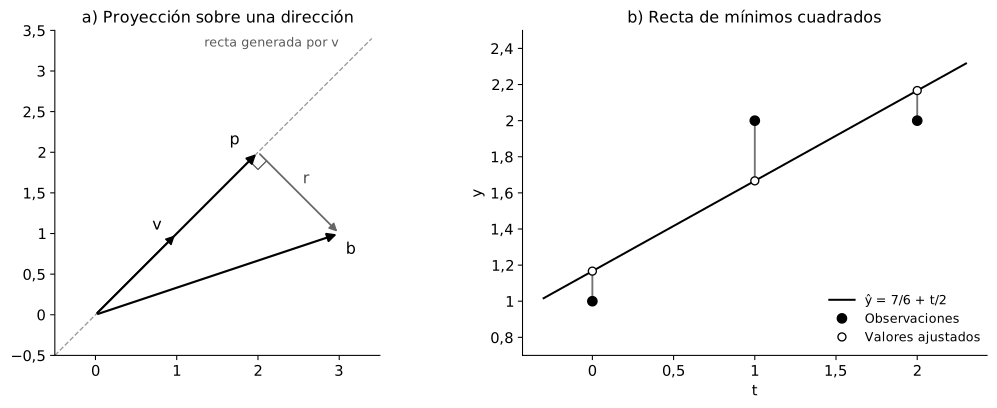
Con y se tiene y , de modo que , y . La ortogonalidad se comprueba con , como muestra el panel a de la figura 15.1. La proyección no afirma que sea realmente . Afirma que, con la distancia euclídea, es el punto de la recta generada por que minimiza la discrepancia con .
Proyección sobre un subespacio
La idea se extiende de una dirección a un subespacio generado por varias columnas. Si las columnas de una matriz son ortonormales, es decir, tienen norma uno y son ortogonales entre sí, se cumple y la proyección ortogonal de sobre el espacio de columnas de es . La matriz es un proyector ortogonal. Cumple , porque proyectar dos veces equivale a proyectar una. Cumple también , propiedad que refleja la geometría euclídea de la proyección.
Si las columnas de una matriz son linealmente independientes aunque no ortonormales, el proyector sobre su espacio de columnas es
La fórmula ayuda a entender los mínimos cuadrados, aunque no es necesariamente la forma numéricamente preferible de calcular una proyección en problemas grandes o mal condicionados. La distinción entre una identidad matemática y un algoritmo estable será importante a lo largo del libro.
La idea central es geométrica. El modelo solo puede producir vectores del espacio de columnas de . Si queda fuera, ningún satisface . La aproximación de mínimos cuadrados sustituye por su proyección sobre ese espacio y busca luego el tal que .
Mínimos cuadrados como problema geométrico
Sea una matriz de con , es decir, con más ecuaciones que parámetros. Se busca el que minimiza la norma del residuo (Boyd y Vandenberghe, 2018),
En el óptimo, el residuo es ortogonal al espacio de columnas de , de modo que . Al sustituir se obtienen las ecuaciones normales,
Si tiene rango completo por columnas, es invertible y la solución única es .
La expresión parece una receta de regresión, aunque su contenido es más general. El vector es la proyección ortogonal de sobre el espacio de resultados accesibles al modelo. El residuo no desaparece y queda en el complemento ortogonal de ese espacio. La solución minimiza la suma de cuadrados porque el cuadrado de la norma euclídea del residuo es .
No todo residuo es ruido. Puede contener error de medición, variables omitidas, una forma funcional inadecuada, heterogeneidad o aspectos del fenómeno que el modelo decidió no representar. Los mínimos cuadrados definen un criterio de aproximación. La interpretación científica de la discrepancia exige información adicional.
Ajuste de una recta a tres observaciones
Supongamos tres observaciones de una variable en los tiempos , con valores , que se quieren aproximar mediante una recta . En forma matricial,
Ninguna recta pasa exactamente por los tres puntos. Se calcula
El determinante de es 6 y la solución de las ecuaciones normales es y . La recta ajustada es , con valores predichos y residuo .
La condición geométrica se comprueba directamente. El producto interno de con la primera columna, , es . Con la segunda, , es . El residuo es ortogonal a ambas columnas y la suma de cuadrados residual es . El panel b de la figura 15.1 muestra el ajuste.
El cálculo no demuestra que el tiempo cause un cambio lineal de ni que los errores sean aleatorios o gaussianos. Solo encuentra la recta que minimiza la distancia cuadrática a estas tres observaciones con la representación elegida.
Ecuaciones normales, factorización QR y estabilidad numérica
Las ecuaciones normales derivan los mínimos cuadrados con claridad, aunque formarlas explícitamente puede empeorar la estabilidad numérica del cálculo. Si tiene rango completo por columnas, en aritmética exacta se cumple , porque los valores propios de son los cuadrados de los valores singulares de . Una matriz con número de condición produce ecuaciones normales con número de condición . Con los unos dieciséis dígitos de la aritmética de doble precisión, el problema original puede perder unos cuatro dígitos y las ecuaciones normales, unos ocho. Si pierde rango, es singular. Estos hechos justifican preferir los métodos basados en QR o en la descomposición en valores singulares en muchos cálculos (Trefethen y Bau, 1997; Golub y Van Loan, 2013).
En la factorización , tiene columnas ortonormales y es triangular superior. Minimizar equivale entonces a resolver , sin formar , lo que conserva mejor la información numérica de la matriz. La descomposición en valores singulares es más costosa en algunos contextos, aunque informa además sobre el rango, el condicionamiento y las direcciones poco identificadas. Elegir un algoritmo es algo más que una cuestión de velocidad, porque también importan las propiedades numéricas que preserva y los diagnósticos que permite.
Las ecuaciones normales, la factorización QR y la descomposición en valores singulares dan la misma solución en aritmética ideal cuando se cumplen las hipótesis apropiadas, aunque no son equivalentes como procedimientos numéricos. Dos expresiones algebraicamente equivalentes pueden comportarse de forma muy distinta con datos finitos, redondeo y matrices mal condicionadas. Por eso conviene separar la solución matemática del problema de optimización, el algoritmo que la aproxima en aritmética finita y la interpretación científica de los parámetros obtenidos. Una deducción correcta en el primer nivel no garantiza la estabilidad numérica del segundo ni la validez causal del tercero.
La descomposición en valores singulares
Los valores propios del capítulo 14 requieren una matriz cuadrada y describen vectores que el operador transforma en múltiplos de sí mismos. La descomposición en valores singulares, conocida por su sigla inglesa SVD, se aplica a cualquier matriz real de ,
En la forma completa, es ortogonal de , es ortogonal de y es de , con ceros fuera de la diagonal. Si y el rango es , las posiciones diagonales contienen los valores singulares ordenados,
Las direcciones del núcleo de pertenecen al espacio de entrada y las del núcleo de , al de salida. Sus dimensiones pueden diferir si la matriz es rectangular.
Las columnas de son los vectores singulares derechos y las columnas de , los izquierdos. Para se cumple
La matriz expresa la entrada en una base ortonormal. La matriz escala sus componentes y puede anular algunas. La matriz expresa el resultado en la base ortonormal de salida. La descomposición separa así los cambios ortogonales de coordenadas de los factores de escala no negativos, sin exigir que una dirección de entrada coincida con su dirección de salida.
Los valores propios de son los cuadrados de los valores singulares, completados con ceros hasta . Lo mismo ocurre con , completando hasta . Sus vectores propios pueden elegirse como las columnas de y de , respectivamente. La construcción usa matrices simétricas semidefinidas positivas aunque no sea cuadrada ni simétrica, de modo que no supone que sea diagonalizable por semejanza.
Geometría de la descomposición en valores singulares
La imagen de la bola unitaria cerrada, el conjunto de vectores de norma menor o igual que uno, es un elipsoide, posiblemente degenerado, dentro de la imagen de . Los vectores singulares derechos con valor singular positivo son direcciones ortogonales de entrada cuyas imágenes son ortogonales y tienen longitudes , los semiejes del elipsoide. Las direcciones del núcleo se anulan. Si la aplicación no es inyectiva, la imagen de la esfera puede incluir el interior relativo del elipsoide. La matriz de una fila , por ejemplo, lleva la circunferencia a todo el intervalo .
El mayor valor singular cumple
de modo que mide la máxima amplificación euclídea de un vector unitario. La mínima amplificación sobre los vectores unitarios coincide con el menor valor singular solo si tiene rango completo por columnas. Si hay un núcleo no trivial, esa mínima es cero. Para una matriz cuadrada invertible, el cociente es el número de condición espectral, que también se define como para matrices de rango completo por columnas. La matriz del capítulo 13 con filas y tiene valores singulares cercanos a 2,05 y 0,049, cuyo cociente reproduce el número de condición de 42 que se mencionó allí.
La descomposición complementa el capítulo 14. En una matriz no normal, los valores propios pueden no describir la máxima amplificación, mientras que los valores singulares están construidos para medir la expansión y la contracción euclídeas. La matriz de aquel capítulo tiene valores propios 0,9 y 0,8 y valores singulares cercanos a 10,1 y 0,07, de modo que en un solo paso puede multiplicar por diez la norma de una perturbación. El producto de los valores singulares, 0,72, coincide con el valor absoluto del determinante, igual que el producto de los valores propios. Espectro propio y espectro singular responden preguntas distintas.
En tiempo continuo hay que indicar, además, qué operador se analiza. Si , la amplificación del estado tras un tiempo se obtiene de los valores singulares de . La matriz transforma estados en tasas instantáneas, mientras que transforma el estado inicial en el estado en el instante . Confundir esos papeles puede llevar a conclusiones incorrectas sobre el crecimiento transitorio.
Pseudoinversa y direcciones débilmente identificadas
La descomposición define de manera uniforme la pseudoinversa de Moore y Penrose (Penrose, 1955). Si , se reemplaza cada valor singular positivo por y se mantienen en cero las direcciones nulas, lo que da
Para cualquier matriz real, es la única solución de norma euclídea mínima entre todas las que minimizan . Todos los minimizadores se escriben , con en el núcleo de . Si tiene rango completo por columnas, el núcleo es trivial y la solución es única. Si el sistema es compatible, el residuo mínimo es cero. Los parámetros pueden no ser únicos, aunque el vector ajustado sí lo es. Para la ecuación , por ejemplo, la pseudoinversa elige entre las infinitas soluciones.
El precio de invertir valores singulares pequeños se ve en un ejemplo mínimo. Si , entonces . Un cambio de en la segunda componente de cambia la segunda componente de la solución en . La matriz comprimió cien veces esa dirección y la inversión debe ampliarla cien veces, de modo que usar más decimales no resuelve el problema si la incertidumbre proviene de los datos.
En las aplicaciones científicas, un valor singular pequeño puede indicar que combinaciones distintas de parámetros producen resultados casi indistinguibles con las observaciones disponibles. Que el modelo tenga solución no basta, porque la solución puede ser extremadamente sensible. La idea reaparecerá al estudiar la identificabilidad y la regularización.
Aproximación de rango reducido
La descomposición representa una matriz como una suma de componentes de rango uno,
Conservar solo los primeros términos da . El teorema de Eckart y Young (1936), extendido después a otras normas, establece que es una mejor aproximación de rango a lo sumo según la norma espectral y la de Frobenius, con
El resultado es fuerte y específico. Mejor significa mejor dentro de una clase de matrices de rango restringido y según una norma determinada, sin garantía de que la aproximación conserve lo científicamente relevante.
La matriz simétrica del capítulo 14, con filas y , tiene valores propios 3 y 1. Como es simétrica y definida positiva, sus valores singulares son también 3 y 1, con . La aproximación de rango uno es
con error de filas y , cuya norma espectral es 1, el segundo valor singular. El primer término retiene la fracción de la suma de los cuadrados de los valores singulares. Con esa métrica, el componente dominante conserva el 90 % de la energía cuadrática de la matriz, lo que no autoriza a concluir que una sola causa explique el 90 % del fenómeno.
Si tiene rango , la descomposición reducida prescinde de las columnas asociadas a valores singulares nulos. Separa el rango algebraico exacto del rango efectivo que se elige al truncar los valores singulares pequeños, que depende de un umbral, de la escala del problema y de la precisión de los datos. Un valor singular distinto de cero en aritmética exacta puede ser tan pequeño respecto del error de medición que la dirección correspondiente no pueda estimarse de manera confiable. Hablar de dimensión efectiva exige declarar una tolerancia o un modelo de incertidumbre, porque la matriz no contiene un punto natural en que deba cortarse el espectro singular.
De la descomposición en valores singulares al análisis de componentes principales
El análisis de componentes principales, o PCA, se basa habitualmente en la matriz de covarianzas (Jolliffe y Cadima, 2016). Si contiene observaciones centradas por columnas, esa matriz es . Sus vectores propios pueden elegirse como las columnas de en la descomposición de y sus valores propios son . Cada componente principal conserva así una dirección de variación alrededor de la media. Aplicar la descomposición sin centrar sigue siendo válido, aunque describe los segundos momentos respecto del origen. Estandarizar además las columnas cambia otra vez la geometría. Un informe debe identificar qué matriz se descompuso y con qué escala de variables.
La técnica permite comprimir, visualizar y reducir redundancias. Una componente principal es, sin embargo, una combinación lineal elegida para optimizar un criterio geométrico de varianza. Eso no la convierte en una entidad causal, en un mecanismo biológico ni en una dimensión psicológica natural. Su significado sustantivo debe justificarse de manera independiente.
La advertencia es especialmente relevante con datos clínicos. Una combinación de síntomas que explica mucha varianza puede reflejar un proceso común, una estructura de medición, diferencias de escala, la composición de la muestra o varios mecanismos simultáneos. La descomposición describe la geometría lineal de la matriz que se le entrega y no decide cuál interpretación es correcta.
La escala de las variables
La descomposición en valores singulares y los mínimos cuadrados dependen de la métrica usada. Una variable medida en unidades numéricamente mucho mayores que otra puede dominar una norma euclídea sin ser científicamente más importante. Cambiar las unidades puede modificar una aproximación de rango reducido si la representación no se ajusta en consecuencia.
Supongamos una matriz que combina dos variables sin correlación entre sí. La edad tiene una desviación estándar de 10 años y una concentración sanguínea, una de 0,5 ng/mL. Con esas unidades, la varianza de la edad es 100 y la de la concentración, 0,25, de modo que la primera componente principal es prácticamente la edad. Si la concentración se expresa en pg/mL, su desviación estándar pasa a 500 y su varianza a 250 000. La primera componente se vuelve entonces la concentración. El fenómeno no cambió, aunque sí la escala numérica. Centrar, estandarizar o introducir una métrica ponderada no son, por tanto, operaciones cosméticas.
El problema conecta con el capítulo 11. Elegir escalas características y unidades adecuadas precede a la interpretación de distancias, proyecciones o componentes dominantes. En algunos problemas la geometría euclídea es una elección natural. En otros hacen falta ponderaciones derivadas de las incertidumbres de medición, de los costos o de estructuras físicas específicas.
Dos lecturas de una misma reducción
Una dirección de poca varianza no es necesariamente irrelevante. Consideremos dos grupos de 100 personas medidas en dos variables que comparten un factor común de gran varianza. Los grupos difieren en una dirección perpendicular a ese factor, en que la variación es pequeña. En una simulación con estas características, la primera componente principal explica el 95 % de la varianza y no distingue a los grupos, con una diferencia estandarizada de medias de 0,07. La segunda explica solo el 5 %, aunque separa a los grupos casi por completo, con una diferencia estandarizada de 4,2. La figura 15.2 muestra ambos resultados.
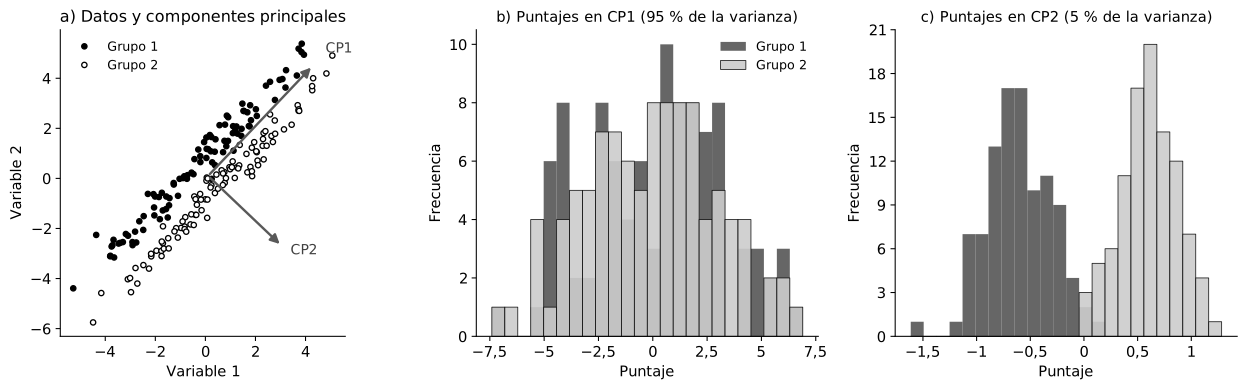
La reducción adecuada depende, por tanto, de la tarea. Para comprimir un archivo, minimizar el error de reconstrucción puede bastar. Para detectar una diferencia entre grupos o un acontecimiento raro, preservar una dirección de poca varianza puede ser decisivo. Para explicar causalmente un sistema, la varianza retenida no es un criterio de suficiencia explicativa. Un segundo valor singular pequeño indica que, en la métrica elegida, buena parte de la variación puede aproximarse con menos dimensiones, sin demostrar que la dirección descartada sea prescindible para toda decisión. Puede contener una señal pequeña y clínicamente crítica o ser necesaria para identificar un mecanismo.
Una misma operación algebraica admite, además, lecturas distintas según lo que representen las filas, las columnas y las distancias. Aproximar por rango uno la matriz de un operador reemplaza una transformación del plano por otra cuya imagen es una recta. La misma operación sobre una matriz de datos es una reducción de dimensión. La matriz no contiene su propia semántica científica.
Aproximación, predicción y explicación
Las herramientas de este capítulo realizan operaciones matemáticas muy precisas. La proyección encuentra el elemento más cercano de un subespacio con una métrica dada. Los mínimos cuadrados encuentran los parámetros que minimizan una suma de discrepancias cuadráticas. La descomposición en valores singulares separa una matriz en direcciones ortogonales con factores de escala. Su truncación produce aproximaciones óptimas de rango reducido según normas específicas.
Ninguna de esas propiedades responde preguntas causales. Una proyección excelente de una variable sobre un espacio de características no demuestra que las características sean causas manipulables. Una matriz que se comprime bien en dos dimensiones no demuestra que el sistema tenga exactamente dos mecanismos. Un parámetro bien estimado por mínimos cuadrados todavía exige examinar los supuestos de medición, el diseño, la dependencia temporal y la estructura del error.
La precisión matemática de estas operaciones no resuelve las preguntas conceptuales. Una representación puede ser óptima para un criterio e insuficiente para otro propósito. En las ciencias de la complejidad, donde se trabaja repetidamente con reducciones, descripciones más gruesas y modelos de menor dimensión, esta distinción evitará confundir una descripción eficiente con una explicación completa.
Consolidación
Una proyección ortogonal reemplaza un vector por el elemento más cercano de un subespacio según la norma euclídea. En los mínimos cuadrados, es la proyección de sobre el espacio de columnas de y el residuo queda ortogonal a ese espacio. Las ecuaciones normales expresan esa condición, aunque no siempre son el algoritmo numéricamente preferible.
La descomposición en valores singulares existe para cualquier matriz real y separa su acción en direcciones ortogonales de entrada, factores de escala no negativos y direcciones ortogonales de salida. Los valores singulares cuantifican la amplificación y la contracción. Los pequeños revelan direcciones que la transformación casi elimina y cuya inversión puede amplificar el error.
La truncación de la descomposición produce una aproximación óptima de bajo rango según normas específicas, lo que justifica técnicas de compresión y de reducción de dimensión sin identificar variables causales ni mecanismos latentes. La interpretación depende del significado de las filas y las columnas, de las unidades, de la escala y del objetivo del análisis, como mostró la dirección de poca varianza que separaba a los grupos.
Los valores propios y los valores singulares no son intercambiables. Los primeros describen direcciones invariantes de matrices cuadradas y los segundos, la expansión y la contracción ortogonales de matrices generales. Ambas herramientas serán necesarias al analizar la estabilidad, la sensibilidad y los datos de sistemas dinámicos. El cuadro 15.1 reúne los conceptos del capítulo.
Cuadro 15.1. Proyecciones, mínimos cuadrados y descomposición en valores singulares.
| Concepto | Definición operativa | Qué informa | Precaución |
|---|---|---|---|
| Proyección ortogonal | Punto más cercano de un subespacio con la norma euclídea | Componente representable dentro del subespacio | Depende de la métrica y del subespacio elegidos |
| Mínimos cuadrados | Minimización de ‖b − Ax‖₂² | Mejor ajuste cuadrático dentro del modelo lineal | El residuo no es sinónimo de ruido |
| Residuo | r = b − Ax̂ | Parte no representada por la solución ajustada | Puede contener estructura, sesgo o variables omitidas |
| Descomposición en valores singulares | A = UΣVᵀ | Direcciones ortogonales y factores de escala | No es una descomposición causal |
| Valor singular | σᵢ ≥ 0 | Amplificación o contracción en una dirección singular | Los valores pequeños vuelven sensible la inversión |
| Pseudoinversa | A⁺ = VΣ⁺Uᵀ | Soluciones de mínimos cuadrados y de norma mínima | Puede amplificar errores en direcciones mal condicionadas |
| Aproximación de rango k | Truncación de la descomposición | Compresión óptima según normas específicas | Una dimensión geométrica baja no equivale a pocos mecanismos |
| Componente principal | Dirección de máxima varianza de los datos centrados | Resumen de la variación dominante | Una dirección de poca varianza puede ser la relevante |
El capítulo 16 retoma el cálculo con varias variables. Introduce las derivadas parciales, los gradientes y las matrices jacobianas para describir cómo cambia localmente una función o una transformación cuando se perturban varias variables a la vez.
Ejercicios
Ejercicio 15.1. Proyecte sobre la dirección . (a) Calcule , y el residuo . (b) Compruebe la ortogonalidad y el teorema de Pitágoras. (c) Interprete y en términos de la media de las componentes de .
Ejercicio 15.2. Ajuste por mínimos cuadrados una recta a las observaciones , , y . (a) Calcule y . (b) Resuelva las ecuaciones normales. (c) Calcule los residuos y compruebe que son ortogonales a las columnas de . (d) Calcule la suma de cuadrados residual.
Ejercicio 15.3. Una matriz de rango completo por columnas tiene valores singulares 1 y . (a) Calcule y . (b) Con unos dieciséis dígitos de precisión, ¿cuántos dígitos podrían perderse al resolver el problema por QR y cuántos al usar las ecuaciones normales?
Ejercicio 15.4. Considere la matriz con filas y . (a) Calcule y, a partir de sus valores propios, los valores singulares de . (b) Compare el producto de los valores singulares con el de los valores propios. (c) ¿Cuál es la máxima amplificación de la norma en un paso y qué dirección de entrada la produce?
Ejercicio 15.5. (a) Con , calcule para y para . (b) Repita el cálculo con la pseudoinversa truncada que anula el segundo valor singular. Compare la sensibilidad y el sesgo de ambas soluciones. (c) Encuentre la solución de norma mínima de y escriba el conjunto de todas las soluciones.
Ejercicio 15.6. Para la matriz con filas y , (a) calcule sus valores singulares, (b) su aproximación de rango uno y (c) la norma espectral del error. (d) ¿Qué fracción de la suma de los cuadrados de los valores singulares retiene el primer término?
Ejercicio 15.7. Se analizan con componentes principales dos variables sin correlación. La edad tiene una desviación estándar de 10 años y una concentración, una de 0,5 ng/mL. (a) ¿Qué variable domina la primera componente con esas unidades? (b) ¿Qué variable la domina si la concentración se expresa en pg/mL? (c) ¿Qué ocurre si ambas variables se estandarizan? (d) ¿Qué enseña el ejercicio sobre la elección de la escala?
Consultar las soluciones de los ejercicios
Soluciones de los ejercicios
Solución 15.1. (a) , de modo que y . (b) y . (c) La proyección sobre reemplaza cada componente por la media, que es 2. El residuo contiene las desviaciones respecto de esa media.
Solución 15.2. (a) tiene filas y . Además, . (b) El determinante es 20 y la solución es y . (c) Los valores ajustados son 1,3; 2,1; 2,9 y 3,7. Los residuos son −0,3; 0,9; −0,9 y 0,3. Su suma es cero y su producto con es . (d) La suma de cuadrados residual es .
Solución 15.3. (a) y . (b) Como regla aproximada, se pierden tantos dígitos como el logaritmo decimal del número de condición. Con QR podrían perderse unos cuatro dígitos y quedar unos doce. Con las ecuaciones normales podrían perderse unos ocho y quedar unos ocho.
Solución 15.4. (a) tiene filas y . Sus valores propios son cercanos a 101,44 y 0,0051, cuyas raíces dan valores singulares cercanos a 10,07 y 0,0715. (b) El producto de los valores singulares, , coincide con el producto de los valores propios, , porque ambos son el valor absoluto del determinante. (c) La máxima amplificación en un paso es cercana a 10,07. La produce el primer vector singular derecho, cercano a , casi paralelo a . Eso explica que la perturbación del capítulo 14, que partía de , creciera de inmediato.
Solución 15.5. (a) , de modo que las soluciones son y . Un cambio de 0,001 en el dato cambia la solución en 0,1. (b) La pseudoinversa truncada da en ambos casos. La solución deja de ser sensible al cambio del dato, aunque ignora la segunda componente y queda sesgada. Elegir entre ambas opciones exige ponderar la varianza frente al sesgo, que es el problema de la regularización. (c) La matriz tiene pseudoinversa , de modo que la solución de norma mínima es . El conjunto de soluciones es , con real.
Solución 15.6. (a) La matriz es simétrica y definida positiva, con valores propios 4 y 2, que coinciden con sus valores singulares. (b) Con , la aproximación es , con todas sus entradas iguales a 2. (c) El error tiene filas y y norma espectral 2, el segundo valor singular. (d) La fracción es .
Solución 15.7. (a) La edad, con varianza 100 frente a 0,25. (b) La concentración, cuya varianza pasa a 250 000. (c) Ambas varianzas valen 1 y no hay correlación, de modo que las dos componentes explican la misma varianza y cualquier dirección del plano puede tomarse como componente principal. (d) La escala decide el resultado del análisis y su elección debe justificarse según la pregunta.
Referencias
Boyd, S. y Vandenberghe, L. (2018). Introduction to applied linear algebra: Vectors, matrices, and least squares. Cambridge University Press.
Eckart, C. y Young, G. (1936). The approximation of one matrix by another of lower rank. Psychometrika, 1(3), 211–218. https://doi.org/10.1007/BF02288367
Golub, G. H. y Van Loan, C. F. (2013). Matrix computations (4.ª ed.). Johns Hopkins University Press.
Jolliffe, I. T. y Cadima, J. (2016). Principal component analysis: A review and recent developments. Philosophical Transactions of the Royal Society A, 374(2065), 20150202. https://doi.org/10.1098/rsta.2015.0202
Penrose, R. (1955). A generalized inverse for matrices. Mathematical Proceedings of the Cambridge Philosophical Society, 51(3), 406–413. https://doi.org/10.1017/S0305004100030401
Strang, G. (2016). Introduction to linear algebra (5.ª ed.). Wellesley-Cambridge Press.
Trefethen, L. N. y Bau, D., III. (1997). Numerical linear algebra. SIAM.