Describir cómo cambia algo cuando cambian varias cosas a la vez
En una función de una variable, la derivada resume la variación local mediante una pendiente. Si es diferenciable, una perturbación pequeña produce un cambio aproximado . El paso a varias variables añade una dificultad conceptual, porque ya no hay una única manera de alejarse de un punto. Puede modificarse una coordenada manteniendo las demás fijas, avanzarse en una dirección oblicua o perturbarse a la vez varias componentes del estado.
La situación es habitual en las ciencias de la complejidad. Un sistema puede describirse por la temperatura y la concentración, por dos poblaciones que interactúan, por la actividad de varias regiones o por variables clínicas observadas a lo largo del tiempo. La pregunta de cómo cambia el sistema queda incompleta mientras no se indique qué componente se perturba, en qué dirección y qué cantidad se observa como respuesta.
Las derivadas parciales, el gradiente y la matriz jacobiana organizan estas preguntas. Las derivadas parciales describen los cambios locales al variar una coordenada concreta. El gradiente reúne las derivadas parciales de una función escalar y la matriz jacobiana extiende la misma idea a una transformación con varias salidas. Ninguna de estas herramientas es una afirmación causal, porque describen la sensibilidad matemática dentro de una función o de un modelo ya especificados. La interpretación científica depende de lo que representen las variables y de si las perturbaciones matemáticas corresponden a intervenciones o variaciones posibles en el sistema real.
Derivadas parciales
La derivada parcial de una función escalar respecto de en el punto se obtiene manteniendo fija y tomando el límite del cociente incremental,
La derivada respecto de se define de manera análoga. Consideremos
Derivar respecto de tratando como constante da . Derivar respecto de da . En el punto , las pendientes parciales valen 4 y 9. Para perturbaciones suficientemente pequeñas alrededor de ese punto, aumentar en con fija cambia en cerca de . Aumentar en con fija la cambia en cerca de .
La expresión mantener las otras variables constantes designa, en primer lugar, una operación matemática. Si e representan variables físicas acopladas que no pueden variar de manera independiente, la derivada parcial sigue bien definida en el modelo, aunque su interpretación experimental puede ser difícil o imposible. En las ciencias empíricas, el ceteris paribus algebraico no equivale automáticamente a una intervención realizable.
Derivadas parciales y diferenciabilidad
En una variable, la existencia de la derivada en un punto da una aproximación lineal local. En varias variables, que todas las derivadas parciales existan en un punto no basta para garantizar que una única transformación lineal aproxime la función en todas las direcciones.
La noción relevante es la diferenciabilidad (Spivak, 1965). Una función es diferenciable en si existe una aplicación lineal tal que
La condición exige que el error de la aproximación lineal sea pequeño en relación con el tamaño de la perturbación, cualquiera sea la dirección desde la que uno se acerque. Si tiene derivadas parciales continuas en un entorno del punto, la diferenciabilidad está garantizada. Hay, sin embargo, funciones con derivadas parciales en un punto que no son diferenciables allí.
Un contraejemplo explícito es fuera del origen, con . Sobre ambos ejes la función vale cero, de modo que las dos derivadas parciales en el origen existen y valen cero. Sobre la recta , con , se tiene en cambio . La función ni siquiera es continua en el origen y no admite allí una aproximación lineal conjunta. La continuidad de las derivadas parciales en un entorno es una condición suficiente útil, que su mera existencia en un punto no asegura.
La distinción importa porque en los capítulos siguientes se linealizarán sistemas no lineales cerca de equilibrios. Esa operación exige que la transformación admita una aproximación lineal local suficientemente regular en la región considerada, algo más que calcular algunas pendientes.
Gradiente de una función escalar
Para una función escalar , el gradiente en coordenadas cartesianas es el vector de sus derivadas parciales,
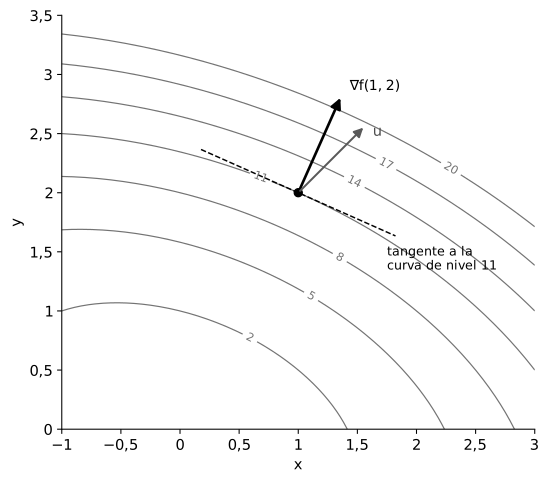
En el ejemplo, y, en particular, . El gradiente permite escribir la aproximación de primer orden de forma compacta,
para una perturbación pequeña (Marsden y Tromba, 2012).
Con en el punto , el cambio predicho es . La calidad de la aproximación puede comprobarse, porque y , de modo que el cambio exacto es . El resto vale 0,0007 y puede calcularse sin aproximaciones. Para , el término omitido es , que con y da . El capítulo 17 sistematizará este cálculo mediante el desarrollo de Taylor.
Derivada direccional
Una perturbación no tiene por qué seguir un eje coordenado. Para un vector unitario , la derivada direccional de en la dirección es la tasa de cambio al avanzar desde a lo largo de esa dirección. Para funciones diferenciables y con la geometría euclídea,
En el punto y en la dirección , se obtiene . En la dirección opuesta, la derivada vale .
Si el gradiente no es nulo, la derivada direccional alcanza su máximo entre todas las direcciones unitarias en la dirección del gradiente. Se deduce de la desigualdad de Cauchy y Schwarz, . En geometría euclídea, el gradiente apunta hacia el ascenso local más rápido y su norma, en el ejemplo, es la tasa máxima de aumento por unidad de desplazamiento. Si el gradiente es nulo, todas las derivadas direccionales son nulas y ninguna dirección de ascenso queda seleccionada en primer orden. Las curvas o superficies de nivel regulares, , son perpendiculares al gradiente, porque un desplazamiento tangente a ellas no cambia en primer orden. La figura 16.1 muestra estas relaciones.
Gradiente y métrica
Suele afirmarse que el gradiente es el vector de las derivadas parciales. La afirmación es correcta en coordenadas cartesianas con el producto interno euclídeo, aunque conviene precisar qué estructura se usa. La derivada de una función escalar en un punto es, de manera más precisa, una aplicación lineal, el diferencial, que asigna a cada perturbación el cambio de primer orden de ,
Para convertir ese funcional lineal en un vector hace falta un producto interno que identifique funcionales con vectores (Hubbard y Hubbard, 2015). Con la métrica euclídea se obtiene la fórmula habitual. Con otra métrica, el vector gradiente cambia aunque el diferencial represente la misma variación local.
Para un producto interno con simétrica definida positiva, el vector gradiente es , porque . En el ejemplo, la métrica con cuenta un desplazamiento en como el doble de largo que uno igual en . El vector gradiente en pasa a ser . La dirección de máximo ascenso, normalizada con esa métrica, apunta hacia , mientras que con la métrica euclídea apuntaba hacia .
Esta precisión será útil con variables de escalas diferentes o con espacios de estados cuya geometría natural no sea euclídea. Evita además una inferencia incorrecta, porque el camino de máximo ascenso depende de cómo se mida la longitud de las perturbaciones. La función no especifica siempre qué desplazamientos deben considerarse igualmente grandes.
La matriz jacobiana
Consideremos ahora una transformación vectorial , , en que cada componente de la salida puede depender de varias entradas. La matriz jacobiana tiene como elementos las derivadas parciales . Sus filas corresponden a las componentes de salida y sus columnas, a las variables de entrada. Si es diferenciable, la matriz jacobiana es la de la mejor aproximación lineal local,
Consideremos
La perturbación produce el cambio lineal aproximado . La primera componente tiene un cambio de primer orden nulo porque . La segunda cambia en cerca de . El cálculo exacto da . La matriz jacobiana no da una sola pendiente, porque es la transformación lineal que combina todas las perturbaciones de entrada y estima sus efectos locales sobre todas las salidas.
La matriz jacobiana como mapa local
El elemento cuantifica cuánto cambia localmente la salida al perturbar la entrada con las demás coordenadas fijas dentro del modelo. Ese significado matemático es preciso. Su significado causal depende de cómo se obtuvo .
Si representa una ley física conocida y es una variable manipulable de manera independiente, la derivada puede tener una interpretación intervencionista directa. Si se ajustó a datos observacionales o si las variables comparten causas no representadas, un término cruzado de la matriz jacobiana no establece causalidad. Incluso en un modelo causal, mantener fijas las demás variables puede corresponder a una intervención imposible o a una condición que rompe otras relaciones del sistema.
Esto será especialmente importante en los modelos clínicos. Una matriz jacobiana estimada para una dinámica de síntomas indica una sensibilidad local dentro del modelo, sin demostrar que intervenir sobre un síntoma produzca el cambio predicho en los demás. Esa afirmación requiere supuestos causales, un diseño adecuado y una validación empírica adicional.
Matriz jacobiana de un sistema dinámico
Un sistema continuo de dos variables, y , se escribe como con . La matriz jacobiana del campo vectorial es
Los elementos diagonales describen cómo responde localmente la tasa de cambio de cada variable a su propio valor. Los elementos fuera de la diagonal describen los acoplamientos locales entre variables. La lectura exige conservar la palabra localmente, porque en un sistema no lineal las derivadas cambian con el estado.
Consideremos el sistema
con matriz jacobiana
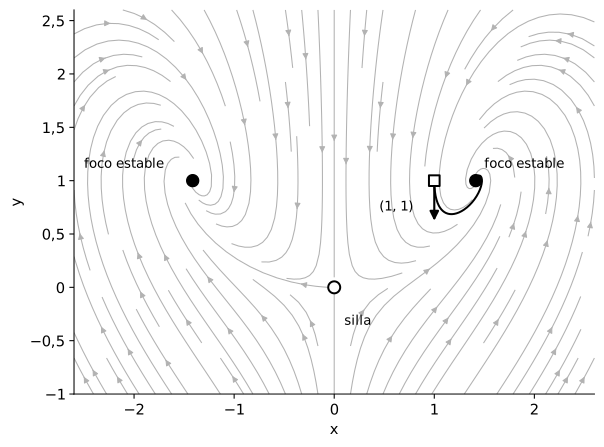
En el punto , sus filas son y . El elemento −1 indica que, en ese punto, un aumento pequeño de reduce la tasa en una unidad por unidad de . El elemento 2 indica que un aumento de incrementa la tasa a razón de dos unidades. En otro punto esos valores cambian, porque la matriz jacobiana es una descripción lineal local del campo, fija solo cuando el sistema es lineal.
El punto no es un equilibrio, porque el campo vale allí . Los equilibrios cumplen y , de modo que son el origen y los puntos . En el origen, la matriz jacobiana tiene valores propios 1 y −2, una silla. En tiene traza −2 y determinante 4, de modo que sus valores propios son y ambos equilibrios son focos estables, como se vio en el capítulo 14. La matriz en tiene valores propios , parecidos a los del foco cercano, aunque no clasifican nada, porque no corresponden a un equilibrio. La figura 16.2 muestra el retrato de fase y la trayectoria que parte de y converge al foco. Para estudiar las perturbaciones de una trayectoria no estacionaria hay que seguir la ecuación variacional a lo largo de ella, con la matriz jacobiana de cada instante (Hirsch, Smale y Devaney, 2013).
Unidades de la matriz jacobiana
Las derivadas parciales tienen unidades. Si tiene unidades y tiene unidades , entonces . En un sistema dinámico continuo, tiene unidades de por tiempo, de modo que . Si todas las variables comparten las mismas unidades, la matriz jacobiana tiene unidades de tiempo inverso. Si no las comparten, comparar directamente elementos distintos puede carecer de sentido, porque una derivada de valor 100 no es necesariamente más fuerte que otra de valor 0,1 si sus unidades y escalas son distintas. Como vimos en el capítulo 11, antes de interpretar una matriz jacobiana como una tabla de intensidades relativas puede hacer falta adimensionalizar el sistema o usar sensibilidades normalizadas.
Sensibilidades normalizadas
Una sensibilidad adimensional se obtiene normalizando el cambio relativo de la salida por el cambio relativo de la entrada. Si y son distintos de cero, la sensibilidad relativa o elasticidad es
Para magnitudes positivas, significa que un aumento del 1 % en produce, dentro del modelo y con las demás coordenadas fijas, un aumento cercano al 2 % en . Para una ley de potencia , la elasticidad vale en todo punto. En el modelo del capítulo 8, la elasticidad del efecto respecto de la concentración es , que vale 0,5 en y 0,1 en , lo que expresa la saturación en términos relativos. Con valores negativos o cerca de cero, la normalización exige cuidado o deja de estar definida. Sigue siendo una sensibilidad local del modelo, cuyo alcance causal debe justificarse aparte.
Otra posibilidad consiste en escalar las variables con magnitudes características antes de derivar. Con y , las derivadas son adimensionales y expresan la sensibilidad respecto de las escalas elegidas. Esa elección debe justificarse, porque escalas distintas producen matrices numéricamente distintas para la misma dinámica.
Normalizar no elimina la necesidad de interpretar la estructura completa. Un elemento grande puede producir poco efecto neto si otras vías compensan la perturbación. Uno pequeño puede ser importante si actúa sobre un modo lento o sobre una variable con gran amplificación posterior. Por eso el paso siguiente en el análisis dinámico consiste en estudiar cómo interactúan conjuntamente los elementos, algo que hacen los valores y vectores propios del capítulo 14.
Regla de la cadena
Los sistemas complejos suelen construirse mediante transformaciones sucesivas. Si se transforma en y luego en , la composición cumple la regla de la cadena en varias variables (Apostol, 1969),
El orden importa. Primero transforma una perturbación en y después transforma ese cambio en . La matriz total es el producto , coherente con la composición de transformaciones del capítulo 13.
Con y , la composición es , cuyo gradiente es . La regla de la cadena da el mismo resultado,
La idea reaparecerá en redes, en aprendizaje automático y en modelos multiescala, porque las sensibilidades locales de una cadena de transformaciones se obtienen componiendo sus operadores diferenciales.
Cambio de coordenadas y transformación de la matriz jacobiana
El capítulo 12 mostró que una misma dinámica puede representarse con coordenadas diferentes. Con un cambio lineal invertible , el sistema lineal se convierte en . Las matrices y representan el mismo generador en coordenadas distintas y comparten valores propios.
Con un cambio no lineal , independiente del tiempo y con y su inversa suficientemente suaves, el campo transformado es , con . Al derivar aparecen, además de la conjugación de la matriz jacobiana, términos que contienen las segundas derivadas de multiplicadas por . En un equilibrio se tiene y esos términos se anulan, de modo que . La semejanza espectral en los equilibrios no debe extrapolarse a la matriz jacobiana evaluada en cualquier punto de una trayectoria (Hirsch, Smale y Devaney, 2013).
La corrección se ve en una dimensión. Con y , la tasa es y la regla de la cadena da
El segundo término explica por qué la derivada del campo no es invariante fuera de un equilibrio. Con y para , la derivada vale −1 en el equilibrio , igual que . En vale −1,5, mientras que sigue valiendo −1. Si el cambio depende del tiempo, aparece además la derivada parcial de respecto del tiempo.
Los elementos individuales de una matriz jacobiana dependen, por tanto, de la elección de variables y coordenadas. No conviene convertir cada coeficiente en una entidad física independiente sin justificar la representación. Algunas propiedades locales, como la estabilidad de un equilibrio bajo transformaciones regulares, se conservan, en cambio, aunque cambien los números de la matriz.
Aproximación local de una transformación no lineal
Retomemos en , donde . Para una perturbación , la aproximación lineal es
mientras que la expresión exacta es
Los términos , y son los que la aproximación lineal omite. Cuando y tienden a cero, son pequeños respecto de la norma de la perturbación, aunque no necesariamente menores que el cambio lineal de cada componente, que puede anularse por cancelación, como en la primera componente del ejemplo. Al alejarse del punto dejan de ser despreciables. La linealización no afirma que sea lineal. Afirma que, con diferenciabilidad, su comportamiento cerca del punto se aproxima mediante una transformación lineal con un error de orden superior.
El capítulo 17 cuantificará los términos de segundo orden mediante la matriz hessiana y estudiará cómo la curvatura limita la región en que una aproximación lineal es adecuada.
Sensibilidad local de un modelo de dos variables
Consideremos un modelo abstracto, sin atribuirlo todavía a un fenómeno clínico,
en que es una entrada externa. La matriz jacobiana respecto del estado es
que en el estado tiene filas y . El elemento −0,75 indica una respuesta local restauradora de la primera tasa frente a . El elemento 1 indica que pequeñas variaciones de modifican la tasa de con signo positivo en ese punto. La segunda ecuación tiene un acoplamiento de 0,2 desde hacia la tasa de y una respuesta propia de −1 respecto de .
Si las variables tuvieran unidades distintas, no sería correcto comparar 1 y 0,2 como intensidades conmensurables. Tampoco podría concluirse, a partir del signo de un elemento aislado, que una perturbación de aumentará siempre , porque el estado evoluciona, la matriz cambia y las interacciones entre modos pueden modificar la trayectoria. En ese punto, la segunda tasa vale 0,15, de modo que no es un equilibrio para ningún valor de . Se usó para calcular sensibilidades. Clasificar la estabilidad exige evaluar la matriz en un equilibrio. Confundir ambos usos llevaría a tomar una matriz local por una descripción de toda una trayectoria.
Gradiente, jacobiano y causalidad en aplicaciones empíricas
En optimización, el gradiente indica cómo modificar parámetros para reducir o aumentar una función objetivo. En los modelos dinámicos, la matriz jacobiana linealiza el campo. En el análisis de sensibilidad, las derivadas cuantifican respuestas locales del modelo. Estas operaciones comparten un formalismo y responden a preguntas diferentes.
En una aplicación clínica podría definirse una función que estime un resultado a partir de variables observadas. Su gradiente indicaría cómo cambia la predicción local del modelo, sin demostrar cuánto cambiaría el resultado real si un clínico interviniera sobre cada variable. Esa segunda pregunta es causal y requiere definir intervenciones, controlar la confusión y especificar qué relaciones estructurales permanecen invariantes bajo la intervención.
De manera análoga, la matriz jacobiana de un modelo neuronal o poblacional se interpreta dentro de las ecuaciones que lo generan. Si esas ecuaciones son una representación fenomenológica ajustada a datos, sus elementos describen propiedades locales del modelo ajustado. Si derivan de mecanismos con fundamento físico, pueden tener una interpretación mecanicista más directa. El cálculo es idéntico, mientras que la fuerza de la inferencia científica cambia.
Consolidación
Una derivada parcial describe la variación local respecto de una coordenada mientras las demás se mantienen fijas dentro de la representación matemática. La existencia de las derivadas parciales no garantiza la diferenciabilidad, que exige una aproximación lineal conjunta con un error pequeño respecto de la magnitud de la perturbación.
Para una función escalar, el gradiente reúne las derivadas parciales y, con la métrica euclídea, determina las derivadas direccionales mediante un producto interno. Apunta en la dirección de máximo aumento por unidad de distancia medida con esa métrica, de modo que su interpretación geométrica depende de cómo se miden los desplazamientos.
Para una transformación vectorial, la matriz jacobiana es la de la aproximación lineal local. En los sistemas dinámicos, sus elementos describen las sensibilidades locales de las tasas de cambio respecto de las variables de estado. Los elementos fuera de la diagonal representan acoplamientos locales dentro del modelo, que no prueban causalidad entre las variables reales. Evaluada en un equilibrio, la matriz permite clasificarlo, mientras que en otros puntos solo describe sensibilidades.
La regla de la cadena compone matrices jacobianas y permite seguir las perturbaciones a través de transformaciones sucesivas. Las unidades de las derivadas y la elección de coordenadas deben mantenerse explícitas antes de comparar magnitudes. El cuadro 16.1 reúne los conceptos del capítulo.
Cuadro 16.1. Derivadas en varias variables.
| Concepto | Objeto | Forma matemática | Precaución principal |
|---|---|---|---|
| Derivada parcial | Función de varias variables | ∂f/∂xᵢ | Mantener fijas las otras coordenadas es primero una operación matemática |
| Diferencial | Variación lineal local | df_x(h) | Es más general que una lista de derivadas parciales |
| Gradiente | Función escalar | ∇f | Depende de la métrica que identifica diferencial y vector |
| Derivada direccional | Función escalar y dirección | D_u f = ∇fᵀu | Depende de la dirección y de su normalización |
| Matriz jacobiana | Transformación vectorial | J_F = [∂Fᵢ/∂xⱼ] | Es local y depende de las variables y coordenadas elegidas |
| Elasticidad | Sensibilidad relativa | (xⱼ/Fᵢ) ∂Fᵢ/∂xⱼ | Solo se define lejos de los ceros |
| Linealización | Transformación diferenciable | F(x + h) ≈ F(x) + J_F h | Omite términos de orden superior |
| Regla de la cadena | Composición G∘F | J_{G∘F} = J_G J_F | El orden de la multiplicación importa |
El capítulo 17 añadirá los términos de segundo orden para estudiar la curvatura, los extremos locales y el error de la linealización.
Ejercicios
Ejercicio 16.1. Considere en el punto . (a) Calcule el gradiente. (b) Calcule la derivada direccional en la dirección . (c) ¿Cuál es la tasa máxima de aumento y en qué dirección se alcanza? (d) Compare el cambio lineal predicho para con el cambio exacto.
Ejercicio 16.2. Para , con , (a) calcule las derivadas parciales en el origen y (b) el valor de sobre la recta . (c) Concluya si es continua y diferenciable en el origen.
Ejercicio 16.3. Para en y la métrica , (a) calcule . (b) Verifique que para y . (c) Calcule la dirección de máximo ascenso normalizada con esa métrica y la tasa máxima correspondiente.
Ejercicio 16.4. Para el sistema , , (a) encuentre los equilibrios. (b) Calcule la matriz jacobiana en cada uno y clasifíquelos con la traza y el determinante. (c) Explique por qué los valores propios de la matriz en no clasifican ningún equilibrio.
Ejercicio 16.5. (a) Calcule la elasticidad de . (b) Para , calcule la elasticidad en y en e interprétela. (c) ¿Cambia la elasticidad si la concentración se expresa en microgramos en lugar de miligramos? ¿Cambia la derivada ?
Ejercicio 16.6. Sean y . Calcule el gradiente de en de manera directa y mediante la regla de la cadena.
Ejercicio 16.7. Considere con y el cambio de variable . (a) Escriba el campo transformado . (b) Calcule en y en y compárelo con . (c) Compruebe la fórmula del texto.
Consultar las soluciones de los ejercicios
Soluciones de los ejercicios
Solución 16.1. (a) y , de modo que . (b) . (c) La tasa máxima es , en la dirección . (d) El cambio lineal es . El exacto es , de modo que el resto vale 0,021.
Solución 16.2. (a) Sobre los ejes la función es nula, de modo que ambas derivadas parciales en el origen valen cero. (b) Sobre , con , . (c) El límite en el origen depende de la dirección, porque vale 0 sobre el eje y 1/2 sobre . La función no es continua en el origen y, por tanto, no es diferenciable allí, aunque sus derivadas parciales existan.
Solución 16.3. (a) . (b) Con se obtiene . Con se obtiene . (c) La norma de con la métrica es . La dirección normalizada es cercana a y la tasa máxima por unidad de longitud medida con es 6,02, menor que la euclídea, 9,85.
Solución 16.4. (a) El origen y los puntos . (b) En el origen, la matriz es diagonal con elementos 1 y −2, una silla. En , la traza es −2 y el determinante 4, con discriminante , de modo que son focos estables con valores propios . (c) El punto no es un equilibrio, porque el campo vale . Los valores propios de la matriz en ese punto, , describen sensibilidades locales y no determinan la estabilidad de nada. La trayectoria que parte de converge al foco por razones que dependen de la dinámica completa.
Solución 16.5. (a) en todo punto. (b) La elasticidad es , es decir, 0,5 en y 0,1 en . Un aumento del 1 % de la concentración produce un aumento cercano al 0,5 % del efecto en el primer caso y al 0,1 % en el segundo, lo que refleja la saturación. (c) La elasticidad no cambia, porque es adimensional. La derivada sí cambia, porque la misma concentración se expresa con un número mil veces mayor y la derivada se divide por mil.
Solución 16.6. De manera directa, , con y en . Con la regla de la cadena, y . La matriz jacobiana de tiene filas y . El producto por esa matriz da .
Solución 16.7. (a) Con , . (b) . En vale −1, igual que . En vale −1,5, mientras que . (c) La fórmula da . En el equilibrio , el término corrector se anula porque .
Referencias
Apostol, T. M. (1969). Calculus, volume II: Multi-variable calculus and linear algebra with applications to differential equations and probability (2.ª ed.). Wiley.
Hirsch, M. W., Smale, S. y Devaney, R. L. (2013). Differential equations, dynamical systems, and an introduction to chaos (3.ª ed.). Academic Press.
Hubbard, J. H. y Hubbard, B. B. (2015). Vector calculus, linear algebra, and differential forms: A unified approach (5.ª ed.). Matrix Editions.
Marsden, J. E. y Tromba, A. J. (2012). Vector calculus (6.ª ed.). W. H. Freeman.
Spivak, M. (1965). Calculus on manifolds. W. A. Benjamin.