Programas que terminan y simulaciones verificadas
Los capítulos 21 a 28 construyeron una cadena de herramientas suficiente para ejecutar modelos dinámicos con cierto rigor. Incluyen la representación explícita del estado y las funciones reutilizables, la visualización, la integración numérica con control de tolerancias y el tratamiento de la rigidez, además de la aritmética de precisión finita, los barridos de parámetros y la detección de eventos. Con esas herramientas es relativamente fácil producir trayectorias convincentes. El problema científico empieza justamente allí, porque una trayectoria calculada puede parecer razonable y resultar, sin embargo, de una implementación equivocada.
Hay que distinguir si el programa ejecuta las operaciones especificadas y si esas operaciones resuelven, con una precisión aceptable, las ecuaciones que se quería resolver. Ambas cuestiones pertenecen a la verificación. Otra cuestión es si esas ecuaciones describen adecuadamente el fenómeno real para el uso que se les quiere dar, lo que corresponde a la validación y requiere evidencia empírica externa al programa. Oberkampf y Roy (2010) formalizan esta distinción en la computación científica. La verificación examina la corrección de la solución respecto del modelo matemático y de su implementación, mientras que la validación examina la relación del modelo con la realidad para una finalidad determinada.
La separación tiene importancia filosófica. Un código puede implementar con precisión impecable una ecuación científicamente inadecuada. También puede ocurrir que una ecuación pertinente se resuelva con un programa que contiene un error. Los dos problemas requieren evidencias diferentes. Ninguna prueba única permite declarar «correcta» una simulación en sentido absoluto.
Ejecutar el programa varias veces y observar que produce el mismo resultado tampoco verifica nada. Eso muestra reproducibilidad computacional en las mismas condiciones. Un error determinista puede reproducirse perfectamente.
Este capítulo desarrolla una estrategia de verificación basada en soluciones conocidas, invariantes, casos límite y estudios de convergencia. Añade además pruebas unitarias y de propiedades y el método de soluciones manufacturadas. El hilo conductor es una implementación deliberadamente defectuosa. La finalidad es comprender qué clase de error detecta cada prueba y qué clase de error deja intacto, de modo que la verificación no se reduzca a una lista ritual de controles.
Verificación de código y verificación de solución
Dentro de la literatura de verificación y validación hay que distinguir dos problemas relacionados (Roache, 1998). La verificación de código pregunta si la implementación reproduce correctamente el algoritmo matemático previsto. Busca errores de programación, como signos equivocados, índices desplazados, actualizaciones en un orden incorrecto, condiciones de frontera mal aplicadas o fórmulas de integración defectuosas.
La verificación de solución pregunta si una ejecución concreta aproxima la solución de las ecuaciones con precisión suficiente. Incluso un código perfectamente implementado puede producir resultados inadecuados si el paso temporal, la malla espacial o la tolerancia no tienen la resolución adecuada. Lo mismo ocurre si la aritmética de precisión finita domina el cálculo (Higham, 2002).
La diferencia puede expresarse formalmente. Supongamos que el modelo matemático es
y que un algoritmo numérico produce una aproximación , donde es un parámetro de resolución, como el paso temporal. Las dos fuentes de discrepancia son conceptualmente distintas. Una implementación defectuosa puede estar aproximando otra regla, . Una implementación correcta, en cambio, puede resolver con un error de discretización todavía grande, .
Reducir ayuda con el segundo problema si el método es convergente, pero no repara necesariamente el primero. Un programa que implementa la ecuación equivocada puede converger con toda regularidad hacia la solución equivocada. Por eso una estrategia de verificación robusta combina pruebas de la estructura del código con pruebas cuantitativas de la solución.
Un oscilador con solución exacta e invariante
Usaremos el oscilador armónico, porque tiene varias propiedades independientes que sirven para verificar un integrador. En unidades adimensionales,
y la solución exacta es , . La trayectoria en el espacio de estados es una circunferencia y el período exacto es . El sistema conserva además la energía
que vale para todo con esta condición inicial.
Esto da varias pruebas distintas. La comparación punto a punto con la solución analítica examina el error de fase y de amplitud. El retorno después de un período condensa esa información en un estado concreto, mientras que el invariante evalúa una propiedad estructural de la dinámica. Un método puede reproducir bien una de ellas y fallar en otra.
Disponer de una solución conocida es especialmente útil, porque separa la evaluación del algoritmo de la incertidumbre empírica. No hacen falta datos experimentales para saber cuál debe ser la respuesta del modelo matemático.
Una implementación correcta y otra casi correcta
Consideremos el método clásico de Runge-Kutta de cuarto orden. Para una ecuación vectorial , un paso correcto es
Introduzcamos ahora un defecto pequeño. En la cuarta etapa usaremos por error donde corresponde ,
El programa resultante se ejecuta sin excepciones ni valores NaN y genera trayectorias visualmente suaves. Con pasos pequeños puede parecer incluso muy preciso, aunque ya no implementa el esquema RK4 clásico. El código siguiente resume ambas versiones.
import numpy as np


def f(t, z):
    x, v = z
    return np.array([v, -x])


def rk4_step(z, t, h):
    k1 = f(t, z)
    k2 = f(t + h/2, z + h*k1/2)
    k3 = f(t + h/2, z + h*k2/2)
    k4 = f(t + h, z + h*k3)
    return z + h*(k1 + 2*k2 + 2*k3 + k4)/6


def rk4_defectuoso(z, t, h):
    k1 = f(t, z)
    k2 = f(t + h/2, z + h*k1/2)
    k3 = f(t + h/2, z + h*k2/2)
    k4 = f(t + h, z + h*k2)  # error deliberado
    return z + h*(k1 + 2*k2 + 2*k3 + k4)/6
Una prueba superficial podría no descubrir el defecto. Hacen falta pruebas que exploten propiedades conocidas del algoritmo y del modelo.
Estudio de convergencia y orden observado
Bajo las condiciones apropiadas, un método de orden tiene un error global que escala aproximadamente como cuando es suficientemente pequeño. Si el paso se divide por dos, , de modo que el orden observado puede estimarse como
Integramos un período completo, , cuya solución exacta al final es de nuevo . El cuadro 29.1 y la figura 29.1 muestran el error final de las dos implementaciones. La versión correcta presenta una pendiente cercana a cuatro en escala log-log. La implementación defectuosa también converge, aunque con un orden cercano a tres. El defecto modifica la estructura asintótica de la convergencia sin impedirla.
Cuadro 29.1. Error al cabo de un período del oscilador y orden observado para el RK4 correcto y para la versión defectuosa. El orden observado compara cada fila con la anterior.
| Puntos por período | Paso | Error del RK4 correcto | Error de la versión defectuosa | Orden observado del correcto | Orden observado del defectuoso |
|---|---|---|---|---|---|
| 20 | 0,314159 | ||||
| 40 | 0,157080 | 3,999 | 2,994 | ||
| 80 | 0,078540 | 4,000 | 2,999 | ||
| 160 | 0,039270 | 4,000 | 3,000 | ||
| 320 | 0,019635 | 4,000 | 3,000 |
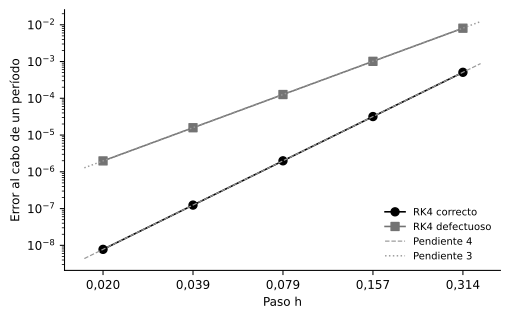
El orden observado tiene una explicación exacta. La versión defectuosa cumple todas las condiciones de orden de Runge-Kutta hasta el orden tres, pero incumple una de las de cuarto orden, , porque en ella esa suma vale cero (Hairer et al., 1993). Aplicada a la ecuación de prueba , su función de estabilidad es , con , a la que le falta el término de RK4.
El ejemplo muestra que obtener resultados visualmente razonables no verifica el algoritmo. El orden de convergencia da una prueba cuantitativa vinculada con la teoría del método. También muestra por qué hay que saber de antemano qué comportamiento se espera. Si se implementara un algoritmo nuevo cuyo orden teórico se desconoce, el estudio de convergencia seguiría siendo útil, aunque se perdería esa referencia independiente.
Invariantes como pruebas estructurales
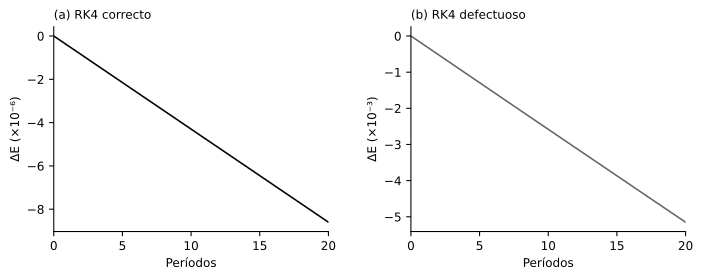
Para el oscilador exacto, es constante, de modo que puede evaluarse la deriva . La figura 29.2 compara esa deriva en las dos implementaciones durante veinte períodos con . En el RK4 correcto la energía disminuye , mientras que en la versión defectuosa disminuye , unas seiscientas veces más. Esta prueba usa una propiedad distinta de la que empleó el estudio de orden. La diferencia se explica con las funciones de estabilidad. En el eje imaginario, para RK4 y para la versión defectuosa, de modo que cada paso de esta última disipa energía con un término de cuarto orden en .
Conservar un invariante, sin embargo, no demuestra que la trayectoria sea correcta. Existen integradores diseñados para preservar determinadas cantidades que pueden tener errores de fase importantes. A la inversa, un integrador no simpléctico puede aproximar muy bien la trayectoria durante un intervalo finito y mostrar una deriva pequeña pero no nula del invariante.
En general, una propiedad conservada es una condición necesaria para ciertas implementaciones o regímenes de error, aunque rara vez basta para establecer la corrección completa.
En otros modelos los invariantes pueden ser balances de masa, sumas de probabilidades, cargas eléctricas, poblaciones totales o restricciones algebraicas. Si una simulación viola sistemáticamente una conservación exacta del modelo, el resultado exige explicación. Puede deberse a un error de implementación o de discretización, o a un método que no preserva la estructura. La prueba, considerada aisladamente, no identifica cuál de esas causas es la responsable.
Casos límite con respuesta simplificada
Una de las técnicas más eficientes de verificación consiste en elegir parámetros o condiciones iniciales que reduzcan el modelo a un caso de respuesta conocida. En el oscilador, la condición inicial tiene como solución exacta el estado cero. La prueba es necesaria pero débil, porque muchos errores respetarían trivialmente ese estado.
Otro caso consiste en introducir una frecuencia , con y . Si , entonces y la solución es , . Esta reducción prueba una rama distinta del comportamiento. Un programa puede aprobar el caso y fallar cuando debe transportar una velocidad constante. Como esa solución es un polinomio de primer grado en , RK4 debe reproducirla exactamente salvo por el redondeo, lo que da un criterio de aceptación muy estricto.
En el modelo de dos compartimentos de los capítulos 21 y 22, anular ambas fracciones de intercambio exige que el estado permanezca constante. Igualar las fracciones y partir de cantidades iguales exige mantener la simetría. En un modelo probabilístico, las probabilidades deben permanecer no negativas y sumar uno si esas restricciones forman parte de la especificación.
Los casos límite son potentes porque reducen la dependencia de herramientas externas, ya que el resultado esperado no requiere otro simulador. Aun así, hay que elegir varios casos que activen mecanismos distintos del código, porque un único caso trivial puede dar una falsa sensación de seguridad.
Pruebas unitarias, de regresión y de propiedades
El software científico puede aprovechar técnicas habituales de la ingeniería de software, siempre que se entienda qué verifica cada una. Una prueba unitaria evalúa un componente aislado. Por ejemplo, puede comprobarse que la función que calcula la energía da el valor correcto en un caso conocido.
import numpy as np


def energia(z):
    return 0.5 * float(z @ z)


z = np.array([1.0, 0.0])
assert np.isclose(energia(z), 0.5)
La prueba verifica esa operación en el caso elegido, sin verificar el integrador completo.
Una prueba de regresión almacena un resultado previamente aceptado y comprueba que los cambios futuros del código no lo alteren inesperadamente. Es útil para detectar modificaciones accidentales, aunque tiene una limitación evidente. Si el resultado de referencia era incorrecto, la regresión protege el error.
Las pruebas de propiedades comprueban relaciones que deben cumplirse sobre un conjunto amplio de entradas. En un sistema lineal, por ejemplo, puede probarse numéricamente que escalar la condición inicial escala la solución. Para una cantidad conservada pueden generarse varias condiciones iniciales y verificarse el balance. Estas pruebas son especialmente útiles cuando no se dispone de una solución cerrada para cada caso.
En sistemas complejos hay que incluir además pruebas de forma y de dominio, que comprueban las dimensiones de los arreglos, la finitud numérica, la no negatividad cuando es una propiedad del modelo, los rangos admisibles y la correspondencia entre unidades. No reemplazan las pruebas matemáticas, pero detectan errores que de otro modo se propagan en silencio.
Las simulaciones estocásticas agregan una dificultad. Fijar una semilla y comprobar que una trayectoria se reproduce permite detectar cambios de implementación, pero no verifica la distribución generada. Dos algoritmos pueden producir exactamente la misma secuencia con una semilla y seguir implementando una probabilidad de transición equivocada. La verificación debe incluir propiedades distribucionales, como medias o varianzas conocidas en casos simples, frecuencias de transición, conservación de la probabilidad y comparación con distribuciones analíticas cuando existan. Las pruebas deben repetirse, además, con varias semillas para evitar que un caso particular oculte un defecto.
La aleatoriedad cambia, por tanto, la forma del criterio de prueba, que suele llamarse oráculo. Lo que se espera es una relación probabilística que debe cumplirse dentro de un margen compatible con el error de Monte Carlo. Si una prueba falla ocasionalmente por fluctuación muestral, resulta inestable como prueba automatizada. Si la tolerancia es excesiva, puede dejar pasar un error real. Diseñar una prueba estocástica exige especificar el tamaño de muestra, el estadístico, la tolerancia y una potencia suficiente para detectar la desviación que importa. El ejercicio 29.5 muestra que una banda de cuatro desviaciones estándar con diez mil intentos casi nunca detecta un error de un punto porcentual en una probabilidad de 0,2.
Soluciones manufacturadas
Con frecuencia el modelo que se quiere resolver carece de solución analítica conocida. El método de soluciones manufacturadas invierte el problema (Roache, 1998; Salari y Knupp, 2000). Se elige una función suficientemente suave y se calcula después qué término de forzamiento haría que esa función fuera la solución exacta de una ecuación modificada. Consideremos
y elijamos artificialmente . Como , para que sea solución hay que definir
Ahora la respuesta se conoce exactamente, de modo que puede ejecutarse el código con ese forzamiento y comprobarse su convergencia hacia .
El valor de la técnica es metodológico. Permite ejercitar los términos no lineales y la dependencia temporal del código, que una solución trivial quizá no alcance. La solución manufacturada no pretende describir un fenómeno físico real. Es una herramienta de verificación, sin valor como validación.
Si el programa reproduce perfectamente una solución manufacturada, se obtiene evidencia de que ciertos términos y operaciones están bien implementados. Eso no demuestra que el modelo sin forzamiento artificial describa un sistema biológico, clínico o social.
La comprobación puede hacerse cuantitativa. Con y hasta , el valor exacto es . Al integrar la ecuación forzada con RK4 y pasos de , , y , los errores absolutos son de unos , , y . Los cocientes sucesivos valen , y y se acercan a 16, el valor que corresponde al cuarto orden cuando el paso entra en el régimen asintótico.
La utilidad de esta estrategia depende de la independencia entre la solución manufacturada y el código evaluado. Si el mismo fragmento que define la ecuación genera también el valor de referencia, con las mismas operaciones y los mismos errores, la prueba pierde fuerza. En una auditoría cuidadosa, el forzamiento se deriva por una ruta distinta y, cuando es razonable, se comprueba simbólicamente o con una segunda implementación (Knupp y Salari, 2002).
Verificación independiente y riesgo de errores compartidos
Comparar dos programas puede parecer una prueba fuerte, pero solo lo es si sus fuentes de error son suficientemente independientes. Dos códigos derivados de la misma fórmula equivocada pueden coincidir. La concordancia informa menos cuando un programa se tradujo línea por línea desde el otro. Dos programas que usan la misma biblioteca numérica comparten, además, parte de la implementación.
La independencia también importa en las soluciones analíticas. Un resultado simbólico obtenido con el mismo fragmento de código que después se evalúa numéricamente no es una referencia del todo independiente. Siempre que sea posible hay que variar el método de comprobación, mediante derivaciones manuales, identidades matemáticas, implementaciones alternativas, soluciones límite o bibliotecas externas bien probadas.
La idea conecta con un principio general de la inferencia científica. Las evidencias múltiples informan más cuando no dependen del mismo supuesto ni del mismo mecanismo de error.
Qué significa reparar la implementación defectuosa
Volvamos al RK4 modificado. El estudio de convergencia revela un orden cercano a tres, cuando el algoritmo pretendido debe mostrar orden cuatro. La discrepancia dirige la inspección hacia las etapas del método, donde aparece en el lugar que corresponde a .
Después de corregir esa línea hay que repetir las pruebas, porque no basta con que el código «se vea bien». La corrección se acepta porque restaura el orden cuatro y reduce la deriva energética con el mismo paso.
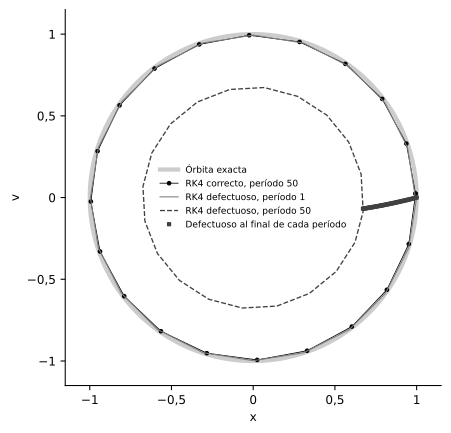
La figura 29.3 muestra la diferencia en el espacio de estados después de cincuenta períodos con veinte pasos por período. Ambos cálculos parten del mismo punto, pero la implementación defectuosa se aleja gradualmente de la órbita esperada. Al final del período 50, su radio es de , mientras que el del RK4 correcto es de .
En un proyecto real, estas comprobaciones deben convertirse en pruebas automatizadas. Así, si una modificación posterior reduce otra vez el orden observado o rompe un invariante, el sistema de pruebas puede detectarlo antes de que nuevos resultados se interpreten científicamente.
Verificación y validación
Supongamos ahora que el código implementa impecablemente el sistema , y que aprueba todas las pruebas, desde la convergencia de cuarto orden hasta la energía y los casos límite. Ese resultado no permite concluir que el modelo describa una oscilación neuronal o una dinámica afectiva.
La validación requiere comparar las consecuencias del modelo con observaciones pertinentes al fenómeno y al uso previsto (Oberkampf y Roy, 2010; Sargent, 2013). Hay que especificar qué magnitudes se observan y con qué incertidumbre, en qué población o sistema y bajo qué condiciones, además de la tolerancia de discrepancia aceptada. Una validación adecuada para predecir una variable agregada puede ser insuficiente para decidir sobre trayectorias individuales.
La distinción tiene una consecuencia importante para los modelos clínicos. Una simulación puede estar perfectamente verificada y seguir siendo una representación especulativa de un trastorno, porque la calidad numérica no compensa la ausencia de evidencia empírica. Del mismo modo, un modelo que reproduce ciertos datos puede hacerlo por razones equivocadas si su implementación o su identificación son defectuosas.
La cadena inferencial completa conserva, por eso, varias preguntas separadas. Si el modelo matemático está bien especificado y el código lo implementa, queda por saber si la solución numérica es suficientemente precisa. Esas cuestiones pertenecen sobre todo a la verificación y al análisis numérico. Preguntar si el modelo reproduce observaciones pertinentes y si la evidencia justifica el uso previsto introduce, en cambio, la validación y la decisión científica.
Matriz mínima de verificación para una simulación dinámica
Una auditoría eficiente puede organizarse como una matriz de pruebas (cuadro 29.2). No todas las pruebas son posibles en todos los modelos, pero la estructura ayuda a evitar que toda la confianza dependa de un único criterio.
Cuadro 29.2. Matriz mínima de verificación para una simulación dinámica.
| Pregunta | Prueba posible | Qué puede detectar | Límite de la prueba |
|---|---|---|---|
| ¿Se implementó la fórmula prevista? | Pruebas unitarias, inspección, solución conocida | Errores locales de código | Pertinencia del modelo |
| ¿Se converge con el orden esperado? | Refinamiento del paso o de la malla | Errores de discretización o de implementación | Validez empírica |
| ¿Se respetan los invariantes? | Balances, energía, suma de probabilidades | Violaciones estructurales | Trayectoria exacta |
| ¿Funcionan los casos simples? | Parámetros nulos, simetrías, límites | Ramas defectuosas | Funcionamiento general |
| ¿El resultado es reproducible? | Entorno fijado, semillas, versiones | Dependencia accidental del entorno | Corrección científica |
| ¿La solución es suficientemente precisa? | Estimación del error y refinamiento | Resolución insuficiente | Adecuación del modelo al mundo |
| ¿El modelo describe el fenómeno? | Comparación con datos externos | Discrepancias empíricas | Unicidad del mecanismo |
El cuadro muestra por qué la verificación no debe reducirse a una casilla binaria. Cada prueba aporta evidencia sobre una propiedad definida. La confianza surge de la convergencia de pruebas independientes y de una documentación suficiente para reconstruirlas.
Consolidación
Que un programa termine sin errores de ejecución no significa que implemente correctamente el modelo. La verificación de código examina la implementación, mientras que la verificación de solución examina la precisión de una ejecución concreta.
Una solución analítica conocida es una referencia especialmente fuerte, pero no siempre está disponible. Cuando falta, pueden combinarse invariantes, casos límite, refinamiento y soluciones manufacturadas. Un estudio de convergencia hace algo más que comprobar que el error disminuye, porque el orden observado revela si el algoritmo conserva la estructura teórica esperada. En el ejemplo, el orden tres delató una sola condición de orden incumplida.
Un invariante es una prueba estructural poderosa, aunque preservar una cantidad no garantiza que toda la trayectoria sea correcta. Los resultados concordantes informan más cuando provienen de rutas suficientemente independientes, porque dos programas con el mismo error conceptual pueden coincidir perfectamente. La verificación y la validación, por último, no son intercambiables. Se puede verificar un código sin haber validado el modelo y obtener un acuerdo aparente con los datos sin haber demostrado que la implementación es correcta.
El capítulo 30 cierra este bloque con una simulación completa, desde el balance inicial hasta una conclusión numérica auditada, en la que se integran la especificación, la implementación, el refinamiento, la visualización y la comunicación de la incertidumbre.
Ejercicios
Ejercicio 29.1. (a) Aplique la versión defectuosa a y muestre que su función de estabilidad es , con . (b) Calcule y compárelo con para RK4. (c) Con veinte pasos por período, calcule la energía de cada versión al cabo de un período del oscilador.
Ejercicio 29.2. Con la tabla de Butcher de RK4, calcule , y para la versión correcta y para la defectuosa, que tiene y . ¿Qué condición de orden falla?
Ejercicio 29.3. (a) Calcule el orden observado de la versión defectuosa con los errores del cuadro 29.1 para 160 y 320 puntos por período. (b) Proponga una prueba automatizada que acepte la implementación solo si el orden observado está cerca de cuatro. (c) ¿Por qué el orden debe evaluarse con los pasos más pequeños del cuadro?
Ejercicio 29.4. (a) Construya el forzamiento que hace de una solución exacta de . (b) Calcule los órdenes observados que corresponden a los errores de la solución manufacturada del capítulo. (c) ¿Por qué una solución manufacturada no aporta evidencia sobre la validez del modelo?
Ejercicio 29.5. Un simulador de una cadena de Markov con dos estados debe producir una transición de A a B con probabilidad por intento. (a) Con intentos, calcule la media y la desviación estándar del número de transiciones, junto con una banda de aceptación de cuatro desviaciones estándar a cada lado. (b) ¿Qué probabilidad tiene esa banda de detectar un error que haga ? (c) ¿Cuántos intentos harían falta para detectarlo con una probabilidad cercana al 90 %?
Ejercicio 29.6. Diseñe una matriz de verificación para el modelo de extracción del capítulo 28, . Incluya al menos una solución conocida, un caso límite, una prueba de propiedades y una comprobación del detector de eventos.
Consultar las soluciones de los ejercicios
Soluciones de los ejercicios
Solución 29.1. (a) Con , las etapas son , , y . Al sustituirlas en la actualización se obtiene , que es . (b) La parte real de es y la imaginaria, , de modo que . Para RK4 el resultado es . (c) Con , la energía al cabo de un período es de con RK4 y de con la versión defectuosa.
Solución 29.2. Las dos primeras sumas valen y en ambas versiones. La suma se conserva porque , así que usar o no la altera. La suma triple vale en RK4. En la versión defectuosa el único término posible es , que vale cero porque . Falla, por tanto, la condición de cuarto orden .
Solución 29.3. (a) Se obtiene . (b) La prueba puede calcular el error con 160 y 320 puntos por período y exigir . El RK4 correcto da y la versión defectuosa, , así que solo la primera se acepta. (c) El orden es una propiedad asintótica y los pasos grandes pueden mostrar otras pendientes. Los pasos tampoco deben ser tan pequeños que el redondeo domine el error. Con 320 puntos por período el error, de , sigue muy por encima del nivel del redondeo.
Solución 29.4. (a) Como , hay que definir . (b) Los cocientes , y dan órdenes observados de , y , que se acercan a 4 al reducir el paso. (c) El forzamiento es artificial y solo sirve para conocer la respuesta exacta. La prueba evalúa si el código resuelve correctamente la ecuación, mientras que la validez del modelo depende de su relación con observaciones del fenómeno.
Solución 29.5. (a) La media es y la desviación estándar, , de modo que la banda es . La probabilidad de una falsa alarma es de unos . (b) Con la media esperada es 2100, dentro de la banda. La probabilidad de detección es de apenas un 7 %. (c) Con unos 45 000 intentos, la probabilidad de detección llega a alrededor del 90 %. La tolerancia y el tamaño de muestra deben elegirse juntos, según la desviación que se quiere detectar.
Solución 29.6. Una solución conocida es el tiempo exacto hasta cuando , que permite comprobar el detector de eventos al refinar las tolerancias. Un caso límite es , cuya solución logística exacta es . Otro caso límite es partir de , que debe mantenerse constante. Una prueba de propiedades puede comprobar que, para , dos condiciones iniciales ordenadas producen trayectorias que conservan su orden, porque en una ecuación escalar las trayectorias no se cruzan. También puede comprobar que ninguna trayectoria que parte por encima de produce un evento. El detector se verifica comparando el tiempo detectado con y exigiendo que la discrepancia disminuya al endurecer las tolerancias.
Referencias
Hairer, E., Nørsett, S. P. y Wanner, G. (1993). Solving ordinary differential equations I: Nonstiff problems (2.ª ed. rev.). Springer.
Higham, N. J. (2002). Accuracy and stability of numerical algorithms (2.ª ed.). Society for Industrial and Applied Mathematics. https://doi.org/10.1137/1.9780898718027
Knupp, P. y Salari, K. (2002). Verification of computer codes in computational science and engineering. Chapman & Hall/CRC.
Oberkampf, W. L. y Roy, C. J. (2010). Verification and validation in scientific computing. Cambridge University Press.
Roache, P. J. (1998). Verification and validation in computational science and engineering. Hermosa Publishers.
Salari, K. y Knupp, P. (2000). Code verification by the method of manufactured solutions (Informe SAND2000-1444). Sandia National Laboratories.
Sargent, R. G. (2013). Verification and validation of simulation models. Journal of Simulation, 7(1), 12–24. https://doi.org/10.1057/jos.2012.20