Del fenómeno a una representación calculable
En los capítulos anteriores usamos modelos sin detenernos en el proceso completo que permite construirlos. Representamos cuatro unidades binarias mediante estados y conexiones, empleamos ecuaciones sencillas para distinguir dinámica de no linealidad y usamos grafos para separar estructura de proceso. En cada caso seleccionamos ciertos rasgos del fenómeno y dejamos otros fuera. Toda representación útil hace esa selección.
Un modelo científico es una representación construida para responder una pregunta. Puede expresarse mediante ecuaciones, algoritmos, diagramas, redes, agentes computacionales o combinaciones de estas formas. Su utilidad depende de que represente con suficiente fidelidad las relaciones que importan para el propósito definido, aunque omita muchos detalles del sistema real. Dos modelos diferentes pueden ser adecuados para preguntas distintas sobre el mismo sistema.
Consideremos un servicio ambulatorio que recibe nuevas derivaciones y resuelve atenciones pendientes. Para estimar cómo cambia el número de personas en espera podrían bastar tres cantidades, la lista actual, las entradas semanales y las salidas semanales. Para explicar por qué algunas personas esperan mucho más que otras, esa representación sería probablemente insuficiente, porque habría que incorporar prioridades, heterogeneidad en los tiempos de atención, cancelaciones u otras reglas. Un modelo simple puede ser correcto para una pregunta y pobre para otra.
Esta relación entre pregunta y representación debe fijarse antes de calcular. De lo contrario, el computador puede producir resultados numéricamente precisos para una pregunta mal formulada. La precisión aritmética no corrige una representación conceptualmente inadecuada.
La construcción de un modelo suele recorrer varias etapas. Se delimitan primero el fenómeno y el objetivo. Luego se decide qué variables o agentes representarán el estado, qué parámetros permanecerán constantes durante el análisis y qué entradas externas se considerarán. Después se formulan las reglas de evolución y solo entonces tiene sentido elegir un método analítico o numérico para estudiar sus consecuencias.
Una simulación consiste en ejecutar esas reglas para producir estados sucesivos o trayectorias posibles. No todo modelamiento requiere simulación. Algunas ecuaciones admiten soluciones analíticas que expresan directamente cómo cambia el sistema. En otros casos resolverlas de forma exacta es imposible o poco práctico y la evolución se aproxima mediante procedimientos numéricos. Hay también modelos, como muchos de los basados en agentes, cuyo comportamiento se estudia sobre todo mediante ejecución computacional.
Una simulación calcula las consecuencias de una representación. Si el modelo presupone una relación, la simulación puede mostrar consecuencias no evidentes de ella, aunque no puede demostrar que esa relación exista en el sistema real. En ese sentido, simular difiere de observar.
Qué contiene un modelo y qué queda fuera
Un modelo dinámico tiene cuatro componentes mínimos, que son el estado, las reglas de evolución, los parámetros y las condiciones iniciales. Según la pregunta, se añaden entradas externas, ruido, restricciones y una regla que conecte el estado interno del modelo con lo que podemos observar.
Tomemos una cantidad que disminuye en proporción a su valor actual,
La variable es el estado representado y el parámetro determina la rapidez del decaimiento. La condición inicial establece desde dónde comienza la trayectoria y la ecuación especifica la regla de cambio. Nada en esta expresión indica todavía qué representa . Podría ser la concentración de un fármaco, una cantidad de material radiactivo o cualquier magnitud para la que la hipótesis de proporcionalidad sea defendible.
Esta separación importa porque una ecuación no adquiere significado empírico por su forma matemática. La misma estructura formal puede representar fenómenos muy distintos. Para afirmar que modela un fenómeno concreto hay que justificar la correspondencia entre variables, parámetros y observaciones.
También hay que distinguir los supuestos estructurales de los valores numéricos. Suponer que la tasa de disminución es proporcional al estado es una decisión estructural. Elegir por unidad de tiempo es una decisión paramétrica. Podemos ajustar con datos y conservar, aun así, una estructura equivocada, porque un buen ajuste de parámetros no compensa un mecanismo mal especificado.
Los límites del sistema también forman parte del modelo. Si representamos una lista de espera, debemos decidir qué cuenta como entrada y qué como salida. Hay que saber si una persona que rechaza una hora sigue en espera, si una derivación incompleta ingresa al sistema y si una reconsulta cuenta como entrada nueva. Estas decisiones modifican los balances. En un modelo clínico, los problemas de definición pueden pesar tanto como los métodos numéricos que se usen después.
Antes de interpretar una simulación conviene poder responder cinco preguntas. Hay que saber qué entidades representa el modelo, qué variables describen su estado, qué reglas producen los cambios, qué información queda fuera y qué observación permitiría compararlo con el sistema real. Si alguna de estas respuestas es ambigua, la interpretación posterior también lo será.
Solución analítica y aproximación numérica
La ecuación de decaimiento admite una solución analítica,
Una solución analítica expresa, dentro del modelo, el valor exacto de en cualquier instante. Con y , después de una unidad de tiempo se obtiene . Después de cinco unidades, .
Muchos sistemas relevantes carecen de una expresión cerrada tan sencilla. Incluso cuando existe una solución exacta, puede ser difícil de obtener o de usar en modelos grandes. En esos casos se recurre a métodos numéricos.
El principio básico consiste en reemplazar la evolución continua por una secuencia de pasos finitos. El método de Euler, uno de los más sencillos, aproxima el valor siguiente con la pendiente conocida en el estado actual. Si la ecuación se escribe como , la regla es
donde es el tamaño del paso. En el decaimiento, y la regla queda .
Con , y se obtiene , mientras que la solución exacta en es 81,87. La diferencia no proviene de un error de programación. Aparece porque una trayectoria continua fue sustituida por una aproximación lineal durante un intervalo finito. Con se necesitan dos pasos para llegar a , que dan y , un valor más cercano al exacto. Con se obtiene 81,45. Los errores son 1,87; 0,87 y 0,42, de modo que se reducen aproximadamente a la mitad cada vez que el paso se divide por dos. Ese comportamiento define un método de primer orden.
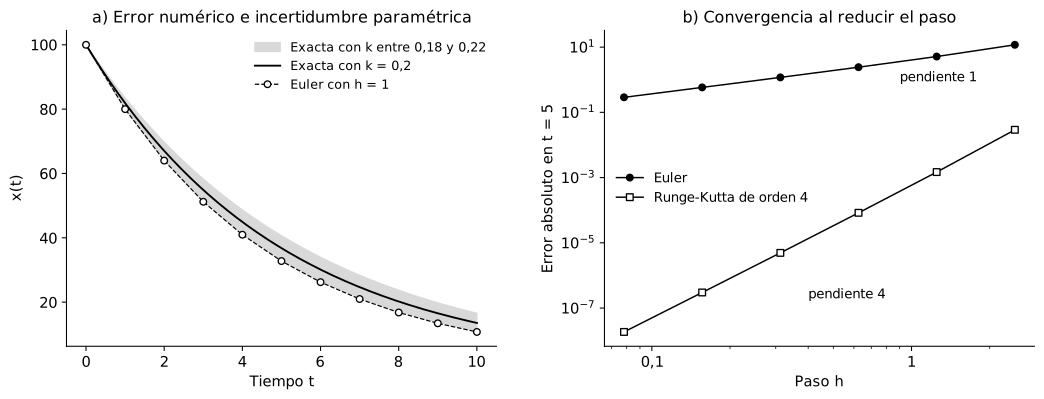
Para este problema regular, el error de Euler tiende a cero al reducir sobre un intervalo finito, en aritmética exacta. En un computador, disminuir el paso aumenta el número de operaciones y puede amplificar el papel del redondeo, de modo que no garantiza reducir indefinidamente el error total. Métodos más elaborados, como los de Runge-Kutta, alcanzan mayor precisión con pasos relativamente grandes. El método clásico de Runge-Kutta de cuarto orden reduce su error unas dieciséis veces cada vez que el paso se divide por dos. En el decaimiento, con , su error en es de 0,0006, frente a 4,02 con el método de Euler. La figura 6.1 muestra ambas tasas de convergencia. Hairer, Nørsett y Wanner (1993) desarrollan formalmente estas diferencias y las condiciones de convergencia de cada método.
La existencia de una respuesta numérica no autoriza a olvidar esta capa intermedia. Ante una trayectoria simulada hay que preguntarse si pertenece al modelo matemático o si es, en parte, un artefacto del método de integración, del tamaño del paso o de otras decisiones computacionales. El capítulo 2 mostró un caso extremo, en que el método de Euler con un paso grande producía oscilaciones ausentes en la ecuación original.
Error numérico, incertidumbre y sensibilidad
En modelamiento conviene separar al menos tres fuentes de discrepancia. El error numérico es la diferencia introducida por el procedimiento que aproxima la solución del modelo. La incertidumbre paramétrica consiste en no conocer con exactitud los valores de parámetros como . La incertidumbre estructural consiste en no saber si la forma de las relaciones representadas es adecuada.
Estas fuentes exigen estrategias diferentes. El error numérico se estudia repitiendo la simulación con pasos menores o con métodos alternativos y examinando la convergencia. La incertidumbre paramétrica se explora variando los parámetros dentro de intervalos plausibles. La incertidumbre estructural obliga a comparar modelos distintos o a confrontar predicciones específicas con observaciones externas.
Supongamos que en un proceso de decaimiento se estimó entre 0,18 y 0,22 y que interesa el estado en , partiendo de . La solución exacta da cerca de 40,66 con , 36,79 con y 33,29 con . Una incertidumbre de 0,02 en el parámetro produce en ese horizonte un intervalo de más de siete unidades en la salida. Si además calculamos la trayectoria central con el método de Euler, el error numérico en es de 4,02 con y de 0,37 con . Con el paso mayor, el error numérico tiene el mismo orden de magnitud que la incertidumbre paramétrica y puede confundirse con ella. El panel a de la figura 6.1 muestra esta superposición.
La relevancia de una incertidumbre depende del uso previsto. Si el modelo tolera un error de diez unidades, un intervalo de siete puede ser aceptable. Si hay que distinguir diferencias de una unidad, no lo es. Informar solo la trayectoria obtenida con ocultaría que otras trayectorias son compatibles con valores igualmente plausibles. Un análisis cuidadoso propaga, cuando es posible, la incertidumbre de las entradas hacia las cantidades que se interpretarán. Más adelante añadiremos incertidumbre estocástica y distribuciones completas. Por ahora basta reconocer que el resultado de una simulación suele ser una familia de trayectorias condicionada por supuestos.
La sensibilidad estudia cómo cambian los resultados cuando se modifican las entradas o los parámetros. En el decaimiento, aumentar acelera la disminución de . En los modelos no lineales la relación puede ser mucho menos intuitiva, porque pequeñas variaciones de un parámetro pueden desplazar el sistema entre regímenes cualitativamente diferentes. Más adelante distinguiremos el análisis de sensibilidad local del global.
Una sensibilidad elevada indica que, dentro del modelo especificado, el resultado depende mucho de un parámetro. Eso no demuestra que el parámetro sea causalmente importante en el sistema real. Para convertir esa dependencia matemática en una afirmación empírica hay que justificar que el parámetro representa una propiedad real y que la estructura del modelo es apropiada.
La distinción será importante en psiquiatría. Podemos construir un modelo en que una variable llamada «estrés» tenga gran sensibilidad sin que eso demuestre que el constructo está bien medido o que modificarlo mediante una intervención produzca el efecto que predice el modelo. El análisis de sensibilidad pertenece a la estructura formal y la interpretación clínica exige una capa adicional de evidencia.
Verificación y validación
La literatura de modelamiento distingue verificación y validación. Las definiciones varían entre disciplinas, aunque la diferencia central es estable. La verificación pregunta si la implementación resuelve correctamente el modelo especificado. La validación pregunta si el modelo representa el sistema real con suficiente adecuación para un propósito determinado. Oberkampf y Trucano (2002) desarrollaron esta distinción en simulación computacional. Sargent (2013) la sistematizó para modelos de simulación y separó además la validez conceptual, la verificación del modelo computacional y la validez operacional.
Las dos preguntas pueden formularse de manera sencilla. La verificación comprueba si construimos correctamente lo que dijimos que construiríamos. La validación examina si lo construido representa el fenómeno con suficiente adecuación para el uso previsto.
El modelo de decaimiento permite verificar el código comparándolo con la solución analítica. Si al reducir el resultado converge hacia con la tasa esperada para el método, como en la figura 6.1, tenemos evidencia de que la implementación se comporta como debe. Esa verificación no demuestra que el fenómeno real siga una ley exponencial. Cuando no existe solución analítica, la implementación puede verificarse con soluciones conocidas de casos particulares, con cantidades que el modelo debe conservar o con la convergencia al refinar el paso.
Validar el modelo exige compararlo con observaciones que no se usaron para construirlo. Ajustar parámetros con unos datos es una calibración. Incluso un ajuste excelente puede ser insuficiente si varios modelos reproducen las mismas observaciones conocidas y divergen solo en condiciones no estudiadas.
La validación tampoco es una propiedad absoluta. Un modelo puede ser adecuado para estimar el promedio semanal de una lista de espera sin serlo para predecir cuánto esperará una persona específica. La evaluación depende del propósito, de la precisión requerida y del intervalo de condiciones en que se pretende usar el modelo. Por eso conviene hablar de evidencia de adecuación para usos determinados y evitar la expresión «modelo validado» en sentido universal.
Una lista de espera como balance dinámico
Construyamos ahora un modelo sencillo y sigamos el proceso completo. Un servicio tiene inicialmente 40 personas en espera. Cada semana ingresan 12 derivaciones nuevas y se resuelven 10 casos. Por ahora supondremos que ambas cantidades son constantes y que nadie abandona la lista por otras razones.
Sea el número de personas en espera al comienzo de la semana . La regla de actualización es con entradas y salidas en cada intervalo semanal. En esta recurrencia, y son cantidades por intervalo, expresadas en casos. Si se usaran tasas por unidad de tiempo, habría que multiplicar su diferencia por la duración del intervalo antes de sumarla al estado. Un intervalo de una semana oculta numéricamente ese factor sin eliminar la distinción dimensional.
Partiendo de se obtiene , , y, en general, . Este caso no necesita realmente una simulación computacional, porque la solución es inmediata. Un computador daría el resultado correcto sin añadir comprensión.
Modifiquemos ahora la regla. Supongamos que la capacidad de resolución disminuye cuando la lista crece, porque parte del tiempo profesional se consume en reprogramaciones y consultas administrativas. Como modelo ilustrativo proponemos
En esta formulación semanal, 14 es la capacidad en personas por semana cuando la lista está vacía y 0,01 tiene unidades inversas al número de personas, de modo que el denominador es adimensional. La constante 14 se eligió para que el modelo coincida con el anterior en el punto de partida, porque . Con , la salida baja a 7. El estado del sistema modifica ahora una tasa que, a su vez, modifica el estado futuro. Esa es una retroalimentación.
Los valores fraccionarios de se interpretan como una aproximación agregada y continua. No describen una realización de conteos enteros ni son necesariamente su esperanza exacta, porque en general la media de una función no lineal difiere de la función aplicada a la media.
La ecuación de actualización queda
donde el máximo impide que la lista sea negativa. El procedimiento computacional es elemental. Se lee el estado actual, se calcula la salida, se actualiza el estado y se repite. El siguiente pseudocódigo lo implementa.
W = 40
repetir cada semana:
    entrada = 12
    salida = 14 / (1 + 0.01 * W)
    W = max(0, W + entrada - salida)
    registrar W
La salida se calcula con el estado de la semana y la actualización ocurre una vez por intervalo. El pseudocódigo usa punto decimal, según la convención de programación, mientras que los cálculos narrados usan coma decimal.
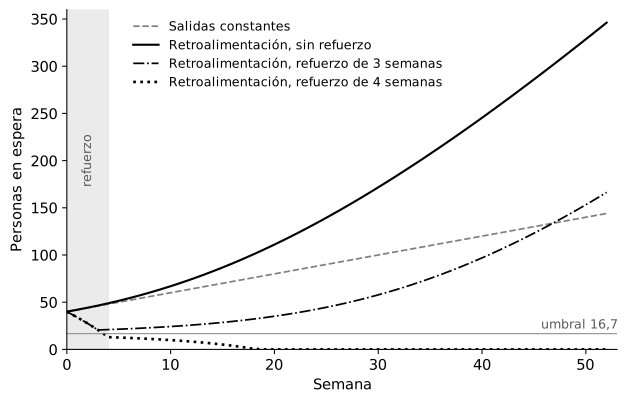
La simulación revela dos consecuencias que la formulación no muestra a simple vista. La primera es que la acumulación se acelera. El incremento semanal, que vale 2 cuando hay 40 personas en espera, sube a 5 con 100 personas y se acerca a 12 cuando la lista es muy grande. Al cabo de un año, el modelo con retroalimentación acumula unas 346 personas en espera, frente a 144 en el modelo lineal. La segunda es la existencia de un umbral. Las entradas y las salidas se igualan cuando , es decir, en . Por encima de ese valor la lista crece y por debajo se reduce, de modo que el equilibrio es inestable.
El umbral cambia la lectura de una intervención transitoria. Supongamos un refuerzo que resuelve 8 casos adicionales por semana. Si dura tres semanas, la lista baja a 20,6 personas, queda sobre el umbral y vuelve a crecer cuando el refuerzo termina. Si dura cuatro, baja a 13,0, queda bajo el umbral y se vacía por sí sola hacia la semana 19. La figura 6.2 muestra estas trayectorias. Una semana adicional de refuerzo produce resultados cualitativamente distintos, algo que el modelo lineal no puede representar.
Conviene detenerse antes de interpretar demasiado. La función se inventó para el ejemplo. La simulación no demuestra que la carga administrativa reduzca la productividad según esa ecuación ni que una lista real vaya a comportarse así. Hemos construido un mecanismo posible y calculado sus consecuencias. Estudiar un servicio real exigiría medir entradas y salidas, examinar si la capacidad varía con la carga, evaluar explicaciones alternativas y contrastar el modelo con datos. Esta separación entre exploración mecanicista y afirmación empírica es un hábito que mantendremos a lo largo de los cinco tomos.
Simulación y predicción
Una simulación puede usarse con fines diferentes. Puede explorar si un mecanismo es capaz de generar un patrón, comparar escenarios bajo supuestos alternativos, estimar cantidades futuras, ayudar a diseñar un experimento o examinar la robustez de una conclusión.
Estos usos no son equivalentes. Un modelo puede servir para comprender las consecuencias cualitativas de una estructura sin ser bastante preciso para pronosticar valores futuros. A la inversa, un modelo predictivo puede funcionar bien dentro de un intervalo de datos sin explicar satisfactoriamente el mecanismo.
En la lista de espera, el modelo lineal basta para mostrar que la lista aumenta si las entradas superan persistentemente a las salidas, una conclusión que es casi una identidad contable. Predecir el número exacto de personas dentro de seis meses exige, en cambio, conocer cómo variarán las entradas, la capacidad, los abandonos y otras condiciones.
En los sistemas complejos, las predicciones pueden estar limitadas por la incertidumbre de los parámetros, los cambios del entorno, el ruido y la sensibilidad dinámica. Estas limitaciones deben analizarse por separado. La palabra «impredecible» no sustituye una evaluación concreta de por qué falla una predicción.
Una simulación también puede producir escenarios condicionales. La afirmación «si las entradas se mantienen en 12 por semana y la salida sigue esta función, un refuerzo de cuatro semanas vacía la lista» es condicional y difiere de pronosticar que la lista se vaciará. La diferencia parece lingüística, aunque tiene consecuencias epistemológicas.
Cuando los modelos apoyan decisiones, los escenarios condicionales pueden ser muy útiles. Permiten identificar qué supuestos cambian una conclusión y qué variables conviene medir con mayor precisión. En el ejemplo, el umbral depende de la forma supuesta para , de modo que medir cómo varía la capacidad con la carga informaría más que refinar el pronóstico de las entradas.
Sistemas dinámicos y dinámica de sistemas
Conviene resolver ahora una ambigüedad terminológica. La teoría de los sistemas dinámicos, que estudiaremos formalmente en este tomo, es un campo matemático dedicado a la evolución de estados según reglas definidas. Incluye ecuaciones diferenciales, mapas iterados, estabilidad, bifurcaciones y caos.
La dinámica de sistemas designa, en cambio, una metodología de modelamiento que surgió del trabajo de Forrester (1961) y que Sterman (2000), entre otros, sistematizó. Esta tradición usa sobre todo acumulaciones, flujos, retroalimentaciones y retardos para estudiar sistemas organizacionales, económicos y sociales, así como problemas de política pública.
Los dos enfoques se superponen sin ser sinónimos. Todo modelo de dinámica de sistemas es un sistema dinámico en sentido matemático, aunque la teoría de los sistemas dinámicos es mucho más amplia. El sistema de Lorenz, el mapa logístico o un sistema hamiltoniano pertenecen a ella sin haberse construido con la metodología de acumulaciones y flujos, stocks and flows en inglés, propia de la dinámica de sistemas.
En español las dos expresiones pueden parecer intercambiables. En este libro usaremos «sistemas dinámicos» para el campo matemático general y «dinámica de sistemas» para la tradición metodológica de Forrester y Sterman.
La idea de acumulación y flujo será útil, sin embargo, mucho más allá de esa tradición. La lista de espera es una acumulación, las derivaciones son un flujo de entrada y las resoluciones un flujo de salida. La ecuación de balance expresa una estructura que aparece en demografía, farmacocinética, inventarios, epidemiología y muchas otras áreas.
Qué puede enseñarnos una simulación que no sabíamos antes
Si la simulación solo ejecuta reglas que nosotros mismos escribimos, podría parecer que nunca produce conocimiento nuevo. Esa conclusión sería demasiado fuerte. En modelos con pocas variables muchas consecuencias pueden anticiparse analíticamente. Cuando hay varias retroalimentaciones, no linealidades, retardos o poblaciones de agentes, las consecuencias conjuntas pueden ser difíciles de deducir. La simulación permite explorar la lógica del modelo y encontrar comportamientos que no eran evidentes al formularlo. El umbral de la lista de espera es un ejemplo modesto, porque la regla no lo menciona y aparece al examinar sus consecuencias.
Ese conocimiento es, en primer lugar, conocimiento sobre el modelo. Podemos descubrir que cierta combinación de reglas produce oscilaciones, que existe un umbral paramétrico o que dos mecanismos interactúan de manera inesperada. Después cabe preguntar si esas consecuencias aparecen también en el sistema empírico.
Hay que distinguir entre la ejecución computacional, el resultado del modelo y la posibilidad empírica. Una trayectoria numérica permite explorar una especificación, aunque no demuestra que el modelo exacto tenga una propiedad determinada ni que esta persista para otros parámetros. Una demostración matemática o un cálculo verificado pueden respaldar esa atribución al modelo. En la lista de espera, el umbral se obtuvo igualando entradas y salidas, lo que confirma analíticamente lo que la simulación sugería. Conectar después el resultado con el fenómeno real exige correspondencias observacionales y pruebas discriminantes, porque reproducir una transición observada no descarta que otro mecanismo también la produzca (Oberkampf y Trucano, 2002; Sargent, 2013).
Lo inverso también merece cautela. Que un modelo simple no reproduzca un patrón no demuestra que el mecanismo general sea imposible. El fracaso puede deberse a una simplificación concreta, a una escala de observación inadecuada o a una implementación deficiente. Los resultados negativos de una simulación informan cuando el espacio de modelos evaluado y las condiciones examinadas están bien especificados. La fuerza del argumento procede entonces de la estructura completa de la inferencia, que incluye la representación, el cálculo y la evidencia externa.
La filosofía de la simulación ha defendido esta posición intermedia. Winsberg (2010) sostiene que una simulación ocupa un lugar entre la observación y la deducción, porque incorpora decisiones de representación, aproximaciones numéricas y procedimientos computacionales. Su valor científico depende de controlar esas capas y de conectar los resultados con evidencia externa.
Por eso la verificación, la validación y el análisis de sensibilidad forman parte del argumento científico. Si un comportamiento desaparece al reducir el paso de integración, probablemente es una propiedad del algoritmo. Si aparece solo con un valor paramétrico mal conocido, la conclusión debe presentarse condicionada a esa incertidumbre. Si varios modelos rivales producen el mismo patrón, el patrón no permite decidir entre ellos.
La simulación es especialmente útil para formular preguntas discriminantes. Un buen resultado puede consistir en descubrir qué observación permitiría distinguir entre dos mecanismos, como la relación entre carga y capacidad en el ejemplo de la lista de espera.
Consolidación
El proceso de modelamiento que mantendremos a lo largo del libro encadena varias inferencias. Parte de una pregunta sobre un fenómeno y construye una representación que selecciona variables, relaciones y límites. Deriva o simula las consecuencias de esa representación, verifica que el cálculo corresponda al modelo especificado y confronta las consecuencias relevantes con observaciones para evaluar si el modelo es adecuado para el propósito propuesto.
Cada transición puede fallar de una manera distinta. Una pregunta mal delimitada produce un modelo irrelevante. Una representación equivocada puede ajustarse por azar a ciertos datos. Una implementación incorrecta genera resultados que el modelo matemático nunca produciría. Un modelo bien implementado puede no describir el sistema real. Un modelo útil para una tarea puede ser inadecuado para otra.
El modelo difiere del sistema real, porque es una representación orientada a una pregunta. La solución analítica y la simulación son dos maneras de estudiar sus consecuencias. Integrar ecuaciones diferenciales suele exigir aproximaciones numéricas, mientras que ejecutar una regla discreta con estados enteros puede ser exacto. También puede simularse un muestreo sin representar ninguna evolución física, de modo que la discretización, el redondeo y la variabilidad de muestreo deben distinguirse antes de atribuirlos a una simulación.
La verificación y la validación responden a preguntas diferentes. Se puede implementar perfectamente una mala representación o representar bien un fenómeno con un código defectuoso. Simular un mecanismo tampoco demuestra que el mecanismo exista en el mundo. La simulación muestra qué ocurre si aceptamos ciertas reglas y condiciones. Convertir ese resultado en conocimiento empírico requiere evidencia adicional. El cuadro 6.1 reúne estas distinciones.
Cuadro 6.1. Conceptos de modelamiento y lo que cada uno no implica.
| Concepto | Qué significa | Qué no implica |
|---|---|---|
| Modelo | Representación construida para una pregunta y un propósito | Una copia exhaustiva del sistema real |
| Simulación | Ejecución de reglas para obtener trayectorias o escenarios | Una observación adicional del mundo |
| Error numérico | Discrepancia introducida por la aproximación computacional | Incertidumbre sobre la estructura empírica del fenómeno |
| Incertidumbre paramétrica | Desconocimiento de los valores de los parámetros | Un defecto del método de cálculo |
| Sensibilidad | Dependencia de la salida respecto de entradas o parámetros dentro del modelo | Importancia causal demostrada en el sistema real |
| Verificación | Comprobación de que la implementación corresponde al modelo especificado | Validación empírica del modelo |
| Calibración | Ajuste de parámetros a datos observados | Capacidad de predecir datos nuevos |
| Validación | Evaluación de la adecuación del modelo para un propósito frente a evidencia externa | Una certificación universal y permanente |
| Escenario condicional | Consecuencia calculada bajo supuestos explícitos | Un pronóstico de lo que ocurrirá |
En el capítulo 7 estudiaremos una de las estructuras que con más frecuencia convierte relaciones locales simples en dinámicas difíciles de anticipar, la retroalimentación. Veremos que el signo, la intensidad y los retardos de los bucles pueden modificar radicalmente la evolución de un sistema. La lista de espera de este capítulo ya contenía un bucle de ese tipo. Los conceptos introducidos aquí permitirán separar el comportamiento matemático del modelo de la cuestión empírica de si el bucle propuesto representa el fenómeno estudiado.
Ejercicios
Ejercicio 6.1. La concentración de un fármaco eliminado según una cinética de primer orden sigue la ecuación . (a) Identifique el estado, el parámetro, la condición inicial y la regla de evolución. (b) Si la semivida es de 24 horas, calcule y la fracción de la concentración inicial que queda a las 72 horas. (c) Nombre tres aspectos del fenómeno que el modelo deja fuera y una pregunta para la que cada uno sería decisivo.
Ejercicio 6.2. Considere con . (a) Calcule con el método de Euler el valor en usando . (b) Con los errores obtenidos para igual a 1; 0,5 y 0,25, compruebe que el método es de primer orden. (c) Muestre que con la aproximación de Euler oscila con amplitud creciente aunque la solución exacta decae. Calcule los primeros valores con .
Ejercicio 6.3. Se quiere estimar en el modelo de decaimiento con entre 0,18 y 0,22. (a) Calcule el intervalo de valores exactos. (b) Para , el error de Euler en vale aproximadamente . ¿Qué paso garantiza que el error numérico sea menor que la décima parte del intervalo paramétrico? (c) ¿Por qué conviene controlar el error numérico antes de explorar la incertidumbre paramétrica?
Ejercicio 6.4. En el modelo de lista de espera con e , (a) calcule el umbral y muestre que es un equilibrio inestable. (b) Suponga que las entradas bajan a 10 por semana. Calcule el nuevo umbral y describa qué ocurre con una lista inicial de 40 personas. (c) ¿Qué datos de un servicio real permitirían evaluar si existe un umbral de este tipo?
Ejercicio 6.5. Clasifique cada actividad como verificación, calibración, validación o análisis de sensibilidad. (a) Comparar el código del decaimiento con la solución analítica. (b) Reducir el paso a la mitad y comprobar que el resultado cambia poco. (c) Ajustar los parámetros para que el modelo reproduzca las listas de espera del año pasado. (d) Comparar las predicciones del modelo ajustado con las listas de este año, que no se usaron en el ajuste. (e) Variar el coeficiente 0,01 entre 0,005 y 0,02 y registrar cómo cambia el umbral. (f) Comprobar que, sin salidas, el código suma exactamente 12 personas por semana.
Ejercicio 6.6. Un informe de gestión concluye que «la simulación demuestra que contratar un psiquiatra adicional hará desaparecer la lista de espera en seis meses». (a) Reescriba la afirmación como escenario condicional. (b) Enumere los supuestos de los que depende. (c) ¿Qué evidencia permitiría convertir el escenario en una predicción con fundamento?
Consultar las soluciones de los ejercicios
Soluciones de los ejercicios
Solución 6.1. (a) El estado es la concentración , el parámetro es la constante de eliminación , la condición inicial es y la regla de evolución es la ecuación diferencial. (b) La solución es . La semivida cumple , de modo que por hora. A las 72 horas han transcurrido tres semividas y queda , es decir, el 12,5 % de la concentración inicial. (c) El modelo omite la absorción y la distribución, decisivas para estimar la concentración máxima tras una dosis oral. También omite los cambios de la función renal o hepática que modifican , decisivos en una persona deshidratada o con insuficiencia renal. Tampoco representa las dosis repetidas ni la adherencia, decisivas para estimar la concentración en estado estacionario.
Solución 6.2. (a) Con se necesitan cuatro pasos y se obtiene . (b) Los errores son 1,87; 0,87 y 0,42. Sus cocientes sucesivos son 2,15 y 2,07, cercanos a 2, como corresponde a un método de primer orden. (c) La regla es . Si , el factor es menor que , de modo que el signo alterna y el valor absoluto crece en cada paso. Con el factor es y la secuencia es 100; −140; 196; −274,4. La oscilación es un artefacto del método, como la que el capítulo 2 mostró en la ecuación logística.
Solución 6.3. (a) Los valores exactos van de 33,29 a 40,66, un intervalo de 7,37. (b) Hace falta un error menor que 0,737, es decir, y . Con el error es 0,37. La constante proviene de desarrollar , de modo que el error relativo es cercano a y el absoluto a . (c) Si el error numérico es comparable al intervalo paramétrico, no puede saberse si las diferencias entre trayectorias provienen de los parámetros o de la discretización. Con un método ya convergido, la variación observada refleja la incertidumbre paramétrica.
Solución 6.4. (a) El umbral satisface , de modo que y . Si , la salida es menor que 12 y la lista crece, alejándose del umbral. Si , la salida supera a 12 y la lista disminuye, alejándose también. El equilibrio es inestable. (b) Con 10 entradas, el umbral satisface , es decir, . Una lista de 40 personas queda exactamente en equilibrio y el modelo determinista la mantiene constante. Cualquier perturbación pequeña, como una derivación adicional o una cancelación, la hace crecer o disminuir de manera sostenida. (c) Harían falta series semanales de entradas, resoluciones y tamaño de la lista, junto con el tiempo profesional dedicado a tareas administrativas. Habría que examinar si las resoluciones disminuyen con el tamaño de la lista una vez controlada la dotación. Los episodios de refuerzo transitorio pueden aprovecharse como experimentos naturales. También habría que descartar otras explicaciones de la caída de las resoluciones, como la rotación del personal o la estacionalidad.
Solución 6.5. (a) Verificación. (b) Verificación, mediante el estudio de la convergencia. (c) Calibración. (d) Validación, para el propósito de predecir listas anuales. (e) Análisis de sensibilidad. Como , el umbral pasa de 33,3 con a 8,3 con . (f) Verificación, mediante una prueba de conservación del balance.
Solución 6.6. (a) Si las entradas se mantienen en su nivel actual, si el nuevo psiquiatra añade la capacidad supuesta y si la relación entre carga y capacidad tiene la forma especificada, el modelo calcula que la lista se vacía en seis meses. (b) El escenario supone entradas constantes, una capacidad adicional que no se desvía hacia otras tareas, la forma y los parámetros de y la ausencia de abandonos o de estacionalidad. Supone además que la mejora del acceso no aumenta las derivaciones, un efecto conocido como demanda inducida. (c) Harían falta la verificación del código, la calibración con datos históricos y la validación con períodos no usados en el ajuste. También un análisis de sensibilidad de los parámetros críticos y, si existen, los resultados de refuerzos anteriores comparables. El seguimiento prospectivo tras la contratación permitiría contrastar el escenario con lo ocurrido.
Referencias
Forrester, J. W. (1961). Industrial dynamics. MIT Press.
Hairer, E., Nørsett, S. P. y Wanner, G. (1993). Solving ordinary differential equations I: Nonstiff problems (2.ª ed. rev.). Springer. https://doi.org/10.1007/978-3-540-78862-1
Oberkampf, W. L. y Trucano, T. G. (2002). Verification and validation in computational fluid dynamics. Progress in Aerospace Sciences, 38(3), 209–272. https://doi.org/10.1016/S0376-0421(02)00005-2
Sargent, R. G. (2013). Verification and validation of simulation models. Journal of Simulation, 7(1), 12–24. https://doi.org/10.1057/jos.2012.20
Sterman, J. D. (2000). Business dynamics: Systems thinking and modeling for a complex world. Irwin/McGraw-Hill.
Winsberg, E. (2010). Science in the age of computer simulation. University of Chicago Press.