Una red agregada puede conectar a todas las personas observadas y, al mismo tiempo, contener rutas que no pueden recorrerse en el orden en que ocurrieron los contactos. El archivo público de una unidad hospitalaria de Lyon permite calcular esa diferencia con observaciones reales. Al reunir todos sus contactos aparece una única componente de setenta y cinco personas. Al conservar los intervalos originales y fijar una regla temporal explícita, algunos pares dejan de ser alcanzables en una de las direcciones.
El caso utiliza el conjunto Hospital ward dynamic contact network de la colaboración SocioPatterns (2013), asociado al estudio de Vanhems et al. (2013a). Se analiza íntegramente el archivo oficial, sin crear observaciones ni seleccionar participantes según sus resultados. Las operaciones resuelven preguntas descriptivas sobre duración, mezcla entre categorías y caminos temporales. Los registros corresponden a detecciones instrumentales de proximidad; no contienen episodios de transmisión que permitan atribuir infecciones a esas rutas.
El diseño del análisis se conservó antes de ejecutar los cálculos derivados. Ya se conocían el artículo y los totales de validación del archivo, de modo que el trabajo no se presenta como una prueba confirmatoria ciega. Se fijaron los denominadores, la definición de episodio y la regla que impide atravesar dos contactos dentro de un mismo intervalo. También se estableció que cada persona actuaría por separado como origen al comienzo de una misma ventana analítica, con espera ilimitada.
Esta elección permite comparar cantidades bien definidas: qué pares tuvieron proximidad registrada, cuánto acumularon y qué pares ordenados admiten una secuencia temporal bajo la regla fijada. Los resultados de alcanzabilidad pertenecen a este reanálisis. El artículo original informa contactos y su distribución, pero no presenta las primeras llegadas que se calculan aquí. Mantener esa atribución separa la procedencia de los datos de las decisiones analíticas añadidas.
Procedencia y unidad de observación
La observación original se realizó en una unidad geriátrica de un hospital universitario de Lyon entre el 6 y el 10 de diciembre de 2010. Participaron cuarenta y seis miembros del personal y veintinueve pacientes. Las categorías publicadas distinguen personal médico, MED; personal paramédico, NUR, que incluye enfermería y auxiliares; personal administrativo, ADM; y pacientes, PAT. El archivo contiene, respectivamente, once, veintisiete, ocho y veintinueve identificadores en esas categorías (Vanhems et al., 2013a).
El estudio informa cincuenta miembros del personal y treinta y un pacientes durante el periodo: cuatro miembros del personal y dos pacientes no participaron; los visitantes quedaron fuera. Además, la sección analítica del artículo utiliza HCW para agrupar MED y NUR, mientras ADM permanece separado. En este reanálisis se conservan las cuatro etiquetas originales, evitando que una abreviatura reúna poblaciones diferentes según la tabla consultada.
El archivo se obtuvo directamente del sitio oficial y se conserva comprimido, sin modificar. La distribución de los datos utiliza la licencia Creative Commons Attribution-NonCommercial-ShareAlike 3.0 Unported. La procedencia del suplemento mantiene la atribución a SocioPatterns y a los autores del estudio, identifica las transformaciones efectuadas y conserva el enlace a la licencia. El artículo tiene una corrección de financiación, que se comprobó y no modifica los registros ni sus conteos (Vanhems et al., 2013b).
Cada fila pública contiene cinco campos: una marca temporal, dos identificadores y las categorías de sus portadores. Según la documentación oficial, una fila con marca t describe un contacto activo durante el intervalo [t−20,t], expresado en segundos. La relación es no dirigida: intercambiar las columnas de los identificadores no cambia el contacto. Si varios pares están activos en un intervalo, aparecen varias filas con la misma marca temporal (SocioPatterns, 2013).
El sistema de sensores intercambia paquetes de radio de baja potencia. Cattuto et al. (2010) describen cómo esa señal, junto con la colocación frontal del dispositivo, se utiliza como indicador de proximidad cara a cara. La presencia de al menos un intercambio en un intervalo establece su condición de contacto. Por tanto, un paquete, un intervalo positivo y un episodio formado por varios intervalos son unidades distintas. El archivo público utilizado aquí ya contiene la representación por intervalos, no los paquetes originales.
La detección depende de una operación instrumental. No registra una conversación ni demuestra contacto físico. La distinción entre compartir una localización amplia y mantener proximidad cercana también importa: Génois y Barrat (2018) muestran que la correspondencia entre esas mediciones depende de la resolución y del contexto. En este caso se analiza el archivo de proximidad publicado; no se reconstruye la localización continua de las personas a partir de sus encuentros.
Un intervalo positivo tampoco determina el instante preciso del intercambio dentro de esos veinte segundos. Dos filas con la misma marca podrían corresponder a acontecimientos con órdenes internos diferentes. Asignar una duración operacional a la detección permite comparar registros de manera uniforme, pero no recupera esa cronología más fina. La regla de un salto por intervalo responde a esta limitación de resolución. Su carácter restrictivo frente a otras reglas sobre el mismo archivo no la convierte en una cota general de infecciones reales, que exigiría conocer otro proceso y sus condiciones.
Los identificadores permiten seguir una misma etiqueta a lo largo del archivo y relacionarla con su categoría. No se intenta recuperar identidades externas. La consistencia interna se comprobó antes de analizar: ningún identificador cambia de categoría, no aparecen contactos de una persona consigo misma y no hay duplicados del mismo par en un mismo intervalo. También se confirmó que todas las marcas temporales pertenecen a la cuadrícula de veinte segundos.
La validación identifica las observaciones disponibles, pero no convierte la ausencia de una fila en una prueba general de ausencia de interacción. Puede faltar una persona, una detección o una modalidad de contacto que el dispositivo no observa. Las cantidades que siguen utilizan expresamente contactos registrados entre los identificadores participantes. Esa definición evita que un resultado sobre el archivo se extienda inadvertidamente a todas las personas y actividades de la unidad.
Del intervalo al episodio y al peso agregado
El archivo contiene 32424 filas de pares e intervalos. Al ordenar los identificadores de cada pareja, se identifican 1139 pares distintos. Un par puede aparecer muchas veces, tanto en intervalos consecutivos como después de largas separaciones. Cada fila aporta veinte segundos-pareja a la duración operacional, por lo que el total reconstruido es:
Esta suma equivale aproximadamente a 180,13 horas-pareja. Cuenta por separado los contactos simultáneos de pares diferentes. Si una persona mantiene contacto registrado con dos personas en un intervalo, contribuyen dos relaciones. El total no es tiempo único transcurrido en el hospital, ni tiempo individual sin solapamientos. La unidad debe acompañar a la cifra para evitar esas conversiones implícitas.
Para contar episodios se reúnen intervalos consecutivos del mismo par. Si sus marcas finales difieren exactamente en veinte segundos, pertenecen al mismo episodio. Un hueco mayor inicia otro. Esta regla reconstruye 14037 episodios, concordantes con el total del artículo original. Por tanto, las 32424 filas no representan otras tantas ocasiones independientes de encuentro; muchas prolongan un contacto ya abierto.
Un ejemplo visible al principio del archivo lo muestra. El par 1157–1159 aparece con marcas finales de 500 y 520 segundos. Los intervalos correspondientes son [480,500] y [500,520], que forman un episodio de cuarenta segundos. No se supone que el contacto duró exactamente cuarenta segundos en una escala más fina que la detección; esa es su duración según la resolución y la regla utilizadas. La separación entre medición y reconstrucción queda explícita.
La agregación de todo el periodo asigna a cada par un peso igual a la suma de sus intervalos. El número de episodios conserva otra información: cuánto se fragmenta ese tiempo. Dos pares con igual duración acumulada pueden tener un episodio largo o muchos episodios breves. Una matriz ponderada exclusivamente por duración no permite reconstruir esa diferencia. Por eso el suplemento conserva tanto la tabla de pares como la de episodios.
La continuidad se define respecto de los intervalos disponibles. Un episodio que comienza en el primer contacto registrado podría haber tenido antecedentes fuera de la observación, y uno que termina al final podría continuar después. Además, una interrupción de la señal puede separar dos episodios operacionales sin demostrar por sí misma una separación física equivalente. La condición comprobable es que no existe otro intervalo registrado inmediatamente adyacente para ese par. Esta definición permite reproducir los episodios sin atribuir a sus extremos una precisión conductual que el archivo no ofrece.
El promedio depende además del denominador. Dividir los 648480 segundos-pareja entre los 1139 pares observados da aproximadamente 569,34 segundos por par con contacto registrado. Entre setenta y cinco identificadores existen 2775 pares no ordenados posibles; al incluir también los que no presentan contacto, el promedio es aproximadamente 233,69 segundos por par posible. Ambas cifras describen el mismo archivo y responden a preguntas distintas.
La densidad agregada es 1139 dividida entre 2775, aproximadamente 0,410. Informa sobre qué fracción de pares posibles tuvo al menos un intervalo registrado. Un encuentro breve basta para que un par contribuya a esa densidad. El peso indica cuánto tiempo operacional se acumuló; el episodio informa sobre continuidad; la marca temporal conserva cuándo estuvo disponible cada relación. Ninguna de esas cantidades sustituye automáticamente a las otras.
Mezcla entre roles y elección del denominador
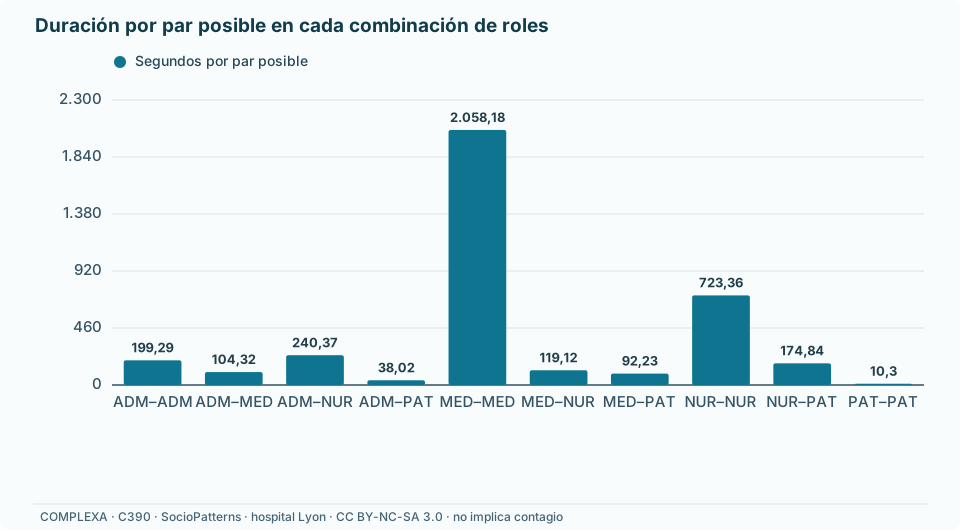
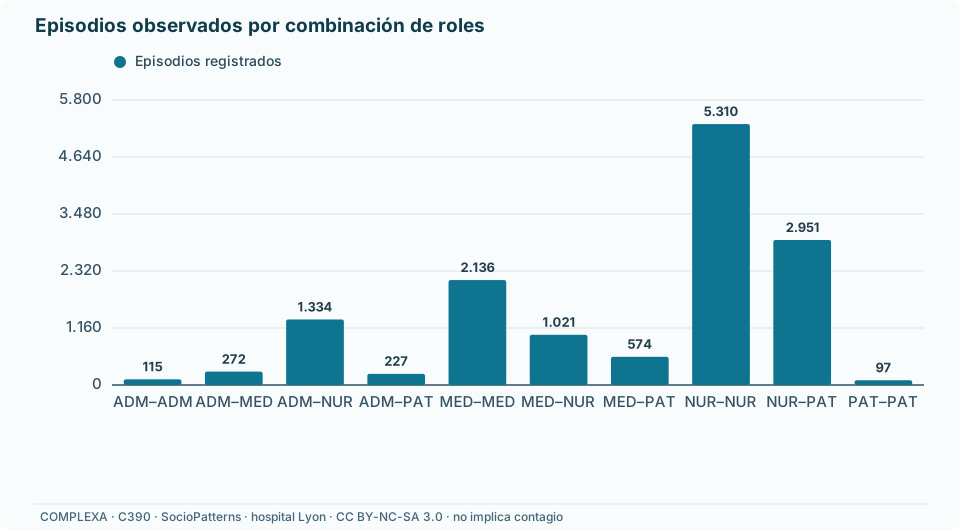
La siguiente tabla reconstruye las diez combinaciones no ordenadas de las cuatro categorías. Cada episodio y cada intervalo pertenecen a una sola fila, por lo que sus sumas reproducen los totales. La última columna divide la duración por todos los pares posibles de esa combinación, incluidos los que no tuvieron contacto registrado. Las cifras son resultados del reanálisis del archivo oficial.
| Roles | Pares observados | Episodios | Segundos-pareja | Segundos por par posible |
|---|---|---|---|---|
| ADM–ADM | 12 | 115 | 5580 | 199,29 |
| ADM–MED | 42 | 272 | 9180 | 104,32 |
| ADM–NUR | 98 | 1334 | 51920 | 240,37 |
| ADM–PAT | 69 | 227 | 8820 | 38,02 |
| MED–MED | 48 | 2136 | 113200 | 2058,18 |
| MED–NUR | 151 | 1021 | 35380 | 119,12 |
| MED–PAT | 102 | 574 | 29420 | 92,23 |
| NUR–NUR | 202 | 5310 | 253900 | 723,36 |
| NUR–PAT | 402 | 2951 | 136900 | 174,84 |
| PAT–PAT | 13 | 97 | 4180 | 10,30 |
El mayor volumen acumulado corresponde a NUR–NUR, con 253900 segundos-pareja. MED–MED acumula 113200, una cifra menor. Sin embargo, hay veintisiete identificadores NUR y once MED. Dentro de cada categoría, el número de pares posibles es n(n−1)/2: 351 entre NUR y 55 entre MED. Al usar ese denominador, la duración media resulta mayor para MED–MED. La comparación cambia porque se pasa de un volumen total a una cantidad por pareja posible.
El cálculo concreto permite evitar una interpretación vaga de «más contacto». En NUR–NUR, 253900 dividido entre 351 da aproximadamente 723,36 segundos por par posible. En MED–MED, 113200 dividido entre 55 da aproximadamente 2058,18. Si se restringe el denominador a los pares observados, se obtienen aproximadamente 1256,93 y 2358,33 segundos, respectivamente. El archivo de resultados conserva ambas medias y sus denominadores.
Entre categorías distintas, los pares posibles se calculan multiplicando sus tamaños. Para NUR–PAT son veintisiete por veintinueve, es decir, 783. De ellos, 402 tienen algún intervalo registrado. La duración acumulada es 136900 segundos-pareja, equivalente a unos 174,84 segundos por par posible. Ese promedio incorpora tanto la frecuencia de pares sin contacto como la duración de los que sí lo tuvieron.
Ninguno de esos denominadores mide el tiempo durante el cual cada pareja estuvo simultáneamente disponible en la unidad. Personas diferentes pueden tener periodos de presencia distintos, y el archivo de contactos no proporciona un registro completo de esas oportunidades. Por eso los segundos por par posible son una descripción del conjunto y la ventana, no una tasa ajustada por copresencia. No permiten atribuir a la categoría profesional una propensión causal a contactar.
La tabla conserva pares no ordenados. En una matriz cuadrada, una combinación entre dos categorías suele aparecer en dos posiciones simétricas para facilitar su lectura; sumar ambas duplicaría su duración si no se corrige. Dentro de una categoría también hay que distinguir parejas de personas de contribuciones incidentes por persona. Cada contacto de un par tiene dos extremos, aunque sea una sola relación. Aquí el recuento único evita mezclar esas convenciones.
Las categorías tampoco sustituyen a la variación individual. Un total por rol puede concentrarse en algunas personas y distribuirse de otro modo en otras. Las tablas por identificador permiten examinar esa composición descriptiva, pero una posición elevada en duración o grado sigue refiriéndose al periodo registrado. Convertirla en una clasificación de importancia clínica exigiría definir el resultado que se intenta explicar y disponer de datos pertinentes sobre ese resultado.
La combinación PAT–PAT ofrece otra lectura del denominador. Solo trece de sus cuatrocientos seis pares posibles tienen contacto registrado, pero eso no significa que los pacientes carezcan de contactos con personas de otras categorías. NUR–PAT, MED–PAT y ADM–PAT describen otras partes de esa misma población observada. Examinar exclusivamente la diagonal de una matriz de roles eliminaría esas relaciones por definición. Por su parte, sumar todas las categorías incidentes a pacientes requeriría contar con cuidado PAT–PAT: es una relación única con dos extremos pertenecientes a esa categoría.
Una ventana de observación no es un reloj civil
Las marcas finales del archivo van de 140 a 347640 segundos. El comienzo del primer intervalo registrado es, por tanto, 120. Se utiliza la ventana analítica comprendida entre 120 y 347640, que abarca 347520 segundos. Esta convención contiene todos los intervalos observados y define desde cuándo se estudian los caminos. No se presenta como una estimación del comienzo y final exactos del despliegue de sensores.
Aunque las fuentes describen las fechas del estudio, no fijan inequívocamente el origen civil de las marcas t de este archivo. Por ello no se transforma t=0 en una hora concreta ni se asignan automáticamente registros a turnos. Los resultados utilizan el tiempo original y, cuando se necesita una duración desde el comienzo analítico, restan 120. Esta elección permite reproducir el cálculo sin introducir un calendario supuesto.
El archivo presenta al menos un contacto en 9453 intervalos distintos. Entre ellos puede haber huecos sin filas. El análisis mantiene esos huecos: no prolonga una arista desde su primera aparición hasta la última. Holme (2015) distingue la secuencia de contactos de otras representaciones que suponen persistencia de un enlace. Adoptar esta última interpretación añadiría disponibilidad en momentos para los que no existe el mismo registro.
Los límites de la ventana afectan también las conclusiones. Una persona puede tener encuentros antes del primer registro o después del último, y esos encuentros quedan fuera del análisis. Una ruta que no se completa antes del final puede existir en una observación más larga. Repetir artificialmente el archivo de forma periódica permitiría otras conexiones entre el final y el comienzo; aquí no se realiza esa extensión. Se resuelve la alcanzabilidad dentro de la ventana conservada.
La regla de recorrido temporal
Holme y Saramäki (2012) explican que una ruta temporal depende del orden de los contactos, además de la conectividad agregada. Para aplicar esa idea a intervalos de veinte segundos hay que decidir qué significa atravesar uno de ellos. Las convenciones sobre contactos simultáneos varían entre modelos. En este caso se adopta una regla explícita que no atribuye a las filas del mismo intervalo un orden que los datos no proporcionan.
Para cada identificador se inicia por separado una señal abstracta en el segundo 120. Un contacto que termina en t puede utilizarse si la señal ha llegado a uno de sus extremos como máximo en t−20, inicio de ese intervalo. La llegada al otro extremo se registra en t. Se permite esperar hasta cualquier contacto posterior dentro de la ventana. La señal conserva su disponibilidad y no se le asignan recuperación, caducidad ni probabilidad de transmisión.
La igualdad en la condición temporal es deliberada. Si una señal llega en 140, puede utilizar un contacto que comienza en 140 y termina en 160. Lo que se prohíbe es utilizar en cadena dos aristas que terminan ambas en 140. Esta regla permite intervalos consecutivos y evita cascadas instantáneas dentro de una observación que no distingue el orden de los acontecimientos a una escala menor.
El programa procesa todos los pares de un intervalo desde una copia del conjunto alcanzado antes de comenzarlo. Primero identifica qué extremos nuevos pueden alcanzarse; después incorpora simultáneamente esas llegadas. Si se actualizara el conjunto después de cada fila, una fila posterior del mismo intervalo podría utilizar una llegada producida por otra anterior. El resultado dependería entonces del orden arbitrario de las líneas del archivo.
Puede expresarse mediante un conjunto R de personas ya alcanzadas. Para el intervalo que termina en t, se añaden los vecinos por contactos de ese intervalo de quienes pertenecían a R al comenzar, en t−20. Las personas alcanzadas permanecen en R durante la espera. Repetir esta operación para cada origen produce una tabla completa de primeras llegadas. Los destinos que nunca se añaden quedan registrados como no alcanzables bajo esta convención.
El origen se coloca al comienzo analítico incluso si su primer contacto aparece mucho después. Es una condición del cálculo, no una afirmación de que esa persona estuviera físicamente presente desde el segundo 120. De forma similar, la espera puede atravesar periodos sin contacto observado. La señal abstracta conserva memoria; los datos no demuestran permanencia continua en una habitación ni en el hospital.
Esta definición responde a una pregunta estructural: qué contactos observados pueden concatenarse respetando la resolución declarada. Un proceso biológico podría imponer un periodo antes de transmitir, una duración máxima de capacidad transmisora u otras condiciones. Cada modificación produciría una pregunta diferente. La alcanzabilidad calculada aquí no estima una probabilidad de infección ni afirma que la señal haya existido realmente.
La primera llegada es suficiente para este problema porque se permite espera ilimitada y no hay un coste por llegar antes. Si una ruta alcanza un nodo antes que otra, puede esperar para aprovechar cualquiera de los contactos posteriores que la segunda utilizaría. Esa propiedad justifica conservar la llegada mínima. Con caducidad de la señal u otras restricciones, podría ser necesario mantener más estados y el mismo algoritmo requeriría reconsideración.
Las setenta y cinco ejecuciones corresponden a escenarios separados. En cada una hay un único origen inicial y se registra qué destinos son accesibles desde él. Reunir sus resultados en una matriz no equivale a iniciar simultáneamente señales independientes en todos los nodos de un mismo proceso observado. La matriz responde a preguntas alternativas sobre el mismo conjunto de contactos. Tampoco cuenta cuántas rutas diferentes existen entre dos personas: conserva la existencia de alguna ruta y su llegada mínima, dos resúmenes que dejan fuera otras propiedades de las secuencias.
Conectividad total y alcanzabilidad parcial
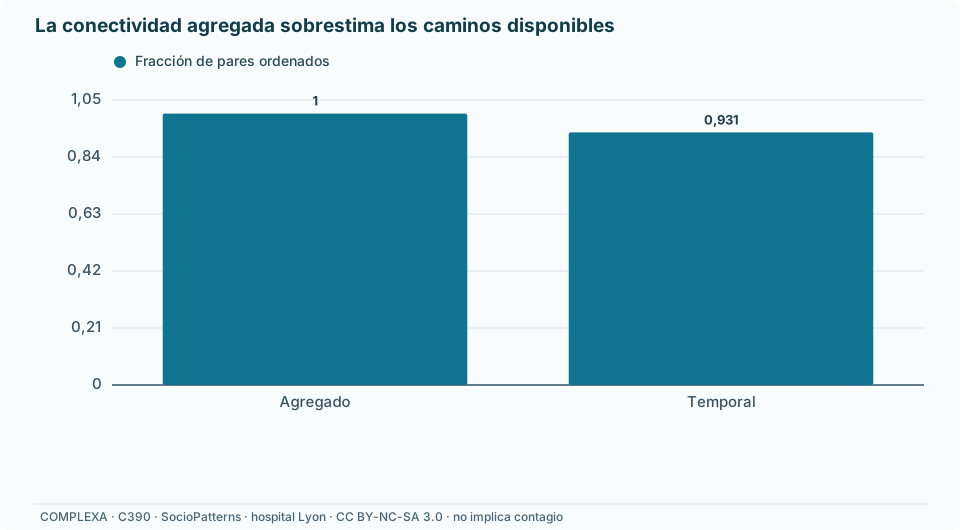
En el grafo agregado, todos los identificadores forman una única componente. Para cada origen hay otros setenta y cuatro nodos conectados por algún camino estático. El denominador de pares ordenados distintos es 75 por 74, igual a 5550. Bajo la regla temporal se alcanzan 5165 de esos pares, aproximadamente el 93,06 %. Los 385 restantes tienen una ruta en el agregado, pero carecen de una secuencia admisible dentro de la ventana y la convención elegidas.
No se trata de una estimación del porcentaje de contactos que transmiten. El numerador cuenta pares de origen y destino con al menos un camino permitido; un camino puede incluir intermediarios y esperas. El denominador incluye todos los pares ordenados de identificadores distintos, no únicamente los que estuvieron directamente en contacto. La proporción describe la posibilidad estructural definida en el diseño.
La red de contactos directos es simétrica, pero su alcanzabilidad temporal puede no serlo. En este archivo hay 385 pares no ordenados alcanzables solamente en una de las dos direcciones bajo la regla fijada. La dirección surge de la secuencia de oportunidades. Que A contacte con B y B contacte con C no permite intercambiar libremente el orden de esos encuentros al estudiar una ruta desde A hasta C.
La cantidad de otros nodos alcanzables desde un origen va de cuarenta y tres a setenta y cuatro; la mediana es setenta y cuatro. El grafo estático asignaría setenta y cuatro a todos. Esta variación muestra que la posición temporal conserva información que la pertenencia a la componente pierde. El suplemento mantiene los resultados de cada origen para que el resumen no oculte esa distribución.
La alcanzabilidad temporal tampoco funciona siempre como una relación transitiva entre resúmenes independientes. Una ruta de A a B puede llegar después del momento en que comienza la ruta disponible de B a C. Saber que ambas existen por separado no garantiza que puedan concatenarse. Para comprobar una ruta compuesta hay que conservar las llegadas y los contactos futuros, en lugar de tratar cada relación alcanzable como si fuese una arista permanentemente disponible.
Los resultados se comprobaron con una segunda implementación. Mientras el análisis principal recorre intervalos cronológicamente, la verificación organiza los contactos incidentes de cada nodo y busca las primeras llegadas mediante una cola de prioridad. Ambas implementaciones comparan todos los pares ordenados, incluidos los que no tienen llegada. La concordancia verifica que dos procedimientos distintos resuelven la misma regla sobre el archivo; la adecuación de esa regla para otro proceso sigue siendo una cuestión separada.
No se calculan intervalos de confianza para convertir la proporción observada en una estimación de todos los hospitales. Se ha enumerado una propiedad del archivo completo bajo una regla determinada. Para generalizarla haría falta definir cómo se seleccionan unidades, periodos y participantes, y qué variación representa una repetición del estudio. La incertidumbre sobre la medición tampoco desaparece por enumerar todas las filas. Es distinto conocer exactamente el resultado de una operación sobre datos conservados que conocer sin incertidumbre todos los contactos del sistema que se pretendía observar.
La dependencia de la regla puede estudiarse de manera transparente. Permitir más saltos dentro de un mismo intervalo ampliaría el conjunto de caminos admisibles respecto del utilizado aquí. Imponer una duración máxima de espera podría restringirlo. Estas relaciones entre conjuntos de caminos no indican cuánto cambiarían los resultados numéricos sin ejecutar los modelos correspondientes. Por eso se mantiene una única convención para las cifras presentadas y se distingue la discusión de alternativas de una comparación efectivamente calculada.
Un camino calculado a partir de contactos observados
La ilustración se eligió a partir de las primeras dos filas de la validación, antes de calcular la alcanzabilidad. La primera registra proximidad entre 1157 y 1232 durante [120,140]. La segunda conecta 1157 con 1191 durante [140,160]. Desde 1232, la señal llega a 1157 en 140 y puede utilizar inmediatamente el intervalo siguiente. Su primera llegada a 1191 ocurre en 160, cuarenta segundos después del comienzo analítico.
El camino inverso no puede recorrer esas mismas filas hacia atrás. Desde 1191, el contacto con 1157 termina en 160, cuando el primer contacto entre 1157 y 1232 ya terminó. Una ruta estática de dos aristas no conserva ese obstáculo. En los registros completos sí existe una ruta temporal inversa, pero su primera llegada ocurre en 259560, muy posterior a 160.
Un camino que alcanza esa llegada utiliza cuatro contactos. Va de 1191 a 1152 en el intervalo [1780,1800], de 1152 a 1193 en [6220,6240], de 1193 a 1190 en [12860,12880] y de 1190 a 1232 en [259540,259560]. Todos esos pares e intervalos están en el archivo observado. Entre los saltos se conserva la espera permitida por el diseño.
La larga separación antes del último contacto tiene una interpretación precisa: la ruta utiliza una oportunidad registrada mucho después. No permite describir qué hicieron las personas durante ese hueco ni atribuirle una duración de contagiosidad. Tampoco demuestra que la ruta mostrada sea la de menos saltos entre todas las posibles. El criterio optimizado es la primera llegada desde el comienzo fijado; el programa conserva un camino que la realiza.
Cuando varias rutas producen la misma primera llegada, conservar una de ellas sirve como comprobación de existencia. La elección determinista entre rutas empatadas facilita repetir la salida. No demuestra que ese recorrido sea único ni que tuviera mayor probabilidad de ocurrir que los demás.
Con límites de espera, algunas rutas de este tipo podrían dejar de ser admisibles. Con otra hora de partida podrían desaparecer contactos tempranos que aquí están disponibles. Holme (2015) discute esa dependencia del origen temporal y de las fronteras de observación. En el caso resuelto, la diferencia entre las dos direcciones se obtiene sin añadir probabilidades ni parámetros biológicos: basta con respetar los intervalos reales y la regla declarada.
Qué queda disponible para reproducir el resultado
El suplemento conserva el archivo comprimido original, su procedencia y la especificación previa del análisis. Incluye tres programas: validación del archivo, análisis descriptivo y temporal, y comprobación mediante la segunda implementación. Todos utilizan únicamente la biblioteca estándar de Python y resuelven las rutas desde su propia ubicación, de modo que pueden ejecutarse desde otro directorio sin acceder a internet.
Las salidas separan cinco unidades: pares agregados, episodios, combinaciones de roles, nodos y pares ordenados para la alcanzabilidad. En esta última tabla, una llegada vacía significa que no existe camino bajo la regla, no que la llegada se produjo en cero. Se conservan tanto la marca original como el tiempo desde el inicio analítico. Un resumen estructurado contiene los totales y los caminos de la ilustración.
La comprobación de episodios verifica que todos sus intervalos están en el archivo original, que no se asigna una fila a dos episodios y que no quedan filas sin asignar. También comprueba que los episodios son maximales: no puede añadirse un intervalo inmediatamente anterior o posterior del mismo par. Estas propiedades evalúan la definición completa, además de la coincidencia de un total agregado.
El README contiene los comandos de ejecución y las unidades de cada tabla. El manifiesto identifica mediante huellas SHA-256 los datos, programas y resultados que acompañan al caso. Las huellas permiten reconocer una versión concreta; la reproducción vuelve a calcular los resultados a partir de la entrada. La revisión independiente añade el examen del texto, de las fuentes y de la correspondencia entre reglas y operaciones.
La cobertura parcial y la medición de proximidad siguen delimitando la interpretación, aunque el cálculo sea reproducible. Una persona no participante podría ofrecer una ruta ausente en el archivo, y un contacto registrado no informa por sí mismo sobre el estado infeccioso de sus extremos. Añadir un modelo de propagación exigiría declarar otros datos y parámetros, y distinguir sus resultados de los contactos observados. La comparación entre mediciones de Génois y Barrat (2018) refuerza la necesidad de mantener visible qué clase de relación proporciona cada tecnología.
Una modificación de la red plantea además una pregunta diferente de la descripción. Eliminar matemáticamente un contacto puede reducir caminos en el archivo, pero una reorganización real podría generar contactos sustitutos, cambiar horarios o modificar quién realiza una actividad. Mantener todo lo demás fijo es un supuesto de esa operación, no un resultado de los sensores. Para evaluar una intervención organizativa habría que definirla y estudiar sus consecuencias sobre el sistema, junto con los resultados relevantes. El caso no utiliza los cálculos de caminos para recomendar la supresión de contactos asistenciales.
La ruta 1232→1157→1191 queda comprobada en dos intervalos consecutivos, mientras que su inversa necesita otras oportunidades y llega mucho después. La tabla agregada conserva las relaciones entre esas personas, pero pierde esa diferencia. Los archivos del caso permiten volver a cada intervalo que sostiene el resultado y distinguir el contacto medido, el camino calculado y la espera introducida por la regla del análisis.
Referencias
Cattuto, C., Van den Broeck, W., Barrat, A., Colizza, V., Pinton, J.-F., & Vespignani, A. (2010). Dynamics of person-to-person interactions from distributed RFID sensor networks. PLOS ONE, 5(7), e11596. https://doi.org/10.1371/journal.pone.0011596
Génois, M., & Barrat, A. (2018). Can co-location be used as a proxy for face-to-face contacts? EPJ Data Science, 7, 11. https://doi.org/10.1140/epjds/s13688-018-0140-1
Holme, P. (2015). Modern temporal network theory: A colloquium. The European Physical Journal B, 88, 234. https://doi.org/10.1140/epjb/e2015-60657-4
Holme, P., & Saramäki, J. (2012). Temporal networks. Physics Reports, 519(3), 97–125. https://doi.org/10.1016/j.physrep.2012.03.001
SocioPatterns. (2013). Hospital ward dynamic contact network [Conjunto de datos]. https://sociopatterns.org/datasets/hospital-ward-dynamic-contact-network/
Vanhems, P., Barrat, A., Cattuto, C., Pinton, J.-F., Khanafer, N., Régis, C., Kim, B.-a., Comte, B., & Voirin, N. (2013a). Estimating potential infection transmission routes in hospital wards using wearable proximity sensors. PLOS ONE, 8(9), e73970. https://doi.org/10.1371/journal.pone.0073970
Vanhems, P., Barrat, A., Cattuto, C., Pinton, J.-F., Khanafer, N., Régis, C., Kim, B.-a., Comte, B., & Voirin, N. (2013b). Correction: Estimating potential infection transmission routes in hospital wards using wearable proximity sensors. PLOS ONE, 8(9). https://doi.org/10.1371/annotation/b20d3cec-62b7-44ec-9150-8a06a9b30a9b