Una línea entre cansancio y dificultad de concentración puede representar cosas distintas. Puede resumir que quienes informan más cansancio también informan más dificultades, indicar que ambas respuestas se apartan conjuntamente del nivel habitual de una persona o expresar que una respuesta ayuda a predecir otra unas horas después. Incluso el significado de los nodos depende de cómo se preguntó: una evaluación del momento presente no equivale a un resumen de las últimas semanas. El dibujo necesita esas definiciones para convertirse en una afirmación interpretable.
La teoría de redes de síntomas propone estudiar relaciones mediante las cuales determinados componentes pueden activar o sostener otros. Borsboom (2017) formula una teoría causal en la que esas interacciones contribuyen a explicar la organización y persistencia de los trastornos. El trabajo distingue ese objeto teórico de las asociaciones que pueden estimarse con observaciones. Que una teoría describa mecanismos causales no convierte automáticamente cada arista de una red estadística en uno de esos mecanismos.
El interés del enfoque está en formular preguntas que una puntuación total puede ocultar. Dos personas con igual suma pueden presentar combinaciones diferentes de respuestas y trayectorias distintas. Investigar esas diferencias requiere conservar el contenido de las variables, sus escalas y el momento en que se observaron. Un modelo puede describir asociaciones entre componentes sin identificar todavía una dinámica causal. La adecuación del análisis se juzga por la correspondencia entre la pregunta, la medición y las relaciones que el modelo efectivamente estima.
El nodo comienza en una pregunta de medición
Un síntoma como concepto y una respuesta a un cuestionario son objetos relacionados, pero diferentes. La respuesta combina la experiencia que se intenta conocer con comprensión de la pregunta, recuerdo y uso de las categorías disponibles. Si un ítem pregunta por frecuencia y otro por intensidad, una conexión entre ellos relaciona dos operaciones de medición distintas. La interpretación debe mantener esa diferencia aunque el programa represente ambos como círculos del mismo tamaño.
La selección del instrumento también selecciona el universo de nodos. Fried (2017), cuya comparación cuenta con un corrigendum posterior (Fried, 2020), examinó el contenido de siete escalas de depresión y documentó diferencias en los síntomas representados y en la combinación de contenidos dentro de los ítems. Esa comparación de instrumentos no estima una red causal ni demuestra que una escala sea apropiada para cualquier objetivo. Sí permite reconocer que cambiar de cuestionario puede cambiar qué componentes entran en el análisis, aunque todos los instrumentos utilicen una misma denominación general.
Supongamos que dos preguntas hipotéticas se refieren a «dificultad para mantener la atención» y «problemas para concentrarse en una tarea». Una asociación elevada podría reflejar que ambas captan una experiencia muy similar. Interpretarla como activación de un componente por otro exigiría justificar que se trata de componentes distintos. En cambio, una pregunta que combine «dormir poco o demasiado» reúne estados que pueden tener relaciones diferentes con otras variables. Crear un único nodo impide distinguir esas relaciones si los datos originales tampoco separan las respuestas.
La ventana de recuerdo añade otra estructura. Una respuesta acerca del último momento aproxima un estado localizado; una pregunta sobre la última semana resume una trayectoria mediante un proceso de memoria. Si cada día se pregunta por los siete días anteriores, las ventanas se solapan. Parte de la persistencia entre respuestas sucesivas puede proceder de que ambas incluyen los mismos días. Aumentar la frecuencia de administración no crea automáticamente medidas de un proceso que cambia a esa misma frecuencia.
Las categorías de respuesta también importan. Una escala ordinal establece un orden, pero no asegura que la distancia entre categorías adyacentes sea constante. Tratarla como continua introduce una aproximación que debe justificarse para el instrumento y la distribución observada. Un modelo para variables binarias, otro para categorías ordenadas y un modelo gaussiano describen probabilidades y parámetros diferentes. Comparar sus aristas por el grosor del dibujo oculta esas diferencias si no se explica qué representa cada peso.
La medición puede cambiar entre personas y momentos. Una misma palabra puede tener usos distintos, y una intervención o un cambio de contexto puede modificar el criterio con que alguien responde. Una diferencia en la red estimada podría reflejar cambios en la experiencia, cambios en su expresión medida o ambos. Para distinguirlos conviene examinar el funcionamiento de las preguntas y mantener información sobre instrucciones, traducciones y dispositivos. La estabilidad del nombre de una variable en la base de datos no demuestra estabilidad de su significado.
Las instrucciones deben ajustarse además a la variación que se pretende estudiar. Preguntar por una característica habitual varias veces durante una tarde puede generar respuestas repetidas porque la persona sigue respondiendo sobre su experiencia general. Preguntar por el estado presente cambia el referente y puede captar fluctuaciones, pero requiere que la experiencia resulte interpretable en ese intervalo. Una comprobación previa de comprensión puede revelar que dos participantes están utilizando referencias temporales distintas. Ese problema ocurre antes del ajuste estadístico: el modelo recibe números, mientras que las instrucciones determinan a qué experiencias corresponden.
La variación disponible limita además lo estimable. Si una persona utiliza siempre la misma categoría para un ítem durante el periodo observado, no hay variación intrapersonal que permita estimar su asociación dinámica con otros ítems mediante una regresión ordinaria. Ese resultado no establece que el componente carezca de importancia fuera del periodo o de las condiciones observadas. Describe una restricción de los datos. La decisión de eliminar el nodo cambia el conjunto de variables al que se referirán las asociaciones restantes y debe quedar documentada.
Comparar personas y estudiar cambios personales
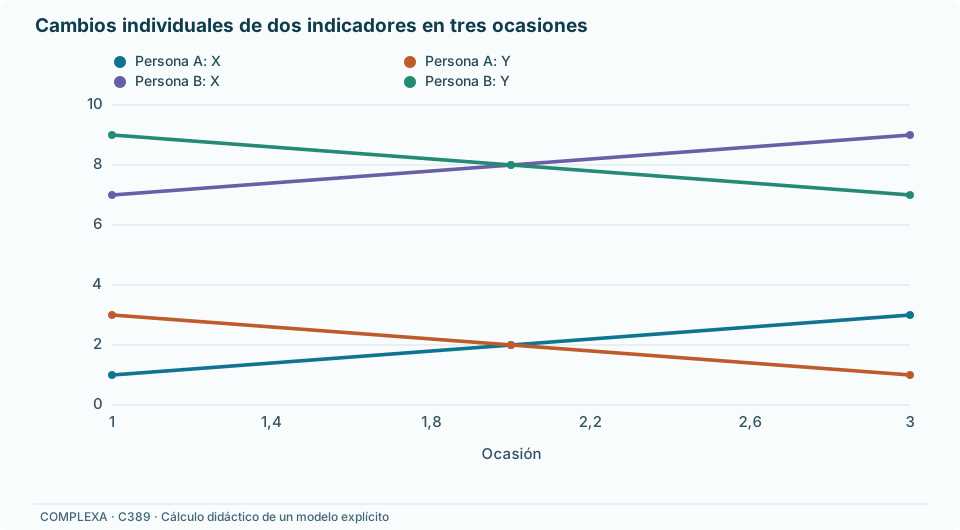
Las diferencias entre personas y las fluctuaciones dentro de una persona pueden producir relaciones de signo contrario. Consideremos seis observaciones completamente construidas, correspondientes a dos personas ficticias medidas en tres ocasiones. Las puntuaciones continuas abstractas se denominan X e Y; no son respuestas de pacientes ni una escala clínica validada.
| Persona | Primera ocasión: X, Y | Segunda ocasión: X, Y | Tercera ocasión: X, Y |
|---|---|---|---|
| A | 1, 3 | 2, 2 | 3, 1 |
| B | 7, 9 | 8, 8 | 9, 7 |
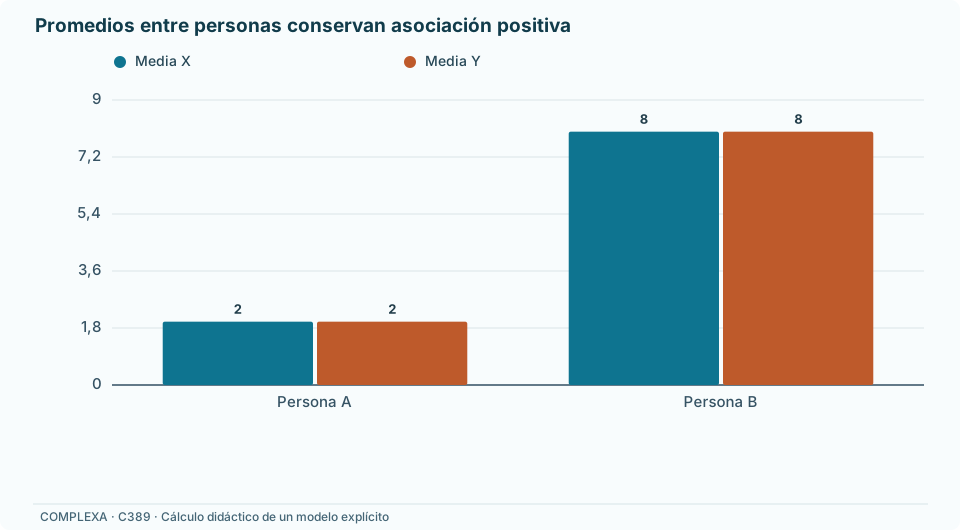
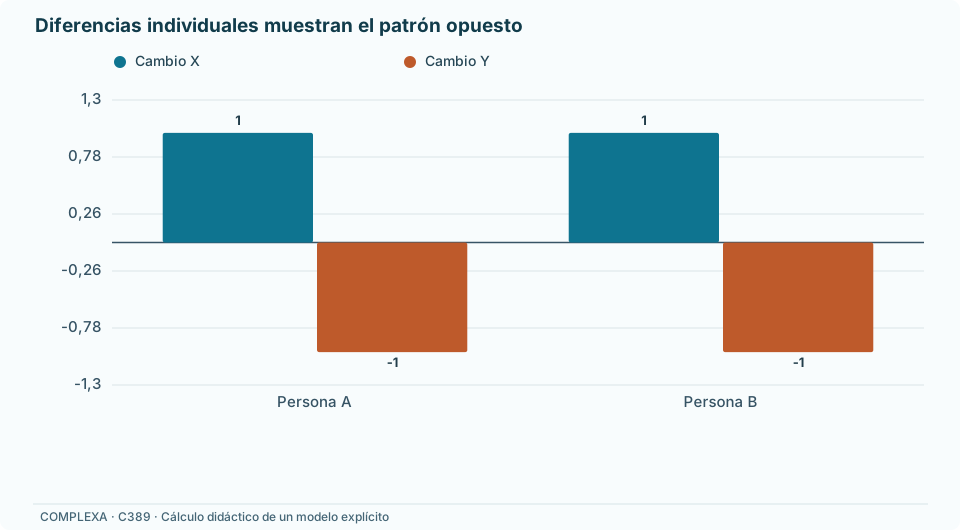
La primera persona tiene medias de 2 en ambas variables; la segunda, medias de 8. Las personas con mayor promedio en X tienen también mayor promedio en Y. Dentro de cada persona ocurre algo distinto: al aumentar X una unidad entre ocasiones, Y disminuye una unidad. La correlación intrapersonal es −1 en ambos casos. El ejemplo usa relaciones perfectas para que el contraste pueda comprobarse sin ambigüedad, no para representar la precisión de una medición real.
Si se reúnen las seis filas ignorando su pertenencia, las medias globales son 5. Calculando las covarianzas con peso igual para cada una de las seis observaciones, la covarianza conjunta es 25/3 y la varianza de cada variable es 29/3. La correlación conjunta vale por tanto 25/29, aproximadamente 0,862. Una asociación positiva fuerte resume el conjunto y convive con asociaciones negativas en las dos trayectorias individuales.
La descomposición permite localizar su origen. La covarianza entre las medias personales es 9, mientras que la covarianza dentro de cada persona es −2/3. Su suma da 25/3. La variación entre los niveles habituales domina la asociación agregada. Al restar a cada observación la media de su persona, ambas trayectorias quedan expresadas como desviaciones respecto de esos niveles, y reaparece la relación negativa. El centrado cambia la comparación que se realiza; no corrige por sí solo todos los problemas de un análisis longitudinal.
Esta construcción tampoco distingue un efecto causal. Las dos puntuaciones podrían responder a una condición que cambia con el tiempo, o una podría influir en la otra. Solo se ha fijado su distribución conjunta en las ocasiones seleccionadas. Su función es demostrar que conocer la asociación agregada no determina la asociación intrapersonal. Con dos personas y tres ocasiones no se pretende estimar una red compleja ni proporcionar una pauta para elegir el tamaño de una investigación.
Fisher, Medaglia y Jeronimus (2018) estudiaron la correspondencia entre relaciones grupales e individuales en seis conjuntos de datos con mediciones repetidas. Sus resultados cuestionan trasladar automáticamente una asociación de grupo a la experiencia de cada participante. El alcance de esa conclusión no es que toda evidencia grupal carezca de valor para una persona. La transferencia requiere examinar semejanzas relevantes entre procesos y contextos, o incorporar directamente información individual que permita evaluar esa relación.
En modelos de panel ocurre un problema relacionado. Hamaker, Kuiper y Grasman (2015) muestran que incluir términos autorregresivos en el modelo de panel cruzado tradicional puede no separar adecuadamente diferencias estables entre personas y relaciones dentro de ellas. Su propuesta incorpora interceptos aleatorios para representar los niveles estables. Esta separación modifica la interpretación de los coeficientes y puede cambiar sus resultados. Aun así, distinguir niveles no proporciona información sobre todas las causas que varían con el tiempo ni convierte la predicción longitudinal en un efecto de intervención.
Un promedio de relaciones intrapersonales merece también una interpretación propia. Si algunas personas presentan una asociación positiva y otras una negativa, el promedio puede aproximarse a cero aunque las relaciones individuales sean pronunciadas. Un modelo multinivel puede representar heterogeneidad y compartir información entre participantes bajo supuestos explícitos. Esa combinación depende de cuánto se supone que se parecen los procesos. La cantidad de personas y la longitud de sus series aportan información diferente: muchas trayectorias muy breves no equivalen a observar extensamente la dinámica de cada participante.
En datos reales, los niveles habituales tampoco se conocen exactamente. Una media personal calculada durante un periodo corto puede estar influida por un acontecimiento transitorio o por las ocasiones en que se respondió. Restarla organiza las observaciones alrededor de ese promedio observado, cuya relación con un nivel estable necesita justificarse. Si se comparan periodos con distinta composición de ocasiones, el cambio del promedio puede modificar las desviaciones sin que todas las experiencias hayan cambiado de la misma forma. Separar niveles implica modelar o delimitar esa referencia, además de efectuar una resta.
Qué redes puede producir un mismo estudio longitudinal
Epskamp, Waldorp, Mõttus y Borsboom (2018) distinguen estructuras que conviene mantener separadas. Una red temporal representa coeficientes de regresión entre variables observadas en ocasiones sucesivas, condicionando por los predictores incluidos. Una red contemporánea describe asociaciones parciales entre los residuos que permanecen en una misma ocasión después de modelar los retardos. Una red entre personas puede construirse sobre la covariación de sus niveles medios. Sus aristas responden a comparaciones diferentes, aunque procedan de un mismo conjunto de observaciones.
En la red temporal, una flecha desde X hacia Y indica que el valor previo de X contribuye a predecir Y en el siguiente momento, dado el resto de predictores del modelo. Su tamaño depende de la escala, del intervalo entre mediciones y de qué historia se ha incluido. La flecha no representa necesariamente un mecanismo directo a una resolución más fina. Una causa omitida que preceda a ambas variables también puede producir capacidad predictiva.
La red contemporánea trabaja con otra cantidad. Después de calcular las predicciones temporales, quedan desviaciones que el modelo no explica. Sus asociaciones pueden reflejar procesos más rápidos que el intervalo de observación, influencias comunes o propiedades de la medición. El modelo gráfico de esos residuos es no dirigido: una asociación residual entre X e Y no indica por cuál variable comenzó un proceso. Llamarla contemporánea describe la resolución disponible, sin demostrar simultaneidad física de los mecanismos.
En un modelo gráfico gaussiano, una correlación parcial nula corresponde a independencia condicional cuando la distribución conjunta es normal multivariante y la matriz de covarianzas es invertible. La independencia se refiere a las demás variables incluidas. Fuera de ese marco, ausencia de correlación parcial no garantiza ausencia de dependencia. Además, incorporar o retirar un ítem cambia el conjunto de condicionamiento. Una arista puede variar sin que haya cambiado el sistema real, porque se ha cambiado qué información utiliza la comparación.
Condicionar por más variables tampoco elimina necesariamente todas las asociaciones que carecen de un enlace causal directo. Si dos componentes contribuyen a una consecuencia común, fijar estadísticamente esa consecuencia puede relacionarlos. La selección de participantes puede operar de forma parecida: restringir el análisis a quienes superan un criterio construido a partir de varias respuestas modifica las combinaciones observables. El criterio de inclusión forma entonces parte del problema causal y estadístico. Una red estimada dentro de esa selección debe describirse respecto de ella, sin suponer que coincide con la red de la población antes de aplicar el criterio.
La red transversal merece una precisión adicional. Medir una vez a muchas personas no equivale necesariamente a medir sus niveles habituales. La variación entre respuestas puede combinar diferencias estables con estados transitorios en el momento de la encuesta. Por eso, la red obtenida con una única medición por persona no debe identificarse automáticamente con una red de medias personales. Para aproximar estas últimas se necesita información sobre los niveles medios y sobre la incertidumbre con que se estiman.
El intervalo de observación forma parte del modelo
Un coeficiente temporal necesita una unidad de tiempo. Consideremos un proceso didáctico con tres variables continuas, X, Y y Z, que evolucionan en pasos regulares. Las ecuaciones se estipulan para mostrar cómo cambia la representación al observar cada dos pasos; no se ajustan a datos clínicos. Cada variable conserva la mitad de su valor previo. X contribuye al siguiente valor de Y con coeficiente 0,4, e Y contribuye al siguiente valor de Z con el mismo coeficiente:
Los errores tienen media cero, varianza uno y distribución gaussiana; son independientes entre componentes, entre momentos y respecto de la historia anterior. La matriz de coeficientes es estable: sus valores propios son 0,5. El ejemplo puede considerarse en su distribución estacionaria. En un solo paso no hay un término de X en la ecuación de Z. Esa ausencia tiene un significado preciso dentro de las ecuaciones estipuladas, con todas sus condiciones.
Al sustituir las ecuaciones un paso más adelante, aparece:
El coeficiente de X es ahora 0,16 porque su influencia pasa por Y. Si solo se observan los momentos separados por dos pasos, la red temporal puede contener una flecha X hacia Z. Esa flecha resume una relación a la resolución observada, aunque en las ecuaciones originales no exista un enlace directo de un paso. Dentro del sistema causal construido, el efecto a dos pasos está mediado; describirlo como una conexión directa entre síntomas a cualquier escala perdería esa información.
La transformación también afecta los residuos. Al agrupar dos pasos, el nuevo error combina los errores del primer paso propagados por la dinámica y los errores del segundo. Por ejemplo, el error de X al final del intervalo contiene parte de la innovación previa de X, que también contribuye al error agregado de Y. La covarianza residual entre X e Y pasa a ser 0,2; ocurre lo mismo entre Y y Z. Los errores originales eran independientes, pero la observación más espaciada produce dependencia contemporánea en la representación agregada.
El ejemplo permite entender por qué dos estudios con intervalos distintos pueden obtener redes diferentes sin que uno de ellos haya cometido un error de cálculo. La diferencia puede expresar mecanismos que actúan entre las mediciones. También muestra qué se pierde al seleccionar un intervalo por comodidad sin relacionarlo con la pregunta. Una observación diaria puede ser útil para ciertas trayectorias y dejar sin resolver relaciones que ocurren en periodos menores. Aumentar la resolución puede ayudar a distinguirlas, siempre que la medición siga siendo adecuada y los participantes puedan responder de forma interpretable.
Los intervalos irregulares introducen otra dificultad. Un retardo que abarca una hora y otro que abarca una noche no representan el mismo paso de evolución. Tratar ambos como una transición idéntica impone una equivalencia que el calendario no respalda. Las opciones incluyen definir transiciones comparables o utilizar modelos que representen explícitamente el tiempo transcurrido. La elección cambia qué parámetros pueden interpretarse y qué información se necesita; no se resuelve desplazando una columna sin examinar las marcas temporales.
La estacionariedad del proceso también debe revisarse. Un modelo que mantiene constantes medias y coeficientes durante todo el periodo resume bajo una misma dinámica las observaciones disponibles. Si cambia el contexto, comienza una intervención o se modifica el instrumento, esa descripción puede combinar regímenes diferentes. Dividir la serie requiere información suficiente en cada tramo y una justificación de los límites. Ajustar un modelo más flexible tampoco crea observaciones de transiciones que apenas se han registrado.
Un nodo central que no propaga cambios
La centralidad resume una propiedad de una red definida. La fuerza de un nodo, por ejemplo, puede calcularse como la suma de los valores absolutos de sus aristas. Otras medidas utilizan distancias o caminos mínimos. Bringmann et al. (2019) cuestionan trasladar estas últimas interpretaciones a redes psicológicas sin especificar un proceso de flujo compatible. También señalan problemas cuando los nodos no son conceptualmente distintos o cuando sus diferencias cualitativas importan para la pregunta. Ser central necesita una definición de importancia, no únicamente un algoritmo.
Un tercer ejemplo construido muestra por qué una centralidad elevada no establece un efecto causal de intervención. Sea U una variable gaussiana no observada con media cero y varianza uno. Tres indicadores dependen de ella: X=U+εX, Y=U+εY y Z=U+εZ. Los tres errores son gaussianos e independientes entre sí y de U. La varianza del error de X es un cuarto; las de Y y Z son uno. En esta construcción, X registra el componente común con menor ruido.
La varianza de X es 1,25 y las de Y y Z son 2. Cada covarianza entre indicadores es 1, porque todos comparten U. A partir de esa matriz se obtienen correlaciones parciales de aproximadamente 0,471 entre X e Y, de 0,471 entre X y Z y de 0,167 entre Y y Z. Todas son positivas. La fuerza absoluta de X suma aproximadamente 0,943, mientras que las fuerzas de Y y Z valen aproximadamente 0,638 cada una. X queda situado como el nodo de mayor fuerza.
La estructura causal estipulada, sin embargo, contiene flechas de U hacia cada indicador y ninguna flecha entre los indicadores. Una intervención formal que sustituya la ecuación de X por un valor fijado no modifica U ni las ecuaciones de Y y Z. Sus distribuciones permanecen iguales. El nodo más central de la red de correlaciones parciales tiene un efecto nulo sobre los otros indicadores bajo esa intervención. El cálculo describe una consecuencia de las ecuaciones; no evalúa ninguna intervención terapéutica real.
El condicionamiento aclara el resultado. Observar un valor de X aporta información relativamente precisa sobre U. Por eso se relaciona intensamente con los otros indicadores, incluso al considerar información parcial de otro de ellos. Fijar X mediante una operación externa rompe su dependencia de U y no cambia la causa común. Las dos operaciones utilizan información distinta: conocer el indicador informa sobre su origen; imponer su valor no transforma necesariamente ese origen.
Este ejemplo no afirma que todos los síntomas sean reflejos de una única causa latente. Es un contraejemplo a la deducción general que pasa de alta centralidad asociativa a gran capacidad de intervención. Una estructura alternativa puede contener interacciones reales entre componentes. Para distinguirla se necesita evidencia o supuestos que discriminen entre procesos compatibles con las asociaciones. La calidad del ajuste de una red y su estabilidad no aportan por sí solas esa discriminación.
El uso de valores absolutos introduce otra elección interpretativa. Dos nodos pueden tener la misma fuerza aunque uno mantenga asociaciones positivas y el otro combine asociaciones positivas y negativas. La suma informa sobre magnitud de conexión bajo esa definición, pero pierde el patrón de signos. Incluso si los coeficientes fueran causales, sumar sus magnitudes no proporcionaría el cambio neto de un resultado definido. Para calcularlo harían falta la dirección de las relaciones, la dinámica y la forma en que se combina cada componente en el resultado. Conviene conservar las aristas y sus signos junto al índice resumido.
En una aplicación, la intervención debe definirse además de forma operacional. Cambiar una respuesta en un cuestionario, modificar una experiencia mediante una acción concreta y alterar una condición que afecta a varias experiencias son operaciones distintas. Pueden tener efectos adicionales, duraciones y restricciones diferentes. Para evaluar un objetivo clínico se necesitaría evidencia pertinente sobre esa acción y sobre los resultados de interés. El orden de los nodos en una lista de centralidad no especifica ninguna de esas cantidades.
Castro y colaboradores (2024) compararon varias formas de desactivar nodos en redes idiográficas contemporáneas de síntomas de ansiedad y depresión. En sus simulaciones, ordenar los nodos por grado produjo cambios mayores en ciertas propiedades estructurales; el resultado dependió de la medida elegida y de si la centralidad se recalculaba después de cada desactivación. El procedimiento evalúa operaciones matemáticas sobre una red estimada. No demuestra que una intervención clínica sobre el síntoma correspondiente produzca la misma modificación del sistema, ni que cambiar la topología implique una mejoría sintomática. La conexión entre un índice de centralidad y un objetivo terapéutico sigue necesitando evidencia sobre mecanismos e intervenciones reales.
Incertidumbre de las aristas y estabilidad de una interpretación
Las redes estimadas incorporan error de muestreo. Dos pesos visualmente distintos pueden tener una incertidumbre suficientemente amplia como para que su orden sea poco informativo. Epskamp, Borsboom y Fried (2018) distinguen la precisión de las aristas de la estabilidad de índices derivados, como la centralidad. En su contexto de redes transversales, el remuestreo permite examinar cuánto cambian los pesos y cuánto se altera el patrón de centralidad al retirar parte de los casos.
Estas comprobaciones responden a preguntas condicionadas al procedimiento de estimación. Una centralidad que permanece semejante al cambiar parte de la muestra es menos sensible a esa perturbación concreta. No demuestra que se hayan medido todos los componentes pertinentes ni que el instrumento mantenga el mismo significado en otra población. En el ejemplo de la causa común, una muestra muy grande podría estimar con precisión la mayor fuerza de X. Aumentaría la confianza en esa propiedad asociativa sin cambiar el efecto nulo de la intervención estipulada.
La regularización añade otra decisión. Reducir pesos o llevar algunos exactamente a cero puede mejorar determinadas propiedades de la estimación, pero también introduce contracción y selección. El tutorial de Epskamp, Borsboom y Fried (2018) advierte que los intervalos de remuestreo de aristas regularizadas no deben utilizarse automáticamente como pruebas ordinarias contra cero. Una línea ausente en el gráfico puede reflejar el criterio de selección aplicado a datos finitos. Su significado depende de ese procedimiento y de la cantidad de información disponible.
En series temporales, el remuestreo debe respetar la dependencia que motiva el modelo. Reordenar o extraer observaciones como si fueran independientes puede destruir la historia temporal. En estudios con varias personas hay además agrupación por participante. La incertidumbre de una relación promedio y la de una relación individual no se evalúan necesariamente con la misma operación. Antes de elegir un método de remuestreo hay que identificar qué unidades se consideran independientes y qué variación se pretende representar.
La cantidad de datos tampoco se resume bien mediante el total de filas. Muchas observaciones muy cercanas pueden aportar información redundante si el proceso cambia lentamente. Una serie larga con pocas variaciones relevantes puede identificar mal ciertos coeficientes. A la inversa, aumentar el número de ítems eleva el número de relaciones posibles y exige más información para distinguirlas. El diseño debe relacionar duración, frecuencia y número de variables con el proceso que se espera observar, sin imponer una regla universal de tamaño suficiente.
Una comparación entre redes requiere conservar estas condiciones. Si dos grupos respondieron cuestionarios distintos o se midieron con frecuencias diferentes, una diferencia de aristas combina cambios en el sistema y en su observación. Incluso con el mismo instrumento, una diferencia de precisión puede producir un gráfico más denso que otro bajo una regla de selección común. La interpretación debe examinar estimaciones e incertidumbre, en lugar de equiparar una línea seleccionada en un grupo y no seleccionada en otro con una diferencia demostrada.
La selección de síntomas puede modificar la red incluso antes de aplicar un algoritmo de estimación. Cusack y colaboradores (2024) estudiaron registros ecológicos momentáneos de dos muestras de personas con trastornos de la conducta alimentaria (71 y 41 participantes). Compararon una selección de ocho ítems basada en sus promedios con mil combinaciones alternativas de ocho ítems en cada estudio. Las estimaciones y algunas posiciones de centralidad variaron según los ítems incluidos, mientras que las posiciones promedio resultaron relativamente más estables entre ambas muestras. Esa estabilidad entre muestras no corrige la dependencia respecto de la definición de los nodos. Antes de interpretar una jerarquía como propiedad clínica de los síntomas, importa comprobar su sensibilidad al contenido del instrumento; los resultados grupales tampoco permiten escoger automáticamente un objetivo de tratamiento individual.
Cuando la finalidad es predecir, se puede evaluar el desempeño en momentos posteriores que no participaron en las decisiones del modelo. Reservar observaciones exige respetar el orden temporal y evitar que una transformación calculada con toda la serie introduzca información del futuro. Esa evaluación informa sobre el uso predictivo bajo condiciones comparables. Si el objetivo es predecir en una persona nueva, reservar solo momentos de participantes ya observados responde a una pregunta distinta. El diseño de validación debe corresponder al destinatario de la predicción, además de a su horizonte temporal.
Formular la pregunta causal después de describir la asociación
Una asociación temporal puede orientar una pregunta causal concreta: qué ocurriría con un resultado posterior si se modificara una condición definida en un momento determinado. Para responderla hay que establecer la intervención, la alternativa y la población, además del horizonte de evaluación. Una flecha de un modelo predictivo no contiene por sí misma esas definiciones. También debe precisarse si interesa un cambio inicial que después evoluciona libremente o una modificación sostenida durante varias ocasiones.
Las causas comunes que varían con el tiempo son especialmente relevantes. Un acontecimiento externo puede alterar varias respuestas y afectar qué ocurre después. Medir repetidamente esas respuestas no elimina el acontecimiento del proceso generador. Ajustar por variables contemporáneas puede ser adecuado para una comparación y bloquear parte del efecto en otra, según su posición temporal y causal. La elección de ajuste necesita una explicación de las relaciones, más allá de la conveniencia de incluir todos los ítems disponibles.
El propio proceso de observación puede depender del estado. Si alguien deja de responder en ocasiones en las que experimenta más malestar, la serie disponible selecciona momentos particulares. Analizar únicamente transiciones completas puede cambiar la distribución de situaciones representadas. Las marcas de ausencia, las reglas de envío de preguntas y el cumplimiento ayudan a estudiar ese mecanismo. Ninguna matriz de relaciones entre respuestas observadas reconstruye por sí sola lo que ocurrió en las ocasiones que no se midieron.
Completar una ausencia con el último valor registrado introduce una persistencia que procede de la regla de sustitución. Interpolar entre dos respuestas introduce otra trayectoria supuesta. Esas operaciones pueden alterar precisamente las relaciones temporales que se buscan estimar. El análisis debe conservar qué valores fueron observados y cuáles se obtuvieron mediante supuestos, y evaluar cómo cambian las conclusiones bajo tratamientos razonables de la información ausente.
Una hipótesis obtenida de la red puede evaluarse mediante un diseño que genere variación informativa para esa intervención. Según la pregunta, ello puede implicar asignación aleatoria de una acción definida, variación externa justificable o un análisis observacional con supuestos de identificación explícitos. El contraste resultante debe referirse a resultados medidos de forma pertinente y mantener separada la evaluación de la intervención de la selección exploratoria que la sugirió. Esta secuencia conserva el valor de la red como herramienta para formular hipótesis sin atribuirle evidencia que el diseño todavía no aporta.
En el proceso didáctico de X, Y y Z, una perturbación inicial de X alcanza Z dos pasos después a través de Y. Una red observada cada dos pasos resume correctamente esa relación en un coeficiente de 0,16, bajo las ecuaciones fijadas. Para preguntar si conviene modificar X habría que añadir qué modificación es posible, qué otros componentes cambia y qué resultado se valora. El coeficiente resuelve una relación temporal del modelo; la nueva pregunta necesita esas especificaciones antes de convertirla en una comparación de intervenciones.
Referencias
Borsboom, D. (2017). A network theory of mental disorders. World Psychiatry, 16(1), 5–13. https://doi.org/10.1002/wps.20375
Bringmann, L. F., Elmer, T., Epskamp, S., Krause, R. W., Schoch, D., Wichers, M., Wigman, J. T. W., & Snippe, E. (2019). What do centrality measures measure in psychological networks? Journal of Abnormal Psychology, 128(8), 892–903. https://doi.org/10.1037/abn0000446
Castro, D., Gysi, D., Ferreira, F., Ferreira-Santos, F., y Ferreira, T. B. (2024). Centrality measures in psychological networks: A simulation study on identifying effective treatment targets. PLOS ONE, 19(2), e0297058. https://doi.org/10.1371/journal.pone.0297058
Cusack, C. E., Vanzhula, I. A., Sandoval-Araujo, L. E., Pennesi, J.-L., Kelley, S. W., y Levinson, C. A. (2024). Are central eating disorder network symptoms sensitive to item selection and sample? Implications for conceptualization of eating disorder psychopathology from a network perspective. Journal of Psychopathology and Clinical Science, 133(1), 48–60. https://doi.org/10.1037/abn0000865
Epskamp, S., Borsboom, D., & Fried, E. I. (2018). Estimating psychological networks and their accuracy: A tutorial paper. Behavior Research Methods, 50, 195–212. https://doi.org/10.3758/s13428-017-0862-1
Epskamp, S., Waldorp, L. J., Mõttus, R., & Borsboom, D. (2018). The Gaussian graphical model in cross-sectional and time-series data. Multivariate Behavioral Research, 53(4), 453–480. https://doi.org/10.1080/00273171.2018.1454823
Fisher, A. J., Medaglia, J. D., & Jeronimus, B. F. (2018). Lack of group-to-individual generalizability is a threat to human subjects research. Proceedings of the National Academy of Sciences, 115(27), E6106–E6115. https://doi.org/10.1073/pnas.1711978115
Fried, E. I. (2017). The 52 symptoms of major depression: Lack of content overlap among seven common depression scales. Journal of Affective Disorders, 208, 191–197. https://doi.org/10.1016/j.jad.2016.10.019
Fried, E. I. (2020). Corrigendum to “The 52 symptoms of major depression: Lack of content overlap among seven common depression scales”, [Journal of Affective Disorders, 208, 191–197]. Journal of Affective Disorders, 260, 744. https://doi.org/10.1016/j.jad.2019.05.029
Hamaker, E. L., Kuiper, R. M., & Grasman, R. P. P. P. (2015). A critique of the cross-lagged panel model. Psychological Methods, 20(1), 102–116. https://doi.org/10.1037/a0038889