Una persona se inscribe en un taller después de que lo haga una amiga. En el registro aparecen una relación previa, una primera inscripción y una segunda inscripción. La secuencia admite una explicación por influencia: la amiga compartió información, hizo una recomendación o redujo la incertidumbre sobre la actividad. También admite otra: ambas tenían interés por el tema, ese interés contribuyó a que se conocieran y cada una habría terminado inscribiéndose sin la participación de la otra.
Las dos explicaciones producen una asociación entre el comportamiento anterior del contacto y la decisión posterior de la persona. Para distinguirlas hay que precisar qué cambio se atribuye a quién y qué comparación lo identifica. La disponibilidad de una red extensa, con fechas exactas y muchas observaciones, mejora la descripción de esa asociación. La interpretación causal requiere además información sobre la formación de los vínculos, las oportunidades compartidas y el origen de la variación en las exposiciones. Los ejemplos numéricos siguientes son construcciones didácticas, sin datos de participantes reales.
Cuatro procesos detrás de una semejanza
La homofilia designa una preferencia o tendencia a relacionarse con personas semejantes en algún rasgo. Puede operar sobre una característica observada, como una afición declarada, o sobre una disposición que el estudio no mide. La selección incluye la creación, conservación y abandono de vínculos; la homofilia es uno de sus posibles mecanismos. También se seleccionan contactos por proximidad, disponibilidad, complementariedad o relaciones anteriores con terceras personas.
La influencia, en sentido causal, significa que cambiar alguna conducta o comunicación de otra persona modifica el resultado de la persona focal. No exige imitación literal. Una recomendación puede aumentar la participación; una experiencia negativa comunicada por un contacto puede reducirla. Por eso, ni toda semejanza indica influencia ni toda influencia genera semejanza. El signo y la forma del cambio dependen del mecanismo y del resultado que se mide.
El contexto compartido proporciona una tercera explicación. Dos compañeras pueden responder al mismo cambio de horario, a una convocatoria o a una limitación de acceso. Aunque una responda antes, ambas decisiones pueden depender del acontecimiento común. La conexión social ayuda a reconocer quién comparte contexto, pero esa conexión no implica que la conducta de una haya producido la de la otra. Medir únicamente la relación y las decisiones deja sin registrar la causa conjunta.
Finalmente, la semejanza depende de cómo se define y observa la red. Una plataforma puede mostrar recomendaciones parecidas a usuarios con perfiles parecidos y, a la vez, sugerirles que se conecten. Un cuestionario que admite pocos nombres conserva algunos vínculos y omite otros. La lista resultante describe relaciones registradas bajo un procedimiento concreto. Antes de atribuir su patrón a una preferencia social hay que conocer qué contactos podían formarse y cuáles podían aparecer en los datos.
Ese conjunto de oportunidades proporciona un denominador para interpretar la selección. Que la mayoría de los contactos comparta una afición puede ser esperable si casi todas las personas accesibles la comparten. Para estudiar una preferencia por semejanza interesa comparar las relaciones que se formaron con las que podían haberse formado bajo condiciones comparables. En un taller de una sola temática, una red muy semejante no demuestra que cada participante haya rechazado deliberadamente a personas diferentes. Horarios, lugares de encuentro y vínculos comunes pueden restringir las oportunidades antes de que ocurra una elección. Registrar posibles contactos, además de contactos efectivos, ayuda a separar esas explicaciones. El resultado sigue dependiendo de cómo se defina la accesibilidad: estar en la misma base de datos no equivale a haber tenido una oportunidad real de conocerse.
Manski (1993) formuló el problema de reflexión al estudiar si el comportamiento medio de un grupo influye sobre quienes lo componen. La dificultad incluye establecer el grupo de referencia y distinguir las dependencias recíprocas de otras fuentes de asociación. En una explicación de efectos sociales conviene separar el efecto de la conducta de los compañeros, el de sus características previas y el de condiciones comunes. Una regresión sobre el promedio del grupo puede mezclar esas cantidades, especialmente cuando decisiones individuales y promedio se determinan conjuntamente.
Una asociación intensa con efecto nulo
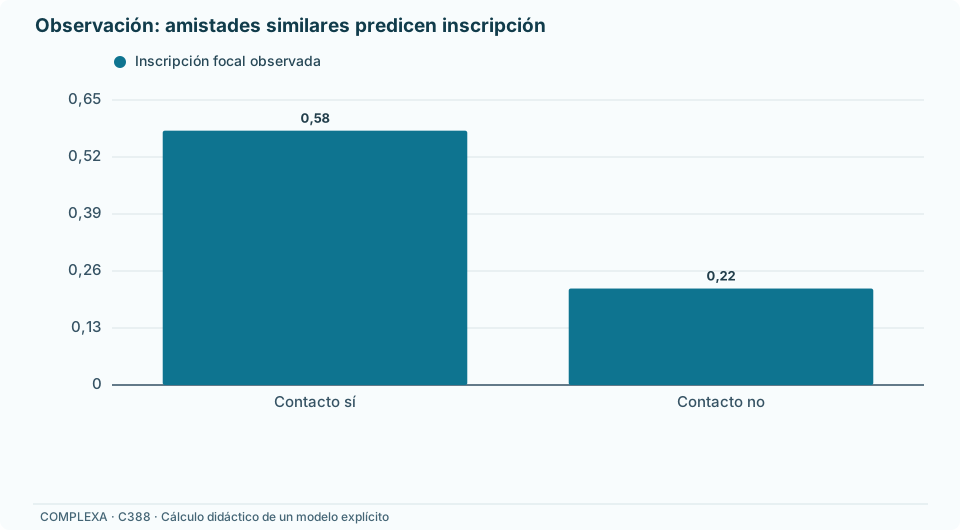
Construyamos parejas dirigidas con dos roles: una persona focal, cuya inscripción futura observamos, y un contacto cuya inscripción anterior conocemos. Las parejas son independientes entre sí. Cada integrante tiene una afinidad alta o baja por el tema del taller. En las parejas ya formadas, ambas afinidades coinciden con probabilidad de ocho décimas. La mitad de las personas focales tiene afinidad alta y la otra mitad baja; lo mismo ocurre entre sus contactos.
Las cuatro composiciones tienen probabilidades de cuatro décimas para alta–alta, una décima para alta–baja, una décima para baja–alta y cuatro décimas para baja–baja. Esta distribución representa selección por semejanza. Para simplificar, el contacto de afinidad alta ya se inscribió y el de afinidad baja todavía no. Denominaremos a tener un contacto inscrito y a tenerlo sin inscribir. Las personas focales aún no están inscritas al comenzar su seguimiento.
La inscripción posterior de la persona focal, , depende únicamente de su propia afinidad. Su probabilidad es de siete décimas si la afinidad es alta y de una décima si es baja. Dentro de cada tipo, la inscripción se genera con un sorteo independiente de la conducta del contacto. No existe una flecha causal desde esa conducta hacia la decisión focal en este modelo. Cambiar la inscripción del contacto, manteniendo las demás reglas, deja intacta la probabilidad focal.
La tabla expresa las frecuencias esperadas al escalar la población de parejas a doscientas. Sirve para facilitar las cuentas; no presenta una muestra observada ni una realización simulada.
| Afinidad focal | Contacto previamente inscrito | Parejas esperadas | Inscripciones focales esperadas |
|---|---|---|---|
| Alta | Sí | 80 | 56 |
| Alta | No | 20 | 14 |
| Baja | Sí | 20 | 2 |
| Baja | No | 80 | 8 |
Entre quienes tienen un contacto inscrito se esperan cincuenta y ocho inscripciones focales de cada cien. Entre quienes no lo tienen se esperan veintidós. La diferencia observada es de treinta y seis puntos porcentuales. La conducta anterior del contacto predice con claridad la conducta posterior de la persona focal, aunque la regla generadora no incluya influencia alguna.
La composición explica la diferencia. El primer grupo contiene un ochenta por ciento de personas de afinidad alta; el segundo, un veinte por ciento. Sus probabilidades de inscripción son promedios de las mismas dos tasas, pero con pesos diferentes. Si comparamos por separado personas de afinidad alta, ambas exposiciones dan siete décimas. Entre personas de afinidad baja, ambas dan una décima. La diferencia dentro de cada tipo es cero.
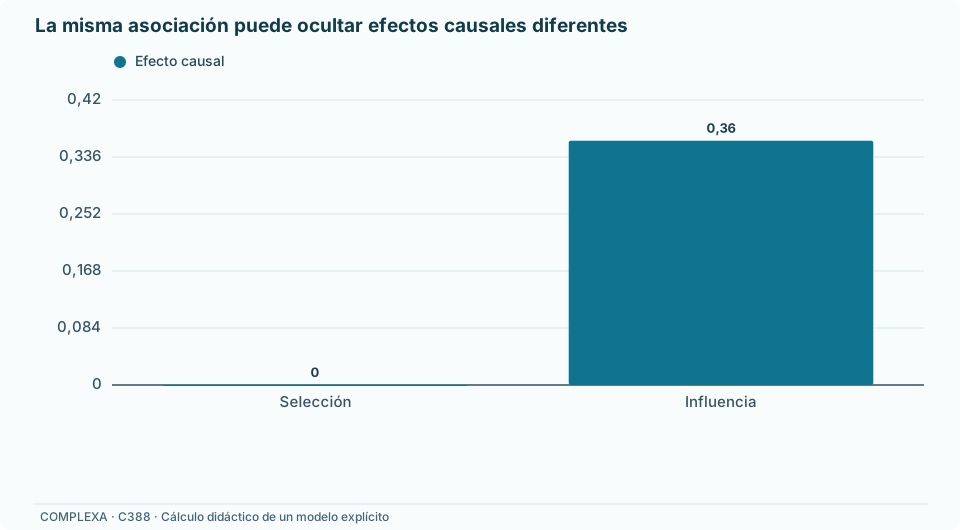
Si intervenimos sobre la inscripción del contacto y conservamos una población focal mitad alta y mitad baja, la probabilidad de inscripción focal es cuatro décimas bajo cualquiera de las dos intervenciones. La media causal se calcula con la misma composición en ambas condiciones. El contraste observado mezclaba ese cambio hipotético de exposición con un cambio en quiénes integraban los grupos comparados.
Los mismos datos bajo una influencia real
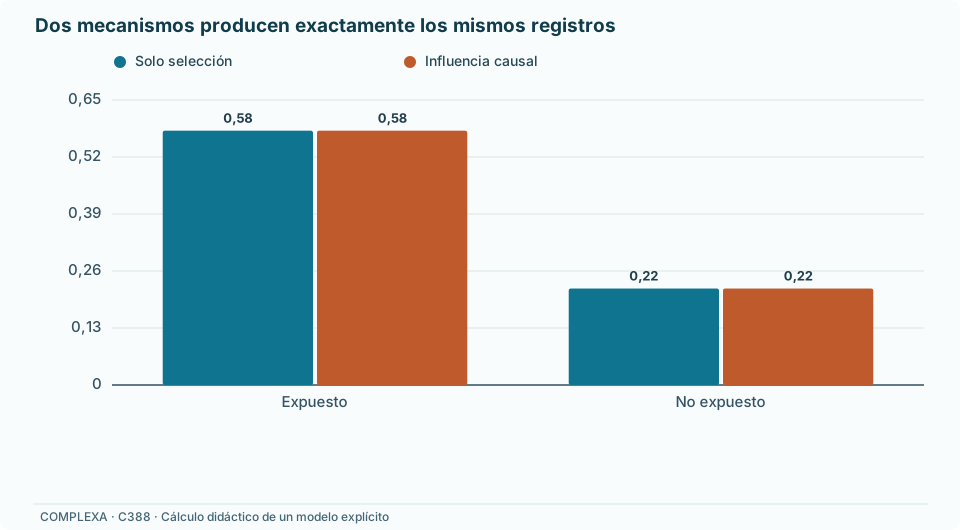
Podemos construir un segundo modelo que produzca exactamente la misma distribución observable de exposición y resultado. En él, la inscripción anterior del contacto se determina con probabilidad de un medio, independientemente de una variable aleatoria que gobierna la respuesta focal. La probabilidad de inscripción focal es veintidós centésimas cuando el contacto no está inscrito y cincuenta y ocho cuando lo está. Ahora sí depende causalmente de la exposición.
Una regla concreta consiste en generar un número uniforme entre cero y uno y declarar la inscripción focal cuando ese número sea menor que . Manteniendo el mismo número al comparar intervenciones, cambiar la exposición convierte en inscritos a quienes estaban entre los dos umbrales. En este modelo, el efecto causal medio es treinta y seis puntos porcentuales. La asociación observada tiene el mismo tamaño que en el modelo anterior, cuyo efecto era cero.
La igualdad cubre toda la tabla observable, no solo una correlación. Las probabilidades de son, respectivamente, , , y en ambos modelos. También se conserva el orden temporal: primero se observa la conducta del contacto y después la respuesta focal. Un registro formado únicamente por esas variables, dentro de las parejas ya existentes, no permite escoger entre los dos mecanismos, aunque su tamaño sea enorme.
La equivalencia está delimitada por ese registro. Si se observan las afinidades del primer modelo, su distribución conjunta aporta información adicional. Si se realiza una intervención que cambie la exposición, los modelos predicen respuestas diferentes. No hemos demostrado que toda colección posible de datos sea insuficiente; hemos mostrado por qué una ley observable concreta no determina el efecto que se pretende extraer de ella.
Shalizi y Thomas (2011) desarrollan este problema de identificación para redes con homofilia latente. Los rasgos no observados pueden afectar tanto a la formación de vínculos como a los resultados. Al estudiar personas conectadas se seleccionan combinaciones de esos rasgos, y la conducta previa del contacto puede resultar informativa sobre la conducta focal sin transmisión directa. Su argumento tampoco convierte la ausencia de identificación en ausencia de influencia. Expone la necesidad de restricciones, covariables adecuadas o variación externa para distinguir procesos compatibles con los mismos datos.
Qué consigue ajustar por covariables
En el primer modelo, observar la afinidad verdadera permite reconstruir una comparación adecuada. Para cada exposición calculamos la probabilidad de inscripción dentro de cada tipo y promediamos con una mitad de peso para cada uno. Las dos probabilidades estandarizadas son cuatro décimas. El ajuste funciona porque hemos especificado un mundo en el que la afinidad bloquea la explicación alternativa y porque existen personas expuestas y no expuestas dentro de ambos tipos.
Esta segunda condición es el soporte de la comparación. Si la selección fuera perfecta, cada persona de afinidad alta tendría un contacto previamente inscrito y cada persona de afinidad baja uno sin inscribir. Faltarían las combinaciones alta–no expuesta y baja–expuesta. Conocer la afinidad no crearía esos datos. Estimar qué ocurriría en las combinaciones ausentes exigiría información externa o restricciones sobre la respuesta, aunque el modelo construido nos permita conocer la verdad por definición.
El problema también cambia si la covariable es una medida imperfecta. Supongamos que un cuestionario clasifica correctamente la afinidad con probabilidad de ocho décimas, por igual en ambos tipos. Sus errores son independientes de exposición y resultado una vez conocida la afinidad verdadera. Si ajustamos por esa clasificación, las probabilidades estandarizadas son aproximadamente con contacto inscrito y sin él. Queda una diferencia de , unos veintiséis puntos y medio porcentuales, pese a que el efecto causal sigue siendo cero. En ambos cálculos se asigna la mitad del peso a cada categoría del cuestionario, que tiene esa misma frecuencia en la población construida.
El cuestionario mejora la comparación respecto a ignorar la afinidad, pero no separa por completo las composiciones. Dentro de una misma categoría medida, la exposición todavía aporta información sobre el tipo verdadero. En este ejemplo, un indicador sin capacidad de clasificación dejaría los treinta y seis puntos originales, y una clasificación perfecta reduciría la diferencia a cero. Entre ambos extremos hay confusión residual. La calidad de la medida forma parte del supuesto causal, además de su presencia como columna en una regresión.
Aral, Muchnik y Sundararajan (2009) utilizaron emparejamiento dinámico para comparar usuarios con distinta exposición a contactos que habían adoptado un servicio. El procedimiento equilibraba características y conductas observadas a lo largo del tiempo. Los autores reconocieron que podían persistir factores latentes no recogidos por esas variables. Su trabajo permite discutir qué comparación mejora al emparejar y qué incertidumbre causal permanece; no autoriza a tratar cualquier diferencia posterior al emparejamiento como influencia ya identificada.
En una aplicación concreta, la afirmación necesaria sería que, dentro de las historias medidas, las personas con distinta exposición tenían perspectivas comparables de inscripción bajo las intervenciones estudiadas. Habría que justificarla con conocimiento del contexto: cómo se enteraron del taller, qué barreras tenían y qué preferencias podían explicar ambos comportamientos. Equilibrar las covariables registradas es comprobable; que no falte una causa relevante requiere argumentos adicionales. Una comprobación del equilibrio y una justificación de suficiencia responden a preguntas diferentes.
La afinidad del ejemplo existía antes de la exposición y no cambiaba por ella. Si el interés declarado se mide después de una recomendación, puede contener parte de la respuesta a esa recomendación. Ajustar por él ya no reproduce la operación anterior: podría bloquear una vía por la que el contacto produjo la inscripción. Un cuestionario con el mismo nombre puede desempeñar funciones causales distintas según cuándo se administre. Si además hay exposiciones repetidas, el interés de una semana puede resultar de recomendaciones anteriores y contribuir a decidir cuáles se recibirán después. La comparación debe entonces referirse a una historia de exposiciones o a un efecto delimitado en el tiempo. Incluir todas las mediciones disponibles como controles, sin distinguir esas posiciones, no garantiza que se conserve el efecto que se quería estimar.
La cronología ayuda a formular la pregunta
Una exposición debe preceder al resultado cuyo cambio se le atribuye. Registrar fechas permite descartar secuencias incompatibles, delimitar ventanas de respuesta y separar decisiones ya tomadas de decisiones posteriores. Sin embargo, el ejemplo de las afinidades satisface esa precedencia y conserva una asociación completamente explicada por selección. El tiempo ordena las variables, pero no elimina sus causas anteriores comunes.
Tampoco basta con incorporar una medición previa del resultado focal. Una inscripción previa, una puntuación o una frecuencia de actividad pueden ser indicadores incompletos de las disposiciones relevantes. Dos personas con el mismo valor inicial pueden tener tendencias diferentes o responder de modo distinto a una nueva oportunidad. El ajuste por el pasado es útil cuando captura causas pertinentes; su utilidad no implica que capture todas las que generaron la exposición.
La resolución temporal debe guardar relación con el mecanismo. Si una encuesta se realiza cada año, pueden ocurrir nuevas amistades, abandonos y cambios de comportamiento entre dos mediciones. Dos personas que aparecen semejantes al final pudieron acercarse por influencia o conectarse después de haberse vuelto semejantes por otras razones. Incluso un cambio de vínculo que luego se revierte deja una historia no visible en los extremos del intervalo.
Las nominaciones dirigidas plantean una dificultad adicional. Que una persona nombre a otra como amiga puede indicar atención, cercanía o un umbral distinto para declarar amistad. Una asociación mayor en la dirección de la nominación no establece por sí sola la dirección del efecto. Shalizi y Thomas (2011) muestran que pueden aparecer asimetrías de regresión sin contagio directo. Para interpretarlas hay que modelar cómo se produjeron las nominaciones y qué diferencias entre personas quedan sin observar.
La selección continúa cuando un vínculo desaparece
La red al final del seguimiento puede contener una selección distinta de la inicial. Consideremos vínculos preexistentes cuyos dos integrantes adoptan después una conducta binaria de manera independiente, cada uno con probabilidad de un medio. Nadie afecta al comportamiento del otro. Supongamos que el vínculo se conserva con probabilidad de ocho décimas si los comportamientos coinciden y de dos décimas si difieren. La conservación se decide después de observar ambos comportamientos.
Antes de seleccionar los vínculos supervivientes, la mitad de las parejas coincide. De esa mitad se retienen ocho décimas; de la mitad discordante, dos décimas. Sobre el conjunto inicial quedan cuatro décimas de parejas concordantes y una décima discordantes. Por tanto, se conserva la mitad de los vínculos y el ochenta por ciento de los conservados es concordante. El aumento de semejanza en la red registrada procede enteramente de qué vínculos permanecieron.
Las prevalencias individuales entre los vínculos retenidos siguen siendo de un medio. La correlación entre los dos comportamientos, que era cero antes de seleccionar, pasa a seis décimas dentro de los vínculos conservados. Analizar únicamente esos vínculos y atribuir la asociación a influencia excluiría precisamente las relaciones que desaparecieron por discordancia. La conducta ha intervenido en el criterio de inclusión de la comparación.
Por esa razón, observar disoluciones tiene valor explicativo. Permite preguntar si un patrón corresponde a cambios de conducta dentro de relaciones que continúan, a la incorporación de relaciones semejantes o a la salida de relaciones diferentes. Son descripciones complementarias, aunque su separación descriptiva no identifique automáticamente los efectos causales. Cuando el objetivo se refiere a la red inicial, restringirse a amistades que sobrevivieron cambia además la población del análisis.
Modelar a la vez vínculos y comportamientos
Una representación longitudinal puede asignar probabilidades tanto a los cambios de vínculos como a los cambios de conducta. Steglich, Snijders y Pearson (2010) desarrollan modelos orientados a actores para esa evolución conjunta. En su formulación, entre las observaciones ocurren pequeños cambios en tiempo continuo: un actor puede modificar un vínculo o su comportamiento. Las probabilidades dependen del estado actual de la red, las conductas y las covariables incluidas. La propiedad de Markov se refiere a ese estado completo, que puede no observarse entre mediciones.
La especificación permite introducir componentes de selección por semejanza, reciprocidad, cierre de relaciones y aproximación al comportamiento de los contactos. Los parámetros distinguen esos componentes dentro del modelo. Los autores señalan, además, que variables omitidas capaces de determinar cambios en red y conducta comprometen la interpretación causal. Por tanto, la separación estadística depende de la representación elegida y de la información disponible sobre explicaciones alternativas.
En el ejemplo del taller, un modelo que omitiera la afinidad podría reproducir parte de los datos utilizando un parámetro de influencia positivo. Otro que incorporara la afinidad verdadera podría reproducirlos mediante selección y decisiones focales independientes. Si solo se entregan las dos variables de nuestra tabla observable, la simulación de nuevas observaciones de esas mismas variables tampoco separaría los mecanismos: ambos producen la misma ley. El algoritmo de estimación no puede resolver una diferencia que su entrada deja indeterminada.
Los datos adicionales deben plantear exigencias nuevas al modelo. Conocer cuándo se formaron relaciones, cuáles desaparecieron o qué preferencias se declararon antes del taller permite evaluar predicciones que los dos mecanismos no tienen por qué compartir. Un modelo puede acertar la prevalencia total y fallar en las parejas que se forman; otro puede acertar la semejanza final y fallar en la duración de las relaciones. Examinar esas discrepancias permite revisar supuestos concretos, en lugar de atribuir toda falta de ajuste a un único parámetro.
También hay que distinguir los datos observados de los cambios intermedios que el modelo reconstruye. Simular una secuencia plausible entre dos encuestas no demuestra que esa secuencia haya ocurrido. Puede haber muchas historias compatibles con los extremos observados. Las conclusiones sobre la contribución de selección e influencia deben conservar la incertidumbre entre esas historias y la dependencia respecto a las reglas que las hacen más o menos probables.
Qué cambia al introducir una asignación aleatoria
Una intervención diseñada puede generar variación en una exposición sin depender de las preferencias que originaron la amistad. Para interpretarla conviene nombrar con precisión qué se asigna. Sortear un mensaje, asignar un compañero y hacer que alguien adopte una conducta son operaciones diferentes. Sus efectos pueden coincidir bajo condiciones específicas, pero la aleatorización de una de ellas no identifica automáticamente las otras.
Aral y Walker (2012) realizaron un experimento en el que notificaciones sobre la actividad de usuarios de una aplicación se enviaban a contactos seleccionados aleatoriamente. Compararon la adopción posterior según esa exposición a notificaciones. La intervención introducía variación en una comunicación concreta dentro de redes existentes, reduciendo la selección de destinatarios según su probable respuesta. El efecto de esas notificaciones se refiere al producto, los mensajes y las condiciones de ese experimento. Las características de una persona asociadas con mayor respuesta en ese entorno no constituyen una medida universal de su capacidad de influir.
Construyamos una versión sencilla para el taller. Todas las personas focales tienen un contacto que ya se inscribió. Se sortea si recibirán un aviso estandarizado sobre esa inscripción; el grupo de comparación no recibe ese aviso. El resultado es la inscripción focal durante una semana. Las parejas no se comunican entre sí y no existen efectos del aviso de una pareja sobre otra. Estas condiciones delimitan el experimento matemático, no describen una red real.
Supongamos que una quinta parte de las personas se inscribiría con o sin aviso, que tres de cada veinticinco lo harían únicamente al recibirlo y que las restantes no se inscribirían en ninguna condición. Las probabilidades bajo asignación de aviso y ausencia de aviso son, respectivamente, y . Su diferencia es doce puntos porcentuales. Como el sorteo no depende de esas respuestas potenciales, la comparación entre grupos asignados tiene esa diferencia en expectativa. Una realización finita puede apartarse de ella por variación de la asignación.
Este efecto pertenece al aviso especificado. No mide el efecto de tener una amistad, de sustituir un contacto por otro ni de la inscripción del contacto, que ya ocurrió en todas las parejas. Tampoco permite separar por sí solo información, reconocimiento social y otros componentes que el mensaje comunica conjuntamente. Para distinguir esos componentes habría que comparar versiones diseñadas del mensaje y mantener claros los cambios entre ellas.
Si algunas personas no leen el aviso, comparar lectores con no lectores vuelve a introducir una selección por atención o interés. La asignación original conserva una interpretación como efecto de ofrecer el aviso bajo esas condiciones de cumplimiento. Un efecto de leerlo exige una pregunta adicional y supuestos que vinculen la asignación con la lectura. Del mismo modo, descartar después a quienes abandonaron el seguimiento puede romper la comparación que el sorteo había establecido.
Sacerdote (2001) estudió compañeros de residencia asignados aleatoriamente dentro de bloques definidos por información previa. El diseño reducía la elección de compañeros según características propias. Su análisis utilizaba la asignación inicial, y el artículo distinguía los efectos de las características del compañero de la identificación de mecanismos específicos. Este caso muestra el valor de conocer el procedimiento de asignación: la comparación debe respetar sus bloques y exclusiones. El hecho de compartir habitación introduce una combinación de oportunidades y exposiciones que no equivale a una dosis aislada de imitación.
La exposición necesita una definición operativa
En una red con varios contactos, la frase «está expuesto a influencia» deja demasiadas decisiones sin resolver. Puede significar que un contacto se inscribió, que varios lo hicieron, que enviaron recomendaciones o que la persona focal leyó esas recomendaciones. Para un análisis reproducible hay que fijar quién cuenta como contacto, cuándo se mide el vínculo y qué conductas o comunicaciones se agregan durante qué intervalo.
Si resumimos toda la exposición mediante el número de contactos inscritos, suponemos que distintas configuraciones con ese mismo número son intercambiables para el resultado estudiado, una vez fijadas las demás variables pertinentes. Esa hipótesis puede fallar si importa quién se inscribió, cuánta confianza inspira o cuándo comunicó la decisión. Conservar identidades o tiempos amplía la exposición, pero aumenta la información necesaria para comparar configuraciones con suficiente apoyo en los datos.
Una notación general expresa el resultado de la persona como función del vector de asignaciones a la red, además de la propia estructura de vínculos. Reducir ese vector a una dosis local es una decisión del modelo. El efecto de cambiar la asignación de un contacto, manteniendo las demás, y el efecto de cambiar una política que actúa sobre todos los contactos responden a contrastes diferentes. La segunda operación puede alterar varias rutas simultáneamente e inducir cambios posteriores en la red.
También importa el límite del sistema observado. Una persona puede recibir información de familiares o de grupos que el registro no incluye. Si esas exposiciones externas se relacionan con las internas, atribuir la respuesta exclusivamente a los contactos registrados puede mezclar canales. Delimitar una escuela, plataforma o residencia proporciona una unidad de estudio, pero no demuestra que todas las comunicaciones relevantes estén encerradas dentro de ella.
Estas decisiones afectan al cálculo de incertidumbre. Varias parejas registradas pueden compartir la misma persona, y una misma comunicación puede generar varias filas de datos. Contar cada fila como una observación independiente exageraría la información disponible cuando sus resultados dependen de factores compartidos. En un experimento, la distribución de asignación y las posibles interferencias deben formar parte del procedimiento de inferencia. En nuestro ejemplo de avisos, la independencia entre parejas era una condición explícita que simplificaba esa tarea.
Qué observación permite distinguir las explicaciones
Un contraste con redes reordenadas al azar puede mostrar que la semejanza observada depende de quién está conectado con quién. Su interpretación debe conservar ese objetivo. En la construcción sin influencia, reducir la coincidencia de afinidades de ocho décimas a un medio elimina la asociación entre exposición y resultado, porque las composiciones de los grupos pasan a ser iguales. La diferencia observada baja de treinta y seis puntos a cero, aunque el efecto causal de la conducta del contacto era nulo antes y sigue siéndolo después.
Por tanto, encontrar más asociación que en una red reordenada no distingue automáticamente contagio de selección. El reordenamiento también destruye las coincidencias de afinidad que generaban el patrón. Un contraste útil necesita declarar qué características mantiene y qué explicación pretende poner a prueba. Un rechazo de la independencia estadística es compatible con varios de los mecanismos que originan dependencia social.
Para estudiar las inscripciones del taller, observar las afinidades antes de la convocatoria permitiría evaluar directamente la explicación del primer modelo. Validar cómo se miden ayudaría a valorar el residuo que podría dejar una clasificación imperfecta. Registrar cuándo se conocieron las personas, cuáles recibieron información externa y qué recomendaciones se comunicaron añadiría variables ligadas a procesos concretos. Cada observación propuesta tiene una función en la comparación; acumular columnas sin esa relación puede complicar el análisis sin resolver su ambigüedad.
Si la pregunta práctica es qué ocurre al enviar un aviso, el sorteo del aviso proporciona un contraste directo para esa decisión, bajo las condiciones del experimento. Si la pregunta es qué ocurriría al cambiar la conducta del contacto, habrá que justificar cómo se produciría ese cambio y qué otros canales modificaría. Las dos preguntas pueden orientar intervenciones diferentes incluso en la misma red. Que una notificación sea eficaz no implica que cualquier modificación del comportamiento de los amigos produzca el mismo resultado.
En la tabla inicial, cincuenta y ocho frente a veintidós inscripciones esperadas seguían siendo una descripción correcta. Para interpretarla como influencia faltaba información que distinguiera dos poblaciones con distinta afinidad de una respuesta causada por el contacto. Medir esa afinidad, estudiar cómo se seleccionaron los vínculos o introducir una exposición asignada aporta comparaciones nuevas. Volver a contar las mismas parejas con mayor precisión reduciría la incertidumbre sobre la asociación, pero dejaría intacta la diferencia causal entre los dos modelos construidos.
Referencias
Aral, S., Muchnik, L., y Sundararajan, A. (2009). Distinguishing influence-based contagion from homophily-driven diffusion in dynamic networks. Proceedings of the National Academy of Sciences, 106(51), 21544–21549. https://doi.org/10.1073/pnas.0908800106
Aral, S., y Walker, D. (2012). Identifying Influential and Susceptible Members of Social Networks. Science, 337(6092), 337–341. https://doi.org/10.1126/science.1215842
Manski, C. F. (1993). Identification of Endogenous Social Effects: The Reflection Problem. The Review of Economic Studies, 60(3), 531–542. https://doi.org/10.2307/2298123
Sacerdote, B. (2001). Peer Effects with Random Assignment: Results for Dartmouth Roommates. The Quarterly Journal of Economics, 116(2), 681–704. https://doi.org/10.1162/00335530151144131
Shalizi, C. R., y Thomas, A. C. (2011). Homophily and Contagion Are Generically Confounded in Observational Social Network Studies. Sociological Methods & Research, 40(2), 211–239. https://doi.org/10.1177/0049124111404820
Steglich, C., Snijders, T. A. B., y Pearson, M. (2010). Dynamic Networks and Behavior: Separating Selection from Influence. Sociological Methodology, 40(1), 329–393. https://doi.org/10.1111/j.1467-9531.2010.01225.x