Módulo 25. Autómatas celulares y modelos basados en agentes
250.1. Dos explicaciones que terminan en la misma imagen
Un modelo puede reproducir un patrón porque sus interacciones lo generan o porque una regla global lo coloca directamente en la salida. Ambas formas de construcción pueden coincidir en una imagen final. Distinguirlas es necesario cuando usamos esa coincidencia para afirmar que hemos identificado un mecanismo.
Este caso compara dos procedimientos completamente especificados. El primero usa activación local por umbrales en un anillo. El segundo consulta una tabla de configuraciones finales preparada para el experimento inicial. Los dos coincidirán exactamente en las diez condiciones de referencia, incluso si registramos qué agentes están activos además de cuántos lo están.
La coincidencia será deliberada y la tabla no se presentará como un descubrimiento. Construirla explícitamente permite mostrar qué información contiene un ajuste perfecto y cuál falta todavía. Después diseñaremos observaciones e intervenciones que separen los procedimientos.
La perspectiva generativa discutida por Epstein pregunta cómo reglas individuales producen organización colectiva [1]. El contraste de múltiples patrones propuesto en la modelización orientada a patrones añade restricciones a esas explicaciones [2]. Aplicaremos ambas ideas en un experimento pequeño, sin atribuirle validación empírica.
Llamaremos L al modelo local e I al procedimiento de resultado incorporado. Ambos comparten agentes, etiquetas de umbral e inicialización de referencia. Difieren en la operación que transforma el estado inicial en estados posteriores. La comparación examina esa operación además del resultado.
Estudiaremos tres tipos de evidencia (las configuraciones finales en el escenario inicial, una observación temprana de la trayectoria y las respuestas a dos intervenciones). Las intervenciones retirarán una conexión o añadirán una semilla de activación; cada una modifica una condición específica y mantiene las demás.
Todos los resultados se obtendrán enumerando diez asignaciones de umbrales, de modo que las tablas no tienen error de Monte Carlo. Sí hay límites de interpretación, porque la distribución uniforme de asignaciones y las reglas son decisiones del experimento que no estiman ninguna población real.
Buscamos una conclusión precisa sobre qué observaciones distinguen estos dos procedimientos y por qué el ajuste del estado final es insuficiente. No intentaremos demostrar que cualquier modelo local es una explicación correcta ni que una tabla de consulta carece siempre de utilidad.
250.2. El modelo local y su conjunto de condiciones
Usaremos seis agentes fijos, numerados de cero a cinco y conectados en un anillo. Cada uno observa a sus dos vecinos inmediatos. La activación es binaria e irreversible. Un agente inactivo se activa cuando el número de vecinos activos alcanza su umbral.
El agente cero tiene umbral uno. Entre las cinco posiciones restantes elegimos exactamente dos para recibir también umbral uno; las otras tres tienen umbral dos. Hay diez pares posibles de posiciones elegidas. Consideraremos cada par con probabilidad un décimo.
La condición inicial contiene únicamente al agente cero activo. Todas las actualizaciones son simultáneas; cada decisión usa la configuración anterior y los cambios se aplican juntos. La dinámica se detiene cuando una actualización completa no modifica ningún estado.
La regla define cómo una exposición local habilita un cambio. No contiene el número final de agentes que deben activarse, que depende de la ubicación de los umbrales y de las conexiones que permiten transmitir la activación desde la semilla.
Si los dos umbrales bajos adicionales están en uno y dos, la activación pasa de cero a uno y después a dos. Los agentes de umbral dos que quedan en la frontera no reciben apoyo suficiente para continuar. La configuración final es el conjunto cero, uno y dos.
Si los umbrales bajos están en dos y cuatro, los dos vecinos inmediatos de la semilla tienen umbral dos. Ninguno recibe dos apoyos y el proceso se detiene sin nuevas activaciones. El conjunto final contiene únicamente al agente cero.
Estos ejemplos muestran que la distribución espacial de los umbrales cambia el resultado aunque la composición total sea la misma. Cada condición contiene tres umbrales de cada tipo. La comparación no cambia el grado de la red ni el tipo de la semilla.
La irreversibilidad facilita una comprobación exacta. El conjunto activo solo puede crecer y hay cinco agentes inicialmente inactivos. Si un paso no añade nada, hemos alcanzado un punto fijo. La implementación no necesita un criterio estadístico para decidir cuándo termina este experimento.
Además del estado final, registraremos el estado después de una actualización y el primer tiempo en que se alcanza la configuración final. Si el estado inicial ya es fijo, ese tiempo vale cero. Esta convención evita contar como cambio un paso adicional usado únicamente para comprobar la detención.
250.3. Un procedimiento que incorpora el resultado final
El procedimiento I recibe el mismo par de posiciones con umbral bajo. Sin aplicar interacciones locales, consulta la tabla siguiente. En el primer paso activa directamente el conjunto indicado y conserva cualquier semilla inicial especificada. Después mantiene ese estado sin cambios.
| Posiciones adicionales con umbral uno | Conjunto activo incorporado |
|---|---|
| 1 y 2 | {0,1,2} |
| 1 y 3 | {0,1} |
| 1 y 4 | {0,1} |
| 1 y 5 | {0,1,5} |
| 2 y 3 | {0} |
| 2 y 4 | {0} |
| 2 y 5 | {0,5} |
| 3 y 4 | {0} |
| 3 y 5 | {0,5} |
| 4 y 5 | {0,4,5} |
La tabla contiene exactamente los estados finales del modelo L en las condiciones de referencia, de modo que I reproduce esos resultados por construcción. No usa la red para decidir qué agente se activa ni requiere que una señal atraviese posiciones intermedias.
La operación de conservar semillas adicionales forma parte de la definición de I. Si en un experimento posterior activamos inicialmente a otro agente, el resultado será la unión entre esas semillas y el conjunto de la tabla. Esta convención fija por anticipado cómo responderá el procedimiento a esa intervención.
También fijamos que retirar una conexión no modifica la tabla; I no contiene un submodelo de transmisión por vínculos. Si quisiéramos recalcular la tabla con L después de cada cambio de red, estaríamos construyendo un emulador de L con otro alcance, distinto del procedimiento que aquí comparamos.
Una tabla de consulta puede ser una herramienta adecuada para ciertas tareas. Si solo necesitamos obtener estados finales de estas diez condiciones, I es una representación compacta y exacta. El problema aparece cuando interpretamos su ajuste como evidencia de una dinámica local que no ejecuta.
Esta distinción separa la utilidad predictiva dentro de un dominio de la interpretación mecanística. Un procedimiento puede resolver bien una tarea limitada y carecer de la estructura necesaria para responder a otra. La descripción del propósito debe indicar qué dominio se pretende cubrir.
Tampoco hay una frontera metafísica entre calcular y consultar. Una tabla puede haberse obtenido mediante una demostración, una simulación previa o datos. Lo relevante es qué dependencias conserva y cómo responde cuando cambia una condición.
Documentar ambos procedimientos mediante entidades, calendario y submodelos, como propone ODD [3], revela rápidamente la diferencia. La misma lista de agentes y la misma imagen final no significan que las operaciones internas sean equivalentes para todas las preguntas.
250.4. El ajuste perfecto no separa los procedimientos
Al enumerar las diez condiciones de referencia, los dos modelos producen la misma configuración final para cada par de umbrales bajos. La coincidencia es de diez sobre diez y no depende de una tolerancia visual ni de una medida aproximada de semejanza.
Si reducimos la salida al número final de activos, obtenemos tres condiciones con uno, cuatro con dos y tres con tres. Bajo la distribución uniforme elegida, las probabilidades son 0,3, 0,4 y 0,3. El promedio final es dos y la varianza es cero coma seis.
| Activos al final | Condiciones en L | Condiciones en I |
|---|---|---|
| 1 | 3 | 3 |
| 2 | 4 | 4 |
| 3 | 3 | 3 |
La igualdad va más allá del promedio, porque ambos comparten distribución, varianza y configuración emparejada por condición. Por tanto, añadir más repeticiones del mismo experimento con observación únicamente final no permitirá distinguirlos; solo dará estimaciones más precisas de una distribución que ambos ya comparten.
Podemos imaginar una calibración que use solo esa salida. Ambos procedimientos recibirían el mismo grado de compatibilidad para las condiciones consideradas, siempre que el modelo de observación también fuera el mismo. Elegir uno requeriría otros criterios o información adicional.
La coincidencia tampoco demuestra que los umbrales sean irrelevantes. En ambos procedimientos el par elegido determina qué fila o qué trayectoria se usa. Lo que el estado final no identifica es la operación temporal que relaciona esa entrada con la salida.
Si inspeccionamos el código, podemos reconocer que L usa transmisión local e I una tabla. Esa inspección describe cómo construimos los modelos y ayuda a formular la comparación. Para inferir cuál representa un sistema observado, en cambio, necesitamos datos que distingan sus predicciones.
La misma lógica aparece en modelos más grandes. Ajustar un histograma, una red final o una curva agregada puede dejar muchas estructuras internas compatibles. La cantidad de detalle de la imagen no garantiza que contenga la información causal relevante.
Descartar toda calibración sería una respuesta equivocada. Lo útil es reconocer qué aspectos quedan identificados por el diseño y buscar observaciones que añadan restricciones. En nuestro caso, la trayectoria temprana y las intervenciones darán esas restricciones de manera exacta.
250.5. Observar el primer paso revela una diferencia
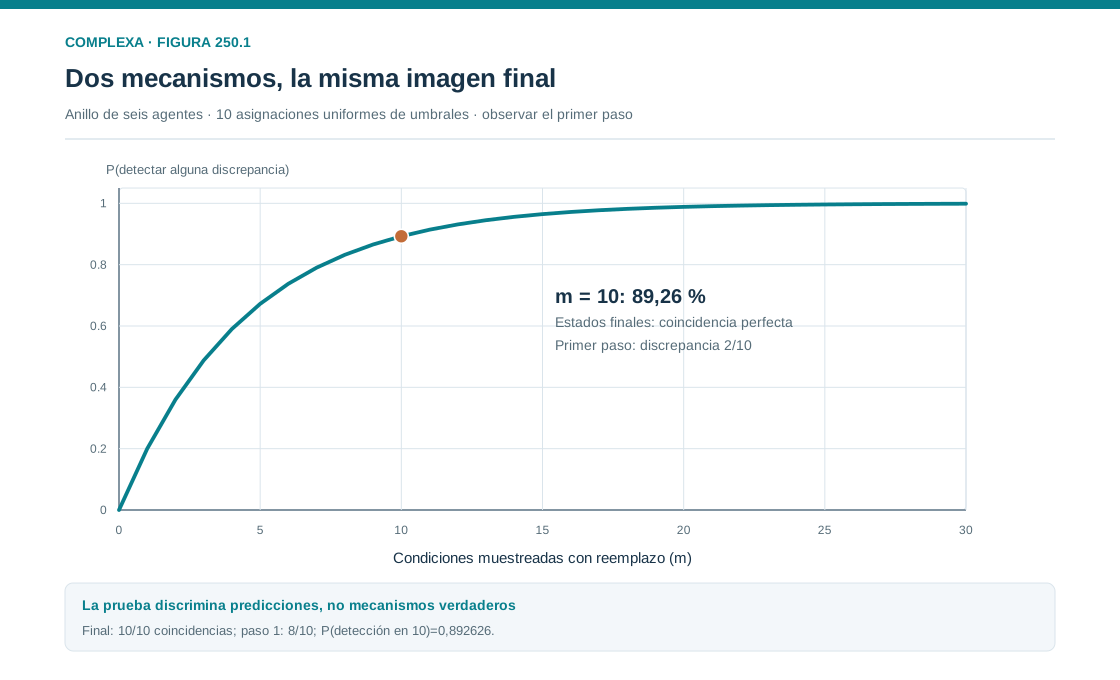
En L, la activación solo puede avanzar mediante los vecinos disponibles en el estado anterior. Cuando los umbrales bajos están en uno y dos, después del primer paso están activos cero y uno; el agente dos debe esperar al segundo. I activa directamente a los tres en su primer paso.
La misma diferencia aparece de forma simétrica cuando los umbrales bajos están en cuatro y cinco. L activa primero a cinco y después a cuatro, mientras que I incorpora inmediatamente el conjunto completo cero, cuatro y cinco.
En las otras ocho condiciones, ambos procedimientos coinciden también después del primer paso. Por tanto, bajo el diseño definido, una observación temprana de una condición elegida al azar distingue los modelos en dos de las diez asignaciones.
| Activos después del primer paso | Condiciones en L | Condiciones en I |
|---|---|---|
| 1 | 3 | 3 |
| 2 | 6 | 4 |
| 3 | 1 | 3 |
El promedio después de un paso es uno coma ocho en L y dos en I. Al final ambos alcanzan promedio dos. La diferencia temporal desaparece cuando observamos únicamente la salida terminal; por eso el experimento inicial no podía separarlos.
El tiempo medio hasta la configuración final también cambia. En L hay tres condiciones ya fijas al inicio, cinco que llegan al final después de un paso y dos que requieren dos; el promedio es cero coma nueve. En I hay tres condiciones inicialmente fijas y siete que alcanzan su resultado en un paso, con promedio cero coma siete.
Estas duraciones se miden en actualizaciones del modelo. Para compararlas con datos reales necesitaríamos una correspondencia con unidades físicas de tiempo. Un registro demasiado espaciado podría observar solo el estado final y volver a ocultar la diferencia.
Esto sugiere un diseño más informativo, en el que elegimos una condición que requiera propagación de dos pasos y la observamos antes de que termine. Recopilar más datos de forma indiscriminada ayuda menos que medir donde las predicciones divergen.
En una aplicación con ruido, los estados tempranos podrían solaparse y la discriminación requeriría repeticiones y un modelo de observación. El ejemplo determinista elimina esa dificultad para mostrar el principio, sin convertir la diferencia de una sola medición en una regla universal de selección de mecanismos.
Podemos cuantificar el efecto de repetir este diseño idealizado. Si elegimos cada condición de forma independiente y uniforme, la probabilidad de no visitar ninguna de las dos condiciones temporalmente discriminantes en m ejecuciones es 0,8 elevado a m. La probabilidad de visitar al menos una es uno menos esa cantidad.
Con diez ejecuciones, esa probabilidad es aproximadamente 0,8926. El cálculo presupone que conocemos la condición, observamos exactamente el primer paso y no hay errores de registro. Lo que mide es la posibilidad de incluir, bajo el protocolo definido, una condición que separa las predicciones; la probabilidad de que un modelo sea verdadero queda fuera del cálculo.
Si podemos elegir la configuración de manera controlada, basta incluir el par uno y dos o el par cuatro y cinco para garantizar esa diferencia predictiva. La comparación muestra cómo el diseño experimental puede ser más informativo que acumular observaciones uniformemente, aunque controlar condiciones pueda tener costos o limitaciones en una aplicación.
También distingue la selección de condiciones de la selección de resultados. Elegir antes una condición donde las hipótesis divergen es una estrategia legítima de contraste. Ejecutar muchas simulaciones y mostrar después solo las que favorecen una historia, sin informar el procedimiento, cambia el significado de la evidencia. La transparencia del diseño permite reconocer esa diferencia.
En todos los casos debemos conservar las predicciones de ambas hipótesis antes de observar. Así, una coincidencia o una discrepancia se interpreta respecto de un contraste definido de antemano, sin recurrir a una explicación reconstruida después de conocer la salida.
El resultado tampoco prueba que toda propagación real ocurra por umbrales, porque otros modelos podrían reproducir la misma trayectoria. Hemos separado dos hipótesis concretas y debemos conservar ese alcance al describir lo aprendido.
250.6. Retirar una conexión cambia la posibilidad de propagación
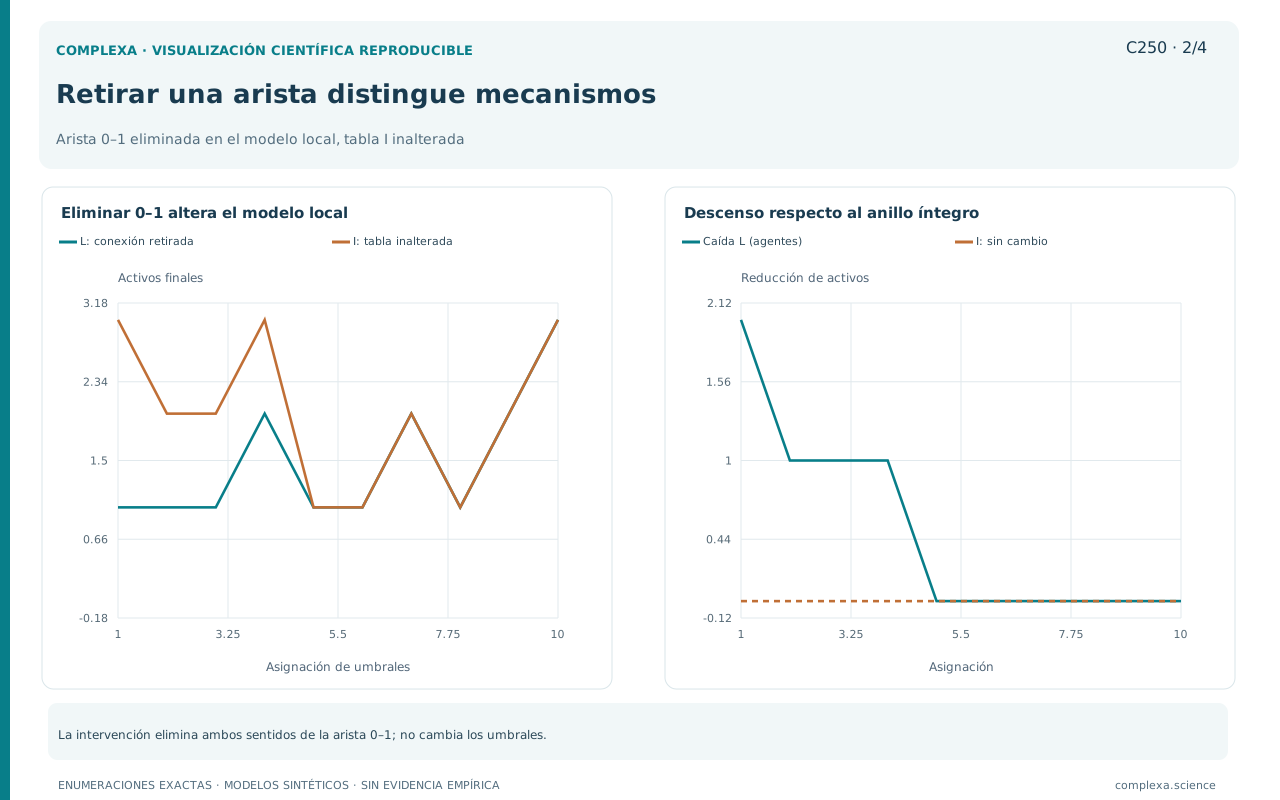
La primera intervención elimina la conexión entre cero y uno en ambas direcciones. Conservamos los seis agentes, sus umbrales, la semilla inicial y la distribución uniforme de los diez pares. No reemplazamos la conexión por otra ni reducimos los umbrales de quienes pierden un vecino.
En L, la activación ya no puede salir de la semilla hacia la posición uno. Solo puede comenzar por la posición cinco, si su umbral es uno, y después podría alcanzar cuatro si también tiene umbral uno. Los demás agentes no encuentran una vía suficiente bajo estas condiciones.
Seis de los diez pares no incluyen la posición cinco. En esas condiciones no aparece ninguna activación nueva y el total final es uno. Tres pares incluyen cinco junto con una posición distinta de cuatro y terminan con dos activos. El par cuatro y cinco permite alcanzar tres.
| Activos al final tras retirar 0–1 | Condiciones en L | Condiciones en I |
|---|---|---|
| 1 | 6 | 3 |
| 2 | 3 | 4 |
| 3 | 1 | 3 |
El promedio de L cae de dos a uno coma cinco. El de I permanece en dos porque su tabla no usa conexiones. La diferencia de medio agente en el promedio compara condiciones; ninguna trayectoria tiene una fracción de agente activo.
Con umbrales bajos adicionales en uno y dos, por ejemplo, L queda solo con la semilla, porque ninguno de sus vecinos restantes puede iniciar la propagación requerida. I mantiene el conjunto cero, uno y dos, ya que esa fila no cambió.
La intervención identifica una dependencia estructural dentro de L. El vínculo retirado era una vía de influencia en varias condiciones. En I, la misma modificación no tiene efecto porque la red no participa en la producción de la salida. Esta diferencia se deriva de las reglas declaradas antes de calcularla.
Si una observación real mostrara una caída semejante, sería evidencia contra el procedimiento I tal como fue definido. Esa observación aislada no confirmaría todos los detalles de L, porque otros mecanismos sensibles al vínculo podrían producir la misma respuesta.
También habría que comprobar que retirar una conexión real no cambia a la vez información externa, recursos o selección de agentes. En el experimento matemático controlamos esas condiciones por definición. En un estudio empírico, sostener esa comparación requiere un diseño y una interpretación adecuados.
El caso convierte así una afirmación general sobre interacción local en una predicción que puede fallar. La red deja de ser una ilustración y pasa a ser una parte del mecanismo cuya intervención tiene consecuencias específicas.
250.7. Añadir una semilla produce respuestas diferentes
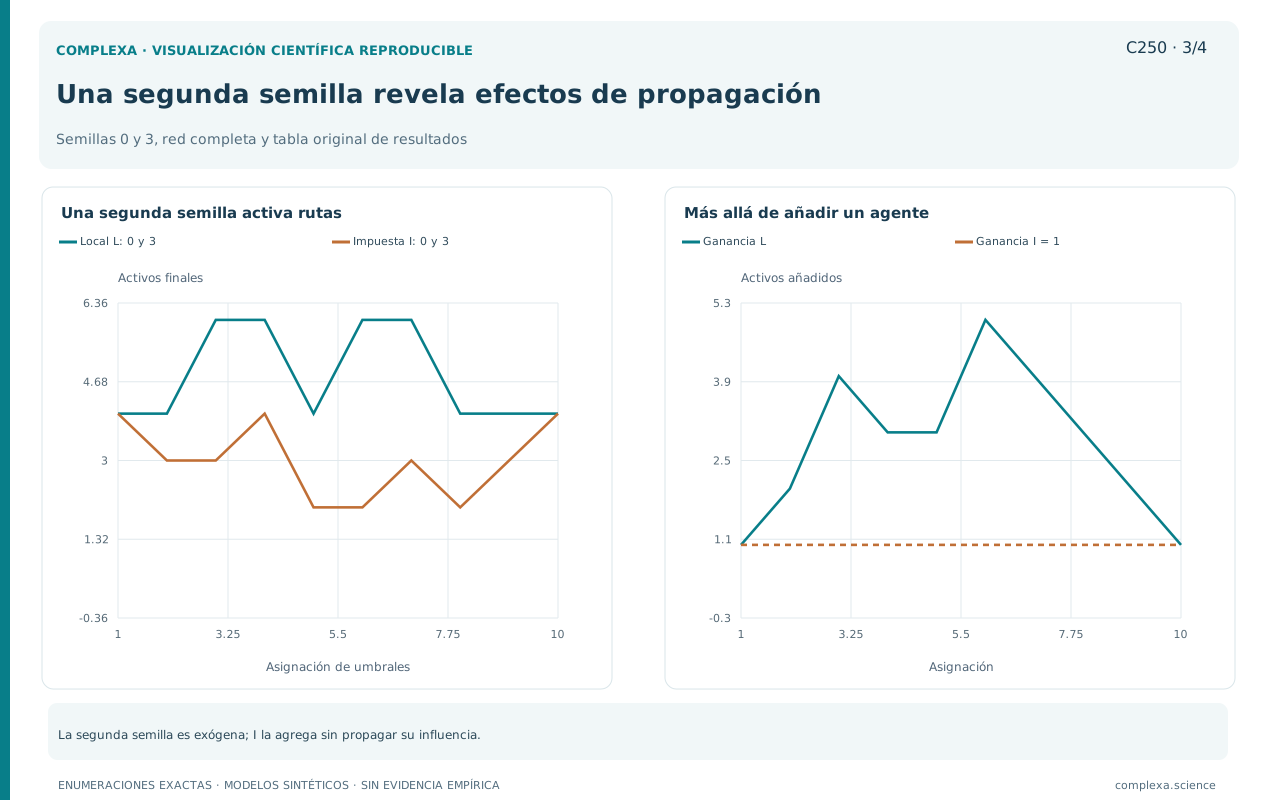
La segunda intervención conserva el anillo completo y activa inicialmente a los agentes cero y tres. No modifica sus umbrales ni la elección de los dos umbrales bajos adicionales. El agente tres puede tener umbral uno o dos, pero comienza activo por intervención.
Las semillas dividen el anillo en dos trayectos, uno por las posiciones uno y dos y otro por cinco y cuatro. Si al menos una de las dos posiciones de un trayecto tiene umbral uno, puede activarse desde una semilla y permitir que la otra reciba dos apoyos.
Cuatro de los diez pares colocan un umbral bajo adicional en cada trayecto. En esas condiciones se activan los seis agentes. Los otros seis pares habilitan solo uno de los trayectos y terminan con cuatro activos. El promedio final de L es cuatro coma ocho.
En I, el agente tres se añade al conjunto de la tabla. Ninguna fila original lo contenía, por lo que cada total aumenta exactamente en uno. La distribución pasa a tres condiciones con dos activos, cuatro con tres y tres con cuatro. El promedio es tres.
| Activos al final con semillas 0 y 3 | Condiciones en L | Condiciones en I |
|---|---|---|
| 2 | 0 | 3 |
| 3 | 0 | 4 |
| 4 | 6 | 3 |
| 6 | 4 | 0 |
La diferencia muestra una interacción entre apoyos en L. Además de su propio estado activo, la nueva semilla puede habilitar activaciones que antes estaban bloqueadas. I conserva la semilla adicional, pero no propaga sus consecuencias mediante la red.
Con umbrales bajos en uno y cuatro, en el primer paso se activan esas dos posiciones desde las semillas. En el siguiente, dos y cinco reciben dos vecinos activos y también cambian. El estado final contiene a toda la población.
El contraste entre cuatro coma ocho y tres es exacto para la distribución de condiciones elegida. No es una estimación del efecto de una intervención en una población externa. Para esa interpretación necesitaríamos justificar tanto los mecanismos como la distribución de umbrales y el significado de una semilla.
La intervención también distingue los efectos aditivos de los mediados por interacción. I responde añadiendo un agente a cada salida. L puede producir un incremento mayor porque cambia qué condiciones locales se satisfacen. Esa diferencia da un criterio concreto para diseñar nuevas observaciones.
Si modificáramos I para incorporar estas nuevas salidas en otra tabla, podría volver a ajustarlas. El ajuste ampliaría su dominio descriptivo, pero una regla general exigiría más evidencia. La evaluación debe reservar condiciones nuevas para comprobar qué dependencias conserva realmente el procedimiento.
250.8. Qué hace legítima la comparación
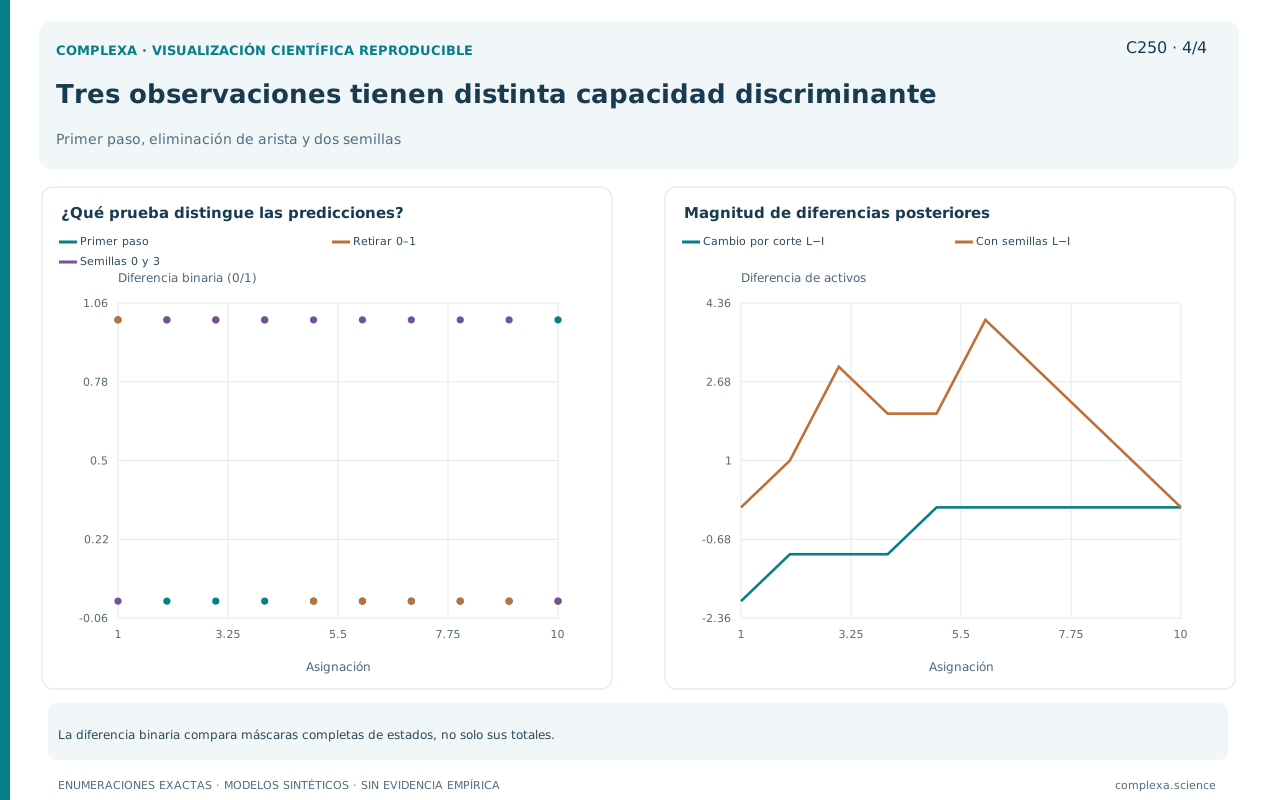
Los dos modelos fueron definidos antes de evaluar las intervenciones. Esta condición evita cambiar una regla después de ver el resultado para conservar una conclusión. Las diferencias son consecuencias de especificaciones explícitas, aunque I haya sido construido deliberadamente para coincidir en el escenario inicial.
La tabla de I puede entenderse como un emulador exacto dentro de un dominio restringido. Si ese fuera su propósito declarado, no responder correctamente fuera de él no sería una falla. El error interpretativo consistiría en atribuirle capacidad mecanística o predictiva para condiciones que no representa.
L también tiene un dominio limitado. Supone percepción exacta, umbrales fijos, irreversibilidad y una red conocida. Si el sistema observado incluye abandono o cambios de conexiones, sus predicciones pueden fallar. Ser local no lo convierte en una explicación privilegiada sin contraste.
La expresión «patrón emergente» tiene aquí un sentido operacional; designa una configuración final de L que resulta de aplicar repetidamente interacciones locales y no está fijada como salida global. Esa definición no implica sorpresa absoluta ni independencia de los supuestos, pues la red y los umbrales ya restringen lo que puede ocurrir.
En I, el patrón terminal está incorporado mediante una tabla. Sin embargo, ambas descripciones pueden contener información equivalente para ciertas preguntas. La distinción relevante depende de las operaciones que queremos predecir y de cómo cambian las entradas; la apariencia o la longitud de un programa no bastan para clasificarlo.
La comparación también debe conservar el mismo proceso de observación. Si observamos a L después de un paso y a I después de dos, introducimos una diferencia artificial. Si medimos estados finales con una regla de detención distinta, podemos confundir tiempos con resultados. Cada contraste necesita condiciones emparejadas.
La enumeración de diez casos elimina la incertidumbre de muestreo dentro de este experimento, pero no la incertidumbre estructural. Tampoco permite extrapolar frecuencias a poblaciones cuyos umbrales tengan otras distribuciones. Una conclusión exacta puede ser muy limitada y seguir siendo útil.
Podemos ampliar el diseño variando semillas, redes y distribuciones, pero cada ampliación debe responder a una pregunta. Para demostrar que el estado final inicial no identifica el mecanismo no hace falta explorar todas las posibilidades, porque los dos contrastes calculados ya establecen esa limitación.
Una evaluación más amplia podría buscar conjuntos de intervenciones que separen muchas hipótesis a la vez. En ese caso convendría preferir observaciones con predicciones diferentes y costos razonables. El modelo ayuda a diseñar la búsqueda de evidencia, además de producir escenarios.
250.9. Reproducción exacta del experimento
El programa siguiente usa únicamente estructuras básicas y enumeración. La función local calcula cierres de activación; la función incorporada consulta una tabla escrita explícitamente. Mantener esa tabla independiente del cálculo local evita que una llamada oculta al mismo algoritmo haga trivial la comparación.
Las historias incluyen el estado inicial y cada cambio hasta alcanzar el punto fijo, sin añadir una copia final sin cambios. Por eso, la longitud de la historia menos uno coincide con el primer tiempo en que se alcanzó el estado terminal. La observación del primer paso usa el estado inicial cuando ya era fijo.
El argumento de la conexión retirada modifica ambos conjuntos de vecinos. Los umbrales permanecen iguales aunque un agente pierda grado. Esta convención es indispensable para reproducir el contraste, porque reducir automáticamente el umbral al retirar una conexión definiría otra intervención.
El procedimiento incorporado recibe el mismo argumento de conexión, pero no lo usa en su regla. Esa ausencia es intencional y está documentada, porque la comparación busca mostrar que su salida terminal depende solo de la tabla y las semillas.
from collections import Counter
from fractions import Fraction
from itertools import combinations
import json

PAIRS = list(combinations(range(1, 6), 2))
LOOKUP = {
    (1, 2): {0, 1, 2}, (1, 3): {0, 1},
    (1, 4): {0, 1}, (1, 5): {0, 1, 5},
    (2, 3): {0}, (2, 4): {0}, (2, 5): {0, 5},
    (3, 4): {0}, (3, 5): {0, 5}, (4, 5): {0, 4, 5},
}

def local(pair, seeds=frozenset({0}), cut=False):
    low = {0, *pair}
    neighbors = {i: {(i - 1) % 6, (i + 1) % 6} for i in range(6)}
    if cut:
        neighbors[0].remove(1)
        neighbors[1].remove(0)
    active = set(seeds)
    history = [set(active)]
    while True:
        nxt = active | {
            i for i in range(6)
            if len(neighbors[i] & active) >= (1 if i in low else 2)
        }
        if nxt == active:
            return history
        assert active < nxt
        active = nxt
        history.append(set(active))

def imposed(pair, seeds=frozenset({0}), cut=False):
    initial = set(seeds)
    final = initial | LOOKUP[pair]
    return [initial] if final == initial else [initial, final]

def summarize(model, seeds=frozenset({0}), cut=False):
    histories = [model(pair, seeds, cut) for pair in PAIRS]
    final = Counter(len(h[-1]) for h in histories)
    first = Counter(len(h[min(1, len(h)-1)]) for h in histories)
    times = Counter(len(h)-1 for h in histories)
    return {
        "final_histogram": dict(sorted(final.items())),
        "mean_final": str(Fraction(sum(k*v for k,v in final.items()), 10)),
        "time1_histogram": dict(sorted(first.items())),
        "time_to_final_histogram": dict(sorted(times.items())),
        "mean_time_to_final": str(Fraction(sum(k*v for k,v in times.items()), 10)),
    }

def run():
    result = {}
    for name, seeds, cut in [
        ("baseline", frozenset({0}), False),
        ("cut_0_1", frozenset({0}), True),
        ("extra_seed_3", frozenset({0, 3}), False),
    ]:
        result[name] = {
            "local": summarize(local, seeds, cut),
            "imposed": summarize(imposed, seeds, cut),
        }
    result["baseline_exact_configuration_matches"] = sum(
        local(pair)[-1] == imposed(pair)[-1] for pair in PAIRS
    )
    result["baseline_rows"] = [
        {"low_pair": pair, "final": sorted(local(pair)[-1]),
         "time_to_final": len(local(pair))-1}
        for pair in PAIRS
    ]
    return result

if __name__ == "__main__":
    print(json.dumps(run(), ensure_ascii=False, indent=2))
La salida incluye histogramas y medias expresadas como fracciones exactas. También cuenta las coincidencias de configuración final en el escenario inicial. Debe informar diez coincidencias, media dos para ambos, media tres medios para L después del corte y media veinticuatro quintos para L con la semilla adicional.
Las pruebas deben verificar cada fila además de esos promedios. Podemos comprobar que ningún estado activo se pierde en L, que todos los agentes permanecen en el dominio y que las semillas aparecen en cada estado final. Para I, verificamos la unión exacta entre semillas y fila de la tabla.
Una implementación independiente puede enumerar con vectores binarios las configuraciones que el programa anterior representa como conjuntos. La coincidencia de ambas sobre todas las condiciones es una comprobación más fuerte que ejecutar repetidamente el mismo código. La independencia es necesaria porque dos funciones que comparten un error pueden coincidir entre sí.
Si el programa se amplía, debe conservarse la separación entre regla, inicialización e intervención. Añadir ruido requeriría especificar su distribución y repetir ejecuciones. Añadir abandono eliminaría la monotonía y obligaría a revisar la detención. Las comprobaciones actuales no cubren automáticamente esos cambios.
250.10. Del patrón observado a una explicación contrastable
El caso mostró que dos procedimientos pueden coincidir exactamente en estados finales y diferir en trayectorias e intervenciones. La igualdad inicial pertenecía a las distribuciones definidas; ningún error de medida ni muestra insuficiente la explicaba. Repetir el mismo diseño no podía resolver la ambigüedad.
Observar el primer paso añadió información temporal. Retirar una conexión examinó una dependencia de la red. Añadir una semilla examinó cómo nuevos apoyos se propagan mediante umbrales. Cada operación impuso una restricción diferente y produjo predicciones calculables.
La comparación no establece que una tabla sea una mala herramienta ni que un modelo de agentes sea automáticamente una buena explicación. Una tabla puede ser exacta y eficiente dentro de su dominio. Un modelo local puede equivocarse sobre el mundo. El criterio es la correspondencia entre propósito, estructura y evidencia.
La documentación permite reconocer qué está impuesto y qué se produce. Las pruebas pequeñas comprueban que el programa ejecuta lo declarado. Con observaciones e intervenciones contrastamos si las dependencias representadas ayudan a explicar un sistema. Esas tareas deben conectarse sin confundirse.
Una afirmación mecanística gana contenido cuando especifica qué cambios deberían alterar el resultado y cuáles deberían conservarlo. Si toda salida puede incorporarse después mediante una nueva excepción, el modelo pierde capacidad de quedar en desacuerdo con la evidencia. Conservar predicciones para condiciones nuevas hace más exigente la evaluación.
El bloque siguiente estudiará agentes adaptativos y aprendizaje. Allí cambiarán los estados y también parámetros, estrategias o reglas. La lección de este caso seguirá vigente, porque de una conducta persistente observada no se sigue que el agente haya aprendido. Tendremos que identificar qué se modifica, mediante qué información y con qué consecuencias contrastables.
Referencias
- Epstein, J. M. (1999). Agent-based computational models and generative social science. Complexity, 4(5), 41–60. Artículo original.
- Grimm, V., Revilla, E., Berger, U. y colaboradores (2005). Pattern-oriented modeling of agent-based complex systems: Lessons from ecology. Science, 310(5750), 987–991. https://doi.org/10.1126/science.1116681
- Grimm, V., Railsback, S. F., Vincenot, C. E. y colaboradores (2020). The ODD protocol for describing agent-based and other simulation models: A second update to improve clarity, replication, and structural realism. Journal of Artificial Societies and Social Simulation, 23(2), 7. https://doi.org/10.18564/jasss.4259