Módulo 25. Autómatas celulares y modelos basados en agentes
249.1. Un modelo debe poder reconstruirse
La descripción de un modelo cumple una función más exigente que acompañar sus resultados. Debe permitir comprender qué sistema se construyó, qué supuestos contiene y cómo produce sus salidas. Si otra persona necesita adivinar reglas, calendarios o excepciones para implementarlo, la descripción todavía deja decisiones científicas sin documentar.
El protocolo ODD organiza esa tarea para modelos basados en individuos y agentes. Su nombre corresponde a visión general, conceptos de diseño y detalles. Fue presentado en 2006, revisado en 2010 y actualizado nuevamente en 2020 [1–3]. Su estructura fija lugares previsibles donde buscar la información necesaria.
La utilidad de un protocolo común aparece al comparar modelos. Dos artículos pueden usar palabras distintas para mecanismos semejantes, o el mismo nombre para reglas diferentes. Una estructura compartida facilita localizar entidades, procesos, fuentes de variación y criterios de observación sin reconstruirlos desde fragmentos dispersos.
ODD no convierte un modelo en correcto por el hecho de describirlo. Una regla equivocada puede documentarse con gran claridad. El protocolo hace más fácil examinar esa regla, reproducir sus consecuencias y detectar dónde una interpretación supera sus supuestos. Transparencia y validez son propiedades relacionadas pero distintas.
Tampoco reemplaza al código. La descripción comunica el mecanismo en un lenguaje legible; el código ejecuta operaciones concretas. Ambos deben corresponderse. Si una ecuación indica actualización simultánea y el programa modifica estados durante el recorrido, la existencia de un documento ordenado no resuelve la discrepancia.
Usaremos el anillo de activación de seis agentes del capítulo 242 como ejemplo de documentación. Sus reglas son pequeñas y conocidas; así podemos concentrarnos en cómo hacerlas reconstruibles. Veremos qué debe decirse sobre identidad, umbrales, vecindad, tiempo e inicialización.
El capítulo también distinguirá la descripción del modelo de la descripción de un experimento. Un mismo mecanismo puede explorarse con parámetros, condiciones iniciales y preguntas diferentes. Para reproducir un resultado necesitamos ambos niveles, además de saber qué versión de la implementación se usó.
La pregunta práctica será si una segunda persona puede obtener las mismas trayectorias sin consultar decisiones ocultas del autor. Esa prueba de reconstrucción convierte la reproducibilidad en una tarea concreta y permite localizar omisiones antes de interpretar diferencias entre resultados.
249.2. Siete elementos y una lectura organizada
La actualización de 2020 mantiene siete elementos, que forman la estructura del documento ODD: propósito y patrones; entidades, variables de estado y escalas; visión general de procesos y calendario; conceptos de diseño; inicialización; datos de entrada; y submodelos [3].
| Elemento | Pregunta que debe resolver |
|---|---|
| 1. Propósito y patrones | ¿Para qué se construyó el modelo y con qué criterios se evaluará? |
| 2. Entidades, variables de estado y escalas | ¿Qué existe en el modelo y cómo se representa? |
| 3. Procesos y calendario | ¿Qué ocurre, cuándo y en qué orden? |
| 4. Conceptos de diseño | ¿Qué principios organizan las decisiones e interacciones? |
| 5. Inicialización | ¿Cómo se construye el estado inicial? |
| 6. Datos de entrada | ¿Qué información externa alimenta la dinámica? |
| 7. Submodelos | ¿Cuáles son las reglas y ecuaciones detalladas? |
La tabla es solo un mapa de lectura. Responder que hay agentes que interactúan y producen patrones dejaría sin resolver casi todas las decisiones de implementación. La información debe avanzar desde la visión general hasta las operaciones precisas.
El propósito ayuda a interpretar el nivel de detalle. Una simulación destinada a demostrar una posibilidad puede usar una población artificial pequeña; una destinada a predecir una distribución observada necesita justificar escalas, parámetros y proceso de observación. El protocolo no exige la misma complejidad para todas las finalidades.
La separación entre procesos generales y submodelos facilita tanto una lectura conceptual como una implementación independiente. Podemos comprender primero la secuencia del sistema sin leer todas las fórmulas y localizar después los detalles necesarios para reconstruir cada operación.
Los conceptos de diseño son el lugar para explicar decisiones que no se entienden solo mediante listas de variables. Por ejemplo, debemos aclarar si una conducta se impone mediante una regla fija, se modifica por aprendizaje o resulta de una optimización. Esas alternativas pueden producir salidas semejantes y tener interpretaciones diferentes.
La estructura no obliga a inventar componentes inexistentes. Si el modelo carece de aprendizaje o de datos externos durante la ejecución, debemos decirlo de forma breve cuando ayude a evitar una ambigüedad. Llenar apartados con afirmaciones vagas puede dificultar más la lectura que reconocer su ausencia.
En un documento ODD autónomo conviene conservar los siete elementos y su orden. Este capítulo usa diez secciones pedagógicas para explicar cómo elaborarlos; no propone cambiar la estructura del protocolo. La ficha del modelo debe seguir siendo reconocible para lectores familiarizados con él.
La calidad de una descripción se mide por la información que permite reconstruir. Un modelo pequeño puede describirse de manera compacta; uno con procesos acoplados necesitará más detalle, referencias cruzadas y una organización que evite repetir reglas incompatibles en diferentes lugares.
249.3. Propósito, patrones y criterios de evaluación
Para nuestro anillo, el propósito es estudiar cómo la ubicación de umbrales individuales modifica la propagación de una activación local. No buscamos estimar una población real ni predecir una conducta humana concreta. Esta declaración limita qué evidencia necesitamos y qué conclusiones podemos extraer.
La comparación principal mantiene seis agentes, dos vecinos por agente y una semilla inicial. Solo varía la distribución de umbrales entre posiciones. El resultado de interés es el conjunto final de activos y la secuencia temporal de activaciones. Así queda claro qué diferencias queremos explicar y cuáles permanecen controladas.
Los patrones usados para evaluar el modelo pueden proceder de observaciones empíricas o de objetivos explícitos de un experimento conceptual. En este caso no hay patrones empíricos. Tenemos consecuencias calculables que permiten verificar la implementación y comparar condiciones, sin presentarlas como validación de un fenómeno real.
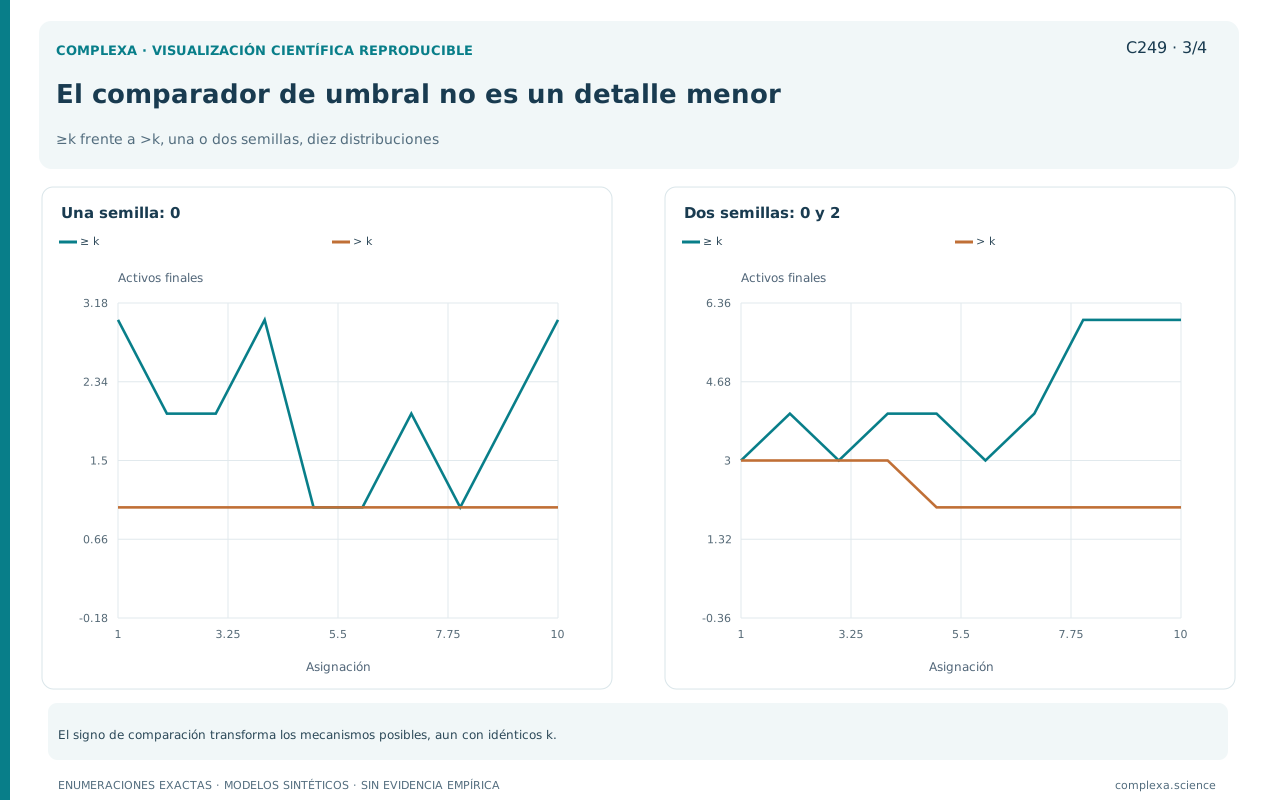
La distribución A, con tres umbrales bajos consecutivos desde la semilla, alcanza tres activos. La distribución B, con umbrales bajos alternados, conserva solo la semilla. Esos resultados se deducen de las reglas y deben aparecer como referencias de verificación; ninguna rutina debe forzarlos artificialmente al terminar.
Si un programa activara exactamente tres agentes para coincidir con el resultado esperado, no estaría implementando el mecanismo local. La coincidencia numérica dejaría de ser evidencia. El criterio de evaluación debe poder fallar cuando el código o los supuestos son distintos.
Podemos añadir preguntas secundarias, como cuánto tarda la propagación, qué ocurre al retirar una conexión o cómo cambia la distribución final al redistribuir los tipos. Cada pregunta necesita observables y comparaciones definidos. Una lista extensa de aspiraciones generales no reemplaza esa relación entre propósito y prueba.
El alcance también debe incluir condiciones excluidas. Nuestro modelo no incluye abandono de la activación, cambios de umbral ni información externa. Mencionar estas ausencias sirve cuando evita una interpretación equivocada de persistencia o aprendizaje. No necesitamos enumerar todos los procesos imaginables que el modelo no contiene.
La justificación de diseño del anillo es que todos los agentes tienen el mismo grado y que la geometría es fácil de verificar. Esa elección reduce ciertas diferencias estructurales para aislar la distribución de umbrales. La justificación no afirma que todas las redes relevantes tengan forma circular.
El propósito debe mantenerse conectado con el análisis final. Si después usamos el modelo para otra pregunta, conviene revisar qué partes de la descripción y evaluación necesitan ampliarse. Cambiar la finalidad puede volver relevantes detalles que antes era razonable omitir.
249.4. Entidades, variables y escalas sin ambigüedad
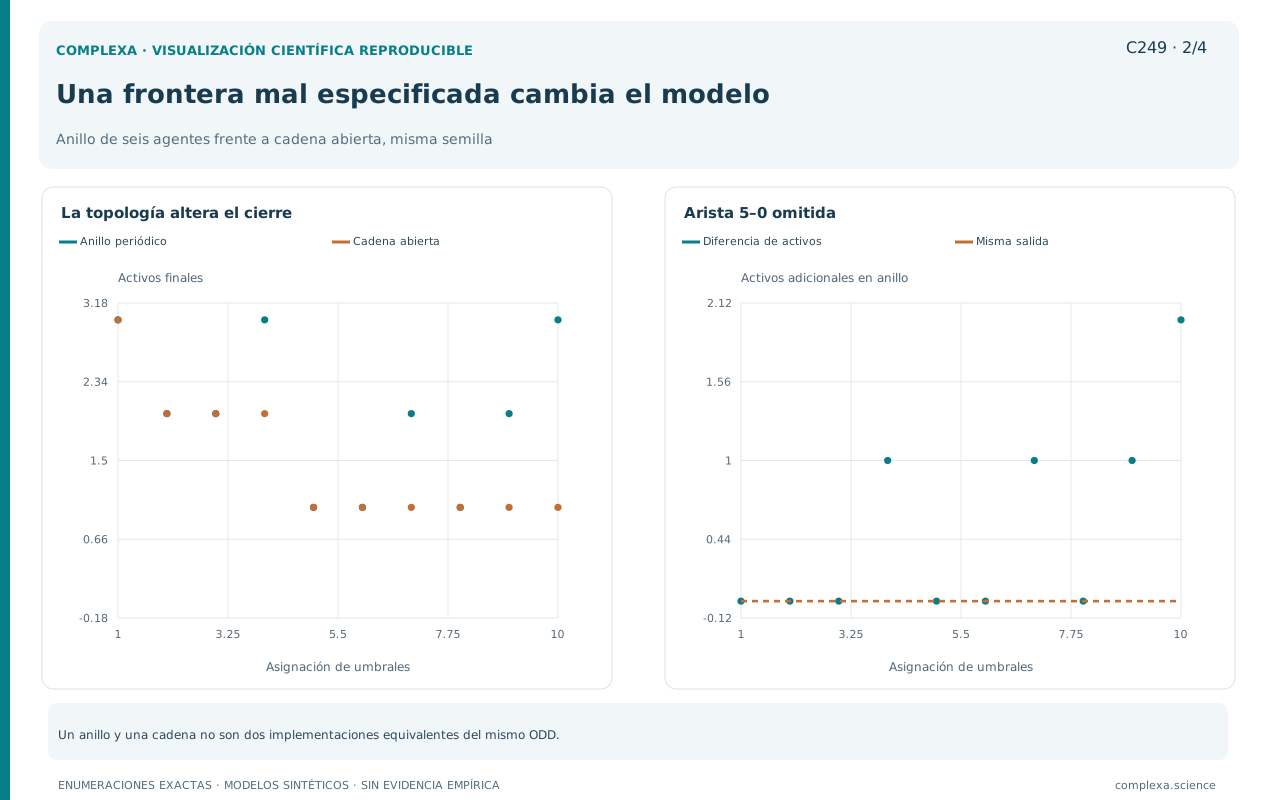
El modelo contiene seis agentes con identidades persistentes de cero a cinco. Cada identidad coincide con una posición fija en el anillo. No hay desplazamientos, nacimientos ni salidas. Esta especificación permite saber que una activación observada en una posición corresponde al mismo agente durante toda la trayectoria.
Cada agente tiene un estado binario de activación y un umbral entero que puede valer uno o dos. El estado cambia con el tiempo; el umbral permanece fijo dentro de una ejecución. La documentación debe indicar dominios y unidades; aquí el umbral es un número de vecinos activos, distinto de una proporción o de una probabilidad.
La red contiene conexiones entre cada posición y sus dos vecinas inmediatas, con cierre entre cinco y cero. Las conexiones son simétricas y no incluyen bucles del agente consigo mismo. Para eliminar dudas sobre fronteras podemos listar las seis aristas, que son cero–uno, uno–dos, dos–tres, tres–cuatro, cuatro–cinco y cinco–cero.
El tiempo avanza mediante pasos enteros. Un paso corresponde a una oportunidad simultánea de actualización para todos los agentes y no tiene asignada una duración empírica. El espacio es una red abstracta; la distancia entre posiciones no se interpreta como metros ni como tiempo de contacto.
El estado global necesario para continuar una ejecución incluye la configuración de activación, los umbrales y la red. Si estos dos últimos componentes permanecen fijos, pueden almacenarse como parámetros o estructuras constantes del programa. Su clasificación informática no debe ocultar su función en el modelo.
La identidad no se reduce a una etiqueta decorativa. Si en una variante futura permitimos movimiento, tendremos que separar identidad y posición. De lo contrario, una lista ordenada por lugares podría hacer parecer que los atributos cambian cuando en realidad se desplazaron los agentes.
También distinguimos variables internas y observables. El número total de activos se calcula a partir de estados individuales; no controla la regla. Si introdujéramos una retroalimentación que modificara umbrales según ese total, dejaría de ser solo una medida y pasaría a formar parte de la dinámica.
La precisión de las escalas evita interpretaciones indebidas. Dos pasos de propagación en el anillo no equivalen a dos días de adopción. Una correspondencia temporal requeriría datos y una regla que haga corresponder oportunidades reales con actualizaciones. El documento debe indicar si esa correspondencia existe o permanece convencional.
Una tabla de variables puede complementar la explicación, especialmente en modelos mayores. Debe incluir símbolo, significado, dominio, unidad y condición de actualización. Una lista de nombres del código, sin esas definiciones, obliga al lector a inferir el mecanismo desde detalles de implementación.
249.5. Procesos y calendario como parte de la especificación
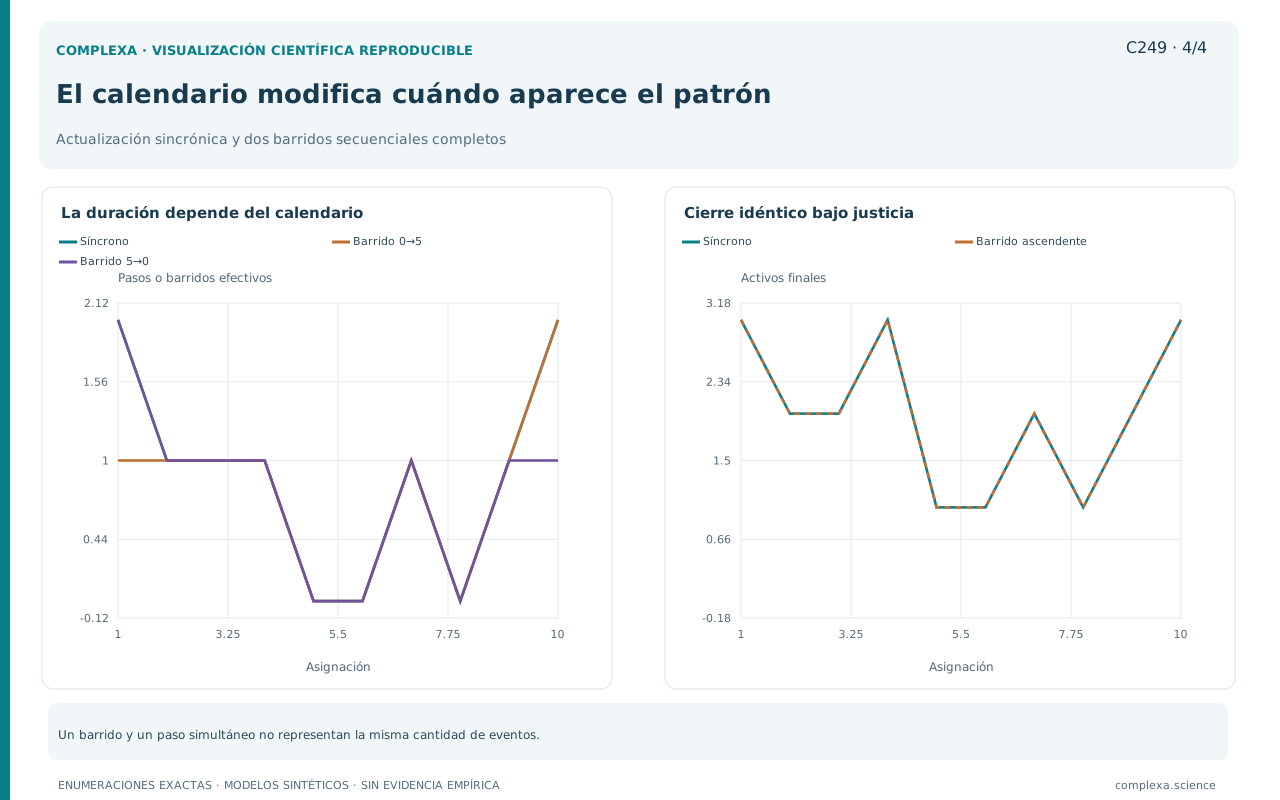
En cada paso observamos la configuración anterior completa y, para cada agente, contamos vecinos activos y calculamos su estado propuesto. Cuando todas las propuestas están calculadas, reemplazamos simultáneamente la configuración. Finalmente registramos observables y comprobamos si el estado cambió.
La secuencia separa lectura, decisión y escritura. Todos los conteos usan la misma versión del estado, de modo que ninguna activación nueva puede contribuir al conteo de otro agente durante ese paso. Esa condición debe quedar explícita aunque el código recorra los agentes uno por uno.
El criterio de detención es igualdad entre dos configuraciones consecutivas después de una actualización completa. Como la dinámica es determinista y los umbrales y la red permanecen fijos, esa igualdad identifica un punto fijo. Un límite máximo de pasos puede usarse como protección informática, pero no debe confundirse con ese criterio científico.
La observación inicial se registra antes de actualizar. Así, la trayectoria incluye el tiempo cero y los estados posteriores. Si otra implementación registra solo después del primer paso, las curvas parecerán desplazadas aunque la dinámica sea la misma. La convención de registro evita esa discrepancia.
La irreversibilidad garantiza que un agente activo permanezca activo. Cada paso no estacionario incorpora al menos una activación nueva. Con una semilla y cinco agentes inactivos, no puede haber más de cinco pasos que añadan actividad. Este argumento da una cota útil para revisar el criterio de detención.
El calendario general debe remitir a la regla detallada sin duplicarla de manera incompatible. Podemos explicar aquí que se cuentan vecinos y se aplica un umbral; la ecuación y los casos particulares quedan para los submodelos. Si escribimos dos versiones completas, debemos mantenerlas sincronizadas al revisar el modelo.
En una variante asincrónica, la descripción tendría que añadir selección de agentes, distribución de oportunidades y unidad de tiempo. También habría que adaptar observación y detención, porque un evento individual sin cambios no prueba que toda la configuración sea fija.
Los procesos simultáneos con conflictos requieren una fase adicional. En nuestro anillo no hay competencia por destinos, pero en el modelo de segregación sí la habría si varios agentes intentaran ocupar una vacante. El protocolo debe describir cómo se resuelve esa situación y cuándo se vuelve visible el resultado.
Una reconstrucción independiente puede empezar por este calendario antes de escribir las funciones detalladas. Si la secuencia no está clara, incluso funciones locales correctas pueden combinarse en una dinámica diferente. Documentar el orden es documentar el mecanismo.
249.6. Conceptos de diseño, lo impuesto y lo producido
Los conceptos de diseño permiten explicar cómo el modelo usa ideas como emergencia, adaptación, aprendizaje, percepción, interacción y observación. La revisión de 2010 y la actualización de 2020 proponen una estructura para examinarlos [2,3]. La tarea consiste en responder sobre el modelo concreto, sin atribuirle capacidades que no contiene.
En el anillo, la distribución final de activación resulta de reglas locales y el número final de activos no se fija directamente. Sin embargo, la red, los umbrales y la irreversibilidad sí están impuestos. Describir ambas cosas evita presentar el resultado como si apareciera sin condiciones organizadoras.
Los agentes no aprenden. Su umbral no cambia a partir de experiencias ni recompensas. Que un estado pase de inactivo a activo tampoco es aprendizaje. Si quisiéramos representar modificación de estrategias, necesitaríamos variables y reglas adicionales que describieran esa modificación.
Tampoco hay una función de utilidad que los agentes maximicen. La regla de umbral es una respuesta especificada. Podemos interpretarla como un mecanismo hipotético de decisión, pero el código no evalúa alternativas ni anticipa consecuencias. Hablar de optimización sería introducir una explicación ausente.
La percepción es local, exacta y contemporánea al estado de referencia. Cada agente conoce sin error los estados de sus dos vecinos; no conoce directamente el estado del resto ni usa una predicción del futuro. Si hubiera retraso o ruido perceptivo, deberían aparecer como procesos explícitos.
La interacción consiste en que los estados de los vecinos pueden habilitar una activación. No hay intercambio de recurso, mensajes diferenciados ni modificación de conexiones. La ausencia de esos componentes permite aislar influencia por exposición local, pero limita las interpretaciones posibles.
La estocasticidad depende del experimento. Las distribuciones A y B producen trayectorias deterministas. En el experimento de redistribución de umbrales, la incertidumbre se sitúa solo en la inicialización. Esa ubicación determina qué significa repetir una ejecución.
No existen colectivos como entidades adicionales del programa. Podemos identificar un conjunto conectado de agentes activos durante el análisis, pero ese conjunto no tiene estado propio ni toma decisiones. Confundir una agrupación observada con una entidad que actúa agregaría un nivel causal inexistente.
La observación registra configuraciones, total de activos y tiempo de cada activación. El observador dispone del estado completo para analizarlo, aunque los agentes no lo usen. Mantener separadas ambas perspectivas evita filtrar información global hacia una regla que pretende ser local.
249.7. Inicialización y datos externos
La inicialización determinista coloca al agente cero activo y a los demás inactivos. Para la distribución A, los umbrales desde cero hasta cinco son uno, uno, uno, dos, dos y dos. Para B son uno, dos, uno, dos, uno y dos. La red es el mismo anillo en ambas.
Decir que la mitad de los agentes tiene umbral bajo deja muchas distribuciones posibles entre posiciones y, como vimos, esas distribuciones cambian el resultado. La descripción debe dar la asignación completa o el procedimiento que la genera.
Para el experimento de redistribución de umbrales, fijamos el umbral de la semilla en uno y elegimos dos posiciones adicionales entre las otras cinco para recibir ese umbral. Hay diez asignaciones. Podemos enumerarlas todas o muestrearlas uniformemente. Ambos procedimientos estudian la misma distribución definida, pero tienen errores computacionales diferentes.
La enumeración exacta no necesita una semilla aleatoria. Si muestreamos, debemos registrar generador, semilla y mecanismo de selección. Elegir dos posiciones sin reemplazo no equivale a generar cinco umbrales de manera independiente con cierta probabilidad, aunque ambas alternativas puedan conservar una proporción media parecida.
El apartado de datos de entrada describe información externa que alimenta la dinámica durante la ejecución. Nuestro anillo no recibe una serie externa de estímulos después del tiempo inicial. Esa ausencia debe quedar clara para que nadie añada nuevas activaciones durante la simulación.
Los archivos usados para construir la red o los atributos iniciales deben documentarse donde cumplen esa función. Su existencia no implica que la dinámica reciba entradas temporales. Separar inicialización y forzamiento externo permite reconstruir qué información actúa en cada momento.
En un modelo con temperatura diaria o llegadas observadas, habría que indicar fuente, unidad, resolución, alineación temporal y tratamiento de valores faltantes. Interpolar una serie, repetir el último valor o detener la ejecución son decisiones diferentes, que no deben quedar ocultas en una rutina de lectura.
La documentación también debe distinguir parámetros calibrados y datos usados para evaluarlos. Si una misma serie se usa para ambas tareas, el lector necesita saberlo. La función científica de un archivo depende de cómo interviene en el diseño y el análisis, cualquiera que sea su estructura.
La inicialización puede formar parte de la hipótesis. Comenzar desde una población ya organizada puede favorecer la persistencia de un patrón. Por eso, las conclusiones sobre formación, estabilidad y recuperación requieren condiciones iniciales acordes con la pregunta.
249.8. Submodelos, ecuaciones y excepciones
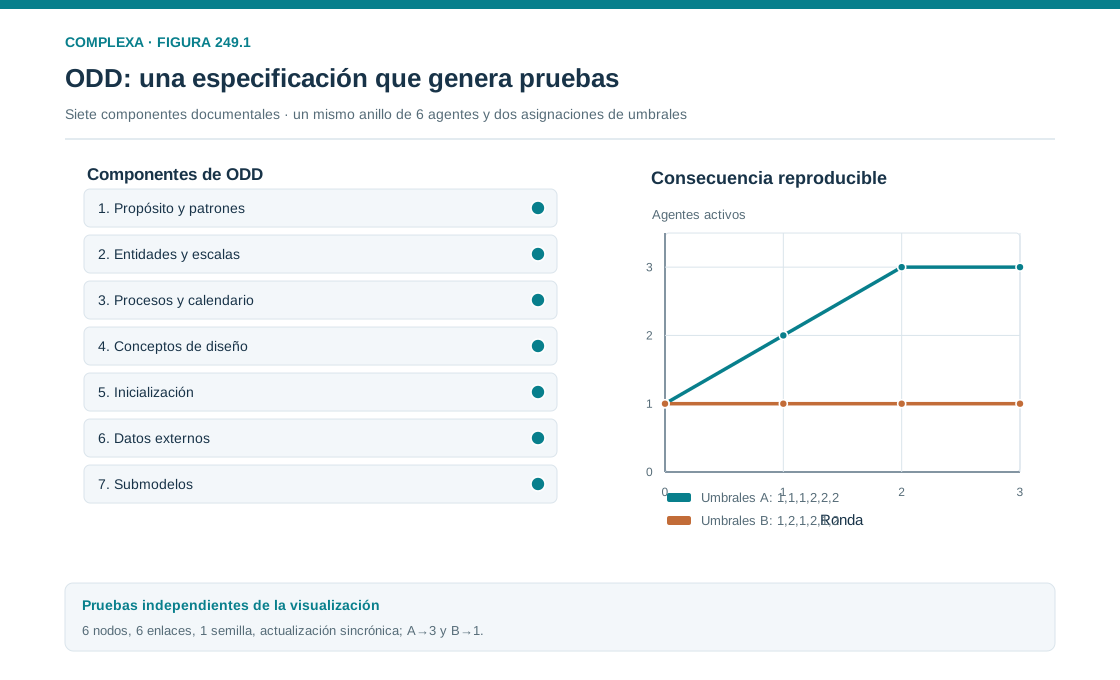
El submodelo de activación puede expresarse mediante una ecuación que combina persistencia y umbral. Un agente permanece activo si ya lo estaba, o se activa si la suma de sus dos vecinos alcanza su umbral. Los índices se interpretan módulo seis.
La ecuación debe acompañarse de dominios y convenciones. El estado es cero o uno; el umbral es uno o dos; la función indicadora vale uno cuando se cumple la condición. No hay redondeo, probabilidad de activación ni recuperación. Esos detalles permiten implementar la regla sin interpretar metáforas.
Los límites del índice merecen una explicación concreta. Para el agente cero, el vecino anterior es cinco; para el agente cinco, el siguiente es cero. Una implementación que omita esas conexiones produciría una cadena abierta y estudiaría otro sistema.
El signo de comparación también es parte del mecanismo. Un agente de umbral dos se activa con exactamente dos vecinos activos. Si el programa usara mayor estricto, ese agente nunca podría activarse, porque solo tiene dos vecinos.
La persistencia debe verificarse por separado. Incluso si un agente activo deja de cumplir su umbral, continúa activo bajo la regla. En esta dinámica los apoyos no se pierden porque los demás tampoco se desactivan, pero la expresión de persistencia sigue siendo necesaria para definir el proceso.
Los submodelos de observación calculan el total de activos mediante suma de estados y registran el primer paso en que cada agente se activa. Para la semilla, ese tiempo es cero. Para un agente que nunca se activa antes del punto fijo, usamos una marca explícita de ausencia, distinta del cero de la semilla.
Una descripción completa puede incluir pseudocódigo breve, especialmente cuando hay desempates o secuencias difíciles de expresar con una sola fórmula. El pseudocódigo debe describir operaciones del modelo sin depender innecesariamente de una biblioteca particular. Los detalles del entorno de ejecución se documentan además para reproducir el programa.
En modelos mayores, cada submodelo debe indicar entradas, salidas y variables que modifica. Esa información permite revisar acoplamientos, como un componente que consume una reserva actualizada por otro o que usa una observación con retraso. Las interfaces son lugares frecuentes de ambigüedad.
La justificación de una regla debe distinguirse de su definición. Podemos explicar por qué usamos un umbral y qué evidencia lo motivaría, pero esa explicación no debe sustituir la ecuación. La reconstrucción necesita saber exactamente qué ocurre, incluso cuando la motivación científica permanece discutible.
249.9. Del documento al experimento reproducible
Una descripción ODD permite reconstruir el mecanismo, pero un resultado concreto requiere además un diseño experimental. Debemos indicar qué condiciones se compararon, cuántas ejecuciones se hicieron, qué observables se resumieron y cómo se calculó la incertidumbre. La actualización de 2020 insiste en que también deben describirse los experimentos de simulación [3].
Para nuestro caso, el experimento A frente a B requiere dos ejecuciones deterministas y comparación de trayectorias completas. La enumeración requiere diez inicializaciones y un histograma del número final de activos. Son experimentos diferentes sobre el mismo mecanismo y deben identificarse como tales.
Conviene declarar también qué diferencia entre ejecuciones consideramos aceptable. En este modelo binario determinista exigimos igualdad exacta de configuraciones. En un modelo continuo, podríamos necesitar tolerancias numéricas justificadas. En uno estocástico, comparar una sola trayectoria puede ser insuficiente y quizá debamos evaluar distribuciones bajo un diseño común.
Usar la misma semilla aleatoria en dos programas no garantiza la misma secuencia de decisiones. Bibliotecas distintas pueden transformar números aleatorios de manera diferente o consumirlos en otro orden. Para una comparación estricta podemos suministrar una secuencia de entradas aleatorias explícita, mientras que para una comparación estadística debemos definir qué propiedades distribucionales esperamos conservar.
Estas decisiones pertenecen al plan de reproducción y deben distinguirse de la explicación conceptual del modelo. Ayudan a interpretar si una discrepancia procede de reglas diferentes, aritmética, generación aleatoria o variación esperada entre realizaciones. Sin ese criterio, cualquier diferencia puede presentarse equivocadamente como una refutación o descartarse sin examen como ruido.
Cada implementación debe declarar a qué versión de la descripción corresponde. Si cambiamos a actualización asincrónica, el documento anterior deja de describir completamente el programa. Mantener un registro de cambios permite explicar qué resultados corresponden a cada combinación de reglas y código.
Las pruebas pequeñas deben tener resultados esperados explícitos. Para A, las configuraciones binarias son 100000, 110000 y 111000; la última permanece fija. Cada carácter es el estado de un agente según el orden declarado; estas cadenas son configuraciones y no deben leerse como cantidades decimales.
Para B, la configuración 100000 permanece igual. En la enumeración, tres asignaciones terminan con un activo, cuatro con dos y tres con tres. Una segunda implementación debería reproducir cada trayectoria, más allá de la media final de dos.
La coincidencia de medias puede ocultar errores compensatorios. Dos programas podrían intercambiar los resultados de algunas asignaciones y mantener el mismo histograma. Por eso, la auditoría debe comparar entradas y salidas emparejadas antes de limitarse a estadísticas agregadas.
La disponibilidad del código ayuda a inspeccionar decisiones, pero no reemplaza una explicación legible. A la inversa, una descripción clara no garantiza que el código la cumpla. La correspondencia entre ambos se examina mediante revisión, casos calculables y, cuando sea útil, una implementación independiente.
Los archivos de resultados deben conservar suficiente información para reconstruir el análisis. Una figura final sin configuraciones, parámetros o reglas de exclusión impide saber qué se promedió. La trazabilidad necesita conectar pregunta, versión, ejecución, observación y resumen.
Cuando una discrepancia revele una omisión, debemos corregir la descripción y revisar qué resultados afecta, porque completar un apartado puede cambiar la interpretación del mecanismo. Detectar decisiones implícitas es una de las principales ventajas de documentar mientras se construye el modelo.
249.10. Auditar lo que otra persona tendría que adivinar
Una auditoría útil puede pedir a un lector que escriba las decisiones que necesitaría tomar para implementar el modelo. Si aparecen preguntas sobre vecindad, orden, empates, fronteras, unidades o detención, esas decisiones deben incorporarse a la descripción. El criterio es operativo y no depende de que el documento parezca formal.
También conviene revisar contradicciones entre secciones. Una variable declarada fija no debe cambiar en un submodelo sin explicación. Un agente descrito como local no debe usar una media global. Un proceso presentado como determinista no debe depender de una selección aleatoria no documentada.
La distinción entre resultados impuestos y producidos requiere una comprobación aparte. Un patrón puede aparecer porque una regla local lo genera o porque un procedimiento de inicialización ya lo incorpora. El documento debe permitir localizar esa diferencia y formular una comparación que la examine.
La extensión de la descripción debe responder a la complejidad del mecanismo. Repetir afirmaciones generales sobre emergencia no compensa la ausencia de una regla de desempate. Una tabla compacta de variables o un ejemplo calculable puede aportar más reproducibilidad que varias páginas de motivación abstracta.
ODD da una estructura común para ordenar ese trabajo. Su valor aparece cuando permite reconstruir, comparar y criticar mecanismos concretos. No certifica una explicación, pero reduce el espacio de decisiones ocultas y facilita que las discrepancias se conviertan en preguntas examinables.
El siguiente capítulo aplicará estas ideas a un caso completo. Compararemos un patrón generado por interacción local con otro incorporado mediante una regla de selección. La tarea será identificar qué evidencia permite distinguir ambas formas de producir una salida semejante y qué observaciones adicionales necesita la explicación.
Referencias
- Grimm, V., Berger, U., Bastiansen, F. y colaboradores (2006). A standard protocol for describing individual-based and agent-based models. Ecological Modelling, 198(1–2), 115–126. https://doi.org/10.1016/j.ecolmodel.2006.04.023
- Grimm, V., Berger, U., DeAngelis, D. L., Polhill, J. G., Giske, J. y Railsback, S. F. (2010). The ODD protocol: A review and first update. Ecological Modelling, 221(23), 2760–2768. https://doi.org/10.1016/j.ecolmodel.2010.08.019
- Grimm, V., Railsback, S. F., Vincenot, C. E. y colaboradores (2020). The ODD protocol for describing agent-based and other simulation models: A second update to improve clarity, replication, and structural realism. Journal of Artificial Societies and Social Simulation, 23(2), 7. https://doi.org/10.18564/jasss.4259